Трек
Ассоциированный AI-инженер для разработчиков
26 ч
Практикуйтесь и следите за своим прогрессом.
Продолжить С GoogleПредставьте, что вы пришли в ресторан, и официант спрашивает: «Вода обычная или с газом?» Вы не отвечаете абзацем о том, как предпочитаете поддерживать гидратацию; вы выбираете один из двух вариантов, которые вам предложили.
Теперь вспомните, как мы используем большие языковые модели (LLM) в большинстве приложений сегодня. Мы задаём им вопросы вроде «Этот тикет поддержки про биллинг, доставку или возвраты?» — и модель присылает нам полное предложение, которое затем приходится разбирать в коде. По сути, возможных ответов было всего три, но мы всё равно заплатили за целый рассуждательный ответ.
Именно этот разрыв новая категория моделей и пытается закрыть. В сентябре 2026 стартап TypeSafe AI выпустил Jev — модель, которая вовсе не пишет текст.
Вместо этого она оценивает фиксированный набор ответов и сообщает, насколько вероятен каждый из них. Спустя несколько недель свои версии выпустили OpenAI, Cloudflare, Perplexity и Microsoft — показатель того, насколько стремительно развивается область.
В этой статье рассмотрим, что такое модели принятия решений на основе ИИ, как они работают и откуда вообще взялась эта идея (она гораздо старше, чем кажется по текущему хайпу). Также посмотрим, что показали независимые бенчмарки.
if.Модель принятия решений — это модель, которая получает на вход данные и набор допустимых ответов и возвращает вероятность каждого ответа, не генерируя свободный текст.
Ключевая идея: вывод таких моделей уже структурирован.
Не нужно разбирать предложения — модель может вернуть только один из предложенных ответов. Значит, результат можно сразу использовать в вашем коде в операторе if.
Разницу удобно представить как два формата экзамена.
Большая языковая модель сдаёт сочинение, выписывая ответ слово за словом, тогда как модель решений сдаёт тест с вариантами и вдобавок сообщает уверенность по каждому пункту (оценку уверенности).
Jev и большинство альтернатив Jev поддерживают три типа вопросов:
У TypeSafe также есть экспериментальный тип Box для нахождения объектов на изображениях, но мы его здесь опустим.
Пример из документации TypeSafe.
Вы передаёте state (это просто текст, который модель должна проанализировать) и словарь questions. Для вопроса типа choice у каждого варианта есть краткое описание в поле criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
А вот соответствующий ответ:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Парсить текст не нужно.
Вы получаете выбранный вариант, вероятность для каждого варианта и значение уверенности, полученное из наивысшей вероятности: чем «плосче» распределение, тем ниже уверенность. В документации более «грязный» тикет, где упоминаются и неверный размер, и двойное списание, делит вероятность между возвратами (0,61) и биллингом (0,35), а уверенность падает до 0,42.
TypeSafe описывает Jev как «System One Model», ссылаясь на книгу Даниэля Канемана Думай медленно… решай быстро. Почему?
Если упростить, Система 1 — это быстрые, интуитивные суждения, а Система 2 — медленное, пошаговое рассуждение.
Модель решений задумана как быстрая.
Оговорка: Система 1 — это также часть мозга, которая часто ошибается на скорую руку, и в заслугу TypeSafe стоит отметить, что в их документации открыто перечислены типичные промахи Jev. К этому мы вернёмся.
Меня поначалу смутил термин «модель решений»: он уже означает разные вещи. Например:
Итак, в этой статье «модель решений» — это только новая категория моделей, вышедших в конце 2026 года, которые оценивают типизированные ответы вместо генерации текста.
Прежде чем разбираться, как работают модели решений, полезно вспомнить, как обычный LLM формирует ответ. Так контраст лучше виден.
Большая языковая модель работает в цикле.
Она преобразует наш текст в токены, предсказывает вероятность для каждого токена в словаре, выбирает один, добавляет его к тексту и повторяет цикл.
Каждый дополнительный токен в ответе — это ещё один прямой проход через модель.
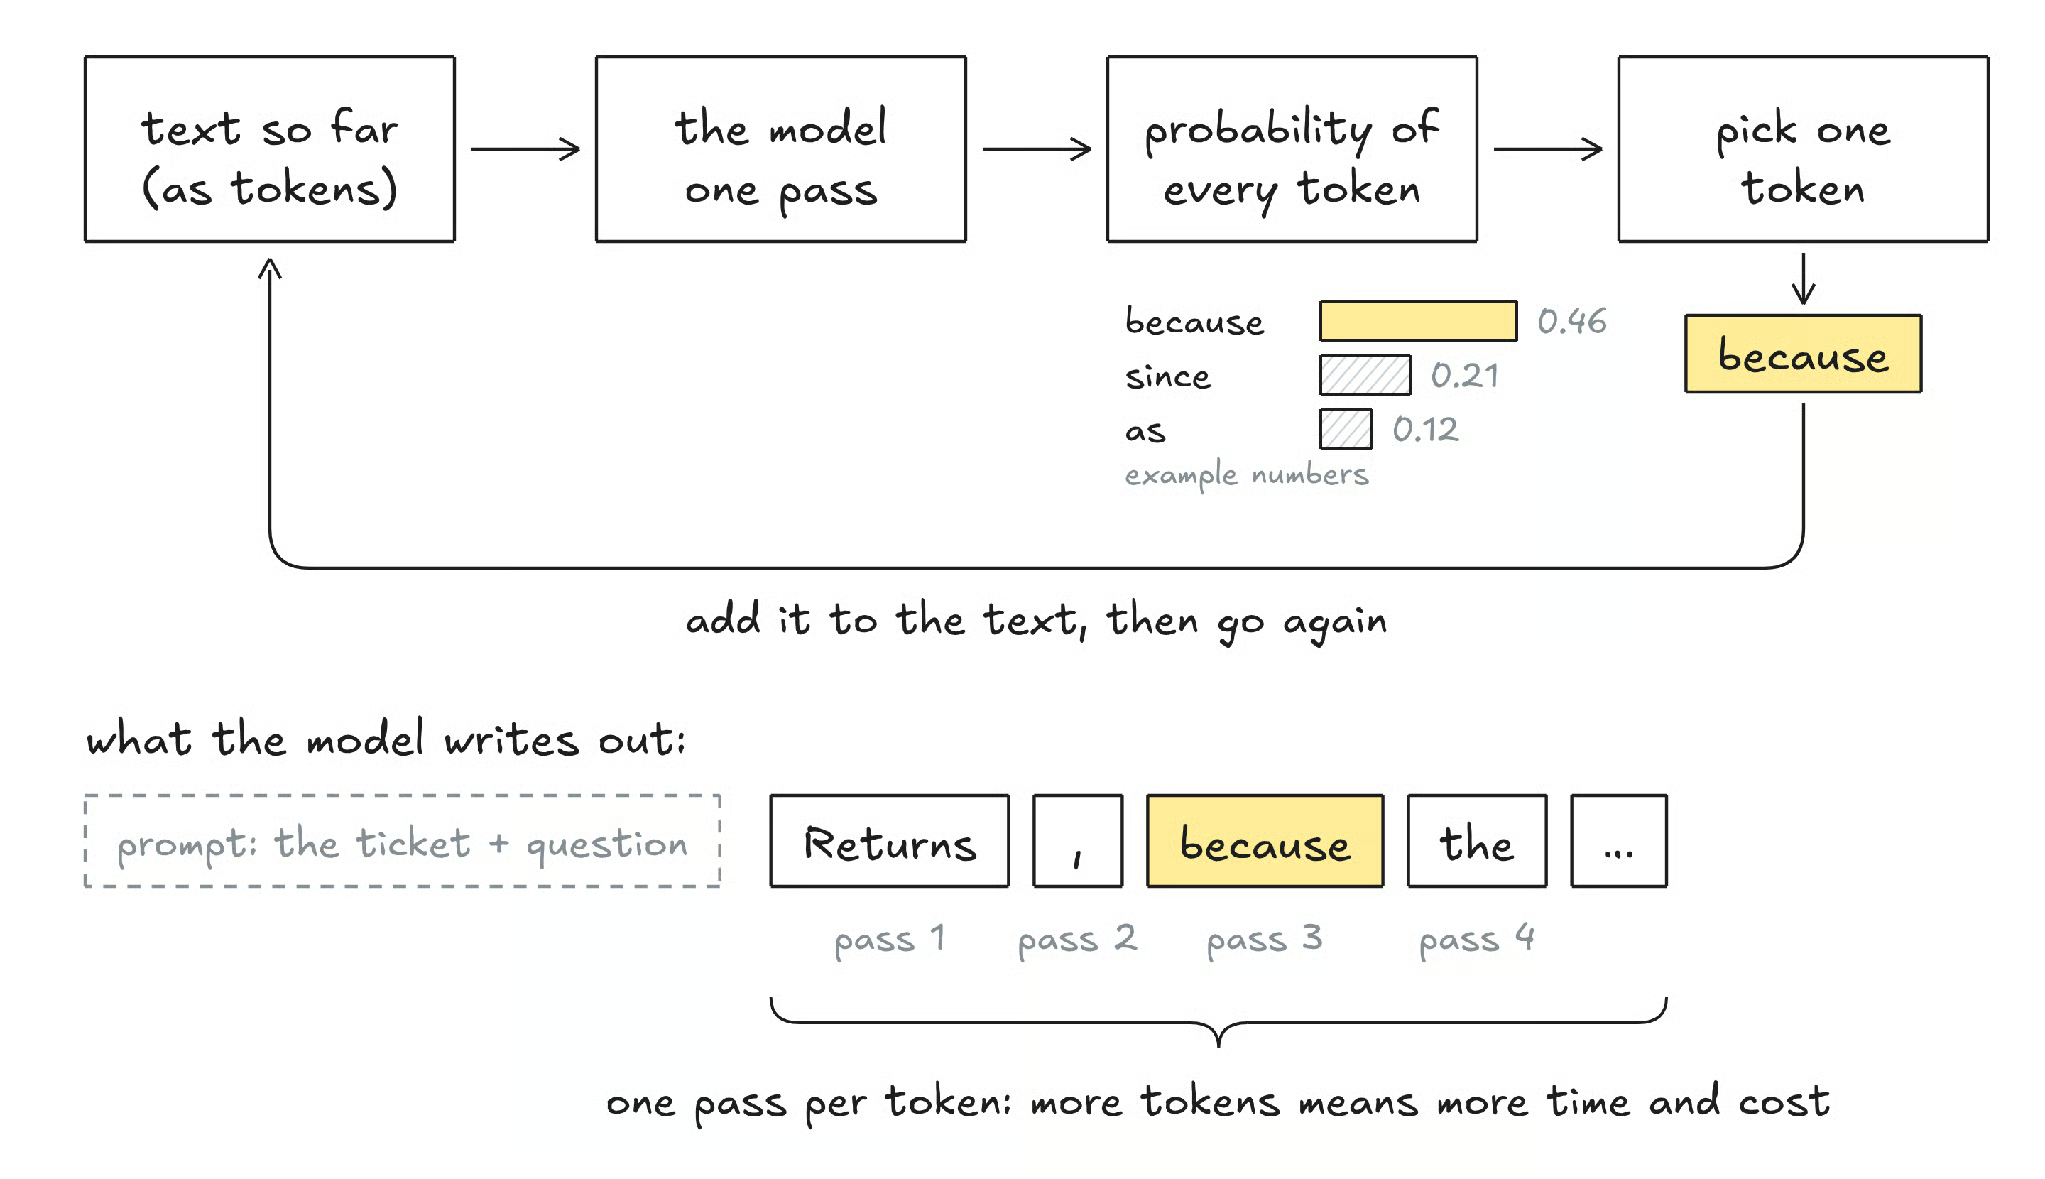
Рисунок 1. LLM нужен один прямой проход на каждый токен, который он пишет. Оригинальное изображение автора.
Этот цикл отлично подходит для писем, кода или объяснений, но для простых решений он вносит проблемы:
Модели решений пытаются исправить именно это.
Теперь к механике.
Есть три идеи, которые стоит понять:
Разберём каждую по очереди.
Модель решений читает ваш ввод и вопросы и вычисляет оценку для каждого допустимого ответа.
Эти оценки обычно превращаются в вероятности через функцию softmax. Как нетрудно заметить, длинного цикла нет — писать нечего.
В документации TypeSafe говорится, что вопросы в одном запросе обрабатываются параллельно, так что добавление вопросов почти не влияет на время ответа.
Отсюда и берётся основная скорость: TypeSafe сообщает, что Jev обычно отвечает за 70–500 мс.
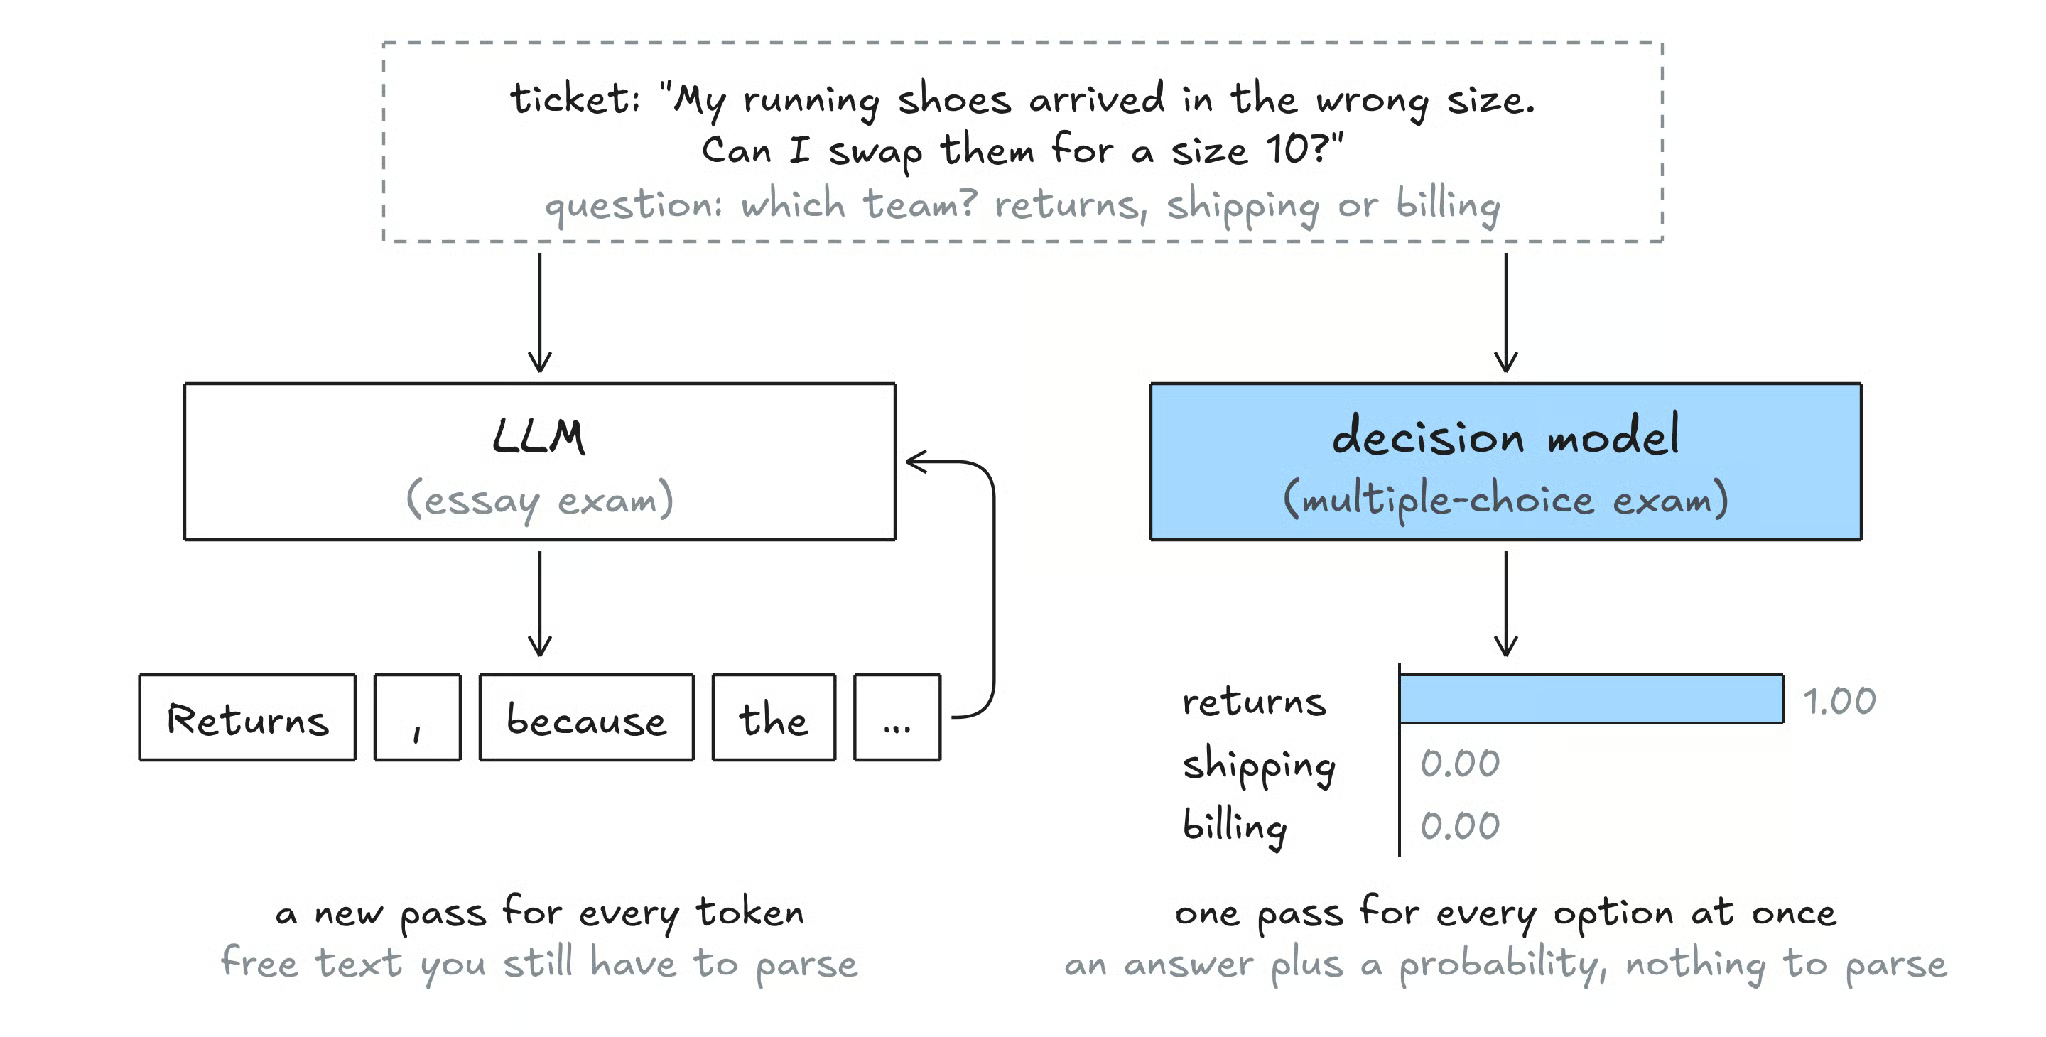
Рисунок 2. Один и тот же тикет, отвеченный LLM и моделью решений. Оригинальное изображение автора.
Единой «архитектуры модели решений» нет.
TypeSafe не раскрывает устройство Jev, но есть примерно три способа получить эти оценки:
Не слишком переживайте о том, где какой способ используется: все три приводят к одному — числу для каждого допустимого ответа.
Это, на мой взгляд, самый важный момент, поэтому приведу пример.
Представьте, что модель говорит «вероятность 70%» по 100 разным вопросам. Если модель хорошо откалибрована, примерно 70 из этих ответов окажутся правильными.
Калибровка важна, потому что калиброванные вероятности позволяют безопасно выставлять пороги в коде: «автоматически одобрять выше 90%, иначе отправлять человеку».
Если вероятности не соответствуют реальности, такие пороги бессмысленны.
Поставщики обучают модели с функциями потерь, наказывающими за излишнюю уверенность.
TypeSafe называет свой метод Reinforcement Learning for Calibrated Decisions (RLCD), а Cloudflare пишет, что для своих моделей Clef сочетает кросс-энтропию с Brier loss.
Возможно, вас удивит, но идея оценивать кандидаты вместо их генерации существует уже много лет.
На мой взгляд, модели решений — это последняя и самая удобная версия, а не изобретение с нуля. Вот основные семейства, на которых всё основывается.
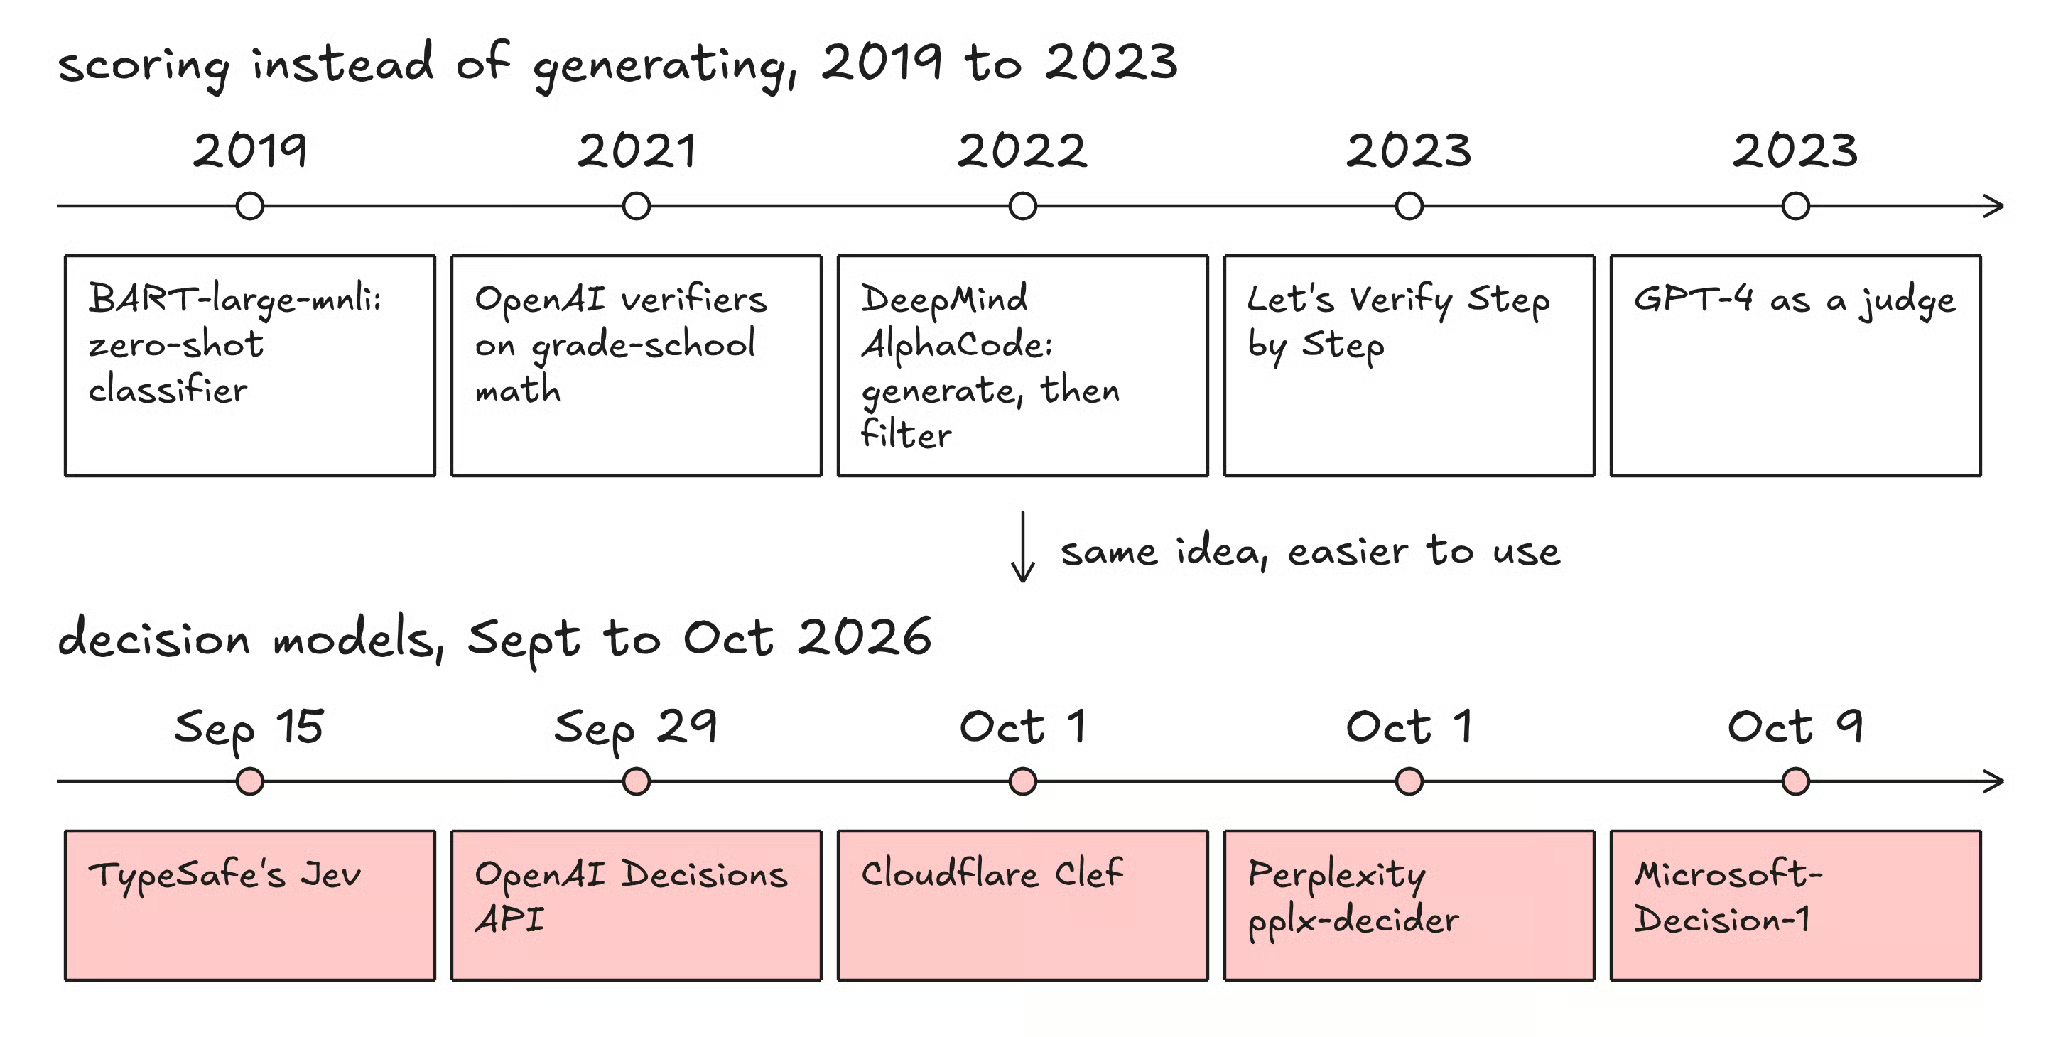
Рисунок 3. Подход «оценивать, а не генерировать» восходит к 2019 году; модели решений — версия 2026 года. Оригинальное изображение автора.
Ещё в 2019 году модели вроде BART-large-mnli умели раскладывать текст по меткам, на которых не обучались.
Они делали это, оценивая утверждения вида «этот текст про биллинг» для каждой возможной метки.
Команда по безопасности ИИ Red Hat предполагает, что модели решений по сути те же zero-shot классификаторы под новым именем.
Если вы строили RAG-систему, вы, возможно, использовали их. Сначала быстро извлекается короткий список (например, 50 документов), затем кросс-энкодер читает вопрос и каждый документ вместе и присваивает паре оценку релевантности.
Ничего не генерируется; документы просто переупорядочиваются по оценке.
Это скореры, оценивающие ответы, уже сгенерированные LLM.
В 2021 году исследователи OpenAI показали, что добавление верификатора к модели дало прирост в задачах начальной математики, примерно равный увеличению модели в 30 раз — что впечатляет.
Два года спустя статья «Let’s Verify Step by Step» показала, что оценка каждого шага рассуждения работает ещё лучше, чем оценка только финального ответа.
Простой вариант — сгенерировать много ответов, оценить каждый и оставить лучший. AlphaCode от DeepMind (2022) довёл это до крайности: генерировал до миллиона программ на задачу, отбрасывал ~99% с помощью тестов-примеров и отправлял только 10.
В симулированных оценках на прошедших контестах Codeforces он в среднем попадал в топ-54,3% участников-людей.
Предупреждение: если слишком давить на несовершенный скорер, качество со временем падает — генератор начинает эксплуатировать ошибки скорера.
Технический термин: reward overoptimization.
Это когда большой LLM оценивает выход другой модели.
Исследование 2023 года показало, что GPT-4 соглашался с людьми более чем в 80% случаев, но имел и предвзятости — например, предпочитал более длинные ответы или тот, что показан первым.
Модели решений частично подаются как более дешёвая и структурированная замена таким «судьям».
Энергетическая модель присваивает низкую «энергию» паре вход–ответ, если они хорошо согласуются, и высокую — если нет.
Выбор ответа тогда — просто поиск минимальной энергии, то есть снова оценивание кандидатов.
Ян ЛеКун много лет утверждает, что покадровая генерация токенов — не путь к настоящему интеллекту, а энергетические подходы и JEPA — более перспективное направление.
Теперь о реально вышедших моделях. Здесь всё меняется быстро, поэтому кратко.
TypeSafe AI — стартап из Сан-Франциско, основанный Дьогу Алмейдой, бывшим исследователем OpenAI. 15 сентября 2026 он вышел из «тени» с Jev и сид-раундом $40 млн во главе с DCVC.
Jev — это хостed API. В проде принимает только текст; изображения — экспериментально и требуют заголовка opt-in. Оплата взимается за входные токены, а выходы бесплатны — логично, когда выходом являются лишь несколько чисел.
14 октября вышел Jev 1.14, хотя алиас jev-latest по-прежнему указывает на 1.13.0 — версию, протестированную Red Hat далее в статье.
Запуск вызвал большой шум. Vercel сообщил, что около 13% платных команд опробовали Jev через AI Gateway в первые 24 часа, хотя доступ тогда был бесплатным.
OpenAI анонсировала Decisions API на DevDay 29 сентября 2026.
API работает с пользовательскими вопросами с фиксированными ответами и построен на GPT-6 Luna. 6 октября перешёл в публичную бету; также поддерживает изображения, тогда как у Jev это пока лишь эксперимент.
Cloudflare выпустила Clef и облегчённый Clef-flash 1 октября 2026 с открытыми весами и хостингом на Workers AI. Обе модели построены на Qwen и принимают запросы в стиле Jev, так что код под Jev можно перенаправить на Clef с минимумом правок.
| Model | Maker | Released (2026) | Access | Notable detail |
|---|---|---|---|---|
| pplx-decider | Perplexity | October 1 | Open weights and API | Самоотчёт: 85,71% против 84,51% у Jev на собственной панели из 11 бенчмарков Perplexity |
| Microsoft-Decision-1 | Microsoft | October 9 | Foundry preview | Послеобученная 9B-модель Qwen |
| Laya | Convai Innovations | September | Open weights | Небольшая (421 млн параметров), работает на CPU ноутбука; в карточке указано, что это база для специализации, а не zero-shot «движок» |
Что бросается в глаза: большинство открытых и «большетеховских» моделей — это дообученные обычные LLM. Исключение — Laya: это энкодер с «головой решений». Внутреннее устройство Jev не раскрыто.
На мой взгляд, это поддерживает идею, что настоящая новизна — в упаковке (интерфейс и обучение калибровке), а не в принципиально новой архитектуре.
Проще всего выбирать по сравнению:
| Feature | LLM | Decision model | Fine-tuned classifier | LLM + verifier |
|---|---|---|---|---|
| Output | Свободный текст | Типизированный ответ и вероятности | Фиксированные метки | Лучший из нескольких сгенерированных ответов |
| Needs labeled data | Нет | Нет | Да | Часто |
| Speed | Секунды | Десятки–сотни миллисекунд | Очень быстро | Самый медленный |
| Off-format answers | Возможны | Невозможны | Невозможны | Зависит от генератора |
| Explains its answer | Да | Нет | Нет | Да |
| Best for | Письмо, код, рассуждения | Маршрутизация, триаж, защитные рамки | Одна фиксированная массовая задача | Математика, код с тестами |
Грубое эмпирическое правило:
Лучшие системы, полагаю, смешивают всё перечисленное.
Модели решений можно использовать как быстрые «ворота» вокруг LLM. Ворота решают:
Так дорогой LLM запускается только тогда, когда действительно нужно что-то написать.
Это самая важная часть, потому что большинство громких цифр в сети — от самих вендоров. Даже TypeSafe признаёт, что их заголовочные выгоды по скорости и стоимости — это верхняя планка для реального применения.
В октябре 2026 команда по безопасности ИИ Red Hat сравнила девять конфигураций защитных механизмов по двум задачам: выявление инъекций подсказок и небезопасного контента.
DiffusionGemma — текст-диффузионная модель на базе Gemma, обслуживаемая через vLLM.
Самое интересное:
| Method | Type | Prompt injection accuracy | Content safety accuracy |
|---|---|---|---|
| deberta-v3-base | Fine-tuned classifier | 89.01% | - |
| granite-guardian-hap-125m | Fine-tuned classifier | - | 80.27% |
| Qwen3.6-35B | LLM-as-a-judge | 89.31% | 85.47% |
| DiffusionGemma | Decision model (open) | 87.72% | 85.53% |
| Jev | Decision model | 86.35% | 86.20% |
| Laya | Decision model (open) | 85.44% | 57.87% |
| BART-large-mnli | 2019 zero-shot classifier | 61.49% | 68.67% |
Jev занял первое место по безопасности контента, опередив DiffusionGemma на 0,67 п.п. (судья Qwen был третьим), а по инъекциям подсказок первым был судья Qwen.
Из-за такого разделения Red Hat и делает вывод, что в целом модели решений не показали выигрыша в качестве по сравнению с LLM-судьями.
Но самое примечательное: классификатор на ~200 млн параметров отстал всего на 0,3 п.п. по инъекциям подсказок, при медианной задержке менее 100 мс против примерно 348 мс у Jev.
Задержка Jev включала перелёт через Атлантику: тесты шли из Великобритании, а серверы TypeSafe — в США.
Этот «хоп» объясняет лишь разрыв с локальными CPU-моделями. Qwen, Nemotron и DiffusionGemma тоже работали на кластере в США, и Qwen всё равно был быстрее Jev.
Тем не менее Red Hat заключает: в их тестах модели решений не дали ответов быстрее, дешевле или лучше, чем LLM-as-a-judge, за исключением Laya, чья малость — реальное преимущество, если суметь обойти её ограничения с помощью промптов.
Научная работа университетских исследователей, размещённая на arXiv в сентябре 2026, проверила Jev на 44 «эллайнмент»-бенчмарках.
Результаты оказались любопытно смешанными:
На практике мысль про выборку по уверенности очень полезна.
Она показывает, что простая схема, где модель решений обрабатывает лёгкие случаи, а неопределённые передаёт LLM или человеку, — хорошая стратегия.
Теперь соберём свою модель решений.
Мы превратим небольшой открытый LLM в модель решений с помощью трюка с вероятностями токенов и проверим, можно ли доверять его вероятностям.
Сначала установим пакеты (всё можно запустить в бесплатном Colab):
pip install transformers torch datasets sentence-transformers numpyВозьмём Qwen2.5-0.5B-Instruct — достаточно мал, чтобы работать на CPU.
Идея проста: помечаем варианты буквами, один раз запускаем модель и смотрим только на вероятности этих букв как следующего токена.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Заметьте, мы ни разу не вызываем generate(). Мы делаем один прямой проход, берём оценки для «A», «B», «C» и т. д., остальное отбрасываем.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
И это действительно всё. Мы только что создали рабочую модель решений примерно в 30 строках.
Вопрос «да/нет» — это просто вопрос выбора с двумя вариантами.
Посмотрим, где начинает пробуксовывать простая версия.
Попробуйте перемешать порядок вариантов и запустите тот же вопрос снова:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
На «грязных» вводах вроде этого часто видно, как вероятности меняются только из-за перестановки вариантов.
Это называется предвзятость порядка, и TypeSafe честно указывает склонность к первому варианту среди известных слабостей Jev.
Вы также можете часто видеть почти 100%-ные ответы. Берриман провёл показательный тест на самом Jev: он сообщил, что монета выпадает орлом в 60% случаев, — вопрос «да/нет» дал 0,58, близко к правде.
Но вопрос выбора («орёл или решка?») вернул 0,99 для орла, потому что вероятность «схлопнулась» к более вероятному ответу.
Этот шаг стоит делать всем. Возьмём 400 новостных заметок из датасета AG News (заголовок плюс описание) с четырьмя темами и проверим, соответствуют ли наши вероятности реальности.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Далее нужен способ измерить калибровку. Ожидаемая ошибка калибровки (ECE) бьёт предсказания по бинам уверенности и смотрит, насколько средняя уверенность в каждом бине расходится с фактической точностью.
Ниже — чем лучше:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Теперь трюк.
Делим данные пополам, на первой половине подбираем температуру, чтобы сделать вероятности честнее, а затем проверяем на второй.
Температура выше 1 смягчает излишне уверенные предсказания, ниже 1 — заостряет недооценённые.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Точность не меняется, потому что деление на температуру не меняет порядок вариантов.
Меняется только уверенность.
Конкретные числа зависят от запуска, но ECE на тестовой половине обычно снижается. На 200 тестовых примерах оценка шумная, не переоценивайте малые отличия.
Вывод прост: калибровка модели на чужих данных не означает калибровку на ваших.
Чтобы показать, насколько распространён подход «оценивать, не генерировать», приведём пример в RAG-сценарии.
Кросс-энкодер оценивает каждый фрагмент относительно запроса — и мы просто сортируем:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Снова ничего не генерируется: модель выдаёт для каждого кандидата просто число.
Чаще всего встречаются такие случаи:
| Use case | How a decision model helps |
|---|---|
| Agent routing | Решает, какой инструмент или суб-агент должен выполнить следующий шаг. |
| Guardrails | Флагирует инъекции подсказок или небезопасный контент до попадания в LLM. |
| Support triage | Маршрутизирует тикеты по командам, темам и срочности. |
| Document intake | Отвечает на фиксированный чек-лист вопросов по каждому документу. |
| Search and RAG | Реранжирует извлечённые фрагменты по релевантности. |
| Credit and fraud | Оценивает риск, хотя решения о людях всё равно должны включать ручную проверку. |
| Robotics | Может служить быстрым слоем между медленным LLM-планировщиком и низкоуровневым управлением, хотя это пока спекуляция. |
Лично мне больше всего нравится пример с робототехникой.
Берриман предполагает, что модель вроде Jev может располагаться между медленным LLM, строящим планы, и кинематическими моделями, двигающими суставы робота.
Однако стоит помнить: в известном демо Doom от TypeSafe Jev подавали текстовую телеметрию, а не «сырые» изображения.
Модели решений полезны, но переоценивать их не стоит.
Главные ограничения, о которых важно помнить:
Модели решений берут старую идею оценивать кандидаты вместо генерации ответов и делают её гораздо удобнее.
Обучающие данные не нужны; вы получаете типизированные ответы, и можно задавать множество вопросов за раз.
На мой взгляд, именно упаковка — настоящая инновация.
Ожидаю, что модели решений будут располагаться вокруг LLM как быстрые и дешёвые «ворота», берущие на себя простые решения, чтобы дорогая модель запускалась только тогда, когда действительно надо что-то написать.
Лучшие курсы DataCamp
Трек
Трек
Практикуйтесь и следите за своим прогрессом.
Продолжить С Google