
Lộ trình
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleHãy hình dung bạn ngồi vào một nhà hàng và người phục vụ hỏi: “Nước lọc hay có ga?” Bạn sẽ không trả lời bằng một đoạn văn về sở thích uống nước của mình; bạn chọn một trong hai lựa chọn được đưa ra.
Bây giờ nghĩ về cách chúng ta dùng các mô hình ngôn ngữ lớn (LLM) trong hầu hết ứng dụng hiện nay. Ta hỏi những câu như “Vé hỗ trợ này thuộc về thanh toán, giao hàng, hay đổi trả?” và mô hình phản hồi lại một câu hoàn chỉnh, mà ta lại phải phân tích bằng mã. Thực tế chỉ có ba câu trả lời khả dĩ, nhưng ta vẫn phải trả tiền cho cả một quá trình suy luận.
Đây chính là khoảng trống mà kiểu mô hình mới đang cố lấp đầy. Tháng 9/2026, một startup tên TypeSafe AI ra mắt Jev, một mô hình không viết văn bản.
Thay vào đó, nó chấm điểm một tập câu trả lời cố định và cho biết mức độ khả dĩ của từng câu trả lời. Chỉ trong vài tuần, OpenAI, Cloudflare, Perplexity và Microsoft đều tung ra phiên bản của riêng mình, cho thấy lĩnh vực này phát triển nhanh thế nào.
Trong bài viết này, tôi muốn tìm hiểu các mô hình ra quyết định bằng AI là gì, chúng hoạt động ra sao, và ý tưởng này thực ra xuất phát từ đâu (cũ hơn nhiều so với làn sóng thổi phồng hiện nay). Tôi cũng sẽ xem các bài đo chuẩn độc lập cho kết quả thế nào.
if.Một mô hình ra quyết định là mô hình nhận đầu vào và một tập các câu trả lời cho phép rồi trả về xác suất cho từng câu trả lời, mà không sinh bất kỳ văn bản tự do nào.
Ý tưởng chính là đầu ra đã có cấu trúc sẵn.
Bạn không bao giờ phải phân tích một câu vì mô hình chỉ có thể trả về một trong các đáp án bạn đã cung cấp. Điều này có nghĩa kết quả có thể đưa thẳng vào một câu lệnh if trong mã.
Tôi thích hình dung sự khác biệt này như hai kiểu bài thi.
Một mô hình ngôn ngữ lớn làm bài luận, viết câu trả lời từng từ, trong khi mô hình ra quyết định làm bài trắc nghiệm và còn cho biết mức độ chắc chắn với từng ô (điểm tin cậy).
Jev và hầu hết các giải pháp thay thế Jev hỗ trợ ba loại câu hỏi:
TypeSafe còn có loại Box thử nghiệm để định vị trong ảnh, tôi sẽ bỏ qua ở đây.
Đây là một ví dụ từ tài liệu của chính TypeSafe.
Bạn có thể gửi một state (chính là đoạn văn bản bạn muốn mô hình xem xét) và một bản đồ questions. Với câu hỏi lựa chọn, mỗi phương án đi kèm mô tả ngắn trong trường criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Và đây là phản hồi tương ứng:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Không có văn bản nào để phân tích.
Bạn nhận được phương án đã chọn, xác suất cho mọi phương án, và một giá trị độ tin cậy suy ra từ xác suất cao nhất, nên phân phối càng phẳng thì độ tin cậy càng thấp. Trong tài liệu, một vé phức tạp hơn nhắc đến cả sai kích cỡ và bị tính tiền hai lần đã chia xác suất giữa returns (0,61) và billing (0,35), và độ tin cậy giảm còn 0,42.
TypeSafe mô tả Jev là “System One Model,” mượn từ cuốn Tư duy, Nhanh và Chậm của Daniel Kahneman. Vì sao vậy?
Nói đơn giản, Hệ thống 1 là phán đoán nhanh theo trực giác, còn Hệ thống 2 là lý luận chậm theo từng bước.
Một mô hình ra quyết định được thiết kế để là phần nhanh.
Một lưu ý: Hệ thống 1 cũng là phần bộ não dễ mắc lỗi nhanh, và phải công nhận TypeSafe thẳng thắn liệt kê trong tài liệu những nơi Jev mắc sai. Ta sẽ quay lại điểm này.
Một điều khiến tôi bối rối lúc đầu là “mô hình ra quyết định” vốn đã có nhiều nghĩa khác. Nó có thể chỉ:
Vì vậy, để rõ ràng, trong bài viết này, “mô hình ra quyết định” chỉ đề cập đến nhóm mô hình mới phát hành cuối 2026, chấm điểm câu trả lời có kiểu thay vì viết văn bản.
Trước khi vào cách mô hình ra quyết định hoạt động, sẽ hữu ích nếu xem một LLM bình thường tạo ra câu trả lời thế nào. Tôi tin điều này giúp bạn thấy khác biệt dễ hơn.
Một mô hình ngôn ngữ lớn hoạt động theo vòng lặp.
Nó biến văn bản thành token, dự đoán xác suất cho mọi token trong từ vựng, chọn một token, thêm vào văn bản, rồi lặp lại.
Mỗi token thêm vào câu trả lời là thêm một lần truyền xuôi qua mô hình.
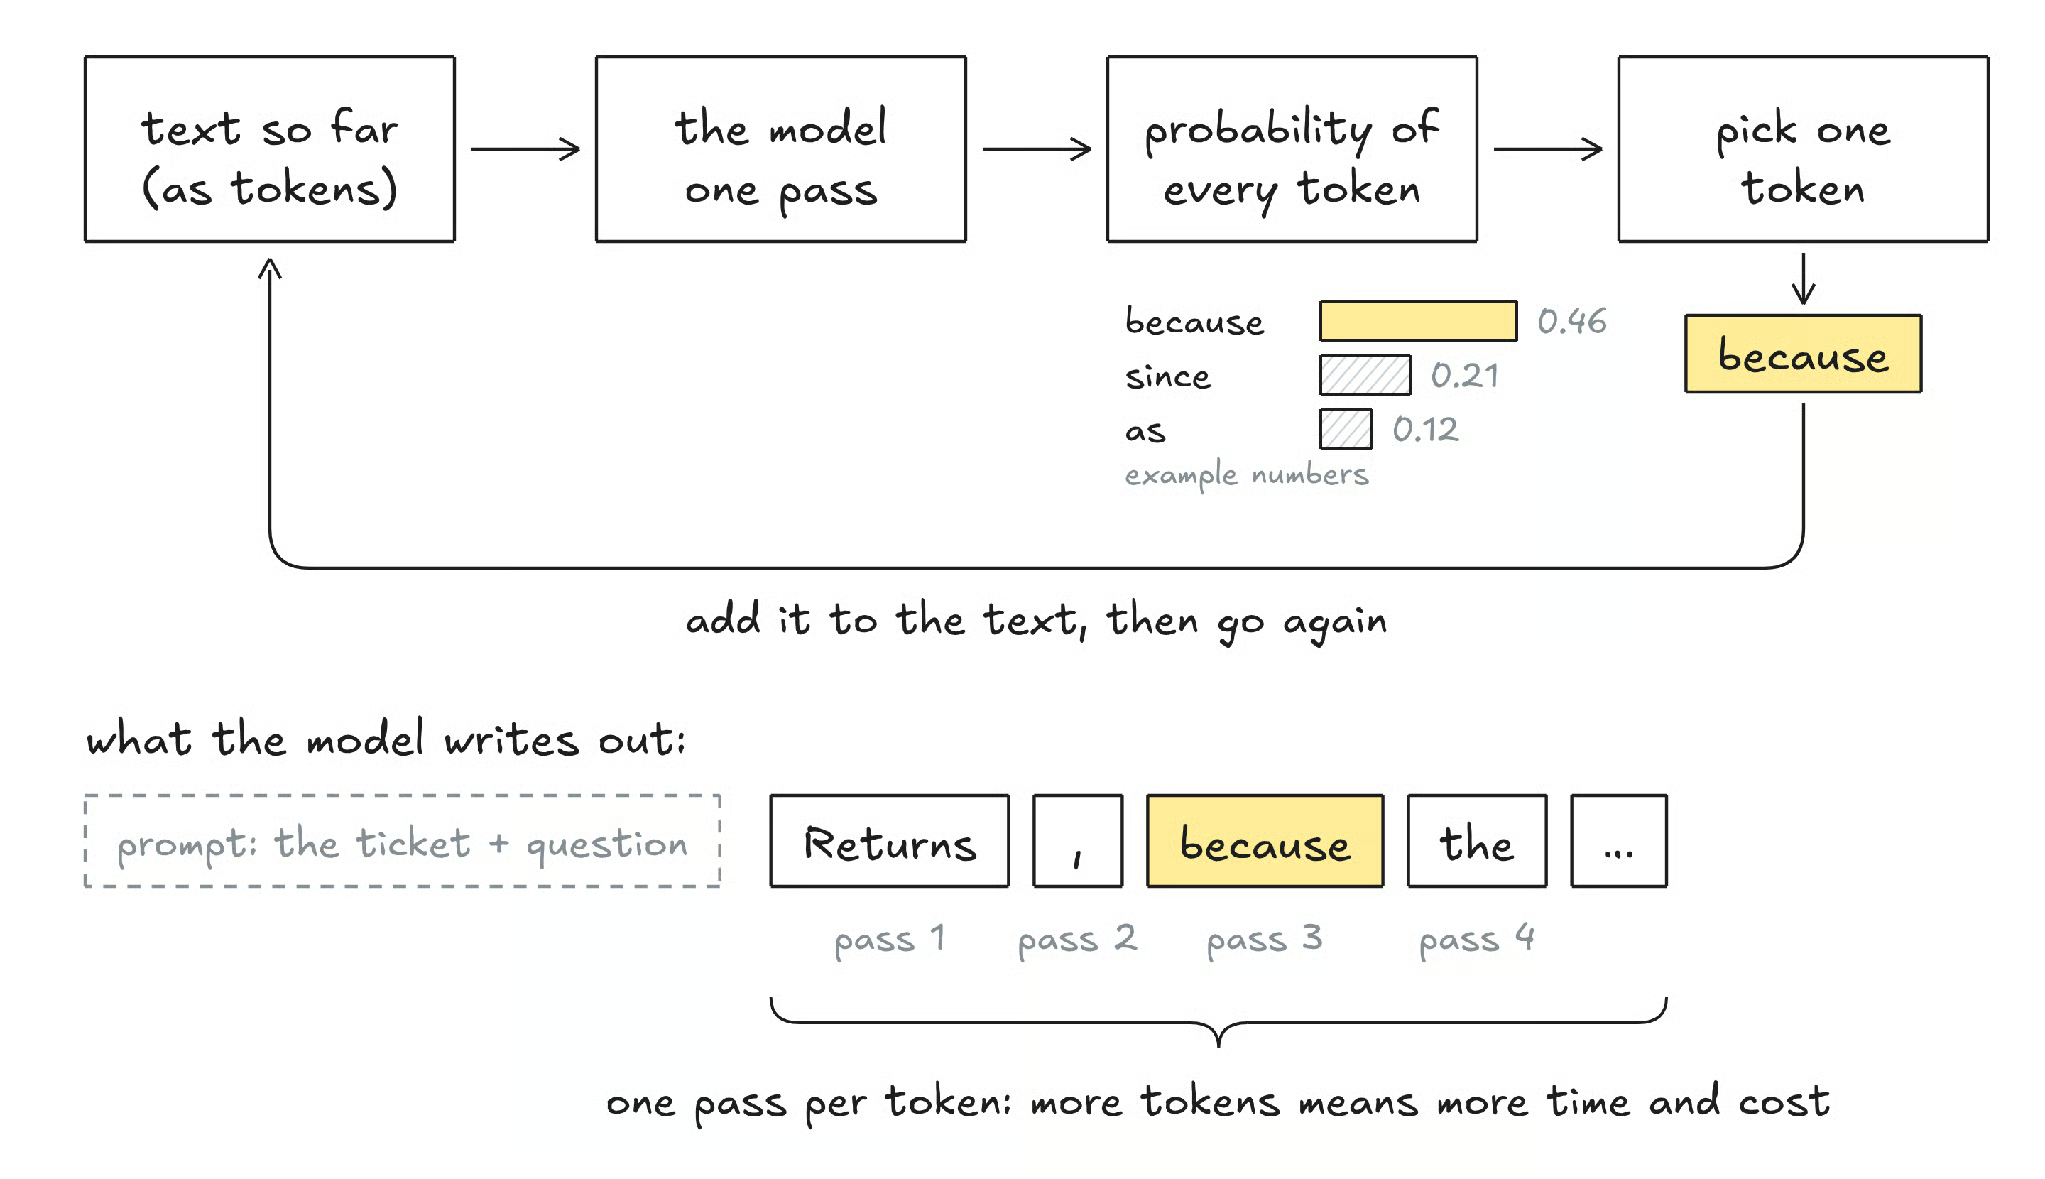
Hình 1: Một LLM cần một lần truyền xuôi cho mỗi token nó viết. Hình gốc do tác giả vẽ.
Vòng lặp này rất phù hợp để viết email, mã, hay giải thích, nhưng với các quyết định đơn giản, nó có thể gây vài vấn đề:
Mô hình ra quyết định đang cố giải đúng các vấn đề này.
Bây giờ đi vào cơ chế thực tế.
Có ba ý quan trọng cần hiểu:
Hãy xem từng ý một chút chi tiết.
Một mô hình ra quyết định đọc đầu vào và câu hỏi rồi tạo điểm cho từng câu trả lời cho phép.
Những điểm này thường được chuyển thành xác suất bằng hàm softmax. Bạn có thể thấy ngay là không có vòng lặp dài vì không có gì để viết.
Tài liệu của TypeSafe cũng nói các câu hỏi trong cùng một yêu cầu được đánh giá song song, nên thêm câu hỏi hầu như không làm thay đổi thời gian phản hồi.
Đây là nguồn gốc phần lớn tốc độ, và TypeSafe cho biết Jev thường phản hồi khoảng 70 đến 500 mili-giây.
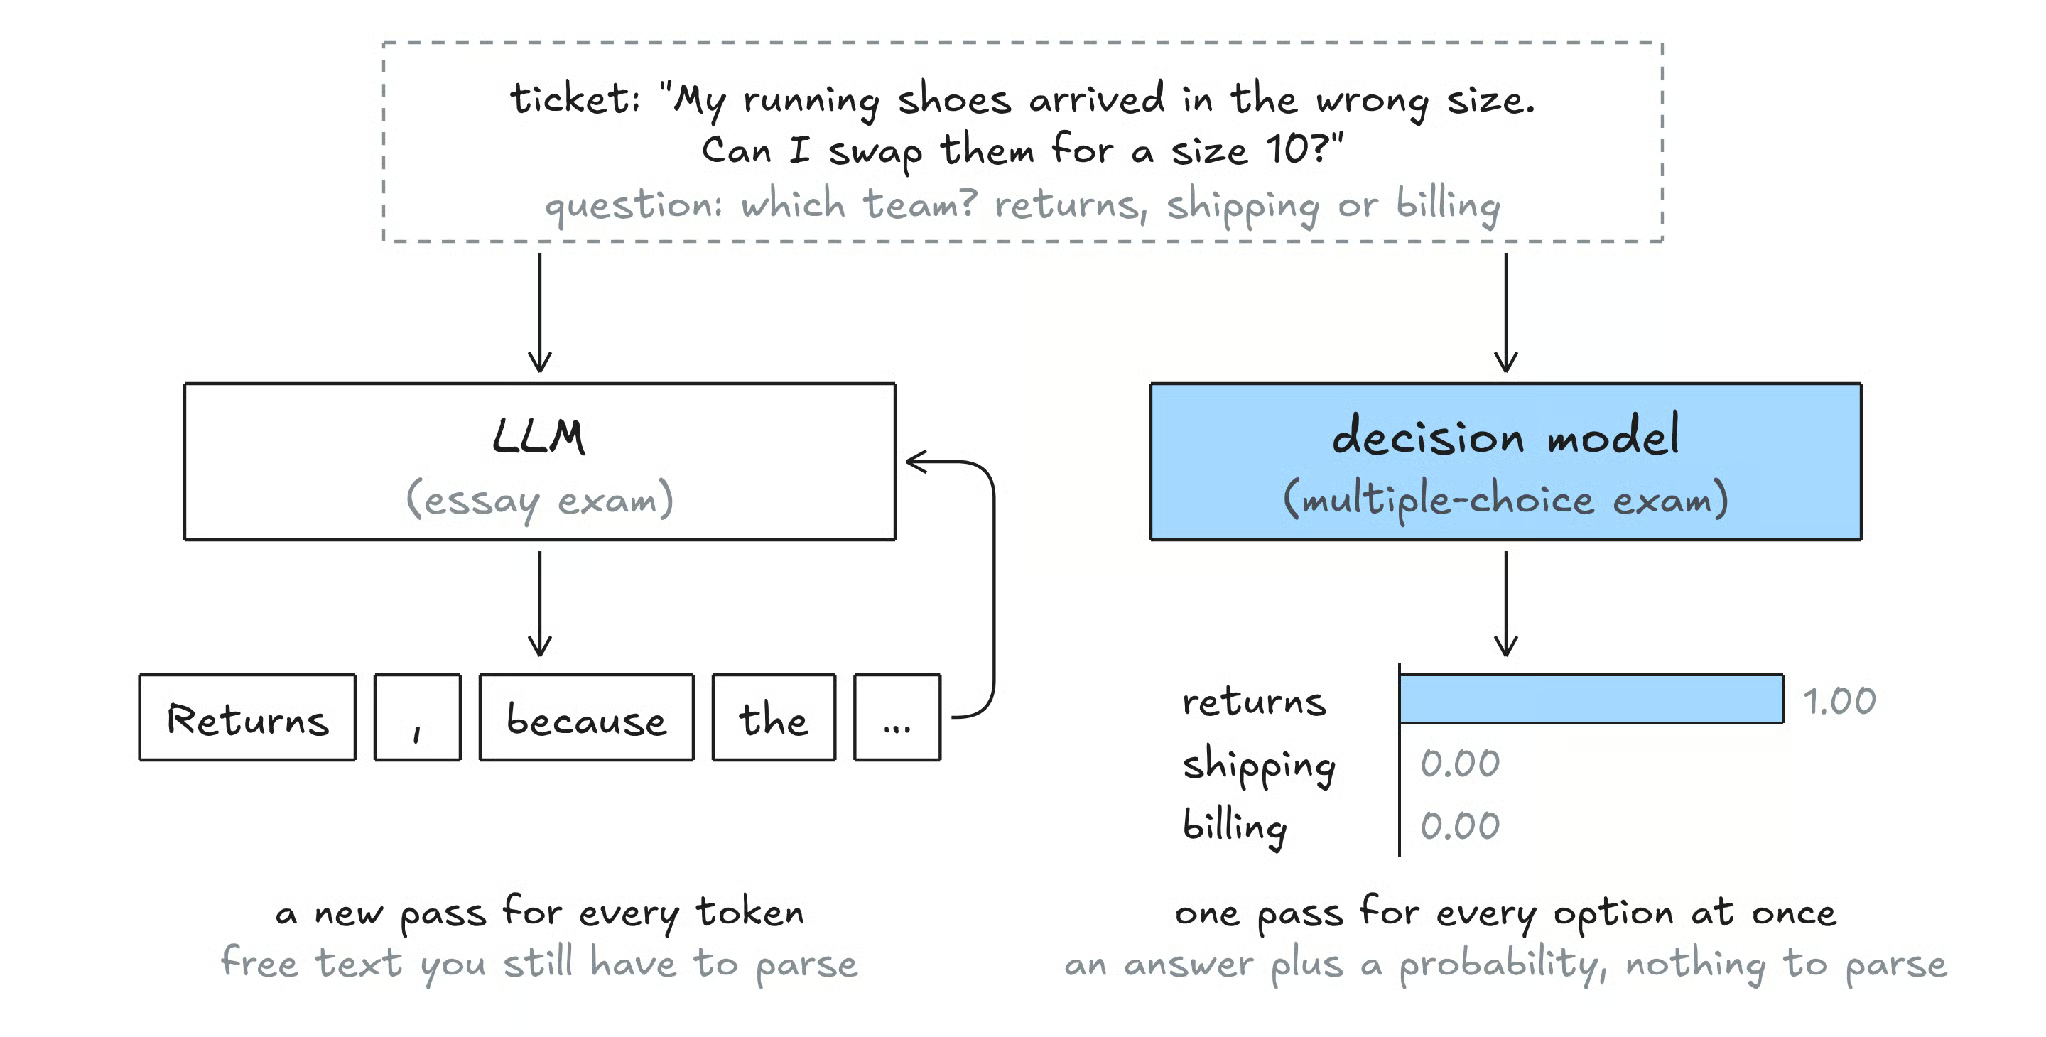
Hình 2: Cùng một vé hỗ trợ, trả lời bởi LLM và mô hình ra quyết định. Hình gốc do tác giả vẽ.
Không có một “kiến trúc mô hình ra quyết định” duy nhất.
TypeSafe chưa công bố cách Jev hoạt động, nhưng có khoảng ba cách để có được các điểm số này:
Đừng quá bận tâm mô hình nào dùng cách nào: cả ba đều kết thúc ở cùng nơi, một con số cho mỗi câu trả lời cho phép.
Đây là phần tôi cho là quan trọng nhất, nên xin ví dụ.
Hãy tưởng tượng một mô hình nói “khả năng 70%” trên 100 câu hỏi khác nhau. Nếu mô hình được hiệu chỉnh tốt, khoảng 70 câu trong đó sẽ đúng.
Hiệu chỉnh quan trọng vì các xác suất đã hiệu chỉnh cho phép ta đặt ngưỡng an toàn trong mã, như “tự động chấp thuận trên 90%, còn lại chuyển cho con người.”
Nếu xác suất không khớp thực tế, các ngưỡng đó vô nghĩa.
Các nhà cung cấp huấn luyện bằng hàm mất mát trừng phạt sự quá tự tin.
TypeSafe gọi phương pháp của họ là Reinforcement Learning for Calibrated Decisions (RLCD), trong khi Cloudflare nói họ kết hợp cross-entropy với Brier loss cho các mô hình Clef.
Có thể bạn sẽ ngạc nhiên, nhưng ý tưởng chấm điểm ứng viên thay vì sinh chúng đã tồn tại nhiều năm.
Theo quan điểm của tôi, mô hình ra quyết định là phiên bản mới nhất và thuận tiện nhất, không phải phát minh hoàn toàn mới. Dưới đây là các họ mô hình chính mà nó dựa vào.
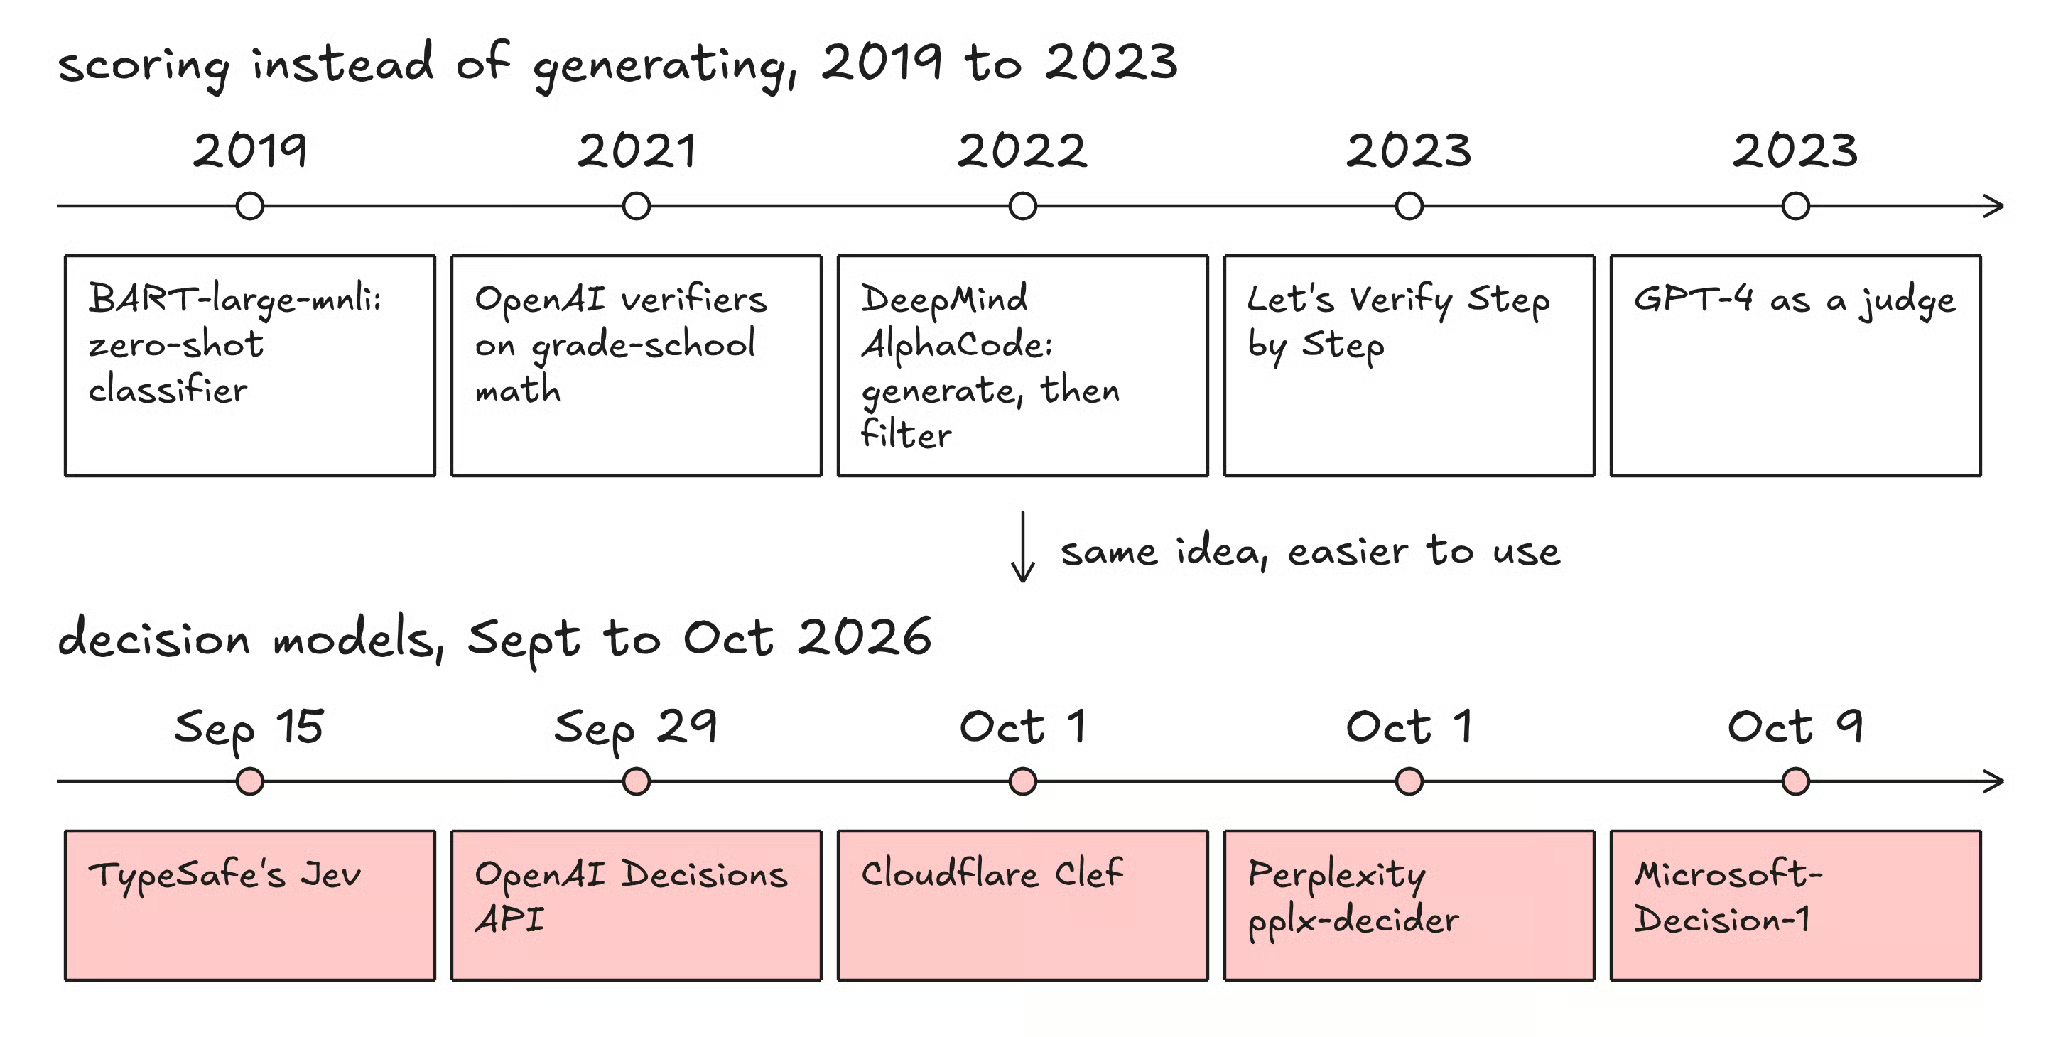
Hình 3: Chấm điểm thay vì sinh bắt đầu từ 2019, và mô hình ra quyết định là phiên bản 2026. Hình gốc do tác giả vẽ.
Từ 2019, các mô hình như BART-large-mnli đã có thể phân loại văn bản vào các nhãn mà chúng chưa từng được huấn luyện.
Chúng làm điều này bằng cách chấm điểm các mệnh đề như “văn bản này nói về thanh toán” cho mỗi nhãn khả dĩ.
Nhóm an toàn AI của Red Hat gợi ý rằng mô hình ra quyết định về bản chất chỉ là các bộ phân loại zero-shot dưới tên gọi mới.
Nếu bạn từng xây một hệ thống RAG, bạn có thể đã dùng một trong số này. Đầu tiên truy xuất nhanh một danh sách rút gọn (ví dụ 50 tài liệu), rồi cross-encoder đọc câu hỏi và từng tài liệu cùng nhau và gán điểm liên quan cho mỗi cặp.
Không có gì được sinh ra; các tài liệu chỉ được sắp lại theo điểm.
Đây là các bộ chấm điểm đánh giá câu trả lời mà một LLM đã sinh.
Năm 2021, các nhà nghiên cứu OpenAI cho thấy thêm một verifier vào mô hình giúp cải thiện bài toán toán tiểu học tương đương việc tăng kích thước mô hình lên 30 lần, điều mà tôi thấy ấn tượng.
Hai năm sau, bài “Hãy kiểm chứng từng bước” cho thấy chấm điểm từng bước suy luận còn hiệu quả hơn chỉ chấm câu trả lời cuối.
Phiên bản đơn giản là sinh nhiều câu trả lời, chấm điểm từng cái, và giữ cái tốt nhất. AlphaCode của DeepMind (2022) đẩy điều này đến cực hạn khi sinh tới một triệu chương trình mỗi bài, loại bỏ khoảng 99% bằng bài test ví dụ, rồi chỉ nộp 10.
Trong đánh giá mô phỏng trên các kỳ Codeforces trước đây, nó xếp trung bình trong top 54,3% thí sinh.
Một cảnh báo: nếu bạn ép quá mạnh lên một bộ chấm điểm chưa hoàn hảo, chất lượng cuối cùng sẽ giảm vì bộ sinh sẽ khai thác lỗi của bộ chấm.
Thuật ngữ kỹ thuật cho hiện tượng này là tối ưu hóa quá mức phần thưởng.
Đây là khi một LLM lớn chấm điểm đầu ra của mô hình khác.
Một nghiên cứu năm 2023 cho thấy GPT-4 đồng ý với giám khảo con người trên 80% thời gian nhưng cũng có thiên lệch, như ưu tiên câu trả lời dài hơn hoặc câu được hiển thị trước.
Mô hình ra quyết định phần nào được bán như một thay thế rẻ hơn, có cấu trúc hơn cho các “giám khảo” này.
Một mô hình dựa trên năng lượng cho điểm “năng lượng” thấp cho cặp đầu vào–câu trả lời khớp nhau tốt và điểm cao cho cặp không khớp.
Chọn câu trả lời đồng nghĩa tìm năng lượng thấp nhất, tức lại là chấm điểm ứng viên.
Yann LeCun nhiều năm qua lập luận rằng sinh từng token không phải con đường đến trí tuệ thực sự, và các hướng tiếp cận dựa trên năng lượng và JEPA là hướng tốt hơn.
Bây giờ tôi muốn nói về những mô hình đã thực sự phát hành. Nhịp độ ở đây rất nhanh, nên tôi sẽ tóm lược từng cái.
TypeSafe AI là một startup ở San Francisco do Diogo Almeida, cựu nhà nghiên cứu OpenAI, sáng lập, ra mắt ngày 15/9/2026 với Jev và vòng hạt giống 40 triệu đô do DCVC dẫn dắt.
Jev là API được lưu trữ. Trong sản xuất nó chỉ nhận văn bản; đầu vào hình ảnh là thử nghiệm và cần header opt-in. Giá tính theo token đầu vào, và đầu ra miễn phí, hợp lý khi đầu ra chỉ là vài con số.
Jev 1.14 ra mắt ngày 14/10, dù bí danh jev-latest vẫn trỏ về 1.13.0, phiên bản Red Hat kiểm thử sau này trong bài.
Đợt ra mắt gây nhiều chú ý. Vercel nói khoảng 13% đội trả phí của họ đã thử Jev qua AI Gateway trong 24 giờ đầu, dù khi đó nó miễn phí trên gateway.
OpenAI công bố Decisions API tại DevDay ngày 29/9/2026.
Nó làm việc với các câu hỏi do người dùng định nghĩa có tập câu trả lời cố định và xây dựng trên GPT-6 Luna. Dịch chuyển sang public beta ngày 6/10, và cũng nhận ảnh, điều mà Jev chỉ hỗ trợ thử nghiệm.
Cloudflare phát hành Clef và bản nhỏ hơn Clef-flash ngày 1/10/2026, với trọng số mở và lưu trữ trên Workers AI. Cả hai xây dựng trên các mô hình Qwen và chấp nhận yêu cầu kiểu Jev, nên mã viết cho Jev có thể trỏ sang Clef với rất ít thay đổi.
| Mô hình | Nhà phát triển | Phát hành (2026) | Truy cập | Chi tiết đáng chú ý |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 tháng 10 | Trọng số mở và API | Tự báo cáo 85,71% so với 84,51% của Jev trên bộ 11 chuẩn của chính Perplexity |
| Microsoft-Decision-1 | Microsoft | 9 tháng 10 | Foundry preview | Mô hình Qwen 9B hậu huấn luyện |
| Laya | Convai Innovations | Tháng 9 | Trọng số mở | Nhỏ (421M tham số), chạy trên CPU laptop; thẻ mô hình mô tả là nền tảng để chuyên biệt hóa, không phải động cơ zero-shot |
Điều khiến tôi chú ý khi tổng hợp phần này là phần lớn mô hình mở và của các hãng lớn ở đây là các LLM bình thường được fine-tune. Laya là ngoại lệ: nó là encoder với đầu quyết định. Nội tình của Jev chưa công bố.
Theo tôi, điều này củng cố quan điểm rằng đổi mới thực sự nằm ở cách đóng gói (tức giao diện và huấn luyện để hiệu chỉnh) hơn là kiến trúc hoàn toàn mới.
Cách rõ ràng nhất để quyết định dùng cái nào là so sánh:
| Tính năng | LLM | Mô hình ra quyết định | Bộ phân loại fine-tune | LLM + verifier |
|---|---|---|---|---|
| Đầu ra | Văn bản tự do | Câu trả lời có kiểu và xác suất | Nhãn cố định | Phương án tốt nhất trong nhiều câu trả lời sinh ra |
| Cần dữ liệu gán nhãn | Không | Không | Có | Thường có |
| Tốc độ | Vài giây | Vài chục đến vài trăm mili-giây | Rất nhanh | Chậm nhất |
| Trả lời sai định dạng | Có thể | Không thể | Không thể | Phụ thuộc bộ sinh |
| Giải thích câu trả lời | Có | Không | Không | Có |
| Phù hợp nhất cho | Viết, mã, suy luận | Định tuyến, phân loại sơ bộ, guardrail | Một tác vụ cố định khối lượng lớn | Toán, mã có kiểm thử |
Quy tắc ngón tay cái của tôi là:
Tôi tin rằng hệ thống tốt nhất sẽ kết hợp tất cả các loại này.
Tôi có thể hình dung mô hình ra quyết định đóng vai “cổng” nhanh quanh một LLM. Một cổng sẽ quyết định:
Như vậy, LLM đắt tiền chỉ chạy khi thực sự cần phải viết ra thứ gì đó.
Phần này quan trọng nhất, vì hầu hết con số hoành tráng bạn thấy trực tuyến là do nhà cung cấp đưa ra. Ngay cả TypeSafe cũng thừa nhận các con số tốc độ và chi phí tiêu đề của họ là ở mức cao so với thực tế sử dụng.
Tháng 10/2026, nhóm an toàn AI của Red Hat so sánh chín cấu hình guardrail trên hai tác vụ: phát hiện prompt injection và phát hiện nội dung không an toàn.
DiffusionGemma là mô hình khuếch tán văn bản Gemma phục vụ qua vLLM.
Đây là kết quả đáng chú ý nhất:
| Phương pháp | Loại | Độ chính xác prompt injection | Độ chính xác an toàn nội dung |
|---|---|---|---|
| deberta-v3-base | Bộ phân loại fine-tune | 89,01% | - |
| granite-guardian-hap-125m | Bộ phân loại fine-tune | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Mô hình ra quyết định (mở) | 87,72% | 85,53% |
| Jev | Mô hình ra quyết định | 86,35% | 86,20% |
| Laya | Mô hình ra quyết định (mở) | 85,44% | 57,87% |
| BART-large-mnli | Bộ phân loại zero-shot 2019 | 61,49% | 68,67% |
Jev đứng đầu ở an toàn nội dung, hơn DiffusionGemma 0,67 điểm phần trăm (giám khảo Qwen đứng thứ ba), và giám khảo Qwen đứng đầu ở prompt injection.
Sự chia rẽ này là lý do Red Hat vẫn có thể nói mô hình ra quyết định không cho thấy cải thiện chất lượng tổng thể so với LLM-as-a-judge.
Nhưng điều tôi thấy thú vị nhất là một bộ phân loại 200 triệu tham số chỉ kém 0,3 điểm phần trăm ở prompt injection, với độ trễ trung vị dưới 100 mili-giây so với khoảng 348 của Jev.
Độ trễ của Jev có bao gồm chuyến đi xuyên Đại Tây Dương, vì kiểm thử chạy từ Anh còn máy chủ TypeSafe ở Mỹ.
Chặng đó chỉ giải thích khoảng cách với các mô hình chạy cục bộ trên CPU. Qwen, Nemotron và DiffusionGemma cũng chạy trên cụm ở Mỹ, và Qwen vẫn nhanh hơn Jev.
Dù vậy, Red Hat kết luận mô hình ra quyết định không cho câu trả lời nhanh hơn, rẻ hơn hoặc tốt hơn so với LLM-as-a-judge trong các bài test của họ, ngoại trừ Laya, có lợi thế thực sự nhờ kích thước nhỏ nếu bạn có thể prompt để vượt qua giới hạn.
Một bài nghiên cứu từ các nhà nghiên cứu đại học, đăng lên arXiv tháng 9/2026, kiểm thử Jev trên 44 chuẩn căn chỉnh (alignment).
Kết quả pha trộn theo cách thú vị:
Tôi nghĩ điểm dự đoán có chọn lọc này rất hữu ích trong thực tế.
Nó cho thấy thiết kế đơn giản, nơi mô hình ra quyết định xử lý các trường hợp dễ và chuyển các trường hợp không chắc cho LLM hoặc con người, là chiến lược tốt.
Giờ hãy tự xây một mô hình ra quyết định.
Chúng ta sẽ biến một LLM nguồn mở nhỏ thành mô hình ra quyết định bằng mẹo xác suất token ở trên rồi kiểm tra xem ta có thể thực sự tin vào các xác suất đó không.
Trước tiên, cài các gói bằng lệnh này (tất cả có thể chạy trên Colab miễn phí):
pip install transformers torch datasets sentence-transformers numpyTa sẽ dùng Qwen2.5-0.5B-Instruct, đủ nhỏ để chạy trên CPU.
Ý tưởng đơn giản: gán nhãn các phương án bằng chữ cái, chạy mô hình một lần, và chỉ nhìn xác suất của các chữ cái đó làm token tiếp theo.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Lưu ý rằng ta không bao giờ gọi generate(). Ta làm một lần truyền xuôi, giữ lại điểm cho “A”, “B”, “C”… rồi bỏ phần còn lại.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Và thực sự chỉ vậy. Ta vừa tạo một mô hình ra quyết định hoạt động trong khoảng 30 dòng mã.
Một câu hỏi có/không thực chất là câu hỏi lựa chọn với hai phương án.
Giờ hãy xem phiên bản đơn giản này bắt đầu gặp khó ở đâu.
Hãy thử xáo trộn thứ tự các phương án và chạy lại cùng câu hỏi:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Với đầu vào rối như thế này, ta thường sẽ thấy các xác suất thay đổi chỉ vì hoán đổi thứ tự phương án.
Đây gọi là thiên lệch theo thứ tự, và TypeSafe thực tế liệt kê xu hướng nghiêng về phương án đầu tiên như một điểm yếu đã biết của chính Jev.
Bạn cũng có thể thấy mô hình trả lời gần 100% khá thường xuyên. Berryman chạy một thử nghiệm hay trên chính Jev: nói rằng một đồng xu rơi ngửa 60% thời gian, câu hỏi có/không trả về 0,58, khá sát.
Nhưng câu hỏi lựa chọn (“ngửa hay sấp?”) trả về 0,99 cho ngửa, vì xác suất dồn về phương án có khả năng hơn.
Đây là bước tôi nghĩ ai cũng nên chạy. Ta sẽ lấy 400 bản tin từ tập AG News (mỗi mẫu gồm tiêu đề và mô tả ngắn), có bốn chủ đề, và kiểm tra xem xác suất của ta có khớp thực tế không.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Tiếp theo, ta cần cách đo hiệu chỉnh. Lỗi hiệu chỉnh kỳ vọng (ECE) gom dự đoán vào các “thùng” theo độ tin cậy và kiểm tra độ chênh giữa độ tin cậy trung bình và độ chính xác thực tế ở mỗi thùng.
Rõ ràng, càng thấp càng tốt:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Và đây là “mẹo”.
Ta chia dữ liệu làm đôi, dùng nửa đầu để tìm một nhiệt độ giúp xác suất trung thực hơn, rồi kiểm thử trên nửa sau.
Nhiệt độ trên 1 làm dịu các dự đoán quá tự tin, trong khi dưới 1 làm sắc các dự đoán thiếu tự tin.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Độ chính xác không đổi, vì chia cho nhiệt độ không thay đổi hạng của phương án đứng nhất.
Chỉ độ tin cậy thay đổi.
Số cụ thể tùy lần chạy, nhưng ECE trên nửa kiểm thử thường sẽ giảm. Với chỉ 200 mẫu kiểm thử, ước lượng nhiễu, nên đừng quá coi trọng chênh lệch nhỏ.
Bài học đơn giản: một mô hình được hiệu chỉnh trên dữ liệu của người khác không có nghĩa là được hiệu chỉnh trên dữ liệu của bạn.
Để cho thấy “chấm điểm, không sinh” phổ biến thế nào, đây là cùng ý tưởng trong bối cảnh RAG.
Một cross-encoder chấm điểm mỗi đoạn so với câu hỏi và ta chỉ việc sắp xếp:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Một lần nữa, không có gì được sinh ra: mô hình chỉ cho mỗi ứng viên một con số.
Đây là các trường hợp dùng phổ biến nhất:
| Trường hợp sử dụng | Mô hình ra quyết định giúp thế nào |
|---|---|
| Định tuyến tác tử | Quyết định công cụ hay tiểu tác tử nào xử lý bước tiếp theo. |
| Guardrail | Gắn cờ prompt injection hoặc nội dung không an toàn trước khi vào LLM. |
| Phân loại vé hỗ trợ | Định tuyến theo nhóm, chủ đề, và mức độ khẩn. |
| Tiếp nhận tài liệu | Trả lời một danh sách câu hỏi cố định về mỗi tài liệu. |
| Tìm kiếm và RAG | Rerank các đoạn truy xuất theo mức độ liên quan. |
| Tín dụng và gian lận | Chấm điểm rủi ro, dù quyết định liên quan con người vẫn nên có xem xét của con người. |
| Robot | Có thể làm lớp nhanh giữa LLM lập kế hoạch chậm và điều khiển động học mức thấp, dù còn mang tính suy đoán. |
Điểm về robot là điều cá nhân tôi thích nhất.
Berryman gợi ý một mô hình như Jev có thể nằm giữa một LLM chậm lập kế hoạch cấp cao và các mô hình động học điều khiển khớp robot.
Cũng nên biết rằng bản demo Doom nổi tiếng của TypeSafe cung cấp cho Jev dữ liệu đo đạc dạng văn bản chứ không phải ảnh thô.
Mô hình ra quyết định hữu ích, nhưng tôi không muốn “thần thánh hóa” chúng.
Dưới đây là các hạn chế chính cần lưu ý:
Mô hình ra quyết định bằng AI lấy một ý tưởng rất cũ là chấm điểm ứng viên thay vì sinh câu trả lời, và làm cho nó dễ dùng hơn nhiều.
Bạn không cần dữ liệu huấn luyện; bạn nhận lại câu trả lời có kiểu, và có thể hỏi nhiều câu một lúc.
Theo tôi, cách đóng gói này mới là đổi mới thực sự.
Tôi kỳ vọng mô hình ra quyết định sẽ nằm xung quanh LLM như những cổng nhanh, rẻ xử lý quyết định đơn giản, để mô hình đắt tiền chỉ chạy khi thực sự cần viết ra nội dung.
Các khóa học hàng đầu trên DataCamp
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
