
Programa
Associate AI Engineer para desenvolvedores
26 h
Pratique e programa seu progresso.
Continuar Com O GoogleImagine que você senta em um restaurante e o garçom pergunta: “Com ou sem gás?”. Você não responde com um parágrafo sobre suas preferências de hidratação; você escolhe uma das duas opções oferecidas.
Agora pense em como usamos grandes modelos de linguagem (LLMs) na maioria dos apps hoje. Fazemos perguntas como “Este chamado de suporte é sobre cobrança, envio ou devoluções?” e o modelo nos devolve uma frase completa, que a gente ainda precisa interpretar com código. Na prática, só havia três respostas possíveis, mas pagamos por todo um raciocínio mesmo assim.
É essa a lacuna que esse novo tipo de modelo quer preencher. Em setembro de 2026, uma startup chamada TypeSafe AI lançou o Jev, um modelo que não escreve texto.
Em vez disso, ele atribui pontuações a um conjunto fixo de respostas e informa a probabilidade de cada uma. Em poucas semanas, OpenAI, Cloudflare, Perplexity e Microsoft liberaram suas próprias versões, mostrando o ritmo acelerado desse campo.
Neste artigo, quero explorar o que são esses modelos de decisão em IA, como funcionam e de onde veio a ideia (ela é bem mais antiga do que o hype sugere). Também vou comentar o que mostraram benchmarks independentes.
if no seu código.Um modelo de decisão em IA é um modelo que recebe um input e um conjunto de respostas permitidas e retorna a probabilidade de cada resposta, sem gerar texto livre.
A grande sacada desses modelos é que a saída já vem estruturada.
Você nunca precisa analisar uma frase, porque o modelo só consegue devolver uma das respostas que você forneceu. Isso significa que o resultado pode ir direto para um if no seu código.
Gosto de pensar nessa diferença como dois tipos de prova.
Um grande modelo de linguagem faz uma prova dissertativa, escrevendo a resposta palavra por palavra, enquanto um modelo de decisão faz uma prova de múltipla escolha e ainda te diz o quão seguro está em cada opção (um score de confiança).
O Jev e a maioria das alternativas ao Jev suportam três tipos de perguntas:
A TypeSafe também tem um tipo experimental chamado Box para localizar coisas em imagens, que vou deixar de lado aqui.
Deixa eu te dar um exemplo da própria documentação da TypeSafe.
Você pode enviar um state (que é só o texto que quer que o modelo analise) e um mapa de questions. Para uma pergunta de escolha, cada opção vem com uma breve descrição em um campo chamado criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
E esta foi a resposta respectiva:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Não há texto para interpretar.
Você recebe a opção escolhida, a probabilidade de cada opção e um valor de confiança derivado da maior probabilidade — quanto mais “achatada” a distribuição, menor a confiança. Na documentação, um chamado mais confuso que menciona tamanho errado e cobrança em duplicidade divide a probabilidade entre returns (0,61) e billing (0,35), e a confiança cai para 0,42.
A TypeSafe descreve o Jev como um “System One Model”, pegando emprestado do livro Pensando, rápido e devagar, de Daniel Kahneman. Por quê?
Em linguagem simples, o Sistema 1 é seu julgamento rápido, de intuição, e o Sistema 2 é seu raciocínio lento, passo a passo.
Um modelo de decisão é pensado para ser o rápido.
Um alerta: o Sistema 1 também é a parte do cérebro que comete erros rápidos, e, para crédito da TypeSafe, sua própria documentação lista abertamente onde o Jev erra. Voltaremos a isso já já.
Uma coisa que me confundiu quando li sobre isso pela primeira vez é que “modelo de decisão” já significa outras coisas. Pode se referir a:
Então, só para ficar claro: neste artigo, “modelo de decisão” significa apenas a nova categoria de modelos lançada no fim de 2026 que pontua respostas tipadas em vez de escrever texto.
Antes de entrar no funcionamento dos modelos de decisão, ajuda ver como um LLM normal produz sua resposta. Acredito que isso facilita enxergar a diferença.
Um grande modelo de linguagem trabalha em loop.
Ele transforma nosso texto em tokens, prevê uma probabilidade para cada token do vocabulário, escolhe um, adiciona ao texto e repete.
Cada token extra na resposta significa mais uma passada forward pelo modelo.
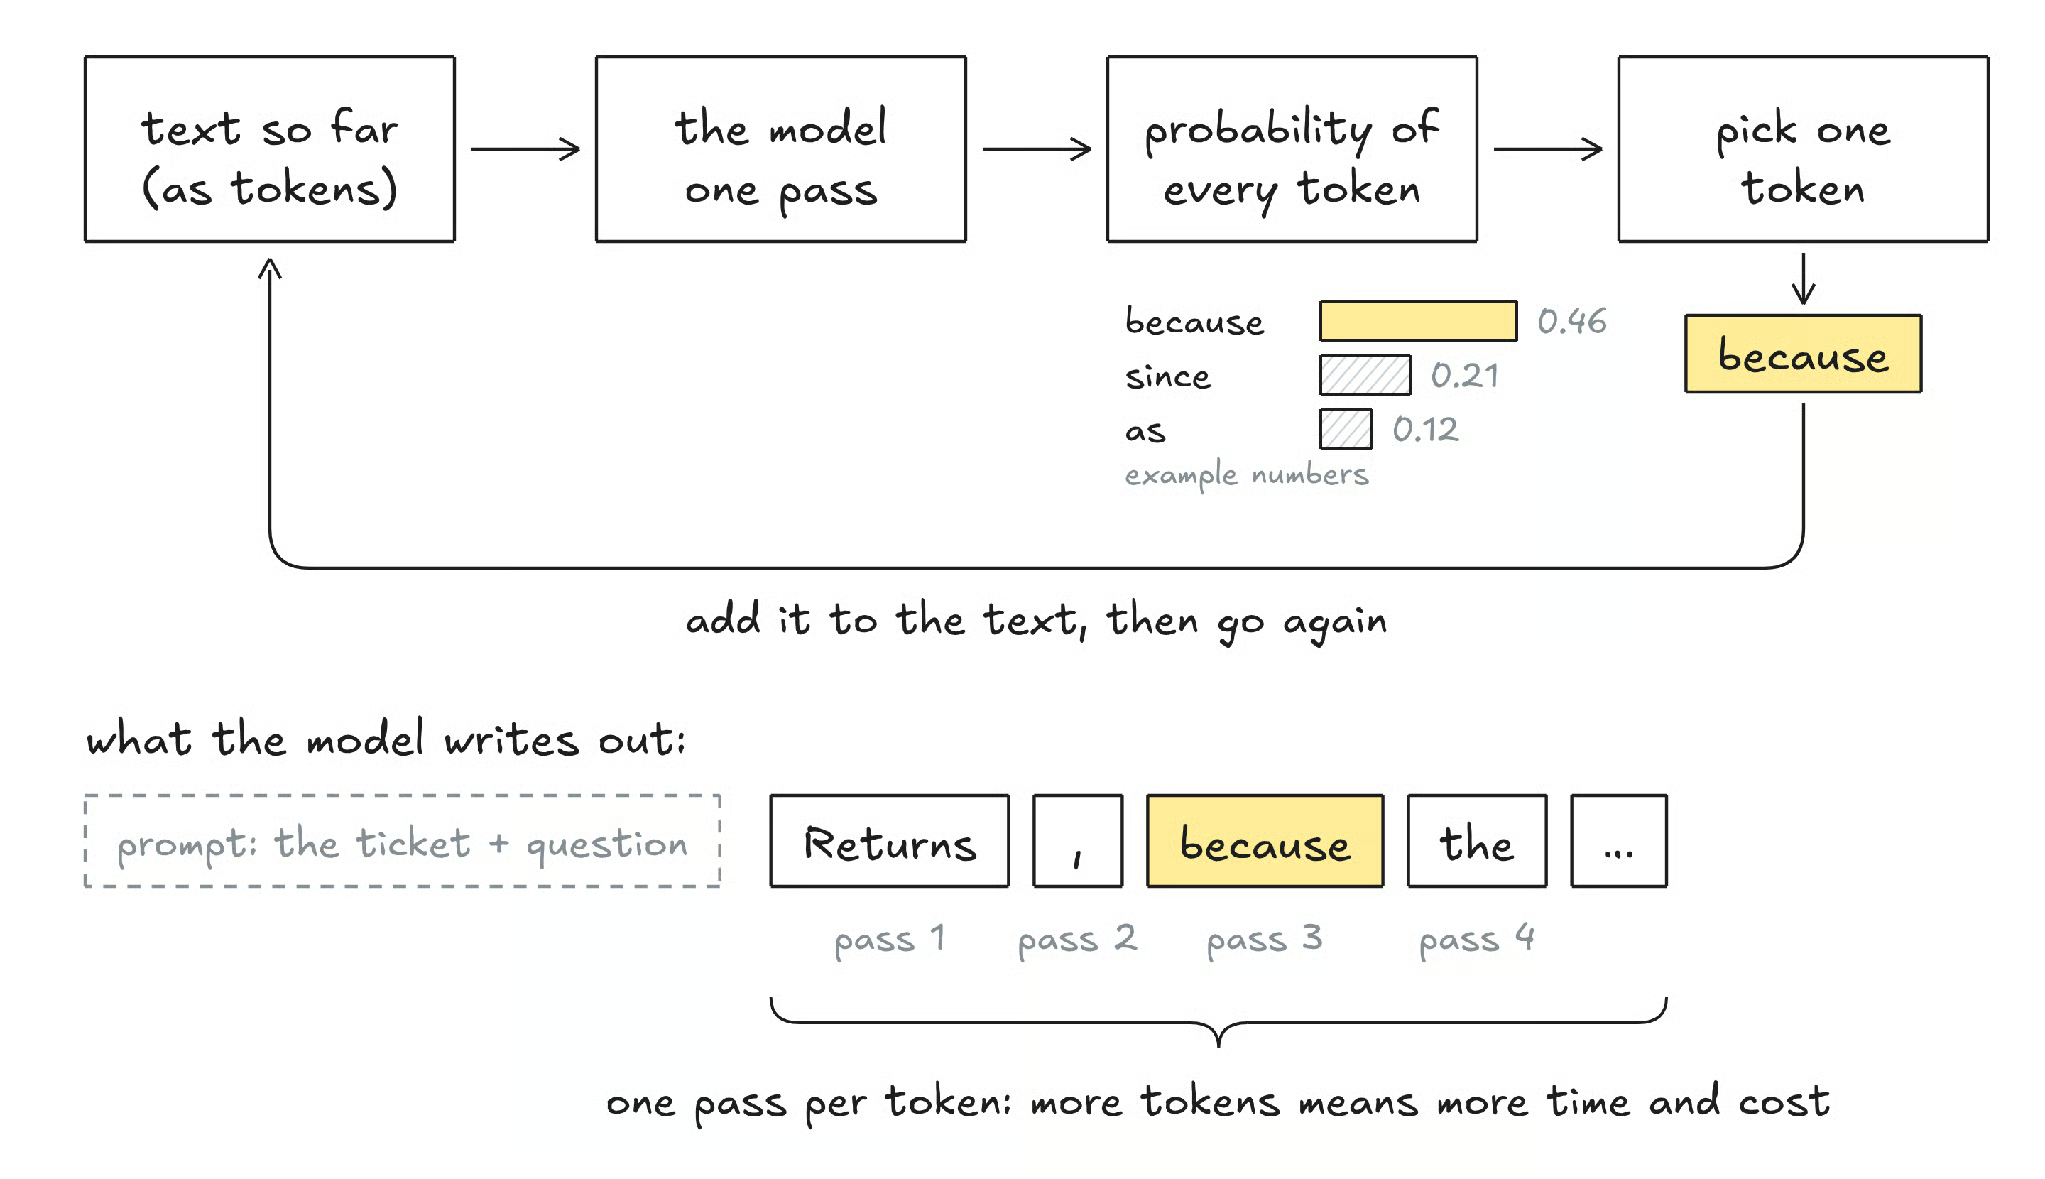
Figura 1: Um LLM precisa de uma passada forward para cada token que escreve. Imagem original do autor.
Esse loop funciona bem para escrever e-mails, código ou explicações, mas, para decisões simples, pode causar alguns problemas:
Modelos de decisão tentam resolver exatamente esses problemas.
Agora vamos à mecânica.
Há três ideias importantes aqui:
Vamos olhar cada uma delas com mais cuidado.
Um modelo de decisão lê seu input e as perguntas e produz um score para cada resposta permitida.
Esses scores normalmente viram probabilidades usando a função softmax. Como dá para notar, não há um loop longo, porque não há nada para escrever.
A documentação da TypeSafe também diz que perguntas no mesmo request são avaliadas em paralelo, então adicionar perguntas quase não muda o tempo de resposta.
É daí que vem a maior parte da velocidade, e a TypeSafe diz que o Jev costuma responder entre 70 e 500 milissegundos.
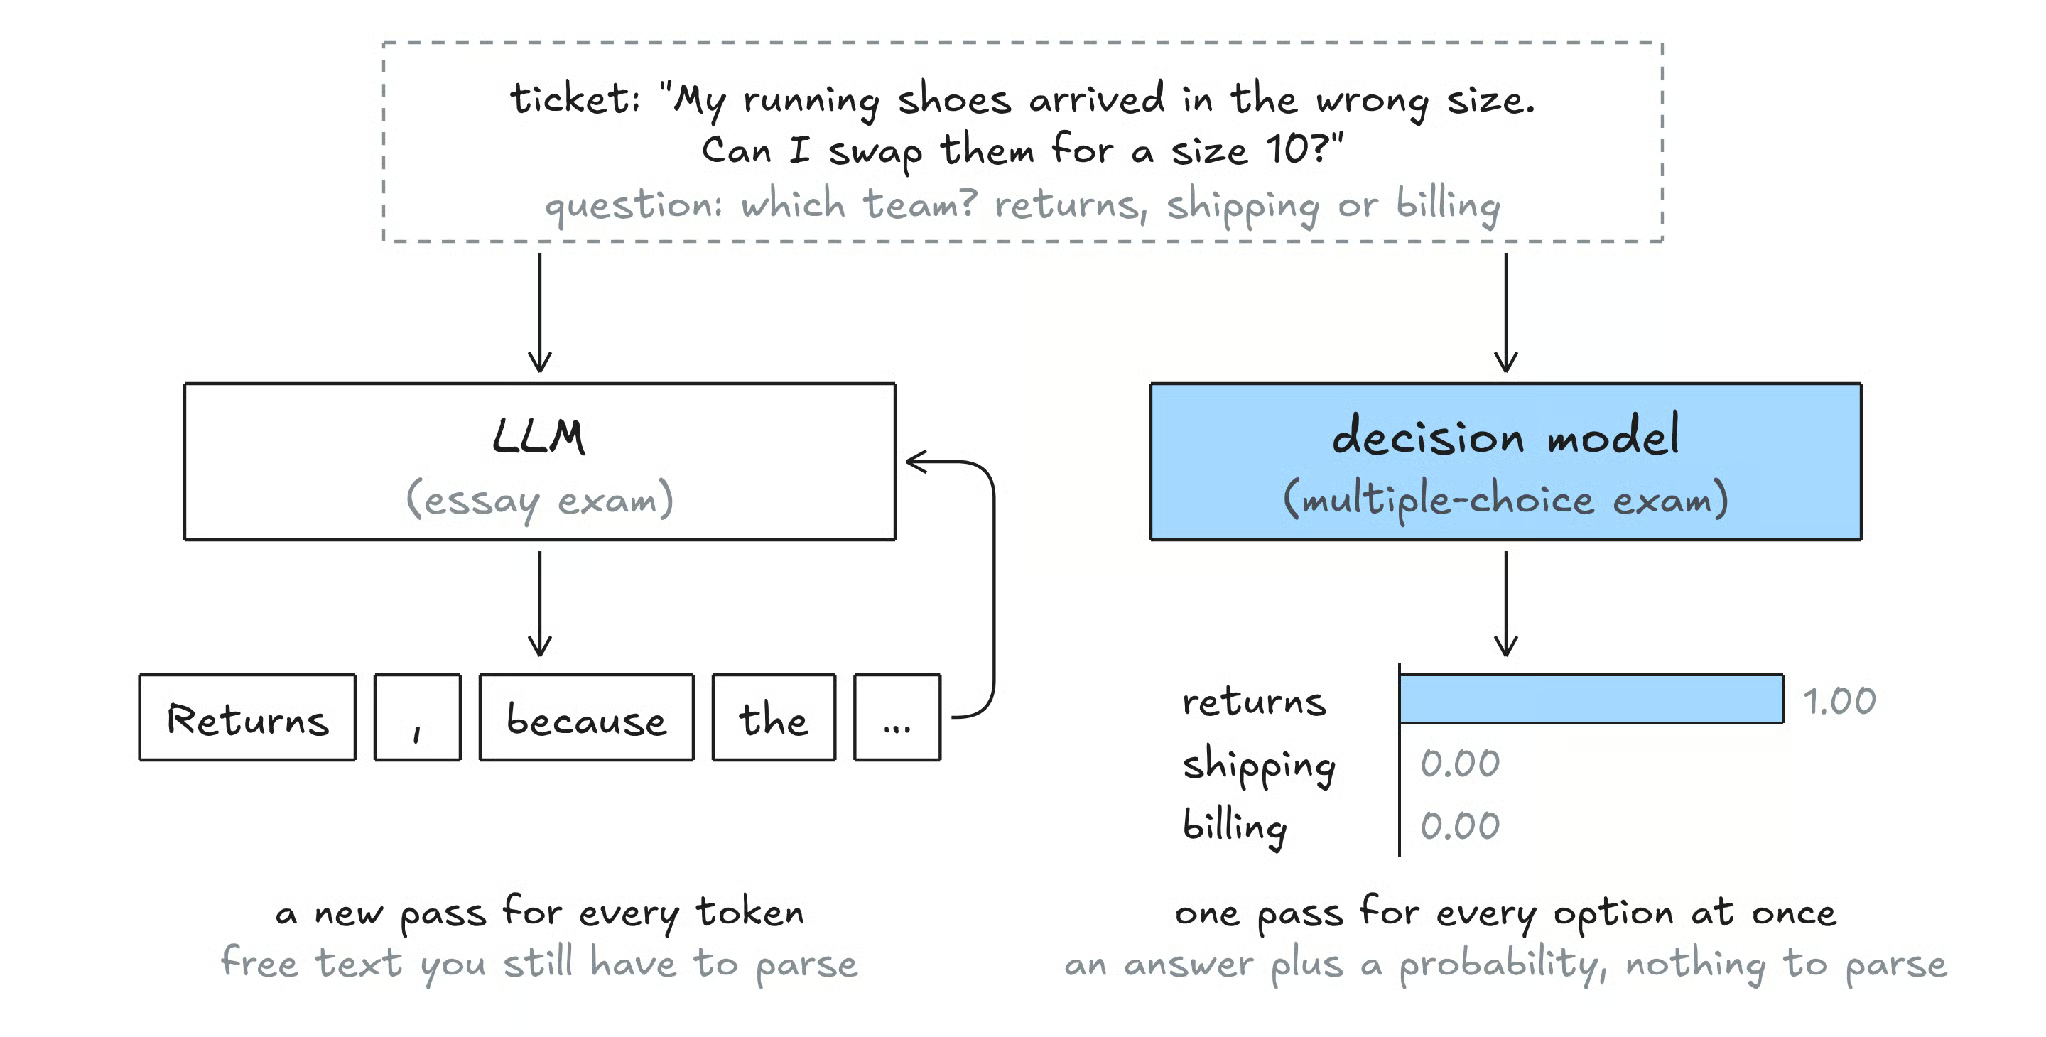
Figura 2: O mesmo chamado, respondido por um LLM e por um modelo de decisão. Imagem original do autor.
Não existe uma única “arquitetura de modelo de decisão”.
A TypeSafe não publicou como o Jev funciona, mas há basicamente três jeitos de obter esses scores:
Não se prenda a qual é usado onde: os três chegam ao mesmo lugar, um número para cada resposta permitida.
Para mim, esta é a parte que mais importa, então vou dar um exemplo.
Imagine que um modelo diga “70% de chance” em 100 perguntas diferentes. Se o modelo é bem calibrado, cerca de 70 dessas respostas devem estar certas.
Calibração importa porque probabilidades calibradas permitem definir limiares seguros no código, como “aprovar automaticamente acima de 90%, senão mandar para um humano”.
Se as probabilidades não batem com a realidade, esses limiares não significam nada.
Fornecedores treinam isso usando funções de perda que punem excesso de confiança.
A TypeSafe chama seu método de Reinforcement Learning for Calibrated Decisions (RLCD), enquanto a Cloudflare diz que combina cross-entropy com Brier loss nos modelos Clef.
Pode surpreender, mas a ideia de pontuar candidatos em vez de gerá-los existe há anos.
Na minha visão, modelos de decisão são a versão mais recente e conveniente disso, não uma invenção do zero. Aqui estão as principais famílias de modelos em que eles se apoiam.
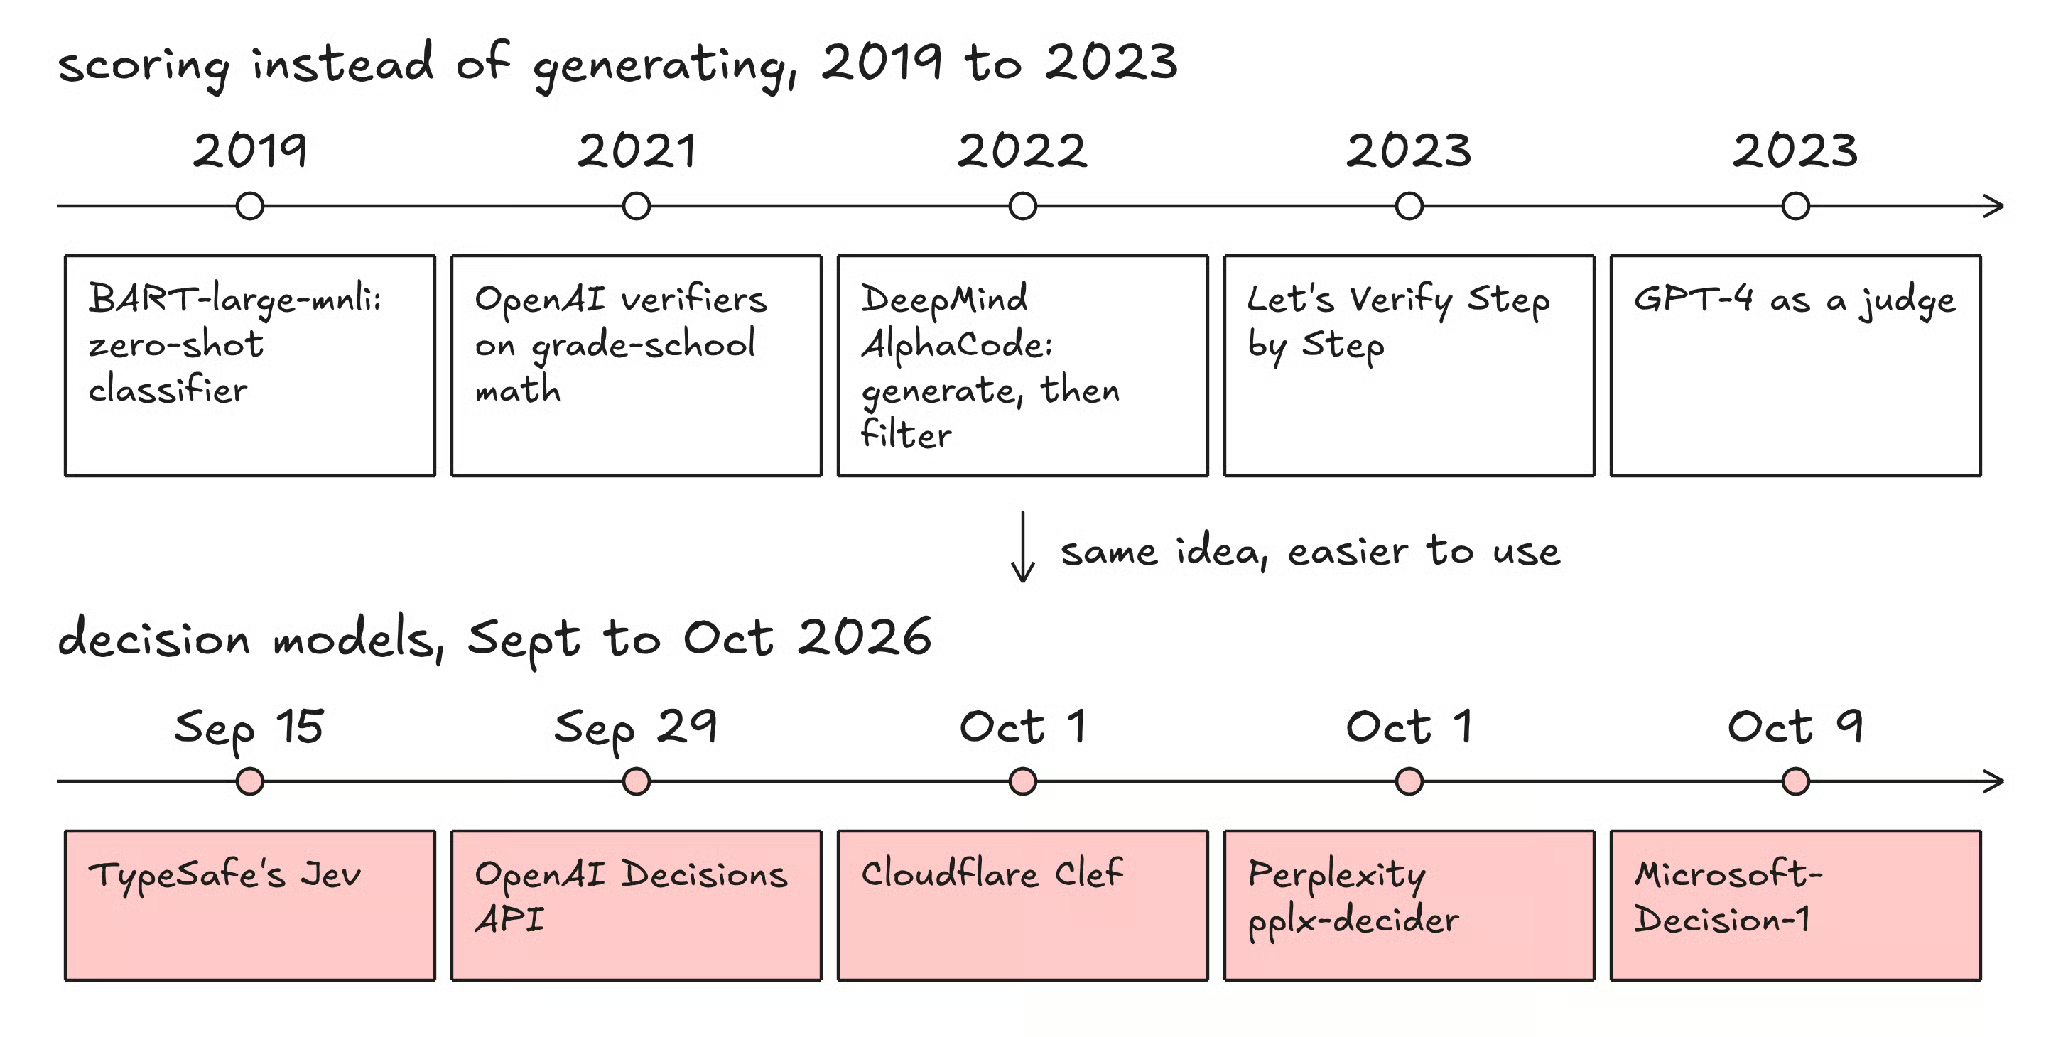
Figura 3: Pontuar em vez de gerar remonta a 2019, e os modelos de decisão são a versão de 2026. Imagem original do autor.
Lá em 2019, modelos como o BART-large-mnli já conseguiam classificar textos em rótulos para os quais não foram treinados.
Faziam isso pontuando afirmações como “este texto é sobre cobrança” para cada possível rótulo.
O time de segurança de IA da Red Hat sugere que modelos de decisão são, em essência, esses zero-shot classifiers com um novo nome.
Se você já construiu um sistema de RAG, pode ter usado um deles. Primeiro você recupera rapidamente uma shortlist (por exemplo, 50 documentos), depois um cross-encoder lê sua pergunta e cada documento junto e atribui um score de relevância a cada par.
Nada é gerado; os documentos são apenas reordenados pelo score.
São avaliadores que pontuam respostas que um LLM já gerou.
Em 2021, pesquisadores da OpenAI mostraram que adicionar um verifier a um modelo trouxe um ganho em matemática de nível fundamental equivalente a tornar o modelo 30 vezes maior, o que é marcante.
Dois anos depois, o paper “Let’s Verify Step by Step” mostrou que pontuar cada passo do raciocínio funciona ainda melhor do que avaliar só a resposta final.
A versão simples é gerar várias respostas, pontuar cada uma e ficar com a melhor. O AlphaCode, do DeepMind (2022), levou isso ao extremo ao gerar até um milhão de programas por problema, descartar cerca de 99% usando testes de exemplo e submeter apenas 10.
Em avaliações simuladas em torneios antigos do Codeforces, ficou, em média, no top 54,3% dos competidores humanos.
Um aviso: se você pressiona demais um avaliador imperfeito, a qualidade cai, porque o gerador passa a explorar as falhas do avaliador.
O termo técnico para isso é reward overoptimization.
É quando um LLM grande avalia a saída de outro modelo.
Um estudo de 2023 encontrou mais de 80% de concordância do GPT-4 com julgadores humanos, mas também vieses, como preferir respostas mais longas ou a que aparece primeiro.
Modelos de decisão estão sendo vendidos em parte como substitutos mais baratos e estruturados para esses “juízes”.
Um modelo baseado em energia dá um score baixo de “energia” para um par input-resposta que combina bem e alto para pares que não combinam.
Escolher uma resposta vira encontrar a menor energia — novamente, pontuar candidatos.
Yann LeCun defende há anos que gerar token a token não é o caminho para inteligência real e que abordagens baseadas em energia e JEPA são uma direção melhor.
Agora, vamos falar dos modelos que de fato foram lançados. As coisas estão mudando muito rápido, então vou ser breve em cada um.
A TypeSafe AI é uma startup de San Francisco fundada por Diogo Almeida, ex-pesquisador da OpenAI, e saiu do modo stealth em 15 de setembro de 2026 com o Jev e uma rodada seed de US$ 40 milhões liderada pela DCVC.
O Jev é uma API hospedada. Em produção, aceita apenas texto; entrada por imagem é experimental e exige um header de opt-in. A precificação cobra pelos tokens de entrada, e as saídas são gratuitas, o que faz sentido quando a saída são só alguns números.
O Jev 1.14 saiu em 14 de outubro, embora o alias jev-latest ainda aponte para a 1.13.0, a versão que a Red Hat testou mais adiante neste artigo.
O lançamento gerou muito burburinho. A Vercel disse que cerca de 13% dos seus times pagos testaram o Jev pelo AI Gateway nas primeiras 24 horas, embora fosse gratuito no gateway naquele momento.
A OpenAI anunciou sua Decisions API no DevDay em 29 de setembro de 2026.
Ela funciona com perguntas definidas pelo usuário que têm um conjunto fixo de respostas e é construída sobre o GPT-6 Luna. Foi para beta público em 6 de outubro e também aceita imagens, algo que o Jev só suporta de forma experimental.
A Cloudflare lançou o Clef e um Clef-flash menor em 1º de outubro de 2026, com pesos abertos e hospedagem no Workers AI. Ambos são baseados em modelos Qwen e aceitam requisições no estilo do Jev, então código escrito para o Jev pode ser apontado para o Clef com pouquíssimas mudanças.
| Modelo | Fabricante | Lançamento (2026) | Acesso | Diferencial |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1º de outubro | Pesos abertos e API | Autorreferiu 85,71% vs 84,51% do Jev no painel de 11 benchmarks da própria Perplexity |
| Microsoft-Decision-1 | Microsoft | 9 de outubro | Preview no Foundry | Um Qwen de 9B pós-treinado |
| Laya | Convai Innovations | Setembro | Pesos abertos | Pequeno (421M de parâmetros), roda em CPU de laptop; o model card o descreve como base para especialização, não um motor zero-shot |
O que mais me chamou a atenção ao compilar esta seção é que a maioria dos modelos abertos e de big tech aqui são versões ajustadas de LLMs normais. O Laya é a exceção: é um encoder com uma cabeça de decisão. Os detalhes internos do Jev não foram divulgados.
Na minha opinião, isso reforça a ideia de que a verdadeira inovação está no empacotamento (isto é, na interface e no treino para calibração), não apenas em uma arquitetura totalmente nova.
A forma mais clara de decidir quando usar cada um é comparar:
| Recurso | LLM | Modelo de decisão | Classificador ajustado | LLM + verifier |
|---|---|---|---|---|
| Saída | Texto livre | Resposta tipada e probabilidades | Rótulos fixos | Melhor entre várias respostas geradas |
| Precisa de dados rotulados | Não | Não | Sim | Frequentemente |
| Velocidade | Segundos | Dezenas a centenas de milissegundos | Muito rápida | A mais lenta |
| Respostas fora do formato | Possível | Impossível | Impossível | Depende do gerador |
| Explica a resposta | Sim | Não | Não | Sim |
| Melhor para | Redação, código, raciocínio | Roteamento, triagem, guardrails | Uma tarefa fixa de alto volume | Matemática, código com testes |
Minha regra prática é:
Acredito que os melhores sistemas combinam tudo isso.
Vejo modelos de decisão atuando como “portões” rápidos ao redor de um LLM. Um portão decide:
Assim, o LLM caro só roda quando realmente é preciso escrever algo.
Esta seção é a mais importante, porque muitos números grandes que você vê online vêm dos próprios fornecedores. A própria TypeSafe admite que os ganhos de velocidade e custo de manchete estão no limite superior do que você veria no uso real.
Em outubro de 2026, a equipe de segurança de IA da Red Hat comparou nove configurações de guardrail em duas tarefas: detectar prompt injection e conteúdo inseguro.
DiffusionGemma é um modelo Gemma de difusão de texto servido via vLLM.
Aqui estão os resultados mais interessantes:
| Método | Tipo | Acurácia em prompt injection | Acurácia em conteúdo seguro |
|---|---|---|---|
| deberta-v3-base | Classificador ajustado | 89,01% | - |
| granite-guardian-hap-125m | Classificador ajustado | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Modelo de decisão (aberto) | 87,72% | 85,53% |
| Jev | Modelo de decisão | 86,35% | 86,20% |
| Laya | Modelo de decisão (aberto) | 85,44% | 57,87% |
| BART-large-mnli | Zero-shot classifier de 2019 | 61,49% | 68,67% |
O Jev ficou em primeiro em content safety, 0,67 ponto percentual à frente do DiffusionGemma (o juiz Qwen ficou em terceiro), e o juiz Qwen ficou em primeiro em prompt injection.
Essa divisão é por que a Red Hat pode dizer que, no geral, modelos de decisão não mostraram ganho de qualidade sobre LLM-as-a-judge.
Mas o que mais me interessa é que um classificador de 200 milhões de parâmetros ficou só 0,3 ponto percentual atrás em prompt injection, com latência mediana abaixo de 100 ms, contra cerca de 348 ms do Jev.
A latência do Jev incluiu uma travessia do Atlântico, já que os testes rodaram do Reino Unido e os servidores da TypeSafe ficam nos EUA.
Esse trajeto só explica a diferença para modelos locais em CPU. Qwen, Nemotron e DiffusionGemma também rodaram em um cluster nos EUA, e o Qwen ainda assim foi mais rápido que o Jev.
Mesmo assim, a Red Hat concluiu que, nos testes deles, modelos de decisão não deram respostas mais rápidas, baratas ou melhores do que LLM-as-a-judge — com exceção do Laya, cujo tamanho pequeno é uma vantagem real se você conseguir contornar suas limitações via prompt.
Um artigo de pesquisa de pesquisadores universitários, publicado no arXiv em setembro de 2026, testou o Jev em 44 benchmarks de alignment.
Os resultados foram mistos de um jeito interessante:
Acho que o ponto da predição seletiva é muito útil na prática.
Ele mostra que um desenho simples em que o modelo de decisão resolve os casos fáceis e passa os incertos para um LLM ou uma pessoa é uma boa estratégia.
Vamos agora construir nosso próprio modelo de decisão.
Vamos transformar um LLM aberto pequeno em um modelo de decisão usando o truque de probabilidade de token que vimos antes e depois checar se dá para confiar nas probabilidades.
Primeiro, precisamos instalar os pacotes (dá para rodar tudo em um Colab gratuito):
pip install transformers torch datasets sentence-transformers numpyVamos usar o Qwen2.5-0.5B-Instruct, pequeno o suficiente para rodar em CPU.
A ideia é simples: rotulamos as opções com letras, rodamos o modelo uma vez e olhamos apenas as probabilidades dessas letras como próximo token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Note que nunca chamamos generate(). Fazemos uma passada forward, guardamos os scores de “A”, “B”, “C” etc. e descartamos todo o resto.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
E é isso mesmo. Acabamos de criar um modelo de decisão funcional em cerca de 30 linhas.
Uma pergunta de sim/não é simplesmente uma pergunta de escolha com duas opções.
Agora vamos ver onde essa versão simples começa a patinar.
Tente embaralhar a ordem das opções e rode a mesma pergunta de novo:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Em inputs confusos como este, é comum vermos as probabilidades mudarem só porque as opções mudaram de lugar.
Isso é chamado de viés de ordem, e a TypeSafe lista, inclusive, uma tendência para a primeira opção como uma das fraquezas conhecidas do Jev.
Você também pode ver o modelo dar respostas perto de 100% com certa frequência. Berryman fez um teste legal no próprio Jev: disse que uma moeda cai em cara 60% das vezes, e a pergunta de sim/não retornou 0,58, bem perto.
Mas a pergunta de escolha (“cara ou coroa?”) retornou 0,99 para cara, porque a probabilidade colapsou na opção mais provável.
Este é o passo que acho que todo mundo deveria rodar. Vamos pegar 400 notícias do dataset AG News (cada uma é um título com uma descrição curta), que tem quatro tópicos, e verificar se nossas probabilidades batem com a realidade.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Depois, precisamos medir a calibração. O Expected calibration error (ECE) agrupa previsões em faixas de confiança e verifica o quanto a confiança média em cada faixa se afasta da acurácia real.
Para ficar claro: quanto menor, melhor.
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Agora vem o truque.
Dividimos os dados em dois, usamos a primeira metade para achar uma temperatura que deixe as probabilidades mais honestas e testamos na segunda metade.
Uma temperatura acima de 1 suaviza previsões autoconfiantes demais, enquanto abaixo de 1 acentua previsões tímidas demais.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
A acurácia não muda, porque dividir por uma temperatura não altera qual opção fica em primeiro.
Só a confiança muda.
Seus números exatos vão variar conforme a execução, mas o ECE na metade de teste deve cair na maioria dos casos. Com apenas 200 itens de teste, a estimativa é ruidosa, então não tire conclusões de diferenças pequenas.
A lição é simples: um modelo ser calibrado em dados de outras pessoas não significa que está calibrado nos seus.
Para mostrar como essa ideia de “pontuar, não gerar” é comum, aqui vai o mesmo conceito num cenário de RAG.
Um cross-encoder pontua cada passagem contra uma pergunta, e a gente só ordena:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
De novo, nada é gerado: o modelo só dá um número para cada candidato.
Estes são os casos de uso que mais aparecem:
| Caso de uso | Como um modelo de decisão ajuda |
|---|---|
| Roteamento de agentes | Decide qual ferramenta ou subagente deve cuidar do próximo passo. |
| Guardrails | Sinaliza prompt injection ou conteúdo inseguro antes de chegar ao LLM. |
| Triagem de suporte | Encaminha chamados por time, assunto e urgência. |
| Intake de documentos | Responde um checklist fixo de perguntas sobre cada documento. |
| Busca e RAG | Reordena passagens recuperadas por relevância. |
| Crédito e fraude | Pontua risco, embora decisões sobre pessoas ainda devam envolver revisão humana. |
| Robótica | Pode atuar como uma camada rápida entre um planejador LLM lento e o controle motor de baixo nível, embora isso ainda seja especulativo. |
O ponto da robótica é o que eu pessoalmente mais gosto.
Berryman sugere que um modelo como o Jev poderia ficar entre um LLM lento fazendo planos de alto nível e os modelos cinemáticos que movem as juntas de um robô.
Vale notar, porém, que o famoso demo de Doom da TypeSafe alimentou o Jev com telemetria em texto, não imagens brutas.
Modelos de decisão são úteis, mas não quero supervendê-los.
Aqui estão as principais limitações que encontrei para ter em mente:
Modelos de decisão em IA pegam uma ideia antiga — pontuar candidatos em vez de gerar respostas — e a tornam muito mais fácil de usar.
Você não precisa de dados de treino; recebe respostas tipadas; e pode fazer muitas perguntas de uma vez.
Na minha opinião, esse empacotamento é a verdadeira inovação.
Espero ver modelos de decisão ao redor dos LLMs como portões rápidos e baratos que resolvem as decisões simples, para que o modelo caro só rode quando realmente for preciso escrever algo.
Principais cursos da DataCamp
Programa
Programa
Pratique e programa seu progresso.
Continuar Com O Google