Traseu de învățare
Inginer AI asociat pentru dezvoltatori
26 ore
Practică și urmărește-ți progresul.
Continuă Cu GoogleImaginează-ți că te așezi la un restaurant și chelnerul te întreabă: „Apă plată sau minerală?” Nu răspunzi cu un paragraf despre preferințele tale de hidratare; alegi una dintre cele două opțiuni primite.
Acum gândește-te cum folosim modelele de limbaj mari (LLM) în majoritatea aplicațiilor de azi. Le punem întrebări de tipul „Acest tichet de suport e despre facturare, livrare sau retururi?” iar modelul ne scrie un întreg enunț, pe care apoi îl analizăm cu puțin cod. Realist vorbind, existau doar trei răspunsuri posibile, dar noi am plătit oricum pentru un întreg proces de gândire.
Aici intervine noul tip de model. În septembrie 2026, un startup numit TypeSafe AI a lansat Jev, un model care nu scrie deloc text.
În schimb, el evaluează un set fix de răspunsuri și îți spune cât de probabil este fiecare. În câteva săptămâni, OpenAI, Cloudflare, Perplexity și Microsoft și-au lansat propriile versiuni, ceea ce arată cât de rapid evoluează acest domeniu.
În acest articol, vreau să explorăm ce sunt aceste modele de decizie AI, cum funcționează și de unde vine de fapt ideea (este mult mai veche decât sugerează toată această efervescență). Voi analiza și ce au descoperit benchmark-urile independente.
if.Un model de decizie AI este un model care primește un input și un set de răspunsuri permise și returnează probabilitatea fiecărui răspuns, fără a genera text liber.
Ideea principală a acestor modele este că ieșirea este deja structurată.
Nu trebuie niciodată să parsezi o propoziție, deoarece modelul poate returna doar unul dintre răspunsurile pe care i le-ai dat. Asta înseamnă că rezultatul poate intra direct într-o instrucțiune if în codul tău.
Mie îmi place să văd diferența ca pe două tipuri de examene.
Un model de limbaj mare dă un examen tip eseu, scriindu-și răspunsul cuvânt cu cuvânt, în timp ce un model de decizie dă un examen cu variante multiple și îți spune și cât de sigur e pentru fiecare căsuță (un scor de încredere).
Jev și majoritatea alternativelor la Jev acceptă trei tipuri de întrebări:
TypeSafe are și un tip experimental numit Box pentru localizarea obiectelor în imagini, pe care îl omit aici.
Îți dau un exemplu din documentația TypeSafe.
Poți trimite un state (care este doar textul pe care vrei ca modelul să-l analizeze) și o mapare de questions. Pentru o întrebare de tip alegere, fiecare opțiune are o scurtă descriere într-un câmp numit criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Iar acesta a fost răspunsul respectiv:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Nu există text de parsare.
Primești opțiunea aleasă, o probabilitate pentru fiecare opțiune și o valoare de încredere derivată din probabilitatea cea mai mare, astfel încât o distribuție mai „plată” înseamnă încredere mai mică. În documentație, un tichet mai încâlcit care menționează atât o mărime greșită, cât și o dublă taxare împarte probabilitatea între retururi (0,61) și facturare (0,35), iar încrederea scade la 0,42.
TypeSafe descrie Jev ca un „System One Model”, împrumutând din cartea lui Daniel Kahneman Thinking, Fast and Slow. De ce?
Foarte simplu spus, Sistemul 1 este judecata ta rapidă, din instinct, iar Sistemul 2 este raționamentul lent, pas cu pas.
Un model de decizie este gândit să fie cel rapid.
Un avertisment: Sistemul 1 este și partea creierului care face greșeli rapide, iar în favoarea TypeSafe, în propria documentație enumeră deschis unde Jev greșește. Revenim la asta mai târziu.
Ce m-a derutat la început a fost că „model de decizie” înseamnă deja alte câteva lucruri. Poate să se refere la:
Deci, ca să fie clar, în acest articol un „model de decizie” înseamnă doar noua categorie de modele lansate la final de 2026 care punctează răspunsuri tipizate în loc să scrie text.
Înainte de a intra în modul de funcționare al modelelor de decizie, ajută să vezi cum produce un LLM obișnuit răspunsul. Cred că așa diferența devine mai clară.
Un model de limbaj mare funcționează într-o buclă.
Îți transformă textul în tokeni, prezice o probabilitate pentru fiecare token din vocabularul său, alege unul, îl adaugă la text, apoi repetă.
Fiecare token în plus din răspuns înseamnă încă o trecere directă prin model.
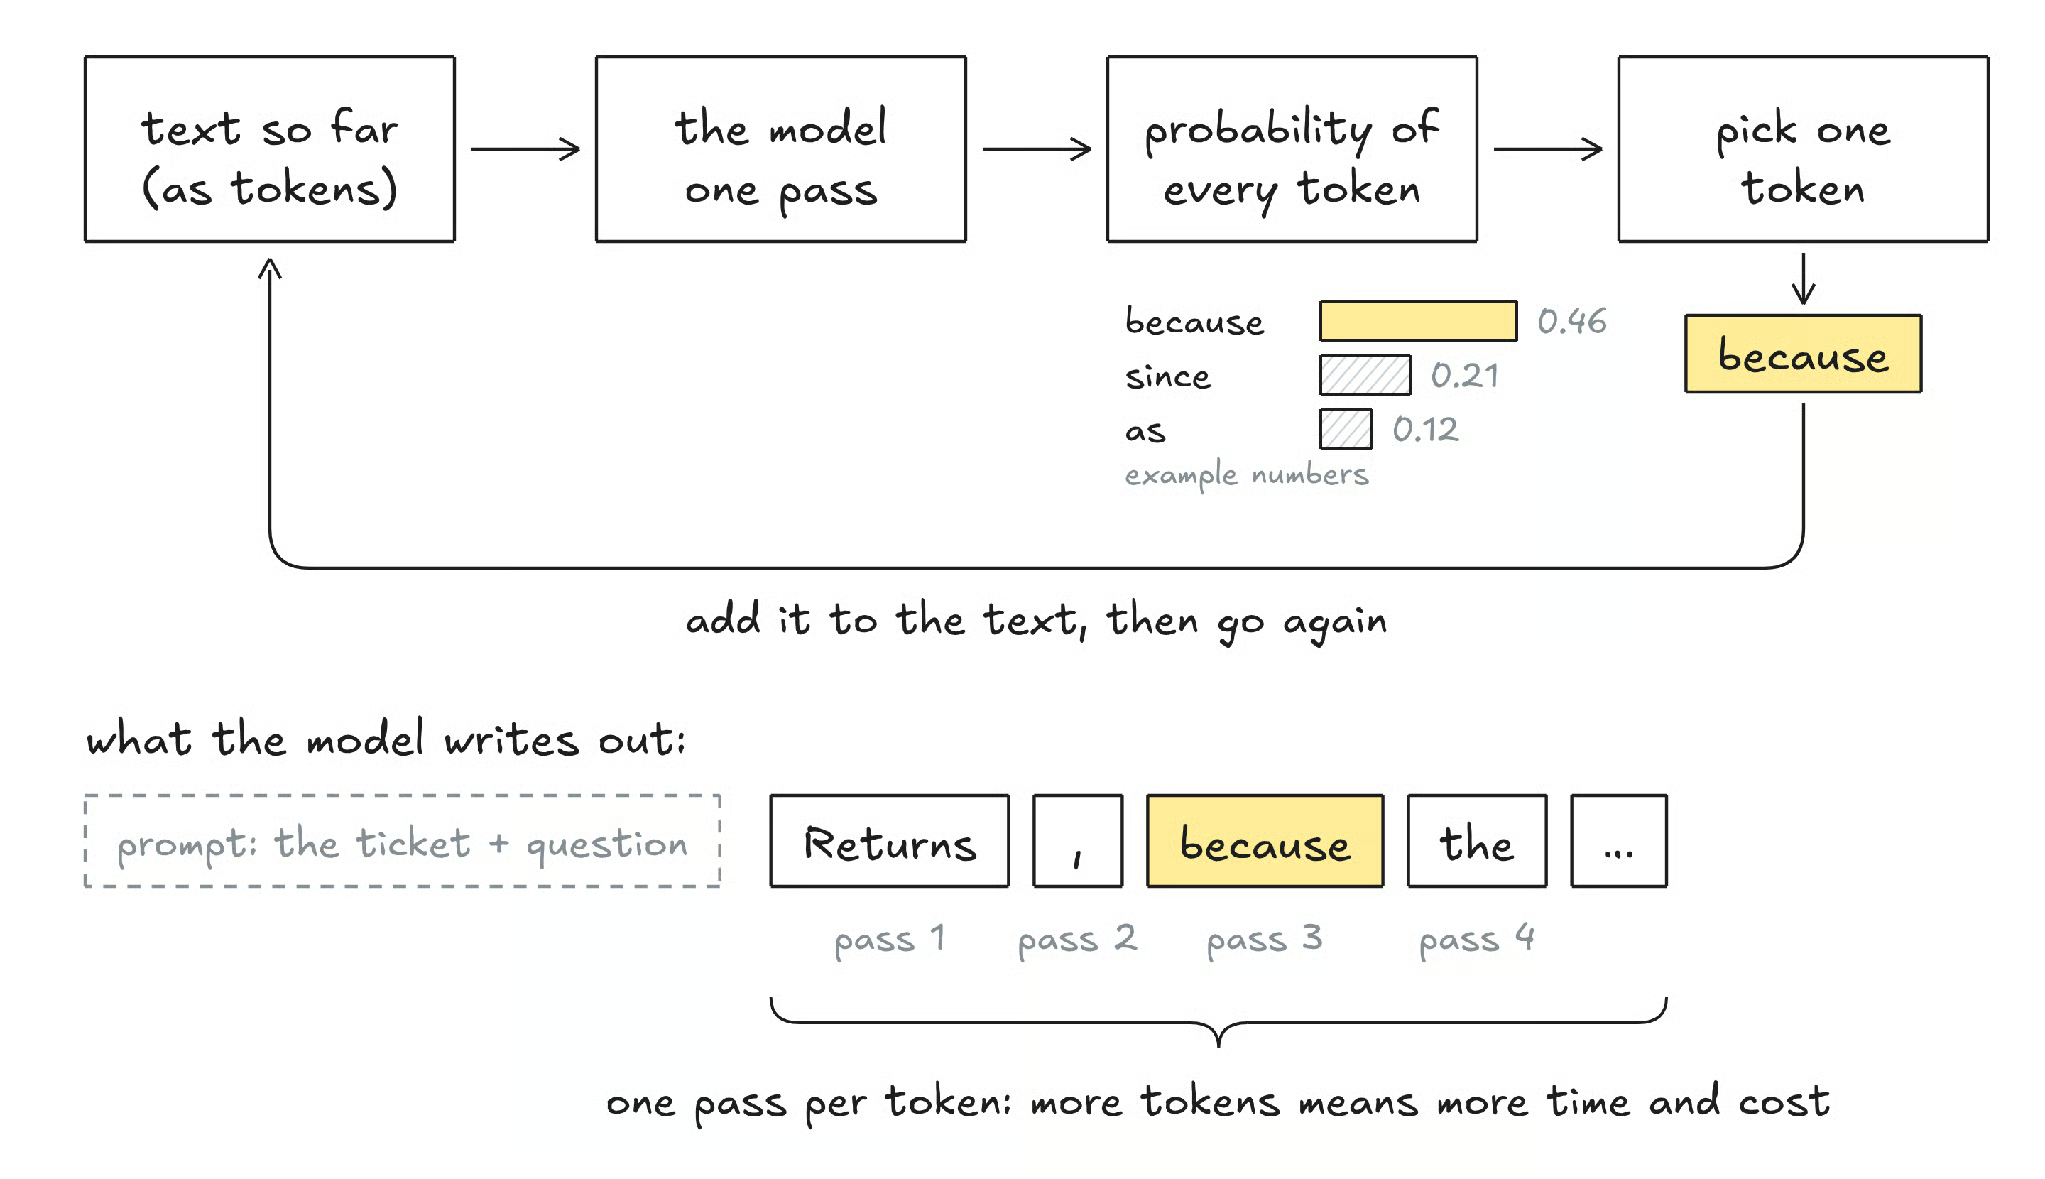
Figura 1: Un LLM are nevoie de o trecere pentru fiecare token pe care îl scrie. Imagine originală de autor.
Această buclă merge foarte bine pentru scriere de e-mailuri, cod sau explicații, dar pentru decizii simple poate crea câteva probleme:
Modelele de decizie încearcă să repare exact aceste probleme.
Acum să intrăm în mecanica propriu-zisă.
Sunt trei idei care merită înțelese aici:
Să le vedem pe rând, puțin mai în detaliu.
Un model de decizie îți citește inputul și întrebările și produce un scor pentru fiecare răspuns permis.
Acele scoruri sunt de obicei transformate în probabilități folosind o funcție softmax. După cum probabil îți dai seama, nu există o buclă lungă, pentru că nu are nimic de scris.
Documentația TypeSafe spune și că întrebările din aceeași cerere sunt evaluate în paralel, astfel încât adăugarea de întrebări abia schimbă timpul de răspuns.
Aici se câștigă cea mai mare parte din viteză, iar TypeSafe spune că Jev răspunde de obicei în jur de 70 până la 500 ms.
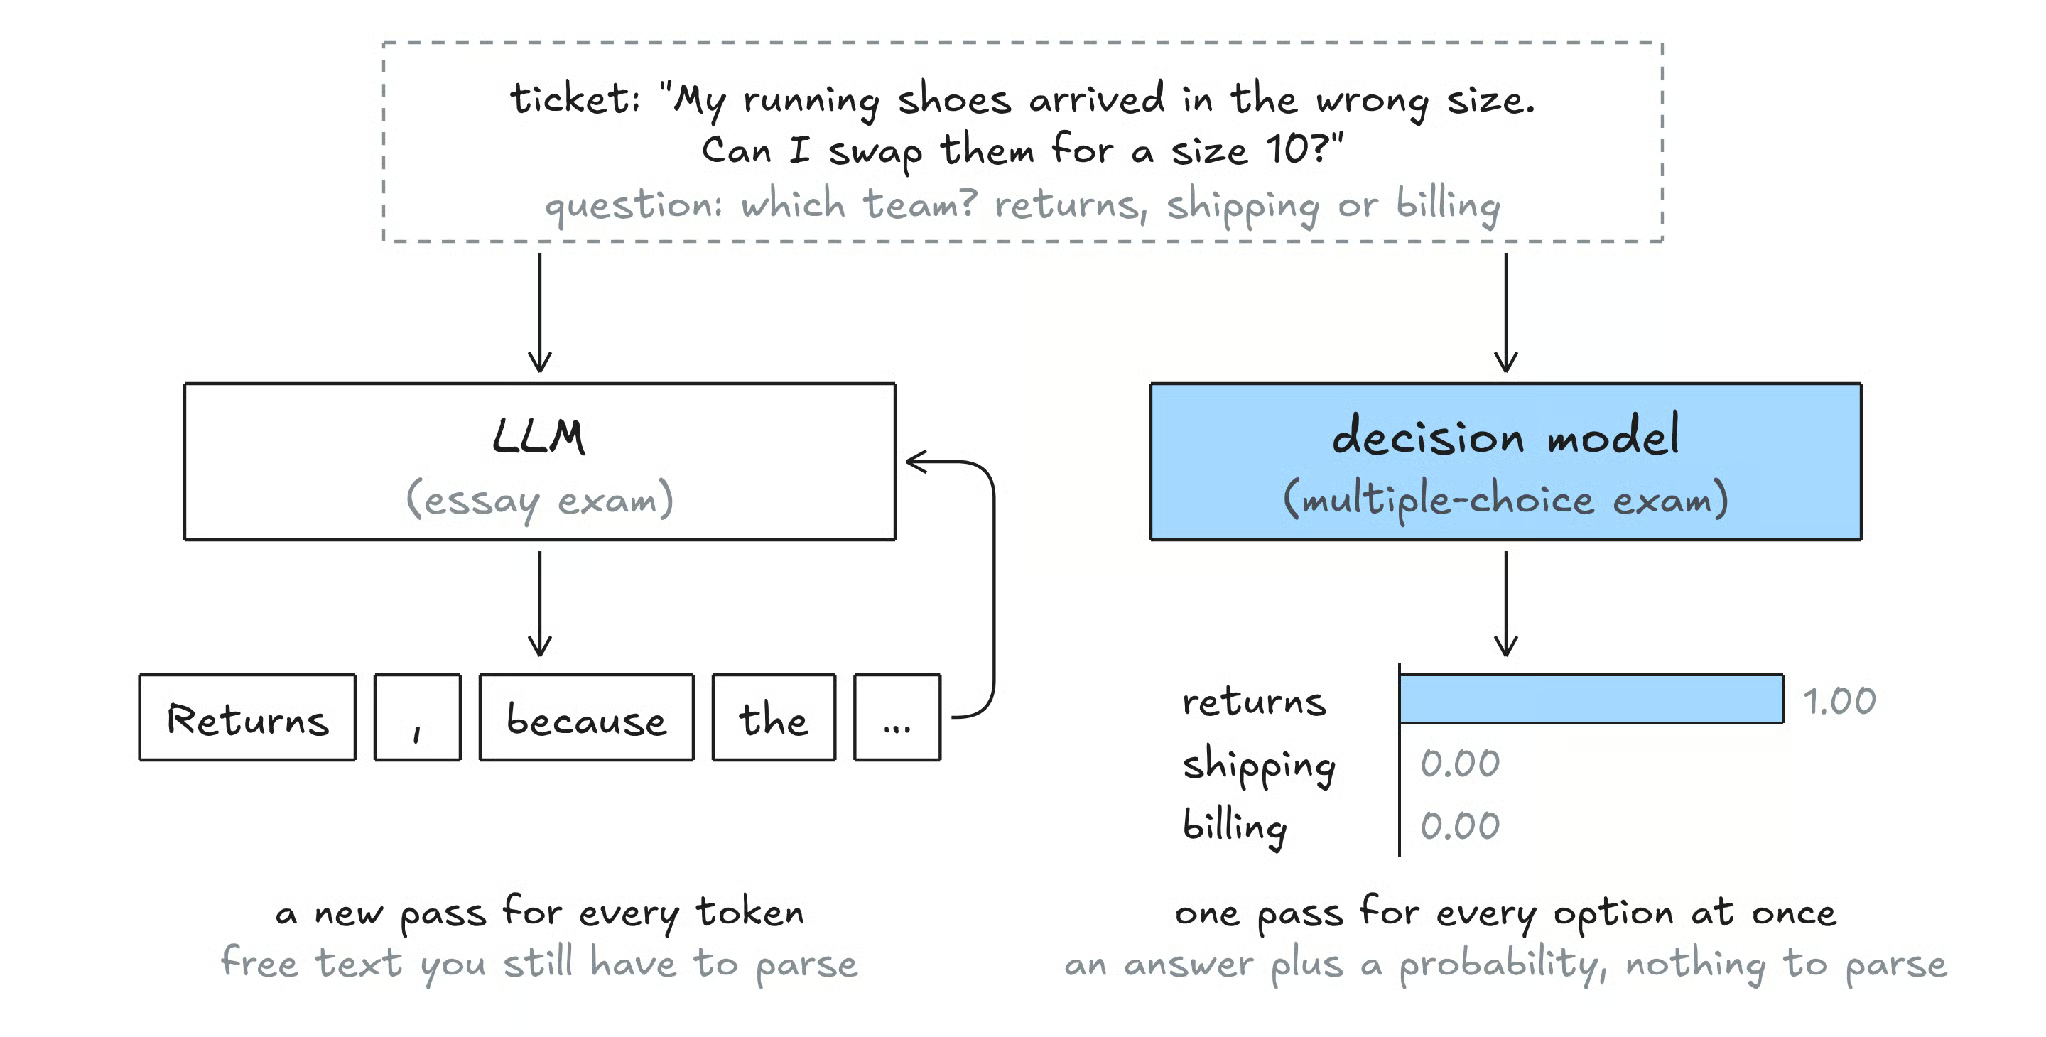
Figura 2: Același tichet, răspuns de un LLM și de un model de decizie. Imagine originală de autor.
Nu există o singură „arhitectură de model de decizie”.
TypeSafe nu a publicat cum funcționează Jev, dar există cam trei moduri de a obține aceste scoruri:
Nu te îngrijora care e folosit unde: toate trei ajung în același loc, un număr pentru fiecare răspuns permis.
Asta cred că e partea cea mai importantă, așa că îți dau un exemplu.
Imaginează-ți că un model spune „probabilitate 70%” pe 100 de întrebări diferite. Dacă modelul e bine calibrat, cam 70 dintre acele răspunsuri ar trebui să fie corecte.
Calibrarea contează pentru că probabilitățile calibrate ne permit să setăm praguri sigure în cod, de tipul „aprobă automat peste 90%, altfel trimite la un om”.
Dacă probabilitățile nu corespund realității, acele praguri nu mai înseamnă nimic.
Vânzătorii antrenează pentru asta cu funcții de pierdere care penalizează supraîncrederea.
TypeSafe își numește metoda Reinforcement Learning for Calibrated Decisions (RLCD), în timp ce Cloudflare spune că îmbină cross-entropy cu o pierdere Brier pentru modelele sale Clef.
Poate te surprinde, dar ideea de a puncta candidați în loc de a-i genera există de ani buni.
În opinia mea, modelele de decizie sunt cea mai nouă și mai comodă versiune, nu o invenție complet nouă. Iată principalele familii de modele pe care se bazează.
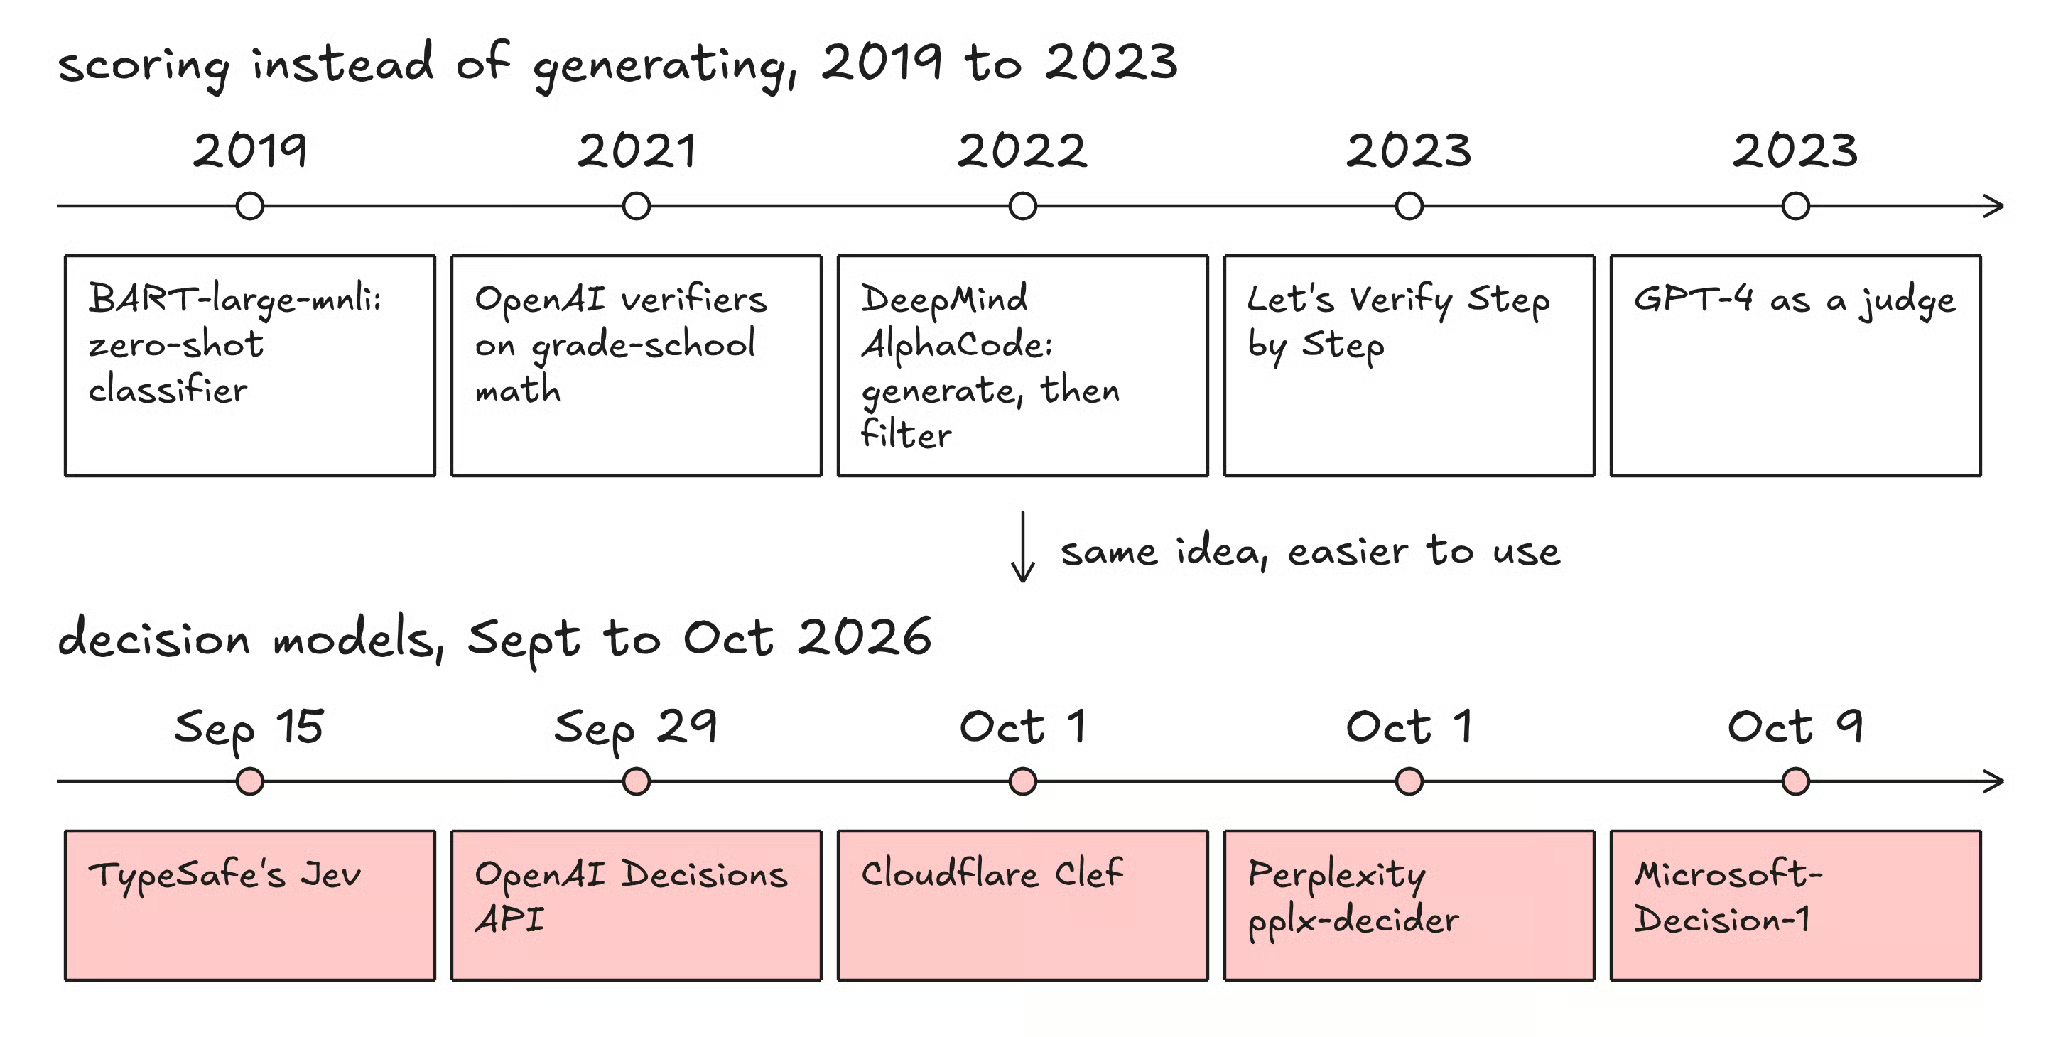
Figura 3: Punctarea în locul generării datează din 2019, iar modelele de decizie sunt versiunea din 2026. Imagine originală de autor.
Încă din 2019, modele precum BART-large-mnli puteau deja să claseze texte în etichete pe care nu fuseseră antrenate.
Făceau asta punctând enunțuri de tipul „acest text este despre facturare” pentru fiecare etichetă posibilă.
Echipa de siguranță AI a Red Hat sugerează că modelele de decizie sunt, în esență, aceste clasificatoare zero-shot sub un nume nou.
Dacă ai construit un sistem RAG, e posibil să fi folosit unele. Mai întâi recuperezi rapid o listă scurtă (de exemplu, 50 de documente), apoi un cross-encoder citește împreună întrebarea ta și fiecare document și atribuie fiecărei perechi un scor de relevanță.
Nu se generează nimic; documentele sunt doar reordonate după scor.
Acestea sunt evaluatori care notează răspunsuri deja generate de un LLM.
În 2021, cercetători de la OpenAI au arătat că adăugarea unui verificator unui model a oferit un salt la matematică de școală primară cam egal cu mărirea modelului de 30 de ori, ceea ce mi se pare remarcabil.
Doisprezece ani mai târziu, lucrarea „Let’s Verify Step by Step” a arătat că punctarea fiecărui pas de raționament funcționează chiar mai bine decât punctarea doar a răspunsului final.
Versiunea simplă este să generezi multe răspunsuri, să le punctezi pe fiecare și să-l păstrezi pe cel mai bun. AlphaCode de la DeepMind (2022) a dus asta la extrem, generând până la un milion de programe per problemă, aruncând cam 99% folosind teste de exemplu și apoi trimițând doar 10.
În evaluări simulate pe concursuri vechi Codeforces, s-a clasat în medie în top 54,3% dintre concurenții umani.
Un avertisment: dacă forțezi prea mult un evaluator imperfect, calitatea scade în cele din urmă, pentru că generatorul ajunge să exploateze greșelile evaluatorului.
Termenul tehnic pentru asta este supraoptimizare a recompensei.
Asta e când un LLM mare notează outputul altui model.
Un studiu din 2023 a constatat că GPT-4 a fost de acord cu evaluatorii umani în peste 80% din cazuri, dar avea și biaisuri, precum preferința pentru răspunsuri mai lungi sau pentru cel afișat primul.
Modelele de decizie sunt vândute parțial ca un înlocuitor mai ieftin și structurat pentru acești „judecători”.
Un model bazat pe energie dă un scor de „energie” mic unui input și răspuns care se potrivesc bine și un scor mare perechilor care nu se potrivesc.
A alege un răspuns înseamnă apoi să găsești energia cea mai mică, adică iarăși să punctezi candidați.
Yann LeCun susține de ani de zile că generarea token-cu-token nu e calea spre inteligență reală și că abordările bazate pe energie și JEPA sunt o direcție mai bună.
Acum vreau să vorbesc despre modelele care chiar au fost lansate. Lucrurile se mișcă foarte rapid aici, așa că le voi păstra pe fiecare pe scurt.
TypeSafe AI este un startup din San Francisco fondat de Diogo Almeida, fost cercetător la OpenAI, care a ieșit din stealth pe 15 septembrie 2026 cu Jev și o rundă seed de 40 de milioane de dolari condusă de DCVC.
Jev este un API găzduit. În producție primește doar text; inputul de imagini este experimental și necesită un header de opt-in. Prețul e calculat pe tokenii de input, iar outputurile sunt gratuite, ceea ce are sens când ieșirea sunt doar câteva numere.
Jev 1.14 a urmat pe 14 octombrie, deși aliasul jev-latest încă indică spre 1.13.0, versiunea testată de Red Hat mai târziu în acest articol.
A fost mult buzz la lansare. Vercel a spus că aproximativ 13% dintre echipele sale plătite au încercat Jev prin AI Gateway în primele 24 de ore, deși era gratuit în gateway la acel moment.
OpenAI și-a anunțat Decisions API la DevDay pe 29 septembrie 2026.
Funcționează cu întrebări definite de utilizator care au un set fix de răspunsuri și este construit pe GPT-6 Luna. A trecut în beta publică pe 6 octombrie și poate primi și imagini, lucru pe care Jev îl acceptă doar experimental.
Cloudflare a lansat Clef și o versiune mai mică, Clef-flash, pe 1 octombrie 2026, cu greutăți deschise și hosting pe Workers AI. Ambele sunt construite pe modele Qwen și acceptă cereri în stil Jev, astfel încât codul scris pentru Jev poate fi direcționat către Clef cu foarte puține modificări.
| Model | Producător | Lansare (2026) | Acces | Detaliu notabil |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 octombrie | Greutăți deschise și API | 85,71% raportat intern vs 84,51% pentru Jev pe panoul propriu Perplexity cu 11 benchmarkuri |
| Microsoft-Decision-1 | Microsoft | 9 octombrie | Previzualizare Foundry | Un model Qwen de 9B post-antrenat |
| Laya | Convai Innovations | Septembrie | Greutăți deschise | Mic (421M de parametri), rulează pe CPU de laptop; fișa modelului îl prezintă ca bază pentru specializare, nu motor zero-shot |
Ce mi-a sărit cu adevărat în ochi punând laolaltă această secțiune este că majoritatea modelelor open și ale marilor companii sunt versiuni fine-tunate ale LLM-urilor normale. Laya este excepția: e un encoder cu un cap de decizie. Internals-urile lui Jev nu sunt dezvăluite.
În opinia mea, asta susține ideea că inovația reală e ambalarea (adică interfața și antrenarea pentru calibrare), nu neapărat o arhitectură complet nouă.
Cel mai clar mod de a decide când să folosești fiecare este comparația:
| Caracteristică | LLM | Model de decizie | Clasificator fine-tuned | LLM + verificator |
|---|---|---|---|---|
| Output | Text liber | Răspuns tipizat și probabilități | Etichete fixe | Cel mai bun dintre mai multe răspunsuri generate |
| Necesită date etichetate | Nu | Nu | Da | Adesea |
| Viteză | Secunde | Zeci până la sute de milisecunde | Foarte rapid | Cel mai lent |
| Răspunsuri off-format | Posibile | Imposibile | Imposibile | Depinde de generator |
| Își explică răspunsul | Da | Nu | Nu | Da |
| Potrivit pentru | Scriere, cod, raționament | Rutare, triaj, guardrails | O singură sarcină cu volum mare | Matematică, cod cu teste |
Regula mea aproximativă este aceasta:
Cred că cele mai bune sisteme le combină pe toate.
Pot vedea modelele de decizie acționând ca „porți” rapide în jurul unui LLM. O poartă decide:
Astfel, LLM-ul scump rulează doar când chiar trebuie scris ceva.
Această secțiune contează cel mai mult, pentru că majoritatea cifrelor mari pe care le vezi online vin de la vânzători. Chiar și TypeSafe admite că câștigurile headline de viteză și cost sunt la limita superioară a ceea ce ai vedea în utilizare reală.
În octombrie 2026, echipa de siguranță AI a Red Hat a comparat nouă configurații de guardrail pe două sarcini: detectarea prompt injection și a conținutului nesigur.
DiffusionGemma este un model Gemma text-difuzie servit prin vLLM.
Iată cele mai interesante rezultate:
| Metodă | Tip | Acuratețe prompt injection | Acuratețe content safety |
|---|---|---|---|
| deberta-v3-base | Clasificator fine-tuned | 89,01% | - |
| granite-guardian-hap-125m | Clasificator fine-tuned | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Model de decizie (open) | 87,72% | 85,53% |
| Jev | Model de decizie | 86,35% | 86,20% |
| Laya | Model de decizie (open) | 85,44% | 57,87% |
| BART-large-mnli | Clasificator zero-shot din 2019 | 61,49% | 68,67% |
Jev a ieșit primul la content safety, cu 0,67 puncte procentuale înaintea DiffusionGemma (judecătorul Qwen a fost al treilea), iar judecătorul Qwen a ieșit primul la prompt injection.
Această împărțire explică de ce Red Hat poate spune totuși că, per total, modelele de decizie nu au arătat un câștig de calitate față de LLM-as-a-judge.
Dar partea care mi se pare cea mai interesantă este că un clasificator de 200 de milioane de parametri a terminat la doar 0,3 puncte procentuale în urmă la prompt injection, cu o latență mediană sub 100 ms față de aproximativ 348 pentru Jev.
Latența lui Jev a inclus un drum peste Atlantic, deoarece testele au rulat din Marea Britanie iar serverele TypeSafe sunt în SUA.
Acel hop explică doar diferența față de modelele locale pe CPU. Qwen, Nemotron și DiffusionGemma au rulat tot pe un cluster din SUA, iar Qwen a fost totuși mai rapid decât Jev.
Chiar și așa, Red Hat a concluzionat că modelele de decizie nu au dat răspunsuri mai rapide, mai ieftine sau mai bune decât LLM-as-a-judge în testele lor, cu excepția Laya, a cărui dimensiune mică e un avantaj real dacă poți construi prompturi în jurul limitelor sale.
O lucrare de cercetare de la universități, postată pe arXiv în septembrie 2026, a testat Jev pe 44 de benchmark-uri de aliniere.
Rezultatele au fost amestecate într-un mod interesant:
Cred că punctul despre predicții selective e foarte util în practică.
Arată că un design simplu în care modelul de decizie gestionează cazurile ușoare și pasează cele incerte către un LLM sau o persoană este o strategie bună.
Hai să construim acum un model de decizie noi înșine.
Vom transforma un LLM open-source mic într-un model de decizie folosind șmecheria cu probabilitățile de token de mai devreme și apoi vom verifica dacă îi putem avea încredere în probabilități.
Mai întâi, instalăm pachetele cu asta (totul poate rula într-un notebook Colab gratuit):
pip install transformers torch datasets sentence-transformers numpyVom folosi Qwen2.5-0.5B-Instruct, suficient de mic pentru a rula pe un CPU.
Ideea e simplă: etichetăm opțiunile cu litere, rulăm modelul o dată și ne uităm doar la probabilitățile acelor litere ca următor token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Observă că nu apelăm niciodată generate(). Facem o singură trecere, păstrăm scorurile pentru „A”, „B”, „C” și așa mai departe, iar apoi aruncăm restul.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Și chiar asta e tot. Tocmai am creat un model de decizie funcțional în aproximativ 30 de linii.
O întrebare da/nu este pur și simplu o întrebare de alegere cu două opțiuni.
Acum să vedem unde începe să se poticnească această versiune simplă.
Încearcă să amesteci ordinea opțiunilor și rulează aceeași întrebare din nou:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Pe inputuri „murdare” ca acesta, deseori vom vedea probabilitățile schimbându-se doar pentru că s-au mutat opțiunile.
Asta se numește order bias, iar TypeSafe listează de fapt o înclinare spre prima opțiune printre punctele slabe cunoscute ale lui Jev.
Poți vedea și răspunsuri aproape de 100% destul de des. Berryman a rulat un test drăguț chiar pe Jev, în care i-a spus că o monedă cade pe cap 60% din timp, iar întrebarea da/nu a întors 0,58, ceea ce e aproape.
Dar întrebarea de alegere („cap sau pajură?”) a întors 0,99 pentru cap, pentru că probabilitatea s-a prăbușit pe răspunsul mai probabil.
Asta cred că e pasul pe care toată lumea ar trebui să-l ruleze. Vom lua 400 de știri din datasetul AG News (fiecare are un titlu și o scurtă descriere), care are patru subiecte, și vom verifica dacă probabilitățile noastre corespund realității.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
În continuare, avem nevoie de o metodă de măsurare a calibrării. Eroarea de calibrare așteptată (ECE) grupează predicțiile în intervale de încredere și verifică cât de departe este în fiecare grup media încrederii de acuratețea reală.
Ca să fie clar, mai mic înseamnă mai bun:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Acum vine șmecheria.
Împărțim datele în două, folosim prima jumătate ca să găsim o temperatură care face probabilitățile mai oneste și apoi testăm pe a doua jumătate.
O temperatură peste 1 „înmoiă” predicțiile supraîncrezătoare, în timp ce o temperatură sub 1 ascuțește predicțiile subîncrezătoare.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Acuratețea nu se schimbă, pentru că împărțirea la o temperatură nu schimbă niciodată care opțiune e pe primul loc.
Se schimbă doar încrederea.
Numerele exacte depind de rularea ta, dar ECE pe jumătatea de test ar trebui, de obicei, să scadă. Cu doar 200 de exemple de test, estimarea e zgomotoasă, așa că nu trage concluzii din diferențe mici.
Lecția e simplă: faptul că un model este calibrat pe datele altcuiva nu înseamnă că e calibrat pe ale tale.
Ca să vezi cât de comună este ideea „evaluează, nu genera”, iată același lucru într-un context RAG.
Un cross-encoder punctează fiecare pasaj față de o întrebare și noi doar le sortăm:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Din nou, nu se generează nimic: modelul dă fiecărui candidat un număr.
Acestea sunt cazurile de utilizare care apar cel mai des:
| Caz de utilizare | Cum ajută un model de decizie |
|---|---|
| Rutarea agenților | Decide ce unealtă sau sub-agent ar trebui să preia pasul următor. |
| Guardrails | Semnalează prompt injection sau conținut nesigur înainte să ajungă la LLM. |
| Triaj pentru suport | Rutează tichetele după echipă, subiect și urgență. |
| Preluare documente | Răspunde la o listă fixă de întrebări despre fiecare document. |
| Căutare și RAG | Reordonează pasajele recuperate după relevanță. |
| Credit și fraudă | Evaluează riscul, deși deciziile despre oameni ar trebui totuși să implice o revizuire umană. |
| Robotică | Ar putea acționa ca un strat rapid între un planificator LLM lent și controlul motor de nivel jos, deși e încă speculativ. |
Punctul despre robotică este cel care îmi place personal cel mai mult.
Berryman sugerează că un model ca Jev ar putea sta între un LLM lent care face planuri de nivel înalt și modelele cinematice care mișcă articulațiile unui robot.
Merită știut totuși că demo-ul bine-cunoscut Doom al TypeSafe a alimentat Jev cu telemetrie în text și nu cu imagini brute.
Modelele de decizie sunt utile, dar nu vreau să le supra-vând.
Iată principalele limitări pe care le-am găsit și de care să ții cont:
Modelele de decizie AI iau o idee foarte veche — punctarea candidaților în locul generării răspunsurilor — și o fac mult mai ușor de folosit.
Nu ai nevoie de date de antrenare; primești răspunsuri tipizate înapoi și poți pune multe întrebări dintr-odată.
În opinia mea, ambalarea este inovația reală.
Mă aștept ca modelele de decizie să stea în jurul LLM-urilor ca porți rapide și ieftine care gestionează deciziile simple, astfel încât modelul scump să ruleze doar când chiar trebuie scris ceva.
Cursuri DataCamp de top
Traseu de învățare
Traseu de învățare
Practică și urmărește-ți progresul.
Continuă Cu Google