
Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleStell dir vor, du sitzt im Restaurant und der Kellner fragt: „Still oder mit Sprudel?“ Du antwortest nicht mit einem Absatz zu deinen Trinkgewohnheiten, sondern wählst eine der zwei Optionen.
Übertrag das auf unseren heutigen Einsatz großer Sprachmodelle (LLMs) in Apps. Wir fragen Dinge wie: „Geht es in diesem Support-Ticket um Abrechnung, Versand oder Rückgaben?“ – und das Modell schreibt uns einen ganzen Satz zurück, den wir dann mit Code parsen müssen. Realistisch gab es nur drei mögliche Antworten, aber wir haben dennoch für einen kompletten Gedankengang bezahlt.
Genau diese Lücke will dieser neue Modelltyp schließen. Im September 2026 hat ein Startup namens TypeSafe AI Jev veröffentlicht – ein Modell, das überhaupt keinen Text schreibt.
Stattdessen bewertet es eine feste Menge an Antworten und sagt dir, wie wahrscheinlich jede davon ist. Innerhalb weniger Wochen folgten OpenAI, Cloudflare, Perplexity und Microsoft mit eigenen Versionen – ein Zeichen, wie schnell sich dieses Feld bewegt.
In diesem Artikel schauen wir uns an, was KI-Entscheidungsmodelle sind, wie sie funktionieren und woher die Idee eigentlich kommt (sie ist deutlich älter, als der Hype vermuten lässt). Außerdem sehen wir uns an, was unabhängige Benchmarks ergeben haben.
if-Statement.Ein KI-Entscheidungsmodell nimmt einen Input und eine Menge erlaubter Antworten und gibt die Wahrscheinlichkeit jeder Antwort zurück – ohne freien Text zu generieren.
Die Grundidee ist, dass der Output bereits strukturiert ist.
Du musst nie einen Satz parsen, weil das Modell nur eine deiner vorgegebenen Antworten zurückgeben kann. Das Ergebnis kann also direkt in ein if-Statement in deinem Code.
Ich denke gern in Prüfungsformen.
Ein großes Sprachmodell schreibt eine Aufsatzprüfung, Wort für Wort, während ein Entscheidungsmodell eine Multiple-Choice-Prüfung ablegt – und zusätzlich sagt, wie sicher es sich bei jedem Kästchen ist (ein Konfidenzwert).
Jev und die meisten Jev-Alternativen unterstützen drei Fragetypen:
TypeSafe hat außerdem einen experimentellen Box-Typ zur Lokalisierung in Bildern, den ich hier auslasse.
Ein Beispiel aus TypeSafes eigener Dokumentation:
Du sendest einen state (das ist einfach der Text, den das Modell betrachten soll) und eine Map aus questions. Bei einer Choice-Frage hat jede Option eine Kurzbeschreibung im Feld criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Und so sah die Antwort dazu aus:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Es gibt keinen Text zu parsen.
Du erhältst die gewählte Option, eine Wahrscheinlichkeit für jede Option und einen Konfidenzwert, der aus der höchsten Wahrscheinlichkeit abgeleitet ist – eine flachere Verteilung bedeutet geringere Konfidenz. In der Doku teilt ein unübersichtlicheres Ticket, das sowohl falsche Größe als auch doppelte Abbuchung erwähnt, die Wahrscheinlichkeit zwischen Returns (0,61) und Billing (0,35), und die Konfidenz sinkt auf 0,42.
TypeSafe beschreibt Jev als „System One Model“ – entlehnt aus Daniel Kahnemans Buch Schnelles Denken, langsames Denken. Warum?
Vereinfacht gesagt ist System 1 dein schnelles Bauchgefühl, System 2 dein langsames, schrittweises Denken.
Ein Entscheidungsmodell soll das schnelle System sein.
Ein Vorbehalt: System 1 ist auch der Teil unseres Gehirns, der schnelle Fehler macht – und fairerweise listet TypeSafes eigene Doku offen auf, wo Jev danebenliegt. Darauf kommen wir zurück.
Verwirrend fand ich anfangs, dass „Entscheidungsmodell“ schon andere Bedeutungen hat. Es kann sich beziehen auf:
Zur Klarstellung: In diesem Artikel meint „Entscheidungsmodell“ ausschließlich die neue Modellkategorie, die Ende 2026 erschienen ist und typisierte Antworten bewertet, statt Text zu schreiben.
Bevor wir klären, wie Entscheidungsmodelle arbeiten, hilft ein Blick darauf, wie ein normales LLM seine Antwort erzeugt. Das macht den Unterschied greifbarer.
Ein großes Sprachmodell arbeitet in einer Schleife.
Es wandelt Text in Tokens, sagt eine Wahrscheinlichkeit für jedes Token im Vokabular voraus, wählt eines, hängt es an den Text und wiederholt das.
Jedes zusätzliche Token in der Antwort bedeutet einen weiteren Forward-Pass durchs Modell.
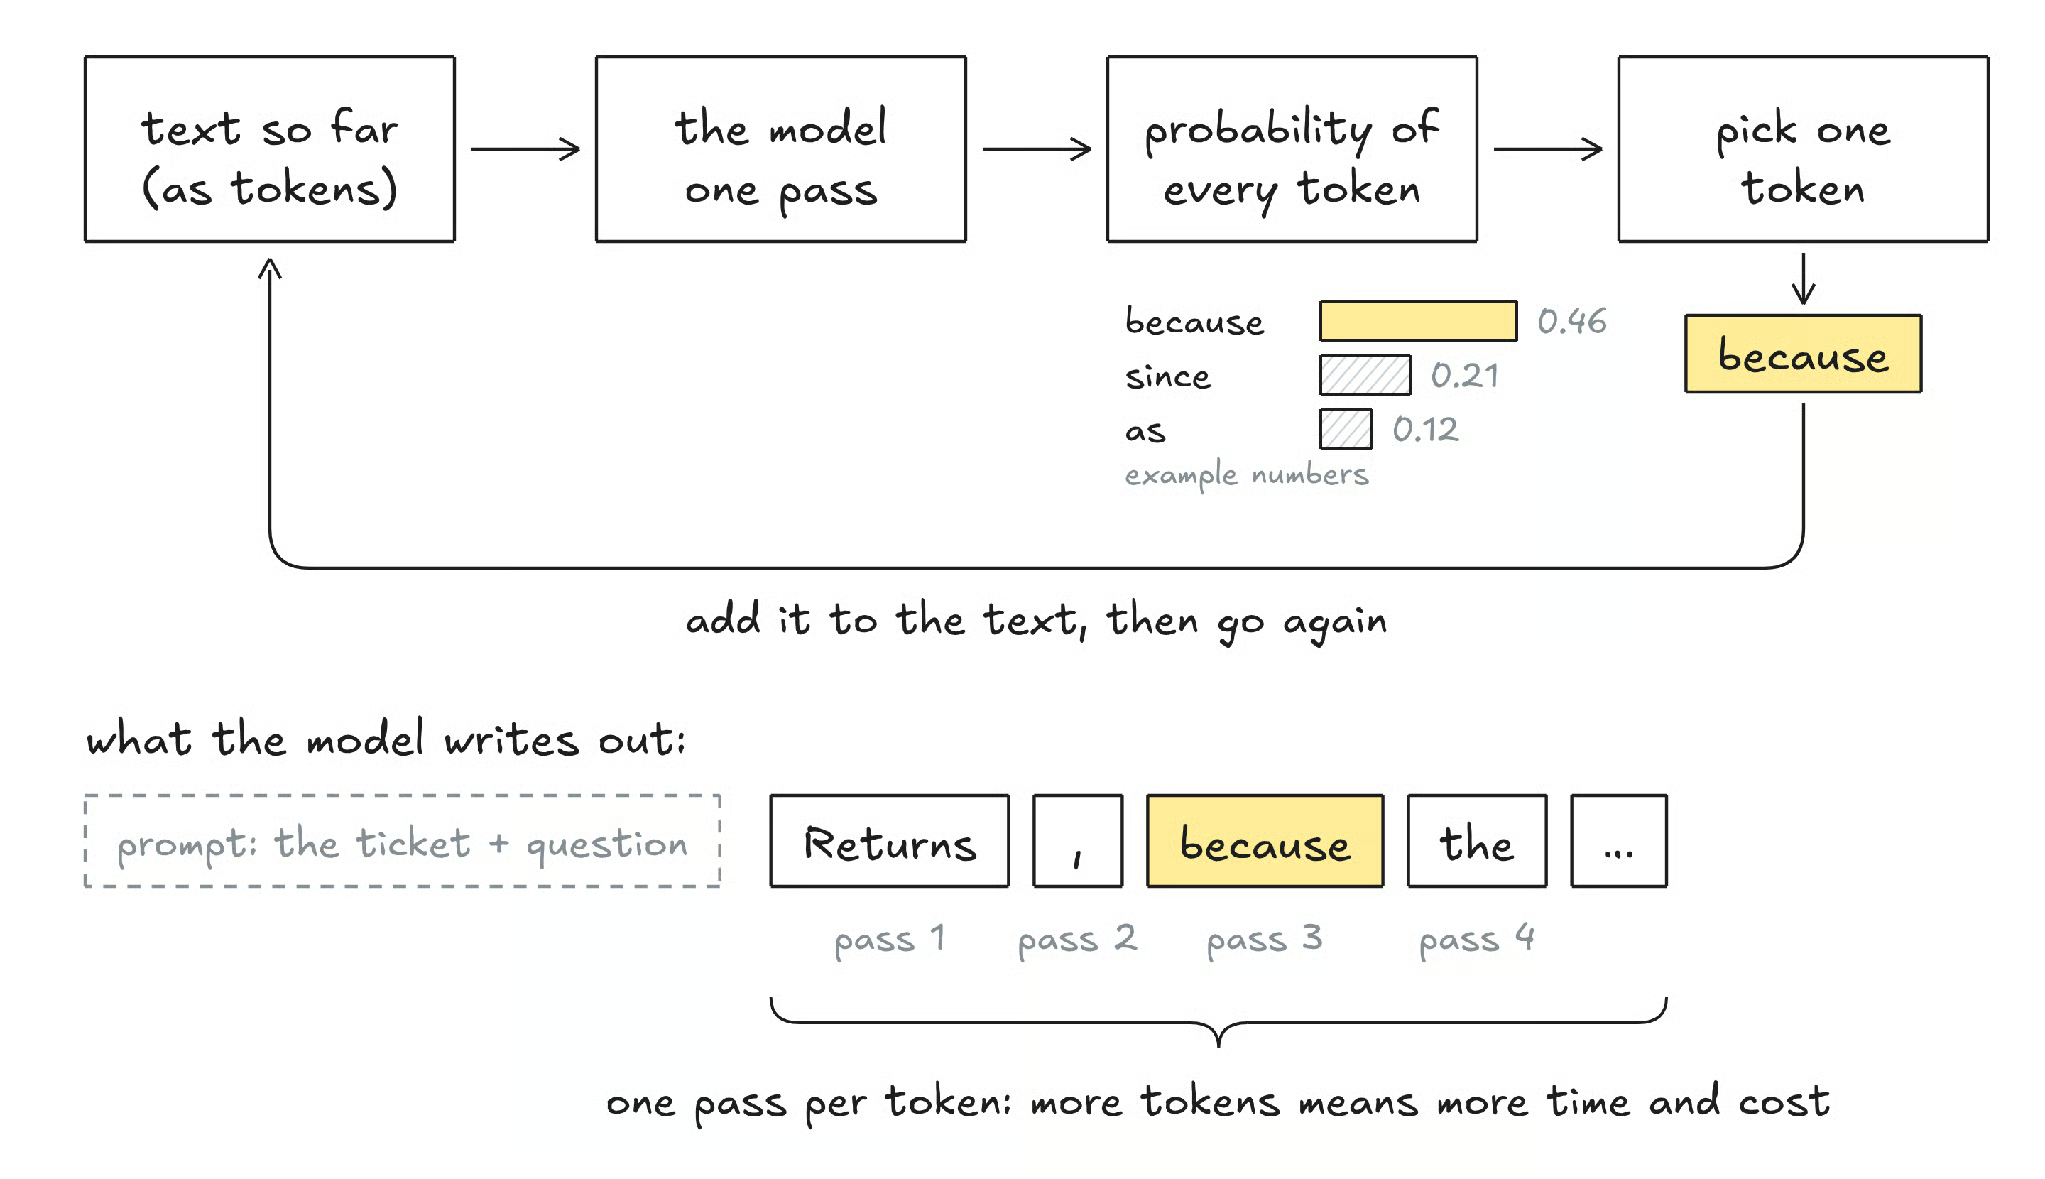
Abbildung 1: Ein LLM braucht einen Forward-Pass pro geschriebenem Token. Originalgrafik der Autorin/des Autors.
Für E-Mails, Code oder Erklärungen ist das großartig, aber bei simplen Entscheidungen entstehen Probleme:
Genau das wollen Entscheidungsmodelle beheben.
Kommen wir zur Mechanik.
Drei Ideen sind hier wichtig:
Schauen wir uns das im Einzelnen an.
Ein Entscheidungsmodell liest deinen Input und die Fragen und erzeugt für jede erlaubte Antwort einen Score.
Diese Scores werden typischerweise mit einer Softmax-Funktion in Wahrscheinlichkeiten umgewandelt. Wie du dir denken kannst, gibt es keine lange Schleife – es wird ja nichts geschrieben.
Laut TypeSafe werden Fragen in derselben Anfrage parallel bewertet, sodass zusätzliche Fragen die Antwortzeit kaum verändern.
Hier entsteht der größte Teil des Geschwindigkeitsvorteils, und TypeSafe nennt für Jev typischerweise rund 70 bis 500 Millisekunden.
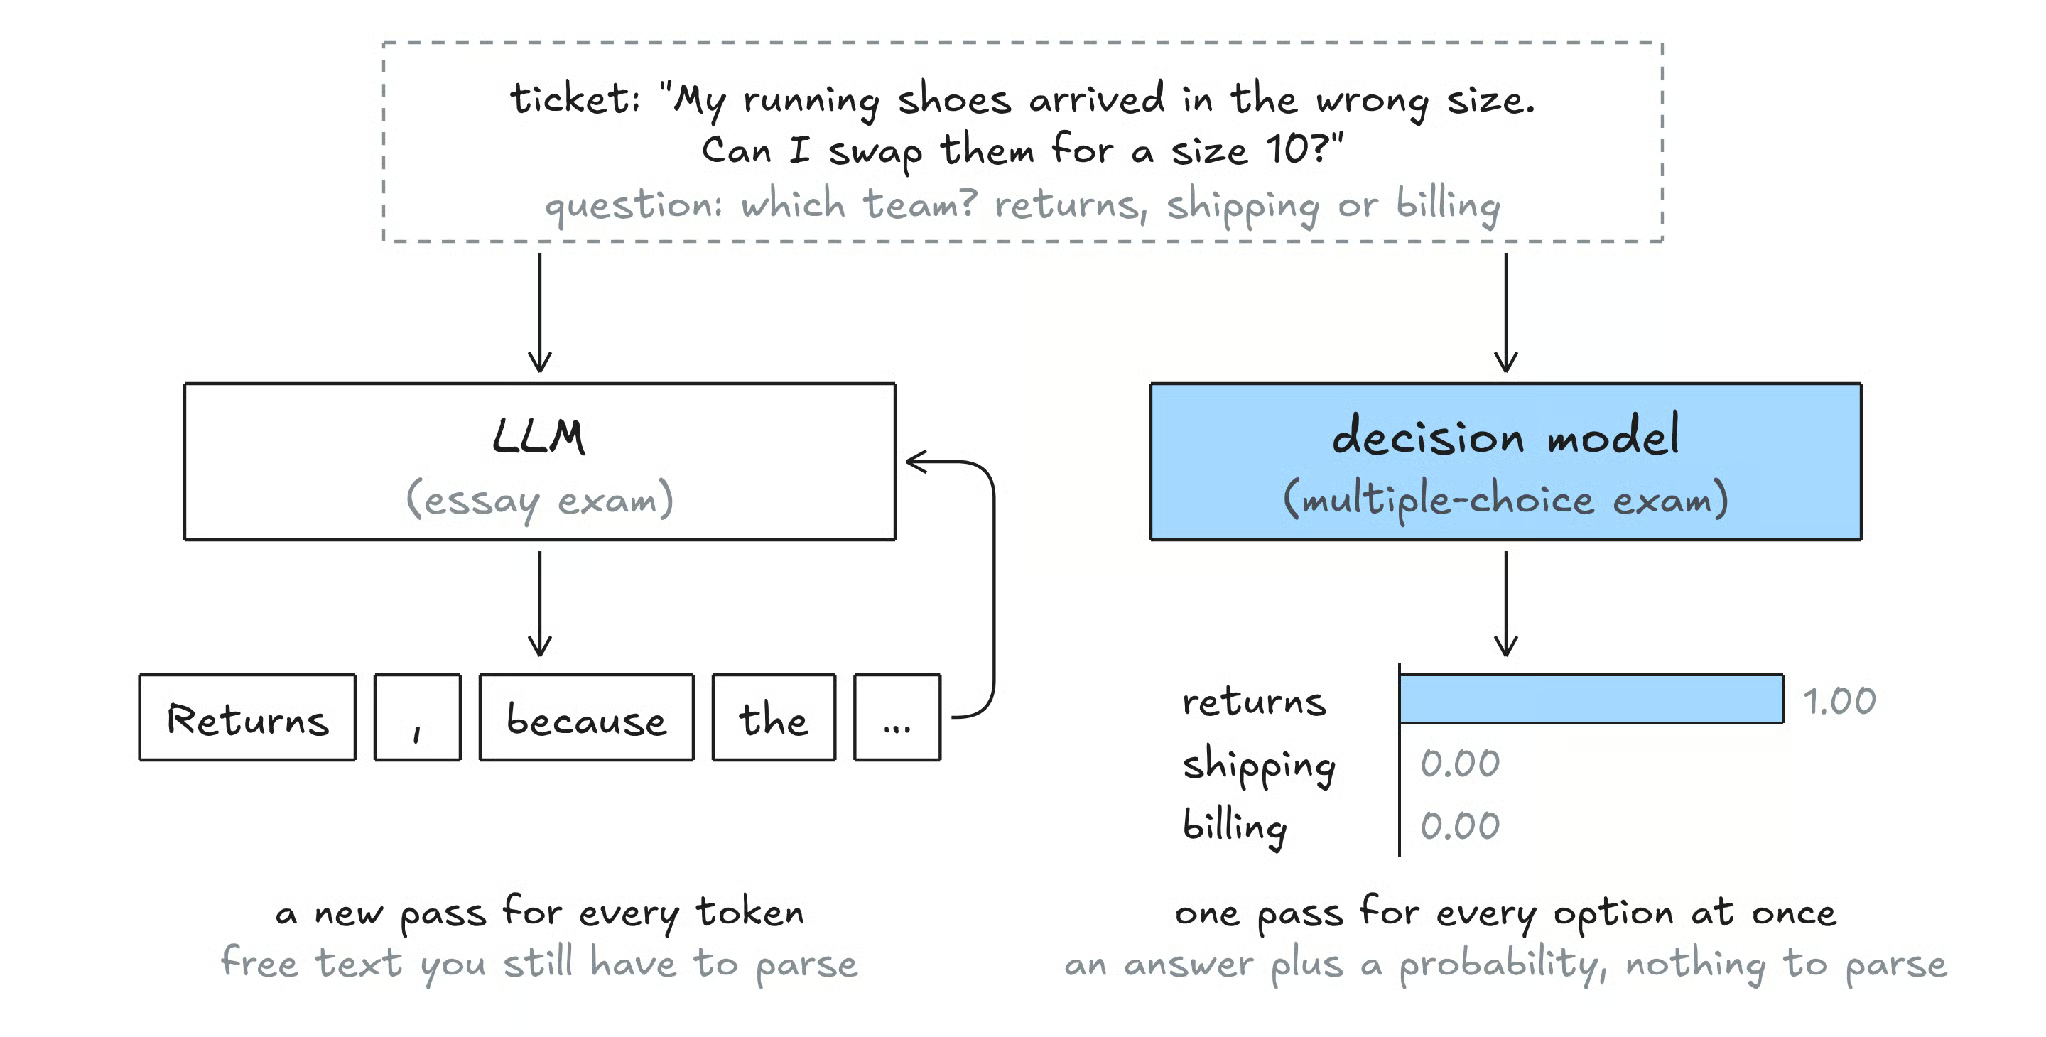
Abbildung 2: Dasselbe Ticket, beantwortet von einem LLM und von einem Entscheidungsmodell. Originalgrafik der Autorin/des Autors.
Es gibt keine einheitliche „Entscheidungsmodell-Architektur“.
TypeSafe hat Jevs Aufbau nicht veröffentlicht, aber grob drei Wege führen zu diesen Scores:
Welche Variante wo genutzt wird, ist zweitrangig: Am Ende steht in allen Fällen eine Zahl pro erlaubter Antwort.
Das ist aus meiner Sicht der wichtigste Teil, daher ein Beispiel.
Stell dir vor, ein Modell sagt bei 100 Fragen jeweils „70% wahrscheinlich“. Ist es gut kalibriert, sollten etwa 70 dieser Antworten korrekt sein.
Kalibrierung ist wichtig, weil uns kalibrierte Wahrscheinlichkeiten sichere Schwellenwerte im Code erlauben, etwa: „Ab 90% automatisch freigeben, sonst an einen Menschen schicken.“
Wenn Wahrscheinlichkeiten nicht zur Realität passen, sind solche Schwellenwerte wertlos.
Anbieter trainieren dafür mit Loss-Funktionen, die Überkonfidenz bestrafen.
TypeSafe nennt seinen Ansatz Reinforcement Learning for Calibrated Decisions (RLCD), während Cloudflare für seine Clef-Modelle Cross-Entropy mit einem Brier Loss kombiniert.
Überraschend vielleicht: Kandidaten zu bewerten, statt sie zu generieren, gibt es seit Jahren.
Meiner Meinung nach sind Entscheidungsmodelle eher die neueste und bequemste Ausprägung davon als eine völlig neue Erfindung. Die wichtigsten Modellfamilien, auf denen sie aufbauen:
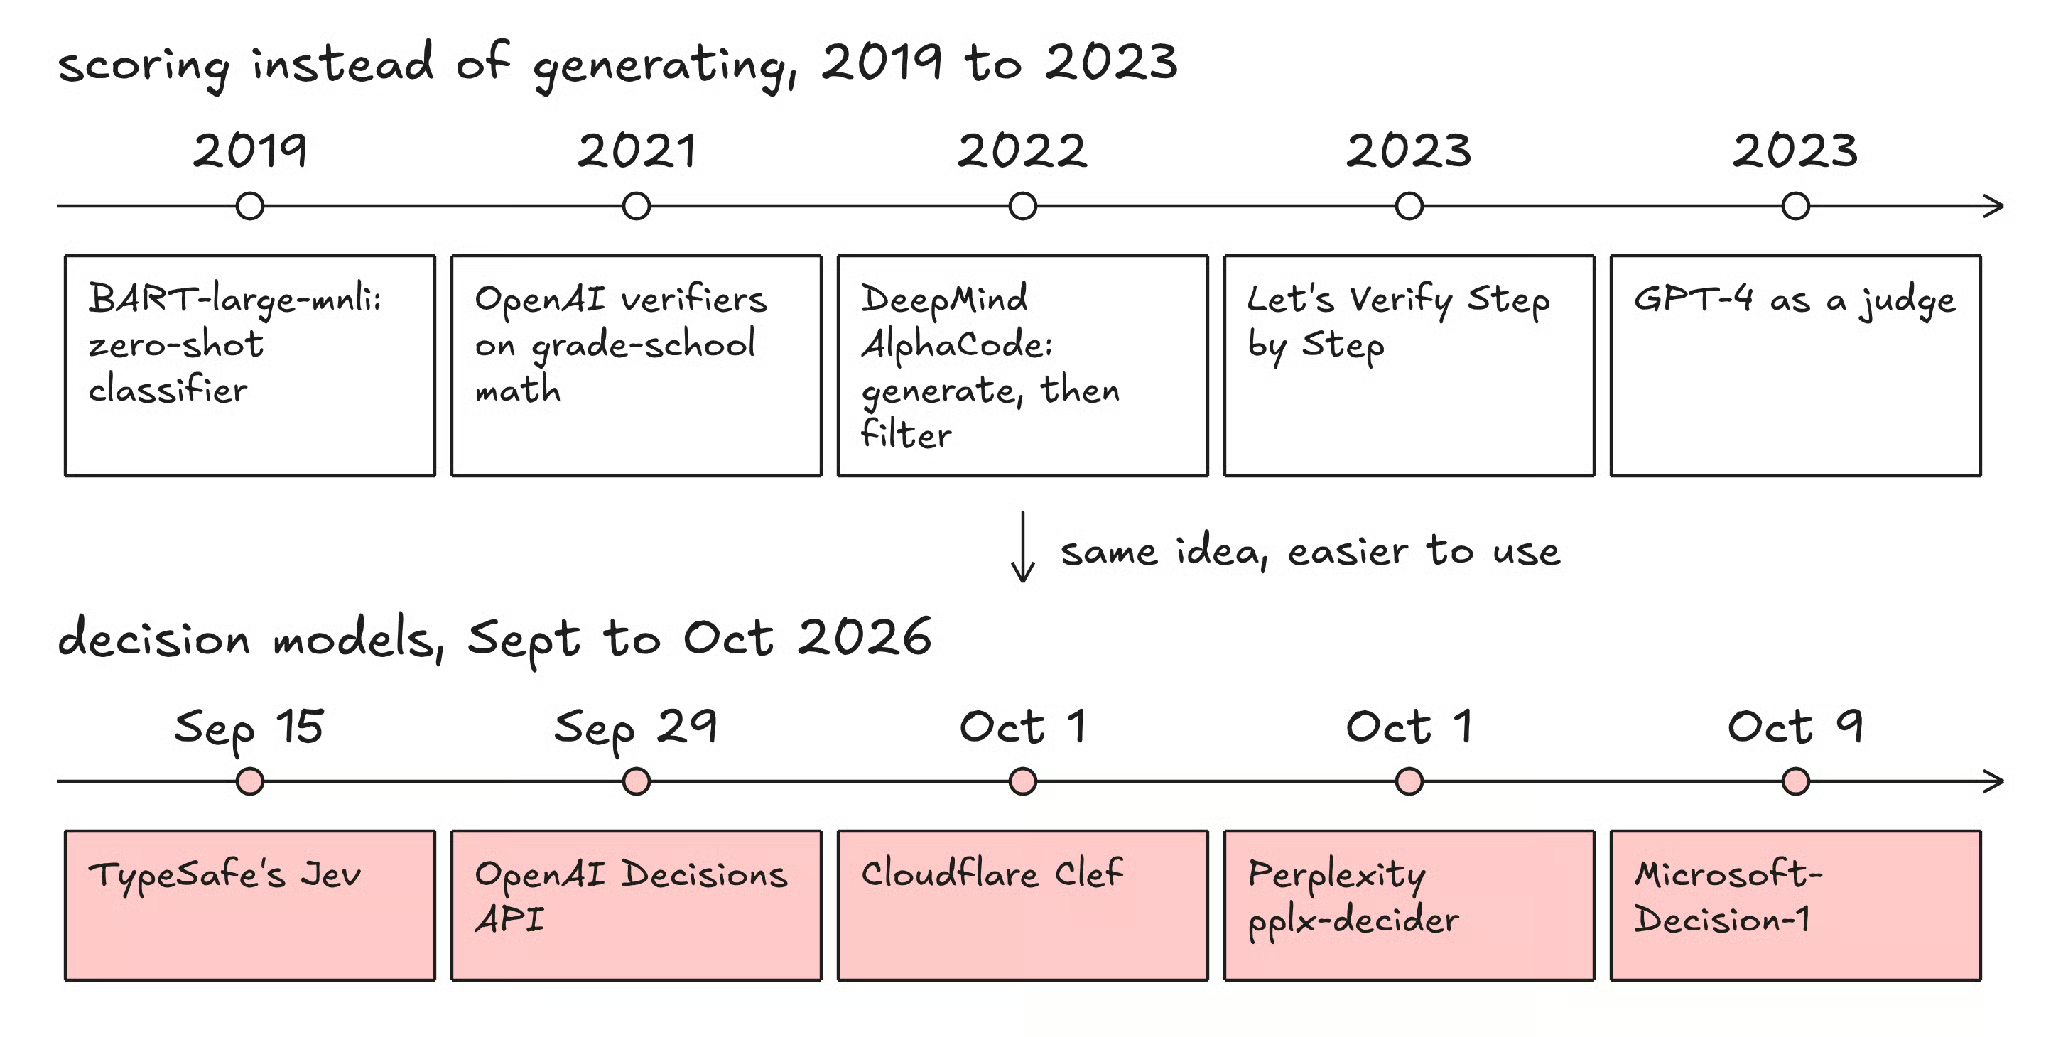
Abbildung 3: Scoring statt Generieren seit 2019; Entscheidungsmodelle sind die Version von 2026. Originalgrafik der Autorin/des Autors.
Schon 2019 konnten Modelle wie BART-large-mnli Texte in Labels sortieren, auf die sie nie explizit trainiert wurden.
Sie taten das, indem sie Aussagen wie „Dieser Text handelt von Abrechnung“ für jedes mögliche Label bewerteten.
Red Hats AI-Sicherheitsteam meint, Entscheidungsmodelle seien im Grunde genau solche Zero-Shot-Classifier unter neuem Namen.
Wenn du ein RAG-System gebaut hast, kennst du sie vermutlich. Du holst zuerst schnell eine Shortlist (z. B. 50 Dokumente), dann liest ein Cross-Encoder Frage und Dokument gemeinsam und vergibt für jedes Paar einen Relevanz-Score.
Es wird nichts generiert; die Dokumente werden nur nach Score umsortiert.
Das sind Scorer, die Antworten bewerten, die ein LLM bereits generiert hat.
2021 zeigten OpenAI-Forschende, dass ein Verifier einem Modell bei Grundschulmathe grob so viel brachte wie eine 30-fache Vergrößerung – bemerkenswert, wie ich finde.
Zwei Jahre später zeigte „Let’s Verify Step by Step“, dass das Bewerten einzelner Gedankenschritte noch besser funktioniert als nur das Endergebnis zu bewerten.
Die einfache Variante: Viele Antworten generieren, bewerten, die beste behalten. DeepMinds AlphaCode (2022) trieb das auf die Spitze, generierte bis zu eine Million Programme pro Aufgabe, verwarf rund 99% via Beispiels-Tests und reichte dann 10 ein.
In simulierten Auswertungen früherer Codeforces-Wettbewerbe lag es im Schnitt unter den besten 54,3% der menschlichen Teilnehmenden.
Warnung: Drückt man einen unvollkommenen Scorer zu hart, fällt die Qualität irgendwann – der Generator exploitet die Fehler des Scorers.
Der Fachbegriff dafür ist Reward Overoptimization.
Hier bewertet ein großes LLM die Ausgabe eines anderen Modells.
Eine Studie von 2023 fand, dass GPT-4 in über 80% der Fälle mit menschlichen Gutachten übereinstimmte, aber auch Bias zeigte, etwa Vorlieben für längere Antworten oder für die zuerst gezeigte Antwort.
Entscheidungsmodelle werden teils als günstigere, strukturierte Alternative zu solchen Richtern vermarktet.
Ein Energy-Based Model vergibt einen niedrigen „Energie“-Score an gut passende Input-Antwort-Paare und einen hohen an unpassende.
Eine Antwort zu wählen heißt dann: die niedrigste Energie finden – wieder Kandidaten scoren.
Yann LeCun argumentiert seit Jahren, dass Token-für-Token-Generierung nicht der Weg zu echter Intelligenz ist und dass Energy-Based-Ansätze und JEPA die bessere Richtung sind.
Kommen wir zu den tatsächlich veröffentlichten Modellen. Die Entwicklung ist rasant, daher fasse ich mich kurz.
TypeSafe AI ist ein Startup aus San Francisco, gegründet von Ex-OpenAI-Forscher Diogo Almeida; am 15. September 2026 kam es mit Jev aus dem Stealth-Modus und meldete eine Seed-Runde über 40 Mio. Dollar unter Führung von DCVC.
Jev ist eine gehostete API. In Produktion nimmt es Text; Bildinput ist experimentell und erfordert einen Opt-in-Header. Die Preisgestaltung basiert auf Input-Tokens, Outputs sind kostenlos – sinnvoll, wenn der Output nur wenige Zahlen sind.
Jev 1.14 folgte am 14. Oktober, allerdings zeigt der Alias jev-latest weiterhin auf 1.13.0 – die Version, die Red Hat später in diesem Artikel testete.
Rund um den Launch gab es viel Buzz. Vercel meldete, dass etwa 13% der zahlenden Teams Jev innerhalb der ersten 24 Stunden über das AI Gateway ausprobierten – es war dort zu dem Zeitpunkt kostenlos.
OpenAI kündigte die Decisions API auf der DevDay am 29. September 2026 an.
Sie arbeitet mit benutzerdefinierten Fragen mit fester Antwortmenge und basiert auf GPT-6 Luna. Am 6. Oktober ging sie in die Public Beta und kann auch Bilder verarbeiten, was Jev nur experimentell unterstützt.
Cloudflare veröffentlichte Clef und das kleinere Clef-flash am 1. Oktober 2026, mit offenen Gewichten und Hosting auf Workers AI. Beide basieren auf Qwen-Modellen und akzeptieren Jev-ähnliche Requests – Code für Jev lässt sich also mit minimalen Anpassungen auf Clef richten.
| Modell | Anbieter | Release (2026) | Zugang | Besonderheit |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1. Oktober | Offene Gewichte und API | Selbstberichtete 85,71% vs. Jevs 84,51% auf Perplexitys eigenem 11-Benchmark-Panel |
| Microsoft-Decision-1 | Microsoft | 9. Oktober | Foundry-Preview | Ein nachtrainiertes 9B-Qwen-Modell |
| Laya | Convai Innovations | September | Offene Gewichte | Klein (421 Mio. Parameter), läuft auf Laptop-CPU; laut Model Card Basis zur Spezialisierung, kein Zero-Shot-Arbeitstier |
Auffällig beim Zusammenstellen: Die meisten offenen und Big-Tech-Modelle hier sind feinabgestimmte Varianten normaler LLMs. Laya ist die Ausnahme: ein Encoder mit Decision-Head. Jevs Interna sind nicht offengelegt.
Für mich stützt das die These, dass die eigentliche Innovation im Packaging liegt (Interface und Training auf Kalibrierung) statt in einer völlig neuen Architektur.
Am einfachsten entscheidest du per Vergleich, wann was passt:
| Merkmal | LLM | Entscheidungsmodell | Feinabgestimmter Classifier | LLM + Verifier |
|---|---|---|---|---|
| Output | Freitext | Typisierte Antwort und Wahrscheinlichkeiten | Feste Labels | Best-of mehrerer generierter Antworten |
| Beschriftete Daten nötig | Nein | Nein | Ja | Oft |
| Geschwindigkeit | Sekunden | Dutzende bis Hunderte Millisekunden | Sehr schnell | Am langsamsten |
| Off-Format-Antworten | Möglich | Unmöglich | Unmöglich | Hängt vom Generator ab |
| Erklärt seine Antwort | Ja | Nein | Nein | Ja |
| Am besten für | Schreiben, Code, Reasoning | Routing, Triage, Guardrails | Eine feste, hochvolumige Aufgabe | Mathe, Code mit Tests |
Meine Faustregel:
Ich denke, die besten Systeme kombinieren alles davon.
Ich sehe Entscheidungsmodelle als schnelle Gates rund um ein LLM. Ein Gate entscheidet:
So läuft das teure LLM nur, wenn wirklich etwas geschrieben werden muss.
Dieser Abschnitt ist wichtig, denn viele große Zahlen online stammen von den Anbietern selbst. Selbst TypeSafe räumt ein, dass die Schlagzeilen zu Speed- und Kostenvorteilen das obere Ende dessen darstellen, was du in der Praxis sehen würdest.
Im Oktober 2026 verglich Red Hats AI-Sicherheitsteam neun Guardrail-Setups auf zwei Aufgaben: Prompt Injection erkennen und unsichere Inhalte erkennen.
DiffusionGemma ist ein Gemma-Text-Diffusionsmodell, serviert über vLLM.
Die interessantesten Ergebnisse:
| Methode | Typ | Prompt-Injection-Genauigkeit | Content-Safety-Genauigkeit |
|---|---|---|---|
| deberta-v3-base | Feinabgestimmter Classifier | 89,01% | - |
| granite-guardian-hap-125m | Feinabgestimmter Classifier | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Entscheidungsmodell (open) | 87,72% | 85,53% |
| Jev | Entscheidungsmodell | 86,35% | 86,20% |
| Laya | Entscheidungsmodell (open) | 85,44% | 57,87% |
| BART-large-mnli | Zero-Shot-Classifier von 2019 | 61,49% | 68,67% |
Jev lag bei Content Safety vorn – 0,67 Prozentpunkte vor DiffusionGemma (der Qwen-Judge wurde Dritter) – und beim Thema Prompt Injection gewann der Qwen-Judge.
Darum kann Red Hat unterm Strich sagen, dass Entscheidungsmodelle gegenüber LLM-Judges keinen Qualitätsgewinn zeigten.
Spannend finde ich, dass ein Classifier mit 200 Mio. Parametern nur 0,3 Punkte dahinter lag – bei Medianlatenz unter 100 Millisekunden gegenüber ca. 348 bei Jev.
Jevs Latenz beinhaltete eine Atlantik-Überquerung, da die Tests aus dem UK liefen und TypeSafes Server in den USA stehen.
Das erklärt aber nur den Abstand zu lokalen CPU-Modellen. Qwen, Nemotron und DiffusionGemma liefen ebenfalls in einem US-Cluster – und Qwen war trotzdem schneller als Jev.
Trotzdem schließt Red Hat: Entscheidungsmodelle lieferten in ihren Tests keine schnelleren, günstigeren oder besseren Antworten als LLM-as-a-judge – Ausnahme Laya, dessen geringe Größe ein echter Vorteil ist, wenn man um seine Grenzen herum prompten kann.
Eine Forschungsarbeit von Universitäten, im September 2026 auf arXiv, testete Jev auf 44 Alignment-Benchmarks.
Die Ergebnisse waren interessant gemischt:
Der Punkt zur selektiven Vorhersage ist in der Praxis sehr nützlich.
Er zeigt, dass ein Design, bei dem das Entscheidungsmodell die einfachen Fälle erledigt und unsichere an ein LLM oder einen Menschen weitergibt, eine gute Strategie ist.
Jetzt bauen wir selbst eines.
Wir machen aus einem kleinen offenen LLM ein Entscheidungsmodell mithilfe des vorhin beschriebenen Token-Probability-Tricks und prüfen dann, ob wir seinen Wahrscheinlichkeiten trauen können.
Zuerst installieren wir die Pakete (alles läuft in einem kostenlosen Colab-Notebook):
pip install transformers torch datasets sentence-transformers numpyWir nutzen Qwen2.5-0.5B-Instruct, klein genug für die CPU.
Die Idee ist simpel: Wir labeln Optionen mit Buchstaben, führen das Modell einmal aus und betrachten nur die Wahrscheinlichkeiten dieser Buchstaben als nächstes Token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Beachte: Wir rufen nie generate() auf. Wir machen einen Forward-Pass, behalten die Scores für „A“, „B“, „C“ usw. und verwerfen den Rest.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Und das war’s im Kern. In etwa 30 Zeilen haben wir ein funktionierendes Entscheidungsmodell gebaut.
Eine Ja/Nein-Frage ist einfach eine Choice-Frage mit zwei Optionen.
Schau dir an, wo diese einfache Version strauchelt.
Probiere, die Optionen zu durchmischen, und führe dieselbe Frage erneut aus:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Bei unübersichtlichen Inputs wie diesem verschieben sich die Wahrscheinlichkeiten oft allein durch die geänderte Reihenfolge.
Das nennt man Order Bias – TypeSafe listet eine Tendenz zur ersten Option sogar als bekannte Schwäche von Jev.
Du wirst auch häufig nahezu 100%-Antworten sehen. Berryman testete Jev schön: Er sagte, eine Münze lande zu 60% auf Kopf – die Ja/Nein-Frage ergab 0,58, nahe dran.
Die Choice-Frage („Kopf oder Zahl?“) gab jedoch 0,99 für Kopf zurück, weil die Wahrscheinlichkeit auf die wahrscheinlichere Antwort kollabierte.
Diesen Schritt sollte jeder machen. Wir nehmen 400 Meldungen aus dem AG News-Datensatz (jeweils Überschrift plus Kurzbeschreibung) mit vier Themen und prüfen, ob unsere Wahrscheinlichkeiten zur Realität passen.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Als Nächstes brauchen wir ein Kalibrierungsmaß. Expected Calibration Error (ECE) bündelt Vorhersagen in Konfidenz-Bins und prüft, wie weit die durchschnittliche Konfidenz im Bin von der tatsächlichen Genauigkeit abweicht.
Wichtig: Kleiner ist besser.
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Jetzt der Trick.
Wir teilen die Daten, nutzen die erste Hälfte, um eine Temperatur zu finden, die die Wahrscheinlichkeiten ehrlicher macht, und testen auf der zweiten Hälfte.
Eine Temperatur über 1 dämpft überkonfidente Vorhersagen, unter 1 schärft unterkonfidente.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Die Accuracy ändert sich nicht, weil das Teilen durch eine Temperatur nie die Rangfolge der Optionen ändert.
Nur die Konfidenz ändert sich.
Deine exakten Zahlen variieren, aber der ECE auf dem Test-Set sollte in der Regel sinken. Mit nur 200 Testbeispielen ist die Schätzung verrauscht – lies nichts in kleine Unterschiede hinein.
Die Lektion: Ein Modell, das auf fremden Daten kalibriert ist, ist nicht automatisch auf deinen kalibriert.
Um zu zeigen, wie verbreitet „Scoren statt Generieren“ ist, hier dasselbe im RAG-Setting.
Ein Cross-Encoder bewertet jeden Passus zur Frage, wir sortieren einfach:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Auch hier wird nichts generiert: Das Modell gibt zu jedem Kandidaten eine Zahl aus.
Diese Anwendungsfälle tauchen am häufigsten auf:
| Use Case | So hilft ein Entscheidungsmodell |
|---|---|
| Agent-Routing | Entscheidet, welches Tool oder welcher Sub-Agent den nächsten Schritt übernimmt. |
| Guardrails | Markiert Prompt Injection oder unsichere Inhalte, bevor sie das LLM erreichen. |
| Support-Triage | Leitet Tickets nach Team, Thema und Dringlichkeit weiter. |
| Dokumenteneingang | Beantwortet eine feste Checkliste pro Dokument. |
| Search und RAG | Rerankt gefundene Passagen nach Relevanz. |
| Kredit und Fraud | Bewertet Risiko – Entscheidungen über Menschen sollten dennoch Menschen einbeziehen. |
| Robotik | Könnte als schnelle Schicht zwischen langsamem LLM-Planer und Low-Level-Motorik dienen – bislang spekulativ. |
Die Robotik-Perspektive gefällt mir persönlich am besten.
Berryman schlägt vor, ein Modell wie Jev könnte zwischen einem langsamen, hochstufig planenden LLM und den kinematischen Modellen für die Gelenkbewegungen eines Roboters sitzen.
Wichtig zu wissen: TypeSafes bekanntes Doom-Demo fütterte Jev mit Text-Telemetrie – nicht mit Rohbildern.
Entscheidungsmodelle sind nützlich, aber ich will sie nicht überverkaufen.
Die wichtigsten Einschränkungen:
KI-Entscheidungsmodelle greifen eine alte Idee auf – Kandidaten scoren statt Antworten generieren – und machen sie viel einfacher nutzbar.
Du brauchst keine Trainingsdaten, bekommst typisierte Antworten zurück und kannst viele Fragen auf einmal stellen.
Für mich liegt die eigentliche Innovation im Packaging.
Ich erwarte, dass Entscheidungsmodelle rund um LLMs als schnelle, günstige Gates sitzen, die einfache Entscheidungen übernehmen – sodass das teure Modell nur läuft, wenn wirklich etwas geschrieben werden muss.
Top-DataCamp-Kurse
Lernpfad
Lernpfad
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Abid Ali Awan
7 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Josef Waples
3 Min.