แทร็ก
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย Googleลองจินตนาการว่ากำลังนั่งในร้านอาหารแล้วพนักงานถามว่า “น้ำเปล่าหรือโซดา?” คงไม่ตอบเป็นย่อหน้าว่าชอบดื่มน้ำแบบไหน แต่จะเลือกจากสองตัวเลือกที่มีให้
ลองคิดถึงวิธีที่ใช้โมเดลภาษาขนาดใหญ่ (LLMs) ในแอปส่วนใหญ่ทุกวันนี้ เราถามว่า “ทิกเก็ตนี้เกี่ยวกับการเรียกเก็บเงิน การจัดส่ง หรือการคืนสินค้า?” แล้วโมเดลก็เขียนประโยคเต็มกลับมา ซึ่งต้องเขียนโค้ดมาช่วยแยกความหมาย ทั้งที่จริงแล้วมีคำตอบเป็นไปได้แค่สามอย่าง แต่เรากลับจ่ายเงินให้ทั้งกระบวนการคิด
นี่คือช่องว่างที่โมเดลประเภทใหม่นี้พยายามจะเติมเต็ม ในกันยายน 2026 สตาร์ทอัปชื่อ TypeSafe AI เปิดตัว Jev โมเดลที่ไม่เขียนข้อความเลย
แทนที่จะเขียน มันจะให้คะแนนชุดคำตอบที่กำหนดไว้และบอกความเป็นไปได้ของแต่ละคำตอบ ภายในไม่กี่สัปดาห์ OpenAI, Cloudflare, Perplexity และ Microsoft ก็ออกเวอร์ชันของตนเอง แสดงให้เห็นว่าพื้นที่นี้พัฒนาเร็วมาก
ในบทความนี้ จะพาไปรู้จักว่าโมเดลตัดสินใจของ AI คืออะไร ทำงานอย่างไร และแนวคิดนี้มาจากไหนกันแน่ (จริง ๆ เก่ากว่ากระแสฮือฮานี้มาก) พร้อมดูผลการทดสอบอิสระ
if ในโค้ดได้ทันทีโมเดลตัดสินใจของ AI คือโมเดลที่รับอินพุตและชุดของคำตอบที่อนุญาต แล้วส่งกลับความน่าจะเป็นของแต่ละคำตอบ โดยไม่สร้างข้อความอิสระ
แนวคิดหลักคือเอาต์พุตมีโครงสร้างอยู่แล้ว
ไม่ต้องแยกวิเคราะห์ประโยค เพราะโมเดลส่งคืนได้เฉพาะหนึ่งในคำตอบที่ให้ไว้ นั่นหมายความว่าผลลัพธ์ส่งเข้า if ในโค้ดได้ทันที
นึกถึงข้อสอบสองประเภท
โมเดลภาษาขนาดใหญ่ทำข้อสอบอัตนัย เขียนคำตอบทีละคำ ในขณะที่โมเดลตัดสินใจทำข้อสอบปรนัย และยังบอกด้วยว่ามั่นใจแค่ไหนในแต่ละตัวเลือก (คะแนนความมั่นใจ)
Jev และ ทางเลือกแทน Jev ส่วนใหญ่รองรับคำถามสามแบบ:
TypeSafe ยังมี Box แบบทดลองสำหรับระบุตำแหน่งในภาพ ซึ่งจะไม่กล่าวถึงที่นี่
ยกตัวอย่างจากเอกสารของ TypeSafe
สามารถส่ง state (ข้อความที่ต้องการให้โมเดลดู) และแผนที่ของ questions สำหรับคำถามแบบ choice แต่ละตัวเลือกมีคำอธิบายสั้น ๆ ในฟิลด์ชื่อ criteria
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
และนี่คือคำตอบที่ได้:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
ไม่มีข้อความให้ต้องแยกวิเคราะห์
ได้ตัวเลือกที่ถูกเลือก ความน่าจะเป็นของทุกตัวเลือก และค่าความมั่นใจที่คำนวณจากความน่าจะเป็นสูงสุด ดังนั้นการกระจายที่แบนกว่าจะหมายถึงความมั่นใจต่ำกว่า ในเอกสาร ตัวอย่างทิกเก็ตที่ซับซ้อนขึ้นซึ่งพูดถึงไซส์ผิดและถูกเรียกเก็บเงินซ้ำ จะแบ่งความน่าจะเป็นระหว่าง returns (0.61) และ billing (0.35) และความมั่นใจลดลงเหลือ 0.42
TypeSafe อธิบาย Jev ว่าเป็น “System One Model” โดยยืมมาจากหนังสือ Thinking, Fast and Slow ของ Daniel Kahneman ทำไมจึงเป็นเช่นนั้น?
แบบง่ายที่สุด System 1 คือการตัดสินใจเร็วจากสัญชาตญาณ ส่วน System 2 คือเหตุผลแบบค่อยเป็นค่อยไป
โมเดลตัดสินใจถูกออกแบบมาให้เป็นแบบเร็ว
ข้อควรระวัง: System 1 ก็เป็นส่วนที่ทำผิดพลาดเร็วด้วย และต้องชื่นชมว่าเอกสารของ TypeSafe เองก็ระบุอย่างเปิดเผยว่า Jev พลาดตรงไหนบ้าง เดี๋ยวจะกลับมาที่จุดนี้
สิ่งหนึ่งที่ทำให้งงตอนอ่านครั้งแรกคือ “โมเดลตัดสินใจ” มีความหมายอย่างอื่นอยู่แล้ว อาจหมายถึง:
ดังนั้น เพื่อความชัดเจน ในบทความนี้ “โมเดลตัดสินใจ” หมายถึงเฉพาะหมวดโมเดลใหม่ที่ออกช่วงปลายปี 2026 ซึ่งให้คะแนนคำตอบแบบมีชนิด แทนการเขียนข้อความ
ก่อนดูว่าโมเดลตัดสินใจทำงานอย่างไร ควรเห็นก่อนว่า LLM ปกติสร้างคำตอบอย่างไร เชื่อว่าจะทำให้เห็นความต่างได้ชัดขึ้น
โมเดลภาษาขนาดใหญ่ทำงานเป็นลูป
มันแปลงข้อความเป็นโทเคน ทำนายความน่าจะเป็นของทุกโทเคนในคลังคำ เลือกหนึ่งโทเคน เพิ่มเข้าในข้อความ แล้วทำซ้ำ
โทเคนเพิ่มทุกตัวหมายถึงการทำ forward pass ผ่านโมเดลอีกครั้ง
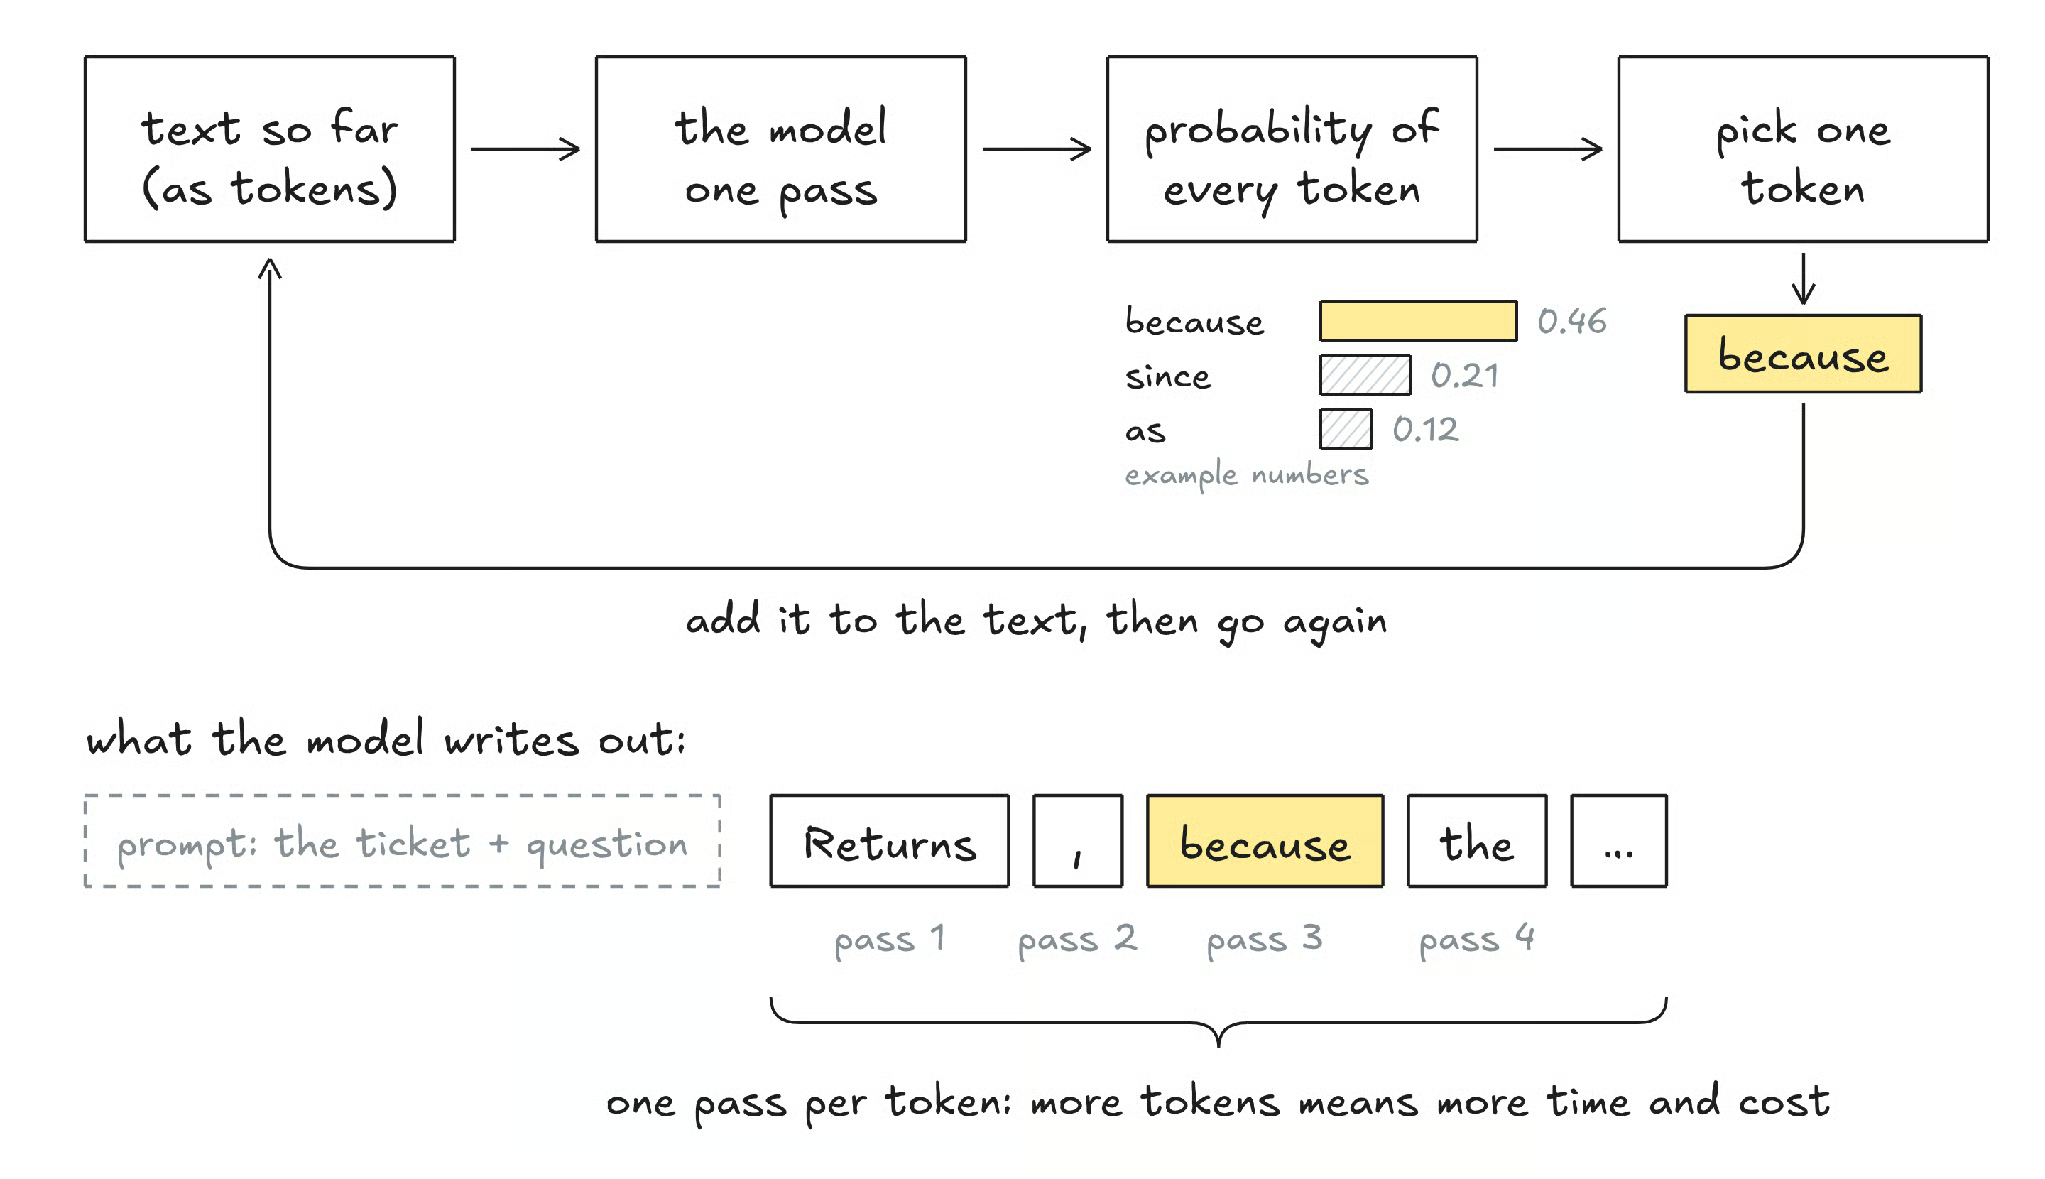
ภาพที่ 1: LLM ต้องทำ forward pass หนึ่งครั้งต่อโทเคนที่เขียน ภาพต้นฉบับโดยผู้เขียน
ลูปนี้เหมาะกับการเขียนอีเมล โค้ด หรือคำอธิบาย แต่พอเป็นการตัดสินใจง่าย ๆ อาจเกิดปัญหาบางอย่าง:
โมเดลตัดสินใจพยายามแก้ปัญหาเหล่านี้โดยตรง
มาดูเชิงกลไกจริง ๆ กัน
มีสามแนวคิดที่ควรเข้าใจ:
มาดูทีละข้อ
โมเดลตัดสินใจอ่านอินพุตและคำถาม แล้วสร้างคะแนนให้คำตอบที่อนุญาตแต่ละข้อ
คะแนนเหล่านั้นมักถูกแปลงเป็นความน่าจะเป็นด้วยฟังก์ชัน softmax อย่างที่เดาได้ ไม่มีลูปยาว ๆ เพราะไม่มีอะไรให้เขียน
เอกสารของ TypeSafe ยังระบุว่าคำถามในคำขอเดียวกันจะประเมินแบบขนาน ดังนั้นการเพิ่มคำถามแทบไม่กระทบเวลา
นี่คือแหล่งที่มาหลักของความเร็ว และ TypeSafe ระบุว่า Jev มักตอบในราว 70 ถึง 500 มิลลิวินาที
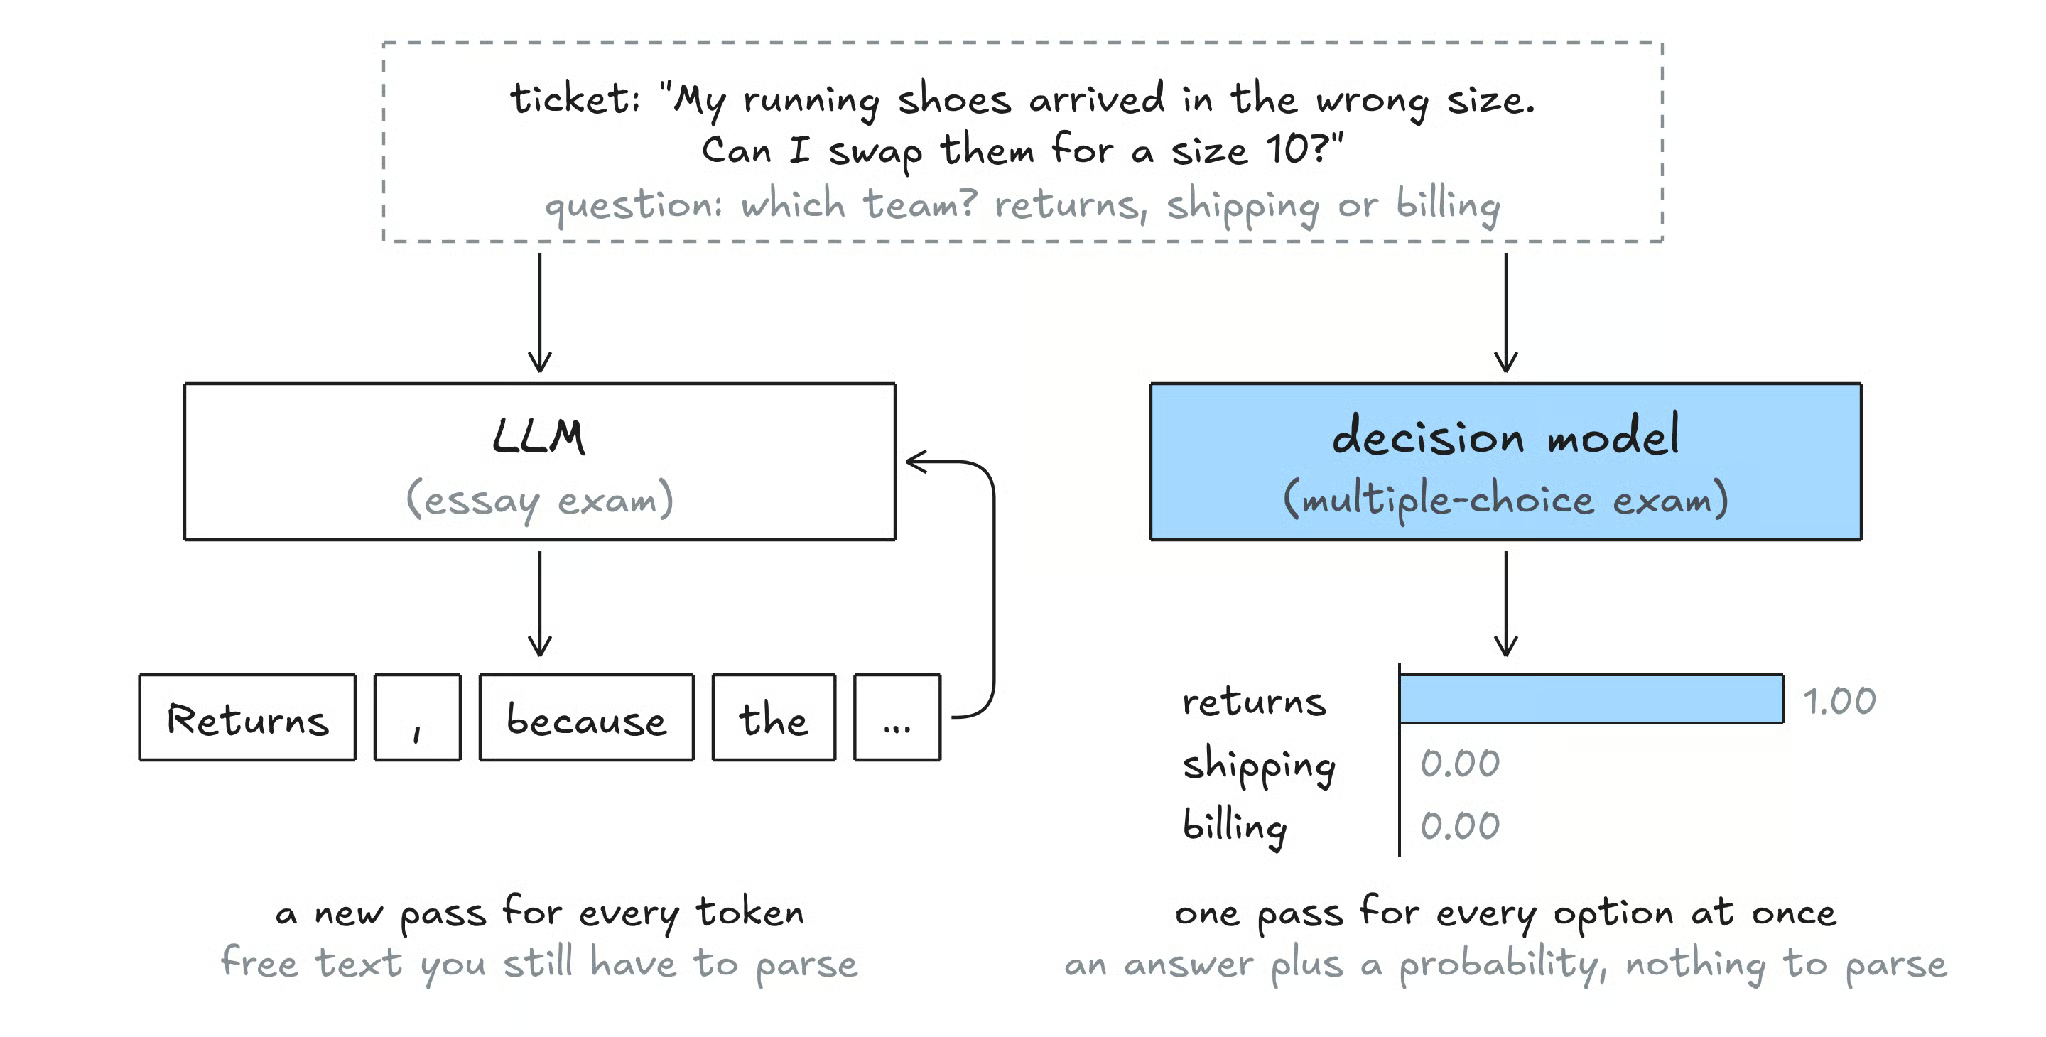
ภาพที่ 2: ทิกเก็ตเดียวกัน ตอบโดย LLM และโดยโมเดลตัดสินใจ ภาพต้นฉบับโดยผู้เขียน
ไม่ได้มี “สถาปัตยกรรมโมเดลตัดสินใจ” แบบเดียว
TypeSafe ไม่ได้เปิดเผยวิธีทำงานของ Jev แต่โดยคร่าว ๆ มีสามวิธีที่จะได้คะแนนเหล่านี้:
ไม่ต้องกังวลว่าใครใช้วิธีไหน ทั้งสามทางจบที่จุดเดียวกัน คือได้ตัวเลขให้กับคำตอบที่อนุญาตแต่ละข้อ
ส่วนนี้สำคัญที่สุด ขอยกตัวอย่าง
สมมติว่าโมเดลบอก “มีโอกาส 70%” บนคำถาม 100 ข้อ ถ้าโมเดลปรับเทียบดี ประมาณ 70 คำตอบควรจะถูกจริง
การปรับเทียบสำคัญเพราะความน่าจะเป็นที่ปรับเทียบดีจะทำให้เราตั้งเกณฑ์ในโค้ดได้อย่างปลอดภัย เช่น “อนุมัติอัตโนมัติถ้าเกิน 90% ไม่เช่นนั้นส่งให้มนุษย์”
ถ้าความน่าจะเป็นไม่ตรงกับความจริง เกณฑ์เหล่านั้นก็ไร้ความหมาย
ผู้ให้บริการจะฝึกด้วยฟังก์ชันสูญเสียที่ลงโทษความมั่นใจเกินจริง
TypeSafe เรียกวิธีของตนว่า Reinforcement Learning for Calibrated Decisions (RLCD) ส่วน Cloudflare ระบุว่าใช้ cross-entropy คู่กับ Brier loss สำหรับโมเดล Clef
อาจทำให้แปลกใจ แต่แนวคิดการให้คะแนนตัวเลือกแทนการสร้างคำตอบมีมาหลายปีแล้ว
ในความเห็นนี้ โมเดลตัดสินใจคือเวอร์ชันล่าสุดและสะดวกที่สุด มากกว่าจะเป็นสิ่งประดิษฐ์ใหม่หมด ต่อไปนี้คือครอบครัวโมเดลหลักที่แนวทางนี้ต่อยอดมา
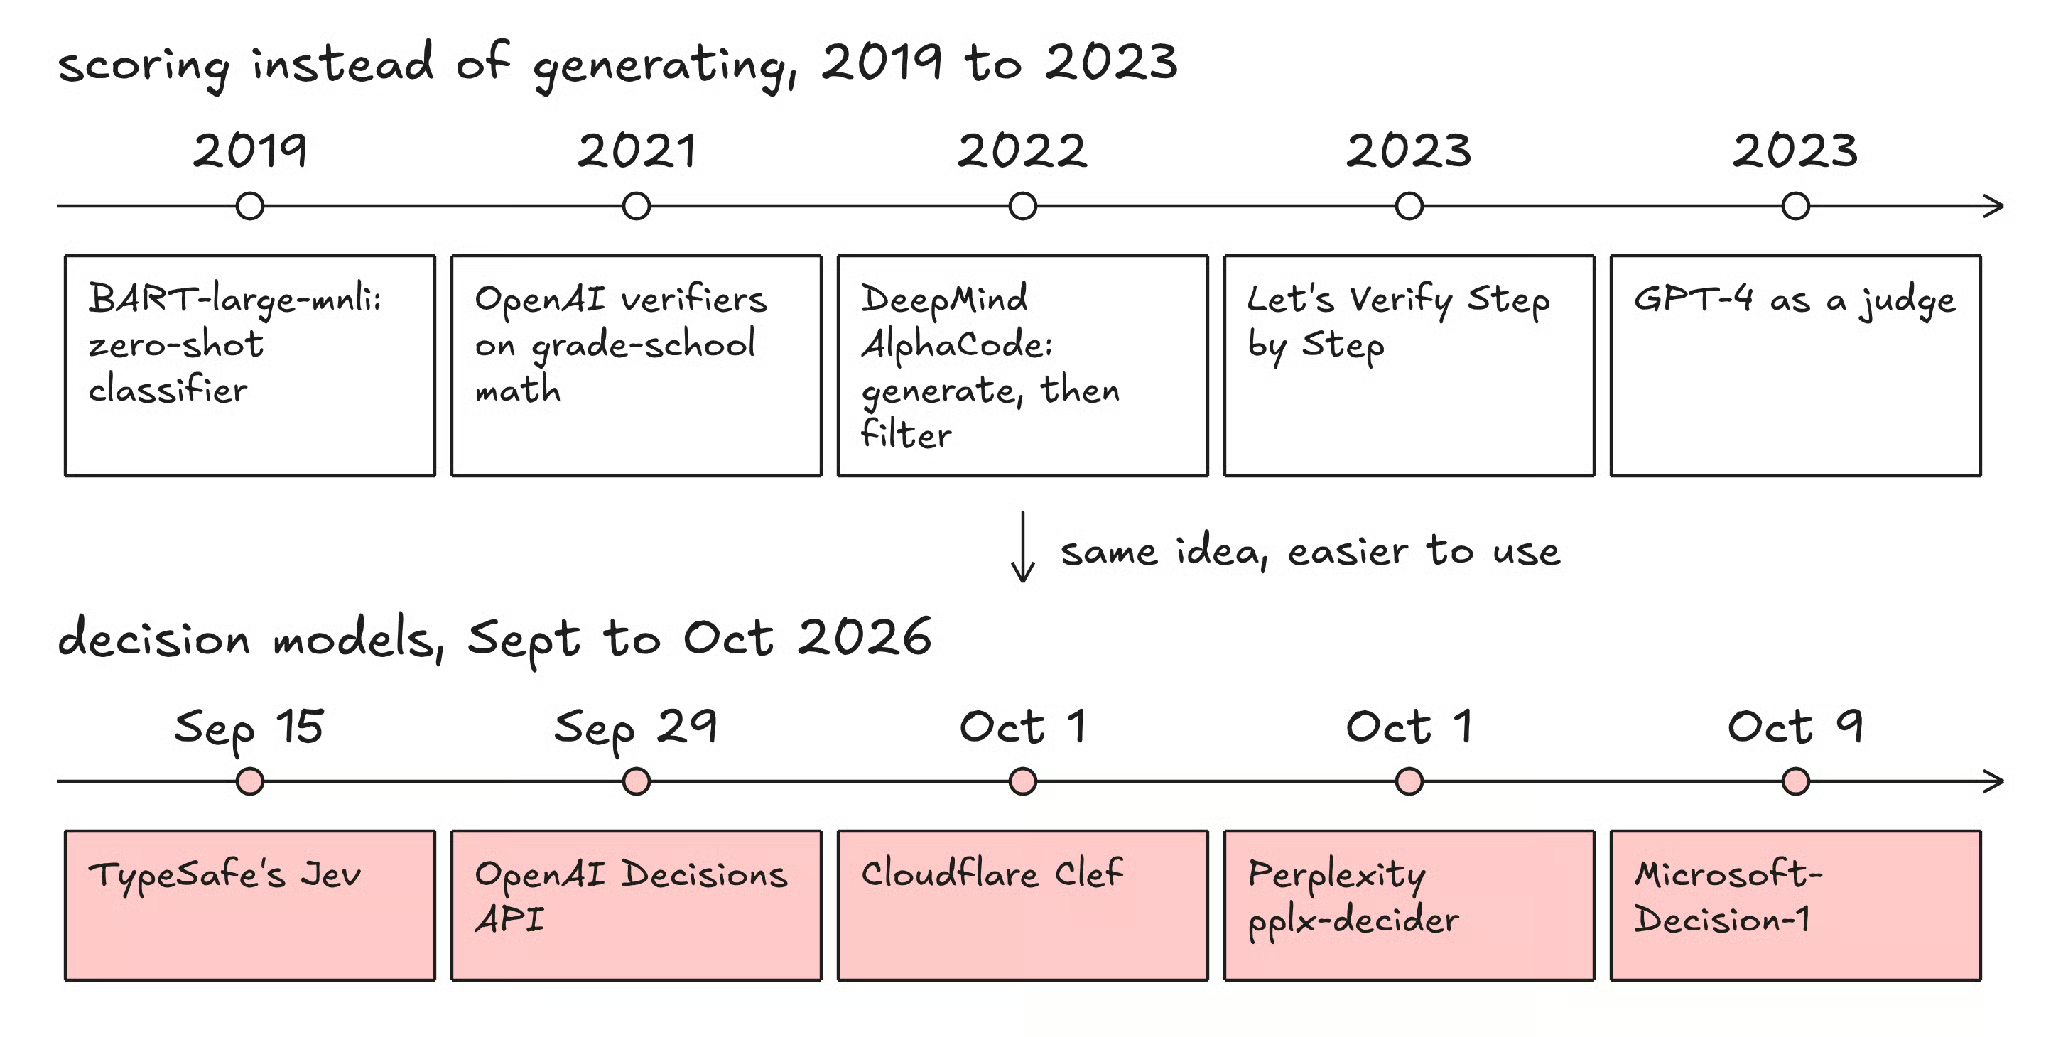
ภาพที่ 3: แนวคิดให้คะแนนแทนการสร้างย้อนไปถึงปี 2019 โมเดลตัดสินใจคือเวอร์ชันปี 2026 ภาพต้นฉบับโดยผู้เขียน
ย้อนไปปี 2019 โมเดลอย่าง BART-large-mnli ก็สามารถจัดข้อความเข้าเลเบลที่ไม่เคยฝึกมาก่อนได้แล้ว
ทำได้โดยให้คะแนนข้อความอย่าง “ข้อความนี้เกี่ยวกับการเรียกเก็บเงิน” สำหรับแต่ละเลเบลที่เป็นไปได้
ทีมความปลอดภัย AI ของ Red Hat เสนอว่า โมเดลตัดสินใจอาจเป็นเพียงคลาสสิฟายเออร์ zero-shot ภายใต้ชื่อใหม่
ถ้าเคยสร้างระบบ RAG น่าจะเคยใช้ คุณจะดึงรายการคร่าว ๆ มาก่อน (เช่น 50 เอกสาร) จากนั้น cross-encoder จะอ่านคำถามคู่กับแต่ละเอกสารและให้คะแนนความเกี่ยวข้องของแต่ละคู่
ไม่มีการสร้างข้อความ เอกสารถูกเรียงใหม่ตามคะแนนเท่านั้น
เป็นตัวให้คะแนนที่ให้คะแนนคำตอบที่ LLM สร้างมาแล้ว
ในปี 2021 นักวิจัย OpenAI แสดงให้เห็นว่าการเติม verifier ให้โมเดลช่วยเพิ่มผลลัพธ์คณิตศาสตร์ระดับประถมได้ประมาณ เท่ากับทำให้โมเดลใหญ่ขึ้น 30 เท่า ซึ่งน่าสนใจมาก
สองปีต่อมา งาน “Let’s Verify Step by Step” แสดงว่าการให้คะแนนแต่ละขั้นตอนของเหตุผลยิ่งได้ผลกว่าการให้คะแนนเฉพาะคำตอบสุดท้าย
เวอร์ชันง่าย ๆ คือสร้างหลายคำตอบ ให้คะแนนแต่ละคำ แล้วเก็บอันที่ดีที่สุด AlphaCode ของ DeepMind (2022) ทำขั้นสุดโดยสร้างโปรแกรมสูงสุดล้านโปรแกรมต่อปัญหา ทิ้งประมาณ 99% ด้วยการทดสอบตัวอย่าง แล้วส่งเพียง 10 อัน
ในการประเมินแบบจำลองบนการแข่งขัน Codeforces เก่า ๆ ทำได้เฉลี่ยอันดับท็อป 54.3% ของผู้แข่งขันมนุษย์
คำเตือน: ถ้ากดดันตัวให้คะแนนที่ไม่สมบูรณ์มากไป คุณภาพจะลดลงในที่สุด เพราะตัวสร้างจะ “เอาเปรียบ” ช่องโหว่ของตัวให้คะแนน
คำทางเทคนิคเรียก reward overoptimization
คือการให้ LLM ขนาดใหญ่มาตัดสินงานของโมเดลอื่น
งานปี 2023 พบว่า GPT-4 เห็นพ้องกับผู้ตัดสินมนุษย์เกิน 80% แต่ก็มีอคติ เช่น ชอบคำตอบยาวกว่า หรือคำตอบที่แสดงก่อน
โมเดลตัดสินใจถูกนำเสนอส่วนหนึ่งว่าเป็นตัวแทนที่ถูกกว่าและมีโครงสร้างสำหรับผู้ตัดสินแบบนี้
โมเดล energy-based จะให้ “พลังงาน” ต่ำกับคู่ของอินพุตและคำตอบที่เข้ากันได้ดี และพลังงานสูงกับคู่ที่ไม่เข้ากัน
การเลือกคำตอบจึงหมายถึงการหาพลังงานต่ำสุด ซึ่งก็คือการให้คะแนนตัวเลือกอีกแบบหนึ่ง
Yann LeCun โต้แย้งมาหลายปีว่าการสร้างทีละโทเคนไม่ใช่เส้นทางสู่ความฉลาดแท้ และแนวทาง energy-based และ JEPA น่าจะดีกว่า
ต่อไปพูดถึงโมเดลที่ออกจริงแล้ว พื้นที่นี้เปลี่ยนเร็วมาก จึงสรุปสั้น ๆ ทีละตัว
TypeSafe AI เป็นสตาร์ทอัปซานฟรานซิสโก ก่อตั้งโดย Diogo Almeida อดีตนักวิจัย OpenAI เปิดตัวจากสเตลธ์เมื่อ 15 กันยายน 2026 พร้อม Jev และเงินระดมทุนซีด 40 ล้านดอลลาร์นำโดย DCVC
Jev เป็น API แบบโฮสต์ ในโปรดักชันรับเฉพาะข้อความ อินพุตภาพยังเป็นแบบทดลองและต้องใส่เฮดเดอร์ opt-in คิดราคาเป็นโทเคนอินพุต เอาต์พุตฟรี ซึ่งสมเหตุสมผลเมื่อเอาต์พุตเป็นแค่ตัวเลขไม่กี่ตัว
Jev 1.14 ตามมาเมื่อ 14 ตุลาคม แม้ว่าแอลิแอส jev-latest ยังชี้ไปที่ 1.13.0 ซึ่งเป็นเวอร์ชันที่ Red Hat ทดสอบในบทความนี้
มีเสียงฮือฮามากตอนเปิดตัว Vercel ระบุว่าประมาณ 13% ของทีมแบบเสียค่าบริการลองใช้ Jev ผ่าน AI Gateway ภายใน 24 ชั่วโมงแรก แม้ว่าตอนนั้นใช้ฟรีบนเกตเวย์
OpenAI เปิดตัว Decisions API ในงาน DevDay วันที่ 29 กันยายน 2026
ทำงานกับคำถามที่ผู้ใช้กำหนดซึ่งมีชุดคำตอบตายตัว และสร้างบน GPT-6 Luna เข้าสู่ public beta วันที่ 6 ตุลาคม และรับภาพได้ด้วย ขณะที่ Jev รองรับแบบทดลองเท่านั้น
Cloudflare ออก Clef และ Clef-flash รุ่นเล็กในวันที่ 1 ตุลาคม 2026 พร้อมน้ำหนักโมเดลแบบเปิด และโฮสต์บน Workers AI ทั้งคู่สร้างบนโมเดล Qwen และรับคำขอรูปแบบเดียวกับ Jev ดังนั้นโค้ดที่เขียนให้ Jev สามารถชี้ไปที่ Clef ได้แทบไม่ต้องแก้
| โมเดล | ผู้พัฒนา | เปิดตัว (2026) | การเข้าถึง | รายละเอียดเด่น |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 ตุลาคม | น้ำหนักเปิดและ API | รายงานตนเอง 85.71% เทียบกับ Jev 84.51% บนชุด 11 เบนช์มาร์กของ Perplexity เอง |
| Microsoft-Decision-1 | Microsoft | 9 ตุลาคม | Foundry preview | Qwen ขนาด 9B ที่ post-train |
| Laya | Convai Innovations | กันยายน | น้ำหนักเปิด | ขนาดเล็ก (พารามิเตอร์ 421M) รันบน CPU แล็ปท็อปได้ การ์ดโมเดลระบุว่าเป็นฐานสำหรับปรับเฉพาะทาง ไม่ใช่เครื่อง zero-shot |
สิ่งที่สะดุดตาคือ โมเดลแบบเปิดและของบิ๊กเทคส่วนใหญ่ที่นี่เป็นเวอร์ชัน fine-tune ของ LLM ปกติ Laya เป็นข้อยกเว้น: เป็นเอนโคเดอร์ที่มี decision head ภายในของ Jev ไม่เปิดเผย
ในความเห็นนี้ สนับสนุนแนวคิดที่ว่านวัตกรรมจริงคือการแพ็กเกจ (อินเทอร์เฟซและการฝึกเพื่อการปรับเทียบ) มากกว่าสถาปัตยกรรมใหม่หมดจด
วิธีตัดสินใจที่ชัดที่สุดว่าเมื่อใดควรใช้อะไรคือเปรียบเทียบกัน:
| คุณลักษณะ | LLM | โมเดลตัดสินใจ | คลาสสิฟายเออร์แบบ fine-tune | LLM + verifier |
|---|---|---|---|---|
| เอาต์พุต | ข้อความอิสระ | คำตอบแบบมีชนิดและความน่าจะเป็น | เลเบลตายตัว | คำตอบที่ดีที่สุดจากหลายเอาต์พุตที่สร้าง |
| ต้องการข้อมูลติดเลเบล | ไม่ | ไม่ | ต้องการ | มักต้องการ |
| ความเร็ว | หน่วยวินาที | หลักสิบถึงหลักร้อยมิลลิวินาที | เร็วมาก | ช้าที่สุด |
| คำตอบผิดรูปแบบ | เป็นไปได้ | เป็นไปไม่ได้ | เป็นไปไม่ได้ | ขึ้นอยู่กับตัวสร้าง |
| อธิบายคำตอบได้ | ได้ | ไม่ได้ | ไม่ได้ | ได้ |
| เหมาะกับ | การเขียน โค้ด การใช้เหตุผล | การจัดเส้นทาง คัดกรอง ตั้งการ์ดเรล | งานเดี่ยวปริมาณสูงที่ตายตัว | คณิตศาสตร์ โค้ดที่มีเทสต์ |
กฎคร่าว ๆ คือ:
เชื่อว่าระบบที่ดีที่สุดจะผสมผสานทั้งหมดนี้
มองเห็นภาพว่าโมเดลตัดสินใจทำหน้าที่เป็น “เกต” ที่เร็วและถูก ล้อมรอบ LLM เกตจะตัดสินว่า:
แบบนี้ LLM ที่แพงจะทำงานเฉพาะเมื่อมีอะไรต้อง “เขียน” จริง
ส่วนนี้สำคัญที่สุด เพราะตัวเลขใหญ่ ๆ ออนไลน์ส่วนมากมาจากผู้ขายเอง แม้แต่ TypeSafe ก็ยอมรับว่าตัวเลขความเร็วและต้นทุนระดับพาดหัวเป็นด้านบน ๆ ของสิ่งที่จะเห็นจริง
ในตุลาคม 2026 ทีมความปลอดภัย AI ของ Red Hat เปรียบเทียบการตั้งค่าการ์ดเรล 9 แบบบนสองงาน: จับ prompt injection และจับคอนเทนต์ไม่ปลอดภัย
DiffusionGemma คือโมเดล text-diffusion ตระกูล Gemma ให้บริการผ่าน vLLM
ผลลัพธ์ที่น่าสนใจที่สุดมีดังนี้:
| วิธี | ประเภท | ความแม่นยำ prompt injection | ความแม่นยำความปลอดภัยเนื้อหา |
|---|---|---|---|
| deberta-v3-base | คลาสสิฟายเออร์แบบ fine-tune | 89.01% | - |
| granite-guardian-hap-125m | คลาสสิฟายเออร์แบบ fine-tune | - | 80.27% |
| Qwen3.6-35B | LLM-as-a-judge | 89.31% | 85.47% |
| DiffusionGemma | โมเดลตัดสินใจ (เปิด) | 87.72% | 85.53% |
| Jev | โมเดลตัดสินใจ | 86.35% | 86.20% |
| Laya | โมเดลตัดสินใจ (เปิด) | 85.44% | 57.87% |
| BART-large-mnli | คลาสสิฟายเออร์ zero-shot ปี 2019 | 61.49% | 68.67% |
Jev ได้ที่หนึ่งด้านความปลอดภัยเนื้อหา แซง DiffusionGemma อยู่ 0.67 จุดเปอร์เซ็นต์ (Qwen เป็นผู้ตัดสินอยู่อันดับสาม) ส่วน Qwen ได้ที่หนึ่งด้าน prompt injection
การแบ่งแบบนี้ทำให้ Red Hat ยังคงสรุปได้ว่าโดยรวมแล้วโมเดลตัดสินใจไม่ได้ให้คุณภาพดีกว่า LLM-as-a-judge
สิ่งที่น่าสนใจที่สุดคือ คลาสสิฟายเออร์ขนาด 200 ล้านพารามิเตอร์ตามหลังเพียง 0.3 จุดเปอร์เซ็นต์บน prompt injection โดยมี latency มัธยฐานต่ำกว่า 100 มิลลิวินาที เทียบกับราว 348 ของ Jev
Latency ของ Jev รวมการข้ามมหาสมุทรแอตแลนติก เพราะทดสอบจากสหราชอาณาจักรและเซิร์ฟเวอร์ของ TypeSafe อยู่ในสหรัฐฯ
การเดินทางนั้นอธิบายช่องว่างกับโมเดลที่รันบน CPU ในเครื่องได้บางส่วน Qwen, Nemotron และ DiffusionGemma ก็รันบนคลัสเตอร์ในสหรัฐฯ เช่นกัน และ Qwen ก็ยังเร็วกว่า Jev
ถึงอย่างนั้น Red Hat ก็สรุปว่า โมเดลตัดสินใจไม่ได้ให้คำตอบที่เร็วกว่า ถูกกว่า หรือดีกว่า LLM-as-a-judge ในการทดสอบของพวกเขา ยกเว้น Laya ที่มีข้อได้เปรียบจากขนาดเล็ก หากสามารถปรับพรอมป์ตล้อมข้อจำกัดได้
งานวิจัยจากนักวิจัยมหาวิทยาลัยที่โพสต์บน arXiv ในกันยายน 2026 ทดสอบ Jev บนเบนช์มาร์ก alignment 44 ชุด
ผลออกมาปะปนในแบบที่น่าสนใจ:
มองว่าประเด็นการคัดเลือกคำตอบที่มั่นใจมีประโยชน์มากในทางปฏิบัติ
มันแสดงว่าดีไซน์ง่าย ๆ ที่ให้โมเดลตัดสินใจจัดการเคสง่าย แล้วส่งเคสไม่มั่นใจไปให้ LLM หรือมนุษย์ เป็นกลยุทธ์ที่ดี
มาสร้างโมเดลตัดสินใจเองกัน
เราจะเปลี่ยน LLM แบบเปิดขนาดเล็กให้เป็นโมเดลตัดสินใจด้วยเทคนิคลความน่าจะเป็นโทเคนจากก่อนหน้า แล้วตรวจว่าความน่าจะเป็นน่าเชื่อถือหรือไม่
ก่อนอื่น ติดตั้งแพ็กเกจด้วยคำสั่งนี้ (ทั้งหมดรันบน Colab ฟรีได้):
pip install transformers torch datasets sentence-transformers numpyจะใช้ Qwen2.5-0.5B-Instruct ซึ่งเล็กพอจะรันบน CPU ได้
แนวคิดง่ายมาก: ติดฉลากตัวเลือกด้วยตัวอักษร รันโมเดลครั้งเดียว แล้วดูเฉพาะความน่าจะเป็นของตัวอักษรเหล่านั้นเป็นโทเคนถัดไป
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
สังเกตว่าเราไม่เรียก generate() เราทำforward pass ครั้งเดียว เก็บคะแนนของ “A” “B” “C” เป็นต้น แล้วทิ้งส่วนอื่น
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
เท่านี้เอง เราสร้างโมเดลตัดสินใจที่ใช้งานได้ในราว 30 บรรทัด
คำถามใช่/ไม่ใช่ ก็คือคำถามแบบ choice ที่มีสองตัวเลือก
มาดูว่ารุ่นง่าย ๆ นี้เริ่มลำบากตรงไหน
ลองสลับลำดับของตัวเลือก แล้วรันคำถามเดิมอีกครั้ง:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
บนอินพุตที่ยุ่งเหยิงแบบนี้ มักเห็นความน่าจะเป็นเปลี่ยนเพียงเพราะสลับตัวเลือก
นี่เรียกว่า order bias และ TypeSafe เองก็ระบุว่าเอนเอียงไปหาตัวเลือกแรกเป็นหนึ่งในจุดอ่อนของ Jev
อาจเห็นโมเดลให้คำตอบเกือบ 100% บ่อยครั้ง Berryman ทดสอบ Jev ไว้อย่างน่าสนใจ โดยบอกว่ามีโอกาสออกหัว 60% สำหรับการโยนเหรียญ คำถามใช่/ไม่ใช่ให้ค่า 0.58 ซึ่งใกล้เคียง
แต่คำถามแบบ choice (“หัวหรือก้อย?”) ให้0.99 สำหรับหัว เพราะความน่าจะเป็นยุบตัวไปที่คำตอบที่เป็นไปได้มากกว่า
ขั้นนี้คิดว่าทุกคนควรรัน เราจะใช้ข่าว 400 รายการจากชุดข้อมูล AG News (แต่ละรายการเป็นพาดหัวกับคำอธิบายสั้น ๆ) ซึ่งมี 4 หัวข้อ แล้วตรวจว่าความน่าจะเป็นของเราตรงกับความจริงไหม
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
ต่อไป เราต้องการตัวชี้วัดการปรับเทียบ Expected calibration error (ECE) จะแบ่งการพยากรณ์ตามช่วงความมั่นใจ แล้วตรวจว่าในแต่ละช่วง ค่าเฉลี่ยความมั่นใจห่างจากความแม่นยำจริงเท่าไร
ย้ำว่า ยิ่งต่ำยิ่งดี:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
เทคนิคคือ
แบ่งข้อมูลเป็นสองส่วน ใช้ครึ่งแรกหาอุณหภูมิที่ทำให้ความน่าจะเป็น “ซื่อสัตย์” ขึ้น แล้วทดสอบบนครึ่งหลัง
อุณหภูมิมากกว่า 1 จะทำให้การพยากรณ์ที่มั่นใจเกินไปนุ่มลง ขณะที่ต่ำกว่า 1 จะทำให้คำทำนายที่ไม่มั่นใจคมขึ้น
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
ความแม่นยำจะไม่เปลี่ยน เพราะการหารด้วยอุณหภูมิไม่เปลี่ยนตัวเลือกที่อันดับหนึ่ง
เปลี่ยนเฉพาะความมั่นใจ
ตัวเลขจริงขึ้นกับการรันของคุณ แต่ ECE บนครึ่งทดสอบมักลดลง ด้วยตัวอย่างทดสอบแค่ 200 ชิ้น ค่าประเมินมีนอยส์ จึงไม่ควรอ่านค่าต่างเล็ก ๆ มากเกินไป
บทเรียนง่าย ๆ คือ: โมเดลที่ปรับเทียบบนข้อมูลของคนอื่น ไม่ได้แปลว่าใช้ได้ดีบนข้อมูลของคุณ
เพื่อให้เห็นว่าแนวคิด “ให้คะแนน ไม่สร้าง” พบได้ทั่วไปแค่ไหน มาดูในบริบท RAG
cross-encoder ให้คะแนนแต่ละพารากราฟเทียบกับคำถาม แล้วเราเพียงเรียงลำดับ:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
อีกครั้ง ไม่มีการสร้างอะไร โมเดลแค่ให้ตัวเลขกับแต่ละตัวเลือก
นี่คือเคสใช้งานที่พบบ่อยที่สุด:
| เคสใช้งาน | โมเดลตัดสินใจช่วยอย่างไร |
|---|---|
| Agent routing | ตัดสินใจว่าเครื่องมือหรือซับเอเจนต์ใดควรจัดการขั้นตอนถัดไป |
| Guardrails | ตั้งธง prompt injection หรือเนื้อหาไม่ปลอดภัยก่อนถึง LLM |
| คัดแยกทิกเก็ตซัพพอร์ต | จัดเส้นทางทิกเก็ตตามทีม หัวข้อ และความเร่งด่วน |
| รับเอกสารเข้า | ตอบเช็กลิสต์คำถามตายตัวเกี่ยวกับแต่ละเอกสาร |
| การค้นหาและ RAG | จัดอันดับพารากราฟที่ค้นคืนตามความเกี่ยวข้อง |
| เครดิตและฉ้อโกง | ให้คะแนนความเสี่ยง แม้ว่าการตัดสินเกี่ยวกับบุคคลยังควรมีมนุษย์ร่วมทบทวน |
| หุ่นยนต์ | อาจทำหน้าที่เป็นชั้นที่เร็วระหว่าง LLM วางแผนที่ช้า กับการควบคุมมอเตอร์ระดับต่ำ อย่างไรก็ดี ยังเป็นการคาดการณ์ |
ด้านหุ่นยนต์เป็นจุดที่ชอบเป็นการส่วนตัว
Berryman เสนอว่าโมเดลแบบ Jev อาจนั่งอยู่ระหว่าง LLM ช้า ๆ ที่วางแผนระดับสูง กับโมเดลคิเนเมติกที่ขยับข้อต่อหุ่นยนต์
แต่ควรรู้ว่าเดโม Doom ของ TypeSafe ที่โด่งดังนั้นป้อน telemetry แบบข้อความ ให้ Jev ไม่ใช่ภาพดิบ
โมเดลตัดสินใจมีประโยชน์ แต่ไม่อยากขายเกินจริง
ข้อจำกัดหลักที่พบมีดังนี้:
โมเดลตัดสินใจของ AI นำแนวคิดเก่าแก่เรื่องการให้คะแนนตัวเลือกแทนการสร้างคำตอบมาทำให้ง่ายต่อการใช้งานมากขึ้น
ไม่ต้องมีข้อมูลฝึก ได้คำตอบแบบมีชนิดกลับมา และถามหลายคำถามพร้อมกันได้
ในความเห็นนี้ การแพ็กเกจนี่แหละคือนวัตกรรมจริง
คาดว่าโมเดลตัดสินใจจะวางตัวล้อมรอบ LLM เป็นเกตที่เร็วและถูก จัดการการตัดสินใจง่าย ๆ เพื่อให้โมเดลที่แพงทำงานเฉพาะเมื่อจำเป็นต้องเขียนจริง
คอร์สยอดนิยมจาก DataCamp
แทร็ก
แทร็ก
ฝึกฝนและตรวจสอบความก้าวหน้าของคุณ
ดำเนินการต่อด้วย Google