
Cursus
Associate AI Engineer pour développeurs
26 h
S'entraîner et cursus vos progrès.
Continuer Avec GoogleImaginez que vous vous asseyez au restaurant et que le serveur vous demande : « Plate ou gazeuse ? ». Vous ne répondez pas avec un paragraphe sur vos préférences d’hydratation ; vous choisissez l’une des deux options proposées.
Maintenant, pensez à la façon dont nous utilisons les grands modèles de langage (LLM) dans la plupart des applications aujourd’hui. On leur pose des questions comme « Ce ticket de support concerne-t-il la facturation, la livraison ou les retours ? » et le modèle nous renvoie une phrase complète, que l’on doit ensuite analyser dans du code. En réalité, il n’y avait que trois réponses possibles, mais nous avons quand même payé pour tout un raisonnement.
C’est précisément l’écart que cette nouvelle catégorie de modèles tente de combler. En septembre 2026, une startup appelée TypeSafe AI a publié Jev, un modèle qui ne génère pas de texte.
À la place, il note un ensemble fixe de réponses et indique la probabilité de chacune. En quelques semaines, OpenAI, Cloudflare, Perplexity et Microsoft ont sorti leurs propres versions, preuve de la vitesse à laquelle le domaine évolue.
Dans cet article, je vous propose de découvrir ce que sont ces modèles de décision en IA, comment ils fonctionnent et d’où vient réellement l’idée (elle est bien plus ancienne que l’engouement actuel ne le laisse penser). Nous verrons aussi ce que montrent les benchmarks indépendants.
if.Un modèle de décision en IA prend une entrée et un ensemble de réponses autorisées et renvoie la probabilité de chaque réponse, sans générer de texte libre.
L’idée clé est que la sortie est déjà structurée.
Vous n’avez jamais à analyser une phrase, car le modèle ne peut renvoyer que l’une des réponses que vous lui avez fournies. Le résultat peut donc aller directement dans une instruction if dans votre code.
J’aime comparer la différence à deux types d’examens.
Un grand modèle de langage passe un examen de dissertation, en écrivant sa réponse mot à mot, tandis qu’un modèle de décision passe un QCM et indique aussi son niveau de certitude pour chaque case (un score de confiance).
Jev et la plupart des alternatives à Jev prennent en charge trois types de questions :
TypeSafe propose aussi un type expérimental Box pour localiser des éléments dans des images, que je laisserai de côté ici.
Voici un exemple tiré de la documentation officielle de TypeSafe.
Vous pouvez envoyer un state (le texte que vous voulez que le modèle lise) et une map de questions. Pour une question de type choix, chaque option est décrite brièvement dans un champ criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Et voici la réponse correspondante :
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Il n’y a aucun texte à analyser.
Vous obtenez l’option choisie, une probabilité pour chaque option, et une valeur de confiance dérivée de la probabilité la plus élevée : une distribution plus plate signifie une confiance plus faible. Dans la documentation, un ticket plus ambigu qui mentionne à la fois une mauvaise pointure et une double facturation répartit la probabilité entre returns (0,61) et billing (0,35), et la confiance tombe à 0,42.
TypeSafe décrit Jev comme un « System One Model », en référence au livre de Daniel Kahneman Système 1 / Système 2 : Les deux vitesses de la pensée. Pourquoi ?
Pour faire simple, le Système 1 correspond à un jugement rapide, intuitif ; le Système 2 à un raisonnement lent et pas à pas.
Un modèle de décision vise à être le rapide.
Une réserve toutefois : le Système 1 est aussi celui qui fait des erreurs hâtives, et, à son crédit, la documentation de TypeSafe liste ouvertement là où Jev se trompe. Nous y reviendrons.
Un point m’a dérouté au départ : « modèle de décision » peut déjà désigner d’autres choses. Cela peut renvoyer à :
Pour être clair, dans cet article, un « modèle de décision » désigne uniquement cette nouvelle catégorie de modèles apparue fin 2026 qui note des réponses typées au lieu d’écrire du texte.
Avant d’expliquer comment travaillent les modèles de décision, il est utile de voir comment un LLM classique produit sa réponse. La différence en devient plus évidente.
Un grand modèle de langage fonctionne en boucle.
Il convertit notre texte en tokens, prédit une probabilité pour chaque token de son vocabulaire, en choisit un, l’ajoute au texte, puis recommence.
Chaque token supplémentaire dans la réponse implique un nouveau passage avant à travers le modèle.
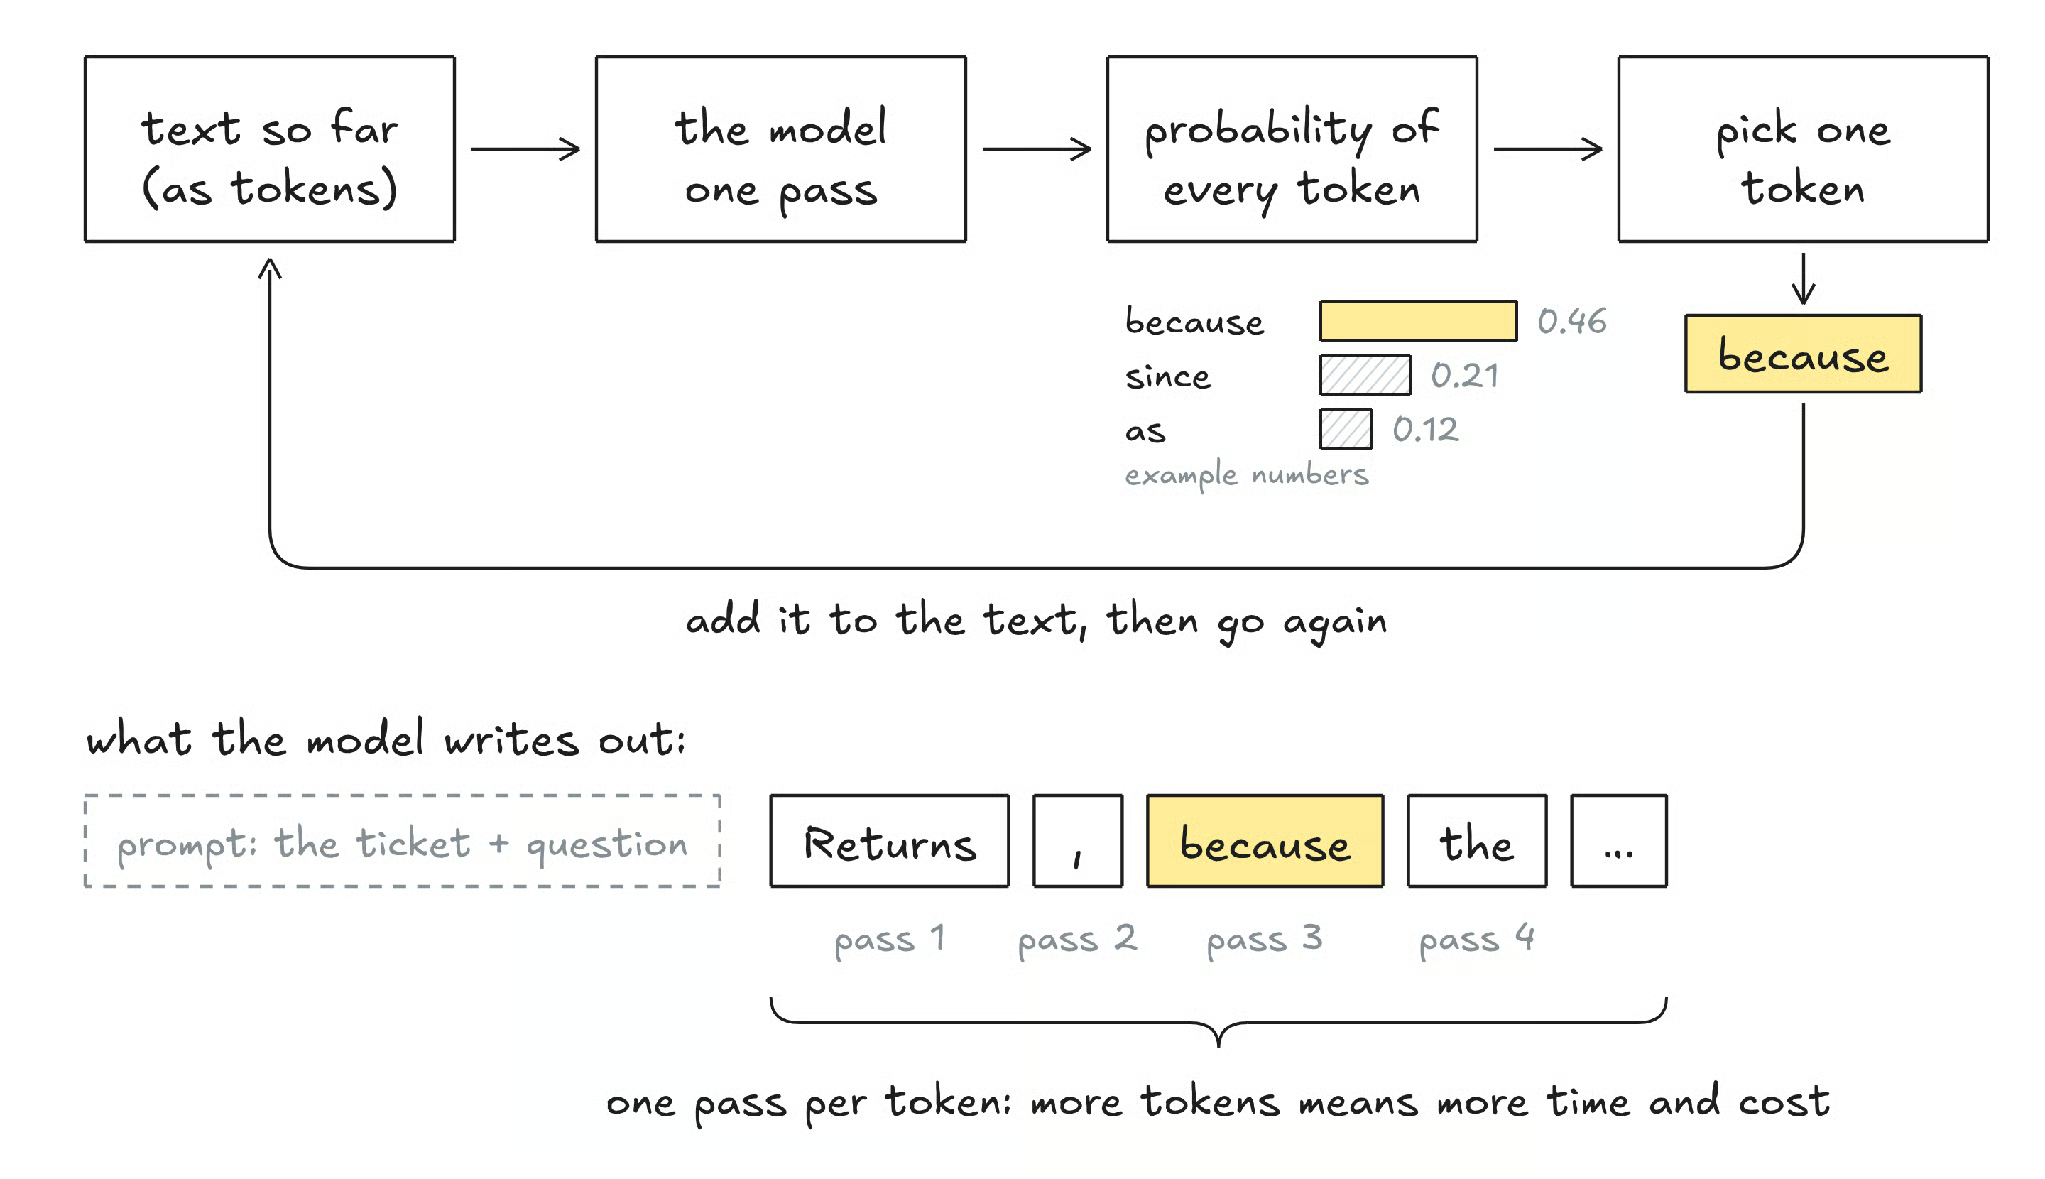
Figure 1 : un LLM a besoin d’un passage avant pour chaque token qu’il écrit. Image originale de l’auteur.
Cette boucle est idéale pour écrire des e-mails, du code ou des explications, mais pour des décisions simples, elle pose quelques problèmes :
Les modèles de décision cherchent précisément à corriger ces points.
Passons maintenant à la mécanique.
Trois idées méritent d’être comprises :
Voyons chacune d’elles plus en détail.
Un modèle de décision lit votre entrée et les questions et produit un score pour chaque réponse autorisée.
Ces scores sont généralement convertis en probabilités via une fonction softmax. Comme vous pouvez l’imaginer, il n’y a pas de longue boucle, puisqu’il n’y a rien à écrire.
La documentation de TypeSafe précise aussi que les questions d’une même requête sont évaluées en parallèle, de sorte qu’en ajouter a peu d’impact sur le temps de réponse.
C’est la principale source de vitesse, et TypeSafe annonce des réponses typiques de Jev autour de 70 à 500 millisecondes.
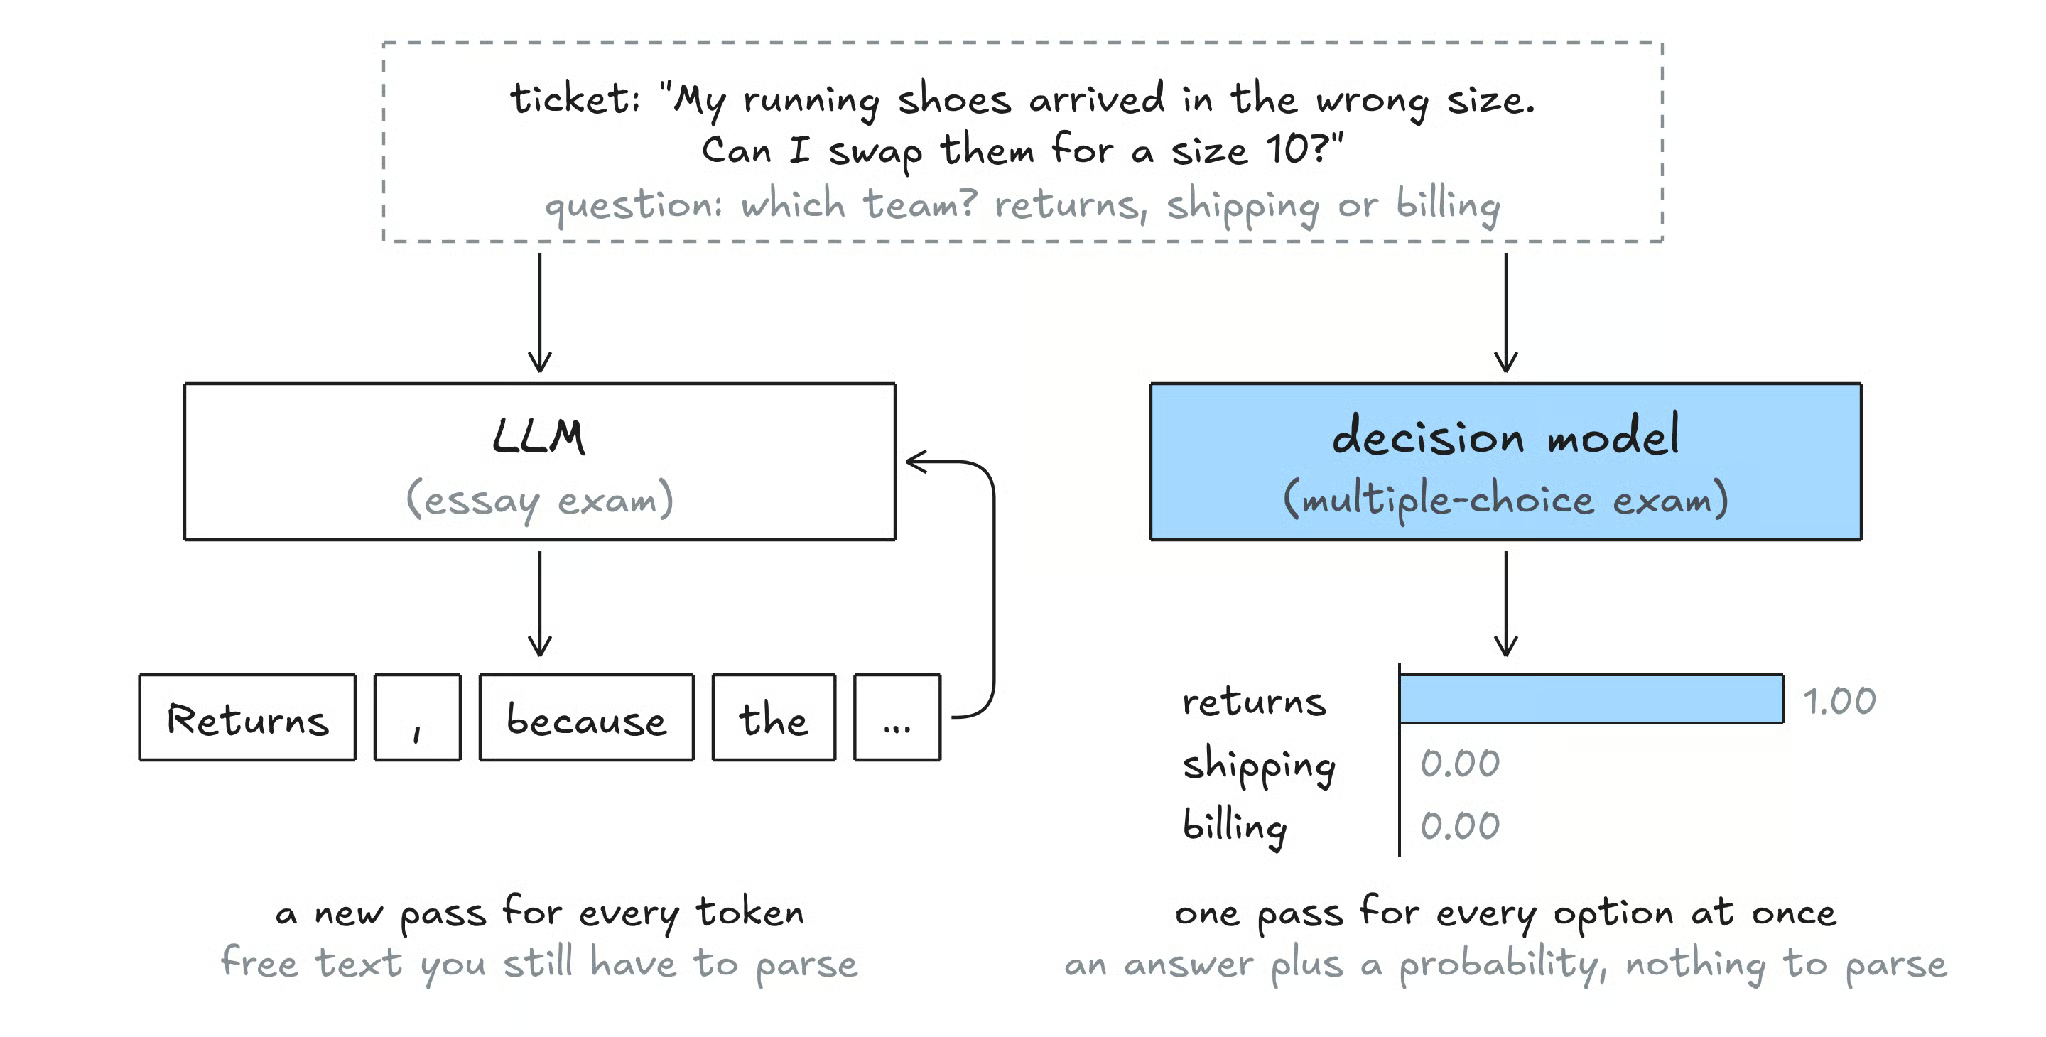
Figure 2 : le même ticket, traité par un LLM et par un modèle de décision. Image originale de l’auteur.
Il n’existe pas une unique « architecture de modèle de décision ».
TypeSafe n’a pas publié le fonctionnement interne de Jev, mais il y a grosso modo trois façons d’obtenir ces scores :
Peu importe laquelle est employée : les trois aboutissent au même résultat, un nombre par réponse autorisée.
C’est, selon moi, l’aspect le plus important : prenons un exemple.
Imaginez qu’un modèle affiche « 70 % de probabilité » sur 100 questions différentes. S’il est bien calibré, environ 70 de ces réponses devraient être correctes.
La calibration compte, car des probabilités calibrées permettent de fixer des seuils sûrs dans le code, comme « approuver automatiquement au-dessus de 90 %, sinon envoyer à un humain ».
Si les probabilités ne correspondent pas à la réalité, ces seuils n’ont plus de sens.
Les fournisseurs entraînent ce comportement via des fonctions de perte qui pénalisent l’excès de confiance.
TypeSafe appelle sa méthode Reinforcement Learning for Calibrated Decisions (RLCD), tandis que Cloudflare indique associer entropie croisée et perte de Brier pour ses modèles Clef.
Surprise : l’idée de noter des candidats au lieu de les générer existe depuis des années.
À mon avis, les modèles de décision en sont la dernière version, plus pratique, plutôt qu’une invention radicalement nouvelle. Voici les principales familles sur lesquelles ils s’appuient.
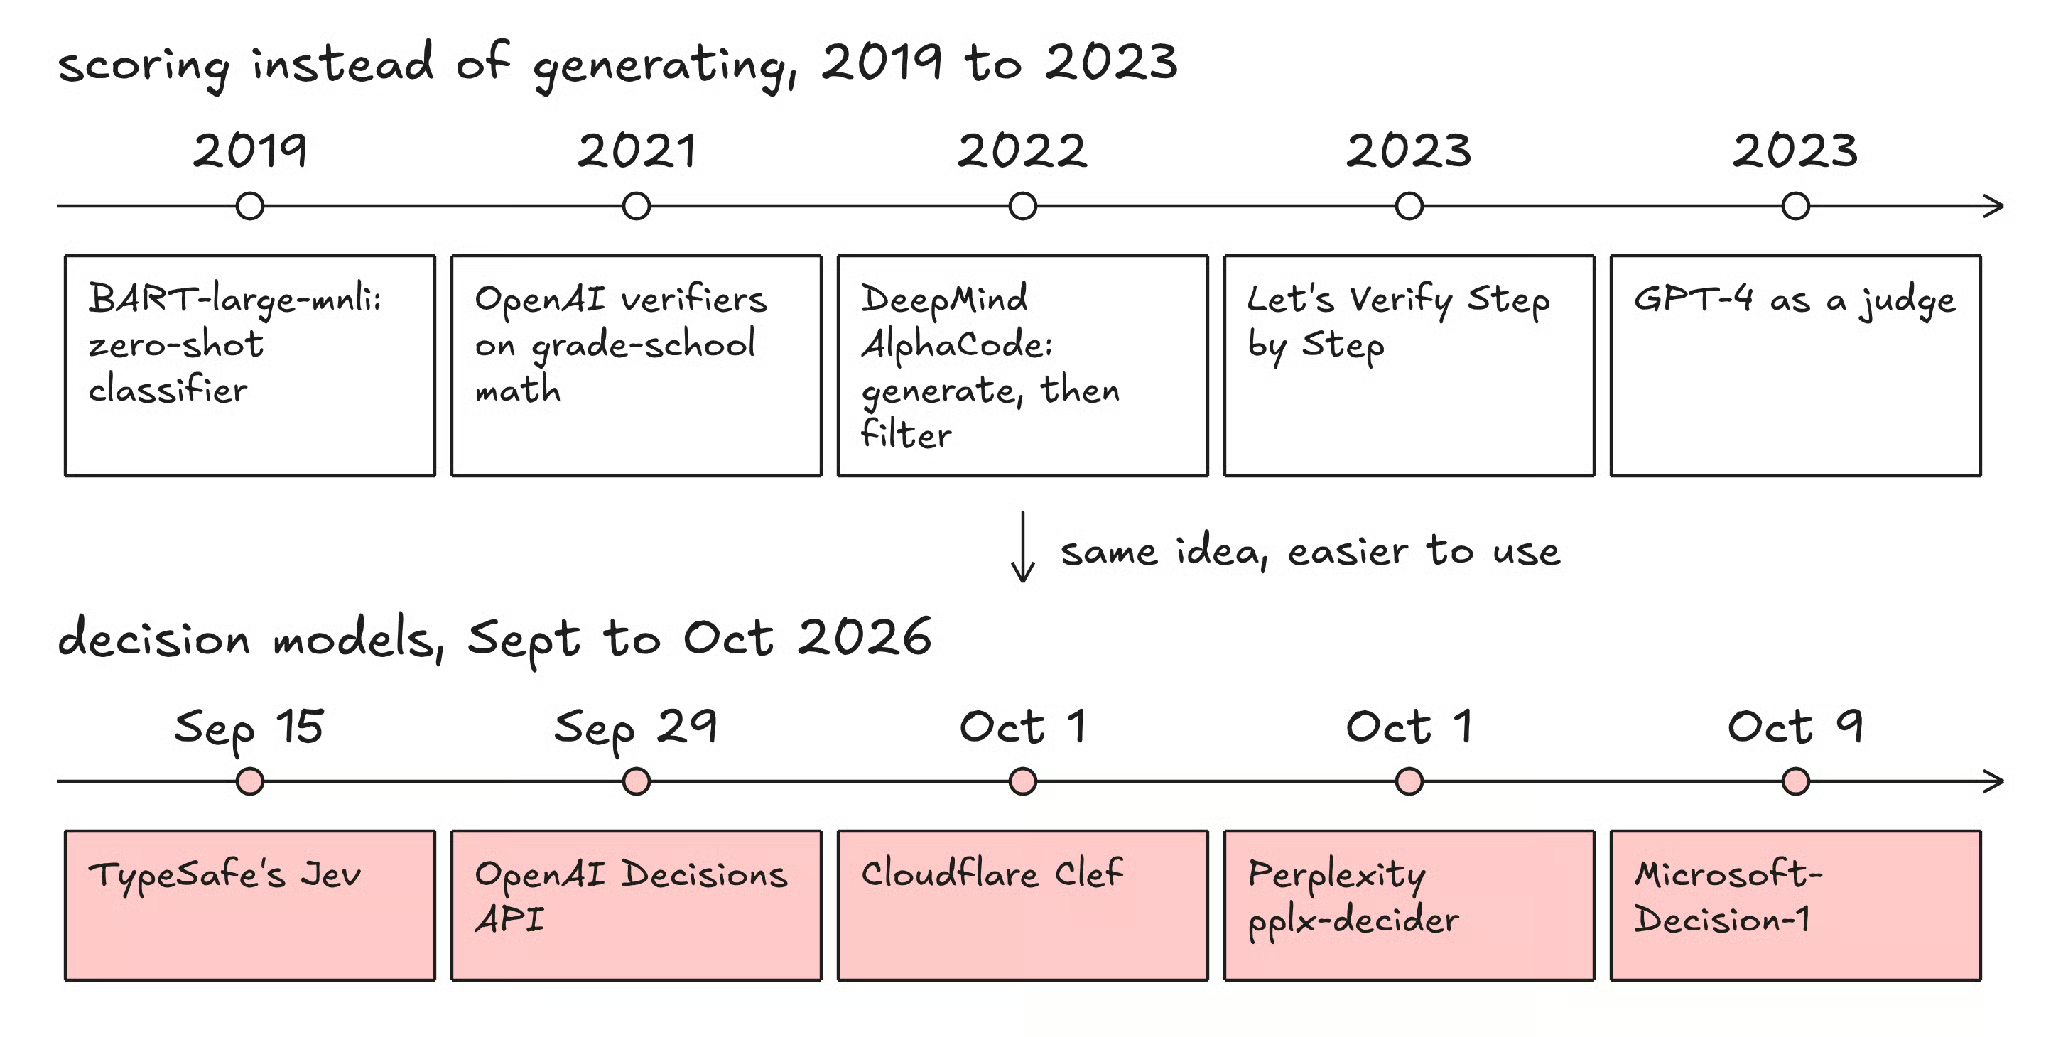
Figure 3 : le « scorer plutôt que générer » remonte à 2019, et les modèles de décision sont la version 2026. Image originale de l’auteur.
Dès 2019, des modèles comme BART-large-mnli pouvaient déjà classer des textes dans des labels jamais vus à l’entraînement.
Ils y parvenaient en notant des affirmations du type « ce texte parle de facturation » pour chaque label possible.
L’équipe sécurité IA de Red Hat suggère que les modèles de décision ne sont, au fond, que ces classificateurs zero-shot sous un nouveau nom.
Si vous avez construit un système RAG, vous en avez peut-être utilisé. On commence par récupérer rapidement une short list (par exemple 50 documents), puis un cross-encoder lit la question et chaque document ensemble et attribue à chaque paire un score de pertinence.
Rien n’est généré : les documents sont simplement réordonnés selon leur score.
Ce sont des scoreurs qui évaluent des réponses déjà générées par un LLM.
En 2021, des chercheurs d’OpenAI ont montré qu’ajouter un vérificateur à un modèle apportait un gain en mathématiques niveau primaire équivalent à multiplier la taille du modèle par 30, ce qui est frappant.
Deux ans plus tard, l’article « Let’s Verify Step by Step » a montré que noter chaque étape de raisonnement fonctionne encore mieux que ne noter que la réponse finale.
La version simple consiste à générer plusieurs réponses, à les noter, puis à garder la meilleure. AlphaCode de DeepMind (2022) a poussé l’idée à l’extrême : jusqu’à un million de programmes générés par problème, 99 % écartés grâce à des tests d’exemples, et une dizaine seulement soumis.
Sur des compétitions Codeforces passées (évaluations simulées), il s’est classé en moyenne dans les 54,3 % supérieurs des concurrents humains.
Attention : si l’on pousse trop fort un scoreur imparfait, la qualité finit par chuter, car le générateur exploite les faiblesses du scoreur.
On parle alors d’overoptimization de la récompense.
Il s’agit de faire évaluer la sortie d’un modèle par un LLM plus grand.
Une étude de 2023 a montré que GPT-4 était d’accord avec des juges humains plus de 80 % du temps, mais présentait aussi des biais, comme préférer les réponses plus longues ou celles affichées en premier.
Les modèles de décision sont en partie présentés comme une alternative structurée et moins coûteuse à ces juges.
Un modèle à énergie attribue une faible « énergie » à une paire entrée–réponse qui s’accorde bien, et une énergie élevée aux paires qui ne collent pas.
Choisir une réponse revient alors à trouver l’énergie la plus basse, c’est-à-dire à noter des candidats.
Yann LeCun défend depuis des années l’idée que générer token par token n’est pas la voie vers une véritable intelligence, et que les approches à énergie et JEPA sont plus prometteuses.
Voyons maintenant les modèles effectivement publiés. Le rythme est très rapide, je vais donc faire court pour chacun.
TypeSafe AI est une startup de San Francisco fondée par Diogo Almeida, ex-chercheur chez OpenAI, sortie du bois le 15 septembre 2026 avec Jev et un tour de seed de 40 millions de dollars mené par DCVC.
Jev est une API hébergée. En production, elle prend du texte uniquement ; l’entrée image est expérimentale et nécessite un en-tête d’opt-in. La tarification est basée sur les tokens d’entrée, et les sorties sont gratuites, ce qui se comprend quand la sortie se résume à quelques nombres.
Jev 1.14 a suivi le 14 octobre, bien que l’alias jev-latest pointe toujours vers 1.13.0, la version testée par Red Hat plus loin dans l’article.
Le lancement a fait du bruit. Vercel a indiqué qu’environ 13 % de ses équipes payantes avaient essayé Jev via son AI Gateway dans les 24 premières heures, même s’il était gratuit sur la gateway à ce moment-là.
OpenAI a annoncé son Decisions API à DevDay le 29 septembre 2026.
Il fonctionne avec des questions définies par l’utilisateur et un ensemble de réponses fixes, et repose sur GPT-6 Luna. Passé en bêta publique le 6 octobre, il accepte aussi les images, que Jev ne supporte qu’expérimentalement.
Cloudflare a publié Clef et un Clef-flash plus petit le 1er octobre 2026, avec poids ouverts et hébergement sur Workers AI. Tous deux sont basés sur des modèles Qwen et acceptent des requêtes au format Jev, ce qui permet de rediriger un code écrit pour Jev vers Clef avec très peu de changements.
| Modèle | Éditeur | Sortie (2026) | Accès | Détail notable |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1er octobre | Poids ouverts et API | 85,71 % auto-rapportés vs 84,51 % pour Jev sur le panel de 11 benchmarks de Perplexity |
| Microsoft-Decision-1 | Microsoft | 9 octobre | Foundry preview | Un modèle Qwen de 9B post-entraîné |
| Laya | Convai Innovations | Septembre | Poids ouverts | Petit (421 M de paramètres), tourne sur CPU portable ; sa model card le présente comme une base à spécialiser, pas un moteur zero-shot |
Ce qui m’a surtout frappé en rassemblant ces éléments, c’est que la plupart des modèles ouverts et big tech ici sont des LLM classiques affinés. Laya fait exception : c’est un encodeur avec une tête de décision. Les entrailles de Jev ne sont pas publiées.
À mon sens, cela conforte l’idée que l’innovation majeure réside dans l’emballage (interface et entraînement à la calibration) plutôt que dans une architecture entièrement nouvelle.
Le plus simple pour choisir, c’est de comparer :
| Caractéristique | LLM | Modèle de décision | Classificateur affiné | LLM + vérificateur |
|---|---|---|---|---|
| Sortie | Texte libre | Réponse typée et probabilités | Labels fixes | Meilleure de plusieurs réponses générées |
| Besoin de données labellisées | Non | Non | Oui | Souvent |
| Vitesse | Secondes | Dizaines à centaines de millisecondes | Très rapide | La plus lente |
| Réponses hors format | Possible | Impossible | Impossible | Dépend du générateur |
| Explique sa réponse | Oui | Non | Non | Oui |
| Idéal pour | Rédaction, code, raisonnement | Routage, triage, garde-fous | Une tâche fixe à gros volume | Maths, code avec tests |
Ma règle d’or, à gros traits :
Je pense que les meilleurs systèmes combinent ces approches.
Je vois bien les modèles de décision agir comme des « portes » rapides autour d’un LLM. Une porte décide :
Ainsi, le LLM coûteux ne tourne que quand il faut réellement écrire quelque chose.
C’est la section la plus importante, car la plupart des gros chiffres en ligne viennent des éditeurs eux-mêmes. Même TypeSafe reconnaît que ses gains vedettes de coût et de vitesse sont le haut de la fourchette en pratique.
En octobre 2026, l’équipe sécurité IA de Red Hat a comparé neuf configurations de garde-fous sur deux tâches : détecter l’injection de prompts et détecter du contenu à risque.
DiffusionGemma est un modèle de diffusion texte Gemma servi via vLLM.
Voici les résultats les plus marquants :
| Méthode | Type | Précision injection de prompts | Précision sécurité des contenus |
|---|---|---|---|
| deberta-v3-base | Classificateur affiné | 89,01 % | - |
| granite-guardian-hap-125m | Classificateur affiné | - | 80,27 % |
| Qwen3.6-35B | LLM-as-a-judge | 89,31 % | 85,47 % |
| DiffusionGemma | Modèle de décision (open) | 87,72 % | 85,53 % |
| Jev | Modèle de décision | 86,35 % | 86,20 % |
| Laya | Modèle de décision (open) | 85,44 % | 57,87 % |
| BART-large-mnli | Classificateur zero-shot (2019) | 61,49 % | 68,67 % |
Jev est arrivé premier sur la sécurité des contenus, devant DiffusionGemma de 0,67 point (le juge Qwen est troisième), et Qwen a pris la tête sur l’injection de prompts.
Ce décalage explique pourquoi Red Hat peut conclure qu’au global les modèles de décision n’ont pas surpassé les LLM juges.
Mais ce que je trouve le plus intéressant, c’est qu’un classificateur de 200 millions de paramètres n’est qu’à 0,3 point sur l’injection de prompts, avec une latence médiane inférieure à 100 ms contre environ 348 pour Jev.
La latence de Jev incluait un aller-retour transatlantique, les tests ayant été lancés depuis le Royaume-Uni tandis que les serveurs de TypeSafe sont aux États-Unis.
Cela n’explique que l’écart face aux modèles locaux sur CPU. Qwen, Nemotron et DiffusionGemma tournaient aussi sur un cluster US, et Qwen restait plus rapide que Jev.
Malgré tout, Red Hat conclut que, dans leurs tests, les modèles de décision n’ont pas fourni de réponses plus rapides, moins chères ou meilleures que LLM-as-a-judge, à l’exception de Laya dont la petite taille est un vrai atout si l’on sait composer avec ses limites.
Un article de recherche d’universitaires, publié sur arXiv en septembre 2026, a testé Jev sur 44 benchmarks d’alignement.
Les résultats sont contrastés de manière intéressante :
Je trouve le point sur la prédiction sélective très utile en pratique.
Il montre qu’un design simple, où le modèle de décision traite les cas faciles et envoie les incertains à un LLM ou à un humain, est une bonne stratégie.
Construisons maintenant un modèle de décision nous-mêmes.
Nous allons transformer un petit LLM open source en modèle de décision grâce à l’astuce des probabilités de tokens vue plus haut, puis vérifier si l’on peut faire confiance à ses probabilités.
D’abord, installons les packages (tout peut être exécuté dans un notebook Colab gratuit) :
pip install transformers torch datasets sentence-transformers numpyNous utiliserons Qwen2.5-0.5B-Instruct, assez petit pour tourner sur CPU.
L’idée est simple : on étiquette les options avec des lettres, on exécute le modèle une fois et on ne regarde que les probabilités de ces lettres comme prochain token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Remarquez que nous n’appelons jamais generate(). Nous faisons un seul passage avant, conservons les scores de « A », « B », « C », etc., puis ignorons le reste.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Et c’est tout. Nous venons de créer un modèle de décision fonctionnel en une trentaine de lignes.
Une question oui/non n’est qu’un cas particulier de choix à deux options.
Voyons maintenant où cette version simple montre ses limites.
Essayez de mélanger l’ordre des options et relancez la même question :
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Sur des entrées ambiguës comme celle-ci, on observe souvent un déplacement des probabilités simplement parce que les options ont changé d’ordre.
C’est ce que l’on appelle un biais d’ordre, et TypeSafe mentionne effectivement une tendance vers la première option parmi les faiblesses connues de Jev.
Vous verrez aussi parfois des réponses près de 100 %. Berryman a réalisé un test parlant sur Jev lui-même : en indiquant qu’une pièce tombe sur face 60 % du temps, la question oui/non renvoie 0,58, proche de la vérité.
Mais la question à choix (« pile ou face ? ») renvoie 0,99 pour face, car la probabilité s’effondre sur l’option la plus probable.
C’est, selon moi, l’étape que tout le monde devrait exécuter. Nous allons prendre 400 actus du dataset AG News (titre + court descriptif), qui comporte quatre thèmes, et vérifier si nos probabilités collent à la réalité.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Ensuite, il nous faut une mesure de calibration. L’Expected Calibration Error (ECE) regroupe les prédictions par tranches de confiance et mesure l’écart entre la confiance moyenne et la précision réelle dans chaque tranche.
À noter : plus bas, c’est mieux.
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Voici maintenant l’astuce.
Nous divisons les données en deux, utilisons la première moitié pour trouver une température qui rend les probabilités plus honnêtes, puis testons sur la seconde.
Une température > 1 adoucit des prédictions trop confiantes, tandis qu’une température < 1 accentue des prédictions timorées.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
La précision ne change pas, car diviser par une température ne modifie pas l’option la mieux classée.
Seule la confiance change.
Vos chiffres exacts varieront selon l’exécution, mais l’ECE sur la moitié test devrait généralement baisser. Avec seulement 200 exemples, l’estimation reste bruitée, donc ne surinterprétez pas de petits écarts.
La leçon est simple : qu’un modèle soit calibré sur les données de quelqu’un d’autre ne garantit pas qu’il le soit sur les vôtres.
Pour montrer à quel point l’idée « noter, ne pas générer » est répandue, voici le même principe dans un contexte RAG.
Un cross-encoder note chaque passage par rapport à une question et on se contente de trier :
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Là encore, rien n’est généré : le modèle attribue simplement un score à chaque candidat.
Voici les cas d’usage les plus fréquents :
| Cas d’usage | Comment un modèle de décision aide |
|---|---|
| Routage d’agents | Décide quel outil ou sous-agent doit prendre la main. |
| Garde-fous | Détecte une injection de prompt ou un contenu à risque avant le LLM. |
| Triage support | Oriente les tickets par équipe, sujet et urgence. |
| Intake documentaire | Répond à une checklist fixe de questions sur chaque document. |
| Recherche et RAG | Reclasse les passages récupérés par pertinence. |
| Crédit et fraude | Évalue le risque, même si les décisions concernant des personnes doivent rester revues par un humain. |
| Robotique | Pourrait servir de couche rapide entre un planificateur LLM lent et le contrôle moteur bas niveau, mais cela reste spéculatif. |
La robotique est, personnellement, l’idée qui m’enthousiasme le plus.
Berryman suggère qu’un modèle comme Jev pourrait s’intercaler entre un LLM lent, qui planifie à haut niveau, et les modèles cinématiques qui déplacent les articulations d’un robot.
À noter toutefois que la célèbre démo Doom de TypeSafe alimentait Jev avec de la télémétrie texte plutôt que des images brutes.
Les modèles de décision sont utiles, mais ne les surestimons pas.
Voici les principales limites à garder à l’esprit :
Les modèles de décision en IA reprennent une idée très ancienne : noter des candidats plutôt que générer des réponses, et la rendent nettement plus simple à utiliser.
Vous n’avez pas besoin de données d’entraînement ; vous recevez des réponses typées, et vous pouvez poser plusieurs questions à la fois.
Selon moi, c’est cet « emballage » qui constitue la vraie innovation.
Je m’attends à voir les modèles de décision se placer autour des LLM comme des filtres rapides et économiques qui gèrent les décisions simples, et ne font tourner le modèle coûteux que lorsque quelque chose doit réellement être rédigé.
Les meilleurs cours DataCamp
Cursus
Cursus
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
Tutoriel
Dr Ana Rojo-Echeburúa
12 min
Tutoriel