Lärstig
Associate AI Engineer för utvecklare
26 tim
Öva och håll koll på dina framsteg.
Fortsätt Med GoogleTänk dig att du sitter på en restaurang och servitören frågar: ”Still eller med bubblor?” Du svarar inte med ett stycke om dina preferenser för vätskeintag; du väljer ett av de två alternativen du fick.
Tänk nu på hur vi använder stora språkmodeller (LLM:er) i de flesta appar idag. Vi ställer frågor som ”Gäller det här supportärendet fakturering, leverans eller returer?” och modellen skriver ett fullständigt svar tillbaka, som vi sedan måste tolka med lite kod. I praktiken fanns det bara tre möjliga svar, men vi betalade ändå för en hel tankeprocess.
Det är den här luckan som den nya typen av modell försöker fylla. I september 2026 släppte en startup som heter TypeSafe AI Jev, en modell som inte skriver text överhuvudtaget.
I stället poängsätter den en fast uppsättning svar och berättar hur sannolikt vart och ett är. Inom några veckor hade OpenAI, Cloudflare, Perplexity och Microsoft alla lanserat sina egna versioner, vilket visar hur snabbt området rör sig.
I den här artikeln vill jag utforska vad dessa AI-beslutsmodeller är, hur de fungerar och var idén faktiskt kommer ifrån (den är mycket äldre än hypen antyder). Jag tittar också på vad oberoende benchmarktester fann.
if-sats.En AI-beslutsmodell är en modell som tar ett indata och en uppsättning tillåtna svar och returnerar sannolikheten för varje svar, utan att generera fri text.
Huvudpoängen med dessa modeller är att utdata är redan strukturerad.
Du behöver aldrig tolka en mening, eftersom modellen bara kan lämna tillbaka något av de svar du angav. Det betyder att resultatet kan gå direkt in i en if-sats i din kod.
Jag tänker på skillnaden som två typer av prov.
En stor språkmodell skriver ett essäprov, där svaret skrivs ord för ord, medan en beslutsmodell skriver ett flervalsprov och berättar dessutom hur säker den är på varje ruta (en konfidenspoäng).
Jev och de flesta Jev-alternativ stödjer tre typer av frågor:
TypeSafe har också en experimentell Box-typ för att lokalisera saker i bilder, vilket jag hoppar över här.
Låt mig ge ett exempel från TypeSafes egen dokumentation.
Du kan skicka ett state (texten du vill att modellen ska titta på) och en mappning av questions. För en choice-fråga kommer varje alternativ med en kort beskrivning i fältet criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Och det här var svaret:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Det finns ingen text att tolka.
Du får det valda alternativet, en sannolikhet för varje alternativ och ett konfidensvärde härlett från den högsta sannolikheten, så en plattare fördelning betyder lägre konfidens. I dokumentationen delar ett rörigare ärende som nämner både fel storlek och dubbeldebitering sannolikheten mellan returns (0,61) och billing (0,35), och konfidensen sjunker till 0,42.
TypeSafe beskriver Jev som en ”System One Model”, lånat från Daniel Kahnemans bok Tänka, snabbt och långsamt. Varför är det så?
Mycket förenklat är System 1 ditt snabba, magkänslebaserade omdöme, och System 2 är ditt långsamma, steg-för-steg-resonemang.
En beslutsmodell är tänkt att vara den snabba.
Ett förbehåll: System 1 är också den del av hjärnan som gör snabba misstag, och till TypeSafes heder listar deras egen dokumentation öppet var Jev gör fel. Vi återkommer till detta.
En sak som förvirrade mig först var att ”beslutsmodell” redan betyder flera andra saker. Det kan syfta på:
För tydlighetens skull betyder ”beslutsmodell” i den här artikeln endast den nya kategorin av modeller som släpptes i slutet av 2026 och som poängsätter typade svar i stället för att skriva text.
Innan vi går in på hur beslutsmodeller fungerar hjälper det att se hur en vanlig LLM producerar sitt svar. Jag tror att det gör skillnaden lättare att se.
En stor språkmodell arbetar i en loop.
Den omvandlar vår text till token, förutspår en sannolikhet för varje token i sitt ordförråd, väljer en, lägger till den i texten och upprepar sedan.
Varje extra token i svaret innebär ytterligare en framåtriktad passering genom modellen.
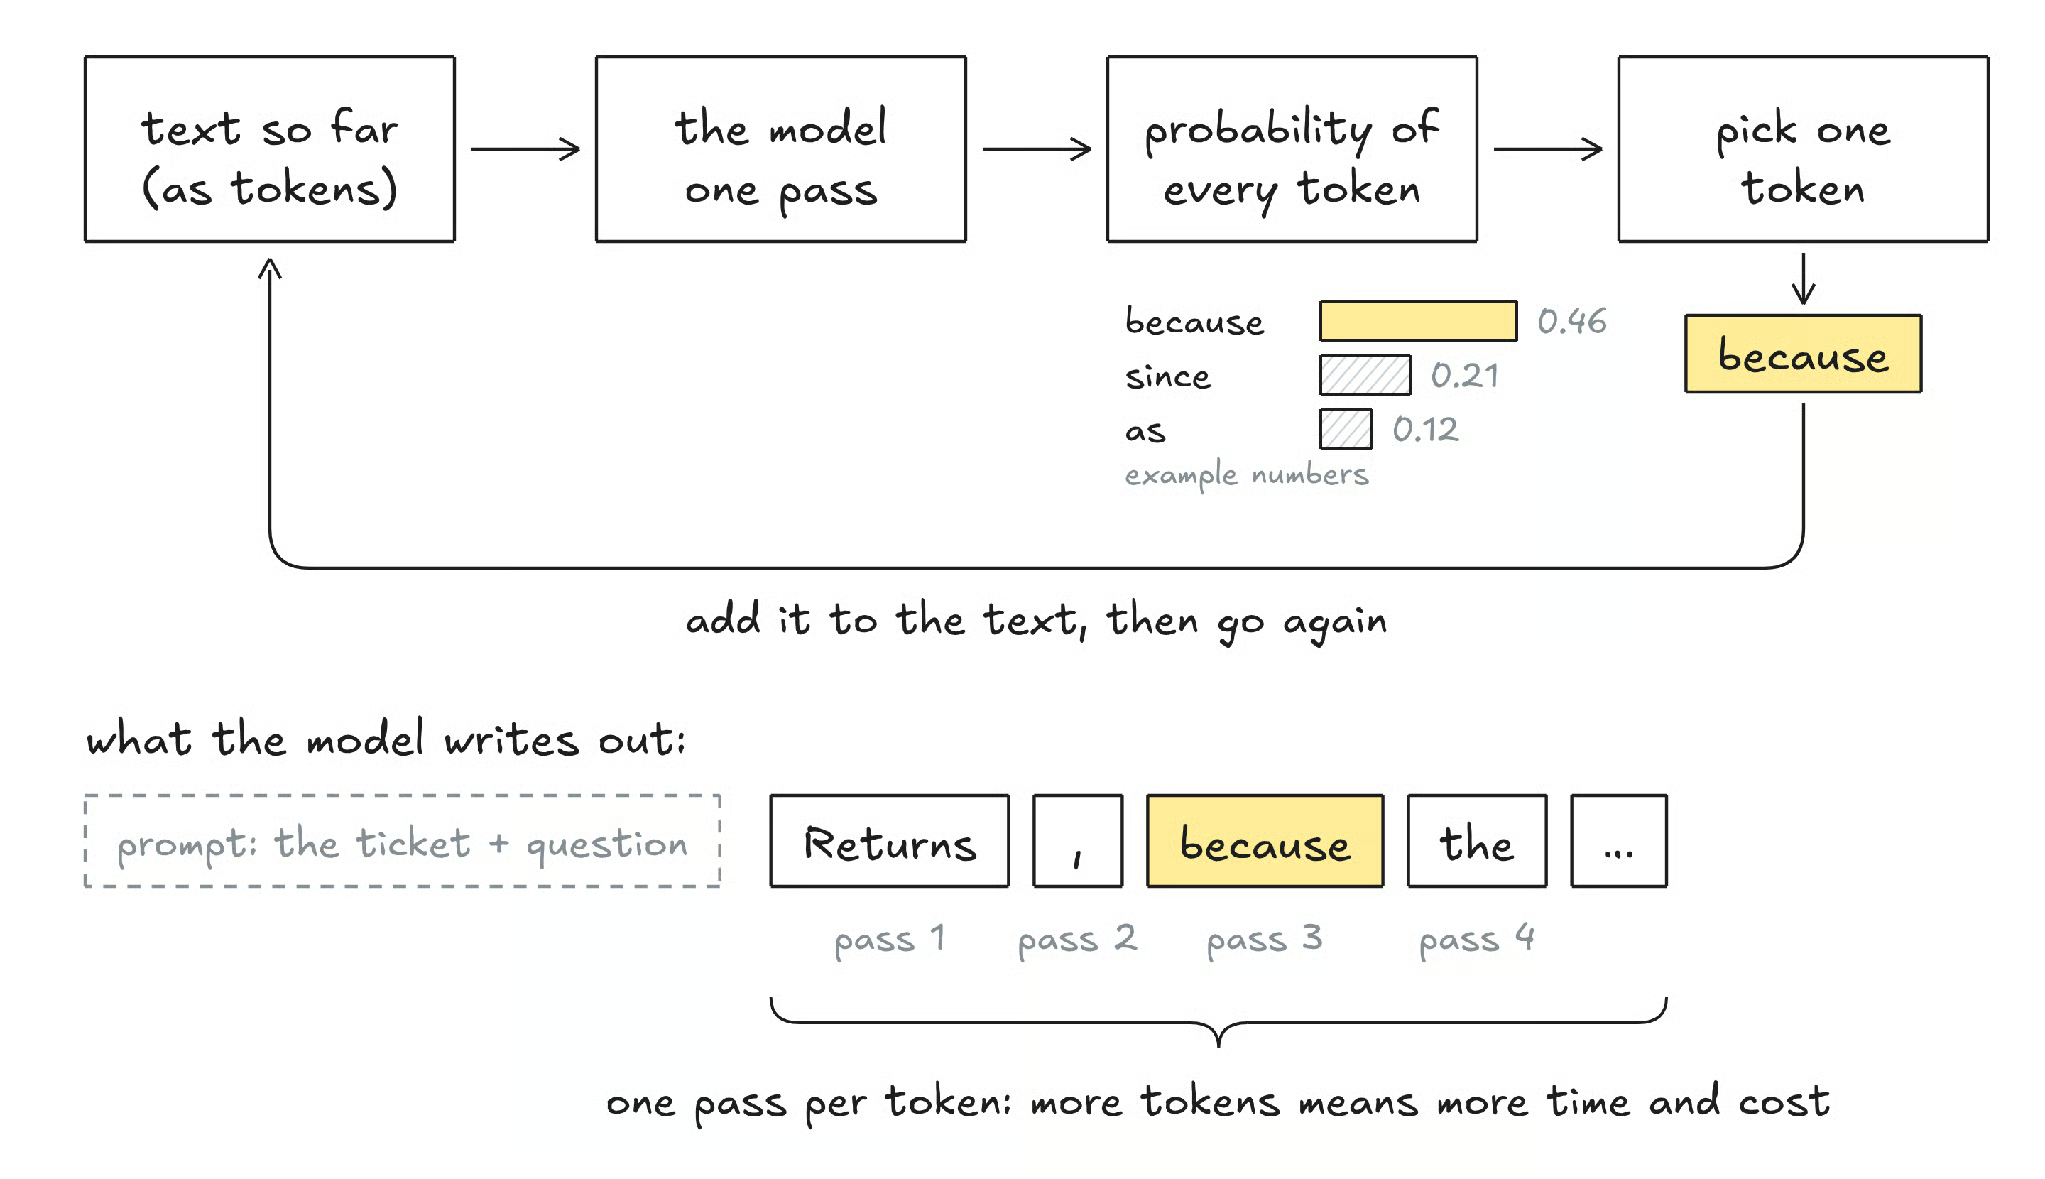
Figur 1: En LLM behöver en framåtriktad passering för varje token den skriver. Ursprunglig bild av författaren.
Den här loopen fungerar bra för att skriva mejl, kod eller förklaringar, men när det gäller enkla beslut kan den skapa några problem:
Beslutsmodeller försöker åtgärda just dessa problem.
Nu går vi in på själva mekaniken.
Det finns tre idéer som är värda att förstå här:
Låt oss titta på var och en lite mer.
En beslutsmodell läser ditt indata och frågorna och producerar en poäng för varje tillåtet svar.
Dessa poäng omvandlas vanligtvis till sannolikheter med en softmax-funktion. Som du säkert märker finns det ingen lång loop, eftersom det inte finns något att skriva.
TypeSafes dokumentation säger också att frågor i samma begäran utvärderas parallellt, så att lägga till extra frågor förändrar knappt svarstiden.
Härifrån kommer det mesta av hastigheten, och TypeSafe säger att Jev normalt svarar på omkring 70 till 500 millisekunder.
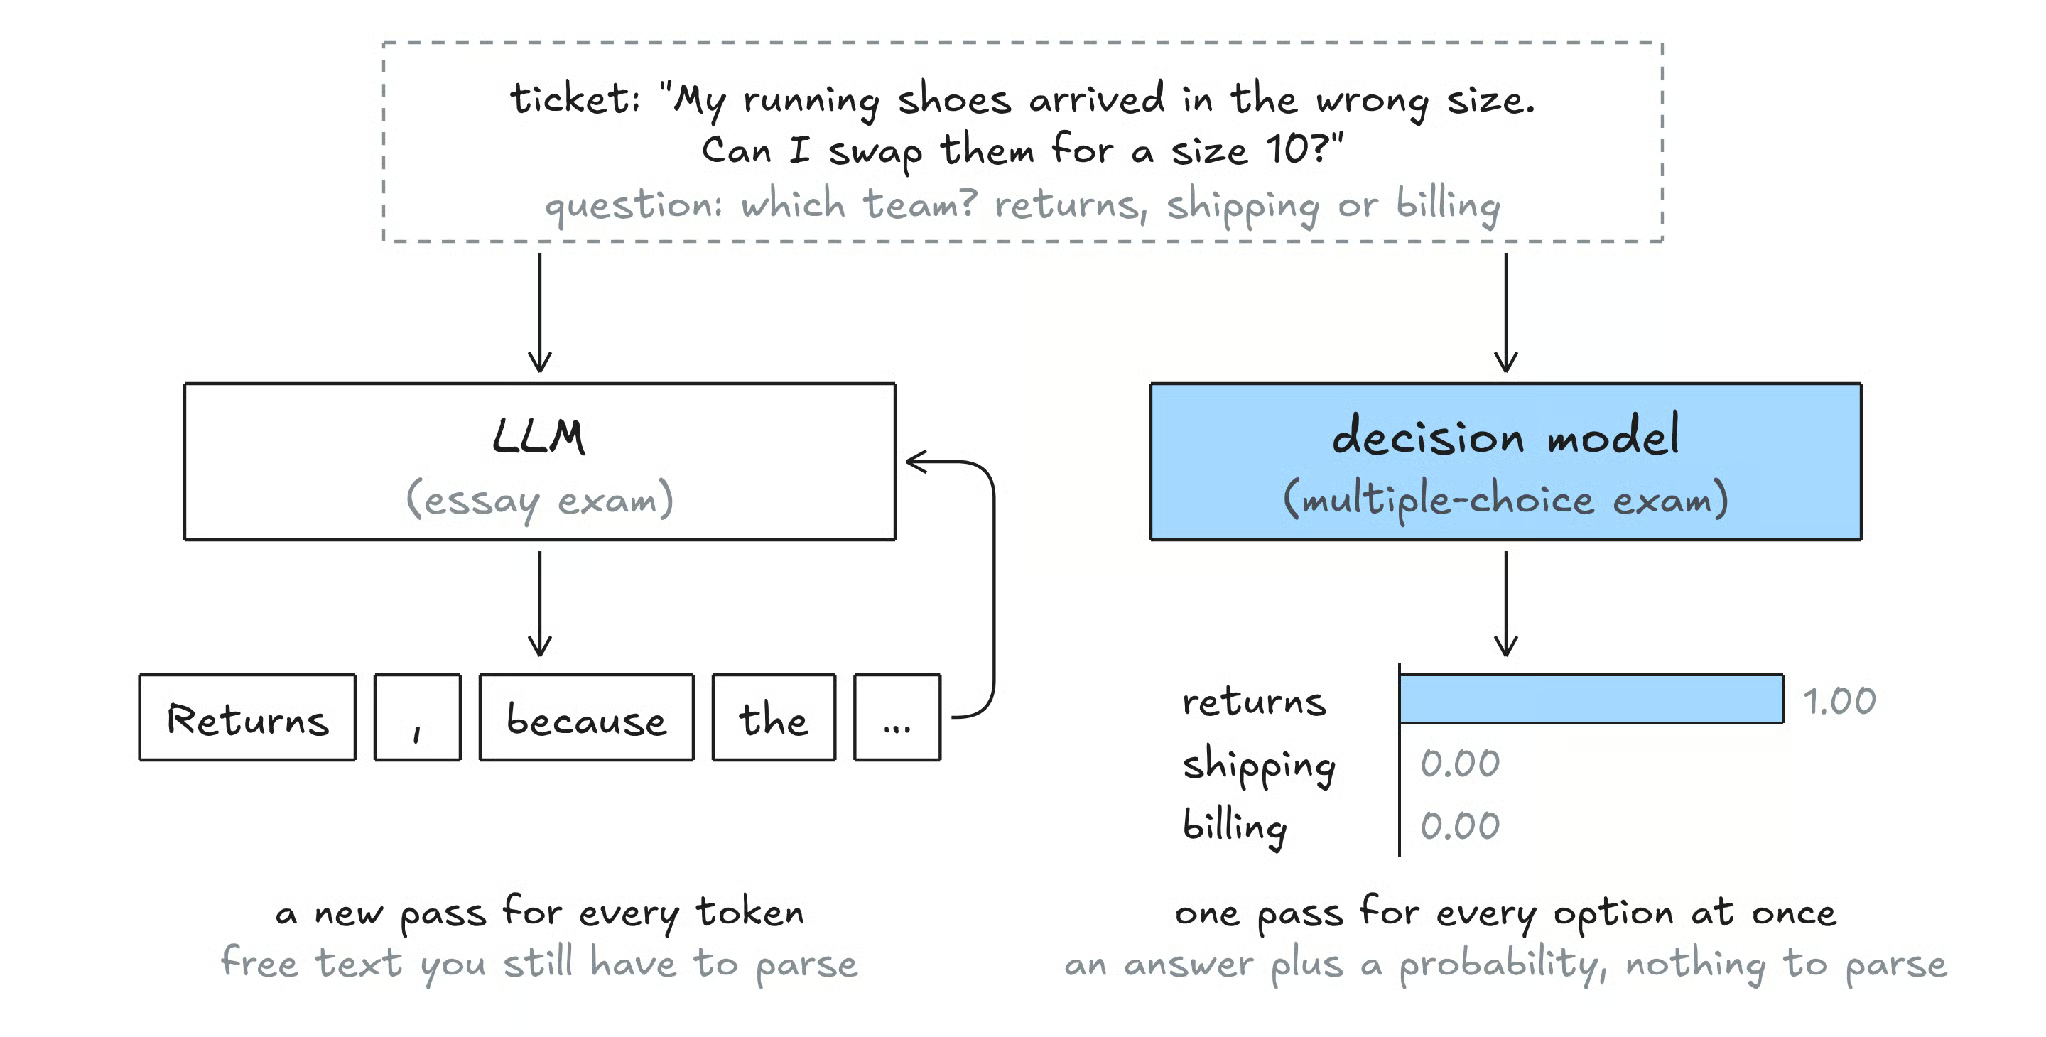
Figur 2: Samma ärende, besvarat av en LLM och av en beslutsmodell. Ursprunglig bild av författaren.
Det finns ingen enda ”arkitektur för beslutsmodeller”.
TypeSafe har inte publicerat hur Jev fungerar, men det finns ungefär tre sätt att få fram dessa poäng:
Oroa dig inte för vilken som används var: alla tre slutar på samma plats, en siffra för varje tillåtet svar.
Det här är den del jag tycker spelar störst roll, så låt mig ge ett exempel.
Tänk dig att en modell säger ”70 % sannolikt” på 100 olika frågor. Om modellen är väl kalibrerad bör ungefär 70 av dessa svar visa sig vara korrekta.
Kalibrering spelar roll eftersom kalibrerade sannolikheter låter oss sätta säkra trösklar i koden, som ”godkänn automatiskt över 90 %, annars skicka till en människa”.
Om sannolikheterna inte stämmer med verkligheten blir trösklarna meningslösa.
Leverantörer tränar för detta med förlustfunktioner som straffar överkonfidens.
TypeSafe kallar sin metod Reinforcement Learning for Calibrated Decisions (RLCD), medan Cloudflare säger att de parar korsprissättning (cross-entropy) med Brier-förlust för sina Clef-modeller.
Det kan överraska dig, men idén att poängsätta kandidater i stället för att generera dem har funnits i åratal.
Enligt min mening är beslutsmodeller den senaste och mest bekväma versionen av detta, snarare än en helt ny uppfinning. Här är de huvudsakliga familjerna av modeller som de bygger på.
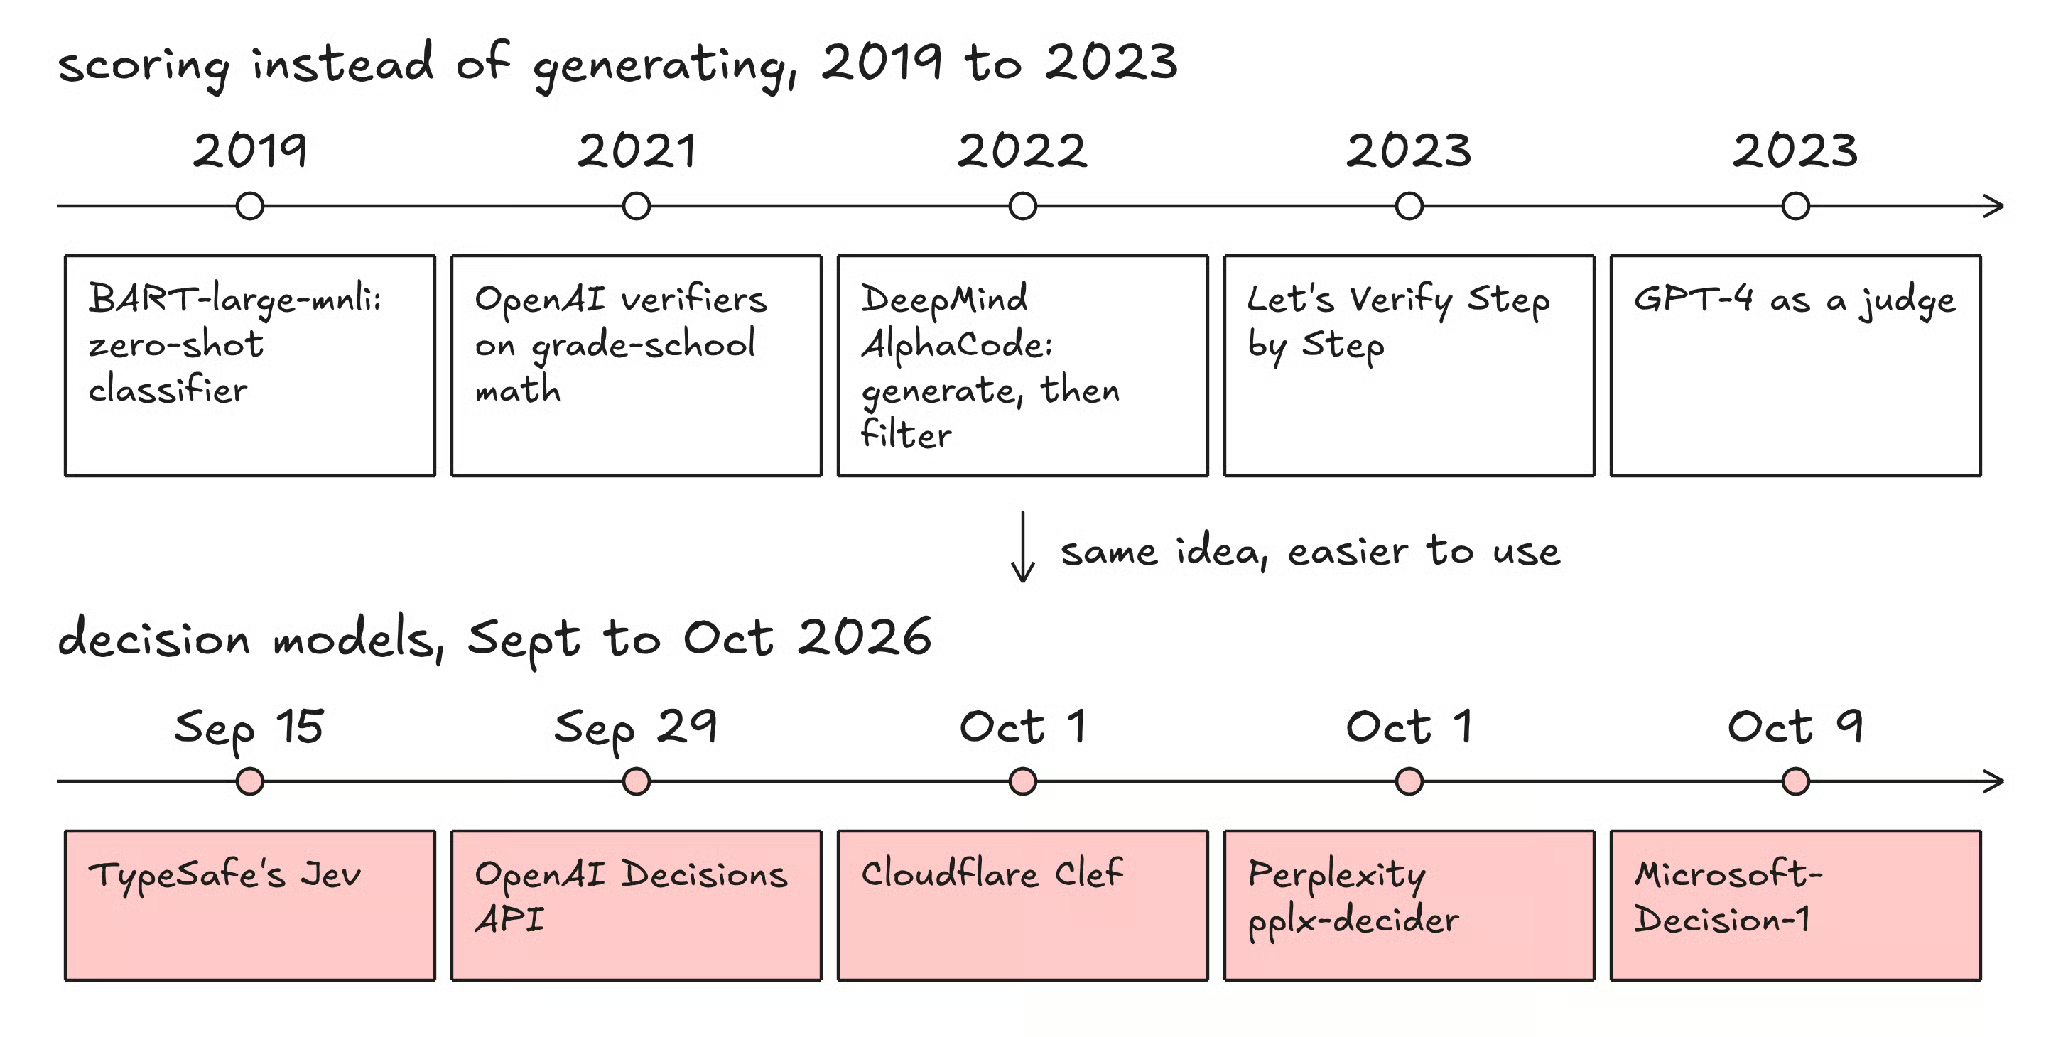
Figur 3: Att poängsätta i stället för att generera går tillbaka till 2019, och beslutsmodeller är 2026 års version. Ursprunglig bild av författaren.
Redan 2019 kunde modeller som BART-large-mnli sortera text i etiketter de aldrig tränats på.
De gjorde det genom att poängsätta påståenden som ”den här texten handlar om fakturering” för varje möjlig etikett.
Red Hats AI-säkerhetsteam menar att beslutsmodeller i praktiken bara är dessa zero-shot-klassificerare under ett nytt namn.
Om du har byggt ett RAG-system har du kanske använt en sådan. Du hämtar först snabbt en kortlista (t.ex. 50 dokument), sedan läser en cross-encoder din fråga och varje dokument tillsammans och tilldelar varje par en relevanspoäng.
Ingenting genereras; i stället omordnas dokumenten efter sina poäng.
Detta är poängsättare som betygsätter svar som en LLM redan har genererat.
År 2021 visade OpenAI-forskare att att lägga till en verifierare till en modell gav ett lyft i låg- och mellanstadiematte ungefär likvärdigt med att göra modellen 30 gånger större, vilket jag tycker är anmärkningsvärt.
Två år senare visade ”Let’s Verify Step by Step”-artikeln att det fungerar ännu bättre att poängsätta varje resonemangs-steg än att bara poängsätta slutsvaret.
Den enkla varianten är att generera många svar, poängsätta vart och ett och behålla det bästa. DeepMinds AlphaCode (2022) tog detta till sin spets genom att generera upp till en miljon program per problem, kasta bort cirka 99 % med exempeltester och sedan bara skicka in 10.
I simulerade utvärderingar på tidigare Codeforces-tävlingar placerade den sig i genomsnitt bland de bästa 54,3 % av mänskliga deltagare.
En varning: om du pressar för hårt på en ofullständig poängsättare går kvaliteten till slut ner eftersom generatorn börjar utnyttja poängsättarens misstag.
Den tekniska termen för detta är överoptimering av belöning.
Detta är när en stor LLM bedömer utfallet från en annan modell.
En studie från 2023 fann att GPT-4 höll med mänskliga domare i över 80 % av fallen men också hade bias, som att föredra längre svar eller det svar som visades först.
Beslutsmodeller säljs delvis som ett billigare, strukturerat alternativ till dessa domare.
En energibaserad modell ger ett lågt ”energi”-värde till ett indata och ett svar som passar bra ihop och ett högt värde till par som inte gör det.
Att välja ett svar betyder då bara att hitta lägsta energin, vilket återigen är att poängsätta kandidater.
Yann LeCun har i åratal hävdat att generering token för token inte är vägen till verklig intelligens, och att energibaserade metoder och JEPA är en bättre riktning.
Nu vill jag prata om modellerna som faktiskt har släppts. Saker rör sig snabbt här, så jag håller varje kort.
TypeSafe AI är en startup i San Francisco grundad av Diogo Almeida, tidigare forskare på OpenAI, och de kom ur stealth den 15 september 2026 med Jev och en seedrunda på 40 miljoner dollar ledd av DCVC.
Jev är ett hostat API. I produktion tar det bara text; bildindata är experimentellt och kräver en opt-in-header. Prissättning debiteras på indatatoken, och utdata är gratis, vilket är rimligt när utdata bara är några siffror.
Jev 1.14 följde den 14 oktober, även om aliaset jev-latest fortfarande pekar på 1.13.0, versionen som Red Hat testade senare i artikeln.
Lanseringen väckte stor uppmärksamhet. Vercel sa att runt 13 % av deras betalande team provade Jev via AI Gateway under de första 24 timmarna, även om det då var gratis i gatewayen.
OpenAI aviserade sitt Decisions API på DevDay den 29 september 2026.
Det fungerar med användardefinierade frågor som har en fast uppsättning svar och är byggt på GPT-6 Luna. Det gick till publik beta den 6 oktober, och det kan också ta bilder, vilket Jev bara stödjer experimentellt.
Cloudflare släppte Clef och en mindre Clef-flash den 1 oktober 2026, med öppna vikter och hosting på Workers AI. Båda är byggda på Qwen-modeller och accepterar Jev-liknande förfrågningar, så kod skriven för Jev kan riktas mot Clef med mycket få ändringar.
| Modell | Tillverkare | Släppt (2026) | Åtkomst | Anmärkningsvärt |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 oktober | Öppna vikter och API | Egenrapporterade 85,71 % mot Jevs 84,51 % på Perplexitys egen panel med 11 benchmark |
| Microsoft-Decision-1 | Microsoft | 9 oktober | Foundry-förhandstitt | En eftertränad 9B Qwen-modell |
| Laya | Convai Innovations | September | Öppna vikter | Liten (421M parametrar), körs på en laptop-CPU; dess model card kallar den en bas att specialisera, inte en zero-shot-motor |
Det som verkligen stack ut för mig när jag satte ihop den här delen är att de flesta öppna och storbolagsmodellerna här är fintrimmade versioner av vanliga LLM:er. Laya är undantaget: den är en encoder med ett beslutshuvud. Jevs inre fungerar är inte offentliggjorda.
Enligt min mening stödjer detta idén att den verkliga innovationen är paketeringen (dvs. gränssnittet och träningen för kalibrering) snarare än en helt ny arkitektur.
Det tydligaste sättet att avgöra när man ska använda vad är en jämförelse:
| Funktion | LLM | Beslutsmodell | Fintrimmad klassificerare | LLM + verifierare |
|---|---|---|---|---|
| Utdata | Fri text | Typat svar och sannolikheter | Fasta etiketter | Bästa av flera genererade svar |
| Behöver märkta data | Nej | Nej | Ja | Ofta |
| Hastighet | Sekunder | Tio- till hundratals millisekunder | Mycket snabb | Långsammast |
| Fel format på svar | Möjligt | Omöjligt | Omöjligt | Beror på generatorn |
| Förklarar sitt svar | Ja | Nej | Nej | Ja |
| Bäst för | Skrivande, kod, resonemang | Routing, triage, skyddsräcken | En fast högvolymuppgift | Matte, kod med tester |
Min ungefärliga tumregel är denna:
Jag tror att de bästa systemen blandar alla dessa.
Jag kan se beslutsmodeller fungera som snabba grindar runt en LLM. En grind avgör:
På så sätt körs den dyra LLM:en bara när något faktiskt behöver skrivas.
Den här delen är viktigast, eftersom de stora siffror du ser online oftast kommer från leverantörerna själva. Till och med TypeSafe medger att deras rubrikartade vinster i hastighet och kostnad ligger i den övre delen av vad man skulle se i verklig användning.
I oktober 2026 jämförde Red Hats AI-säkerhetsteam nio guardrail-upplägg i två uppgifter: att fånga promptinjektion och att fånga osäkert innehåll.
DiffusionGemma är en Gemma text-diffusionsmodell som serveras via vLLM.
Här är de mest intressanta resultaten:
| Metod | Typ | Noggrannhet promptinjektion | Noggrannhet innehållssäkerhet |
|---|---|---|---|
| deberta-v3-base | Fintrimmad klassificerare | 89,01 % | - |
| granite-guardian-hap-125m | Fintrimmad klassificerare | - | 80,27 % |
| Qwen3.6-35B | LLM-as-a-judge | 89,31 % | 85,47 % |
| DiffusionGemma | Beslutsmodell (öppen) | 87,72 % | 85,53 % |
| Jev | Beslutsmodell | 86,35 % | 86,20 % |
| Laya | Beslutsmodell (öppen) | 85,44 % | 57,87 % |
| BART-large-mnli | Zero-shot-klassificerare från 2019 | 61,49 % | 68,67 % |
Jev kom först på innehållssäkerhet, 0,67 procentenheter före DiffusionGemma (Qwen-domaren var trea), och Qwen-domaren kom först på promptinjektion.
Den uppdelningen är varför Red Hat ändå kan säga att beslutsmodeller inte visade kvalitetsvinst över LLM-domare totalt sett.
Men det jag tycker är mest intressant är att en klassificerare med 200 miljoner parametrar bara hamnade 0,3 procentenheter efter på promptinjektion, med en medianlatens under 100 millisekunder jämfört med cirka 348 för Jev.
Jevs latens inkluderade en tur över Atlanten, eftersom testerna kördes från Storbritannien och TypeSafes servrar finns i USA.
Det hoppet förklarar bara gapet mot lokala CPU-modeller. Qwen, Nemotron och DiffusionGemma kördes också på ett kluster i USA, och Qwen var ändå snabbare än Jev.
Ändå drog Red Hat slutsatsen att beslutsmodeller inte gav snabbare, billigare eller bättre svar än LLM-as-a-judge i deras tester, förutom Laya, vars lilla storlek är en verklig fördel om du kan prompta runt dess begränsningar.
En forskningsartikel från universitetsforskare, upplagd på arXiv i september 2026, testade Jev på 44 alignments-benchmark.
Resultaten var blandade på ett intressant sätt:
Jag tycker att poängen om selektiva prediktioner är väldigt användbar i praktiken.
Den visar att en enkel design där beslutsmodellen hanterar de lätta fallen och skickar de osäkra till en LLM eller en människa är en bra strategi.
Låt oss nu bygga en beslutsmodell själva.
Vi ska göra om en liten öppen LLM till en beslutsmodell med tokensannolikhetstricket från tidigare och sedan kolla om vi faktiskt kan lita på dess sannolikheter.
Först behöver vi installera paketen med detta (allt kan köras i en gratis Colab-notebook):
pip install transformers torch datasets sentence-transformers numpyVi använder Qwen2.5-0.5B-Instruct, som är tillräckligt liten för att köras på CPU.
Idén är enkel: vi märker alternativen med bokstäver, kör modellen en gång och tittar bara på sannolikheterna för de bokstäverna som nästa token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Observera att vi aldrig anropar generate(). Vi gör ett framåtriktat pass, behåller poängen för ”A”, ”B”, ”C” och så vidare, och kastar sedan allt annat.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Och det är faktiskt allt. Vi har precis skapat en fungerande beslutsmodell på runt 30 rader.
En ja/nej-fråga är helt enkelt en choice-fråga med två alternativ.
Nu ser vi var den här enkla versionen börjar kämpa.
Prova att blanda om ordningen på alternativen och kör samma fråga igen:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
På röriga indata som detta ser vi ofta att sannolikheterna skiftar bara för att alternativen flyttades.
Detta kallas ordningsbias, och TypeSafe listar faktiskt en dragning mot det första alternativet som en av Jevs kända svagheter.
Du kan också se att modellen ofta ger nästan 100 %-svar. Berryman körde ett bra test på själva Jev, där han sa att ett mynt landar krona 60 % av gångerna, och ja/nej-frågan gav 0,58, vilket är nära.
Men choice-frågan (”krona eller klave?”) gav 0,99 för krona, eftersom sannolikheten kollapsade mot det mer sannolika svaret.
Det här steget tycker jag alla borde köra. Vi tar 400 nyhetsobjekt från datasetet AG News (varje är en rubrik plus en kort beskrivning), som har fyra ämnen, och kollar om våra sannolikheter stämmer med verkligheten.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Nästa steg är att mäta kalibreringen. Expected calibration error (ECE) grupperar prediktionerna i konfidensintervall och kollar hur långt genomsnittlig konfidens i varje intervall är från faktisk noggrannhet.
Bara så att det är tydligt: lägre är bättre:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Här är sedan tricket.
Vi delar upp vår data i två delar, använder den första halvan för att hitta en temperatur som gör sannolikheterna ärligare, och testar sedan på den andra halvan.
En temperatur över 1 mjukar upp överkonfidenta prediktioner, medan en temperatur under 1 skärper underkonfidenta.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Noggrannheten ändras inte, eftersom att dividera med en temperatur aldrig ändrar vilket alternativ som rankas först.
Bara självförtroendet (konfidensen) ändras.
Dina exakta siffror beror på körningen, men ECE på testhalvan bör oftast sjunka. Med bara 200 testobjekt är uppskattningen brusig, så lägg inte för stor vikt vid små skillnader.
Lärdomen är enkel: att en modell är kalibrerad på någon annans data betyder inte att den är kalibrerad på din.
För att visa hur vanligt ”poängsätt, generera inte” faktiskt är, kommer här samma sak i en RAG-miljö.
En cross-encoder poängsätter varje stycke mot en fråga och vi sorterar dem bara:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Återigen genereras ingenting: modellen ger bara varje kandidat en siffra.
Detta är de användningsfall som kommer upp oftast:
| Användningsfall | Hur en beslutsmodell hjälper |
|---|---|
| Agentrouting | Avgör vilket verktyg eller vilken underagent som ska hantera nästa steg. |
| Skyddsräcken | Flaggar promptinjektion eller osäkert innehåll innan det når LLM:en. |
| Supporttriage | Riktar ärenden efter team, ämne och brådska. |
| Dokumentintag | Svarar på en fast checklista med frågor om varje dokument. |
| Sök och RAG | Rangordnar hämtade stycken efter relevans. |
| Kredit och bedrägeri | Poängsätter risk, även om beslut om människor fortfarande bör involvera mänsklig granskning. |
| Robotik | Skulle kunna fungera som ett snabbt lager mellan en långsam LLM-planerare och lågnivå motorstyrning, även om detta fortfarande är spekulativt. |
Punkten om robotik är den jag personligen gillar mest.
Berryman föreslår att en modell som Jev kan sitta mellan en långsam LLM som gör hög nivå-planer och de kinematiska modeller som rör en robots leder.
Det är dock värt att veta att TypeSafes välkända Doom-demo matade Jev med texttelemetri i stället för råa bilder.
Beslutsmodeller är användbara, men jag vill inte översälja dem.
Här är de främsta begränsningarna jag fann att ha i åtanke:
AI-beslutsmodeller tar en mycket gammal idé om att poängsätta kandidater i stället för att generera svar och gör den mycket enklare att använda.
Du behöver inga träningsdata; du får typade svar tillbaka, och du kan ställa många frågor samtidigt.
Enligt min uppfattning är paketeringen den verkliga innovationen.
Jag förväntar mig att beslutsmodeller sitter runt LLM:er som snabba, billiga grindar som hanterar de enkla besluten, så att den dyra modellen bara körs när något faktiskt behöver skrivas.
Toppkurser på DataCamp
Lärstig
Lärstig
Öva och håll koll på dina framsteg.
Fortsätt Med Google