トラック
開発者向けアソシエイトAIエンジニア
26時間
練習とトラックであなたの進捗を記録しましょう。
Googleで登録レストランで席に着くと、店員に「お水はスティルですか?スパークリングですか?」と聞かれます。水分補給の好みを長々と語るのではなく、提示された2つの選択肢からどちらかを選びますよね。
一方で、いま多くのアプリで大規模言語モデル(LLM)を使う場面を考えてみてください。「このサポートチケットは請求・配送・返品のどれに関するものですか?」と尋ねると、モデルは文章全体で答えを返し、こちらはそれをコードでパースしなければなりません。実際には取りうる答えは3つしかないのに、私たちは思考過程まるごとにお金を払っているわけです。
このギャップを埋めようとしているのが新しいタイプのモデルです。2026年9月、TypeSafe AIというスタートアップが、テキストを一切生成しないモデルJevを公開しました。
Jevは、固定の解答候補を採点し、それぞれの候補の尤もらしさを返します。数週間のうちに、OpenAI、Cloudflare、Perplexity、Microsoftも相次いで同様のモデルを出荷し、この分野の動きの速さを物語りました。
本記事では、これらのAIディシジョン・モデルとは何か、どのように動くのか、そして実はこの発想がどこに由来するのか(流行よりずっと古いものです)を見ていきます。あわせて独立ベンチマークの結果も取り上げます。
if文に入れられます。AIディシジョン・モデルは、入力と許可された解答の集合を受け取り、自由テキストを生成せずに各解答の確率を返すモデルです。
中核のアイデアは、出力が最初から構造化されていることにあります。
モデルは与えられた解答のいずれかしか返せないため、文のパースは不要です。つまり結果はコード内のif文にそのまま使えます。
私はこの違いを2種類の試験として捉えるのが好きです。
大規模言語モデルは論述試験に取り組み、語を一つずつ綴っていきます。対してディシジョン・モデルは選択式試験に答え、各選択肢についてどれくらい自信があるか(信頼度スコア)も教えてくれます。
Jevと多くのJev代替モデルは、3種類の質問をサポートします。
TypeSafeには画像内の位置特定のための実験的なBox型もありますが、ここでは割愛します。
例をTypeSafeの公式ドキュメントから紹介します。
state(モデルに見せたいテキスト)とquestionsのマップを送ります。Choice質問では、各オプションにcriteriaという短い説明文を添えます。
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
これに対するレスポンスは次のとおりです。
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
テキストのパースは不要です。
選ばれたオプション、各オプションの確率、そして最上位確率から導かれる信頼度が得られます。確率分布が平坦なほど信頼度は低下します。ドキュメントでは、サイズ違いと二重請求の両方に触れた厄介なチケットが、返品(0.61)と請求(0.35)で確率を分け合い、信頼度が0.42まで下がる例が紹介されています。
TypeSafeはJevを「System One Model」と説明しており、ダニエル・カーネマンの著書『ファスト&スロー』からの拝借です。なぜでしょうか。
ごくかんたんに言えば、システム1は速く直感的な判断、システム2はゆっくり段階的な推論です。
ディシジョン・モデルは速いほうを担います。
ただし注意点もあります。システム1は素早い分、誤りも起こしやすい部分です。TypeSafeのドキュメントはJevの誤りやすい点を率直に列挙しており、その点は評価できます。後ほど戻ってきます。
最初に読んだとき私が混乱したのは、「ディシジョン・モデル」という言葉が他の意味でも使われることです。例えば以下を指すことがあります。
本記事での「ディシジョン・モデル」は、テキストを書かずに型付きの解答を採点する、2026年後半に登場した新しいカテゴリのモデルのみを指します。
ディシジョン・モデルの仕組みに入る前に、通常のLLMがどのように答えを生成するかを見ておくと違いが分かりやすくなります。
大規模言語モデルはループで動きます。
入力テキストをトークンに分割し、語彙中の各トークンの確率を予測して1つ選び、テキストに追加して、また繰り返します。
出力のトークンが1つ増えるごとに、モデルのフォワードパスが1回増えます。
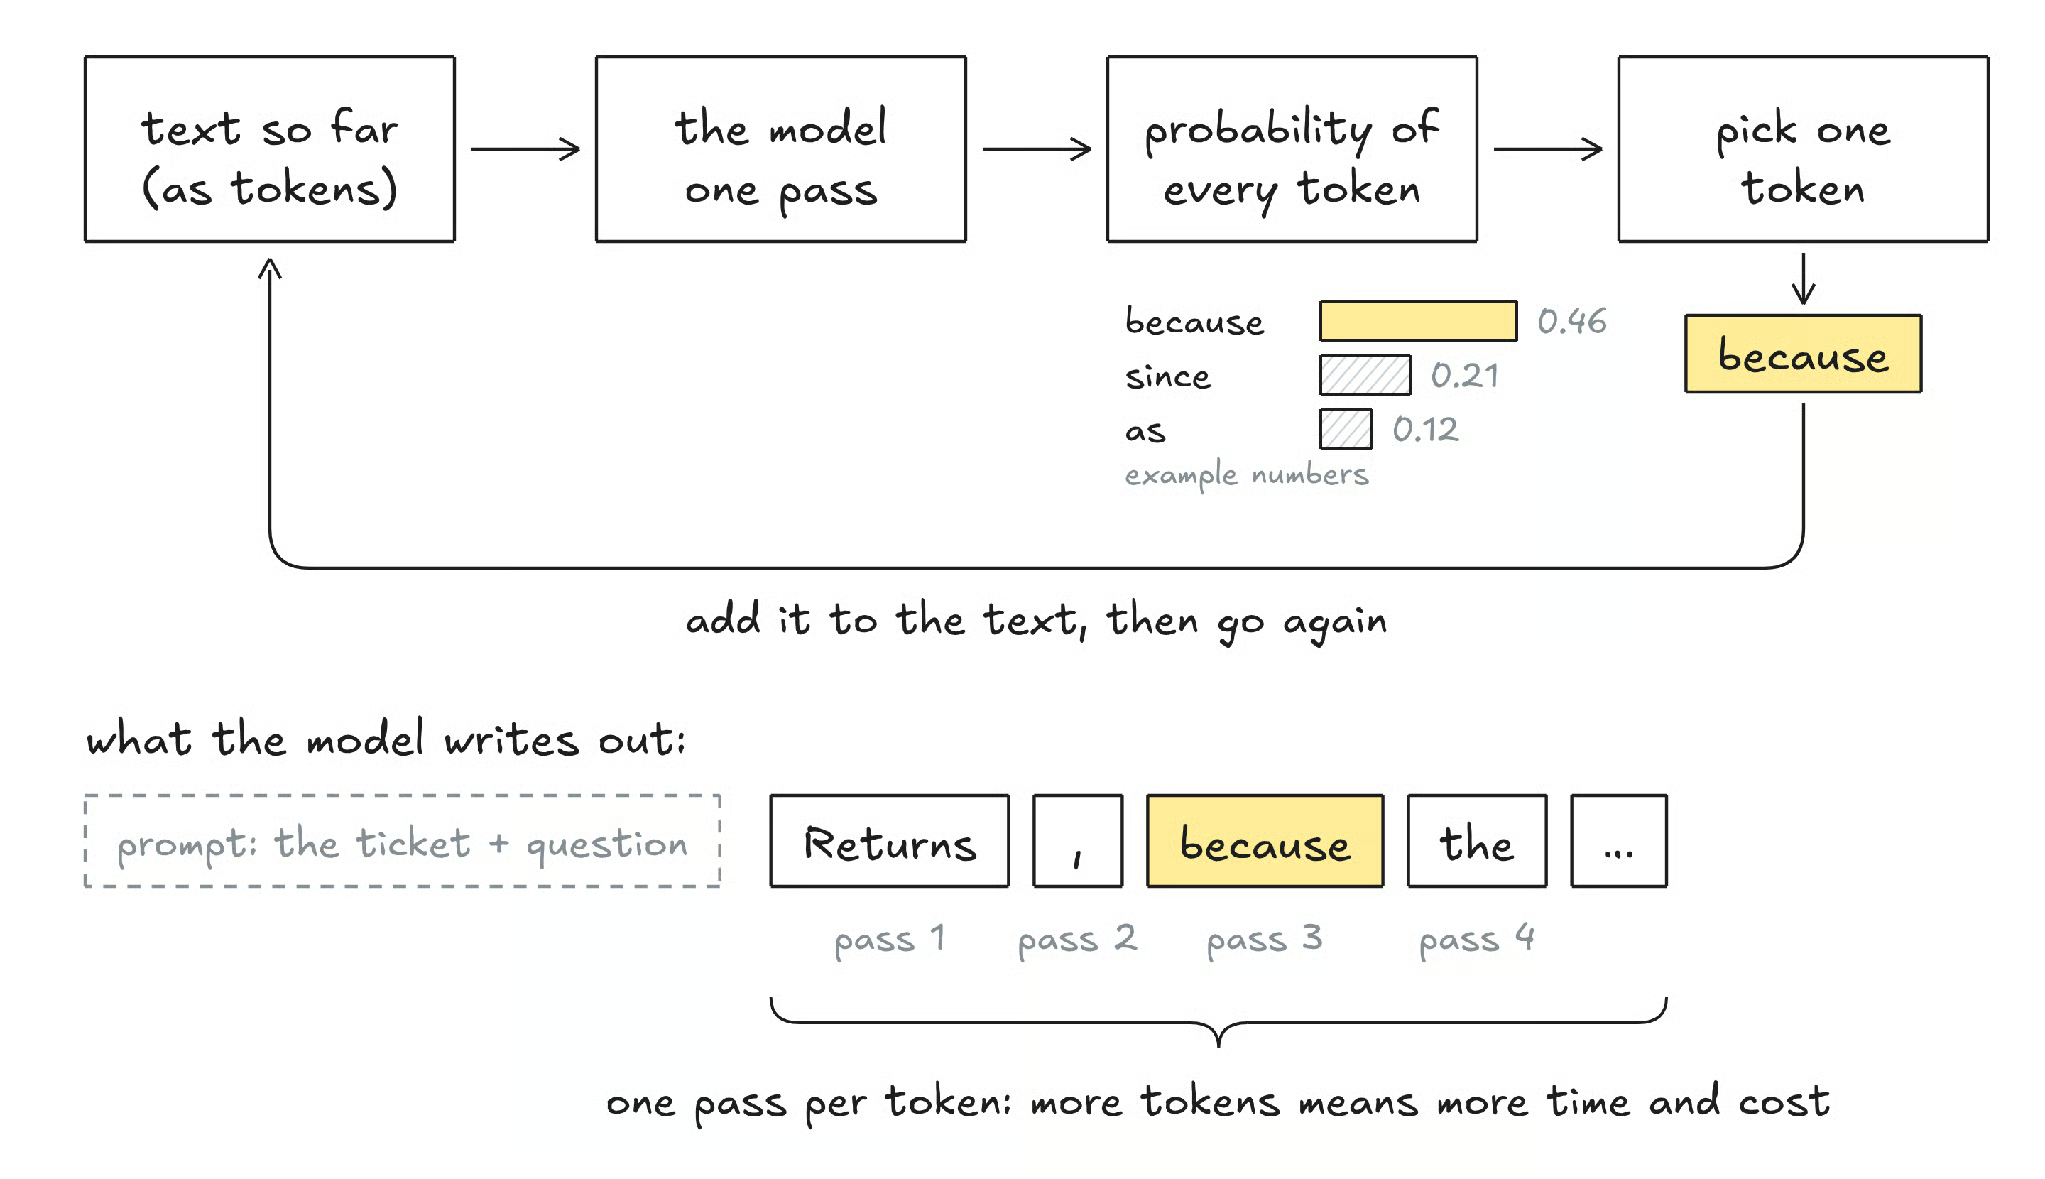
図1:LLMは書くトークンごとに1回のフォワードパスが必要。画像は筆者作成。
このループはメールやコード、説明文の生成には有効ですが、単純な判断には次の問題を招きます。
ディシジョン・モデルはまさにこれらの問題の解消をめざします。
では具体的なメカニズムに入っていきます。
ここで理解しておくべき3つの要点があります。
順に見ていきましょう。
ディシジョン・モデルは入力と質問を読み、許可された各解答に対してスコアを出します。
スコアは通常、ソフトマックス関数で確率に変換します。書き出すものがないため、長いループは存在しないことが分かるでしょう。
TypeSafeのドキュメントによれば、同一リクエスト内の複数質問は並列に評価されるため、質問を増やしても応答時間はほとんど変わりません。
速度向上の主因はここにあり、TypeSafeはJevの典型応答が約70〜500ミリ秒だと述べています。
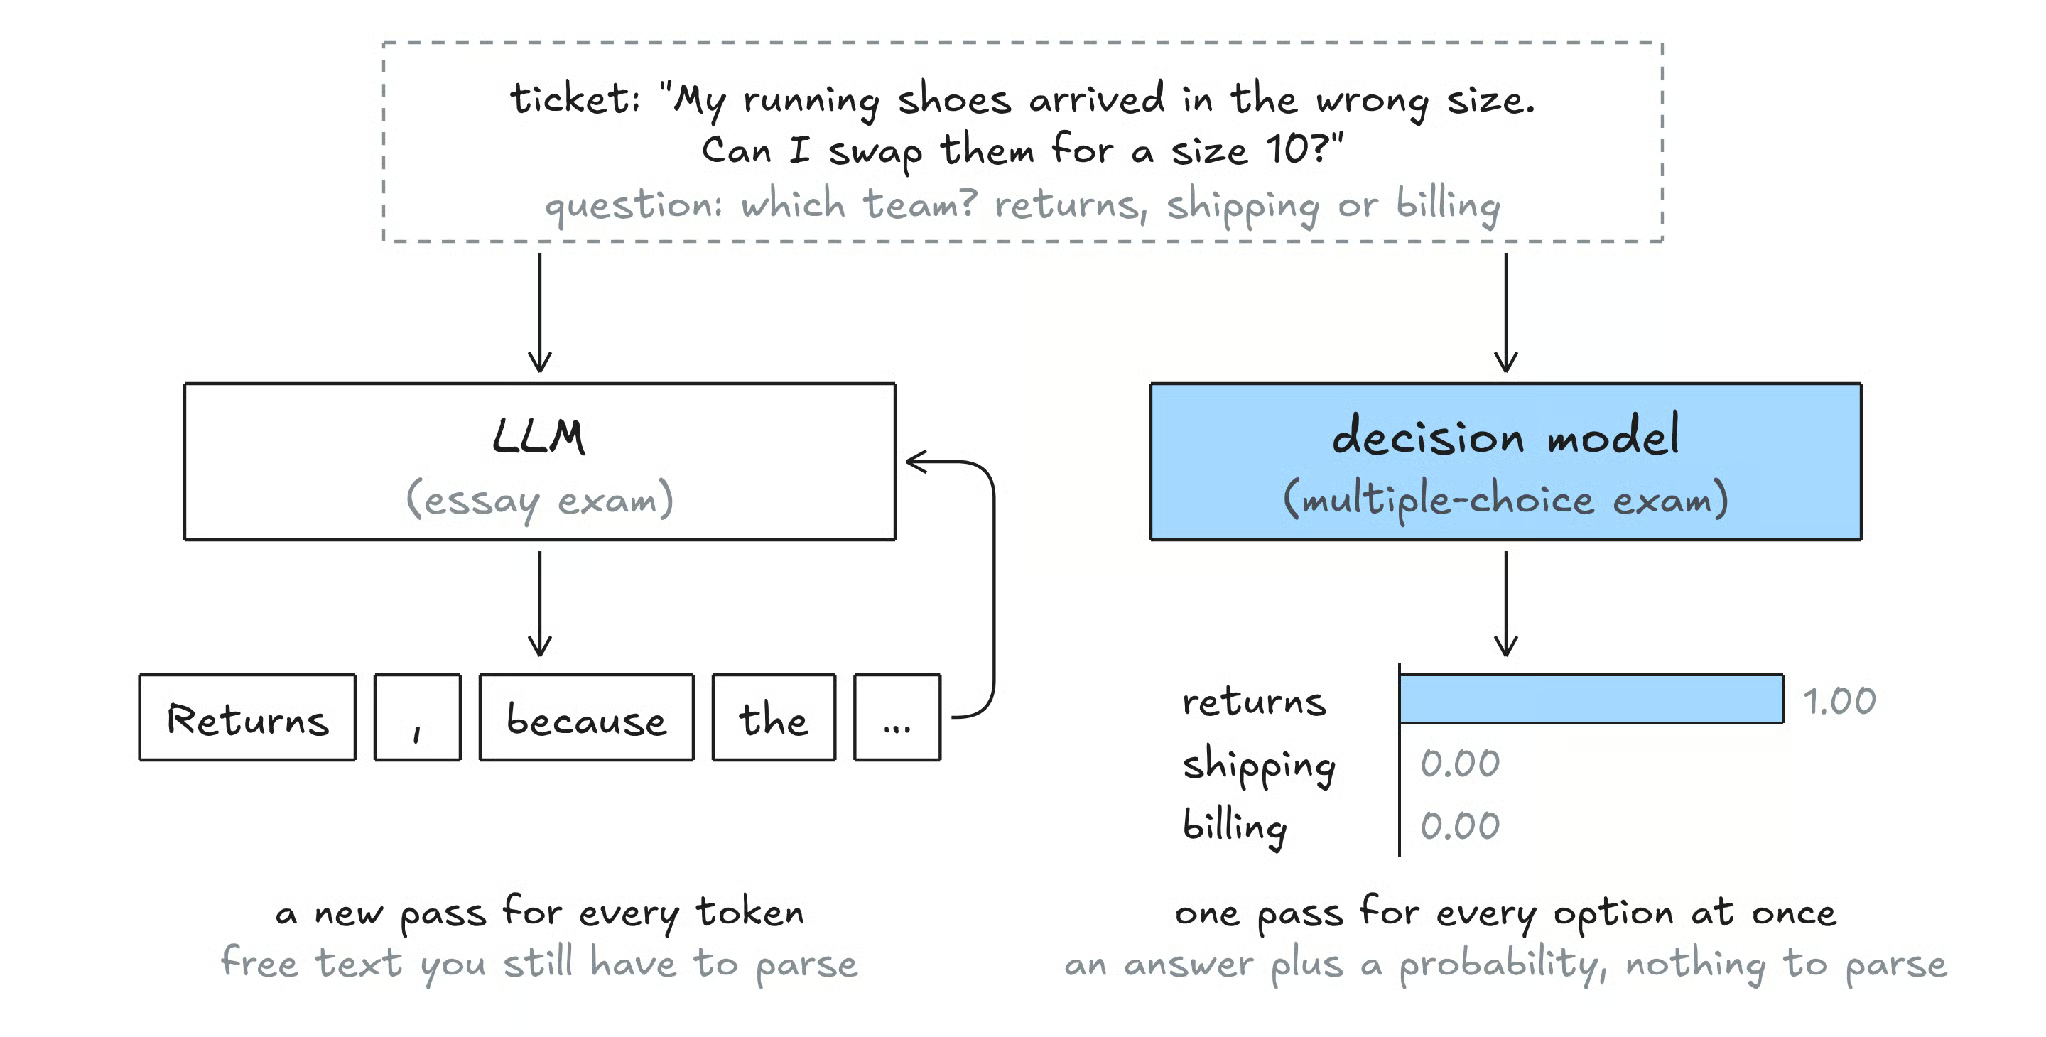
図2:同じチケットに対するLLMとディシジョン・モデルの応答。画像は筆者作成。
単一の「ディシジョン・モデルのアーキテクチャ」があるわけではありません。
TypeSafeはJevの詳細を未公開ですが、概ね3つの方法が考えられます。
どれが使われても最終的には許可された各解答に対する数値が得られる点は同じです。
ここが最重要だと思います。例で説明します。
あるモデルが100の質問で「70%の確率」と答えたとします。モデルが良く校正されていれば、そのうち約70件は実際に正解になります。
校正が重要なのは、確率が正しく校正されていれば、コード側で「90%以上は自動承認、それ以外は人間へ」といった安全な閾値を設定できるからです。
確率が現実と対応していない場合、閾値は無意味になります。
ベンダーは過信にペナルティを与える損失関数で学習させます。
TypeSafeは手法をCalibrated Decisionsのための強化学習(RLCD)と呼び、CloudflareはClefでクロスエントロピーとブライアスコアの併用を明言しています。
意外に思うかもしれませんが、生成ではなくスコアリングを行う発想は何年も前からあります。
私見では、ディシジョン・モデルはまったく新しい発明ではなく、その最新かつ使いやすい形です。土台となる主な系統を挙げます。
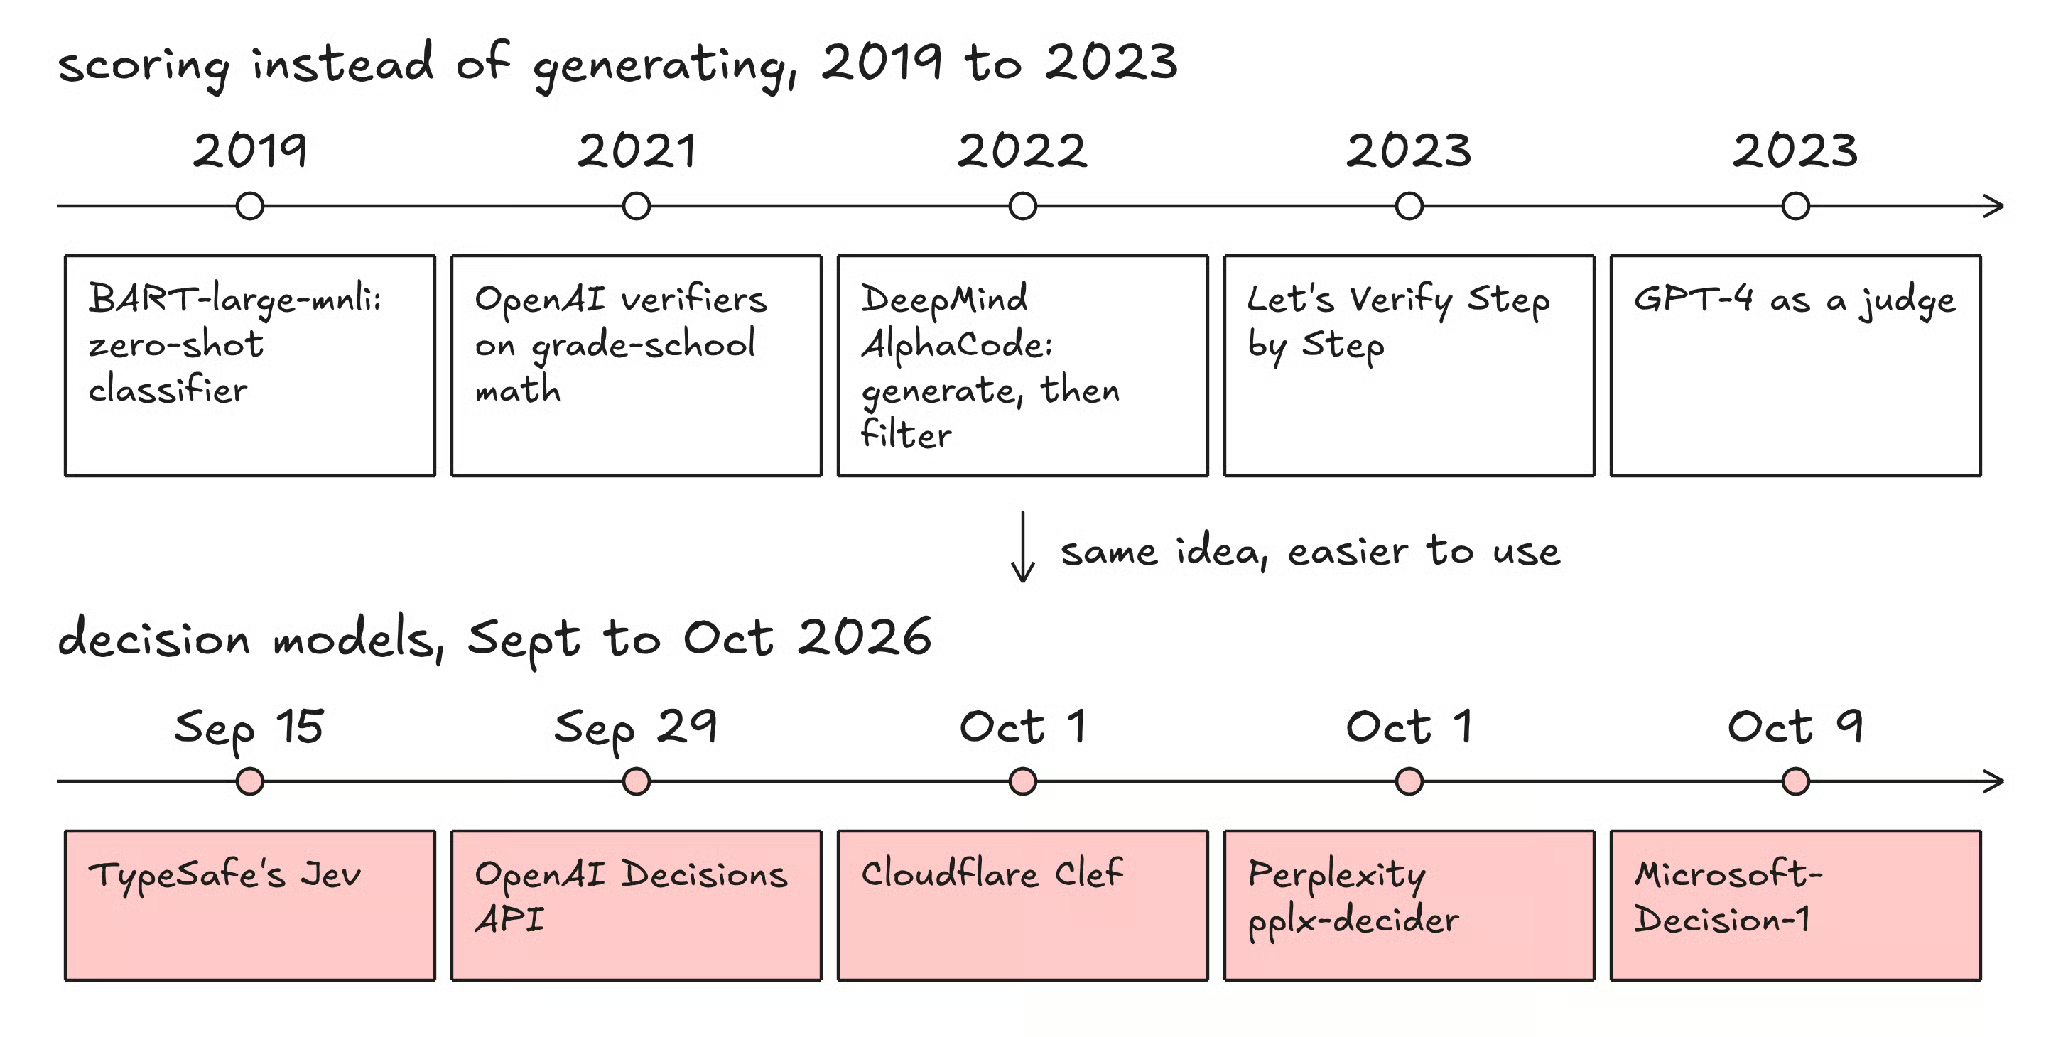
図3:生成ではなくスコアリングの流れは2019年にさかのぼり、ディシジョン・モデルは2026年版。画像は筆者作成。
2019年にはBART-large-mnliのようなモデルが、学習していないラベルにもテキストを振り分けられました。
「このテキストは請求に関するものだ」といった文を各ラベルに対して採点することで実現していました。
Red HatのAIセーフティチームは、ディシジョン・モデルは名称を変えたゼロショット分類器だとすら言える、と示唆しています。
RAGシステムを作ったことがあれば使ったかもしれません。まず高速に候補(例:50文書)を拾い、次にクロスエンコーダが質問と各文書を対に読んで関連度スコアを付けます。
生成は行わず、スコア順に並べ替えるだけです。
これらはLLMが生成した回答を採点するスコアラーです。
2021年、OpenAIの研究者は、モデルにベリファイアを足すと初等数学でモデルを30倍大きくしたのと同程度の改善が得られることを示しました。注目すべき結果です。
2年後の“Let’s Verify Step by Step”論文は、最終解だけでなく推論の各ステップを採点するほうがさらに効果的だと示しました。
単純化すれば、多数の回答を生成して採点し、最良のものだけを残す方法です。DeepMindのAlphaCode(2022)はこれを極端に推し進め、問題ごとに最大100万本のプログラムを生成し、例題テストで約99%を捨て、10本だけ提出しました。
過去のCodeforcesコンテストのシミュレーション評価で、平均して人間参加者の上位54.3%に入りました。
注意点:不完全なスコアラーを強く押しすぎると品質が悪化します。生成側がスコアラーの弱点を突くようになるからです。
この現象は報酬の過最適化と呼ばれます。
大きなLLMが別のモデルの出力を採点する手法です。
2023年の研究では、GPT-4は人間評価者と80%以上の一致を示す一方、長文や先に表示された回答を好むといったバイアスも確認されました。
ディシジョン・モデルは、こうしたジャッジを安価で構造化された方法に置き換えるものとして売り出されています。
エネルギーベースモデルは、入力と解答の相性が良い組に低い「エネルギー」を、悪い組に高いエネルギーを割り当てます。
解答を選ぶとは、最もエネルギーが低いものを見つけること、すなわち候補を採点することに他なりません。
Yann LeCunは、トークン逐次生成は真の知能への道ではなく、エネルギーベース手法やJEPAこそが望ましい方向だと長年主張しています。
ここからは実際に公開されたモデルを見ていきます。動きが非常に速いので要点のみをまとめます。
TypeSafe AIは元OpenAI研究者のDiogo Almeidaが創業したサンフランシスコのスタートアップで、9月15日にJevとDCVC主導の4,000万ドルのシードを発表しました。
JevはホステッドAPIで、本番ではテキスト入力のみを受け付けます。画像入力は実験的機能で専用ヘッダーが必要です。課金は入力トークン単位、出力は無料です(出力が数値のみであることを踏まえると理にかないます)。
10月14日にJev 1.14が続きましたが、jev-latestエイリアスは依然として1.13.0を指しており、本記事後半のRed Hatのテストもこのバージョンで行われました。
ローンチ時は大きな話題となり、Vercelによれば有料チームの約13%が初日24時間でAI Gateway経由でJevを試しました(当時Gateway上では無料提供)。
OpenAIは9月29日のDevDayでDecisions APIを発表しました。
ユーザー定義の固定解答付き質問に対応し、GPT-6 Luna上に構築。10月6日にパブリックベータへ移行し、画像入力にも対応します(Jevの画像対応は実験段階)。
Cloudflareは10月1日にClefと小型のClef-flashを公開し、オープンウェイトとWorkers AIでのホスティングを提供。いずれもQwen系モデルを基盤に、Jevスタイルのリクエストを受け付けるため、Jev向けのコードは最小限の変更でClefに切り替えられます。
| Model | Maker | Released (2026) | Access | Notable detail |
|---|---|---|---|---|
| pplx-decider | Perplexity | October 1 | Open weights and API | Perplexity独自の11ベンチマークパネルでJevの84.51%に対し85.71%と自己申告 |
| Microsoft-Decision-1 | Microsoft | October 9 | Foundry preview | 後学習済みの9B Qwenモデル |
| Laya | Convai Innovations | September | Open weights | 小型(4.21億パラメータ)でノートPCのCPUでも動作。モデルカードではゼロショットエンジンではなく用途特化のベースと位置づけ |
このセクションをまとめていて印象的だったのは、オープン/ビッグテックの多くが通常のLLMのファインチューニング版であることです。Layaだけが例外で、ディシジョン・ヘッドを持つエンコーダです。Jevの内部は非公開。
私見では、真の革新は新規アーキテクチャというよりも、(インターフェースや校正の訓練といった)パッケージングにあるという見方を裏づけます。
使い分けを判断する最も明快な方法は比較です。
| Feature | LLM | Decision model | Fine-tuned classifier | LLM + verifier |
|---|---|---|---|---|
| Output | 自由テキスト | 型付き解答と確率 | 固定ラベル | 複数生成からの最良解 |
| Needs labeled data | 不要 | 不要 | 必要 | しばしば必要 |
| Speed | 数秒 | 数十〜数百ミリ秒 | 非常に高速 | 最も遅い |
| Off-format answers | 起こりうる | 不可能 | 不可能 | 生成側に依存 |
| Explains its answer | 可 | 不可 | 不可 | 可 |
| Best for | 文章生成、コード、推論 | ルーティング、トリアージ、ガードレール | 単一の高ボリューム固定タスク | テスト可能な数学・コード |
大まかな指針は次のとおりです。
最良のシステムはこれらを組み合わせると考えています。
ディシジョン・モデルはLLMの周りで高速な「ゲート」として機能するのがよいでしょう。ゲートは次を判断します。
そうすれば、高価なLLMは本当に何かを書く必要があるときだけ動きます。
ここが最も重要です。オンラインで目にする大きな数字の多くはベンダー発だからです。TypeSafe自身も、速度やコストの見出し数値は実利用の上限に近いと認めています。
2026年10月、Red HatのAIセーフティチームは、プロンプトインジェクション検出と不適切コンテンツ検出の2タスクで9つのガードレール構成を比較しました。
DiffusionGemmaはvLLMで提供されるGemmaのテキスト拡散モデルです。
注目すべき結果は以下のとおりです。
| Method | Type | Prompt injection accuracy | Content safety accuracy |
|---|---|---|---|
| deberta-v3-base | Fine-tuned classifier | 89.01% | - |
| granite-guardian-hap-125m | Fine-tuned classifier | - | 80.27% |
| Qwen3.6-35B | LLM-as-a-judge | 89.31% | 85.47% |
| DiffusionGemma | Decision model (open) | 87.72% | 85.53% |
| Jev | Decision model | 86.35% | 86.20% |
| Laya | Decision model (open) | 85.44% | 57.87% |
| BART-large-mnli | 2019 zero-shot classifier | 61.49% | 68.67% |
コンテンツセーフティではJevが首位で、DiffusionGemmaに0.67ポイント差(Qwenのジャッジが3位)。プロンプトインジェクションではQwenのジャッジが首位でした。
この分かれ方により、Red Hatは総合的にはディシジョン・モデルがLLMジャッジより品質優位を示さなかったと言えます。
私が興味深いと思ったのは、2億パラメータ級の分類器がプロンプトインジェクションでJevに0.3ポイント差まで迫り、レイテンシ中央値がJevの約348ミリ秒に対して100ミリ秒未満だった点です。
Jevの遅延には大西洋横断の往復が含まれます。テストは英国からで、TypeSafeのサーバーは米国にあります。
このホップはローカルCPUモデルとの差は説明しますが、Qwen、Nemotron、DiffusionGemmaも米国クラスター上で動いており、それでもQwenはJevより高速でした。
それでもRed Hatは、Layaを除けば、ディシジョン・モデルはLLM-as-a-judgeに比べて速さ・安さ・品質の面で優位を示さなかったと結論づけました。Layaは小型であることが、プロンプトで限界を回避できるなら真の利点になります。
2026年9月にarXivに投稿された大学研究者の論文は、Jevを44のアラインメント系ベンチマークで評価しました。
結果は興味深い形で混在しています。
この「選択的予測」のポイントは実務上とても有用だと思います。
簡単な設計で、ディシジョン・モデルが易しいケースを処理し、不確実なケースはLLMや人間に回す戦略が有効であることを示しています。
実際にディシジョン・モデルを作ってみましょう。
小型のオープンLLMを先ほどのトークン確率の手法でディシジョン・モデル化し、確率が信頼できるか検証します。
まずはパッケージをインストールします(すべて無料のColabノートブックで実行可能)。
pip install transformers torch datasets sentence-transformers numpyCPUで動く小型のQwen2.5-0.5B-Instructを使います。
やることは簡単です。選択肢にアルファベットを割り当て、モデルを一度だけ走らせ、次トークンがそれらの文字になる確率だけを見るのです。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
return {o: round(p.item(), 3) for o, p in zip(options, probs)}generate()は一度も呼びません。一度のフォワードパスで「A」「B」「C」…のスコアだけを取り出し、他は捨てます。
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
これで本当に動きます。約30行でワーキングなディシジョン・モデルを作れました。
イエス/ノー質問は、2つの選択肢を持つChoice質問にすぎません。
この簡易版がどこで苦戦し始めるかを見ましょう。
選択肢の順序をシャッフルして、同じ質問を再度実行してみてください。
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
このような混在した入力では、選択肢の並びを変えるだけで確率が動くことがよくあります。
これは順序バイアスと呼ばれ、TypeSafeもJevの既知の弱点として「先頭の選択肢への傾き」を挙げています。
また、ほぼ100%の確信が頻繁に出ることもあります。BerrymanはJevで良いテストを行っており、「コインが60%で表」と伝えると、イエス/ノー質問は0.58と近い値を返しました。
しかしChoice質問(「表か裏か?」)では、より尤もらしい方に確率が収束し、表が0.99になりました。
ここは誰もが実行すべき工程だと思います。4クラスのAG Newsデータセットからニュース項目を400件(見出し+短い説明)取り、確率が現実と合っているかを検証します。
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)次に、校正を測る方法が必要です。期待校正誤差(ECE)は、予測を信頼度ビンに分け、各ビンの平均信頼度と実際の正解率の差を測ります。
誤解のないように言うと、低いほど良い値です。
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
ここでコツがあります。
データを半分に分け、前半で確率をより正直にする温度を見つけ、後半で検証します。
1より大きい温度は過信を和らげ、1より小さい温度は過小信頼を引き締めます。
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
精度は変わりません。温度で割っても順位は変わらないからです。
変わるのは確信度だけです。
数値は実行ごとに異なりますが、テスト側のECEはたいてい下がるはずです。テストは200件と少なく推定はノイジーなので、小差は深読みしないでください。
教訓は単純です。他人のデータで校正されているからといって、自分のデータでも校正されているとは限りません。
「生成せずに採点する」という発想が一般的であることを示すため、RAGの文脈でも同様のことを見てみましょう。
クロスエンコーダは質問と各パッセージを採点し、ソートするだけです。
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
print(round(float(result["score"]), 3), passages[result["corpus_id"]])ここでも生成はありません。モデルは各候補に数値を与えるだけです。
よく挙がるユースケースは次のとおりです。
| Use case | How a decision model helps |
|---|---|
| エージェント・ルーティング | 次のステップを担当すべきツールやサブエージェントを決める。 |
| ガードレール | LLMに届く前にプロンプトインジェクションや不適切コンテンツを検知。 |
| サポートのトリアージ | チケットをチーム・トピック・緊急度で振り分ける。 |
| 文書インテーク | 各文書に関する固定チェックリストに回答する。 |
| 検索とRAG | 取得したパッセージを関連度でリランク。 |
| クレジットと不正 | リスクをスコアリング。ただし人物に関する意思決定には人間の確認を伴うべき。 |
| ロボティクス | 遅いLLMプランナーと低レベルのモーター制御の間の高速レイヤーとして機能しうる(現時点では仮説)。 |
個人的に最も面白いのはロボティクスです。
Berrymanは、Jevのようなモデルが、高レベル計画を立てる遅いLLMと、ロボットの関節を動かす運動学モデルの間に挟まる可能性を示唆しています。
ただし、TypeSafeの有名なDoomデモは、生の画像ではなくテキストのテレメトリをJevに与えていたことは知っておく価値があります。
ディシジョン・モデルは有用ですが、過大評価は避けたいところです。
留意すべき主な限界は次のとおりです。
AIディシジョン・モデルは、回答を生成せず候補を採点するという古いアイデアを、ずっと使いやすくしたものです。
学習データは不要で、型付きの回答が返り、複数の質問を一度に投げられます。
私見では、このパッケージングこそが真の革新です。
ディシジョン・モデルはLLMの周辺に配置され、単純な判断を高速・低コストで処理し、本当に文章生成が必要なときだけ高価なモデルが動く、という姿になると予想します。
Top DataCamp Courses
トラック
トラック
練習とトラックであなたの進捗を記録しましょう。
Googleで登録