Ścieżka
Inżynier AI Associate dla programistów
26 godz.
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z GoogleWyobraź sobie, że siadasz w restauracji i kelner pyta: „Woda niegazowana czy gazowana?”. Nie odpowiadasz akapitem o swoich preferencjach nawadniania; wybierasz jedną z dwóch opcji, które ci podano.
Teraz pomyśl, jak używamy dużych modeli językowych (LLM) w większości aplikacji. Pytamy je na przykład: „Czy ten ticket wsparcia dotyczy rozliczeń, wysyłki czy zwrotów?” – a model odpisuje nam pełnym zdaniem, które musimy potem sparsować w kodzie. Realnie były tylko trzy możliwe odpowiedzi, ale i tak zapłaciliśmy za cały proces myślowy.
Tę lukę próbuje wypełnić nowy typ modelu. We wrześniu 2026 startup TypeSafe AI wypuścił Jev – model, który w ogóle nie pisze tekstu.
Zamiast tego przydziela wyniki z góry określonemu zestawowi odpowiedzi i mówi, jak bardzo każda z nich jest prawdopodobna. W ciągu kilku tygodni własne wersje pokazały OpenAI, Cloudflare, Perplexity i Microsoft, co pokazuje, jak szybko rozwija się ta dziedzina.
W tym artykule chcę przyjrzeć się, czym są modele decyzyjne AI, jak działają i skąd właściwie pochodzi ten pomysł (jest dużo starszy, niż sugeruje hype). Zobaczę też, co wykazały niezależne benchmarki.
if.Model decyzyjny AI to model, który przyjmuje wejście i zestaw dozwolonych odpowiedzi i zwraca prawdopodobieństwo każdej odpowiedzi, bez generowania swobodnego tekstu.
Główna idea tych modeli polega na tym, że wynik jest z góry ustrukturyzowany.
Nigdy nie musisz parsować zdania, bo model może zwrócić tylko jedną z odpowiedzi, które mu podałeś. To oznacza, że wynik może od razu trafić do instrukcji if w twoim kodzie.
Lubię myśleć o tej różnicy jak o dwóch typach egzaminów.
Duży model językowy zdaje egzamin esejowy, zapisując odpowiedź słowo po słowie, podczas gdy model decyzyjny zdaje test wielokrotnego wyboru i dodatkowo mówi, jak bardzo jest pewny każdego pola (wynik ufności).
Jev i większość alternatyw dla Jev wspiera trzy typy pytań:
TypeSafe ma też eksperymentalny typ Box do lokalizowania obiektów na obrazach, który tutaj pominę.
Podam przykład z dokumentacji TypeSafe.
Możesz wysłać state (czyli po prostu tekst, który model ma przeanalizować) i mapę questions. Dla pytania typu choice każda opcja ma krótki opis w polu criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
A to była odpowiedź:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Nie ma tu żadnego tekstu do parsowania.
Dostajesz wybraną opcję, prawdopodobieństwo dla każdej opcji i wartość ufności wyprowadzoną z najwyższego prawdopodobieństwa – więc bardziej płaski rozkład oznacza niższą ufność. W dokumentacji, bardziej zawiły ticket, który wspomina zarówno zły rozmiar, jak i podwójne obciążenie, dzieli prawdopodobieństwo między returns (0,61) i billing (0,35), a ufność spada do 0,42.
TypeSafe opisuje Jev jako „System One Model”, zapożyczając z książki Daniela Kahnemana Pułapki myślenia (ang. Thinking, Fast and Slow). Dlaczego?
W dużym uproszczeniu, System 1 to szybka, intuicyjna ocena, a System 2 to wolne, krok po kroku rozumowanie.
Model decyzyjny ma być tym szybkim.
Jedno zastrzeżenie: System 1 to też część mózgu, która popełnia szybkie błędy i, co warto zaznaczyć, w dokumentacji TypeSafe otwarcie wymienia miejsca, gdzie Jev się myli. Wrócimy do tego.
Na początku myliło mnie, że „model decyzyjny” już znaczy kilka innych rzeczy. Może odnosić się do:
Dla jasności: w tym artykule „model decyzyjny” oznacza wyłącznie nową kategorię modeli wypuszczonych pod koniec 2026 r., które oceniają typowane odpowiedzi zamiast pisać tekst.
Zanim przejdziemy do działania modeli decyzyjnych, warto zobaczyć, jak zwykły LLM tworzy odpowiedź. To ułatwia dostrzeżenie różnicy.
Duży model językowy działa w pętli.
Zamienia nasz tekst na tokeny, przewiduje prawdopodobieństwo każdego tokena ze swojego słownika, wybiera jeden, dodaje go do tekstu i powtarza.
Każdy dodatkowy token w odpowiedzi to kolejny forward pass przez model.
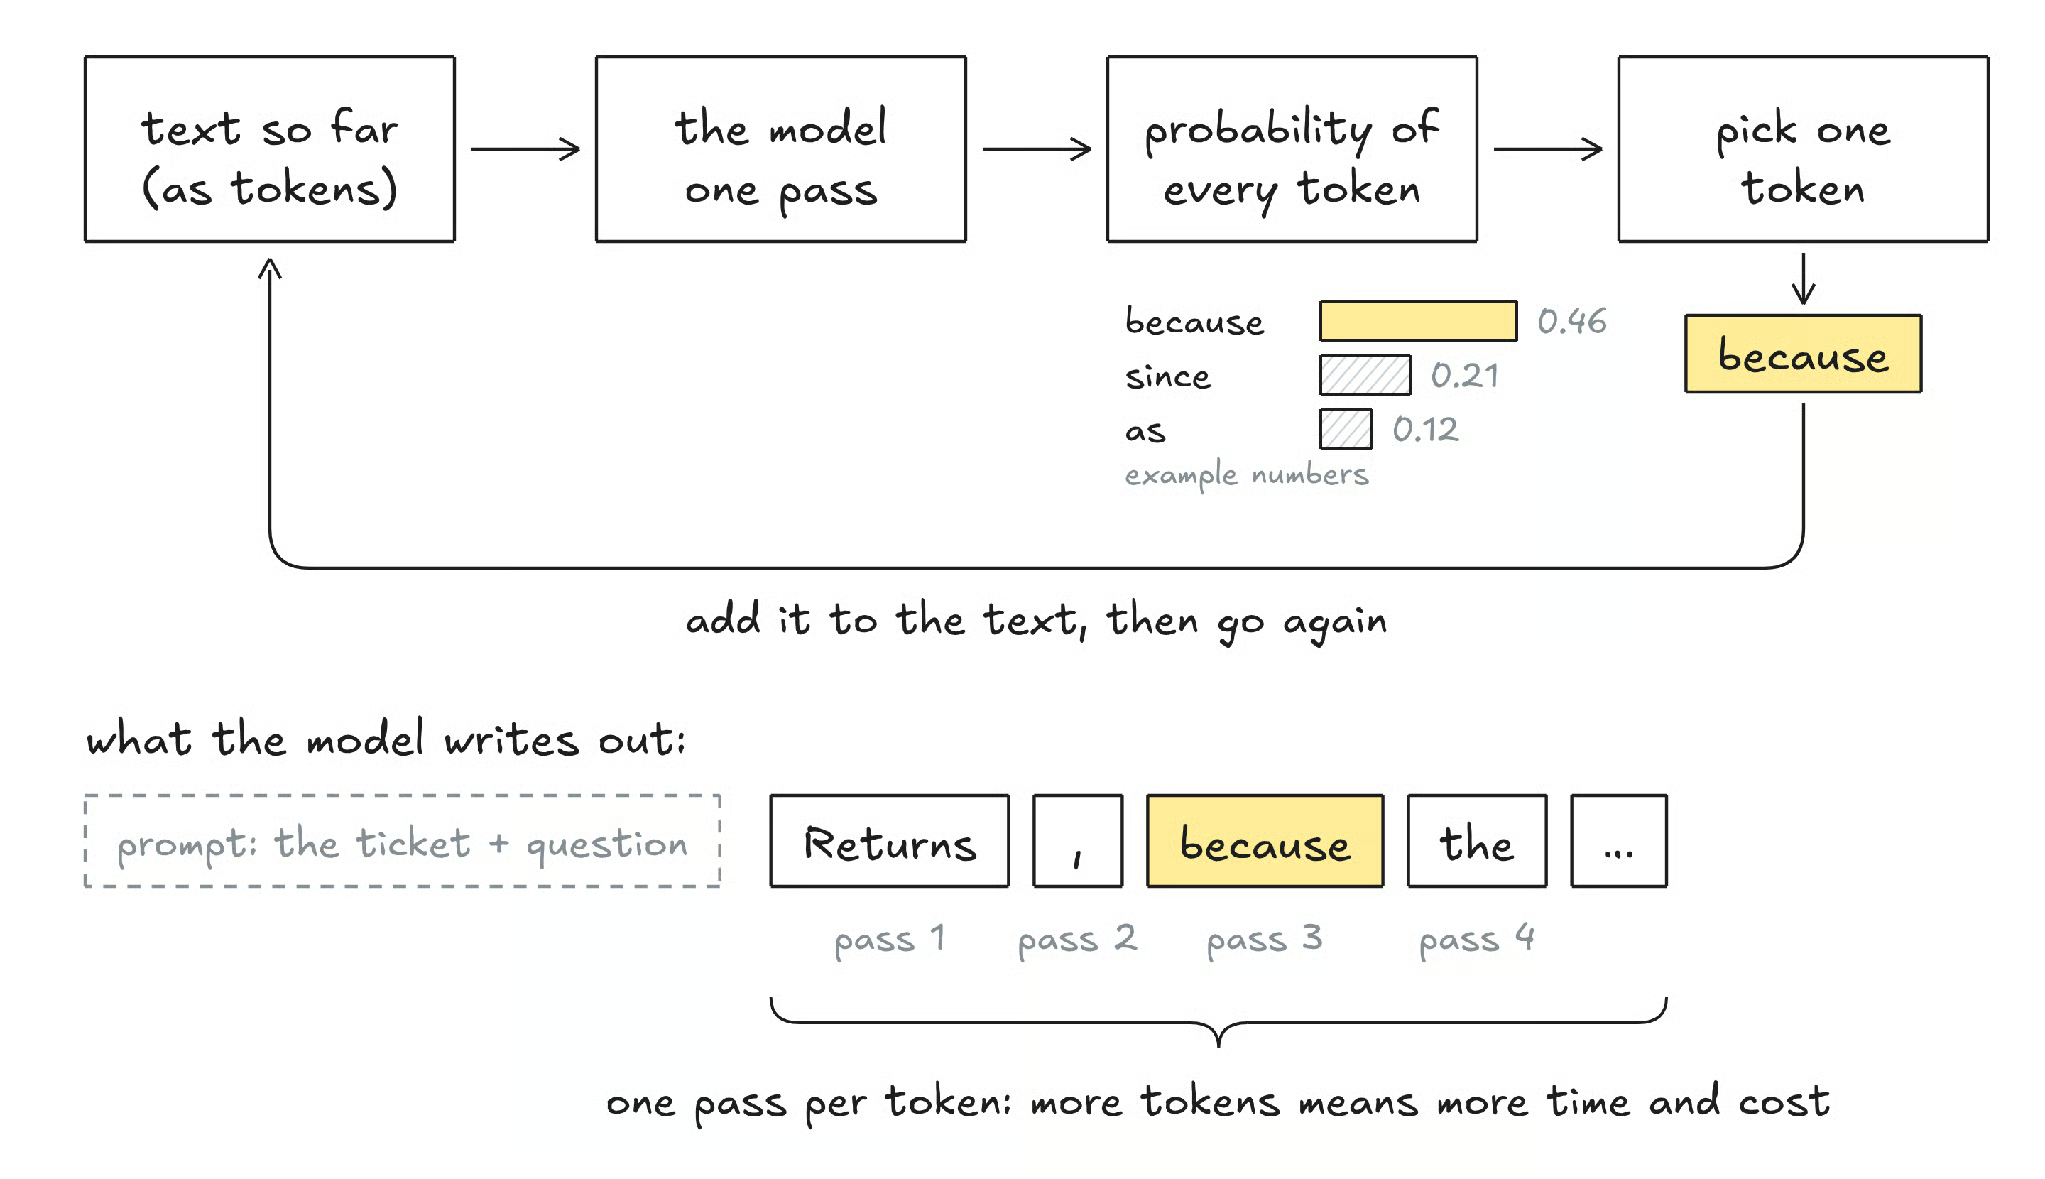
Rysunek 1: LLM potrzebuje jednego przebiegu w przód dla każdego tokena, który zapisze. Oryginalna grafika autora.
Ta pętla świetnie działa do pisania e-maili, kodu czy wyjaśnień, ale przy prostych decyzjach powoduje kilka problemów:
Modele decyzyjne próbują rozwiązać dokładnie te problemy.
Przejdźmy teraz do mechaniki.
Warto zrozumieć tu trzy rzeczy:
Spójrzmy na każdą z nich.
Model decyzyjny czyta twoje wejście i pytania i produkuje wynik dla każdej dozwolonej odpowiedzi.
Te wyniki zazwyczaj zamienia się na prawdopodobieństwa przy pomocy funkcji softmax. Jak pewnie widzisz, nie ma tu długiej pętli, bo nie ma nic do pisania.
Dokumentacja TypeSafe mówi też, że pytania w tym samym żądaniu są oceniane równolegle, więc dodanie kolejnych niewiele zmienia czas odpowiedzi.
Stąd bierze się większość szybkości i TypeSafe podaje, że Jev zwykle odpowiada w ok. 70–500 milisekund.
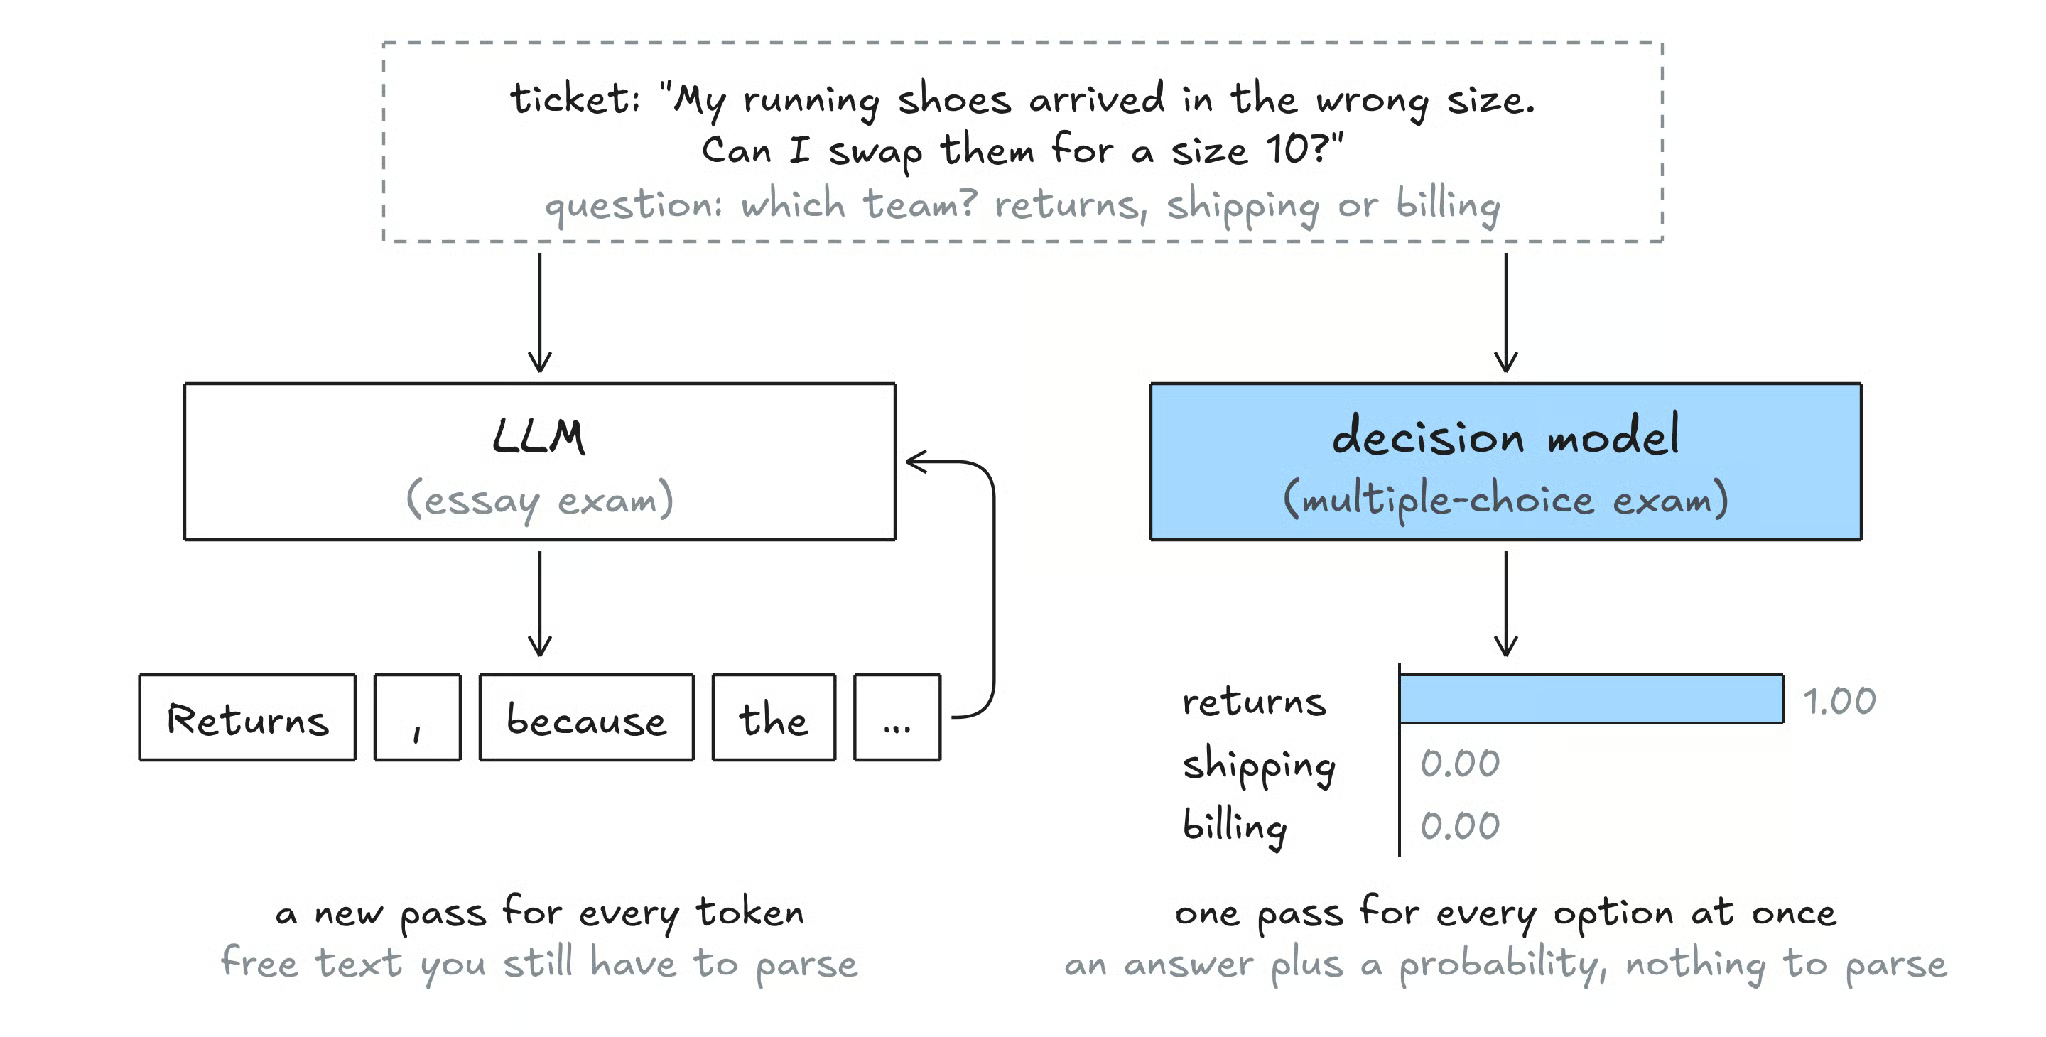
Rysunek 2: Ten sam ticket, obsłużony przez LLM i przez model decyzyjny. Oryginalna grafika autora.
Nie ma jednej „architektury modelu decyzyjnego”.
TypeSafe nie opublikował, jak działa Jev, ale w przybliżeniu są trzy sposoby uzyskania tych wyników:
Nie przejmuj się, gdzie użyto którego: wszystkie trzy kończą w tym samym miejscu – liczbą dla każdej dozwolonej odpowiedzi.
To według mnie najważniejsze, więc podam przykład.
Wyobraź sobie, że model mówi „70% szans” przy 100 różnych pytaniach. Jeśli model jest dobrze skalibrowany, ok. 70 z tych odpowiedzi powinno okazać się poprawnych.
Kalibracja ma znaczenie, bo skalibrowane prawdopodobieństwa pozwalają nam ustawiać bezpieczne progi w kodzie, np. „automatycznie zatwierdź powyżej 90%, w przeciwnym razie wyślij do człowieka”.
Jeśli prawdopodobieństwa nie zgadzają się z rzeczywistością, te progi nic nie znaczą.
Dostawcy trenują to przy pomocy funkcji straty, które karzą nadmierną pewność.
TypeSafe nazywa swoją metodę Reinforcement Learning for Calibrated Decisions (RLCD), a Cloudflare mówi, że łączy cross-entropy z Brier loss w swoich modelach Clef.
Może cię to zaskoczyć, ale idea oceniania kandydatów zamiast ich generowania istnieje od lat.
Moim zdaniem modele decyzyjne to najnowsza i najwygodniejsza wersja, a nie zupełnie nowy wynalazek. Oto główne rodziny modeli, na których się opierają.
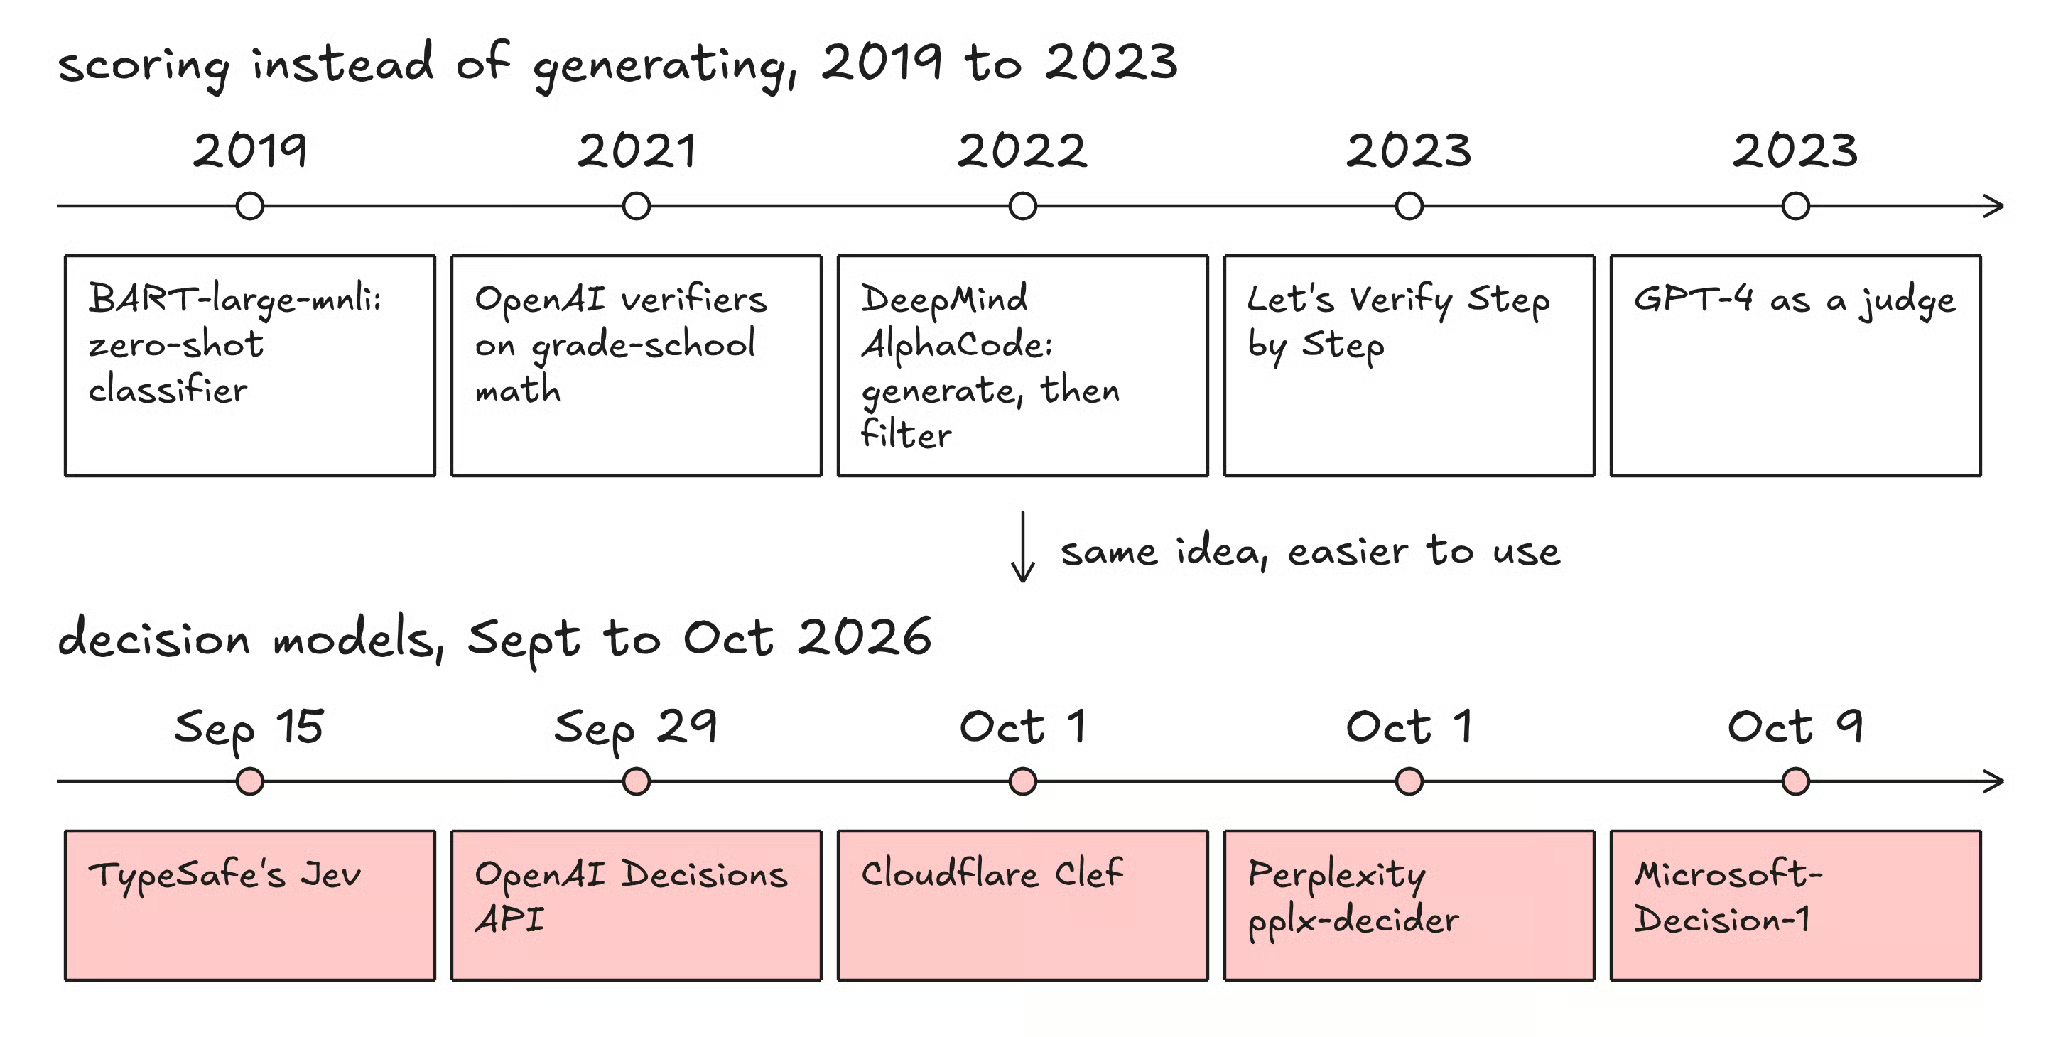
Rysunek 3: Ocenianie zamiast generowania sięga 2019 r., a modele decyzyjne to wersja z 2026 r. Oryginalna grafika autora.
Już w 2019 r. modele takie jak BART-large-mnli potrafiły sortować tekst do etykiet, na których nie były trenowane.
Robiły to, oceniając zdania w stylu „ten tekst jest o billing” dla każdej możliwej etykiety.
Zespół AI safety Red Hata sugeruje, że modele decyzyjne to de facto te klasyfikatory zero-shot pod nową nazwą.
Jeśli budowałeś system RAG, mogłeś ich używać. Najpierw szybko pobierasz shortlistę (np. 50 dokumentów), potem cross-encoder czyta twoje pytanie i każdy dokument razem i przypisuje każdej parze wynik trafności.
Niczego nie generuje; dokumenty są po prostu uporządkowane wg wyniku.
To „scorery”, które oceniają odpowiedzi już wygenerowane przez LLM.
W 2021 r. badacze OpenAI pokazali, że dodanie weryfikatora do modelu dało skok w zadaniach matematyki szkolnej mniej więcej równy powiększeniu modelu 30-krotnie – co robi wrażenie.
Dwa lata później praca „Let’s Verify Step by Step” pokazała, że ocenianie każdego kroku rozumowania działa jeszcze lepiej niż ocenianie tylko końcowej odpowiedzi.
Prosta wersja: generujesz wiele odpowiedzi, oceniasz każdą i zostawiasz najlepszą. AlphaCode DeepMinda (2022) poszło w skrajność: generowało do miliona programów na problem, odrzucało ok. 99% testami przykładowymi i zgłaszało tylko 10.
W symulacjach na archiwalnych konkursach Codeforces zajmowało średnio top 54,3% ludzi.
Uwaga: jeśli zbyt mocno dociśniesz niedoskonały „scorer”, jakość w końcu spadnie, bo generator zacznie wykorzystywać jego błędy.
Technicznie nazywa się to reward overoptimization.
To sytuacja, gdy duży LLM ocenia wyjście innego modelu.
Badanie z 2023 r. wykazało, że GPT-4 zgadzało się z ludźmi w ponad 80% przypadków, ale miało też biasy, jak preferencja dla dłuższych odpowiedzi albo tej pokazanej jako pierwsza.
Modele decyzyjne są częściowo sprzedawane jako tańszy, ustrukturyzowany zamiennik tych sędziów.
Model energetyczny nadaje niski wynik „energii” parze wejście–odpowiedź, która do siebie pasuje, i wysoki parom, które nie pasują.
Wybór odpowiedzi to potem po prostu znalezienie najniższej energii – znów ocenianie kandydatów.
Yann LeCun od lat argumentuje, że generowanie token po tokenie nie prowadzi do prawdziwej inteligencji, a podejścia energetyczne i JEPA to lepszy kierunek.
Teraz o modelach, które faktycznie się ukazały. Rzeczy dzieją się tu szybko, więc każdą pozycję streścę krótko.
TypeSafe AI to startup z San Francisco założony przez Diogo Almeidę, byłego badacza OpenAI, który wyszedł z ukrycia 15 września 2026 z Jev i rundą seed 40 mln dolarów prowadzoną przez DCVC.
Jev to hostowane API. W produkcji przyjmuje tylko tekst; obrazy są eksperymentalne i wymagają nagłówka opt-in. Rozliczanie jest za tokeny wejściowe, a wyjścia są darmowe – co ma sens, skoro wyjście to tylko kilka liczb.
Jev 1.14 pojawił się 14 października, choć alias jev-latest nadal wskazuje 1.13.0, wersję testowaną przez Red Hat później w artykule.
Wokół premiery było sporo szumu. Vercel podał, że ok. 13% płacących zespołów wypróbowało Jev przez AI Gateway w ciągu pierwszych 24 godzin, choć wtedy było to darmowe na gatewayu.
OpenAI ogłosiło Decisions API na DevDay 29 września 2026.
Działa z definiowanymi przez użytkownika pytaniami mającymi stały zestaw odpowiedzi i jest zbudowane na GPT-6 Luna. 6 października przeszło do publicznej bety i potrafi też przyjmować obrazy, co Jev wspiera tylko eksperymentalnie.
Cloudflare wypuścił Clef i mniejszy Clef-flash 1 października 2026, z otwartymi wagami i hostingiem na Workers AI. Oba są oparte na modelach Qwen i akceptują żądania w stylu Jev, więc kod napisany pod Jev można skierować na Clef z minimalnymi zmianami.
| Model | Twórca | Premiera (2026) | Dostęp | Wyróżnik |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 października | Otwarte wagi i API | Samozgłaszane 85,71% vs 84,51% Jev na własnym panelu 11 benchmarków Perplexity |
| Microsoft-Decision-1 | Microsoft | 9 października | Foundry preview | Model Qwen 9B po dodatkowym treningu |
| Laya | Convai Innovations | Wrzesień | Otwarte wagi | Mały (421M parametrów), działa na CPU laptopa; karta modelu opisuje go jako bazę do specjalizacji, nie silnik zero-shot |
Co rzuca się w oczy, to że większość otwartych i bigtechowych modeli to dostrojenia zwykłych LLM. Laya jest wyjątkiem: to enkoder z głowicą decyzyjną. Wnętrzności Jev są nieujawnione.
Moim zdaniem wspiera to tezę, że prawdziwą innowacją jest opakowanie (interfejs i trening kalibracji), a nie zupełnie nowa architektura.
Najjaśniejszy sposób wyboru to porównanie:
| Cecha | LLM | Model decyzyjny | Klasyfikator fine-tuned | LLM + weryfikator |
|---|---|---|---|---|
| Wyjście | Swobodny tekst | Typowana odpowiedź i prawdopodobieństwa | Stałe etykiety | Najlepsza z kilku wygenerowanych odpowiedzi |
| Wymaga danych z etykietami | Nie | Nie | Tak | Często |
| Szybkość | Sekundy | DZIESIĄTki–setki milisekund | Bardzo szybki | Najwolniejszy |
| Odpowiedzi poza formatem | Możliwe | Niemożliwe | Niemożliwe | Zależy od generatora |
| Wyjaśnia swoją odpowiedź | Tak | Nie | Nie | Tak |
| Najlepsze do | Pisania, kodu, rozumowania | Routingu, triage, guardrails | Jednego stałego zadania o dużej skali | Matematyki, kodu z testami |
Mój prosty drogowskaz:
Wierzę, że najlepsze systemy łączą to wszystko.
Widzę modele decyzyjne jako szybkie „bramki” wokół LLM. Bramka decyduje:
Dzięki temu drogi LLM działa tylko wtedy, gdy naprawdę trzeba coś napisać.
To najważniejsza część, bo większość dużych liczb online pochodzi od samych dostawców. Nawet TypeSafe przyznaje, że ich czołowe zyski prędkości i kosztów są z wyższej półki tego, co zobaczysz w praktyce.
W październiku 2026 zespół AI safety Red Hata porównał dziewięć konfiguracji guardrail na dwóch zadaniach: wykrywanie prompt injection i niebezpiecznych treści.
DiffusionGemma to model Gemma typu text-diffusion serwowany przez vLLM.
Oto najciekawsze wyniki:
| Metoda | Typ | Dokładność prompt injection | Dokładność bezpieczeństwa treści |
|---|---|---|---|
| deberta-v3-base | Klasyfikator fine-tuned | 89,01% | - |
| granite-guardian-hap-125m | Klasyfikator fine-tuned | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Model decyzyjny (open) | 87,72% | 85,53% |
| Jev | Model decyzyjny | 86,35% | 86,20% |
| Laya | Model decyzyjny (open) | 85,44% | 57,87% |
| BART-large-mnli | Klasyfikator zero-shot z 2019 | 61,49% | 68,67% |
Jev był pierwszy w bezpieczeństwie treści, wyprzedzając DiffusionGemmę o 0,67 p.p. (sędzia Qwen był trzeci), a Qwen wygrał w prompt injection.
Ten podział pozwala Red Hatowi stwierdzić, że łącznie modele decyzyjne nie dały zysku jakości nad LLM-as-a-judge.
Mnie najbardziej interesuje to, że klasyfikator z 200 mln parametrów był tylko 0,3 p.p. z tyłu w prompt injection, z medianą opóźnienia poniżej 100 ms wobec ok. 348 dla Jev.
Opóźnienie Jev obejmowało przelot przez Atlantyk, bo testy uruchamiano z UK, a serwery TypeSafe są w USA.
Ten skok wyjaśnia tylko różnicę do lokalnych modeli CPU. Qwen, Nemotron i DiffusionGemma też działały w klastrze w USA, a Qwen i tak był szybszy niż Jev.
Mimo to Red Hat podsumował, że modele decyzyjne nie dały szybszych, tańszych ani lepszych odpowiedzi niż LLM-as-a-judge w ich testach – wyjątkiem jest Laya, której mały rozmiar jest realną zaletą, jeśli potrafisz obejść jej ograniczenia promptem.
Artykuł naukowy badaczy akademickich, opublikowany na arXiv we wrześniu 2026, przetestował Jev na 44 benchmarkach alignmentu.
Wyniki były ciekawie mieszane:
Uważam, że punkt o selektywnych predykcjach jest w praktyce bardzo użyteczny.
Pokazuje, że prosta architektura, w której model decyzyjny obsługuje łatwe przypadki, a niepewne przekazuje do LLM lub człowieka, to dobra strategia.
Zbudujmy teraz model decyzyjny sami.
Przerobimy mały otwarty LLM na model decyzyjny, używając sztuczki z prawdopodobieństwami tokenów, a potem sprawdzimy, czy można ufać jego prawdopodobieństwom.
Najpierw zainstaluj pakiety (wszystko możesz uruchomić w darmowym notatniku Colab):
pip install transformers torch datasets sentence-transformers numpyUżyjemy Qwen2.5-0.5B-Instruct, który jest na tyle mały, że działa na CPU.
Pomysł jest prosty: etykietujemy opcje literami, uruchamiamy model raz i patrzymy tylko na prawdopodobieństwa tych liter jako następnego tokena.
import torch from transformers import AutoTokenizer, AutoModelForCausalLM model_name = "Qwen/Qwen2.5-0.5B-Instruct" tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name) model.eval() def option_logits(state, question, options): letters = [chr(ord("A") + i) for i in range(len(options))] option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options)) messages = [ {"role": "system", "content": "Answer with a single letter only."}, {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"}, ] prompt = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True ) inputs = tokenizer(prompt, return_tensors="pt") with torch.no_grad(): next_token_logits = model(**inputs).logits[0, -1].float() letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters] return next_token_logits[letter_ids] def decide(state, question, options, temperature=1.0): logits = option_logits(state, question, options) probs = torch.softmax(logits / temperature, dim=-1) return {o: round(p.item(), 3) for o, p in zip(options, probs)}Zauważ, że nigdy nie wywołujemy
generate(). Robimy jeden przebieg w przód, zachowujemy wyniki dla „A”, „B”, „C” itd., a całą resztę wyrzucamy.print(decide( state="My running shoes arrived in the wrong size. Can I swap them for a size 10?", question="Which team should handle this?", options=["returns", "shipping", "billing"], )) print(decide( state="The app crashes every time I open the settings page.", question="Does this message describe a software bug?", options=["yes", "no"], ))I to naprawdę wszystko. Właśnie stworzyliśmy działający model decyzyjny w ok. 30 liniach.
Pytanie tak/nie to po prostu pytanie typu choice z dwiema opcjami.
Krok 2: Wypatrz osobliwości
Zobaczmy teraz, gdzie ta prosta wersja zaczyna się potykać.
Spróbuj przetasować kolejność opcji i uruchom to samo pytanie ponownie:
options = ["returns", "shipping", "billing"] state = "My shoes arrived late and in the wrong size, and I was charged twice." question = "Which team should handle this?" print(decide(state, question, options)) print(decide(state, question, list(reversed(options))))Przy zawiłych wejściach, takich jak to, często zobaczysz, że prawdopodobieństwa przesuwają się tylko dlatego, że zmieniła się kolejność opcji.
To bias kolejności i TypeSafe faktycznie wymienia skłonność do pierwszej opcji jako jedną z znanych słabości Jev.
Możesz też zauważyć, że model często daje odpowiedzi bliskie 100%. Berryman uruchomił fajny test na samym Jev: powiedział mu, że moneta wypada orzeł 60% czasu i pytanie tak/nie zwróciło 0,58 – całkiem blisko.
Ale pytanie choice („orzeł czy reszka?”) zwróciło 0,99 dla orła, bo prawdopodobieństwo zwinęło się na bardziej prawdopodobnej odpowiedzi.
Krok 3: Zmierz i popraw kalibrację
To krok, który każdy powinien wykonać. Weźmiemy 400 newsów z datasetu AG News (każdy to nagłówek plus krótki opis) z czterema tematami i sprawdzimy, czy nasze prawdopodobieństwa zgadzają się z rzeczywistością.
import numpy as np from datasets import load_dataset data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400)) labels = ["World", "Sports", "Business", "Science and technology"] question = "What is the topic of this news headline?" all_logits, targets = [], [] for row in data: all_logits.append(option_logits(row["text"], question, labels)) targets.append(row["label"]) all_logits = torch.stack(all_logits) targets = torch.tensor(targets)Następnie potrzebujemy miary kalibracji. Expected calibration error (ECE) grupuje predykcje do kubełków ufności i sprawdza, jak daleko średnia ufność w kubełku odbiega od rzeczywistej trafności.
Dla jasności: niżej = lepiej:
def expected_calibration_error(probs, targets, n_bins=10): confidences, predictions = probs.max(dim=-1) correct = (predictions == targets).float() bins = np.linspace(0, 1, n_bins + 1) ece = 0.0 for lo, hi in zip(bins[:-1], bins[1:]): mask = (confidences > lo) & (confidences <= hi) if mask.any(): gap = abs(correct[mask].mean() - confidences[mask].mean()) ece += mask.float().mean() * gap return float(ece), float(correct.mean())Teraz sztuczka.
Dzielimy dane na pół, używamy pierwszej połowy do znalezienia temperatury, która uczyni prawdopodobieństwa bardziej uczciwymi, a potem testujemy na drugiej.
Temperatura powyżej 1 zmiękcza nadmiernie pewne predykcje, a poniżej 1 wyostrza zbyt niepewne.
calib_logits, test_logits = all_logits[:200], all_logits[200:] calib_targets, test_targets = targets[:200], targets[200:] def nll(temperature): probs = torch.softmax(calib_logits / temperature, dim=-1) picked = probs[torch.arange(len(calib_targets)), calib_targets] return -torch.log(picked + 1e-12).mean().item() temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)] best_t = min(temperatures, key=nll) before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets) after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets) print(f"Best temperature: {best_t:.2f}") print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}") print(f"After: ECE={after[0]:.3f}, accuracy={after[1]:.3f}")Dokładność się nie zmienia, bo dzielenie przez temperaturę nie zmienia tego, która opcja jest pierwsza w rankingu.
Zmienia się tylko ufność.
Twoje dokładne liczby będą zależeć od uruchomienia, ale ECE na części testowej zwykle spadnie. Przy tylko 200 testowych wpisach oszacowanie jest szumne, więc nie wyciągaj wniosków z małych różnic.
Wniosek jest prosty: to, że model jest skalibrowany na czyichś danych, nie oznacza, że jest skalibrowany na twoich.
Krok 4: Oceniaj kandydatów cross-encoderm
Żeby pokazać, jak powszechne jest „oceniaj, nie generuj”, oto to samo w ustawieniu RAG.
Cross-encoder ocenia każdy akapit względem pytania i po prostu je sortujemy:
from sentence_transformers import CrossEncoder reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2") query = "How do I get a refund for a double charge?" passages = [ "Our app supports dark mode on all devices.", "If you were charged twice, contact billing and we will refund the duplicate payment.", "Refunds are processed within five business days.", "You can change your password from the settings page.", ] for result in reranker.rank(query, passages): print(round(float(result["score"]), 3), passages[result["corpus_id"]])Znów nic się nie generuje: model daje każdemu kandydatowi liczbę.
Zastosowania modeli decyzyjnych
To najczęstsze use case’y:
| Zastosowanie | Jak pomaga model decyzyjny |
|---|---|
| Routing agentów | Decyduje, które narzędzie lub sub-agent powinien wykonać kolejny krok. |
| Guardrails | Flagi prompt injection lub niebezpieczne treści, zanim trafią do LLM. |
| Triage wsparcia | Routuje tickety wg zespołu, tematu i pilności. |
| Przyjęcie dokumentów | Odpowiada na stałą checklistę pytań o każdy dokument. |
| Wyszukiwanie i RAG | Rerankuje pobrane akapity wg trafności. |
| Kredyt i fraud | Ocena ryzyka, choć decyzje dotyczące ludzi powinny nadal obejmować przegląd przez człowieka. |
| Robotyka | Może działać jako szybka warstwa między wolnym planistą LLM a niskopoziomową kontrolą ruchu, choć to wciąż spekulacja. |
Punkt o robotyce podoba mi się najbardziej.
Berryman sugeruje, że model jak Jev mógłby siedzieć między wolnym LLM planującym na wysokim poziomie a modelami kinematycznymi poruszającymi stawami robota.
Warto jednak wiedzieć, że słynne demo Dooma od TypeSafe karmiło Jev telemetrią tekstową, a nie surowymi obrazami.
Modele decyzyjne są przydatne, ale nie chcę ich przereklamować.
Oto główne ograniczenia, o których warto pamiętać:
Modele decyzyjne AI biorą bardzo stary pomysł oceniania kandydatów zamiast generowania odpowiedzi i robią go dużo łatwiejszym w użyciu.
Nie potrzebujesz danych treningowych; dostajesz typowane odpowiedzi i możesz zadawać wiele pytań naraz.
Moim zdaniem to opakowanie jest prawdziwą innowacją.
Spodziewam się, że modele decyzyjne będą siedzieć wokół LLM jako szybkie, tanie bramki do prostych decyzji, żeby drogi model działał tylko wtedy, gdy naprawdę trzeba coś napisać.
Najlepsze kursy DataCamp
Ścieżka
Ścieżka
Ćwicz i monitoruj swoje postępy.
Kontynuuj Z Google