
Programma
Ingegnere AI associato per sviluppatori
26 ore
Pratica and corso your progress.
Continua Con GoogleImmagina di sederti al ristorante e il cameriere ti chiede: “Naturale o frizzante?” Non rispondi con un paragrafo sulle tue preferenze d’idratazione; scegli una delle due opzioni che ti hanno dato.
Ora pensa a come usiamo i large language model (LLM) nella maggior parte delle app di oggi. Facciamo domande tipo “Questo ticket di supporto riguarda fatturazione, spedizioni o resi?” e il modello ci scrive una frase completa, che poi dobbiamo analizzare con un po’ di codice. In pratica, c’erano solo tre risposte possibili, ma abbiamo comunque pagato per un intero processo di pensiero.
È proprio questo il divario che questo nuovo tipo di modello cerca di colmare. A settembre 2026, una startup chiamata TypeSafe AI ha rilasciato Jev, un modello che non scrive testo.
Invece, assegna un punteggio a un set fisso di risposte e ti dice quanto è probabile ciascuna. Nel giro di poche settimane, OpenAI, Cloudflare, Perplexity e Microsoft hanno lanciato le loro versioni, a dimostrazione della velocità con cui si muove questo settore.
In questo articolo, voglio esplorare cosa sono questi modelli decisionali di AI, come funzionano e da dove viene davvero l’idea (è molto più vecchia di quanto suggerisca l’hype). Darò anche uno sguardo a cosa hanno rilevato i benchmark indipendenti.
if.Un modello decisionale di AI è un modello che riceve un input e un set di risposte consentite e restituisce la probabilità di ciascuna risposta, senza generare testo libero.
L’idea principale di questi modelli è che l’output è già strutturato.
Non devi mai analizzare una frase, perché il modello può restituire solo una delle risposte che gli hai fornito. Questo significa che il risultato può finire direttamente in un’istruzione if nel tuo codice.
Mi piace pensare alla differenza come a due tipi di esami.
Un large language model sostiene un tema, scrivendo la risposta parola per parola, mentre un modello decisionale sostiene un test a scelta multipla e ti dice anche quanto è sicuro per ogni casella (uno score di confidenza).
Jev e la maggior parte delle alternative a Jev supportano tre tipi di domande:
TypeSafe ha anche un tipo Box sperimentale per localizzare elementi nelle immagini, che qui salterò.
Ti faccio un esempio tratto dalla documentazione di TypeSafe.
Puoi inviare uno state (cioè il testo che vuoi che il modello analizzi) e una mappa di questions. Per una domanda di tipo choice, ogni opzione include una breve descrizione in un campo chiamato criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
E questa è stata la relativa risposta:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Non c’è testo da analizzare.
Ottieni l’opzione scelta, una probabilità per ogni opzione e un valore di confidenza derivato dalla probabilità più alta, quindi una distribuzione più piatta implica una confidenza minore. Nella documentazione, un ticket più confuso che menziona sia una misura sbagliata sia un doppio addebito divide la probabilità tra resi (0,61) e fatturazione (0,35), e la confidenza scende a 0,42.
TypeSafe descrive Jev come un “System One Model”, prendendo in prestito dal libro di Daniel Kahneman Pensieri lenti e veloci. Perché?
In parole molto semplici, il Sistema 1 è il tuo giudizio rapido e istintivo, mentre il Sistema 2 è il tuo ragionamento lento e passo dopo passo.
Un modello decisionale è pensato per essere quello rapido.
Una precisazione: il Sistema 1 è anche la parte del cervello che commette errori veloci e, a onor del vero, la documentazione di TypeSafe elenca apertamente dove Jev sbaglia. Ci torneremo più avanti.
Una cosa che mi ha confuso leggendo per la prima volta è che “modello decisionale” indica già altre cose. Può riferirsi a:
Quindi, per essere chiari, in questo articolo “modello decisionale” indica solo la nuova categoria di modelli rilasciata a fine 2026 che assegna punteggi a risposte tipizzate invece di scrivere testo.
Prima di entrare in come funzionano i modelli decisionali, aiuta vedere come un LLM normale produce la sua risposta. Credo renda la differenza più chiara.
Un large language model lavora in un loop.
Trasforma il nostro testo in token, predice una probabilità per ogni token nel suo vocabolario, ne seleziona uno, lo aggiunge al testo e poi ripete.
Ogni token in più nella risposta significa un altro forward pass attraverso il modello.
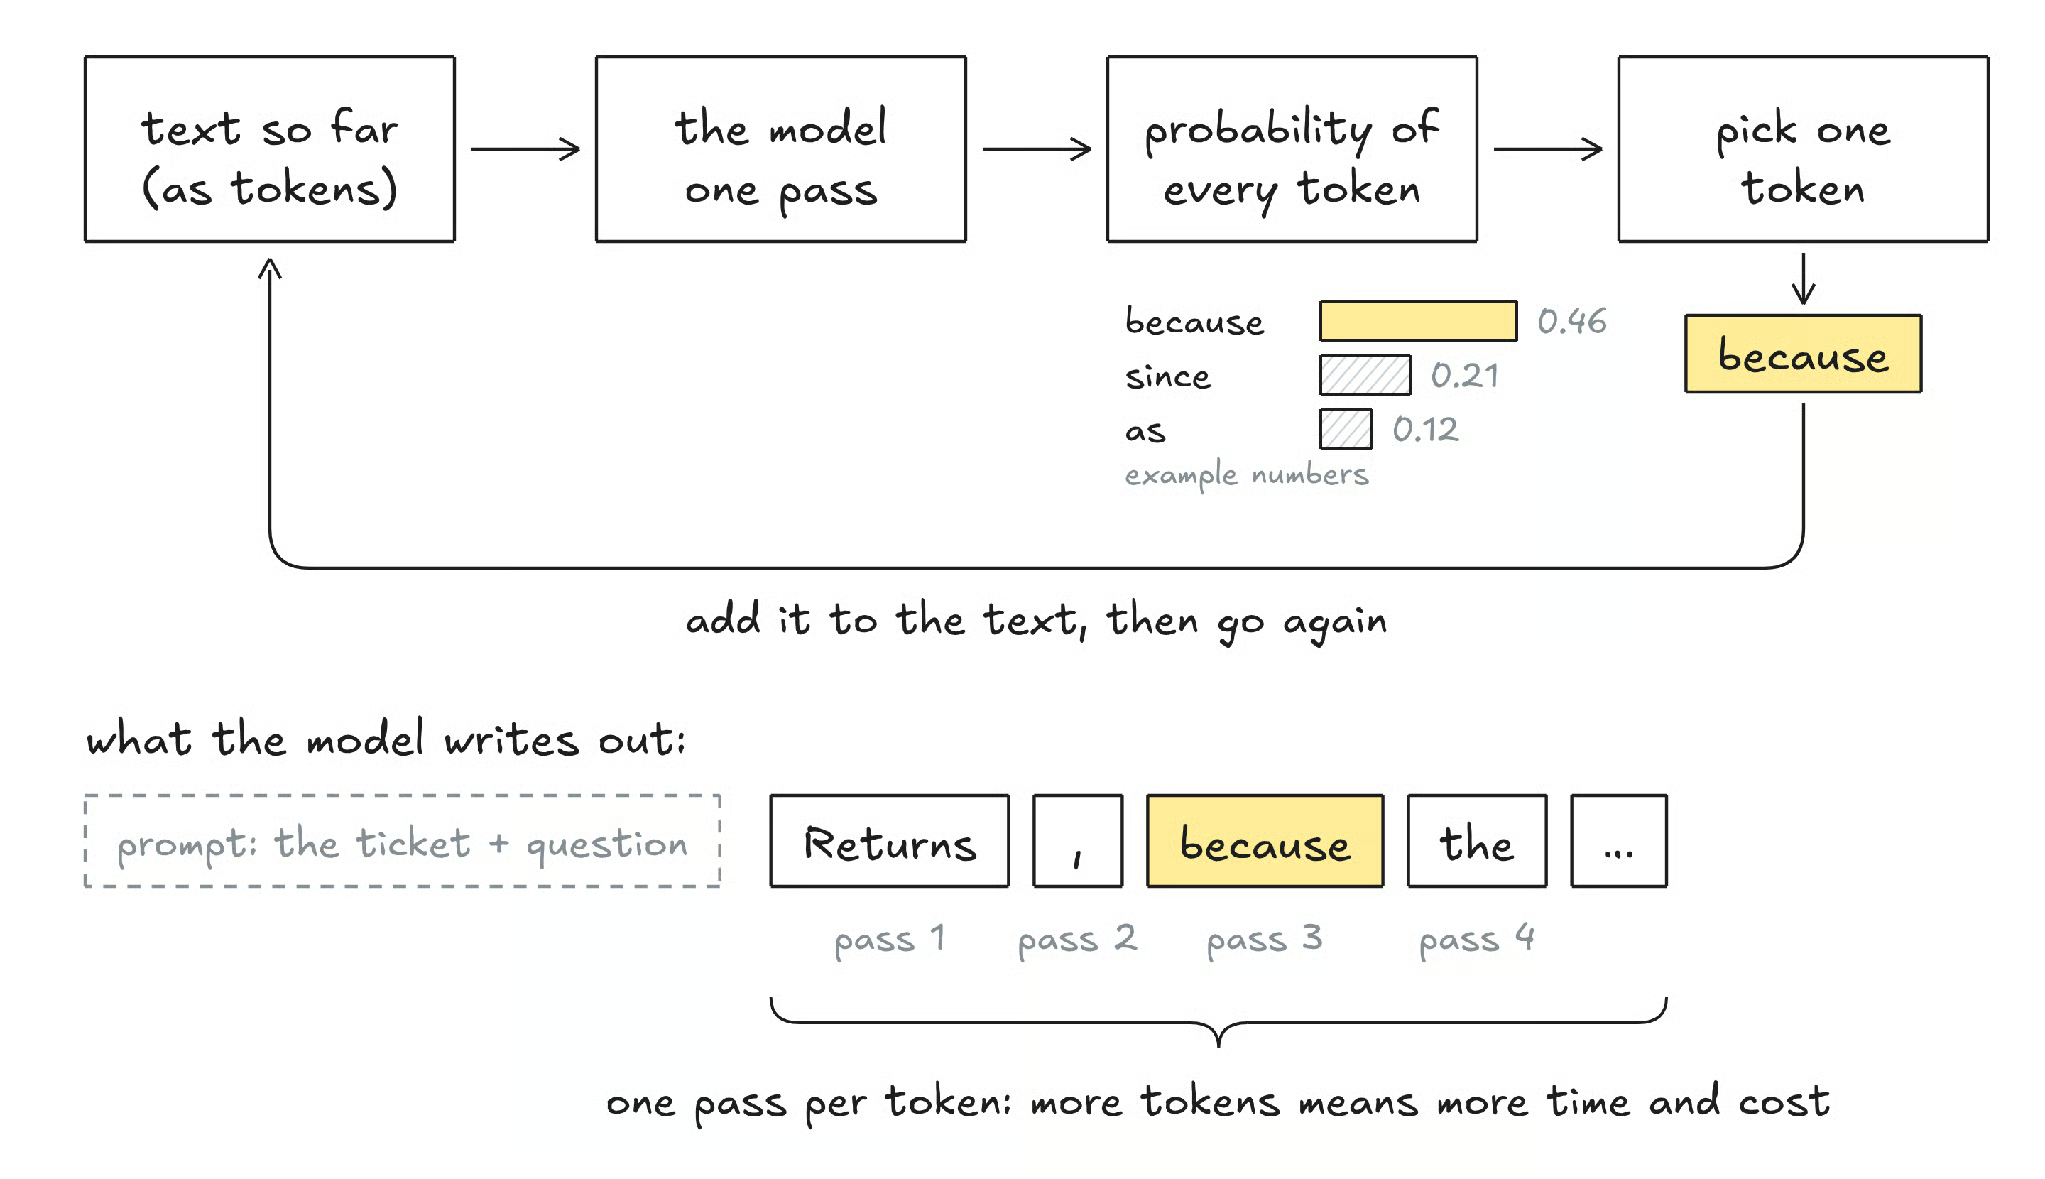
Figura 1: Un LLM ha bisogno di un forward pass per ogni token che scrive. Immagine originale dell’autore.
Questo loop funziona bene per scrivere email, codice o spiegazioni, ma per decisioni semplici può causare alcuni problemi:
I modelli decisionali cercano di risolvere proprio questi problemi.
Passiamo ora alla meccanica effettiva.
Ci sono tre idee da capire qui:
Vediamole nel dettaglio.
Un modello decisionale legge il tuo input e le domande e produce un punteggio per ciascuna risposta consentita.
Questi punteggi sono tipicamente convertiti in probabilità usando una funzione softmax. Come puoi intuire, non c’è un lungo loop perché non c’è nulla da scrivere.
La documentazione di TypeSafe dice anche che le domande nello stesso request sono valutate in parallelo, quindi aggiungerne altre cambia a malapena il tempo di risposta.
È qui che nasce gran parte della velocità, e TypeSafe afferma che Jev risponde tipicamente in circa 70–500 millisecondi.
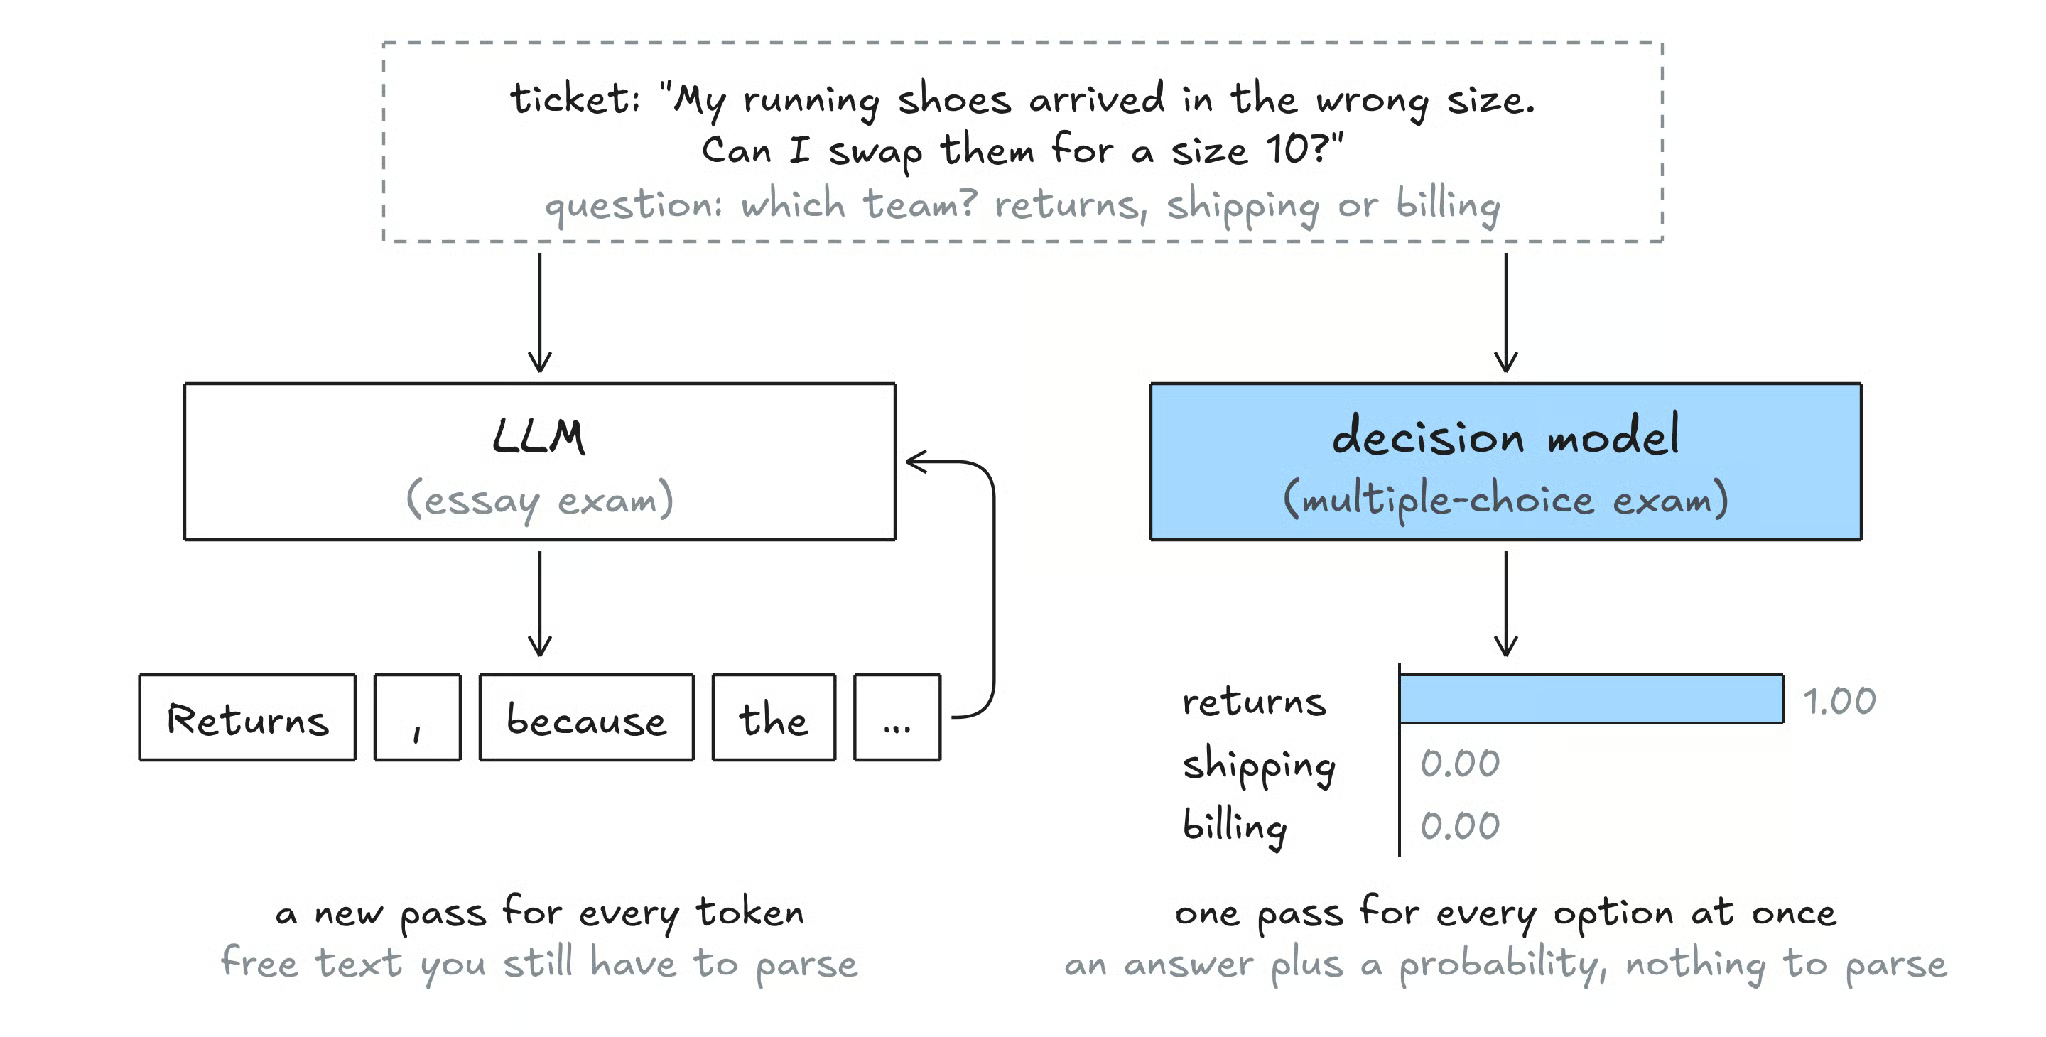
Figura 2: Lo stesso ticket, risposto da un LLM e da un modello decisionale. Immagine originale dell’autore.
Non esiste una singola “architettura del modello decisionale”.
TypeSafe non ha pubblicato come funzioni Jev, ma ci sono grosso modo tre modi per ottenere questi punteggi:
Non preoccuparti di quale approccio sia usato dove: tutti e tre portano allo stesso risultato, un numero per ogni risposta consentita.
Questa è la parte che secondo me conta di più, quindi ti faccio un esempio.
Immagina che un modello dica “70% probabile” su 100 domande diverse. Se il modello è ben calibrato, circa 70 di quelle risposte dovrebbero risultare corrette.
La calibrazione conta perché probabilità calibrate ci permettono di impostare soglie sicure nel codice, tipo “approva automaticamente sopra il 90%, altrimenti invia a un umano”.
Se le probabilità non corrispondono alla realtà, quelle soglie sono prive di senso.
I vendor addestrano a questo scopo usando funzioni di loss che penalizzano l’eccesso di confidenza.
TypeSafe chiama il suo metodo Reinforcement Learning for Calibrated Decisions (RLCD), mentre Cloudflare afferma di abbinare cross-entropy a una Brier loss per i suoi modelli Clef.
Potrebbe sorprenderti, ma l’idea di assegnare punteggi ai candidati invece di generarli esiste da anni.
A mio avviso, i modelli decisionali sono l’ultima e più comoda versione di questa idea, più che un’invenzione del tutto nuova. Ecco le principali famiglie di modelli su cui si basano.
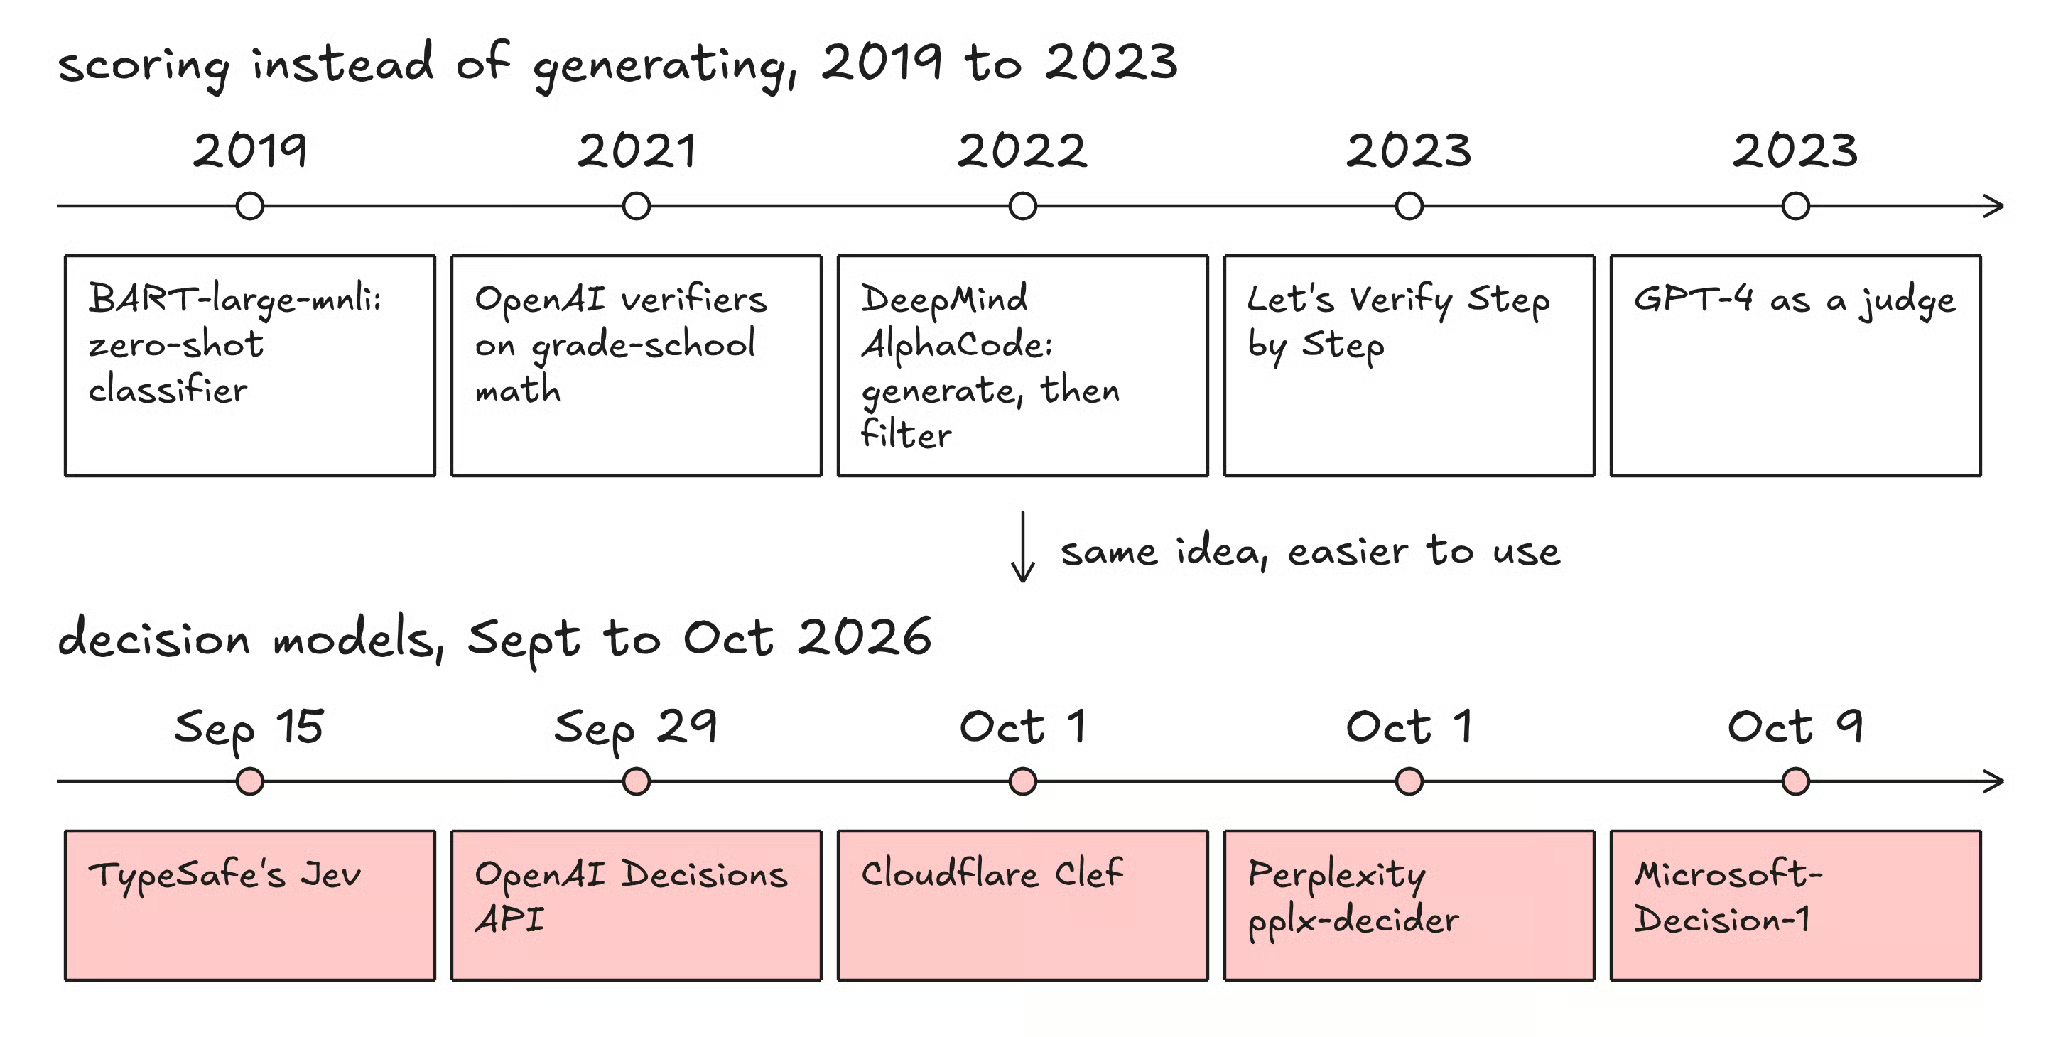
Figura 3: Lo scoring al posto della generazione risale al 2019, e i modelli decisionali sono la versione 2026. Immagine originale dell’autore.
Già nel 2019, modelli come BART-large-mnli potevano classificare testi in etichette su cui non erano stati addestrati.
Lo facevano assegnando un punteggio ad affermazioni come “questo testo riguarda la fatturazione” per ogni etichetta possibile.
Il team AI safety di Red Hat suggerisce che i modelli decisionali siano in fondo questi zero-shot classifier con un nuovo nome.
Se hai costruito un sistema RAG, potresti averne usato uno. Prima recuperi velocemente una shortlist (per esempio 50 documenti), poi un cross-encoder legge insieme la tua domanda e ciascun documento e assegna a ogni coppia un punteggio di rilevanza.
Non si genera nulla; i documenti sono semplicemente riordinati in base al punteggio.
Questi sono scorer che valutano risposte già generate da un LLM.
Nel 2021, ricercatori di OpenAI hanno mostrato che aggiungere un verifier a un modello dava un boost in matematica di scuola elementare pari a rendere il modello 30 volte più grande, cosa notevole.
Due anni dopo, il paper “Let’s Verify Step by Step” ha mostrato che valutare ogni passo del ragionamento funziona ancora meglio che valutare solo la risposta finale.
La versione semplice è generare molte risposte, valutarle tutte e tenere la migliore. AlphaCode di DeepMind (2022) ha portato questo all’estremo generando fino a un milione di programmi per problema, scartandone circa il 99% con test di esempio e inviandone poi solo 10.
Nelle valutazioni simulate su passati contest di Codeforces, si è piazzato in media nel 54,3% migliore dei concorrenti umani.
Un avvertimento: se spingi troppo su uno scorer imperfetto, la qualità alla fine cala perché il generatore finisce per sfruttare gli errori dello scorer.
Il termine tecnico è reward overoptimization.
Qui un grande LLM valuta l’output di un altro modello.
Uno studio del 2023 ha rilevato che GPT-4 concordava con i giudici umani oltre l’80% delle volte, ma aveva anche bias, come preferire risposte più lunghe o quella mostrata per prima.
I modelli decisionali vengono in parte proposti come sostituti più economici e strutturati di questi giudici.
Un energy-based model assegna un punteggio di “energia” basso a una coppia input–risposta che si adatta bene e alto a coppie che non si adattano.
Scegliere una risposta significa trovare l’energia più bassa, cioè ancora una volta assegnare punteggi ai candidati.
Yann LeCun sostiene da anni che generare token per token non è la strada verso una vera intelligenza e che gli approcci energy-based e JEPA siano una direzione migliore.
Ora voglio parlare dei modelli effettivamente rilasciati. Le cose si muovono molto in fretta, quindi sarò conciso per ciascuno.
TypeSafe AI è una startup di San Francisco fondata da Diogo Almeida, ex ricercatore di OpenAI, ed è uscita dalla modalità stealth il 15 settembre 2026 con Jev e un seed round da 40 milioni di dollari guidato da DCVC.
Jev è un’API gestita. In produzione accetta solo testo; l’input di immagini è sperimentale e richiede un header di opt-in. Il prezzo è basato sui token di input, e gli output sono gratuiti, il che ha senso quando l’output è solo qualche numero.
Jev 1.14 è arrivato il 14 ottobre, anche se l’alias jev-latest punta ancora alla 1.13.0, la versione testata da Red Hat più avanti in questo articolo.
Il lancio ha generato molto buzz. Vercel ha affermato che circa il 13% dei suoi team a pagamento ha provato Jev tramite l’AI Gateway nelle prime 24 ore, anche se in quel momento era gratuito sul gateway.
OpenAI ha annunciato la sua Decisions API al DevDay il 29 settembre 2026.
Funziona con domande definite dall’utente che hanno un set fisso di risposte ed è costruita su GPT-6 Luna. È passata alla beta pubblica il 6 ottobre e può anche accettare immagini, cosa che Jev supporta solo in via sperimentale.
Cloudflare ha rilasciato Clef e una versione più piccola, Clef-flash, il 1° ottobre 2026, con pesi open e hosting su Workers AI. Entrambi sono basati su modelli Qwen e accettano richieste in stile Jev, quindi il codice scritto per Jev può essere puntato su Clef con pochissime modifiche.
| Modello | Produttore | Rilascio (2026) | Accesso | Dettaglio notevole |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 ottobre | Pesi open e API | Autodichiara 85,71% contro l’84,51% di Jev sul proprio pannello di 11 benchmark |
| Microsoft-Decision-1 | Microsoft | 9 ottobre | Anteprima Foundry | Un modello Qwen da 9B post-addestrato |
| Laya | Convai Innovations | Settembre | Pesi open | Piccolo (421M di parametri), gira su CPU di un laptop; la sua scheda modello lo definisce una base da specializzare, non un motore zero-shot |
Ciò che mi ha colpito mettendo insieme questa sezione è che la maggior parte dei modelli open e big-tech qui sono versioni fine-tuned di normali LLM. Laya è l’eccezione: è un encoder con una testata decisionale. Gli interni di Jev non sono divulgati.
Secondo me, questo supporta l’idea che la vera innovazione sia il packaging (cioè l’interfaccia e l’addestramento per la calibrazione) più che una nuova architettura.
Il modo più chiaro per decidere quando usarne uno è il confronto:
| Caratteristica | LLM | Modello decisionale | Classifier fine-tuned | LLM + verifier |
|---|---|---|---|---|
| Output | Testo libero | Risposta tipizzata e probabilità | Etichette fisse | Migliore tra più risposte generate |
| Serve dati etichettati | No | No | Sì | Spesso |
| Velocità | Secondi | Decine-centinaia di millisecondi | Molto veloce | La più lenta |
| Risposte fuori formato | Possibili | Impossibili | Impossibili | Dipende dal generatore |
| Spiega la risposta | Sì | No | No | Sì |
| Ideale per | Scrittura, codice, ragionamento | Instradamento, triage, guardrail | Un singolo task ad alto volume | Matematica, codice con test |
La mia regola pratica è questa:
Credo che i sistemi migliori combinino tutti questi elementi.
Vedo i modelli decisionali agire come “gate” rapidi attorno a un LLM. Un gate decide:
In questo modo, l’LLM costoso gira solo quando c’è davvero bisogno di scrivere qualcosa.
Questa sezione conta di più, perché molti numeri che vedrai online provengono dai vendor stessi. Anche TypeSafe ammette che i suoi guadagni di velocità e costo di facciata sono nella fascia alta rispetto a ciò che vedresti nell’uso reale.
Nell’ottobre 2026, il team AI safety di Red Hat ha confrontato nove setup di guardrail su due task: rilevare prompt injection e contenuti non sicuri.
DiffusionGemma è un modello Gemma text-diffusion servito tramite vLLM.
Ecco i risultati più interessanti:
| Metodo | Tipo | Accuratezza prompt injection | Accuratezza content safety |
|---|---|---|---|
| deberta-v3-base | Classifier fine-tuned | 89,01% | - |
| granite-guardian-hap-125m | Classifier fine-tuned | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Modello decisionale (open) | 87,72% | 85,53% |
| Jev | Modello decisionale | 86,35% | 86,20% |
| Laya | Modello decisionale (open) | 85,44% | 57,87% |
| BART-large-mnli | Zero-shot classifier 2019 | 61,49% | 68,67% |
Jev è arrivato primo nella content safety, davanti a DiffusionGemma di 0,67 punti percentuali (il giudice Qwen era terzo), e Qwen è arrivato primo nella prompt injection.
Questa divisione spiega perché Red Hat può comunque dire che, nel complesso, i modelli decisionali non hanno mostrato un guadagno di qualità rispetto agli LLM judge.
Ma la parte che trovo più interessante è che un classifier da 200 milioni di parametri è arrivato solo 0,3 punti percentuali dietro nella prompt injection, con una latenza mediana sotto i 100 millisecondi rispetto ai circa 348 di Jev.
La latenza di Jev includeva anche un viaggio attraverso l’Atlantico, dato che i test sono stati eseguiti dal Regno Unito e i server di TypeSafe sono negli Stati Uniti.
Quel salto spiega solo il divario rispetto ai modelli locali su CPU. Qwen, Nemotron e DiffusionGemma giravano anch’essi su un cluster negli USA, e Qwen era comunque più veloce di Jev.
Detto ciò, Red Hat ha concluso che nei loro test i modelli decisionali non hanno fornito risposte più veloci, economiche o migliori di LLM-as-a-judge, tranne Laya, il cui vantaggio reale è la piccola dimensione se riesci a “promptare” attorno ai suoi limiti.
Un paper universitario, pubblicato su arXiv a settembre 2026, ha testato Jev su 44 benchmark di allineamento.
I risultati sono stati interessanti e contrastanti:
Trovo molto utile, nella pratica, il punto sulla selezione delle predizioni.
Mostra che un design semplice in cui il modello decisionale gestisce i casi facili e passa quelli incerti a un LLM o a una persona è una buona strategia.
Costruiamo ora un modello decisionale da soli.
Trasformeremo un piccolo LLM open in un modello decisionale usando il trucco delle probabilità dei token visto prima e poi verificheremo se possiamo davvero fidarci delle sue probabilità.
Per prima cosa, installiamo i pacchetti con questo (puoi eseguire tutto su un notebook Colab gratuito):
pip install transformers torch datasets sentence-transformers numpyUseremo Qwen2.5-0.5B-Instruct, abbastanza piccolo da girare su CPU.
L’idea è semplice: etichettiamo le opzioni con lettere, eseguiamo il modello una volta e guardiamo solo le probabilità di quelle lettere come prossimo token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Nota che non chiamiamo mai generate(). Facciamo un solo forward pass, tenendo i punteggi per “A”, “B”, “C” e così via, e poi buttiamo via tutto il resto.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
E questo è davvero tutto. Abbiamo appena creato un modello decisionale funzionante in circa 30 righe.
Una domanda sì/no è semplicemente una domanda di tipo choice con due opzioni.
Ora vediamo dove questa versione semplice inizia a faticare.
Prova a mescolare l’ordine delle opzioni ed esegui di nuovo la stessa domanda:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Su input confusi come questo, spesso vedremo le probabilità spostarsi solo perché le opzioni si sono mosse.
Questo si chiama order bias, e TypeSafe elenca effettivamente una tendenza verso la prima opzione tra i punti deboli noti di Jev.
Potresti anche vedere il modello dare risposte quasi al 100% piuttosto spesso. Berryman ha fatto un bel test su Jev stesso: ha detto che una moneta cade su testa il 60% delle volte e la domanda sì/no ha restituito 0,58, che è vicino.
Ma la domanda di tipo choice (“testa o croce?”) ha restituito 0,99 per testa, perché la probabilità è collassata sull’opzione più probabile.
Questo è il passaggio che, secondo me, tutti dovrebbero eseguire. Prenderemo 400 notizie dal dataset AG News (ognuna è un titolo più una breve descrizione), che ha quattro argomenti, e verificheremo se le nostre probabilità corrispondono alla realtà.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Poi ci serve un modo per misurare la calibrazione. L’Expected Calibration Error (ECE) raggruppa le predizioni in bin di confidenza e verifica quanto la confidenza media in ogni bin si discosta dall’accuratezza reale.
Per chiarezza, più basso è meglio:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Ed ecco il trucco.
Dividiamo i dati in due, usiamo la prima metà per trovare una temperatura che renda le probabilità più oneste e poi testiamo sulla seconda metà.
Una temperatura sopra 1 attenua le predizioni troppo sicure, mentre una temperatura sotto 1 rende più decise quelle troppo caute.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
L’accuratezza non cambia, perché dividere per una temperatura non cambia quale opzione è prima in classifica.
Cambia solo la confidenza.
I tuoi numeri esatti dipenderanno dall’esecuzione, ma l’ECE sulla metà di test dovrebbe di solito scendere. Con solo 200 elementi di test, la stima è rumorosa, quindi non dare troppo peso a piccole differenze.
La lezione è semplice: che un modello sia calibrato sui dati di qualcun altro non significa che lo sia sui tuoi.
Per mostrarti quanto sia comune questa idea di “assegnare punteggi, non generare”, ecco la stessa cosa in un contesto RAG.
Un cross-encoder assegna un punteggio a ciascun passaggio rispetto a una domanda e noi li ordiniamo:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Ancora una volta, non si genera nulla: il modello assegna a ciascun candidato un numero.
Questi sono i casi d’uso che ricorrono più spesso:
| Caso d’uso | Come aiuta un modello decisionale |
|---|---|
| Instradamento degli agenti | Decide quale strumento o sotto-agente dovrebbe gestire il prossimo passo. |
| Guardrail | Segnala prompt injection o contenuti non sicuri prima che raggiungano l’LLM. |
| Triage del supporto | Instrada i ticket per team, argomento e urgenza. |
| Acquisizione documenti | Risponde a una checklist fissa di domande su ogni documento. |
| Search e RAG | Riorganizza i passaggi recuperati in base alla rilevanza. |
| Credito e frodi | Valuta il rischio, anche se le decisioni sulle persone dovrebbero comunque coinvolgere una revisione umana. |
| Robotica | Potrebbe fungere da livello rapido tra un pianificatore LLM lento e il controllo motorio di basso livello, anche se è ancora speculativo. |
Il punto sulla robotica è quello che personalmente mi piace di più.
Berryman suggerisce che un modello come Jev potrebbe sedere tra un LLM lento che fa piani ad alto livello e i modelli cinematici che muovono le articolazioni di un robot.
Vale la pena sapere, però, che la celebre demo di Doom di TypeSafe ha fornito a Jev telemetria testuale piuttosto che immagini grezze.
I modelli decisionali sono utili, ma non voglio esagerare.
Ecco le principali limitazioni da tenere a mente:
I modelli decisionali di AI riprendono un’idea molto vecchia, assegnare punteggi ai candidati invece di generare risposte, e la rendono molto più facile da usare.
Non ti servono dati di training; ottieni risposte tipizzate e puoi porre molte domande in una volta.
A mio avviso, questo packaging è la vera innovazione.
Mi aspetto che i modelli decisionali siedano attorno agli LLM come gate rapidi ed economici che gestiscono le decisioni semplici, così il modello costoso gira solo quando c’è davvero bisogno di scrivere qualcosa.
I migliori corsi DataCamp
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



