
लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंमान लीजिए आप किसी रेस्तरां में बैठे हैं और वेटर पूछता है, “साधारण या सोडा?” आप अपने हाइड्रेशन पसंद पर एक पैराग्राफ नहीं बोलते; आप दिए गए दो विकल्पों में से एक चुनते हैं।
अब सोचिए कि आज ज़्यादातर ऐप्स में हम बड़े भाषा मॉडल्स (LLMs) का कैसे उपयोग करते हैं। हम उनसे ऐसे सवाल पूछते हैं, “क्या यह सपोर्ट टिकट बिलिंग, शिपिंग, या रिटर्न्स के बारे में है?” और मॉडल हमें वापस पूरा वाक्य लिखकर देता है, जिसे फिर हमें कुछ कोड से पार्स करना पड़ता है। वास्तविकता में, वहाँ केवल तीन संभावित उत्तर थे, लेकिन हमने फिर भी पूरे सोचने-लिखने की प्रक्रिया के लिए भुगतान कर दिया।
यही वह गैप है जिसे यह नए तरह का मॉडल भरने की कोशिश कर रहा है। सितंबर 2026 में, TypeSafe AI नामक एक स्टार्टअप ने Jev जारी किया, एक ऐसा मॉडल जो बिल्कुल टेक्स्ट लिखता ही नहीं।
इसके बजाय, यह तय उत्तरों के सेट को स्कोर करता है और बताता है कि हर एक की संभावना कितनी है। कुछ ही हफ्तों में OpenAI, Cloudflare, Perplexity, और Microsoft ने अपने-अपने संस्करण जारी कर दिए, जो दिखाता है कि यह क्षेत्र कितनी तेज़ी से आगे बढ़ रहा है।
इस लेख में, मैं देखना चाहता हूँ कि ये AI निर्णय मॉडल क्या हैं, ये कैसे काम करते हैं, और यह विचार असल में कहाँ से आया (यह इस हाइप से कहीं पुराना है)। मैं यह भी देखूँगा कि स्वतंत्र बेंचमार्क्स ने क्या पाया।
if स्टेटमेंट में जा सकता है।AI निर्णय मॉडल ऐसा मॉडल है जो एक इनपुट और अनुमत उत्तरों के सेट को लेता है और बिना कोई फ्री-टेक्स्ट जनरेट किए हर उत्तर की संभावना लौटाता है।
इन मॉडलों का मुख्य विचार यह है कि आउटपुट पहले से संरचित होता है।
आपको कभी वाक्य पार्स नहीं करना पड़ता क्योंकि मॉडल केवल उन्हीं उत्तरों में से कुछ दे सकता है जो आपने दिए हैं। इसका मतलब परिणाम सीधे आपके कोड के if स्टेटमेंट में जा सकता है।
मुझे यह अंतर दो तरह के एग्ज़ाम्स जैसा लगता है।
एक बड़ा भाषा मॉडल निबंध परीक्षा देता है, अपना उत्तर शब्द दर शब्द लिखता है, जबकि एक निर्णय मॉडल बहुविकल्पीय परीक्षा देता है और हर बॉक्स के बारे में यह भी बताता है कि वह कितना आश्वस्त है (एक कॉन्फिडेंस स्कोर)।
Jev और अधिकतर Jev विकल्प तीन तरह के प्रश्न सपोर्ट करते हैं:
TypeSafe के पास इमेज में चीज़ें लोकेट करने के लिए एक प्रायोगिक Box प्रकार भी है, जिसे मैं यहाँ छोड़ रहा हूँ।
मैं TypeSafe के अपने दस्तावेज़ से एक उदाहरण दूँगा।
आप state (यानी वह टेक्स्ट जिस पर आप मॉडल का ध्यान चाहें) और questions का एक मैप भेज सकते हैं। Choice प्रश्न के लिए, हर विकल्प के साथ criteria नाम के फ़ील्ड में एक छोटा विवरण आता है।
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
और इसका संबंधित जवाब यह था:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
यहाँ पार्स करने के लिए कोई टेक्स्ट नहीं है।
आपको चुना गया विकल्प मिलता है, हर विकल्प की संभावना मिलती है, और शीर्ष संभावना से निकला एक कॉन्फिडेंस मान मिलता है, इसलिए सपाट वितरण का मतलब कम कॉन्फिडेंस। दस्तावेज़ में, एक गड़बड़ टिकट जो गलत साइज और डबल चार्ज दोनों का ज़िक्र करता है, उसकी संभावना returns (0.61) और billing (0.35) में बंटती है, और कॉन्फिडेंस 0.42 तक गिर जाता है।
TypeSafe, Daniel Kahneman की किताब Thinking, Fast and Slow से उधार लेकर, Jev को “System One Model” कहता है। ऐसा क्यों?
सरल भाषा में, सिस्टम 1 आपका तेज़, सहज निर्णय है, और सिस्टम 2 आपका धीमा, चरण-दर-चरण तर्क।
एक निर्णय मॉडल तेज़ वाला होने के लिए बना है।
एक चेतावनी: सिस्टम 1 हमारे दिमाग का वही हिस्सा है जो जल्दी-जल्दी गलतियाँ भी करता है, और TypeSafe के श्रेय के लिए, उसके अपने डॉक्यूमेंट खुले तौर पर बताते हैं कि Jev कहाँ गलतियाँ करता है। हम इस पर आगे लौटेंगे।
जब मैंने पहली बार इसके बारे में पढ़ा, तो मुझे यह बात उलझन भरी लगी कि “डिसीजन मॉडल” पहले से ही कई और चीज़ों को भी कहते हैं। यह संदर्भित कर सकता है:
तो साफ़ कहें, इस लेख में “डिसीजन मॉडल” का मतलब केवल 2026 के अंत में जारी वह नई श्रेणी है जो टेक्स्ट लिखने की बजाय टाइप्ड उत्तरों को स्कोर करती है।
डिसीजन मॉडल कैसे काम करते हैं, इसमें जाने से पहले यह देखना मददगार है कि एक सामान्य LLM अपना उत्तर कैसे बनाता है। मुझे लगता है इससे अंतर साफ़ दिखता है।
एक बड़ा भाषा मॉडल एक लूप में काम करता है।
यह हमारे टेक्स्ट को टोकन्स में बदलता है, अपने शब्दकोश के हर टोकन के लिए संभावना भविष्यवाणी करता है, एक चुनता है, उसे टेक्स्ट में जोड़ता है, और फिर दोहराता है।
उत्तर में हर अतिरिक्त टोकन का मतलब मॉडल के एक और फॉरवर्ड पास से है।
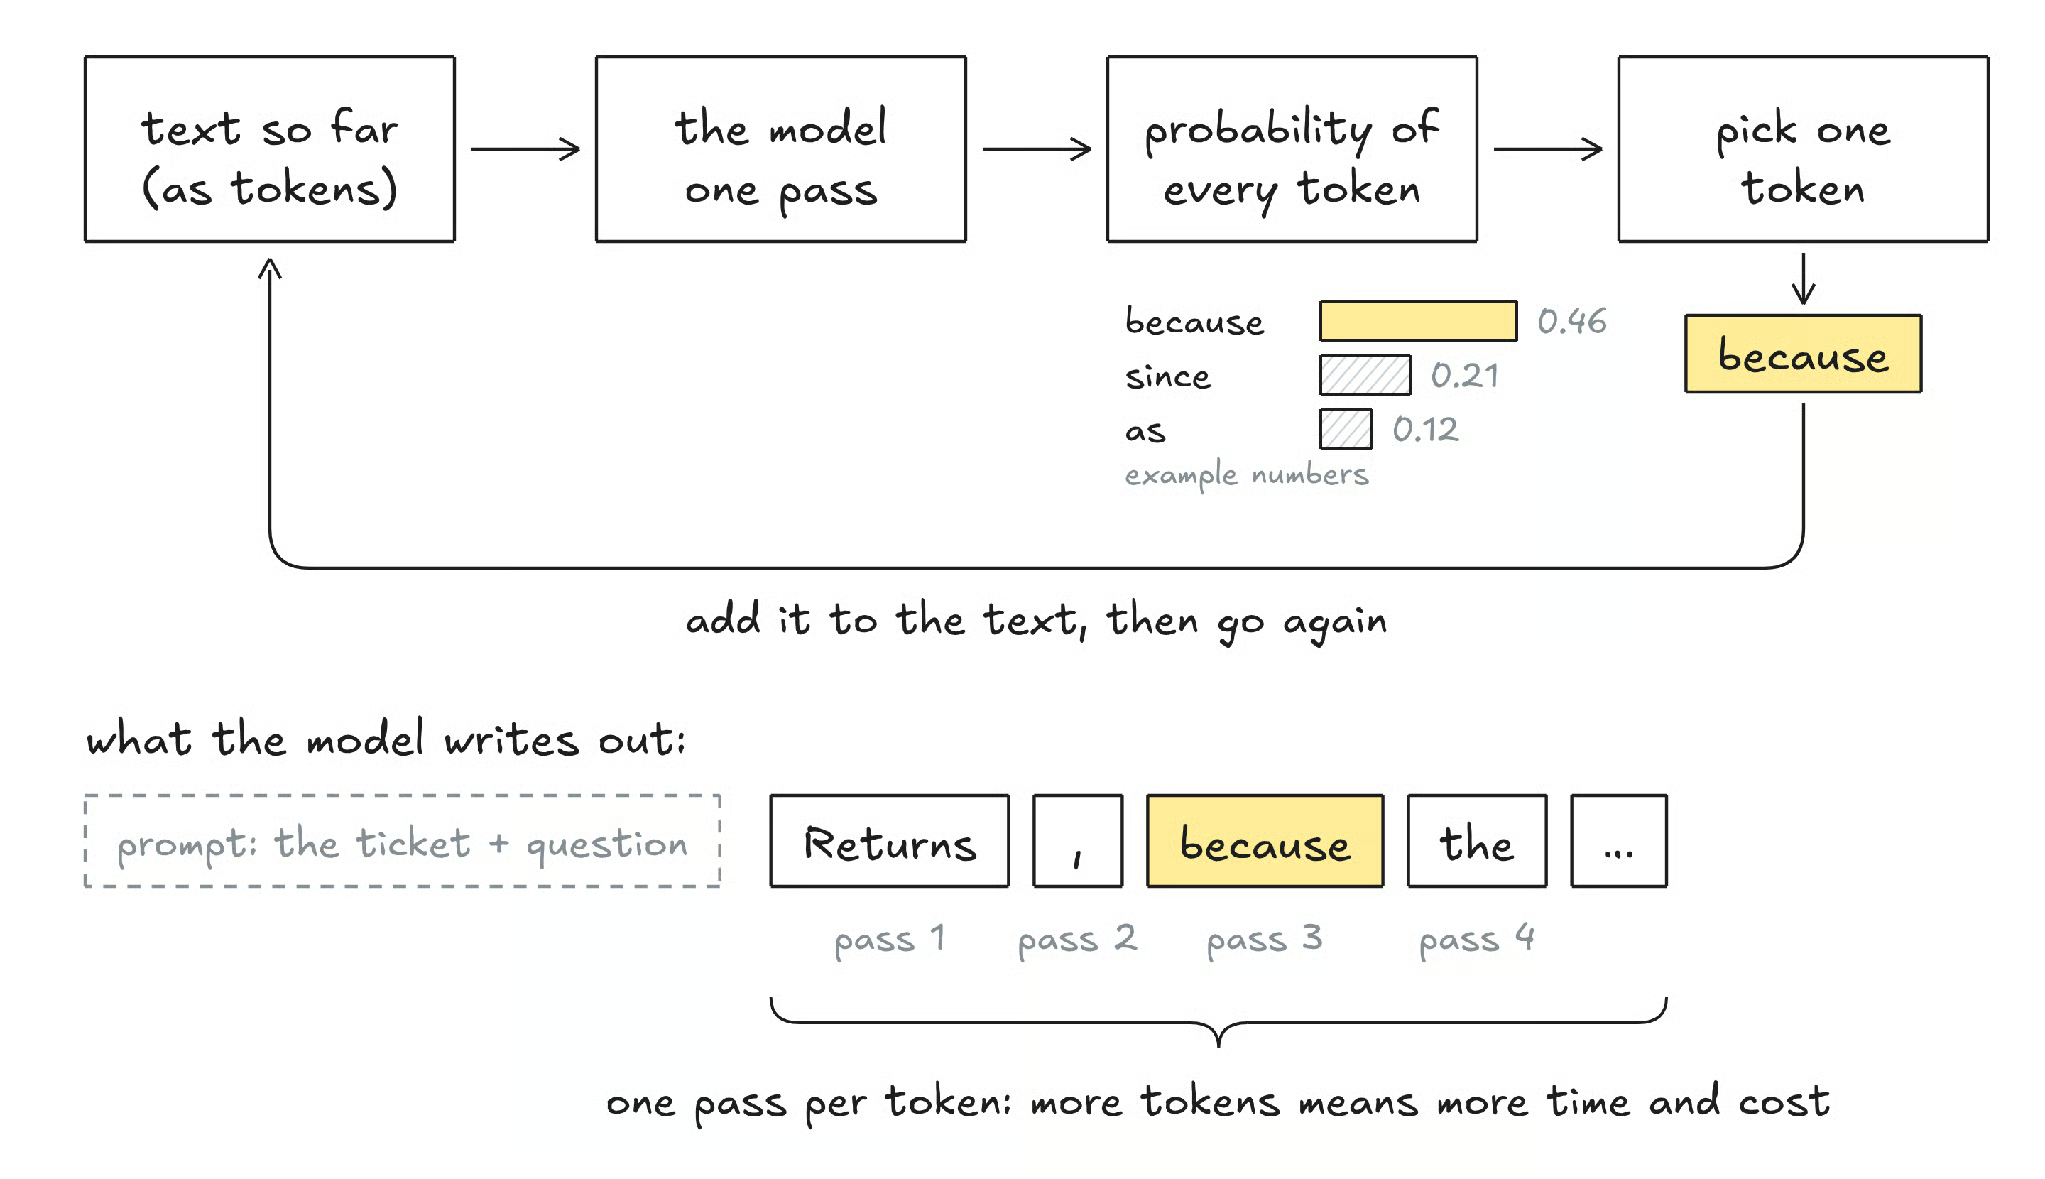
चित्र 1: LLM जो भी टोकन लिखता है, उसके लिए एक फॉरवर्ड पास चाहिए। मूल चित्र: लेखक।
यह लूप ईमेल, कोड, या व्याख्या लिखने में अच्छा काम करता है, लेकिन सरल फैसलों में यह कुछ दिक्कतें खड़ी कर सकता है:
निर्णय मॉडल बिल्कुल इन्हीं समस्याओं को ठीक करने की कोशिश हैं।
अब चलिए वास्तविक यांत्रिकी में आते हैं।
यहाँ तीन विचार समझने लायक हैं:
आइए इन्हें थोड़ा विस्तार से देखें।
एक निर्णय मॉडल आपका इनपुट और प्रश्न पढ़ता है और हर अनुमत उत्तर के लिए एक स्कोर बनाता है।
आमतौर पर यह स्कोर softmax फ़ंक्शन से संभावनाओं में बदला जाता है। जैसा कि आप समझ ही रहे होंगे, यहाँ कोई लंबा लूप नहीं है क्योंकि लिखना ही कुछ नहीं।
TypeSafe के दस्तावेज़ यह भी कहते हैं कि एक ही अनुरोध में दिए गए प्रश्न समानांतर में आंके जाते हैं, इसलिए अतिरिक्त प्रश्न जोड़ने से उत्तर समय में मुश्किल से फर्क पड़ता है।
यही वह जगह है जहाँ ज़्यादातर स्पीड आती है, और TypeSafe कहता है कि Jev आमतौर पर लगभग 70 से 500 मिलीसेकंड में उत्तर देता है।
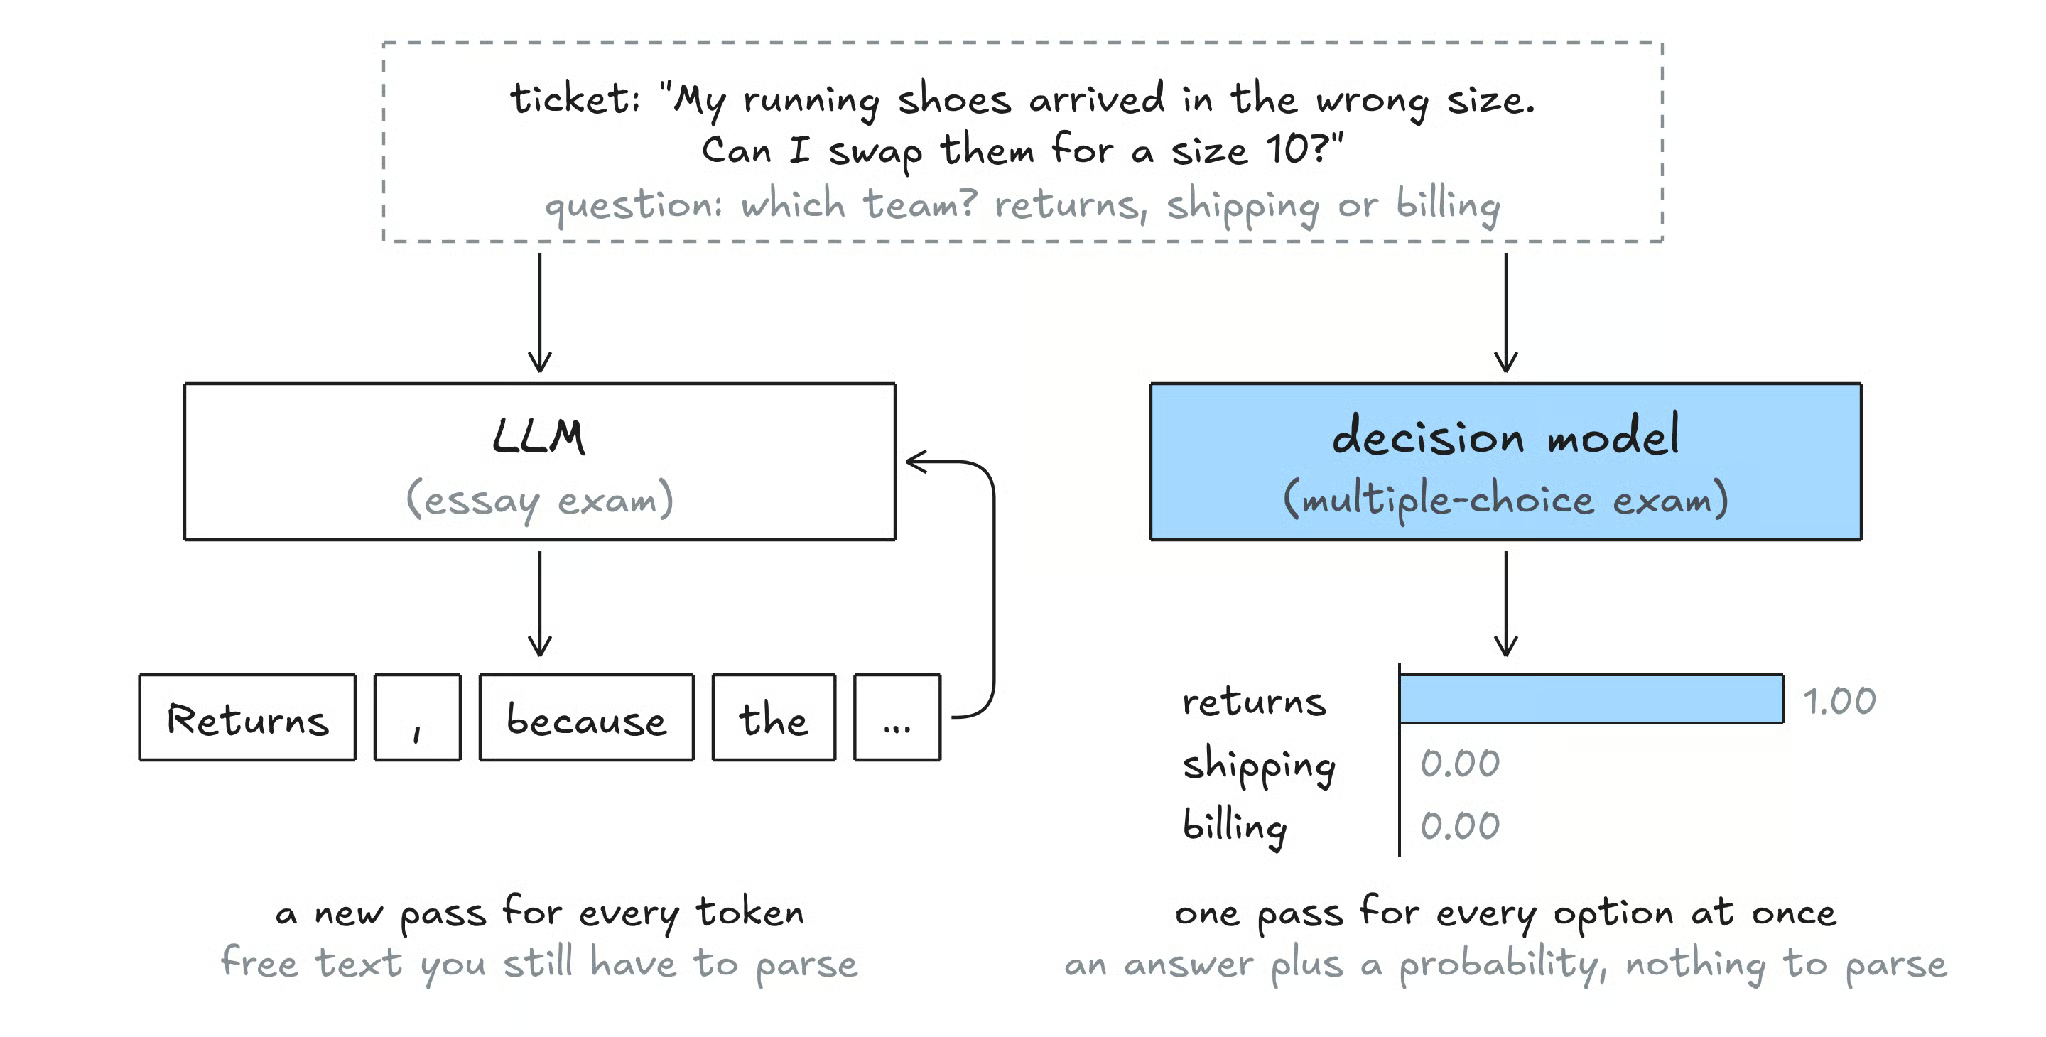
चित्र 2: वही टिकट, एक LLM और एक निर्णय मॉडल से उत्तरित। मूल चित्र: लेखक।
कोई एकल “डिसीजन मॉडल आर्किटेक्चर” नहीं है।
TypeSafe ने Jev कैसे काम करता है, यह प्रकाशित नहीं किया है, लेकिन मोटे तौर पर इन स्कोरों तक पहुँचने के तीन तरीके हो सकते हैं:
कहाँ क्या इस्तेमाल होता है, इसकी चिंता न करें: तीनों का अंत एक ही जगह होता है—हर अनुमत उत्तर के लिए एक संख्या।
मुझे लगता है यह हिस्सा सबसे अहम है, तो एक उदाहरण देता हूँ।
मान लीजिए कोई मॉडल 100 अलग-अलग प्रश्नों पर “70% संभावित” कहता है। अगर मॉडल ठीक से कैलिब्रेटेड है, तो उन में से लगभग 70 उत्तर सही निकलने चाहिए।
कैलिब्रेशन इसलिए मायने रखता है क्योंकि कैलिब्रेटेड संभावनाएँ हमें कोड में सुरक्षित थ्रेशोल्ड सेट करने देती हैं, जैसे “90% से ऊपर हो तो स्वतः मंज़ूर करो, वरना इंसान को भेजो।”
अगर संभावनाएँ हक़ीक़त से मेल नहीं खातीं, तो वे थ्रेशोल्ड बेमानी हैं।
वेंडर्स ऐसे लॉस फ़ंक्शंस से ट्रेन करते हैं जो ओवरकॉन्फिडेंस को दंडित करते हैं।
TypeSafe अपनी विधि को Reinforcement Learning for Calibrated Decisions (RLCD) कहता है, जबकि Cloudflare कहता है कि वह अपने Clef मॉडलों के लिए क्रॉस-एंट्रॉपी के साथ Brier लॉस को पेयर करता है।
यह आपको हैरानी में डाल सकता है, लेकिन कैंडिडेट्स को जनरेट करने के बजाय स्कोर करने का विचार कई वर्षों से मौजूद है।
मेरी राय में, निर्णय मॉडल इसका नवीनतम और सबसे सुविधाजनक संस्करण हैं, कोई बिल्कुल नई खोज नहीं। यहाँ वे मुख्य परिवार हैं जिन पर यह टिका है।
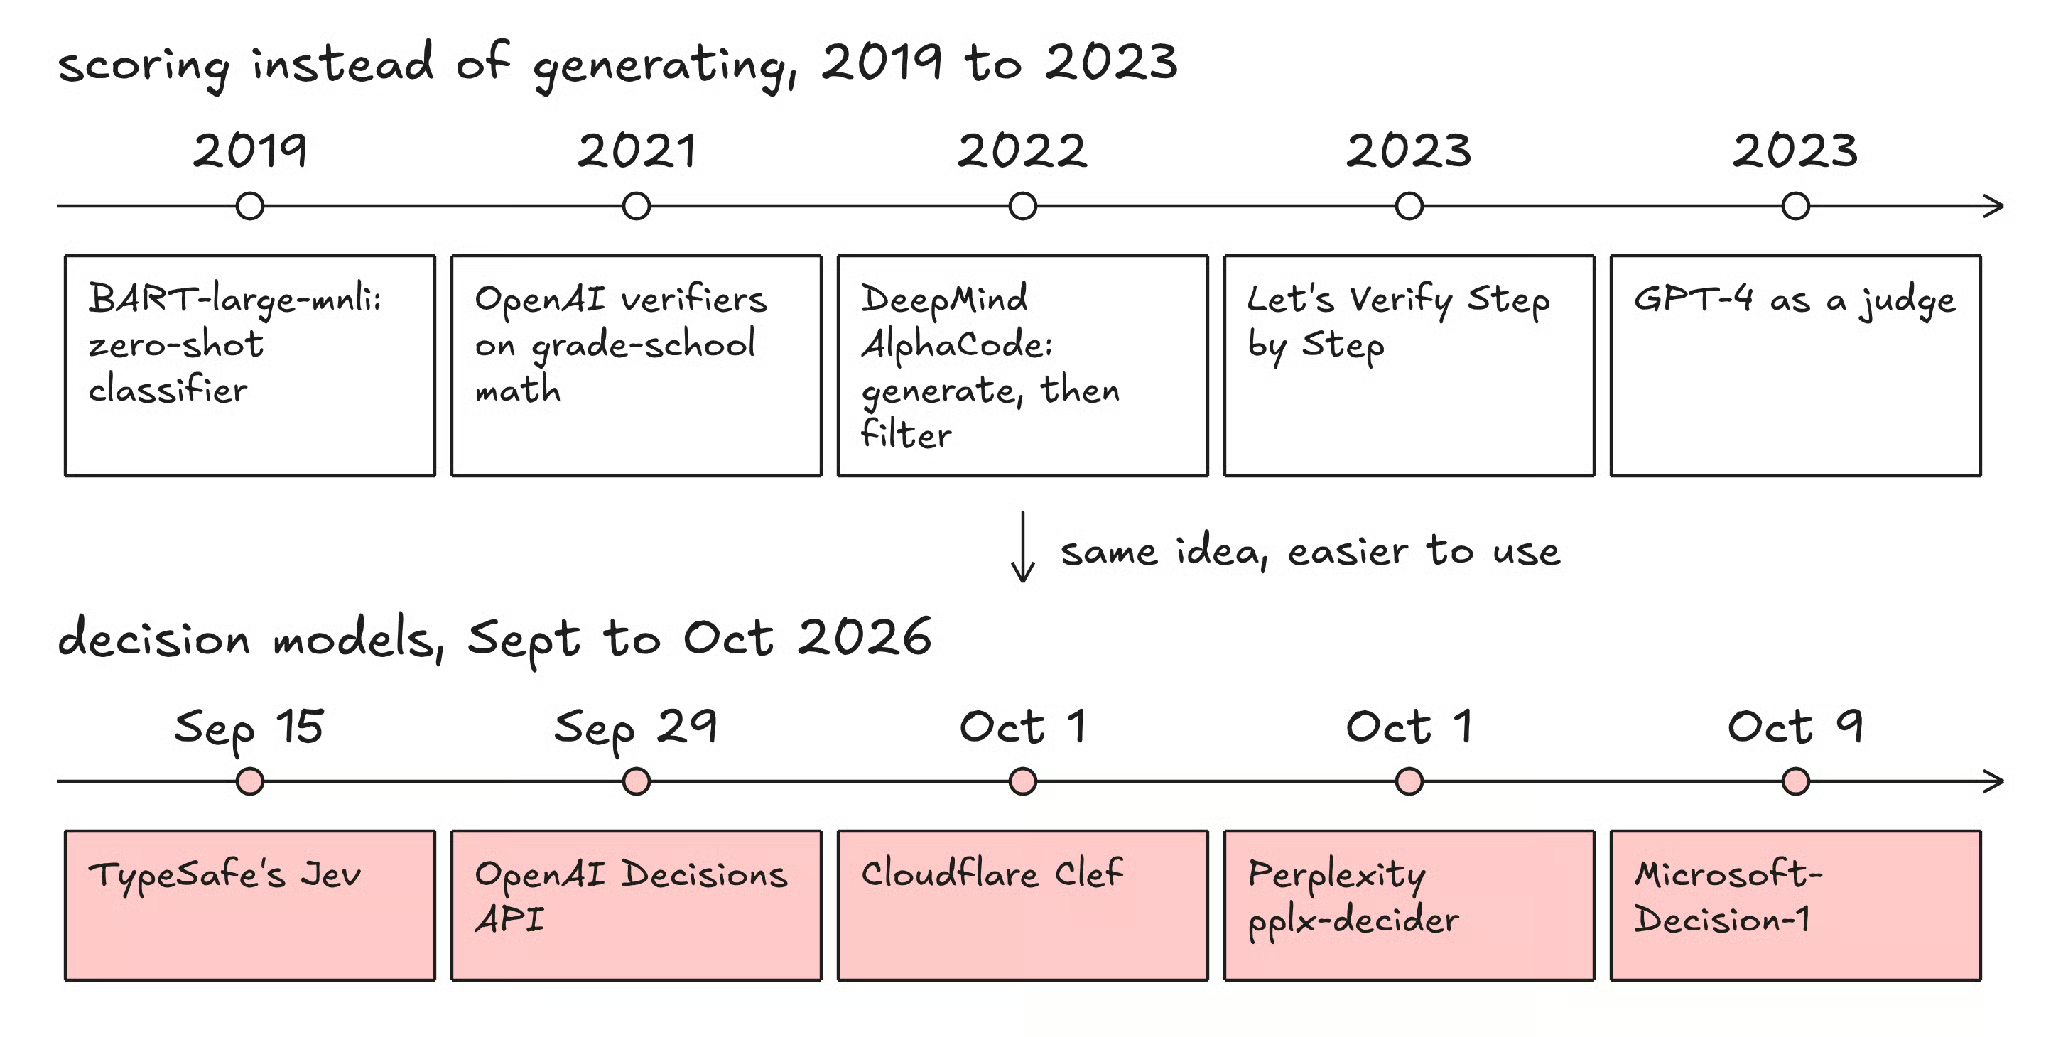
चित्र 3: जनरेशन के बजाय स्कोरिंग 2019 से है, और निर्णय मॉडल इसका 2026 संस्करण हैं। मूल चित्र: लेखक।
2019 में, BART-large-mnli जैसे मॉडल उन लेबल्स में भी टेक्स्ट को बाँट सकते थे जिन पर उन्हें कभी प्रशिक्षित नहीं किया गया था।
वे हर संभावित लेबल के लिए “यह टेक्स्ट बिलिंग के बारे में है” जैसे वक्तव्यों को स्कोर करके ऐसा करते थे।
Red Hat की AI सेफ़्टी टीम का सुझाव है कि निर्णय मॉडल तर्कसंगत रूप से इन्हीं ज़ीरो-शॉट क्लासिफ़ायर्स का नया नाम हो सकते हैं।
अगर आपने कोई RAG सिस्टम बनाया है, तो आपने इनमें से एक का इस्तेमाल किया होगा। आप पहले जल्दी से एक शॉर्टलिस्ट (जैसे 50 दस्तावेज़) लाते हैं, फिर एक क्रॉस-एन्कोडर आपका प्रश्न और हर दस्तावेज़ साथ पढ़कर हर जोड़ी को एक प्रासंगिकता स्कोर देता है।
कुछ जनरेट नहीं होता; दस्तावेज़ बस अपने स्कोर के हिसाब से फिर से क्रमित होते हैं।
ये ऐसे स्कोरर हैं जो LLM द्वारा पहले से जनरेट किए गए उत्तरों को रेट करते हैं।
2021 में, OpenAI शोधकर्ताओं ने दिखाया कि किसी मॉडल में वेरिफ़ायर जोड़ने से ग्रेड-स्कूल गणित पर लगभग मॉडल को 30 गुना बड़ा करने के बराबर बढ़त मिली, जो मुझे चौंकाता है।
दो साल बाद, “Let’s Verify Step by Step” पेपर ने दिखाया कि केवल अंतिम उत्तर को स्कोर करने की बजाय हर तर्क-कदम को स्कोर करना और भी बेहतर काम करता है।
सरल संस्करण यह है कि कई उत्तर जनरेट करें, हर एक को स्कोर करें, और सबसे अच्छा रखें। DeepMind का AlphaCode (2022) इसे चरम पर ले गया—प्रति समस्या दस लाख तक प्रोग्राम जनरेट किए, लगभग 99% को उदाहरण परीक्षणों से छाँट दिया, और फिर सिर्फ 10 जमा किए।
पिछले Codeforces कॉन्टेस्ट्स पर सिम्युलेटेड मूल्याँकन में, यह औसतन मानव प्रतियोगियों के शीर्ष 54.3% में रहा।
एक चेतावनी: अगर आप एक अपूर्ण स्कोरर को बहुत ज़्यादा धकेलते हैं, तो गुणवत्ता अंततः नीचे जाती है क्योंकि जेनरेटर स्कोरर की गलतियों का फ़ायदा उठाने लगता है।
तकनीकी शब्द है reward overoptimization।
यह तब होता है जब एक बड़ा LLM किसी दूसरे मॉडल के आउटपुट को ग्रेड करता है।
2023 के एक अध्ययन में पाया गया कि GPT-4 मानव जजों से 80%+ बार सहमत था लेकिन उसमें बायस भी थे, जैसे लंबे उत्तरों को तरजीह देना या जो उत्तर पहले दिखाया गया उसे प्राथमिकता देना।
निर्णय मॉडल आंशिक रूप से इन्हीं जजों के सस्ते, संरचित विकल्प के रूप में बेचे जा रहे हैं।
एक एनर्जी-बेस्ड मॉडल किसी इनपुट और उत्तर के अच्छे मेल पर कम “एनर्जी” स्कोर देता है और ख़राब मेल पर ऊँचा स्कोर।
उत्तर चुनना तब सबसे कम एनर्जी ढूँढने का काम रह जाता है—फिर से कैंडिडेट्स को स्कोर करना।
Yann LeCun वर्षों से तर्क देते आए हैं कि टोकन-बाय-टोकन जनरेशन वास्तविक बुद्धिमत्ता का रास्ता नहीं है, और एनर्जी-बेस्ड अप्रोच और JEPA बेहतर दिशा हैं।
अब मैं उन मॉडलों की बात करना चाहता हूँ जो वास्तव में जारी किए जा चुके हैं। चीज़ें बहुत तेज़ी से बदल रही हैं, इसलिए हर एक को संक्षिप्त रखूँगा।
TypeSafe AI सैन फ़्रांसिस्को का स्टार्टअप है जिसकी स्थापना पूर्व OpenAI शोधकर्ता Diogo Almeida ने की, और यह 15 सितंबर 2026 को Jev और DCVC के नेतृत्व में $40 मिलियन सीड राउंड के साथ स्टेल्थ से बाहर आया।
Jev एक होस्टेड API है। प्रोडक्शन में यह केवल टेक्स्ट लेता है; इमेज इनपुट प्रायोगिक है और ऑप्ट-इन हेडर चाहिए। प्राइसिंग इनपुट टोकन पर लगती है, और आउटपुट मुफ़्त है, जो समझ में आता है जब आउटपुट कुछ नंबर ही हों।
Jev 1.14, 14 अक्टूबर को आया, हालाँकि jev-latest उपनाम अभी भी 1.13.0 की ओर इशारा करता है, वही संस्करण जिसे Red Hat ने इस लेख में आगे टेस्ट किया।
लॉन्च के आसपास काफ़ी चर्चा रही। Vercel ने कहा कि उसके पेड टीम्स में से लगभग 13% ने पहले 24 घंटों में उसके AI Gateway के ज़रिए Jev को आज़माया, हालाँकि उस समय गेटवे पर यह मुफ़्त था।
OpenAI ने 29 सितंबर 2026 को DevDay पर अपना Decisions API घोषित किया।
यह उपयोगकर्ता-परिभाषित प्रश्नों के साथ काम करता है जिनके उत्तर तय होते हैं और GPT-6 Luna पर बना है। 6 अक्टूबर को यह पब्लिक बीटा में गया, और यह इमेज भी ले सकता है, जिसे Jev केवल प्रायोगिक रूप से सपोर्ट करता है।
Cloudflare ने 1 अक्टूबर 2026 को Clef और छोटा Clef-flash जारी किया, ओपन वेट्स और Workers AI पर होस्टिंग के साथ। दोनों Qwen मॉडलों पर बने हैं और Jev-स्टाइल अनुरोध स्वीकार करते हैं, इसलिए Jev के लिए लिखा कोड बहुत कम बदलावों के साथ Clef की ओर पॉइंट किया जा सकता है।
| Model | Maker | Released (2026) | Access | Notable detail |
|---|---|---|---|---|
| pplx-decider | Perplexity | October 1 | Open weights and API | Perplexity के अपने 11-बेंचमार्क पैनल पर Jev के 84.51% के मुकाबले स्वयं-रिपोर्टेड 85.71% |
| Microsoft-Decision-1 | Microsoft | October 9 | Foundry preview | पोस्ट-ट्रेंड 9B Qwen मॉडल |
| Laya | Convai Innovations | September | Open weights | छोटा (421M पैरामीटर्स), लैपटॉप CPU पर चलता है; इसका मॉडल कार्ड इसे ज़ीरो-शॉट इंजन नहीं बल्कि स्पेशलाइज़ करने का बेस कहता है |
इस खंड को समेटते समय जो बात मुझे सबसे अलग लगी, वह यह है कि यहाँ अधिकांश ओपन और बिग-टेक मॉडल सामान्य LLMs के फाइन-ट्यून किए गए संस्करण हैं। Laya अपवाद है: यह एक एन्कोडर है जिसके साथ डिसीजन हेड है। Jev के आंतरिक हिस्से सार्वजनिक नहीं हैं।
मेरी राय में, यह उस विचार का समर्थन करता है कि वास्तविक नवाचार पैकेजिंग (यानी इंटरफ़ेस और कैलिब्रेशन के लिए ट्रेनिंग) में है, न कि केवल नई आर्किटेक्चर में।
कब क्या उपयोग करना है, इसका सबसे स्पष्ट तरीका तुलना है:
| Feature | LLM | Decision model | Fine-tuned classifier | LLM + verifier |
|---|---|---|---|---|
| Output | फ्री टेक्स्ट | टाइप्ड उत्तर और संभावनाएँ | निश्चित लेबल | कई जनरेटेड उत्तरों में से सर्वश्रेष्ठ |
| लabeled डेटा की ज़रूरत | नहीं | नहीं | हाँ | अक्सर |
| गति | सेकंड्स | दहाई से सैकड़ों मिलीसेकंड | बहुत तेज़ | सबसे धीमा |
| ऑफ़-फ़ॉर्मैट उत्तर | संभव | असंभव | असंभव | जेनरेटर पर निर्भर |
| अपना उत्तर समझाता है | हाँ | नहीं | नहीं | हाँ |
| सबसे उपयुक्त | लेखन, कोड, तर्क | रूटिंग, ट्रायेज, गार्डरेल्स | एक तय उच्च-वॉल्यूम कार्य | गणित, परीक्षण वाले कोड |
मेरा मोटा नियम यह है:
मुझे विश्वास है कि बेहतरीन सिस्टम्स इन सबका मिश्रण होंगे।
मैं निर्णय मॉडल्स को LLM के चारों ओर तेज़ “गेट्स” की तरह देख सकता हूँ। एक गेट यह तय करता है:
इस तरह, महँगा LLM केवल तब चलता है जब सचमुच कुछ लिखने की ज़रूरत हो।
यह खंड सबसे महत्वपूर्ण है, क्योंकि ऑनलाइन दिखने वाले बड़े-बड़े नंबर अधिकतर वेंडर्स से ही आते हैं। TypeSafe भी मानता है कि उसकी हेडलाइन स्पीड और लागत के लाभ वास्तविक उपयोग में ऊपरी सिरे पर हैं।
अक्टूबर 2026 में, Red Hat की AI सेफ़्टी टीम ने दो कार्यों पर नौ गार्डरेल सेटअप्स की तुलना की: प्रॉम्प्ट इंजेक्शन पकड़ना और असुरक्षित कंटेंट पकड़ना।
DiffusionGemma एक Gemma टेक्स्ट-डिफ्यूजन मॉडल है जिसे vLLM के ज़रिए सर्व किया गया।
यहाँ सबसे दिलचस्प नतीजे हैं:
| Method | Type | Prompt injection accuracy | Content safety accuracy |
|---|---|---|---|
| deberta-v3-base | Fine-tuned classifier | 89.01% | - |
| granite-guardian-hap-125m | Fine-tuned classifier | - | 80.27% |
| Qwen3.6-35B | LLM-as-a-judge | 89.31% | 85.47% |
| DiffusionGemma | Decision model (open) | 87.72% | 85.53% |
| Jev | Decision model | 86.35% | 86.20% |
| Laya | Decision model (open) | 85.44% | 57.87% |
| BART-large-mnli | 2019 zero-shot classifier | 61.49% | 68.67% |
कंटेंट सेफ़्टी पर Jev पहले स्थान पर आया, DiffusionGemma से 0.67 प्रतिशत अंक आगे (Qwen जज तीसरे स्थान पर), और प्रॉम्प्ट इंजेक्शन पर Qwen जज पहले स्थान पर रहा।
यही विभाजन है जिसकी वजह से Red Hat अब भी कह सकता है कि समग्र रूप से निर्णय मॉडल्स ने LLM जजों पर गुणवत्ता बढ़त नहीं दिखाई।
लेकिन जो बात मुझे सबसे दिलचस्प लगी वह यह है कि 200-मिलियन-पैरामीटर क्लासिफ़ायर प्रॉम्प्ट इंजेक्शन पर केवल 0.3 प्रतिशत अंक पीछे रहा, और उसकी मीडियन लेटेंसी 100 मिलीसेकंड से कम रही जबकि Jev की लगभग 348 मिलीसेकंड थी।
Jev की लेटेंसी में अटलांटिक पार का सफ़र शामिल था, क्योंकि टेस्ट UK से चले और TypeSafe के सर्वर US में हैं।
वह हॉप केवल लोकल CPU मॉडल्स से गैप को ही समझाता है। Qwen, Nemotron, और DiffusionGemma भी US क्लस्टर पर चले, और Qwen फिर भी Jev से तेज़ था।
इसके बावजूद, Red Hat ने निष्कर्ष निकाला कि उनके परीक्षणों में निर्णय मॉडल्स ने LLM-as-a-judge की तुलना में न तेज़, न सस्ते, न बेहतर उत्तर दिए, Laya को छोड़कर, जिसका छोटा आकार वास्तविक लाभ है यदि आप उसकी सीमाओं के चारों ओर प्रॉम्प्ट कर सकें।
सितंबर 2026 में arXiv पर पोस्ट एक शोध पत्र ने 44 एलाइनमेंट बेंचमार्क्स पर Jev का परीक्षण किया।
नतीजे दिलचस्प तरह से मिश्रित थे:
मुझे लगता है सिलेक्टिव-प्रेडिक्शन वाला बिंदु व्यवहार में बहुत उपयोगी है।
यह दिखाता है कि एक सरल डिज़ाइन, जहाँ निर्णय मॉडल आसान मामलों को संभालता है और अनिश्चित वालों को LLM या इंसान को पास कर देता है, एक अच्छी रणनीति है।
अब हम खुद एक निर्णय मॉडल बनाएँगे।
हम एक छोटे ओपन LLM को पहले बताए गए टोकन संभावना ट्रिक से निर्णय मॉडल में बदलेंगे और फिर देखें گے कि क्या हम सच में इसकी संभावनाओं पर भरोसा कर सकते हैं।
पहले, हमें पैकेज इंस्टॉल करने होंगे (यह सब एक मुफ़्त Colab नोटबुक पर चल सकता है):
pip install transformers torch datasets sentence-transformers numpyहम Qwen2.5-0.5B-Instruct इस्तेमाल करेंगे, जो CPU पर चलने के लिए काफ़ी छोटा है।
विचार सरल है: हम विकल्पों को अक्षरों से लेबल करते हैं, मॉडल एक बार चलाते हैं, और केवल उन्हीं अक्षरों के अगले टोकन के रूप में संभावनाएँ देखते हैं।
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
ध्यान दें कि हम कभी generate() कॉल नहीं करते। हम एक फॉरवर्ड पास करते हैं, “A”, “B”, “C” आदि के स्कोर रखते हैं, और बाकी सब फेंक देते हैं।
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
और बस। हमने लगभग 30 लाइनों में एक काम करने वाला निर्णय मॉडल बना लिया।
हाँ/ना प्रश्न बस दो विकल्पों वाला एक choice प्रश्न है।
अब देखते हैं कि यह साधारण संस्करण कहाँ लड़खड़ाने लगता है।
विकल्पों के क्रम को बदलकर वही प्रश्न फिर चलाएँ:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
ऐसे गड़बड़ इनपुट्स पर, हम अक्सर देखेंगे कि केवल विकल्पों के खिसकने से संभावनाएँ भी बदल जाती हैं।
इसे order bias कहते हैं, और TypeSafe खुद Jev की ज्ञात कमजोरियों में पहले विकल्प की ओर झुकाव सूचीबद्ध करता है।
आप यह भी देख सकते हैं कि मॉडल अक्सर लगभग-100% उत्तर देता है। Berryman ने Jev पर एक अच्छा टेस्ट चलाया, जहाँ उसने बताया कि एक सिक्का 60% समय हेड्स आता है, और हाँ/ना प्रश्न ने 0.58 लौटाया, जो क़रीब है।
लेकिन choice प्रश्न (“हेड्स या टेल्स?”) ने हेड्स के लिए 0.99 लौटाया, क्योंकि संभावना ज़्यादा संभावित उत्तर पर ढह गई।
मेरा मानना है यह कदम हर किसी को चलाना चाहिए। हम AG News डेटासेट से 400 समाचार आइटम लेंगे (हर एक हेडलाइन और छोटा विवरण), जिनके चार टॉपिक्स हैं, और जाँचेंगे कि हमारी संभावनाएँ हक़ीक़त से मेल खाती हैं या नहीं।
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
अगला, हमें कैलिब्रेशन मापने का तरीका चाहिए। Expected calibration error (ECE) भविष्यवाणियों को कॉन्फिडेंस बिन्स में बाँटता है और देखता है कि हर बिन में औसत कॉन्फिडेंस वास्तविक एक्यूरसी से कितना दूर है।
साफ़ कहें तो, जितना कम, उतना बेहतर:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
अब यह ट्रिक देखें।
हम डेटा को दो भागों में बाँटते हैं, पहले हिस्से का उपयोग ऐसा टेम्परेचर ढूँढने के लिए करते हैं जो संभावनाओं को ज़्यादा ईमानदार बना दे, और फिर दूसरे हिस्से पर टेस्ट करते हैं।
1 से ऊपर का टेम्परेचर ओवरकॉन्फिडेंट भविष्यवाणियों को नरम करता है, जबकि 1 से नीचे का टेम्परेचर अंडरकॉन्फिडेंट को तेज़ करता है।
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
एक्यूरसी नहीं बदलती, क्योंकि टेम्परेचर से विभाजन शीर्ष रैंकिंग वाले विकल्प को नहीं बदलता।
केवल कॉन्फिडेंस बदलता है।
आपके सटीक नंबर आपकी रन पर निर्भर होंगे, लेकिन टेस्ट हाफ पर ECE आम तौर पर कम होना चाहिए। केवल 200 टेस्ट आइटम होने से अनुमान शोर वाला है, तो छोटे फ़र्क पर बहुत निष्कर्ष न निकालें।
सीख साफ़ है: किसी मॉडल का किसी और के डेटा पर कैलिब्रेटेड होना यह नहीं दर्शाता कि वह आपके डेटा पर भी कैलिब्रेटेड है।
यह दिखाने के लिए कि “जनरेट मत करो, स्कोर करो” विचार कितना आम है, यहाँ वही बात एक RAG सेटिंग में।
एक क्रॉस-एन्कोडर हर पैसेज को प्रश्न के मुकाबले स्कोर करता है और हम बस उन्हें सॉर्ट कर देते हैं:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
फिर से, कुछ जनरेट नहीं होता: मॉडल हर कैंडिडेट को एक संख्या देता है।
ये वे उपयोग मामले हैं जो सबसे अधिक सामने आते हैं:
| Use case | कैसे मदद करता है निर्णय मॉडल |
|---|---|
| एजेंट रूटिंग | तय करता है कि अगला कदम किस टूल या सब-एजेंट को संभालना चाहिए। |
| गार्डरेल्स | LLM तक पहुँचने से पहले प्रॉम्प्ट इंजेक्शन या असुरक्षित कंटेंट को फ़्लैग करता है। |
| सपोर्ट ट्रायेज | टिकट्स को टीम, विषय, और तात्कालिकता के आधार पर रूट करता है। |
| दस्तावेज़ इनटेक | हर दस्तावेज़ पर तय चेकलिस्ट के प्रश्नों का उत्तर देता है। |
| सर्च और RAG | लाए गए पैसेजेस को प्रासंगिकता के हिसाब से री-रैंक करता है। |
| क्रेडिट और फ़्रॉड | जोखिम स्कोर करता है, हालाँकि लोगों से जुड़े निर्णयों में अब भी मानवीय समीक्षा होनी चाहिए। |
| रोबोटिक्स | धीमे LLM प्लानर और लो-लेवल मोटर कंट्रोल के बीच एक तेज़ लेयर की तरह काम कर सकता है, हालाँकि यह अभी अनुमानात्मक है। |
रोबोटिक्स वाला बिंदु मुझे व्यक्तिगत रूप से सबसे रोचक लगता है।
Berryman सुझाव देते हैं कि Jev जैसा मॉडल एक धीमे LLM जो हाई-लेवल प्लान बनाता है और उन काइनेमैटिक मॉडलों के बीच बैठ सकता है जो रोबोट के जॉइंट्स को चलाते हैं।
यह जानना लायक है, हालांकि, कि TypeSafe का चर्चित Doom डेमो कच्ची इमेजेज़ के बजाय Jev को टेक्स्ट टेलीमेट्री देता था।
निर्णय मॉडल उपयोगी हैं, लेकिन मैं उन्हें बढ़ा-चढ़ाकर नहीं बेचना चाहता।
ध्यान में रखने के लिए मुख्य सीमाएँ ये हैं:
AI निर्णय मॉडल कैंडिडेट्स को जनरेट करने के बजाय स्कोर करने के बहुत पुराने विचार को लेते हैं और उसे इस्तेमाल करना कहीं आसान बना देते हैं।
आपको ट्रेनिंग डेटा नहीं चाहिए; आपको टाइप्ड उत्तर मिलते हैं, और आप एक साथ कई प्रश्न पूछ सकते हैं।
मेरी राय में, असली नवाचार यही पैकेजिंग है।
मुझे उम्मीद है कि निर्णय मॉडल LLMs के चारों ओर तेज़, सस्ते गेट्स की तरह बैठेंगे जो सरल फैसले सँभालते हैं, ताकि महँगा मॉडल केवल तब चले जब सचमुच कुछ लिखना हो।
Top DataCamp Courses
लर्निंग पाथ
लर्निंग पाथ
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें