
学习路径
面向开发者的 AI 工程师助理
26 小时
实践并学习路径你的进步。
使用 Google 继续想象您在餐厅坐下,服务员问:“纯净水还是苏打水?”您不会用一大段话解释自己的补水偏好;您会从给出的两个选项里选一个。
再想想我们如今在大多数应用中如何使用大型语言模型(LLM)。我们会问它诸如“这张支持工单是关于账单、配送,还是退货?”之类的问题,而模型会回我们一整句话,然后我们还得用代码去解析。事实上,只有三种可能的答案,但我们却为一整套思考过程付了费。
这正是这种新型模型试图填补的空白。2026 年 9 月,一家名为 TypeSafe AI 的初创公司发布了 Jev,一种根本不写文本的模型。
它会为一组固定答案打分,并告诉您每个答案的可能性。几周内,OpenAI、Cloudflare、Perplexity 和 Microsoft 相继推出了各自的版本,可见这一领域发展之快。
本文将探讨这些AI 决策模型是什么、如何工作,以及这一理念真正的来源(它比当前的热度古老得多)。我也会看看独立基准测试的结论。
if 语句。AI 决策模型是一种模型:它接收一个输入和一组允许的答案,返回每个答案的概率,且不生成任何自由文本。
其核心理念是输出天生就是结构化的。
您无需解析整句,因为模型只能返回您给它的答案之一。这意味着结果可以直接进入您代码里的 if 语句。
我喜欢把这种差异想象成两种考试类型。
大型语言模型在做申论题,逐字写出答案;而决策模型在做选择题,并告诉您对每个选项的把握程度(置信度)。
Jev 以及大多数 Jev 替代方案支持三类问题:
TypeSafe 还有一个用于在图像中定位目标的实验性 Box 类型,这里不展开。
下面举一个来自 TypeSafe 官方文档 的示例。
您可以发送一个 state(即您希望模型查看的文本)和一张 questions 的映射表。对于 choice 问题,每个选项附带一个短描述,放在名为 criteria 的字段里。
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
对应的响应如下:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
无需解析文本。
您会得到被选中的选项、每个选项的概率,以及一个由最高概率导出的置信度,因此分布越平(越接近均匀),置信度越低。在文档中,一张同时提到尺码不对和重复扣费的更复杂工单,会将概率分给退货(0.61)和账单(0.35),置信度降至 0.42。
TypeSafe 将 Jev 描述为“系统一模型(System One Model)”,借用自丹尼尔·卡尼曼的《思考,快与慢》。为什么?
用非常通俗的话说,系统一是您快速、凭直觉的判断;系统二是缓慢、逐步的推理。
决策模型旨在扮演那个“快”的角色。
但需注意:系统一也是我们大脑中容易犯快速错误的部分。值得肯定的是,TypeSafe 的文档坦诚列出了 Jev 的易错场景。我们稍后会回到这一点。
让我初看时有些困惑的是,“决策模型”本身已经有多重含义。它可能指:
因此明确起见,本文中的“决策模型”仅指 2026 年底发布的这一新类别模型:它为类型化答案打分,而不是写文本。
在讲解决策模型如何工作之前,先看看普通 LLM 如何生成答案,这有助于凸显两者差异。
大型语言模型在一个循环中工作。
它将文本拆成 token,为词表中的每个 token 预测概率,选一个,追加到文本里,然后重复。
答案里的每多一个 token,就多一次前向传播。
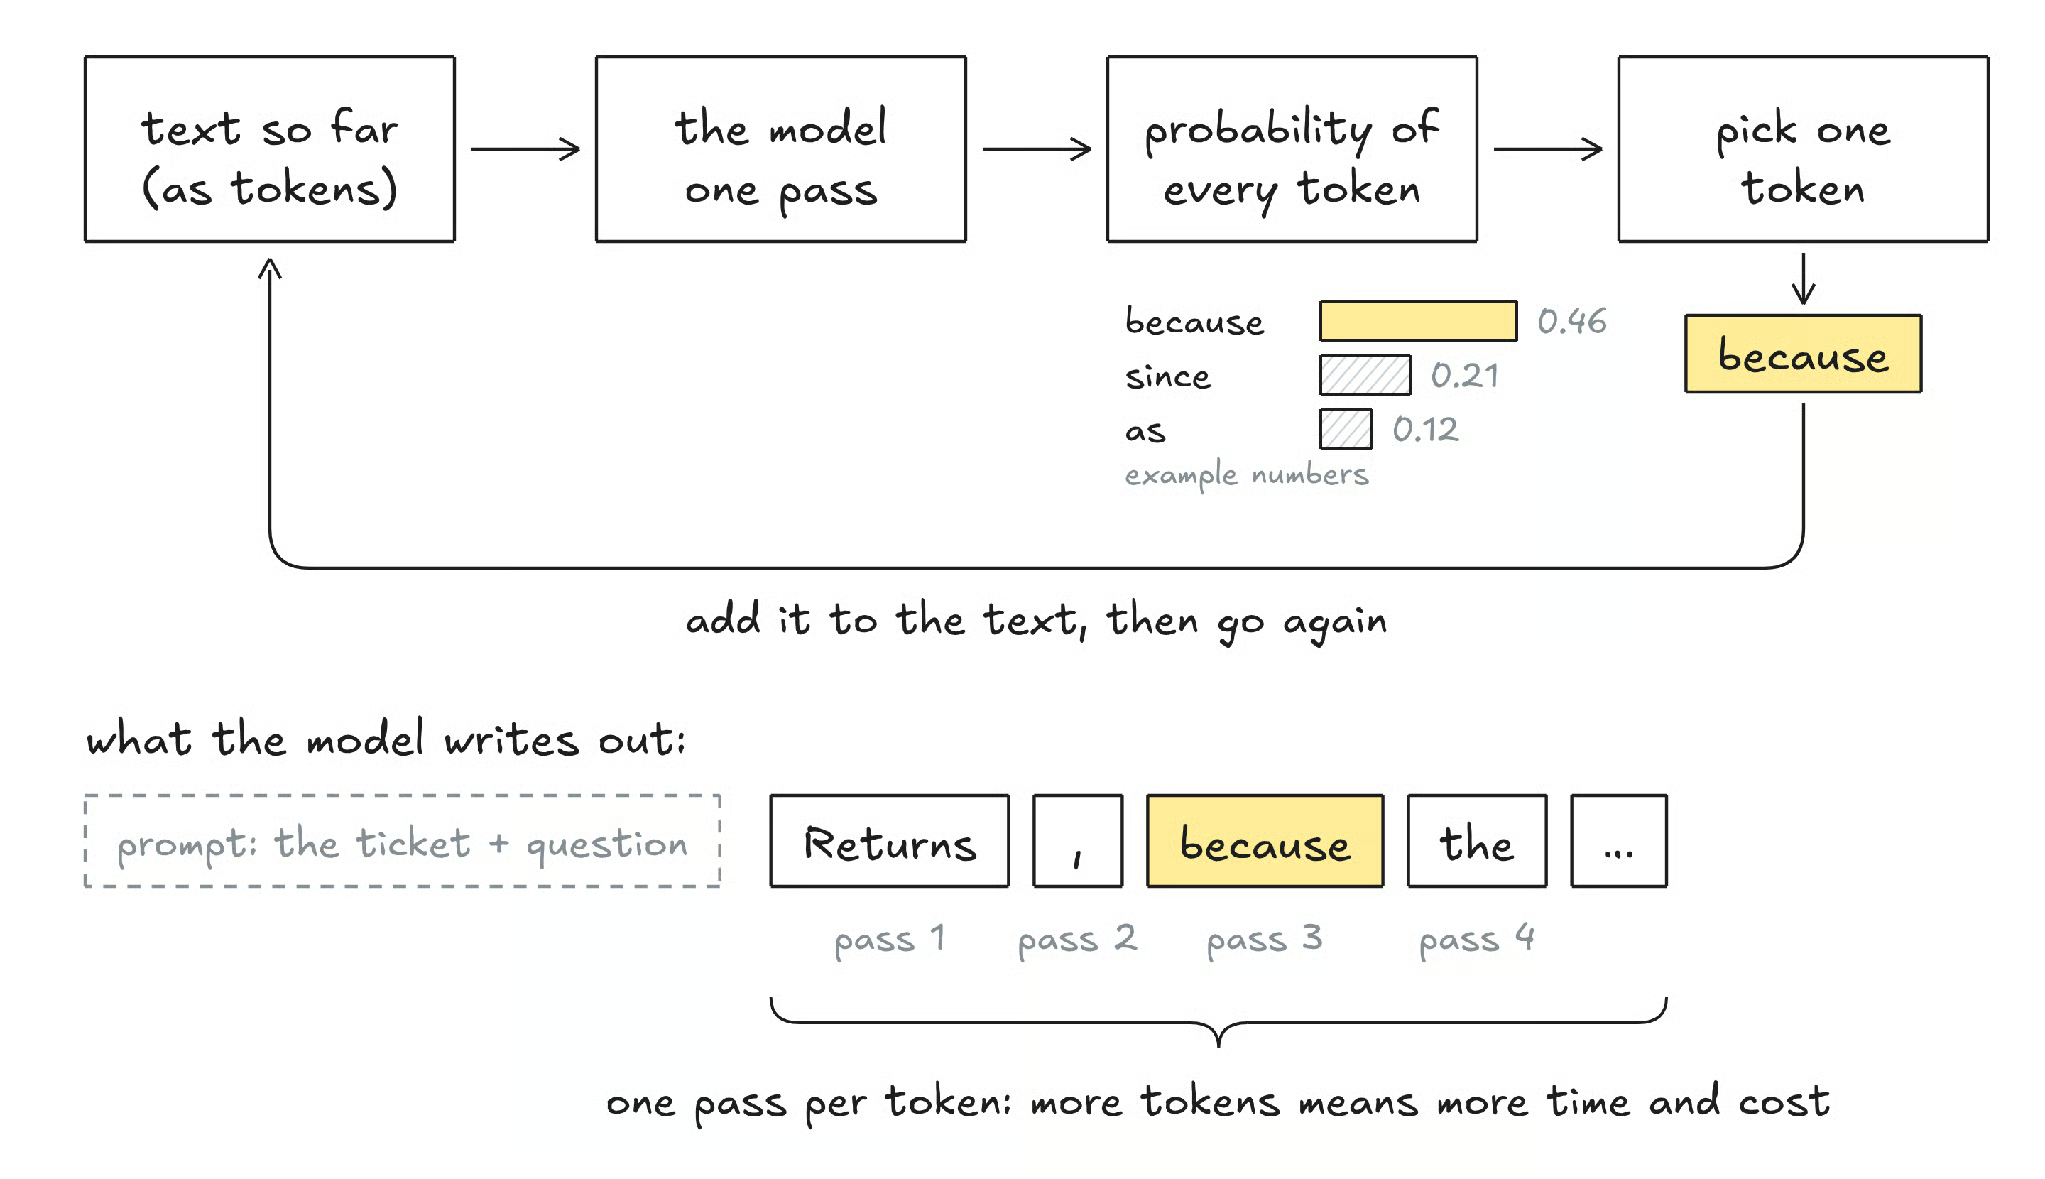
图 1:LLM 写出每个 token 都需要一次前向传播。原图作者自制。
这个循环非常适合写邮件、写代码或解释说明,但在处理简单决策时,它会带来一些问题:
决策模型正是试图解决这些问题。
接下来讲具体机制。
有三点值得理解:
我们分别看一看。
决策模型读取您的输入和问题,为每个允许的答案生成一个分数。
这些分数通常通过 softmax 函数转成概率。正如您能想象的,没有长循环,因为没有需要写出的内容。
TypeSafe 的文档还称,同一请求中的多个问题会并行评估,因此新增问题几乎不影响响应时间。
这就是速度的主要来源,TypeSafe 称 Jev 的典型响应大约在 70 到 500 毫秒。
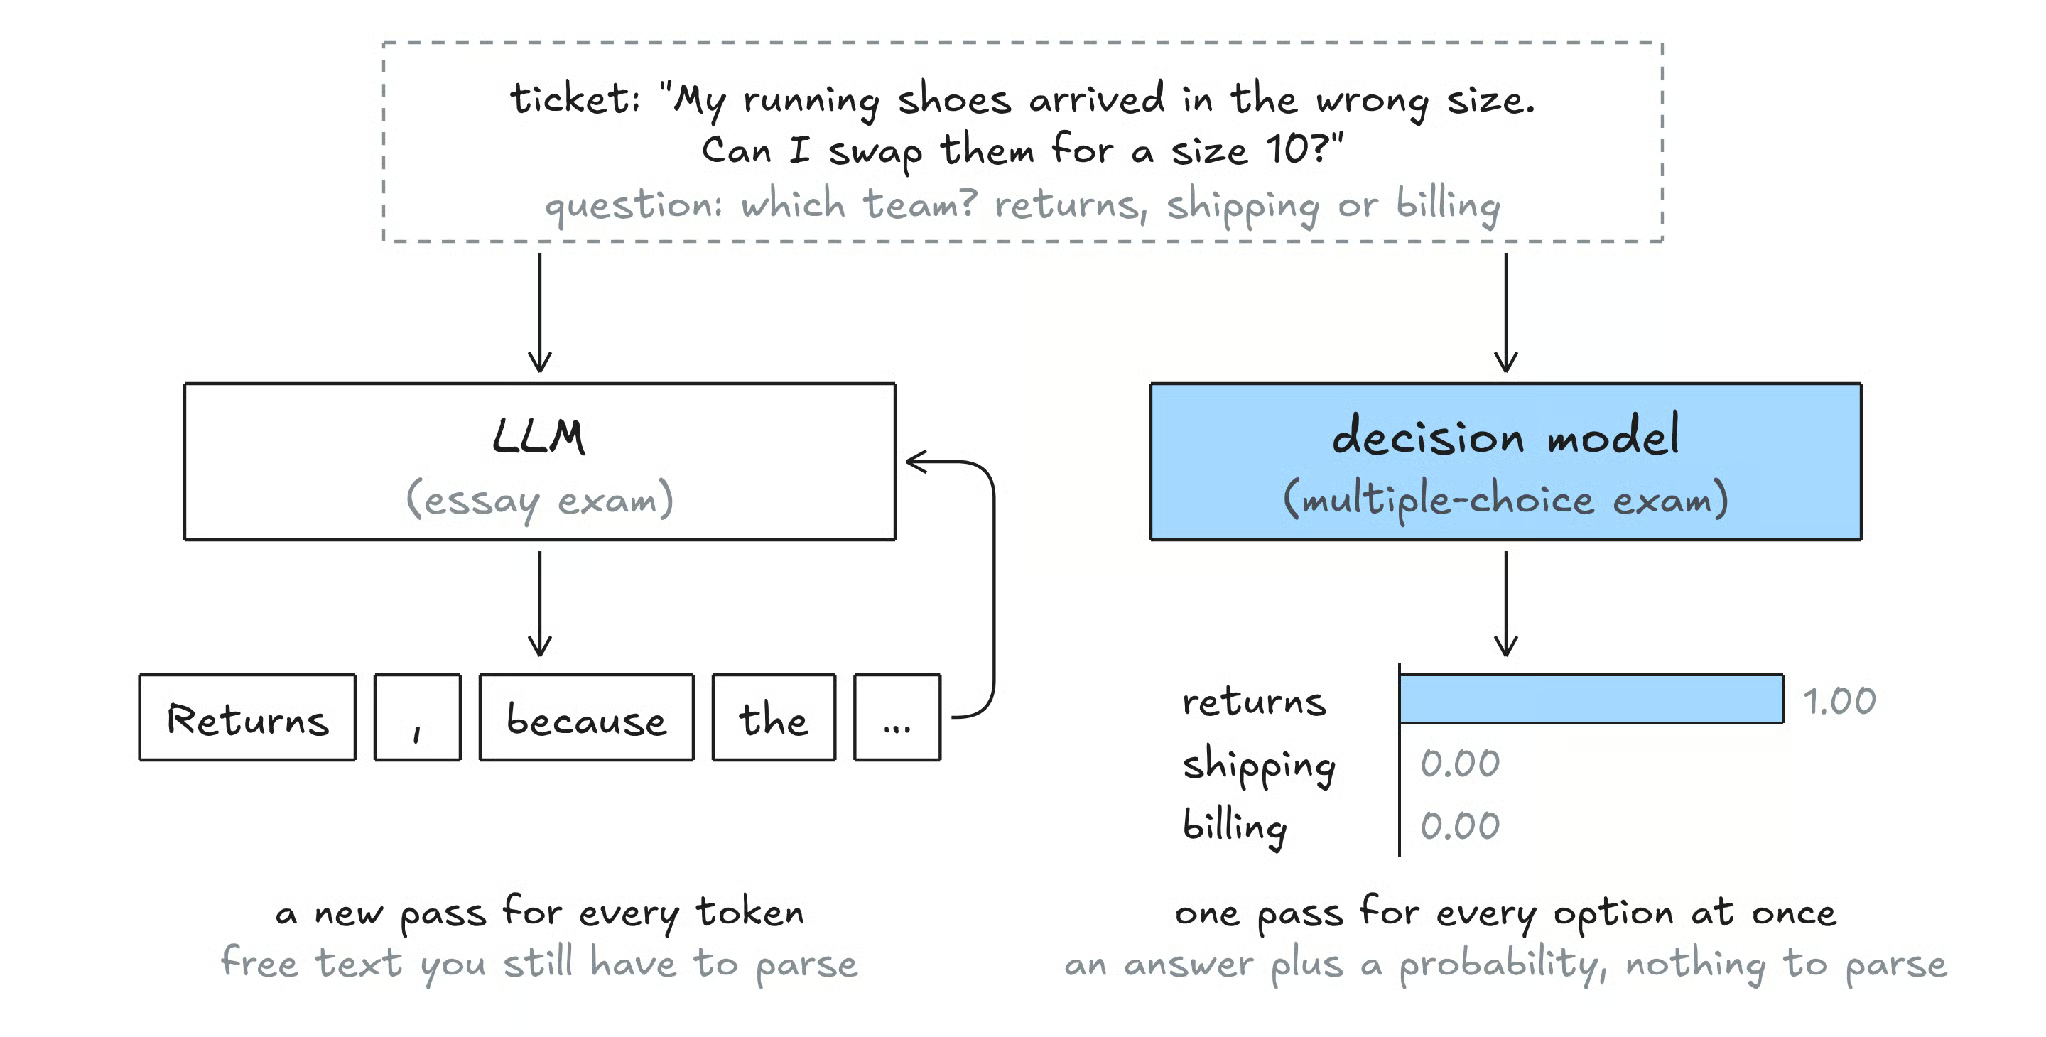
图 2:同一张工单,由 LLM 和决策模型分别作答。原图作者自制。
不存在单一的“决策模型架构”。
TypeSafe 未公开 Jev 的工作方式,但大致有三种方法可以得到这些分数:
不必纠结哪种方法用于何处:三种路线殊途同归,都是为每个允许的答案得到一个数。
我认为这是最关键的部分,用一个例子来说明。
假设一个模型在 100 个问题上都给出“70% 的可能性”。如果模型校准良好,那么大约 70 个答案应当是正确的。
校准之所以重要,是因为经校准的概率让我们能在代码里设定可靠阈值,比如“高于 90% 自动通过,否则转人工”。
如果概率与现实不符,这些阈值就毫无意义。
厂商通常通过会惩罚过度自信的损失函数来训练校准。
TypeSafe 将其方法称为“用于校准决策的强化学习(RLCD)”,Cloudflare 则称其 Clef 模型使用交叉熵配合 Brier 损失。
这可能会让您意外:与其说“生成答案”,不如说“为候选项打分”的想法已经存在多年。
在我看来,决策模型与其说是全新发明,不如说是该思路迄今为止最新、最便利的形态。它主要建立在以下几类模型之上。
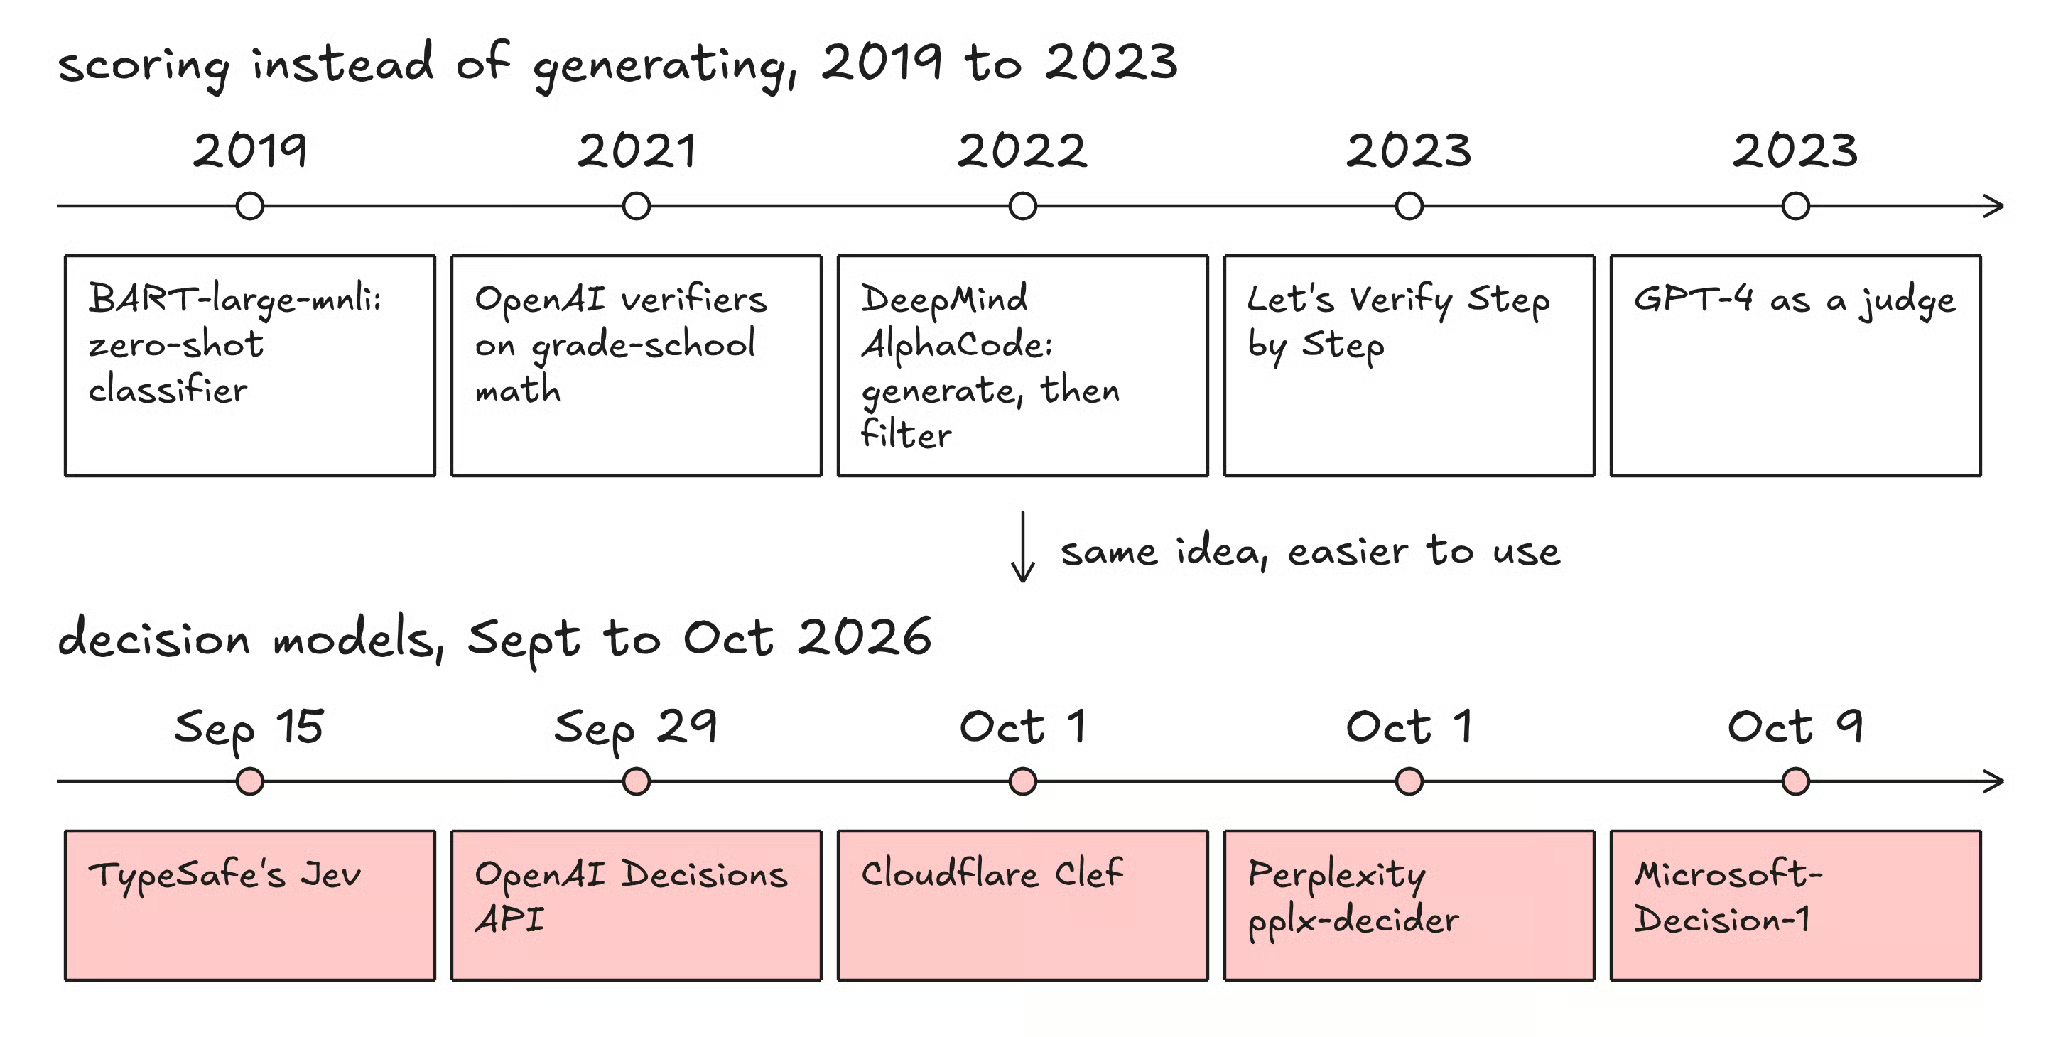
图 3:以打分代替生成可追溯至 2019 年,决策模型是 2026 年版本。原图作者自制。
早在 2019 年,像 BART-large-mnli 这样的模型已经能将文本归入它们从未训练过的标签。
它们的做法是为每个可能标签打分,如“这段文本是关于账单的”。
Red Hat 的 AI 安全团队认为,决策模型在某种意义上只是这些零样本分类器的换名包装。
如果您搭建过RAG 系统,很可能用过它们。先快速检索出一个候选列表(比如 50 篇文档),然后交叉编码器将您的问题与每篇文档一起阅读,为每一对计算相关性分数。
没有生成,文档只是按分数重新排序。
它们是为 LLM 已经生成的答案打分的模型。
2021 年,OpenAI 研究者展示:给模型加一个验证器,在小学数学上带来的提升大致等同于把模型放大 30 倍,这点让我印象很深。
两年后,“Let’s Verify Step by Step” 论文显示:为每一步推理打分比只打最终答案更有效。
简单版本是生成多份答案,为每份打分,然后保留最好的。DeepMind 的 AlphaCode(2022)把这一思路发挥到极致:每道题最多生成一百万个程序,用样例测试丢掉约 99%,最后只提交 10 个。
在对过往 Codeforces 竞赛的模拟评测中,它的平均排名进入了人类选手的前 54.3%。
提醒一点:如果对一个并不完美的打分器施压过大,质量最终会下降,因为生成器会学会利用打分器的漏洞。
技术上称为奖励过度优化。
这是指用一个大型 LLM 来对另一模型的输出评分。
2023 年的一项研究发现,GPT-4 与人类评审的一致率超过 80%,但也存在偏差,比如偏好更长的答案或首先展示的答案。
决策模型部分是作为此类裁判的更便宜、结构化的替代品来推广的。
能量模型会给“契合”的输入-答案对一个低“能量”分,对“不契合”的对给高分。
选择答案就是找能量最低者,本质仍是为候选项打分。
Yann LeCun 多年来一直主张:逐 token 生成并非通往真正智能的道路,能量方法与 JEPA 才是更好的方向。
下面谈谈已经发布的模型。进展很快,因此每个点到为止。
TypeSafe AI 是一家由前 OpenAI 研究员 Diogo Almeida 创立的旧金山初创公司,2026 年 9 月 15 日“出隐”发布 Jev,并宣布由 DCVC 领投的 4000 万美元种子轮。
Jev 是托管式 API。生产环境中仅接收文本;图像输入处于实验阶段,需要通过标头显式启用。定价按输入 token 计费,输出免费,这在输出只是几个数字时颇为合理。
Jev 1.14 于 10 月 14 日发布,尽管 jev-latest 仍指向 1.13.0,即本文稍后 Red Hat 测试的版本。
发布时引发了大量讨论。Vercel 表示,约 13% 的付费团队在发布 24 小时内通过其 AI Gateway 试用了 Jev,不过当时在网关上是免费的。
OpenAI 在 2026 年 9 月 29 日的 DevDay 上宣布了其 Decisions API。
它支持由用户自定义、且拥有固定答案集的问题,构建于 GPT-6 Luna 之上。10 月 6 日进入公开测试,并且也可接收图像输入,而 Jev 仅在实验性地支持图像。
Cloudflare 于 2026 年 10 月 1 日发布 Clef 和更小的 Clef-flash,开放权重并在 Workers AI 上提供托管。二者都基于 Qwen 模型,接受与 Jev 相同风格的请求,因此面向 Jev 编写的代码几乎无需改动即可对接 Clef。
| 模型 | 厂商 | 发布日期(2026) | 获取方式 | 备注 |
|---|---|---|---|---|
| pplx-decider | Perplexity | 10 月 1 日 | 开放权重与 API | 自测 11 项基准面板上 85.71%,对比 Jev 的 84.51% |
| Microsoft-Decision-1 | Microsoft | 10 月 9 日 | Foundry 预览 | 后训练的 9B Qwen 模型 |
| Laya | Convai Innovations | 9 月 | 开放权重 | 体量小(4.21 亿参数),可在笔记本 CPU 上运行;其模型卡称其为可专用化的基础,而非零样本引擎 |
在整理本节时让我印象最深的是:这里多数开源和大厂模型都是对普通 LLM 进行微调的结果。Laya 是个例外:它是带决策头的编码器。Jev 的内部机制未披露。
在我看来,这支撑了这样一种判断:真正的创新在于包装(即接口与校准训练),而非全新的架构。
何时选用哪一种,最清晰的方式是做个对比:
| 特性 | LLM | 决策模型 | 微调分类器 | LLM + 验证器 |
|---|---|---|---|---|
| 输出 | 自由文本 | 类型化答案与概率 | 固定标签 | 多候选中的最佳答案 |
| 是否需要标注数据 | 否 | 否 | 是 | 常常需要 |
| 速度 | 数秒 | 几十到数百毫秒 | 非常快 | 最慢 |
| 超出格式的答案 | 可能 | 不可能 | 不可能 | 取决于生成器 |
| 是否解释答案 | 是 | 否 | 否 | 是 |
| 最适合 | 写作、代码、推理 | 路由、分诊、护栏 | 单一固定的高频任务 | 数学、有测试的代码 |
我的一个粗略经验法则是:
我确实认为,最好的系统会混合使用以上所有方式。
我可以预见决策模型将作为 LLM 周围的快速“闸门”。闸门决定:
这样,昂贵的 LLM 只在确实需要写作时才运行。
这一节最重要,因为您在网上看到的大数值多来自厂商自报。甚至 TypeSafe 也承认,其宣传的速度和成本收益处于真实使用中的偏高端。
2026 年 10 月,Red Hat 的 AI 安全团队在两个任务上比较了九种护栏方案:拦截提示注入与拦截不安全内容。
DiffusionGemma 是通过 vLLM 提供的 Gemma 文本扩散模型。
以下是最有意思的结果:
| 方法 | 类型 | 提示注入准确率 | 内容安全准确率 |
|---|---|---|---|
| deberta-v3-base | 微调分类器 | 89.01% | - |
| granite-guardian-hap-125m | 微调分类器 | - | 80.27% |
| Qwen3.6-35B | 由 LLM 充当裁判 | 89.31% | 85.47% |
| DiffusionGemma | 决策模型(开源) | 87.72% | 85.53% |
| Jev | 决策模型 | 86.35% | 86.20% |
| Laya | 决策模型(开源) | 85.44% | 57.87% |
| BART-large-mnli | 2019 年零样本分类器 | 61.49% | 68.67% |
在内容安全上,Jev 以 0.67 个百分点的优势领先 DiffusionGemma(Qwen 裁判第三);而在提示注入上,Qwen 裁判位列第一。
这种分化也是 Red Hat 仍可宣称“总体上决策模型未显示出优于 LLM 裁判的质量提升”的原因。
但我觉得更有趣的是:一个 2 亿参数量级的分类器在提示注入上仅落后 0.3 个百分点,中位延迟却低于 100 毫秒,而 Jev 大约为 348 毫秒。
Jev 的延迟包含一次跨大西洋往返,因为测试在英国运行,而 TypeSafe 的服务器在美国。
这段跨洋仅能解释与本地 CPU 模型之间的差距。Qwen、Nemotron 和 DiffusionGemma 也在美国集群运行,但 Qwen 仍然比 Jev 更快。
即便如此,Red Hat 的结论是:除 Laya 外(如果能通过提示规避其限制,小体量确有优势),在他们的测试中,决策模型并未比由 LLM 充当裁判更快、更便宜或更好。
一篇来自高校研究者的论文于 2026 年 9 月上传至 arXiv,在 44 个对齐(alignment)基准上测试了 Jev。
结果在某些方面颇为有趣:
我认为“选择性预测”的发现在实践中非常有用。
它说明这样一种简单设计是可取的:让决策模型处理容易的案例,把不确定的交给 LLM 或人工。
我们动手做一个决策模型。
我们会用前面讲的 token 概率技巧,把一个开源小型 LLM 变成决策模型,并检验它的概率是否可信。
首先,用以下命令安装依赖(可在免费的 Colab 笔记本上运行):
pip install transformers torch datasets sentence-transformers numpy我们将使用 Qwen2.5-0.5B-Instruct,它小到可以在 CPU 上运行。
思路很简单:用字母给选项贴标签,运行模型一次,只查看这些字母作为“下一个 token”的概率。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
注意我们从未调用 generate()。我们只做了一次前向传播,保留“A”“B”“C”等的分数,丢掉其他一切。
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
就是这样。我们用大约 30 行代码搭了一个可用的决策模型。
是/否问题本质上就是两个选项的 choice 问题。
现在看看这个简单版本会在哪些地方吃力。
试着打乱选项顺序,对同一个问题再次运行:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
像这样信息混杂的输入,光是调换选项顺序,就可能让概率发生变化。
这叫做顺序偏差,而 TypeSafe 实际也将“偏向第一个选项”列为 Jev 的已知弱点之一。
您还可能看到模型频繁给出接近 100% 的答案。Berryman 在 Jev 本身上做过一个不错的测试:当他说一枚硬币 60% 机率朝上,是/否问题的返回是 0.58,挺接近。
但在 choice 问题(“正面还是反面?”)里,结果正面为 0.99,因为概率向更可能的答案塌缩了。
这一步我认为人人都该做。我们会取 AG News 数据集中的 400 条新闻(每条是标题加简述),它包含四个主题,检查模型的概率是否与现实相符。
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)接下来需要一个衡量校准的方法。期望校准误差(ECE)会将预测按置信度分箱,比较每个箱内的平均置信度与实际准确率的差距。
明确一点:越低越好。
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
现在说个小技巧。
我们将数据一分为二,用前一半寻找能让概率更“诚实”的温度,再在后一半上测试。
温度高于 1 会软化过度自信的预测;温度低于 1 会锐化过度保守的预测。
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
准确率不会改变,因为用温度缩放并不会改变哪个选项排名第一。
改变的只是置信度。
您的具体数值会有随机差异,但测试集一半上的 ECE 通常会下降。由于只有 200 条测试样本,估计会有噪声,因此不要过度解读小幅变化。
这里的道理很简单:某个模型在他人的数据上校准良好,并不意味着在您的数据上也校准良好。
为展示“打分而非生成”理念有多常见,下面在 RAG 场景中演示相同思路。
交叉编码器将每段文本与问题配对打分,然后我们只需排序:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
print(round(float(result["score"]), 3), passages[result["corpus_id"]])同样,没有生成:模型只是给每个候选项一个分数。
以下是最常见的用例:
| 用例 | 决策模型的作用 |
|---|---|
| 代理路由 | 决定下一步应由哪个工具或子代理处理。 |
| 护栏 | 在触达 LLM 之前标记提示注入或不安全内容。 |
| 支持分诊 | 按团队、主题和紧急程度路由工单。 |
| 文档接入 | 回答关于每份文档的一套固定核对清单。 |
| 搜索与 RAG | 按相关性重排检索到的段落。 |
| 信贷与反欺诈 | 评估风险,但涉及人的决策仍应有人工复核。 |
| 机器人 | 可能作为慢速 LLM 规划与低层级运动控制之间的快速层,但仍属推测。 |
机器人这一点是我个人最感兴趣的。
Berryman 建议,像 Jev 这样的模型可以夹在制定高级计划的慢速 LLM,与驱动机器人关节的运动学模型之间。
不过需要了解的是,TypeSafe 著名的 Doom 演示向 Jev 提供的是文本遥测,而非原始图像。
决策模型很有用,但我不想过度吹捧。
以下是我发现需要牢记的主要局限:
AI 决策模型把一个非常古老的理念——为候选项打分,而非生成答案——做得更易用。
您不需要训练数据;您会得到类型化的答案;而且可以一次问很多问题。
在我看来,这种产品化与封装才是真正的创新。
我预计决策模型会作为 LLM 周围的快速、低成本闸门存在,处理简单决策,让昂贵模型只在确实需要写作时才运行。
Top DataCamp Courses
学习路径
学习路径
实践并学习路径你的进步。
使用 Google 继续