
Program
Geliştiriciler için Yardımcı Yapay Zeka Mühendisi
26 sa
Alıştırma and program your progress.
Google Ile Devam EdinBir restoranda oturduğunuzu ve garsonun, “Sade mi yoksa sodalı mı?” diye sorduğunu hayal edin. Susuzluk tercihlerinizi bir paragrafla anlatmazsınız; verilen iki seçenekten birini seçersiniz.
Şimdi de bugün çoğu uygulamada büyük dil modellerini (LLM) nasıl kullandığımızı düşünün. Onlara “Bu destek talebi faturalandırma, kargo veya iade ile mi ilgili?” gibi sorular soruyoruz ve model bize geri dönüp tam bir cümle yazıyor; biz de bunu kodla ayrıştırmak zorunda kalıyoruz. Gerçekte yalnızca üç olası yanıt vardı, ama biz yine de tüm bir düşünme sürecinin bedelini ödedik.
Bu yeni model türü tam da bu boşluğu doldurmaya çalışıyor. Eylül 2026’da TypeSafe AI adlı bir girişim, hiç metin yazmayan bir model olan Jev’i yayınladı.
Bunun yerine, sabit bir yanıt kümesini puanlıyor ve her birinin ne kadar olası olduğunu söylüyor. Birkaç hafta içinde OpenAI, Cloudflare, Perplexity ve Microsoft kendi sürümlerini çıkardı; bu da alanın ne kadar hızlı ilerlediğini gösteriyor.
Bu yazıda bu yapay zeka karar modellerinin ne olduğunu, nasıl çalıştıklarını ve fikrin aslında nereden geldiğini (tüm bu abartıdan çok daha eski) incelemek istiyorum. Ayrıca bağımsız kıyaslamaların neler bulduğuna da bakacağım.
if ifadesine girebildiğini bildiriyor.Bir yapay zeka karar modeli, bir girdi ve izin verilen yanıtlar kümesini alıp herhangi bir serbest metin üretmeden her yanıtın olasılığını döndüren bir modeldir.
Bu modellerin temel fikri, çıktının zaten yapılandırılmış olmasıdır.
Model yalnızca verdiğiniz yanıtlardan birini döndürebileceği için asla bir cümleyi ayrıştırmak zorunda kalmazsınız. Bu da sonucun doğrudan kodunuzdaki bir if ifadesine girebileceği anlamına gelir.
Ben bu farkı iki tür sınav gibi düşünmeyi seviyorum.
Büyük bir dil modeli bir kompozisyon sınavı olur; yanıtını kelime kelime yazar. Buna karşılık bir karar modeli bir çoktan seçmeli sınav olur ve ayrıca her kutucuk için ne kadar emin olduğunu (bir güven puanı) söyler.
Jev ve çoğu Jev alternatifi üç tür soruyu destekler:
TypeSafe’in görüntülerde nesne konumlama için deneysel bir Kutu (Box) türü de var; bunu burada geçiyorum.
Size TypeSafe’in kendi dokümantasyonundan bir örnek vereyim.
Bir state (modelin bakmasını istediğiniz metin) ve bir questions haritası gönderebilirsiniz. Bir seçim sorusunda her seçenek, criteria adlı alanda kısa bir açıklamayla birlikte gelir.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Ve yanıt şu şekildeydi:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Ayrıştırılacak metin yok.
Seçilen seçeneği, her seçenek için bir olasılığı ve en yüksek olasılıktan türetilen bir güven değeri alırsınız; dolayısıyla daha düz bir dağılım daha düşük güven demektir. Dokümanda, hem yanlış beden hem de çift çekimden bahseden daha dağınık bir bilette olasılık iadeler (0,61) ile faturalandırma (0,35) arasında bölünüyor ve güven 0,42’ye düşüyor.
TypeSafe, Jev’i Daniel Kahneman’ın Hızlı ve Yavaş Düşünme kitabından ödünç alarak bir “Sistem Bir Modeli” olarak tanımlıyor. Neden?
Çok basit bir dille, Sistem 1 hızlı, içgüdüsel yargınızdır; Sistem 2 ise yavaş, adım adım muhakemeniz.
Bir karar modeli hızlı olanı hedefler.
Bir uyarı: Sistem 1 aynı zamanda hızlı hatalar yapan beyin parçamızdır ve TypeSafe’in hakkını vermek gerekirse, kendi dokümanları Jev’in nerelerde hata yaptığını açıkça listeliyor. Buna sonra döneceğiz.
İlk okuduğumda beni şaşırtan şeylerden biri, “karar modeli”nin zaten birkaç başka anlama gelmesiydi. Şunlara atıfla kullanılabilir:
Dolayısıyla net olmak gerekirse, bu yazıda “karar modeli” yalnızca metin yazmak yerine yazılan tiplendirilmiş yanıtları puanlayan ve 2026’nın sonlarında çıkan yeni model kategorisini ifade eder.
Karar modellerinin nasıl çalıştığına girmeden önce, normal bir LLM’in yanıtını nasıl ürettiğini görmek faydalıdır. Bunun farkı görmeyi kolaylaştırdığına inanıyorum.
Bir büyük dil modeli döngü içinde çalışır.
Metnimizi token’lara çevirir, söz varlığındaki her token için bir olasılık tahmin eder, birini seçer, metne ekler ve sonra tekrarlar.
Yanttaki her ek token, modelden bir ileri geçiş daha demektir.
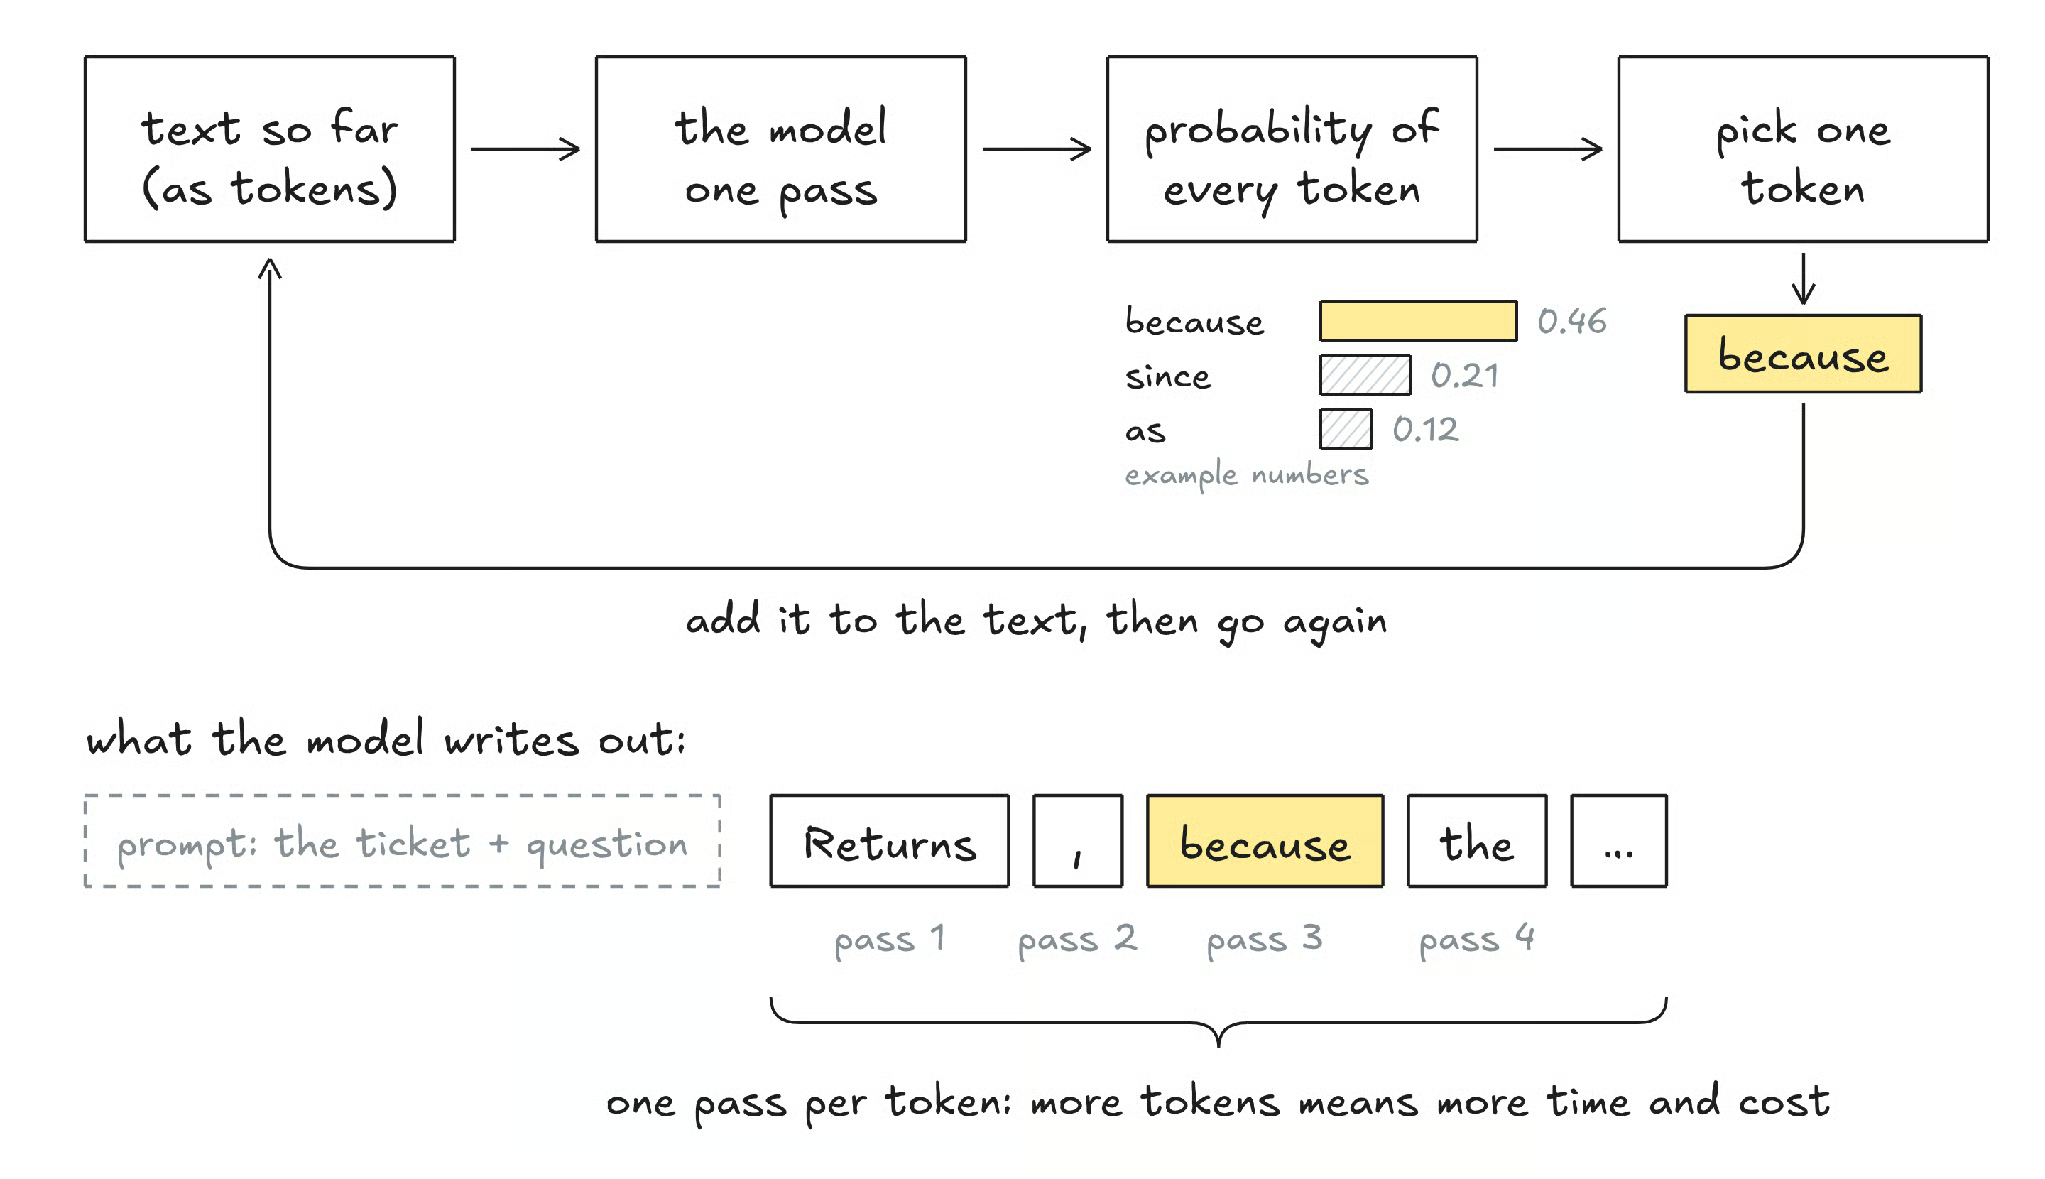
Şekil 1: Bir LLM yazdığı her token için bir ileri geçişe ihtiyaç duyar. Görsel yazar tarafından hazırlanmıştır.
Bu döngü e-postalar, kod veya açıklamalar yazmak için iyi çalışır; ancak basit kararlara gelince birkaç soruna yol açabilir:
Karar modelleri tam olarak bu sorunları düzeltmeye çalışıyor.
Şimdi gerçek mekaniklere geçelim.
Burada anlaşılması gereken üç fikir var:
Bunların her birine biraz yakından bakalım.
Bir karar modeli girdinizi ve soruları okur ve izin verilen her yanıt için bir puan üretir.
Bu puanlar genellikle bir softmax işlevi kullanılarak olasılıklara dönüştürülür. Muhtemelen tahmin edebileceğiniz gibi, yazılacak bir şey olmadığı için uzun bir döngü yoktur.
TypeSafe’in dokümanları ayrıca aynı istekteki soruların paralel değerlendirildiğini söylüyor; bu nedenle ek soru eklemek yanıt süresini zar zor değiştirir.
Hızın büyük kısmı buradan gelir ve TypeSafe, Jev’in genelde 70 ila 500 milisaniye içinde yanıt verdiğini söylüyor.
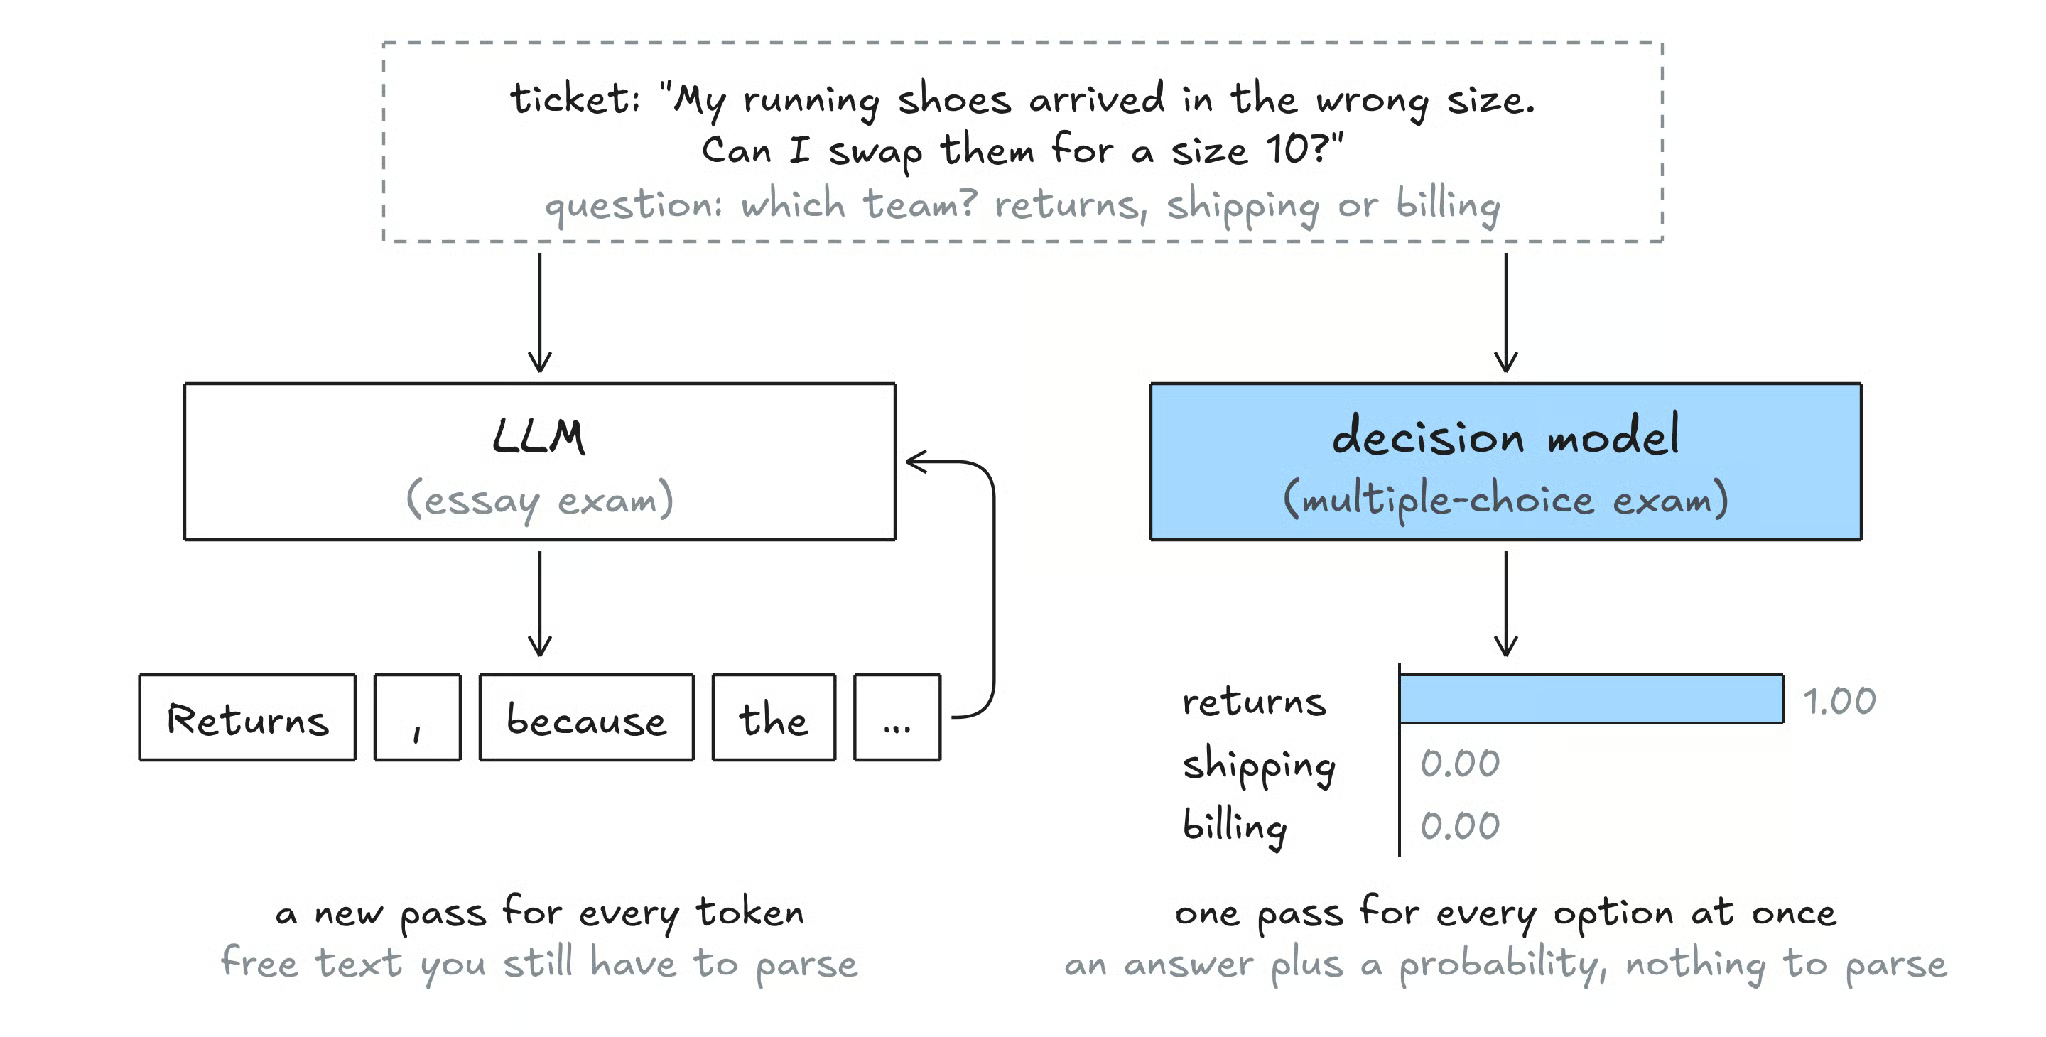
Şekil 2: Aynı bilet, bir LLM ve bir karar modeli tarafından yanıtlanıyor. Görsel yazar tarafından hazırlanmıştır.
Tek bir “karar modeli mimarisi” yoktur.
TypeSafe, Jev’in nasıl çalıştığını yayınlamadı; ancak bu puanları elde etmenin kabaca üç yolu var:
Hangi yerde hangisinin kullanıldığını dert etmeyin: Üçü de aynı yerde biter, yani her izinli yanıt için bir sayı.
Bence en çok önemi olan kısım bu; bir örnek vereyim.
Bir model 100 farklı soruda “%70 olası” diyorsa, model iyi kalibre edilmişse bu yanıtların yaklaşık 70’i doğru çıkmalıdır.
Kalibrasyon önemlidir; çünkü kalibre edilmiş olasılıklar, kodumuzda “%90’ın üzerini otomatik onayla, aksi halde insana gönder” gibi güvenli eşikler belirlememizi sağlar.
Olasılıklar gerçeklikle uyuşmazsa bu eşikler anlamsızdır.
Sağlayıcılar bunu, aşırı özgüveni cezalandıran kayıp işlevleriyle eğitir.
TypeSafe yöntemine Kalibre Edilmiş Kararlar için Pekiştirmeli Öğrenme (RLCD) derken, Cloudflare Clef modelleri için çapraz entropiyi Brier kaybıyla eşleştirdiğini söylüyor.
Bu sizi şaşırtabilir; ancak adayları üretmek yerine puanlama fikri yıllardır var.
Bana göre karar modelleri, tamamen yeni bir icattan ziyade bunun en son ve en kullanışlı versiyonudur. Üzerinde yükseldiği başlıca model aileleri şunlar.
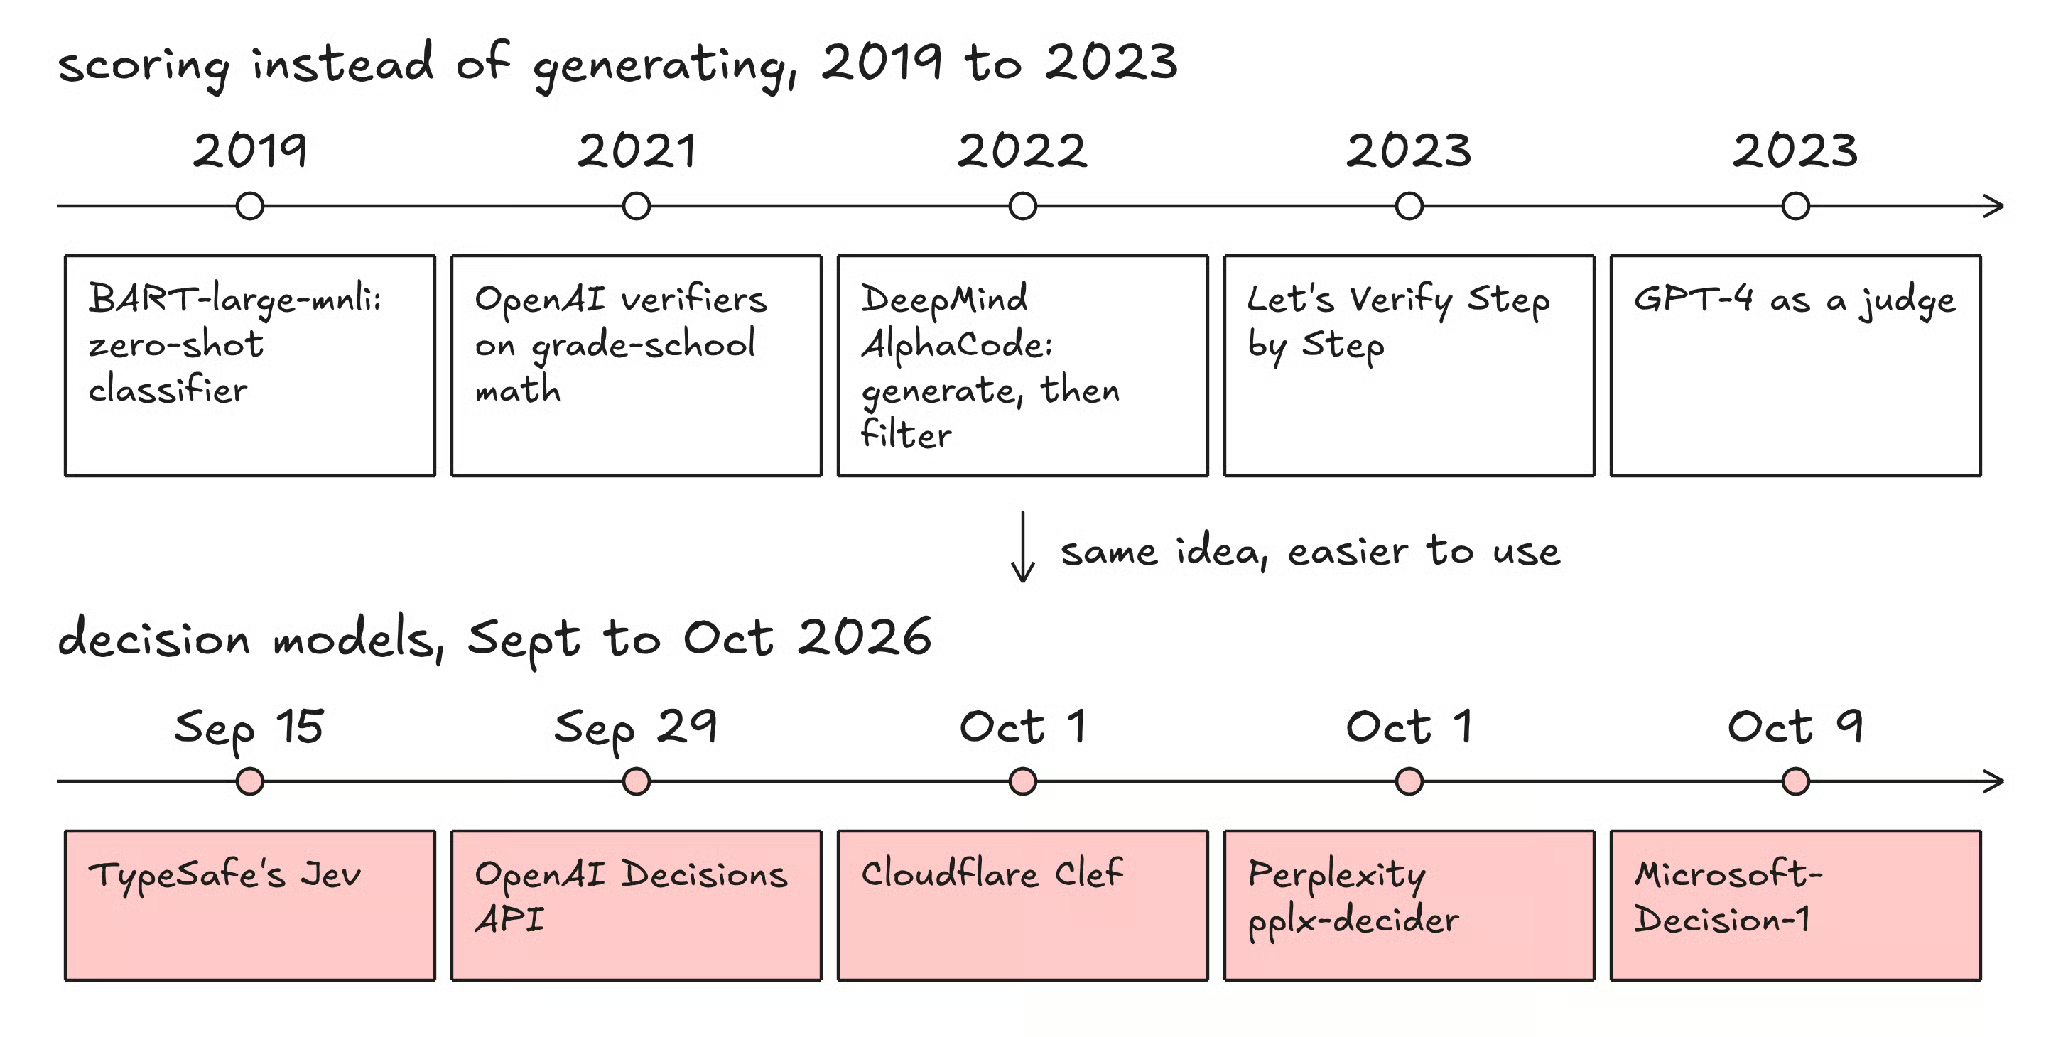
Şekil 3: Üretmek yerine puanlamak 2019’a dayanır; karar modelleri bunun 2026 sürümüdür. Görsel yazar tarafından hazırlanmıştır.
2019’da BART-large-mnli gibi modeller, hiç eğitilmedikleri etiketlere metni ayırabiliyordu.
Bunu, her olası etiket için “bu metin faturalandırma ile ilgili” gibi ifadeleri puanlayarak yapıyorlardı.
Red Hat’in yapay zeka güvenliği ekibi, karar modellerinin aslında bu sıfır atış sınıflandırıcıların yeni bir adla sunulmuş hali olduğunu öne sürüyor.
Bir RAG sistemi kurduysanız bunlardan birini kullanmış olabilirsiniz. Önce hızlıca kısa bir liste (örneğin 50 doküman) çağırırsınız; sonra bir çapraz kodlayıcı, sorunuzu ve her dokümanı birlikte okur ve her çifte bir alaka puanı verir.
Hiçbir şey üretilmez; bunun yerine dokümanlar puana göre yeniden sıralanır.
Bunlar, bir LLM’in halihazırda ürettiği yanıtları puanlayan değerlendiricilerdir.
2021’de OpenAI araştırmacıları, bir modele doğrulayıcı eklemenin ilkokul matematiğinde yaklaşık modeli 30 kat büyütmeye eşdeğer bir artış sağladığını gösterdi; bence çarpıcı.
İki yıl sonra “Adım Adım Doğrulayalım” makalesi, yalnızca nihai yanıtı değil her akıl yürütme adımını puanlamanın daha da iyi çalıştığını gösterdi.
Basit sürüm, birçok yanıt üretmek, her birini puanlamak ve en iyisini tutmaktır. DeepMind’ın AlphaCode’u (2022) bunu aşırıya taşıdı; problem başına bir milyona kadar program üretti, yaklaşık %99’unu örnek testlerle eledi ve sadece 10’unu gönderdi.
Geçmiş Codeforces yarışmalarının simüle değerlendirmelerinde, ortalamada insan yarışmacıların en iyi %54,3’ü arasında yer aldı.
Bir uyarı: Mükemmel olmayan bir değerlendiriciyi çok zorlarsanız kalite sonunda düşer; çünkü üreteç, değerlendiricinin hatalarını sömürmeye başlar.
Bunun teknik adı ödül aşırı optimize etme.
Bu, büyük bir LLM’in başka bir modelin çıktısını notlamasıdır.
2023 tarihli bir çalışma, GPT-4’ün insan hakemlerle %80’in üzerinde anlaşmaya vardığını, ancak daha uzun yanıtlara veya önce gösterilen yanıta meyil gibi önyargıları da olduğunu buldu.
Karar modelleri, kısmen bu hakemlerin daha ucuz ve yapılandırılmış bir ikamesi olarak pazarlanıyor.
Enerji tabanlı model, iyi uyumlu bir girdi-yanıt çifti için düşük “enerji” puanı ve uyuşmayan çiftler için yüksek puan verir.
Yanıt seçmek, en düşük enerjiyi bulmak anlamına gelir; yani yine adayları puanlamak.
Yann LeCun yıllardır, token token üretmenin gerçek zekâya giden yol olmadığını; enerji tabanlı yaklaşımlar ve JEPA’nın daha iyi bir yön olduğunu savunuyor.
Şimdi gerçekten yayınlanmış modellere değinmek istiyorum. Burada işler çok hızlı ilerliyor; bu yüzden her birini kısa tutacağım.
TypeSafe AI, eski bir OpenAI araştırmacısı olan Diogo Almeida’nın kurduğu San Francisco merkezli bir girişimdir; 15 Eylül 2026’da Jev ve DCVC liderliğinde 40 milyon dolarlık tohum turu ile gizlilikten çıktı.
Jev barındırılan bir API’dir. Üretimde yalnızca metin alır; görsel girdi deneyseldir ve bir opt-in başlığı gerektirir. Fiyatlandırma girdi token’ları üzerinden yapılır; çıktılar ücretsizdir; bu da çıktı sadece birkaç sayı olduğunda mantıklıdır.
Jev 1.14, 14 Ekim’de geldi; ancak jev-latest takma adı hâlâ bu yazıda Red Hat’in test ettiği 1.13.0 sürümünü işaret ediyor.
Lansman etrafında büyük bir ilgi vardı. Vercel, ücretli ekiplerinin yaklaşık %13’ünün ilk 24 saat içinde AI Gateway üzerinden Jev’i denediğini söyledi; bu sırada gateway’de ücretsizdi.
OpenAI, Decisions API’sini 29 Eylül 2026’daki DevDay’de duyurdu.
Sabirlenmiş yanıtları olan kullanıcı tanımlı sorularla çalışır ve GPT-6 Luna üzerinde inşa edilmiştir. 6 Ekim’de genel betaya geçti ve Jev’in yalnızca deneysel olarak desteklediği görselleri de alabilir.
Cloudflare, 1 Ekim 2026’da açık ağırlıklarla ve Workers AI üzerinde barındırmayla Clef ve daha küçük Clef-flash’i yayınladı. Her ikisi de Qwen modelleri üzerine kurulu ve Jev tarzı istekleri kabul ediyor; bu nedenle Jev için yazılmış kod çok az değişiklikle Clef’e yönlendirilebilir.
| Model | Üretici | Yayın (2026) | Erişim | Dikkate değer ayrıntı |
|---|---|---|---|---|
| pplx-decider | Perplexity | Ekim 1 | Açık ağırlıklar ve API | Perplexity’nin kendi 11 kıyas panelinde Jev’in %84,51’ine karşı %85,71 (öz bildirim) |
| Microsoft-Decision-1 | Microsoft | Ekim 9 | Foundry ön izlemesi | Eğitim sonrası 9B Qwen modeli |
| Laya | Convai Innovations | Eylül | Açık ağırlıklar | Küçük (421M parametre), dizüstü CPU’da çalışır; model kartı onu sıfır atış motoru değil, özelleştirme tabanı olarak tanımlar |
Bu bölümü hazırlarken beni gerçekten etkileyen şey, buradaki açık ve büyük teknoloji modellerinin çoğunun normal LLM’lerin ince ayarlı sürümleri olmasıydı. Laya istisna: karar başlığı olan bir kodlayıcıdır. Jev’in iç yapısı açıklanmadı.
Bana göre bu, gerçek yeniliğin bambaşka bir mimariden ziyade paketlemede (yani arayüz ve kalibrasyon için eğitimde) olduğunu destekliyor.
Hangisini ne zaman kullanacağınıza karar vermenin en net yolu bir karşılaştırmadır:
| Özellik | LLM | Karar modeli | İnce ayarlı sınıflandırıcı | LLM + doğrulayıcı |
|---|---|---|---|---|
| Çıktı | Serbest metin | Tiplendirilmiş yanıt ve olasılıklar | Sabit etiketler | Birden çok üretilen yanıtın en iyisi |
| Etiketli veriye ihtiyaç | Hayır | Hayır | Evet | Çoğu zaman |
| Hız | Saniyeler | Onlarca ila yüzlerce milisaniye | Çok hızlı | En yavaş |
| Biçim dışı yanıtlar | Mümkün | İmkânsız | İmkânsız | Üretece bağlı |
| Yanıtını açıklar | Evet | Hayır | Hayır | Evet |
| En iyi kullanım | Yazma, kod, akıl yürütme | Yönlendirme, triyaj, koruyucular | Tek sabit yüksek hacimli görev | Testli matematik, kod |
Benim kaba kuralım şu:
En iyi sistemlerin bunların hepsini karıştırdığına inanıyorum.
Karar modellerini bir LLM’in etrafında hızlı “kapılar” olarak görüyorum. Bir kapı şunlara karar verir:
Böylece pahalı LLM yalnızca gerçekten yazılması gereken bir şey olduğunda çalışır.
Bu bölüm en önemlisi; çünkü çevrimiçi göreceğiniz büyük sayıların çoğu satıcıların kendilerinden gelir. TypeSafe bile manşet hız ve maliyet kazanımlarının gerçek kullanımdakinin üst ucunda olduğunu kabul eder.
Ekim 2026’da Red Hat’in yapay zeka güvenliği ekibi, iki görevde dokuz koruyucu kurulumunu karşılaştırdı: prompt enjeksiyonunu yakalamak ve güvensiz içeriği yakalamak.
DiffusionGemma, vLLM üzerinden sunulan bir Gemma metin-difüzyon modelidir.
İşte en ilginç sonuçlar:
| Yöntem | Tür | Prompt enjeksiyon doğruluğu | İçerik güvenliği doğruluğu |
|---|---|---|---|
| deberta-v3-base | İnce ayarlı sınıflandırıcı | %89,01 | - |
| granite-guardian-hap-125m | İnce ayarlı sınıflandırıcı | - | %80,27 |
| Qwen3.6-35B | Hakem olarak LLM | %89,31 | %85,47 |
| DiffusionGemma | Karar modeli (açık) | %87,72 | %85,53 |
| Jev | Karar modeli | %86,35 | %86,20 |
| Laya | Karar modeli (açık) | %85,44 | %57,87 |
| BART-large-mnli | 2019 sıfır atış sınıflandırıcı | %61,49 | %68,67 |
Jev, içerik güvenliğinde %0,67 puan farkla DiffusionGemma’nın önünde birinci geldi (Qwen hakemi üçüncüydü); prompt enjeksiyonunda ise Qwen hakemi birinci oldu.
Bu ayrışma, Red Hat’in karar modellerinin genel olarak LLM hakemlerine göre kalite artışı göstermediğini söyleyebilmesinin nedeni.
Ama bana en ilginç gelen nokta, 200 milyon parametreli bir sınıflandırıcının prompt enjeksiyonunda yalnızca %0,3 puan geride bitirmesi; üstelik ortanca gecikmesi Jev’in yaklaşık 348 milisaniyesine kıyasla 100 milisaniyenin altındaydı.
Jev’in gecikmesi Atlas Okyanusu’nu kat eden bir yolculuğu da içeriyordu; zira testler Birleşik Krallık’tan çalıştırıldı ve TypeSafe’in sunucuları ABD’deydi.
Bu sıçrama yalnızca yerel CPU modelleriyle olan farkı açıklar. Qwen, Nemotron ve DiffusionGemma da ABD’deki bir kümede çalıştırıldı ve Qwen yine de Jev’den hızlıydı.
Yine de Red Hat, Laya hariç (küçük boyutu, sınırları etrafında prompt yazabilirseniz gerçek bir avantaj) karar modellerinin testlerinde LLM-hakeme göre daha hızlı, daha ucuz veya daha iyi yanıtlar vermediği sonucuna vardı.
Eylül 2026’da arXiv’e yüklenen üniversite araştırmacılarından bir araştırma makalesi, Jev’i 44 hizalama kıyaslamasında test etti.
Sonuçlar ilginç bir şekilde karışıktı:
Bence seçici tahmin noktası pratikte gerçekten kullanışlı.
Basit bir tasarımın — karar modelinin kolay vakaları ele alıp belirsiz olanları bir LLM’e veya insana devretmesi — iyi bir strateji olduğunu gösteriyor.
Şimdi bir karar modelini kendimiz oluşturalım.
Önceki token olasılığı hilesini kullanarak küçük bir açık LLM’i karar modeline çevireceğiz ve sonra olasılıklarına gerçekten güvenip güvenemeyeceğimizi kontrol edeceğiz.
Önce şu paketleri kurmamız gerekiyor (tüm bunlar ücretsiz bir Colab defterinde çalıştırılabilir):
pip install transformers torch datasets sentence-transformers numpyCPU’da çalışacak kadar küçük olan Qwen2.5-0.5B-Instruct’ı kullanacağız.
Fikir basit: seçenekleri harflerle etiketliyoruz, modeli bir kez çalıştırıyoruz ve yalnızca bu harflerin bir sonraki token olarak olasılıklarına bakıyoruz.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Dikkat edin, hiç generate() çağırmıyoruz. Tek bir ileri geçiş yapıyoruz; “A”, “B”, “C” vb. için skorları saklıyor ve diğer her şeyi atıyoruz.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
Hepsi bu kadar. Yaklaşık 30 satırda çalışan bir karar modeli oluşturduk.
Bir evet/hayır sorusu, iki seçenekli bir seçim sorusudur.
Şimdi bu basit sürümün nerede zorlanmaya başladığına bakalım.
Seçeneklerin sırasını karıştırmayı deneyin ve aynı soruyu tekrar çalıştırın:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Bunun gibi dağınık girdilerde, yalnızca seçenekler yer değiştirdi diye olasılıkların kaydığını sık sık görürüz.
Bu sıra yanlılığı olarak adlandırılır ve TypeSafe, Jev’in bilinen zayıflıkları arasında ilk seçeneğe doğru bir eğilimi gerçekten listeliyor.
Ayrıca modelin sık sık %100’e yakın yanıtlar verdiğini de görebilirsiniz. Berryman, Jev’in kendisi üzerinde güzel bir test yaptı; bir yazı-tura atışının %60 yazı geldiğini söyledi ve evet/hayır sorusu 0,58 döndürdü; bu yakın.
Ancak seçim sorusu (“yazı mı tura mı?”) yazı için 0,99 döndürdü; çünkü olasılık, daha olası yanıt üzerinde çöktü.
Herkesin çalıştırması gerektiğini düşündüğüm adım bu. AG News veri setinden 400 haber öğesi (her biri başlık artı kısa açıklama) alacağız; dört konu var. Olasılıklarımızın gerçekle uyuşup uyuşmadığını kontrol edeceğiz.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Sırada kalibrasyonu ölçmenin bir yolu var. Beklenen kalibrasyon hatası (ECE), tahminleri güven aralıklarına böler ve her aralıktaki ortalama güvenin gerçek doğruluktan ne kadar saptığını kontrol eder.
Net olmak gerekirse, düşük olan daha iyidir:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Şimdi püf noktası şu.
Verimizi ikiye bölüyoruz; ilk yarıyı olasılıkları daha dürüst hale getiren bir sıcaklık bulmak için kullanıyoruz ve sonra ikinci yarıda test ediyoruz.
1’in üzerindeki bir sıcaklık aşırı kendinden emin tahminleri yumuşatır; 1’in altındaki bir sıcaklık ise yeterince kendine güvenmeyenleri keskinleştirir.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
Doğruluk değişmez; çünkü sıcaklıkla bölmek hangi seçeneğin birinci sırada olduğunu asla değiştirmez.
Yalnızca güven değişir.
Kesin sayılarınız çalıştırmanıza bağlı olacaktır; ancak test yarısındaki ECE genellikle düşmelidir. Yalnızca 200 test öğesiyle tahmin gürültülüdür; bu yüzden küçük farklara çok anlam yüklemeyin.
Buradaki ders basit: bir modelin başkasının verisinde kalibre edilmiş olması, sizin verinizde de kalibre edilmiş olduğu anlamına gelmez.
Bu “üretme, puanla” fikrinin ne kadar yaygın olduğunu göstermek için aynı şeyi bir RAG bağlamında veriyorum.
Bir çapraz kodlayıcı her pasajı bir soruya karşı puanlar ve biz sadece sıralarız:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Yine, hiçbir şey üretilmez: model her adaya bir sayı verir.
En sık karşılaşılan kullanım alanları şunlar:
| Kullanım alanı | Bir karar modeli nasıl yardımcı olur |
|---|---|
| Aracı yönlendirme | Bir sonraki adımı hangi aracın veya alt ajanının ele alması gerektiğine karar verir. |
| Koruyucular | Prompt enjeksiyonunu veya güvensiz içeriği LLM’e ulaşmadan önce işaretler. |
| Destek triyajı | Talepleri ekibe, konuya ve önceliğe göre yönlendirir. |
| Belge alımı | Her belge hakkında sabit bir kontrol listesini yanıtlar. |
| Arama ve RAG | Getirilen pasajları alakalılığa göre yeniden sıralar. |
| Kredi ve dolandırıcılık | Riski puanlar; ancak kişilerle ilgili kararlarda yine insan incelemesi olmalıdır. |
| Robotik | Yavaş bir LLM planlayıcı ile düşük seviyeli motor kontrolü arasında hızlı bir katman olarak görev yapabilir; ancak bu hâlâ spekülatiftir. |
Robotik noktası kişisel olarak en çok hoşuma giden.
Berryman, Jev gibi bir modelin, yüksek seviyeli planlar yapan yavaş bir LLM ile bir robotun eklemlerini hareket ettiren kinematik modeller arasında yer alabileceğini öne sürüyor.
Bilinmeye değer bir nokta, TypeSafe’in meşhur Doom demosunun Jev’e ham görseller yerine metin telemetrisi beslemiş olmasıdır.
Karar modelleri faydalıdır; ama onları abartmak istemiyorum.
Aklınızda tutmanız gereken başlıca sınırlamalar şunlar:
Yapay zeka karar modelleri, yanıtları üretmek yerine adayları puanlama gibi çok eski bir fikri alır ve kullanmayı çok daha kolay hale getirir.
Eğitim verisine ihtiyaç duymazsınız; tiplendirilmiş yanıtlar alırsınız ve bir seferde birçok soru sorabilirsiniz.
Bana göre gerçek yenilik bu paketlemedir.
Karar modellerinin, pahalı modelin yalnızca gerçekten yazılması gereken bir şey olduğunda çalışması için, basit kararları ele alan hızlı ve ucuz kapılar olarak LLM’lerin etrafında yer alacağını bekliyorum.
Öne Çıkan DataCamp Kursları
Program
Program
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



