
Leerpad
Associate AI Engineer voor ontwikkelaars
26 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleStel je voor: je zit in een restaurant en de ober vraagt: “Plat of bruisend?” Je antwoordt niet met een alinea over je hydratatievoorkeuren; je kiest een van de twee opties die je kreeg.
Denk nu aan hoe we grote taalmodellen (LLM’s) tegenwoordig in de meeste apps gebruiken. We stellen vragen als “Gaat dit supportticket over facturatie, verzending of retouren?” en het model schrijft ons een volledige zin terug, die we vervolgens met wat code moeten parsen. In feite waren er maar drie mogelijke antwoorden, maar we betaalden toch voor een heel denkproces.
Dit is het gat dat dit nieuwe type model wil vullen. In september 2026 bracht een startup genaamd TypeSafe AI Jev uit, een model dat helemaal geen tekst schrijft.
In plaats daarvan scoret het een vaste set antwoorden en vertelt het hoe waarschijnlijk elk ervan is. Binnen een paar weken lanceerden OpenAI, Cloudflare, Perplexity en Microsoft allemaal hun eigen versies, wat laat zien hoe snel dit veld beweegt.
In dit artikel wil ik onderzoeken wat deze AI-beslissingsmodellen zijn, hoe ze werken en waar het idee eigenlijk vandaan komt (het is veel ouder dan de hype doet vermoeden). Ik kijk ook naar wat onafhankelijke benchmarks vonden.
if-statement in.Een AI-beslissingsmodel is een model dat een input en een set toegestane antwoorden neemt en de waarschijnlijkheid van elk antwoord teruggeeft, zonder vrije tekst te genereren.
Het belangrijkste idee van deze modellen is dat de output al gestructureerd is.
Je hoeft nooit een zin te parsen, omdat het model alleen een van de antwoorden kan teruggeven die je het hebt gegeven. Dit betekent dat het resultaat direct een if-statement in je code kan in.
Ik denk graag aan het verschil als twee soorten tentamens.
Een groot taalmodel doet een essaytoets, waarbij het zijn antwoord woord voor woord uitschrijft, terwijl een beslissingsmodel een meerkeuzetoets doet en je ook vertelt hoe zeker het is van elk vakje (een confidentiescore).
Jev en de meeste Jev-alternatieven ondersteunen drie soorten vragen:
TypeSafe heeft ook een experimenteel Box-type voor het lokaliseren van objecten in afbeeldingen, dat ik hier oversla.
Laat me een voorbeeld geven uit TypeSafes eigen documentatie.
Je kunt een state sturen (dat is gewoon de tekst waar het model naar moet kijken) en een map met questions. Voor een choice-vraag komt elke optie met een korte beschrijving in een veld genaamd criteria.
{
  "model": "jev-latest",
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
En dit was het bijbehorende antwoord:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "shipping": 0.0,
        "returns": 1.0,
        "billing": 0.0
      }
    }
  }
}
Er is geen tekst om te parsen.
Je krijgt de gekozen optie, een waarschijnlijkheid voor elke optie en een confidentiewaarde afgeleid van de hoogste waarschijnlijkheid; een plattere verdeling betekent dus lagere confidence. In de documentatie splitst een rommeliger ticket dat zowel een verkeerde maat als een dubbele afschrijving noemt de waarschijnlijkheid tussen retouren (0,61) en facturatie (0,35), en de confidence zakt naar 0,42.
TypeSafe beschrijft Jev als een “System One Model,” geleend uit Daniel Kahnemans boek Thinking, Fast and Slow. Waarom is dat zo?
In heel eenvoudige taal: Systeem 1 is je snelle, onderbuikgevoel-oordeel, en Systeem 2 is je langzame, stap-voor-stap redenering.
Een beslissingsmodel is bedoeld als de snelle variant.
Eén kanttekening: Systeem 1 is ook het deel van onze hersenen dat snelle fouten maakt, en tot eer van TypeSafe staat in hun eigen docs openlijk waar Jev de mist in gaat. Daar komen we later op terug.
Wat me in het begin in de war bracht, is dat “beslissingsmodel” al verschillende andere dingen kan betekenen. Het kan verwijzen naar:
Dus voor alle duidelijkheid: in dit artikel betekent een “beslissingsmodel” alleen de nieuwe categorie modellen die eind 2026 is uitgebracht en getypte antwoorden scoort in plaats van tekst te schrijven.
Voordat we ingaan op hoe beslissingsmodellen werken, helpt het om te zien hoe een normaal LLM zijn antwoord produceert. Dat maakt het verschil, denk ik, makkelijker zichtbaar.
Een groot taalmodel werkt in een lus.
Het zet onze tekst om in tokens, voorspelt een waarschijnlijkheid voor elk token in zijn vocabulaire, kiest er één, voegt die toe aan de tekst en herhaalt dit dan.
Elke extra token in het antwoord betekent nog een forward pass door het model.
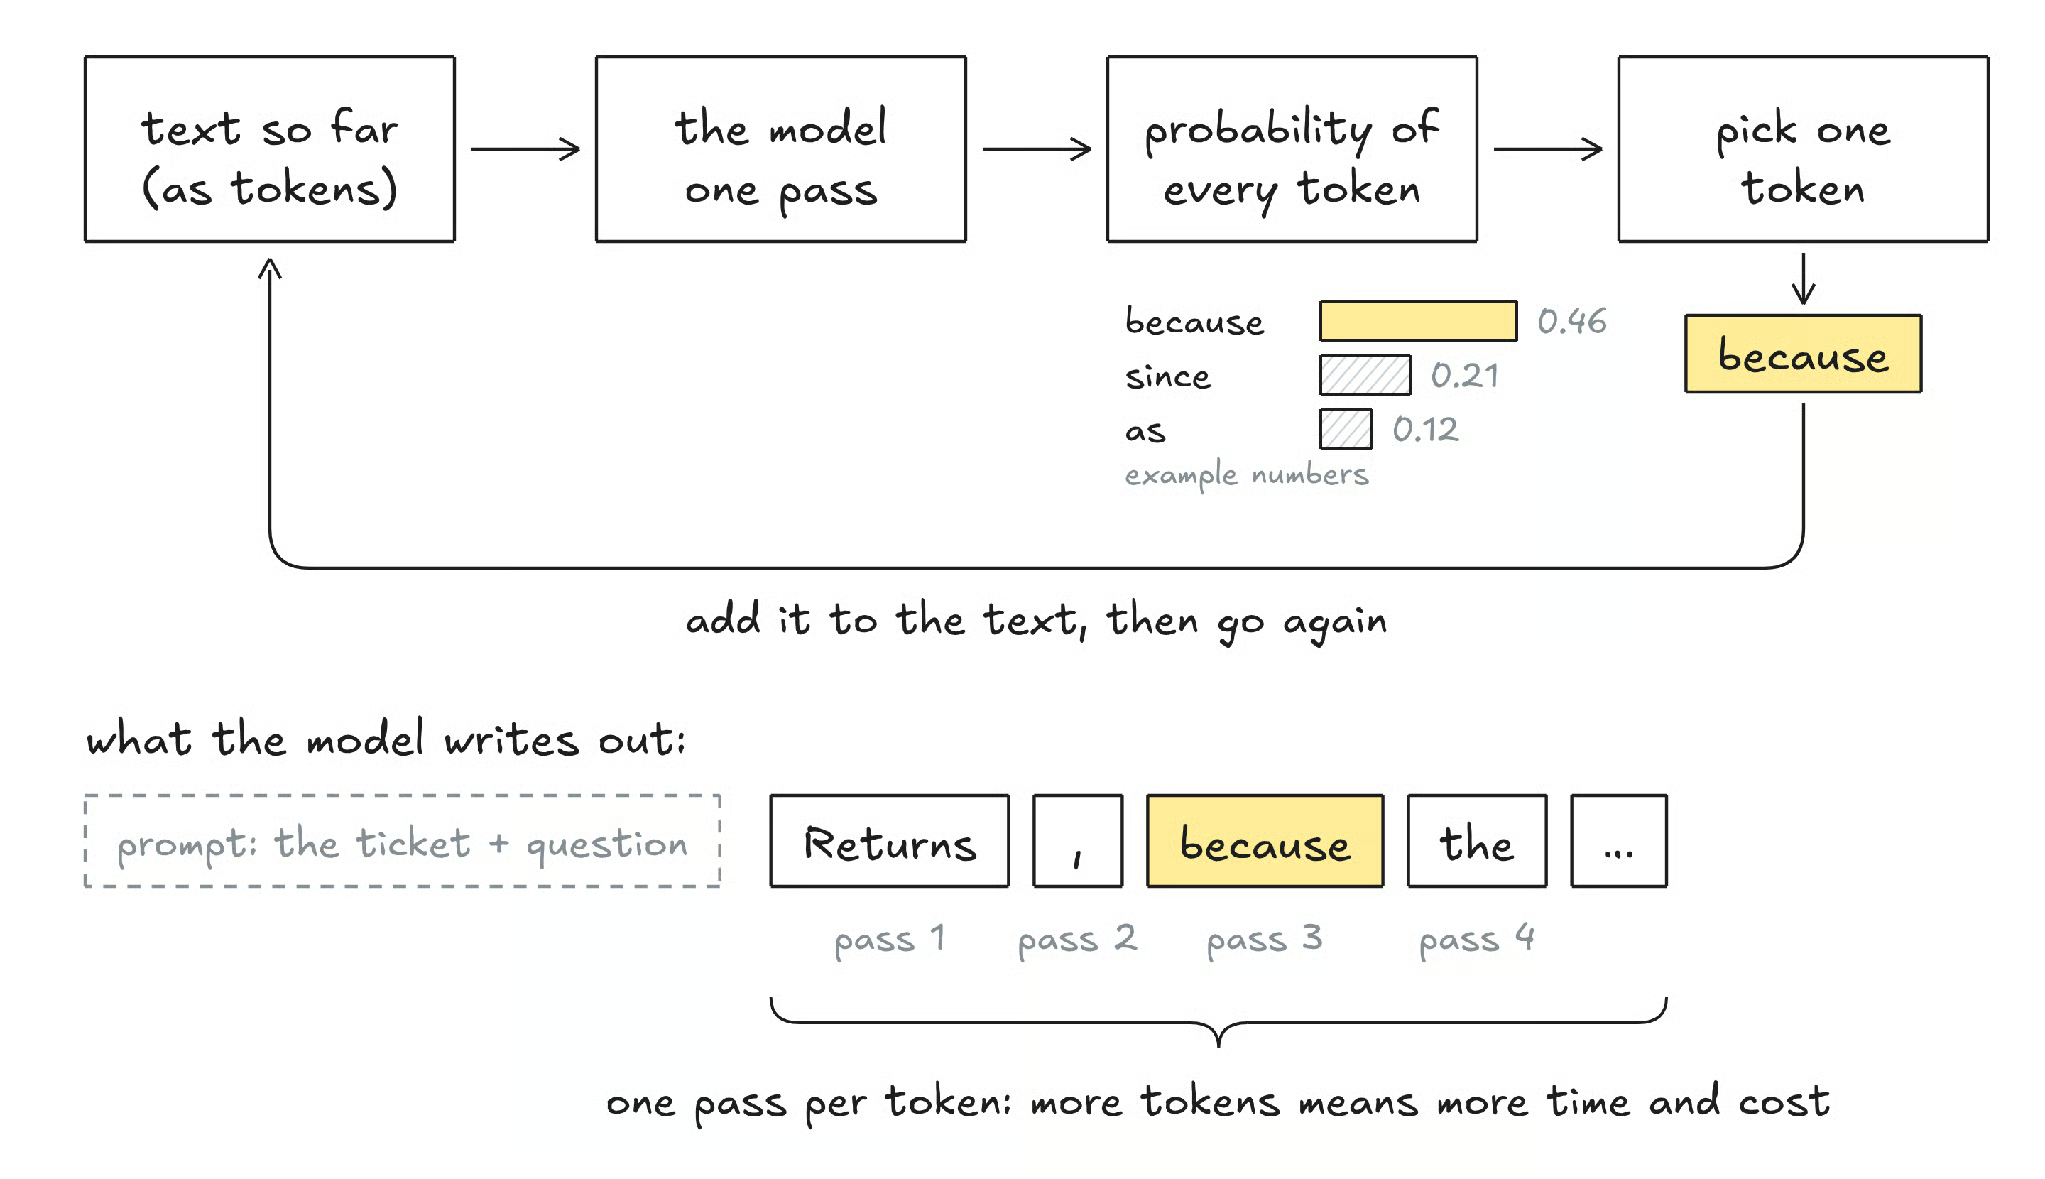
Figuur 1: Een LLM heeft één forward pass nodig voor elke token die het schrijft. Originele afbeelding door auteur.
Deze lus werkt goed voor het schrijven van e-mails, code of uitleg, maar bij simpele beslissingen kan dit voor een paar problemen zorgen:
Beslissingsmodellen proberen precies deze problemen op te lossen.
Laten we nu naar de daadwerkelijke mechaniek gaan.
Er zijn hier drie ideeën die de moeite waard zijn om te begrijpen:
Laten we ze elk iets uitgebreider bekijken.
Een beslissingsmodel leest je input en de vragen en produceert een score voor elk toegestaan antwoord.
Die scores worden doorgaans omgezet in waarschijnlijkheden met een softmaxfunctie. Zoals je kunt raden is er geen lange lus, omdat er niets geschreven hoeft te worden.
TypeSafes documentatie zegt ook dat vragen in dezelfde request parallel worden geëvalueerd, dus extra vragen toevoegen verandert de responstijd nauwelijks.
Hier komt het grootste deel van de snelheid vandaan, en TypeSafe zegt dat Jev doorgaans in zo’n 70 tot 500 milliseconden reageert.
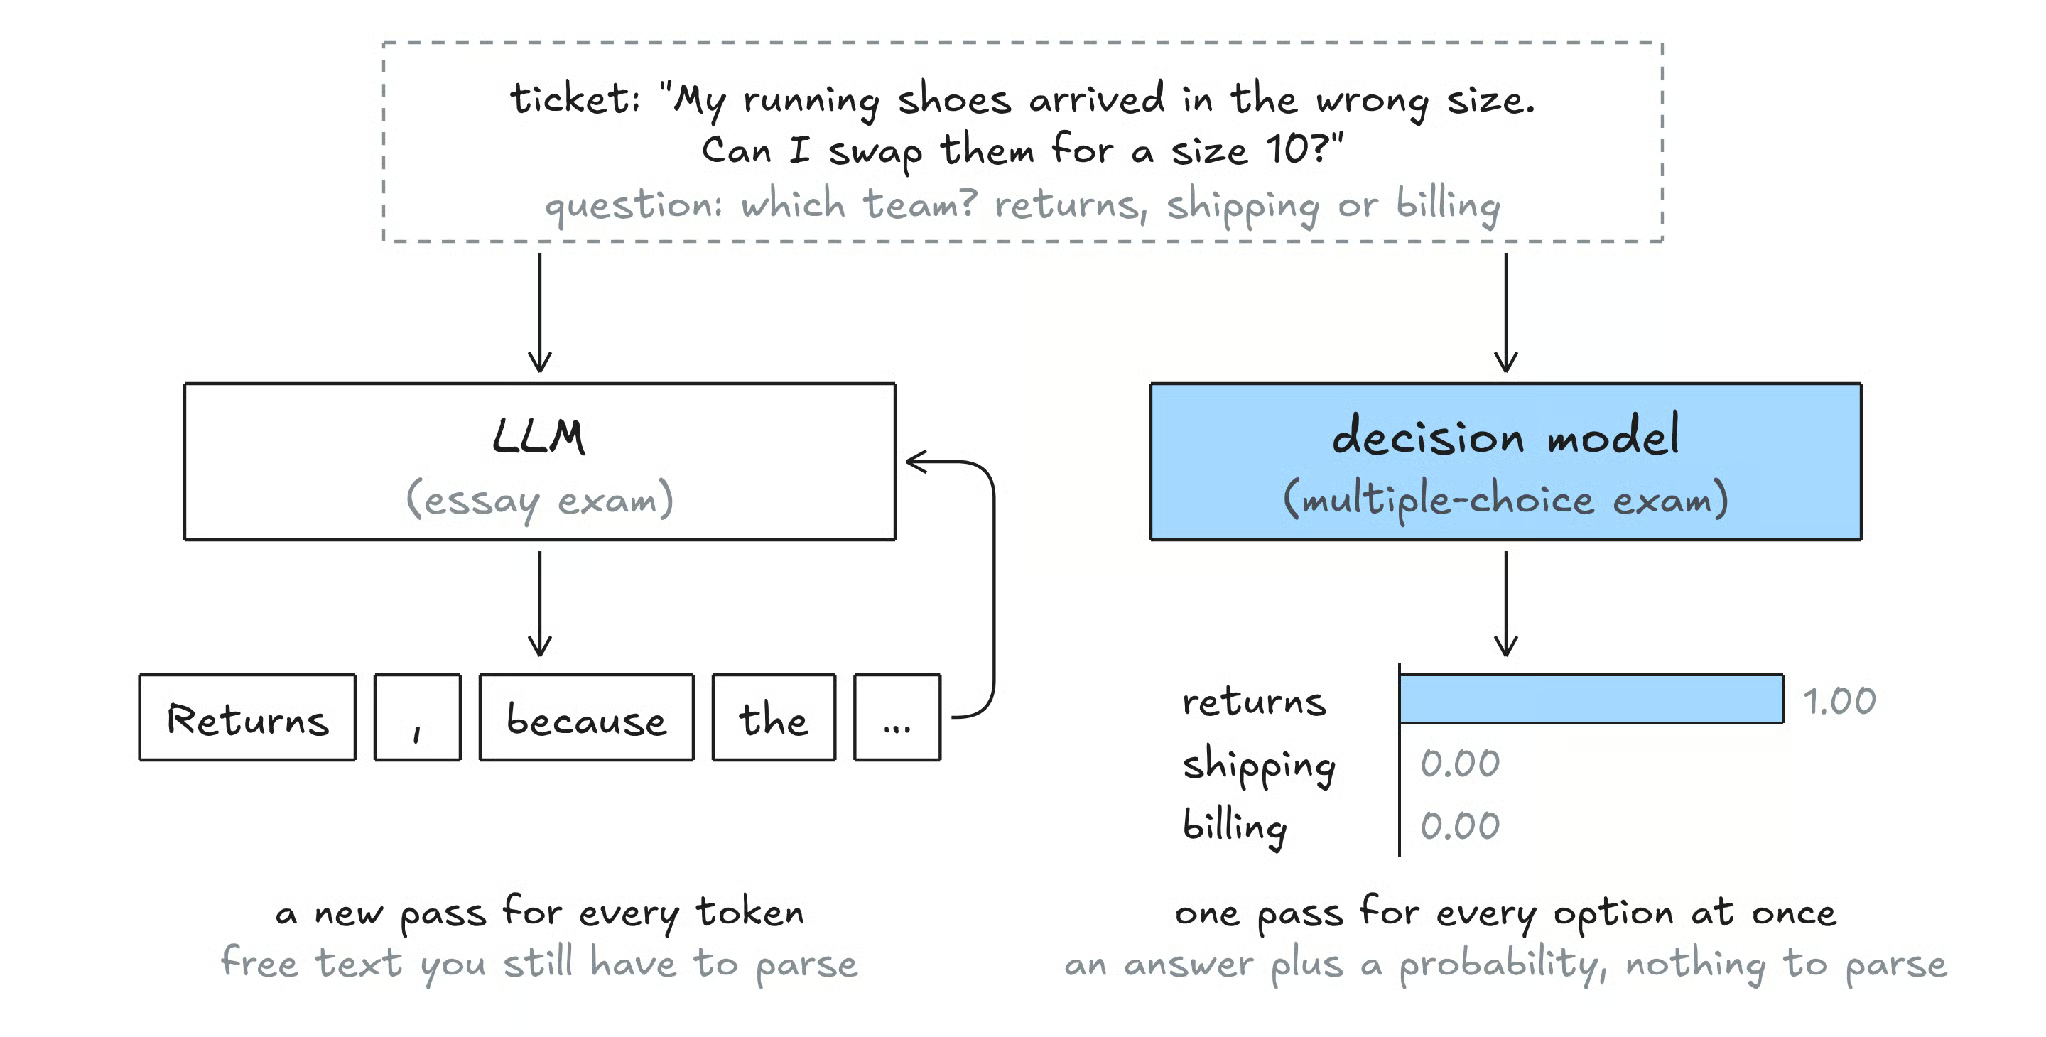
Figuur 2: Hetzelfde ticket, beantwoord door een LLM en door een beslissingsmodel. Originele afbeelding door auteur.
Er is geen enkele “architectuur voor beslissingsmodellen”.
TypeSafe heeft niet gepubliceerd hoe Jev werkt, maar er zijn grofweg drie manieren om deze scores te krijgen:
Maak je niet druk over welke waar wordt gebruikt: alle drie eindigen op hetzelfde punt, een getal voor elk toegestaan antwoord.
Dit is het deel dat volgens mij het meest telt, dus laat me een voorbeeld geven.
Stel je voor dat een model “70% waarschijnlijk” zegt bij 100 verschillende vragen. Als het model goed gekalibreerd is, zouden ongeveer 70 van die antwoorden ook daadwerkelijk correct moeten blijken.
Kalibratie is belangrijk omdat goed gekalibreerde waarschijnlijkheden ons veilige drempels in onze code laten instellen, zoals “automatisch goedkeuren boven 90%, anders naar een mens sturen.”
Als de waarschijnlijkheden niet met de werkelijkheid overeenkomen, zijn die drempels betekenisloos.
Leveranciers trainen hierop met verliesfuncties die overmoed afstraffen.
TypeSafe noemt zijn methode Reinforcement Learning for Calibrated Decisions (RLCD), terwijl Cloudflare zegt dat het cross-entropy koppelt aan een Brier loss voor zijn Clef-modellen.
Dit verrast je misschien, maar het idee om kandidaten te scoren in plaats van ze te genereren bestaat al jaren.
In mijn ogen zijn beslissingsmodellen de nieuwste en meest handige versie hiervan, niet een volledig nieuwe uitvinding. Dit zijn de belangrijkste modellijnen waarop het voortbouwt.
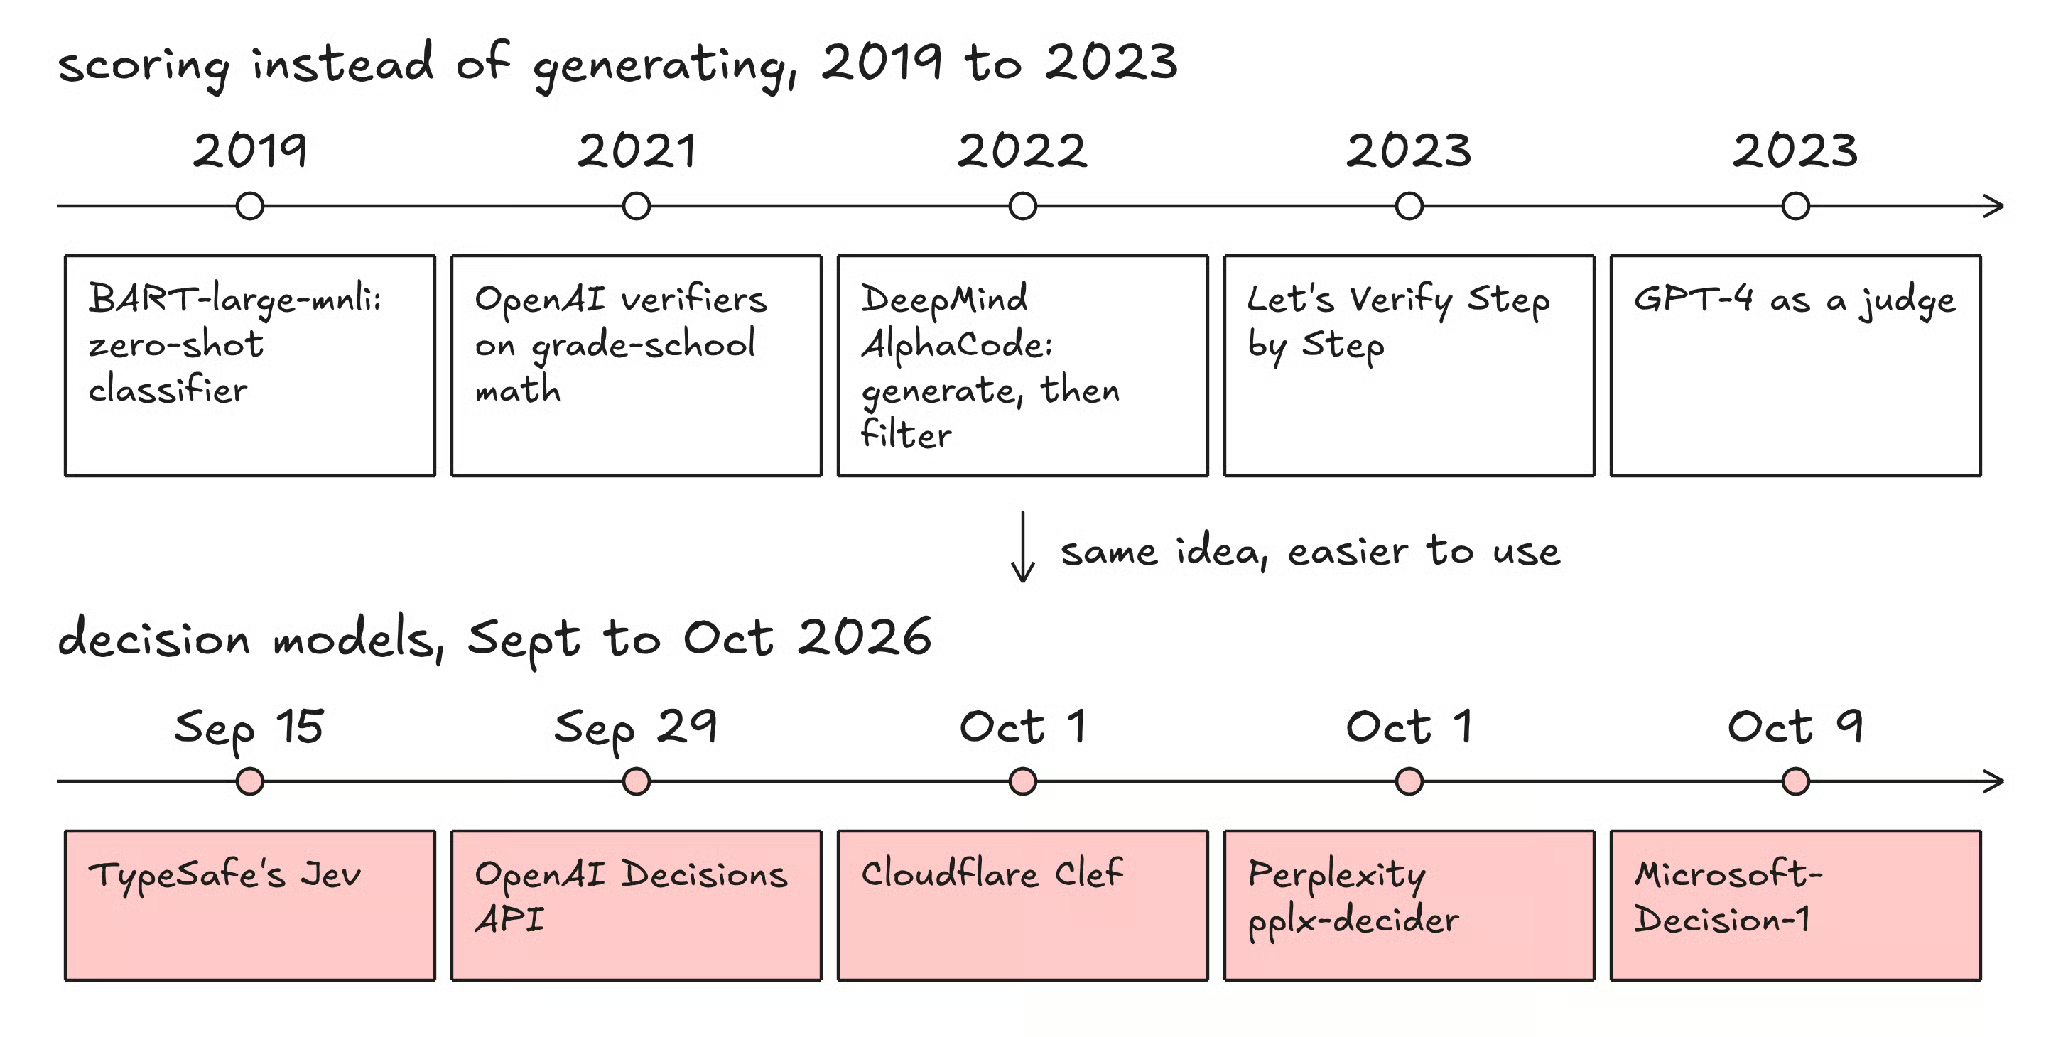
Figuur 3: Scoren in plaats van genereren gaat terug tot 2019, en beslissingsmodellen zijn de versie van 2026. Originele afbeelding door auteur.
Al in 2019 konden modellen zoals BART-large-mnli tekst indelen in labels waarop ze nooit waren getraind.
Ze deden dit door uitspraken als “deze tekst gaat over facturatie” te scoren voor elk mogelijk label.
Het AI-safetyteam van Red Hat suggereert dat beslissingsmodellen in feite gewoon deze zero-shot-classifiers zijn onder een nieuwe naam.
Als je een RAG-systeem hebt gebouwd, heb je er mogelijk een gebruikt. Je haalt eerst snel een shortlist op (bijvoorbeeld 50 documenten), daarna leest een cross-encoder je vraag en elk document samen en kent elk paar een relevantiescore toe.
Er wordt niets gegenereerd; in plaats daarvan worden de documenten gewoon herordend op basis van hun score.
Dit zijn scorers die antwoorden beoordelen die een LLM al heeft gegenereerd.
In 2021 lieten OpenAI-onderzoekers zien dat het toevoegen van een verifier aan een model een boost gaf op rekenkundige schoolwiskunde die grofweg gelijk stond aan het 30 keer groter maken van het model, wat ik opvallend vind.
Twee jaar later liet het “Let’s Verify Step by Step”-paper zien dat het scoren van elke redeneringsstap nog beter werkt dan alleen het eindantwoord scoren.
De simpele versie is: genereer veel antwoorden, scoor elk en houd de beste over. AlphaCode van DeepMind (2022) dreef dit tot het extreme door tot een miljoen programma’s per probleem te genereren, ongeveer 99% weg te gooien met voorbeeldtests en er dan slechts 10 in te dienen.
In gesimuleerde evaluaties op eerdere Codeforces-wedstrijden scoorde het gemiddeld in de top 54,3% van menselijke deelnemers.
Eén waarschuwing: als je te hard pusht op een onvolmaakte scorer, gaat de kwaliteit uiteindelijk omlaag omdat de generator de fouten van de scorer gaat uitbuiten.
De technische term hiervoor is reward overoptimization.
Dit is wanneer een grote LLM de output van een ander model beoordeelt.
Een studie uit 2023 vond dat GPT-4 meer dan 80% van de tijd met menselijke beoordelaars overeenkwam, maar ook biases had, zoals een voorkeur voor langere antwoorden of voor het antwoord dat als eerste werd getoond.
Beslissingsmodellen worden deels verkocht als een goedkoper, gestructureerd alternatief voor deze judges.
Een energy-based model geeft een lage “energie”-score aan een input en antwoord die goed bij elkaar passen en een hoge score aan paren die dat niet doen.
Een antwoord kiezen betekent dan simpelweg de laagste energie vinden, wat opnieuw neerkomt op kandidaten scoren.
Yann LeCun betoogt al jaren dat token-voor-token-generatie niet het pad is naar echte intelligentie, en dat energy-based benaderingen en JEPA een betere richting zijn.
Nu wil ik het hebben over de modellen die daadwerkelijk zijn uitgebracht. Het gaat hier erg snel, dus ik houd elk voorbeeld kort.
TypeSafe AI is een startup uit San Francisco, opgericht door Diogo Almeida, een voormalig onderzoeker bij OpenAI, en kwam op 15 september 2026 uit stealth met Jev en een seedronde van $40 miljoen onder leiding van DCVC.
Jev is een gehoste API. In productie accepteert het alleen tekst; beeldinput is experimenteel en vereist een opt-in-header. De prijs wordt berekend op invoertokens, en de outputs zijn gratis, wat logisch is als de output slechts enkele getallen zijn.
Jev 1.14 volgde op 14 oktober, hoewel de alias jev-latest nog steeds naar 1.13.0 wijst, de versie die Red Hat later in dit artikel testte.
Er was veel buzz rond de lancering. Vercel zei dat ongeveer 13% van zijn betalende teams Jev via de AI Gateway uitprobeerde binnen de eerste 24 uur, hoewel het op dat moment gratis was op de gateway.
OpenAI kondigde zijn Decisions API aan op DevDay op 29 september 2026.
Het werkt met door gebruikers gedefinieerde vragen met een vaste set antwoorden en is gebouwd op GPT-6 Luna. Het ging op 6 oktober naar publieke bèta en kan ook afbeeldingen verwerken, wat Jev alleen experimenteel ondersteunt.
Cloudflare bracht Clef en een kleinere Clef-flash uit op 1 oktober 2026, met open gewichten en hosting op Workers AI. Beide zijn gebouwd op Qwen-modellen en accepteren Jev-achtige requests, dus code geschreven voor Jev kan met heel weinig wijzigingen naar Clef worden gericht.
| Model | Maker | Uitgebracht (2026) | Toegang | Opvallend detail |
|---|---|---|---|---|
| pplx-decider | Perplexity | 1 oktober | Open gewichten en API | Zelfgerapporteerd 85,71% vs 84,51% voor Jev op Perplexitys eigen panel van 11 benchmarks |
| Microsoft-Decision-1 | Microsoft | 9 oktober | Foundry-preview | Een post-getraind 9B Qwen-model |
| Laya | Convai Innovations | September | Open gewichten | Klein (421M parameters), draait op een laptop-CPU; de modelkaart noemt het een basis om te specialiseren, geen zero-shot-engine |
Wat me echt opviel bij het samenstellen van deze sectie is dat de meeste open en big tech-modellen hier fijngestemde versies van normale LLM’s zijn. Laya is de uitzondering: het is een encoder met een decision head. De internals van Jev zijn niet openbaar.
Mijns inziens ondersteunt dit het idee dat de echte innovatie de verpakking is (dus de interface en de training voor kalibratie) in plaats van een gloednieuwe architectuur.
De duidelijkste manier om te beslissen wanneer je welke gebruikt, is een vergelijking:
| Kenmerk | LLM | Beslissingsmodel | Fijngestemde classifier | LLM + verifier |
|---|---|---|---|---|
| Output | Vrije tekst | Getypt antwoord en waarschijnlijkheden | Vaste labels | Beste van meerdere gegenereerde antwoorden |
| Nodig: gelabelde data | Nee | Nee | Ja | Vaak |
| Snelheid | Seconden | Tientallen tot honderden milliseconden | Erg snel | Traagst |
| Antwoorden buiten formaat | Mogelijk | Onmogelijk | Onmogelijk | Hangt af van de generator |
| Legt antwoord uit | Ja | Nee | Nee | Ja |
| Beste voor | Schrijven, code, redeneren | Routing, triage, guardrails | Eén vaste high-volume taak | Wiskunde, code met tests |
Mijn vuistregel is deze:
Ik geloof dat de beste systemen al deze opties combineren.
Ik zie beslissingsmodellen fungeren als snelle poorten rond een LLM. Een poort beslist:
Zo draait de dure LLM alleen wanneer er echt iets geschreven moet worden.
Deze sectie is het belangrijkst, omdat de meeste grote cijfers die je online ziet van de leveranciers zelf komen. Zelfs TypeSafe geeft toe dat de headline-winst in snelheid en kosten aan de hoge kant is van wat je in de praktijk zou zien.
In oktober 2026 vergeleek het AI-safetyteam van Red Hat negen guardrail-opstellingen op twee taken: promptinjection detecteren en onveilige content detecteren.
DiffusionGemma is een Gemma tekst-diffusion-model geserveerd via vLLM.
Dit zijn de interessantste resultaten:
| Methode | Type | Promptinjection-nauwkeurigheid | Content safety-nauwkeurigheid |
|---|---|---|---|
| deberta-v3-base | Fijngestemde classifier | 89,01% | - |
| granite-guardian-hap-125m | Fijngestemde classifier | - | 80,27% |
| Qwen3.6-35B | LLM-as-a-judge | 89,31% | 85,47% |
| DiffusionGemma | Beslissingsmodel (open) | 87,72% | 85,53% |
| Jev | Beslissingsmodel | 86,35% | 86,20% |
| Laya | Beslissingsmodel (open) | 85,44% | 57,87% |
| BART-large-mnli | Zero-shot-classifier uit 2019 | 61,49% | 68,67% |
Jev eindigde eerste op content safety, 0,67 procentpunt voor DiffusionGemma (de Qwen-judge was derde), en de Qwen-judge werd eerste op promptinjection.
Die splitsing is waarom Red Hat nog steeds kan zeggen dat beslissingsmodellen overall geen kwaliteitswinst lieten zien ten opzichte van LLM-judges.
Maar wat ik het interessantst vind, is dat een classifier met 200 miljoen parameters slechts 0,3 procentpunt achterbleef op promptinjection, met een mediane latency onder de 100 milliseconden vergeleken met ongeveer 348 voor Jev.
Jev’s latency omvatte wel een trip over de Atlantische Oceaan, aangezien de tests vanuit het VK draaiden en de servers van TypeSafe in de VS staan.
Die hop verklaart alleen het gat ten opzichte van de lokale CPU-modellen. Qwen, Nemotron en DiffusionGemma draaiden ook op een cluster in de VS, en Qwen was nog steeds sneller dan Jev.
Toch concludeerde Red Hat dat beslissingsmodellen in hun tests geen snellere, goedkopere of betere antwoorden gaven dan LLM-as-a-judge, behalve Laya, wiens kleine formaat een echt voordeel is als je om zijn beperkingen heen kunt prompten.
Een onderzoekspaper van universiteitsonderzoekers, geplaatst op arXiv in september 2026, testte Jev op 44 alignment-benchmarks.
De resultaten waren op een interessante manier gemengd:
Ik denk dat het punt over selectieve voorspellingen in de praktijk erg nuttig is.
Het laat zien dat een simpele opzet waarbij het beslissingsmodel de makkelijke gevallen afhandelt en de onzekere naar een LLM of een persoon doorspeelt, een goede strategie is.
Laten we nu zelf een beslissingsmodel bouwen.
We gaan een kleine open LLM omzetten in een beslissingsmodel met de tokenwaarschijnlijkheden-truc van eerder en vervolgens checken of we de waarschijnlijkheden daadwerkelijk kunnen vertrouwen.
Eerst installeren we de packages met dit commando (dit kun je allemaal in een gratis Colab-notebook draaien):
pip install transformers torch datasets sentence-transformers numpyWe gebruiken Qwen2.5-0.5B-Instruct, die klein genoeg is om op een CPU te draaien.
Het idee is simpel: we labelen de opties met letters, draaien het model één keer en kijken alleen naar de waarschijnlijkheden van die letters als volgende token.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "Qwen/Qwen2.5-0.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()

def option_logits(state, question, options):
    letters = [chr(ord("A") + i) for i in range(len(options))]
    option_text = "\n".join(f"{l}. {o}" for l, o in zip(letters, options))
    messages = [
        {"role": "system", "content": "Answer with a single letter only."},
        {"role": "user", "content": f"{state}\n\nQuestion: {question}\n{option_text}"},
    ]
    prompt = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    inputs = tokenizer(prompt, return_tensors="pt")

    with torch.no_grad():
        next_token_logits = model(**inputs).logits[0, -1].float()

    letter_ids = [tokenizer.encode(l, add_special_tokens=False)[0] for l in letters]
    return next_token_logits[letter_ids]

def decide(state, question, options, temperature=1.0):
    logits = option_logits(state, question, options)
    probs = torch.softmax(logits / temperature, dim=-1)
    return {o: round(p.item(), 3) for o, p in zip(options, probs)}
Let op dat we nooit generate() aanroepen. We doen één forward pass, bewaren de scores voor “A”, “B”, “C”, enzovoort, en gooien al het andere weg.
print(decide(
    state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
    question="Which team should handle this?",
    options=["returns", "shipping", "billing"],
))

print(decide(
    state="The app crashes every time I open the settings page.",
    question="Does this message describe a software bug?",
    options=["yes", "no"],
))
En dat is het echt. We hebben zojuist in ongeveer 30 regels een werkend beslissingsmodel gemaakt.
Een ja/nee-vraag is simpelweg een choice-vraag met twee opties.
Laten we nu zien waar deze eenvoudige versie begint te worstelen.
Probeer de volgorde van de opties te wisselen en draai dezelfde vraag opnieuw:
options = ["returns", "shipping", "billing"]
state = "My shoes arrived late and in the wrong size, and I was charged twice."
question = "Which team should handle this?"

print(decide(state, question, options))
print(decide(state, question, list(reversed(options))))
Bij rommelige inputs als deze zullen we vaak zien dat de waarschijnlijkheden verschuiven alleen omdat de opties verhuisden.
Dit heet ordebias, en TypeSafe noemt een neiging naar de eerste optie zelfs als een van Jev’s bekende zwaktes.
Je kunt ook zien dat het model vrij vaak bijna-100%-antwoorden geeft. Berryman draaide een mooie test op Jev zelf, waarbij hij vertelde dat een munt 60% van de tijd op kop landt, en de ja/nee-vraag gaf 0,58 terug, wat dichtbij is.
Maar de choice-vraag (“heads or tails?”) gaf 0,99 voor heads, omdat de waarschijnlijkheid instortte op het meer waarschijnlijke antwoord.
Dit is de stap die ik vind dat iedereen zou moeten draaien. We nemen 400 nieuwsitems uit de AG News-dataset (elk is een kop plus een korte beschrijving), die vier onderwerpen heeft, en checken of onze waarschijnlijkheden met de werkelijkheid overeenkomen.
import numpy as np
from datasets import load_dataset

data = load_dataset("fancyzhx/ag_news", split="test").shuffle(seed=42).select(range(400))
labels = ["World", "Sports", "Business", "Science and technology"]
question = "What is the topic of this news headline?"

all_logits, targets = [], []
for row in data:
    all_logits.append(option_logits(row["text"], question, labels))
    targets.append(row["label"])

all_logits = torch.stack(all_logits)
targets = torch.tensor(targets)
Vervolgens hebben we een manier nodig om kalibratie te meten. Expected calibration error (ECE) groepeert de voorspellingen in confidence-bins en controleert hoe ver het gemiddelde vertrouwen in elke bin afligt van de werkelijke nauwkeurigheid.
Voor de duidelijkheid: lager is beter:
def expected_calibration_error(probs, targets, n_bins=10):
    confidences, predictions = probs.max(dim=-1)
    correct = (predictions == targets).float()
    bins = np.linspace(0, 1, n_bins + 1)
    ece = 0.0
    for lo, hi in zip(bins[:-1], bins[1:]):
        mask = (confidences > lo) & (confidences <= hi)
        if mask.any():
            gap = abs(correct[mask].mean() - confidences[mask].mean())
            ece += mask.float().mean() * gap
    return float(ece), float(correct.mean())
Hier komt nu de truc.
We splitsen onze data in tweeën, gebruiken de eerste helft om een temperatuur te vinden die de waarschijnlijkheden eerlijker maakt en testen dan op de tweede helft.
Een temperatuur boven 1 verzacht overzekere voorspellingen, terwijl een temperatuur onder 1 onderzekere voorspellingen aanscherpt.
calib_logits, test_logits = all_logits[:200], all_logits[200:]
calib_targets, test_targets = targets[:200], targets[200:]

def nll(temperature):
    probs = torch.softmax(calib_logits / temperature, dim=-1)
    picked = probs[torch.arange(len(calib_targets)), calib_targets]
    return -torch.log(picked + 1e-12).mean().item()

temperatures = [float(t) for t in np.linspace(0.5, 5.0, 46)]
best_t = min(temperatures, key=nll)

before = expected_calibration_error(torch.softmax(test_logits, dim=-1), test_targets)
after = expected_calibration_error(torch.softmax(test_logits / best_t, dim=-1), test_targets)

print(f"Best temperature: {best_t:.2f}")
print(f"Before: ECE={before[0]:.3f}, accuracy={before[1]:.3f}")
print(f"After:  ECE={after[0]:.3f}, accuracy={after[1]:.3f}")
De nauwkeurigheid verandert niet, omdat delen door een temperatuur nooit verandert welke optie als eerste eindigt.
Alleen het vertrouwen verandert.
Je exacte cijfers hangen af van je run, maar de ECE op de testhelft zou meestal moeten dalen. Met slechts 200 testitems is de schatting ruiserig, dus lees niet te veel in kleine verschillen.
De les is simpel: dat een model gekalibreerd is op andermans data betekent niet dat het gekalibreerd is op jouw data.
Om te laten zien hoe gebruikelijk dit “scoren, niet genereren”-idee eigenlijk is, hier hetzelfde in een RAG-setting.
Een cross-encoder scoort elke passage tegen een vraag en we sorteren ze gewoon:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L6-v2")

query = "How do I get a refund for a double charge?"
passages = [
    "Our app supports dark mode on all devices.",
    "If you were charged twice, contact billing and we will refund the duplicate payment.",
    "Refunds are processed within five business days.",
    "You can change your password from the settings page.",
]

for result in reranker.rank(query, passages):
    print(round(float(result["score"]), 3), passages[result["corpus_id"]])
Opnieuw wordt er niets gegenereerd: het model geeft elk kandidaat gewoon een getal.
Dit zijn de use-cases die het vaakst terugkomen:
| Use-case | Hoe een beslissingsmodel helpt |
|---|---|
| Agent routing | Bepaalt welke tool of sub-agent de volgende stap moet uitvoeren. |
| Guardrails | Vlagt promptinjection of onveilige content voordat het de LLM bereikt. |
| Supporttriage | Routeert tickets op team, onderwerp en urgentie. |
| Documentintake | Beantwoordt een vaste checklist met vragen over elk document. |
| Zoeken en RAG | Rerankt opgehaalde passages op relevantie. |
| Krediet en fraude | Scoren van risico, al moeten beslissingen over mensen nog steeds menselijke review bevatten. |
| Robotica | Zou kunnen fungeren als een snelle laag tussen een trage LLM-planner en low-level motorbesturing, al is dit nog speculatief. |
Het robotica-punt vind ik persoonlijk het interessantst.
Berryman suggereert dat een model als Jev kan zitten tussen een trage LLM die high-level plannen maakt en de kinematische modellen die de gewrichten van een robot bewegen.
Het is wel goed om te weten dat TypeSafes bekende Doom-demo Jev teksttelemetrie voerde in plaats van ruwe beelden.
Beslissingsmodellen zijn nuttig, maar ik wil ze niet oversellen.
Dit zijn de belangrijkste beperkingen die ik vond om in gedachten te houden:
AI-beslissingsmodellen nemen een heel oud idee van kandidaten scoren in plaats van antwoorden genereren en maken het veel makkelijker te gebruiken.
Je hebt geen trainingsdata nodig; je krijgt getypeerde antwoorden terug, en je kunt veel vragen tegelijk stellen.
Naar mijn mening is deze verpakking de echte innovatie.
Ik verwacht dat beslissingsmodellen rondom LLM’s komen te zitten als snelle, goedkope poorten die de simpele beslissingen afhandelen, zodat het dure model alleen draait wanneer er echt iets geschreven moet worden.
Topcursussen bij DataCamp
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

