
Verschillen tussen voorspellingsintervallen en betrouwbaarheidsintervallen
De twee concepten—voorspellingsintervallen en betrouwbaarheidsintervallen—zijn nauw verwant. In dezelfde analyse gebruik je vaak beide soorten intervallen. Het is daarom handig ze direct met elkaar te vergelijken.
Doel en interpretatie
Wanneer je een populatieparameter, zoals een gemiddelde, wilt weten, gebruik je een steekproef om deze parameter te schatten. Omdat de steekproefgrootte meestal veel kleiner is dan de populatie, is de schatting van de steekproef onvolmaakt. Het betrouwbaarheidsinterval is het bereik (rond de steekproefschatting) waarvan wordt verwacht dat het de populatieparameter bevat.
Regressiecoëfficiënten worden ook als populatieparameters beschouwd. Omdat ze zijn geschat op basis van een steekproef (en niet de hele populatie), zit er een foutmarge in deze parameters. Daarom kun je regressiecoëfficiënten ook met een betrouwbaarheidsinterval weergeven.
Daarnaast kun je regressie gebruiken om óf:
- De gemiddelde waarde van een afhankelijke variabele te voorspellen (zoals het gemiddelde gewicht van 2 jaar oude honden), of
- De waarde van een individuele datapun (zoals een individuele hond van 2 jaar).
Het eerste gebruikt een betrouwbaarheidsinterval, het tweede een voorspellingsinterval. Het volgende deel legt dit verschil uitgebreider uit.
Berekening en breedte van het interval
Het betrouwbaarheidsinterval voor statistische inferentie berekenen
Zoals eerder uitgelegd, is het betrouwbaarheidsinterval recht evenredig met de standaarddeviatie en omgekeerd evenredig met de steekproefgrootte. Het betrouwbaarheidsinterval van het populatiegemiddelde, 𝛍, wordt uitgedrukt als:
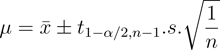
In bovenstaande uitdrukking:
- x is het steekproefgemiddelde, de schatting die je kunt meten
- 𝛍 is het populatiegemiddelde, de populatieparameter die je wilt schatten.
- n is de steekproefgrootte
- s is de standaarddeviatie van de steekproef
- t is de kritieke waarde van de t-verdeling van Student bij
- Significantieniveau van 1 - α
- n-1 vrijheidsgraden
- Je vindt t-waarden in gestandaardiseerde tabellen—google bijvoorbeeld op "Student’s T table".
Dus het bereik van 𝛍 is:
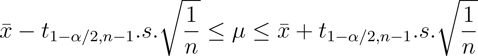
Betrouwbaarheids- en significantieniveaus begrijpen
Let ook op dat de grootte van het interval evenredig is met de t-waarde. Als je een zeer hoge mate van vertrouwen (zekerheid) wilt dat de werkelijke waarde binnen het bereik ligt, moet dat bereik groter zijn. Hoe lager het betrouwbaarheidsniveau, hoe smaller het interval. Maar een heel laag betrouwbaarheidsniveau is niet erg nuttig. In de praktijk kies je vaak 90%, 95%, 99%, enz.
Bij een betrouwbaarheidsniveau van 95% hoort een significantieniveau van 5%. Gaande van een tweezijdig interval, zoek je de kritieke t-waarde bij 2,5% (0,025).
Conceptueel worden alle intervallen als volgt uitgedrukt:

Merk op dat in alle gevallen: hoe groter de fout, hoe breder het interval. Deze fout wordt verschillend berekend afhankelijk van de toepassing. Bij inferentie is de fout de standaarddeviatie. Bij regressie wordt de fout in de volgende secties getoond.
Het betrouwbaarheidsinterval voor regressie berekenen
Wanneer je de gemiddelde waarde van de afhankelijke variabele voorspelt, schat je het bereik met het betrouwbaarheidsinterval. Bijvoorbeeld: je wilt een bereik voorspellen voor het gemiddelde gewicht van 2 jaar oude honden op basis van hun leeftijd. Dit heet het betrouwbaarheidsinterval van de gemiddelde respons. Het wordt ook als populatieparameter beschouwd, omdat het een eigenschap is van de volledige populatie. Het interval wordt uitgedrukt als:
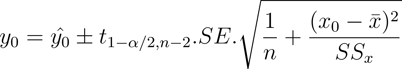
In bovenstaande uitdrukking:
- y0 is de werkelijke waarde van de voorspelde parameter.
- y0 is de waarde die is voorspeld met de regressierelatie.
- De kritieke t-waarde is in de vorige sectie uitgelegd
- n is de steekproefgrootte
- (x0 - x) is het verschil tussen de gemiddelde waarde van x en x0, waarvoor je y0 probeert te voorspellen. Merk op: hoe groter dit verschil, hoe groter het interval. Je krijgt dus smallere intervallen (en nauwkeurigere voorspellingen) voor waarden van x dicht bij het steekproefgemiddelde.
- SSx is de gekwadrateerde afwijking van de steekproef van x-waarden. Dit wordt uitgedrukt als:
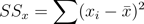
- SE is de standaardfout van de schatting. Dat is de wortel uit de mean square error (MSE). De MSE is de variantie van de fout. De SE is dus analoog aan de standaarddeviatie van de fout. De MSE is gebaseerd op de residuele fout. Deze wordt uitgedrukt als:
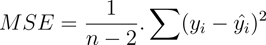
In bovenstaande uitdrukking wordt de sommatie ook wel de som van kwadraten van de residuen genoemd. Het residu is het verschil tussen de werkelijke y en de voorspelde y.
Met de MSE in plaats van de SE kan het betrouwbaarheidsinterval van de gemiddelde respons ook zo worden geschreven:
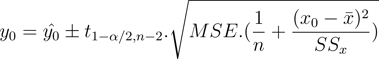
Vergelijk bovenstaande uitdrukking met de eerder getoonde conceptuele relatie.
Zie dat de fout rekening houdt met:
- Het verschil tussen de werkelijke en voorspelde waarden van y.
- Het verschil tussen de gemiddelde waarde van x en de waarde van o, waarvoor je de voorspelling wilt genereren
- De totale spreiding van x-waarden (ten opzichte van hun gemiddelde)
Het voorspellingsinterval voor regressie berekenen
Om de exacte waarde van een individuele datapun (niet het gemiddelde) te voorspellen, schat je het bereik met het voorspellingsinterval. Bijvoorbeeld: je wilt het bereik voorspellen voor het werkelijke gewicht van één specifieke hond van 2 jaar oud op basis van leeftijd. Dit is het voorspellingsinterval, en het wordt als volgt uitgedrukt:
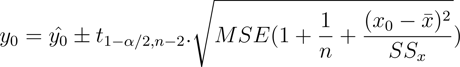
Vergelijk dit met het eerder getoonde betrouwbaarheidsinterval:
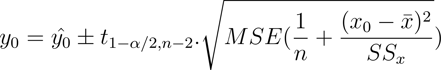
Merk op dat beide uitdrukkingen sterk op elkaar lijken. Het enige verschil is de extra foutterm in het voorspellingsinterval. Het voorspellingsinterval heeft binnen de wortel een extra MSE-term ten opzichte van het betrouwbaarheidsinterval. Dit om rekening te houden met de variabiliteit in y-waarden die je wilt voorspellen. Daardoor is het voorspellingsinterval breder dan het betrouwbaarheidsinterval.
De onderstaande schets toont de betrouwbaarheids- en voorspellingsintervallen ten opzichte van de puntschatting (voorspelde waarde).
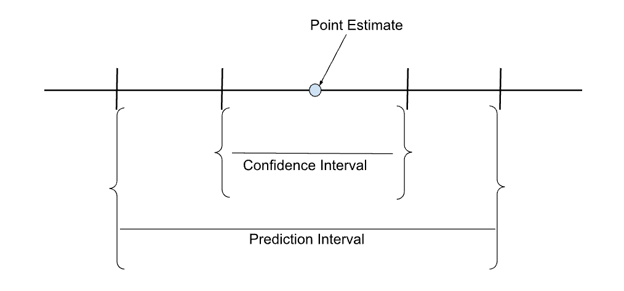
Vergelijking van betrouwbaarheids- en voorspellingsintervallen bij een puntschatting. Afbeelding door de auteur.
De schematische schets hieronder toont de intervallen ten opzichte van de regressie—merk ook op dat de intervallen het smalst zijn in de buurt van het gemiddelde.
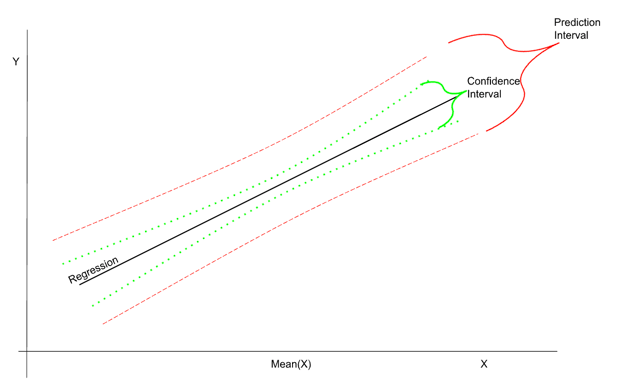
Illustratie van betrouwbaarheids- en voorspellingsintervallen in regressie. Afbeelding door de auteur.
Wanneer gebruik je een betrouwbaarheidsinterval
De vorige secties bespraken de basis van betrouwbaarheids- en voorspellingsintervallen, hun toepassingen en de formules om ze te berekenen. Dit deel geeft praktische voorbeelden van wanneer je deze intervallen gebruikt.
Een betrouwbaarheidsinterval gebruik je bij het schatten van een populatieparameter. Om de populatieparameter te schatten, kun je ofwel:
- Directe metingen doen op basis van een willekeurige steekproef
- Een regressiemodel gebruiken op basis van een willekeurige steekproef
Enkele voorbeeldtoepassingen van het betrouwbaarheidsinterval zijn:
- Een populatieparameter schatten op basis van een willekeurige steekproefmeting. Bijvoorbeeld: om de gemiddelde lengte en het gemiddelde gewicht van pasgeboren baby’s te schatten, neem je metingen van een willekeurige steekproef pasgeborenen.
- Het gedrag van een populatie schatten door een willekeurige steekproef te bestuderen. Deze toepassing is gebruikelijk in klinische proeven, waar je de effecten van een geneesmiddel op de populatie probeert te schatten door de effecten op een willekeurige steekproef te bestuderen.
- De gemiddelde respons van een afhankelijke variabele voorspellen op basis van een regressieanalyse op een willekeurige steekproef. Bijvoorbeeld: je wilt het gemiddelde gewicht van puppy’s van 55 dagen voorspellen op basis van een steekproef met puppygewichten die elke 15 dagen zijn gemeten.
- Tolerantielimieten instellen in productieprocessen. Als een machine onderdelen van een gespecificeerd gewicht produceert, heeft niet elk onderdeel exact hetzelfde gewicht als de specificatie. Het gewicht van elk onderdeel ligt binnen een betrouwbaarheidsinterval rond het gespecificeerde gewicht. Dit interval is de tolerantielimiet. Onderdelen met gewichten buiten de tolerantielimieten worden afgekeurd. De machine moet voornamelijk onderdelen binnen de tolerantielimiet produceren.
- Kwaliteitscontrole. Stel dat je wilt vaststellen of de onderdelen van een machine binnen de tolerantielimiet vallen. Het is niet mogelijk om elk onderdeel te meten. Je moet vertrouwen op willekeurige steekproeven, die meten, en vervolgens de steekproefschattingen gebruiken om de populatieparameters te beoordelen.
- Hypothesen testen. Betrouwbaarheidsniveaus en significantieniveaus zijn twee kanten van dezelfde medaille. Significantieniveau = 1 - betrouwbaarheidsniveau. Een betrouwbaarheidsinterval, met een gespecificeerd betrouwbaarheidsniveau, omvat die datapunten waarvoor de nulhypothese waar is bij een significantieniveau van (1 - het gespecificeerde betrouwbaarheidsniveau).
Wanneer gebruik je een voorspellingsinterval
Voorspellingsintervallen gebruik je wanneer je de verwachte waarde van een individuele datapun voorspelt op basis van observaties (en regressieanalyse) op een willekeurige steekproef.
Enkele praktische voorbeelden zijn:
- Het bereik van een individuele datapun voorspellen op basis van een regressieanalyse. Omdat individuele datapunten een grotere variabiliteit kunnen hebben (dan het steekproefgemiddelde), heb je een breder bereik van het voorspellingsinterval nodig. Bijvoorbeeld: je wilt het gewicht voorspellen van een individuele puppy van 55 dagen op basis van een willekeurige steekproef met puppygewichten die elke 15 dagen zijn gemeten.
- Je kunt Monte Carlo-simulaties gebruiken om de waarde van een onbekende variabele te voorspellen. Omdat Monte Carlo-methoden probabilistisch zijn, krijg je elke keer dat je het model draait een iets andere output. Deze verschillen tussen uitkomsten zitten vervat in het Monte Carlo-onzekerheidsinterval, dat conceptueel vergelijkbaar is met een voorspellingsinterval.
- In standaardregressie bouw je een relatie om de gemiddelde waarde van een parameter te voorspellen. In kwantielregressie bouw je verschillende modellen om elk kwantiel van de doelparameter te voorspellen. Dit maakt het ook mogelijk om meer genuanceerde voorspellingsintervallen te construeren.
- Machinelearningmodellen richten zich op het voorspellen van de waarde van een onbekende parameter. Deze modellen zijn doorgaans gebaseerd op statistische methoden en voorspellen dus de gemiddelde waarde van de onbekende grootheid. Daarom bevat de output van het model zowel de verwachte (gemiddelde) waarde als het voorspellingsinterval.
- Deep learning-modellen gebruiken een reeks neurale netwerken om voorspellingen te doen. Om de onzekerheid in de output te beoordelen, is het gebruikelijk om willekeurig verschillende neuronen te laten vervallen om de variabiliteit in de output te bestuderen. De variantie in deze voorspellingen wordt gebruikt om het voorspellingsinterval te construeren.
- Bij tijdreeksvoorspellingen is het doel om de waarde van een waarneembare grootheid in een toekomstige tijdstap te voorspellen. Voorspellingen zijn gebaseerd op statistische modellen zoals ARIMA, welke autoregressie uitvoert op een voortschrijdend gemiddelde. Het voorspelt dus de verwachte waarde. De werkelijke geobserveerde waarden vallen binnen een voorspellingsinterval rond de verwachte waarde. Dit voorspellingsinterval wordt berekend als functie van de standaarddeviatie. Bijvoorbeeld: bij een betrouwbaarheidsniveau van 95% ligt het voorspellingsinterval binnen 1,96 standaarddeviaties van de verwachte waarde. Verder geldt dat meerstapsvoorspellingen, met een langere voorspelhorizon, ook een groter voorspellingsinterval hebben. Wil je meer leren over tijdreeksen, bekijk dan de DataCamp cursus over tijdreeksanalyse.
Betrouwbaarheidsinterval vs. voorspellingsinterval: een samenvatting
Betrouwbaarheidsintervallen en voorspellingsintervallen worden vaak in dezelfde context gebruikt, waardoor het belangrijk is te begrijpen hoe ze verschillen.
Deze tabel vat de verschillen samen op basis van de bespreking in de vorige secties:
|
Betrouwbaarheidsinterval |
Voorspellingsinterval |
|
Gebruikt om populatieparameters te bepalen op basis van steekproefstatistieken |
Niet gebruikt om populatieparameters op basis van steekproeven te bepalen |
|
Gebruikt om de gemiddelde respons te voorspellen (gemiddelde waarde van de afhankelijke variabele voor een gegeven onafhankelijke variabele) op basis van regressies. |
Gebruikt om de toekomstige waarde te voorspellen (van een individuele datapun voor een gegeven onafhankelijke variabele) op basis van regressies. |
|
Meestal smaller binnen een gegeven analyse |
Meestal breder binnen een gegeven analyse |
Betrouwbaarheids- en voorspellingsintervallen implementeren in R
Dit deel laat hands-on voorbeelden zien van het gebruik van de programmeertaal R om betrouwbaarheids- en voorspellingsintervallen te schatten. R is ontworpen voor statistische toepassingen en wordt geleverd met ingebouwde datasets en statistische functies.
Wil je meer leren over regressies met R, volg dan de DataCamp tutorial over lineaire regressies in R.
De onderstaande voorbeelden gebruiken de ingebouwde Orange-dataset. Deze dataset volgt de omtrek (in millimeters) en leeftijd (in dagen) van sinaasappelbomen. Logischerwijs geldt: hoe ouder de boom, hoe groter de omtrek.
Betrouwbaarheidsintervallen implementeren in R
De onderstaande voorbeelden laten zien hoe je betrouwbaarheidsintervallen voor samenvattende statistieken en regressieanalyses schat.
Betrouwbaarheidsinterval bij samenvattende statistieken
Om het betrouwbaarheidsinterval voor het gemiddelde te krijgen, voer je de standaard t-toets uit met de functie t.test() op de dataset:
t.test(Orange$circumference)De output ziet eruit als in het onderstaande voorbeeld:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
96.10926 135.60502
sample estimates:
mean of x
115.8571 Je krijgt het gemiddelde en het 95%-betrouwbaarheidsinterval. Standaard gebruikt de t-toetsfunctie een betrouwbaarheidsniveau van 95%. Gebruik de parameter conf.level om een ander betrouwbaarheidsinterval te specificeren, zoals 99%.
> t.test(Orange$circumference, conf.level = 0.99)Dit commando levert de volgende output op:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
89.34458 142.36970
sample estimates:
mean of x
115.8571 Merk op dat de geschatte gemiddelde waarde in beide gevallen hetzelfde is. Maar het interval moet breder zijn om een hoger betrouwbaarheidsniveau te hebben. Op basis van de data ben ik 99% zeker dat het gemiddelde tussen 89,3 en 142,4 ligt, maar slechts 95% zeker dat het tussen 96,1 en 135,6 ligt. Voor een uit een gegeven steekproef geschatte parameter geldt: hoe smaller het betrouwbaarheidsinterval, hoe lager het betrouwbaarheidsniveau.
Betrouwbaarheidsinterval in regressie
In regressieanalyses heb je de betrouwbaarheidsintervallen nodig voor de regressiecoëfficiënten en voor voorspelde waarden.
Voor een diepgaand begrip van regressies in R, volg de DataCamp cursus Inference for Linear Regression in R.
Betrouwbaarheidsinterval van regressiecoëfficiënten
Regressiecoëfficiënten worden geschat door een willekeurige steekproef te analyseren. Ze zijn dus niet de werkelijke coëfficiënten voor de volledige populatie. De schattingen van de regressieparameters gaan gepaard met fouten. Naast hun geschatte waarden is het nuttig om een betrouwbaarheidsinterval voor de parameters te geven.
Gebruik de functie lm() om een lineair model te bouwen op basis van de Orange-dataset, om de omtrek (in mm) van sinaasappelbomen te voorspellen op basis van hun leeftijd (in dagen):
model_orange <- lm(circumference ~ age, data = Orange)Bekijk de coëfficiënten van dit lineaire model:
model_orangeDit commando toont de modelparameters (intercept en helling) zoals hieronder:
Coefficients: (Intercept) age
17.3997 0.1068 Gebruik de functie confint() om de 95%-betrouwbaarheidsintervallen te berekenen:
confint(model_orange, level = 0.95)Je ziet nu de 95%-betrouwbaarheidsintervallen van de helling en het intercept die door het model zijn geschat:
2.5 % 97.5 %
(Intercept) -0.14328303 34.9425835
age 0.08993141 0.1236092Betrouwbaarheidsinterval van een voorspelling van de gemiddelde respons
Gebruik het hierboven gemaakte regressiemodel om de verwachte gemiddelde omtrek van 900 dagen oude bomen te voorspellen. Gebruik de parameter interval om een betrouwbaarheidsinterval te specificeren.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) De output bevat de voorspelling (fit) en het betrouwbaarheidsinterval (lwr en upr voor onder- en bovengrens), zoals hieronder:
fit lwr upr
1 113.4929 105.3211 121.6647Voorspellingsintervallen implementeren in R
Gebruik hetzelfde model als hierboven om de specifieke omtrek te voorspellen van een individuele sinaasappelboom die 900 dagen oud is. Gebruik de parameter interval om aan te geven dat je het voorspellingsinterval wilt.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) De output lijkt op het onderstaande voorbeeld:
fit lwr upr
1 113.4929 64.5118 162.4741Merk op dat in beide gevallen de voorspelde omtrek hetzelfde is—113,49. Maar het voorspellingsinterval is veel breder dan het betrouwbaarheidsinterval. Het betrouwbaarheidsinterval van de voorspelling is het bereik waarvan wordt verwacht dat het de gemiddelde omtrek van 900 dagen oude bomen bevat. Het voorspellingsinterval is het verwachte bereik van de omtrek van een individuele boom van 900 dagen. Dit komt doordat er aanzienlijk meer variatie kan zijn tussen individuele bomen, wat wordt afgevlakt wanneer je naar de gemiddelde waarde kijkt.
Veelvoorkomende misvattingen en valkuilen
Statistische intervallen worden veel gebruikt in toegepaste statistische vakgebieden zoals data-analyse, farmacie, econometrie, enz. Voor wie geen academische achtergrond in statistiek heeft, is het makkelijk om betrouwbaarheidsintervallen en voorspellingsintervallen te verwarren.
Enkele veelvoorkomende misvattingen worden hieronder besproken:
- Een voorspelling doen zonder rekening te houden met het voorspellingsinterval.
- Wanneer je een regressiemodel gebruikt om de waarde van de afhankelijke variabele te voorspellen voor een gegeven waarde van de onafhankelijke variabele, geeft de regressievergelijking je de verwachte waarde van de afhankelijke variabele. De werkelijke waarde komt zelden exact overeen met de verwachte waarde, maar ligt binnen een bepaald bereik rond de verwachte waarde, zoals gespecificeerd door het voorspellingsinterval.
- Aannemen dat een regressieanalyse alleen voorspellingsintervallen omvat.
- Je doet twee soorten voorspellingen met regressiemodellen: 1) een toekomstige waarde voorspellen en 2) de gemiddelde respons voorspellen. In het sinaasappelboomvoorbeeld kun je proberen 1) de omtrek te voorspellen van een specifieke sinaasappelboom die 900 dagen oud is of 2) de gemiddelde omtrek van alle bomen die 900 dagen oud zijn. In beide gevallen is de verwachte waarde hetzelfde. Maar het eerste gebruikt het voorspellingsinterval, het tweede het betrouwbaarheidsinterval.
- Geloven dat het smallere interval het betere is.
- Je kunt soms in de verleiding komen om gewoon het smallere interval te gebruiken bij het interpreteren van een regressiestudie. Het betrouwbaarheidsinterval is niet "beter" omdat het smaller is. Het is smaller omdat het het bereik weergeeft voor iets anders dan het voorspellingsinterval. Bedenk of je het gemiddelde van de afhankelijke variabele wilt voorspellen, of een individuele datapun.
- Een betrouwbaarheidsinterval verwarren met een voorspellingsinterval.
- Als je voorspelling bestaat uit het bepalen van de waarde van een populatieparameter op basis van een steekproef of het voorspellen van de gemiddelde respons (gemiddelde waarde) uit een regressie, gebruik je het betrouwbaarheidsinterval. Als je een eigenschap van een individuele datapun probeert te voorspellen op basis van een regressie, gebruik dan het voorspellingsinterval.
Conclusie
Dit artikel gaf een overzicht van betrouwbaarheidsintervallen en voorspellingsintervallen. Het legt ook het verschil uit tussen deze gelijkklinkende concepten en biedt praktische voorbeelden van wanneer je elk type interval gebruikt. Het artikel liet ook zien hoe je voorspellings- en betrouwbaarheidsintervallen berekent met de programmeertaal R.
Wil je leren hoe je statistische formules toepast met Python, bekijk dan de DataCamp-cursus statistiek in Python. Als je je voorbereidt op sollicitaties waarin statistiek aan bod komt, bekijk dan de DataCamp-cursus statistiek-vragen voor sollicitatiegesprekken in Python.
FAQs
Waarom hebben we überhaupt intervallen nodig? Waarom is de werkelijke waarde niet gelijk aan de verwachte waarde?
We hebben intervallen nodig omdat we voor statistische analyses beperkt zijn tot het bestuderen van kleine steekproeven in plaats van de volledige populatie. De steekproefeigenschappen, die we kunnen bestuderen en voorspellen, zijn indicatief voor maar niet exact gelijk aan de populatie-eigenschappen die we willen kennen. De werkelijke waarde ligt echter binnen een bepaald interval rond de voorspelde waarde.
Kun je betrouwbaarheidsintervallen en voorspellingsintervallen door elkaar gebruiken?
Nee, ze zijn heel verschillend. Betrouwbaarheidsintervallen worden gebruikt om het bereik van een populatieparameter, zoals het gemiddelde, uit te drukken. Voorspellingsintervallen gaan over het bereik van de werkelijke waarde van een individuele datapun.
Worden betrouwbaarheidsintervallen en voorspellingsintervallen ooit in dezelfde context gebruikt?
Ja, ze worden allebei gebruikt bij regressiestudies. Je kunt ofwel de gemiddelde waarde van een datapun voorspellen (zoals het gemiddelde gewicht van 2 jaar oude honden) of je kunt het gewicht van één specifieke hond van 2 jaar voorspellen. Voor het eerste gebruik je het betrouwbaarheidsinterval. Voor het tweede het voorspellingsinterval.
Hangen betrouwbaarheids- en voorspellingsintervallen af van de steekproefgrootte?
Ja, hoe groter de steekproef, hoe beter de schatting van de populatieparameters. Dus schattingen op basis van een grotere steekproef hebben een smaller interval.
Kan ik een steekproefschatting gebruiken zonder het interval?
In principe wel. In de praktijk is het niet erg nuttig. De steekproefschatting is de "verwachte" waarde. De werkelijke waarde is zelden gelijk aan de verwachte waarde. De werkelijke waarde zal echter waarschijnlijk binnen een bereik rond de verwachte waarde liggen. Daarom is het standaardpraktijk om het interval samen met de schatting te geven. Je kunt het zonder de verwachte waarde stellen als je het juiste interval hebt.
Als je y probeert te voorspellen op basis van x, is het voorspellingsinterval dan hetzelfde voor alle x- en y-waarden? En het betrouwbaarheidsinterval?
Goede vraag. Het antwoord is nee. Hoe verder de waarde van x van de gemiddelde waarde van x afligt, hoe breder de voorspellings- en betrouwbaarheidsintervallen. De intervallen zijn het smalst wanneer de waarde van x dicht bij het gemiddelde van x ligt.



Statistische studies, of het nu gaat om het bepalen van populatieparameters of het voorspellen van afhankelijke variabelen, gaan altijd gepaard met onzekerheid. De kern van die onzekerheid is het steekproefproces. Het is onrealistisch om de volledige populatie te beschouwen bij een statistische analyse. Daarom kies je een representatieve steekproef—of je nu een populatieparameter, zoals het gemiddelde, wilt schatten of een regressiemodel wilt bouwen.
Wil je deze basis opfrissen of leren, bekijk dan de DataCamp introductiecursus statistiek.
De werkelijke waarde van de populatieparameter is meestal niet precies gelijk aan de waarde die uit de steekproef wordt geschat—dit verschil is de standaardfout. Om hiermee rekening te houden, is het gebruikelijk om een verwachte waarde te schatten en vervolgens een bereik te specificeren waarvan wordt verwacht dat het de werkelijke waarde bevat.
Op dezelfde manier zijn regressiestudies ook gebaseerd op willekeurige steekproeven in plaats van de volledige populatie. De relatie tussen de afhankelijke en onafhankelijke variabelen, zoals geschat door de regressiestudie op de steekproef, is niet exact gelijk aan de werkelijke relatie tussen die variabelen in de gehele populatie. De voorspelde waarde van een individuele datapun is dus niet precies gelijk aan de werkelijke waarde. De werkelijke waarde wordt verwacht binnen een bepaald interval rond de voorspelde waarde te liggen.
Dit artikel legt de betekenis uit van beide typen intervallen en de onderliggende wiskundige methoden om ze te berekenen. Het bespreekt praktische voorbeelden van wanneer je elk interval gebruikt. Tot slot laat het met hands-on voorbeelden zien hoe je betrouwbaarheids- en voorspellingsintervallen in de programmeertaal R berekent.
Wat is een betrouwbaarheidsinterval?
Een betrouwbaarheidsinterval is het bereik waarvan—met een bepaald betrouwbaarheidsniveau—wordt verwacht dat het de werkelijke waarde van een populatieparameter, zoals het populatiegemiddelde, bevat.
Betrouwbaarheidsintervallen in statistische inferentie
Een populatieparameter is een numerieke eigenschap van de volledige populatie. Het gemiddelde (van de volledige populatie) is een voorbeeld van een populatieparameter. De werkelijke waarde van de regressiecoëfficiënten tussen twee variabelen is een ander voorbeeld. Inferentiële statistiek gaat over het bestuderen van de datapunten in een willekeurige steekproef om een populatieparameter te schatten.
Stel, hypothetisch, dat je hovenier of sinaasappelteler bent en wilt weten hoe dik sinaasappelbomen worden als ze 100 dagen oud zijn. Het is onmogelijk om elke afzonderlijke sinaasappelboom van 100 dagen oud te bestuderen. Dus selecteer je willekeurig een aantal bomen van 100 dagen en meet je hun omtrek (dikte). Het gemiddelde van deze metingen geeft je het steekproefgemiddelde. Je wilt dit steekproefgemiddelde gebruiken om het populatiegemiddelde te benaderen.
Een populatie sinaasappelbomen. Gemaakt met DALL-E.
Het steekproefgemiddelde is een puntschatting voor de populatieparameter (in dit geval is het gemiddelde de parameter van belang). Deze DataCamp cursus over inferentiële statistiek bespreekt deze concepten uitgebreider.
Het steekproefgemiddelde is representatief voor het populatiegemiddelde, maar er niet exact aan gelijk. Het populatiegemiddelde wordt verwacht binnen een bepaald interval rond het steekproefgemiddelde te liggen; dat is het betrouwbaarheidsinterval.
Betrouwbaarheidsintervallen in regressie
In het vorige deel zijn betrouwbaarheidsintervallen in inferentiële statistiek uitgelegd. Ook in regressie maak je gebruik van betrouwbaarheidsintervallen.
Neem als voorbeeld een variant op het sinaasappelboomscenario:
Dit doe je met een regressieanalyse. De dataset waarop je de regressie draait, is gebaseerd op een steekproef van sinaasappelbomen. Dus het geschatte steekproefgemiddelde (gemiddelde omtrek van 100 dagen oude bomen) zal niet exact gelijk zijn aan het populatiegemiddelde. De werkelijke waarde van het populatiegemiddelde ligt binnen een betrouwbaarheidsinterval rond het geschatte steekproefgemiddelde.
In latere secties zie je de wiskundige formules voor het betrouwbaarheidsinterval en worden ze uitgelegd.
Wat is een voorspellingsinterval?
Een voorspellingsinterval is het bereik waarvan—met een bepaald betrouwbaarheidsniveau—wordt verwacht dat het de werkelijke waarde van een individuele datapun bevat, gebaseerd op een voorspelling met een regressieanalyse.
Beschouw een andere variant op het eerder genoemde regressievoorbeeld:
Je gebruikt dezelfde regressieformule als eerder. De geschatte waarde (d.w.z. de verwachte waarde) van de individuele omtrek is dezelfde als de geschatte gemiddelde omtrek. Maar je moet rekening houden met de grotere variabiliteit van individuele datapunten, omdat je een individuele waarde voorspelt (en niet een gemiddelde). Daarom is het voorspellingsinterval groter dan het betrouwbaarheidsinterval.
Later in het artikel zie je de formules voor deze intervallen en leer je hoe je R gebruikt om ze te berekenen.