Kurs
Einführung in die Statistik in Python
4 Std.
197K
Statistische Untersuchungen – ob zur Bestimmung von Populationsparametern oder zur Vorhersage abhängiger Variablen – gehen immer mit Unsicherheit einher. Ursache ist die Stichprobenziehung. Es ist unrealistisch, bei einer statistischen Analyse die gesamte Grundgesamtheit zu betrachten. Daher wählst du eine repräsentative Stichprobe – sei es, um einen Populationsparameter wie den Mittelwert zu schätzen oder um ein Regressionsmodell zu erstellen.
Zum Auffrischen der Grundlagen schau dir den DataCamp Einführungskurs in die Statistik an.
Der wahre Wert des Populationsparameters entspricht in der Regel nicht exakt dem aus der Stichprobe geschätzten Wert – diese Abweichung ist der Standardfehler. Um diesen Fehler abzubilden, ist es üblich, einen Erwartungswert zu schätzen und anschließend einen Bereich anzugeben, der den tatsächlichen Wert mit einer gewissen Wahrscheinlichkeit enthält.
Ähnlich basieren auch Regressionsstudien auf Zufallsstichproben statt auf der gesamten Population. Die Beziehung zwischen abhängiger und unabhängiger Variable, wie sie in der Stichprobe per Regression geschätzt wird, entspricht nicht exakt der „wahren“ Beziehung in der Gesamtpopulation. Entsprechend ist der vorhergesagte Wert eines einzelnen Datenpunkts nicht genau gleich seinem wahren Wert. Der wahre Wert wird innerhalb eines Intervalls um den vorhergesagten Wert erwartet.
Dieser Artikel erklärt die Bedeutung beider Intervalltypen und die zugrunde liegenden mathematischen Verfahren zu ihrer Berechnung. Er zeigt praxisnahe Beispiele, wann welches Intervall eingesetzt wird. Abschließend demonstrieren Hands-on-Beispiele, wie du Konfidenz- und Vorhersageintervalle in der Programmiersprache R berechnest.
Ein Konfidenzintervall ist der Bereich, der – mit einer gewählten Sicherheit – den wahren Wert eines Populationsparameters (etwa den Populationsmittelwert) enthält.
Ein Populationsparameter ist eine numerische Eigenschaft der gesamten Grundgesamtheit. Der Mittelwert (der gesamten Population) ist ein Beispiel dafür. Die wahren Regressionskoeffizienten zwischen zwei Variablen sind ein weiteres Beispiel. Schließende Statistik bedeutet, anhand einer Zufallsstichprobe Populationsparameter zu schätzen.
Angenommen, du bist Obstbauingenieurin oder Orangenfarmer und möchtest wissen, wie dick Orangenbäume mit 100 Tagen sind. Es ist unmöglich, jeden einzelnen 100 Tage alten Baum zu messen. Also wählst du zufällig einige 100-Tage-Bäume aus und misst ihren Umfang (Dicke). Der Durchschnitt dieser Messungen ist der Stichprobenmittelwert. Diesen willst du nutzen, um den Populationsmittelwert zu schätzen.
Eine Population von Orangenbäumen. Erstellt mit DALL-E.
Der Stichprobenmittelwert ist eine Punktschätzung für den Populationsparameter (hier: der Mittelwert). Dieser DataCamp Kurs zu Inferenzstatistik geht näher darauf ein.
Der Stichprobenmittelwert repräsentiert den Populationsmittelwert, ist ihm aber nicht exakt gleich. Der Populationsmittelwert wird in einem bestimmten Intervall um den Stichprobenmittelwert erwartet – dem Konfidenzintervall.
Im vorherigen Abschnitt ging es um Konfidenzintervalle in der Inferenzstatistik. Auch in der Regression spielen sie eine Rolle.
Betrachten wir eine Abwandlung des Orangenbaum-Beispiels:
Dafür nutzt du eine Regressionsanalyse. Der Datensatz dafür basiert auf einer Stichprobe von Orangenbäumen. Daher entspricht der geschätzte Stichprobenmittelwert (durchschnittlicher Umfang 100 Tage alter Bäume) nicht exakt dem Populationsmittelwert. Der wahre Populationsmittelwert liegt innerhalb eines Konfidenzintervalls um den geschätzten Stichprobenmittelwert.
Spätere Abschnitte zeigen und erklären die mathematischen Ausdrücke für das Konfidenzintervall.
Ein Vorhersageintervall ist der Bereich, der – mit einer gewählten Sicherheit – den wahren Wert eines einzelnen Datenpunkts enthält, basierend auf einer Vorhersage mittels Regressionsanalyse.
Betrachten wir erneut eine Abwandlung des obigen Regressionsbeispiels:
Du verwendest dieselbe Regressionsformel wie zuvor. Der geschätzte (erwartete) Wert für den individuellen Umfang ist identisch mit dem geschätzten Mittelwert. Da du jedoch einen Einzelwert vorhersagst (und nicht einen Durchschnitt), musst du die höhere Variabilität einzelner Punkte berücksichtigen. Daher ist das Vorhersageintervall größer als das Konfidenzintervall.
Weiter unten siehst du die Formeln für diese Intervalle und lernst, wie du sie in R berechnest.
Beide Konzepte – Vorhersageintervall und Konfidenzintervall – sind eng verwandt. Oft kommen in derselben Analyse beide Arten von Intervallen zum Einsatz. Ein Direktvergleich ist daher hilfreich.
Wenn du einen Populationsparameter wie den Mittelwert kennen möchtest, nutzt du eine Stichprobe, um ihn zu schätzen. Da die Stichprobe typischerweise viel kleiner ist als die Population, ist die Schätzung unvollkommen. Das Konfidenzintervall ist der Bereich um die Stichprobenschätzung, der den Populationsparameter voraussichtlich enthält.
Auch Regressionskoeffizienten sind Populationsparameter. Weil sie auf einer Stichprobe (und nicht der gesamten Population) beruhen, enthalten sie Schätzfehler. Daher lassen sich auch Regressionskoeffizienten mit einem Konfidenzintervall angeben.
Mithilfe von Regressionen kannst du außerdem Folgendes vorhersagen:
Für Ersteres nutzt du ein Konfidenzintervall, für Letzteres ein Vorhersageintervall. Der nächste Abschnitt vertieft diesen Unterschied.
Wie erläutert, ist die Intervallbreite proportional zur Standardabweichung und umgekehrt proportional zur Stichprobengröße. Das Konfidenzintervall des Populationsmittelwerts 𝛍 lautet:
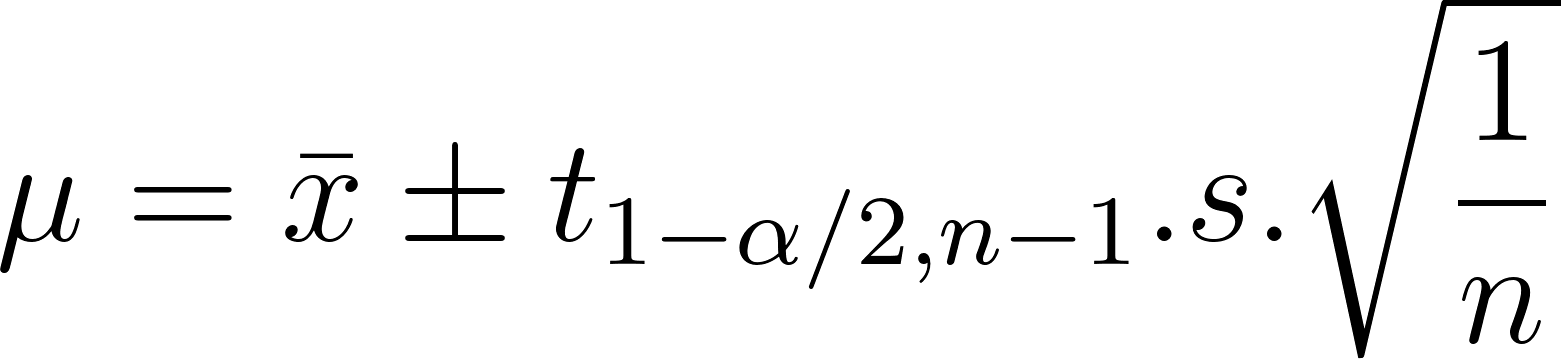
Dabei gilt:
Damit ergibt sich für 𝛍 der Bereich:
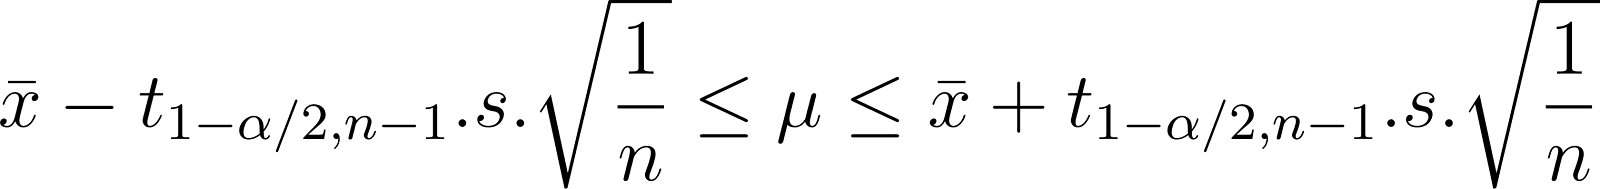
Beachte, dass die Intervallbreite proportional zum t-Wert ist. Wenn du eine sehr hohe Sicherheit willst, dass der wahre Wert im angegebenen Bereich liegt, muss dieser Bereich groß sein. Je niedriger das Konfidenzniveau, desto schmaler das Intervall. Ein zu niedriges Konfidenzniveau ist jedoch wenig nützlich. In der Praxis sind 90 %, 95 %, 99 % etc. üblich.
Ein Konfidenzniveau von 95 % entspricht einem Signifikanzniveau von 5 %. Bei einem zweiseitigen Intervall benötigst du den kritischen t-Wert bei 2,5 % (0,025).
Konzeptionell lassen sich alle Intervalle wie folgt ausdrücken:

Je größer der Fehlerterm, desto breiter das Intervall. Dieser Fehler wird je nach Anwendungsfall unterschiedlich berechnet. Für Inferenz ist es die Standardabweichung. Für Regression zeigt der nächste Abschnitt den Fehlerterm.
Wenn du den durchschnittlichen Wert der abhängigen Variable vorhersagen willst, schätzt du dessen Bereich über das Konfidenzintervall. Beispiel: Du möchtest den durchschnittlichen Gewichtsbereich 2-jähriger Hunde basierend auf ihrem Alter vorhersagen. Das ist das Konfidenzintervall der mittleren Antwort (mean response). Es ist ebenfalls ein Populationsparameter, da es eine Eigenschaft der gesamten Population ist. Das Intervall lautet:
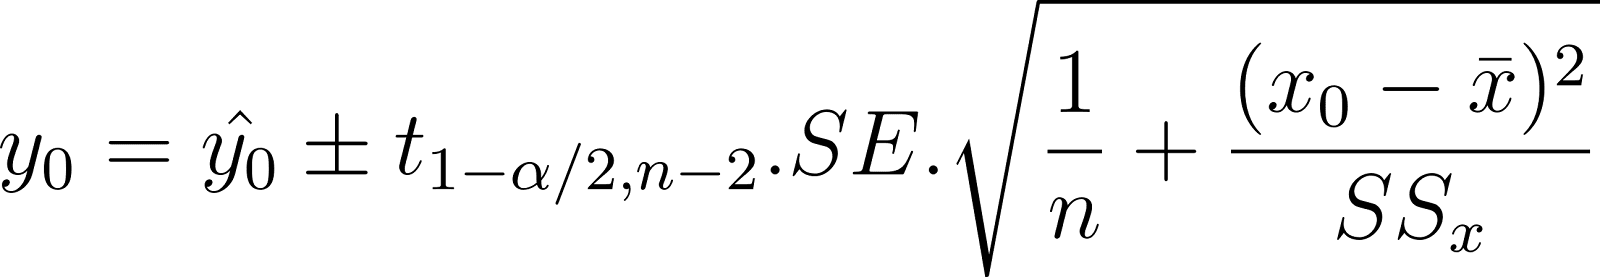
Darin gilt:


Die Summe in der Formel heißt auch Summe der quadrierten Residuen. Das Residuum ist die Differenz zwischen dem wahren y-Wert und dem vorhergesagten y-Wert.
Unter Verwendung des MSE statt SE kann das Konfidenzintervall der mittleren Antwort auch so geschrieben werden:
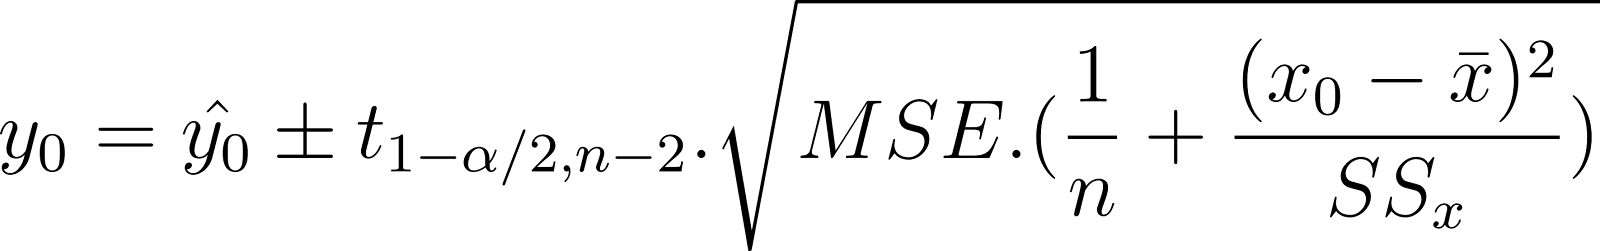
Vergleiche den obigen Ausdruck mit der zuvor gezeigten konzeptionellen Beziehung.
Der Fehlerterm berücksichtigt:
Um den exakten Wert eines einzelnen Datenpunkts (nicht den Durchschnitt) vorherzusagen, nutzt du das Vorhersageintervall. Beispiel: Du möchtest den Gewichtsbereich eines bestimmten 2-jährigen Hundes basierend auf dem Alter schätzen. Das Vorhersageintervall lautet:
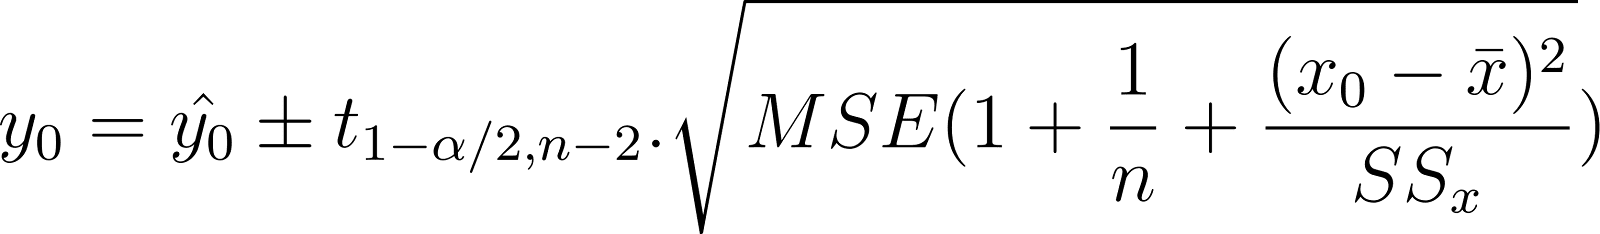
Zum Vergleich das zuvor gezeigte Konfidenzintervall:
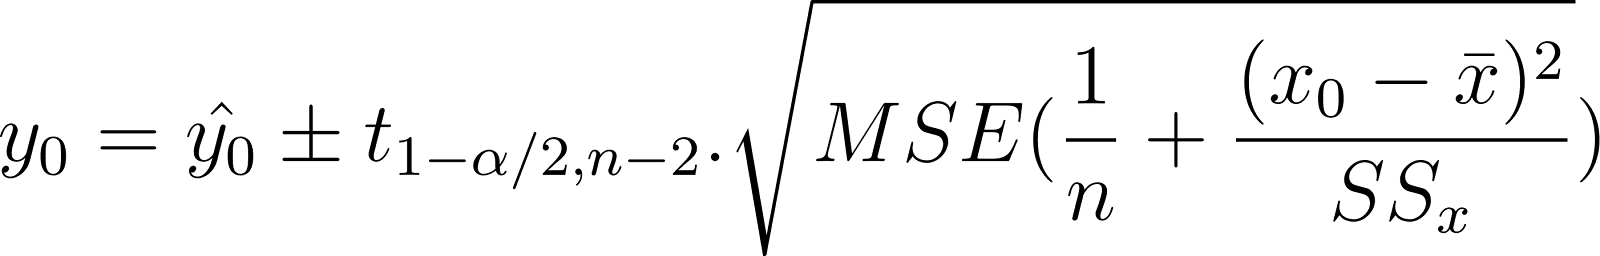
Beide Ausdrücke sind sehr ähnlich. Der einzige Unterschied ist der zusätzliche Fehlerterm im Vorhersageintervall. Das Vorhersageintervall enthält unter der Wurzel einen zusätzlichen MSE-Term gegenüber dem Konfidenzintervall. Damit wird die Variabilität in den y-Werten berücksichtigt, die du vorhersagen willst. Dadurch ist das Vorhersageintervall breiter als das Konfidenzintervall.
Die Skizze unten zeigt Konfidenz- und Vorhersageintervalle im Verhältnis zur Punktschätzung (Prognosewert).
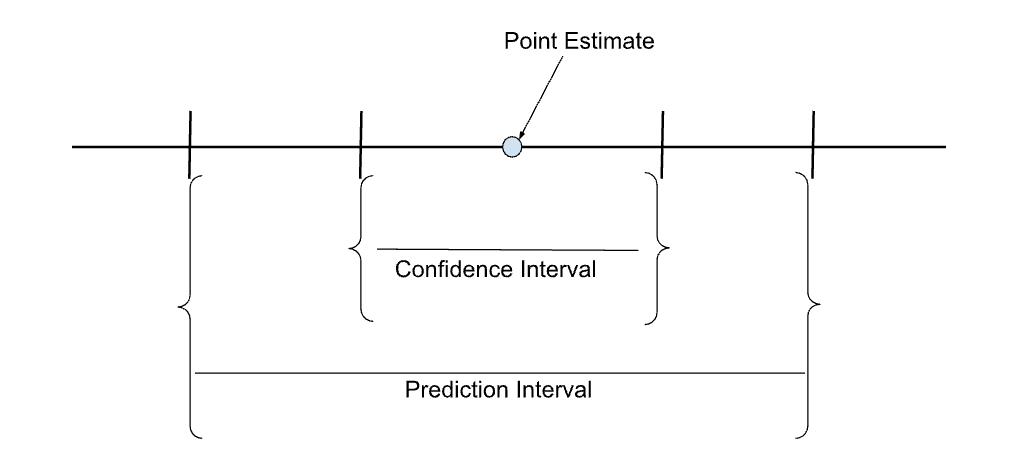
Vergleich von Konfidenz- und Vorhersageintervall einer Punktschätzung. Bild: Autor.
Die schematische Darstellung unten zeigt die Intervalle entlang der Regressionsgeraden – beachte, dass sie in der Nähe des Mittelwerts am schmalsten sind.
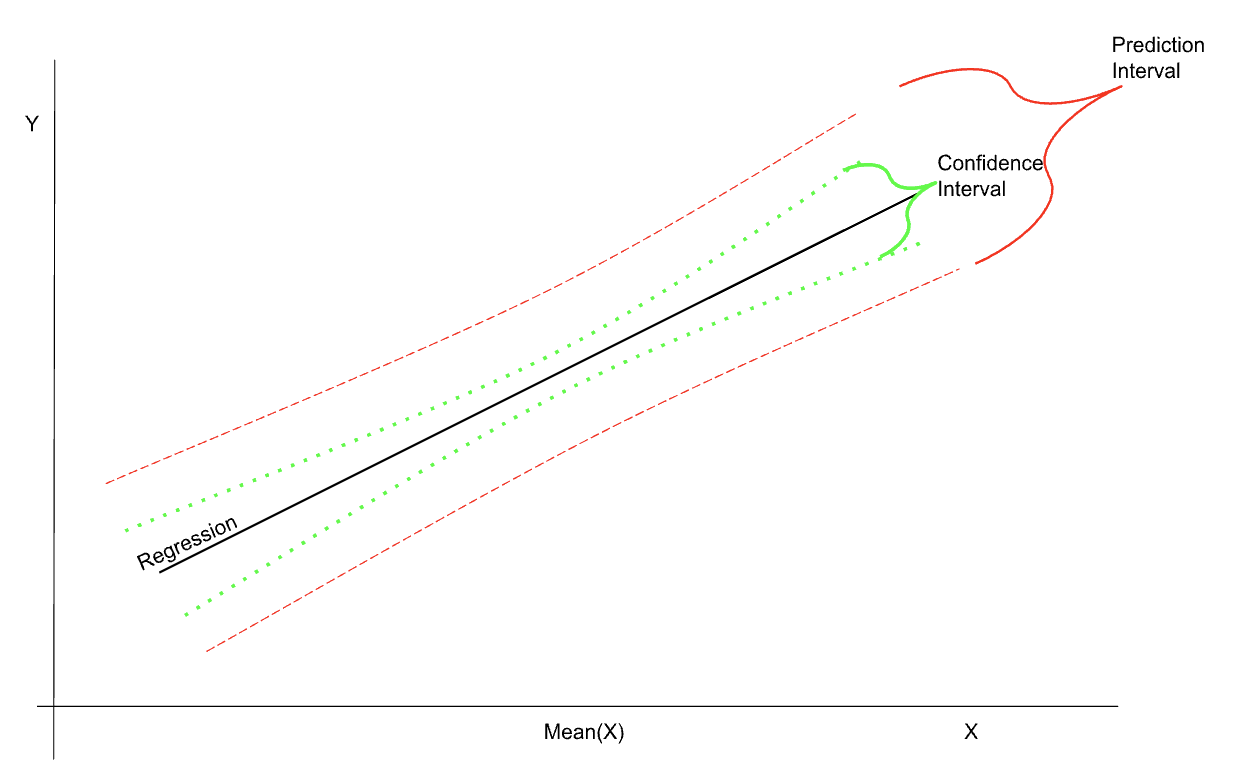
Illustration von Konfidenz- und Vorhersageintervallen in der Regression. Bild: Autor.
Zuvor wurden Grundlagen, Einsatzzwecke und Formeln für Konfidenz- und Vorhersageintervalle erläutert. Hier folgen praktische Beispiele, wann welches Intervall sinnvoll ist.
Ein Konfidenzintervall nutzt du, wenn du einen Populationsparameter schätzt. Zur Schätzung kannst du entweder:
Beispielhafte Anwendungsfälle für Konfidenzintervalle:
Vorhersageintervalle nutzt du, wenn du den erwarteten Wert eines einzelnen Datenpunkts vorhersagst – basierend auf Beobachtungen und einer Regressionsanalyse einer Zufallsstichprobe.
Praktische Beispiele:
Konfidenz- und Vorhersageintervalle werden oft im selben Kontext verwendet. Umso wichtiger ist es, ihren Unterschied zu verstehen.
Die folgende Tabelle fasst die Unterschiede basierend auf den vorherigen Abschnitten zusammen:
|
Konfidenzintervall |
Vorhersageintervall |
|
Wird genutzt, um Populationsparameter auf Basis von Stichprobenstatistiken zu bestimmen |
Wird nicht zur Bestimmung von Populationsparametern aus Stichproben genutzt |
|
Dient dazu, die mittlere Antwort (Durchschnittswert der abhängigen Variable für einen gegebenen x-Wert) per Regression vorherzusagen. |
Dient dazu, den zukünftigen Wert eines einzelnen Datenpunkts (für einen gegebenen x-Wert) per Regression vorherzusagen. |
|
Für eine gegebene Analyse meist schmaler |
Für eine gegebene Analyse meist breiter |
Dieser Abschnitt zeigt praktische Beispiele, wie du in R Konfidenz- und Vorhersageintervalle berechnest. R ist für statistische Anwendungen entwickelt worden und bringt eingebaute Datensätze und Funktionen mit.
Mehr zu Regressionen mit R erfährst du im DataCamp Tutorial zu linearen Regressionen in R.
Die folgenden Beispiele nutzen den eingebauten Orange Datensatz. Er enthält Umfang (in Millimetern) und Alter (in Tagen) von Orangenbäumen. Naheliegend ist: Je älter der Baum, desto größer sein Umfang.
Die folgenden Beispiele zeigen Konfidenzintervalle für deskriptive Statistiken und Regressionsanalysen.
Um das Konfidenzintervall für den Mittelwert zu erhalten, führst du einen Standard-t-Test mit der Funktion t.test() auf dem Datensatz aus:
t.test(Orange$circumference)Die Ausgabe sieht beispielsweise so aus:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
   96.10926 135.60502
sample estimates:
mean of x
   115.8571
Du erhältst die Schätzung des Mittelwerts und das 95%-Konfidenzintervall. Standardmäßig nutzt t.test() 95 % Konfidenz. Über den Parameter conf.level kannst du z. B. 99 % angeben.
> t.test(Orange$circumference, conf.level = 0.99)Diese Anweisung liefert etwa:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
   89.34458 142.36970
sample estimates:
mean of x
   115.8571
Der geschätzte Mittelwert ist in beiden Fällen gleich. Für ein höheres Konfidenzniveau muss das Intervall jedoch breiter sein. Auf Basis der Daten bin ich zu 99 % sicher, dass der Mittelwert zwischen 89,3 und 142,4 liegt, aber nur zu 95 % sicher, dass er zwischen 96,1 und 135,6 liegt. Für eine gegebene Stichprobe gilt: Je schmaler das Intervall, desto geringer das Konfidenzniveau.
In Regressionsanalysen benötigst du Konfidenzintervalle für Regressionskoeffizienten und Vorhersagen.
Für ein tieferes Verständnis von Regressionen in R folge dem DataCamp Kurs Inference for Linear Regression in R.
Regressionskoeffizienten werden anhand einer Zufallsstichprobe geschätzt und sind daher keine „wahren“ Koeffizienten für die Gesamtpopulation. Die Schätzungen sind mit Fehlern behaftet. Zusätzlich zu den Punktschätzungen ist es hilfreich, Konfidenzintervalle für die Parameter anzugeben.
Erstelle mit lm() ein lineares Modell auf Basis des Orange-Datensatzes, um den Umfang (mm) von Orangenbäumen anhand des Alters (Tage) vorherzusagen:
model_orange <- lm(circumference ~ age, data = Orange)Prüfe die Koeffizienten des linearen Modells:
model_orangeDer Befehl zeigt Achsenabschnitt und Steigung:
Coefficients: (Intercept)          age
                              17.3997       0.1068
Mit confint() berechnest du die 95%-Konfidenzintervalle:
confint(model_orange, level = 0.95)Du siehst nun die 95%-Konfidenzintervalle für Steigung und Achsenabschnitt:
                          2.5 %                   97.5 %
(Intercept)     -0.14328303       34.9425835
age 0.08993141 0.1236092Nutze das oben erstellte Regressionsmodell, um den erwarteten durchschnittlichen Umfang 900 Tage alter Bäume vorherzusagen. Gib über den Parameter interval das Konfidenzintervall an.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) Die Ausgabe enthält die Vorhersage (fit) sowie untere und obere Grenze (lwr, upr):
       fit                    lwr              upr
1 113.4929 105.3211 121.6647Nutze dasselbe Modell, um den konkreten Umfang eines einzelnen 900 Tage alten Orangenbaums vorherzusagen. Verwende den Parameter interval, um das Vorhersageintervall zu wählen.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) Die Ausgabe ähnelt diesem Beispiel:
       fit                    lwr              upr
1      113.4929        64.5118        162.4741
In beiden Fällen ist der vorhergesagte Umfang gleich – 113,49. Das Vorhersageintervall ist jedoch deutlich breiter als das Konfidenzintervall. Das Konfidenzintervall der Vorhersage beschreibt den Bereich, in dem der durchschnittliche Umfang 900 Tage alter Bäume erwartet wird. Das Vorhersageintervall beschreibt den erwarteten Bereich für den Umfang eines einzelnen 900 Tage alten Baums. Einzelwerte variieren stärker, was sich im Mittel glättet.
Statistische Intervalle sind in angewandten Feldern wie Datenanalyse, Pharma, Ökonometrie usw. weit verbreitet. Ohne formalen Statistik-Hintergrund lassen sich Konfidenz- und Vorhersageintervalle leicht verwechseln.
Einige verbreitete Missverständnisse sind:
Dieser Artikel gab einen Überblick über Konfidenz- und Vorhersageintervalle, erklärte die Unterschiede und zeigte praxisnahe Einsatzfälle. Außerdem hast du gesehen, wie du Vorhersage- und Konfidenzintervalle in R berechnest.
Wenn du statistische Formeln mit Python anwenden möchtest, sieh dir den DataCamp Kurs Statistik in Python an. Und falls du dich auf Bewerbungen mit Statistik-Fokus vorbereitest, schau dir den DataCamp Kurs zu Statistik-Fragen im Vorstellungsgespräch in Python an.
Lerne mehr über Statistik und Data Science mit diesen Kursen!
Kurs
Kurs
Kurs