
Perbedaan Antara Interval Prediksi dan Interval Kepercayaan
Kedua konsep—interval prediksi dan interval kepercayaan—sangat terkait. Analisis yang sama sering kali melibatkan penggunaan kedua jenis interval. Jadi, membandingkannya secara langsung akan membantu.
Tujuan dan interpretasi
Ketika Anda perlu mengetahui parameter populasi, seperti mean, Anda menggunakan sampel untuk mengestimasi parameter ini. Karena ukuran sampel biasanya jauh lebih kecil daripada populasi, estimasi parameter dari sampel tidak sempurna. Interval kepercayaan adalah rentang (dari estimasi sampel) yang diharapkan memuat parameter populasi.
Koefisien regresi juga dianggap sebagai parameter populasi. Karena diestimasi berdasarkan sampel (dan bukan seluruh populasi), terdapat galat pada parameter-parameter ini. Maka, koefisien regresi juga dapat dinyatakan dengan interval kepercayaan.
Selain itu, Anda dapat menggunakan regresi untuk memprediksi salah satu dari:
- Nilai rata-rata variabel dependen (seperti berat rata-rata anjing berusia 2 tahun) atau
- Nilai satu titik data individual (seperti satu anjing berusia 2 tahun).
Yang pertama menggunakan interval kepercayaan, dan yang kedua menggunakan interval prediksi. Bagian berikut menjelaskan perbedaan ini secara lebih rinci.
Perhitungan dan lebar interval
Menghitung interval kepercayaan untuk inferensi statistik
Seperti dijelaskan sebelumnya, interval kepercayaan berbanding lurus dengan simpangan baku dan berbanding terbalik dengan ukuran sampel. Interval kepercayaan dari mean populasi, 𝛍, dinyatakan sebagai:
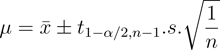
Pada ekspresi di atas:
- x adalah mean sampel, estimasi yang dapat Anda ukur
- 𝛍 adalah mean populasi, parameter populasi yang ingin Anda estimasi.
- n adalah ukuran sampel
- s adalah simpangan baku sampel
- t adalah nilai kritis dari distribusi T-Student pada
- Tingkat signifikansi 1 - α
- n-1 derajat kebebasan
- Anda dapat menemukan nilai T dari tabel standar—cukup cari “Student’s T table.”
Dengan demikian, rentang 𝛍 adalah:
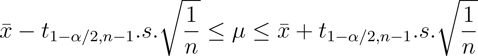
Memahami tingkat kepercayaan dan tingkat signifikansi
Perhatikan juga bahwa ukuran interval berbanding lurus dengan nilai t. Jika Anda menginginkan derajat kepercayaan (kepastian) yang sangat tinggi bahwa nilai sebenarnya berada dalam rentang yang diberikan, maka rentang itu harus sangat besar. Semakin rendah derajat kepercayaan, semakin sempit intervalnya. Namun, derajat kepercayaan yang sangat rendah tidak terlalu berguna. Jadi, dalam praktik, lazim memilih tingkat kepercayaan 90%, 95%, 99%, dll.
Jika Anda memiliki tingkat kepercayaan 95%, itu menghasilkan tingkat signifikansi 5%. Dengan asumsi interval dua sisi, Anda perlu mencari nilai kritis t pada 2,5% (0,025).
Secara konseptual, semua interval dinyatakan sebagai berikut:

Perhatikan bahwa dalam semua kasus, semakin besar galatnya, semakin lebar intervalnya. Galat ini dihitung berbeda-beda tergantung kasus penggunaan. Untuk inferensi, galatnya adalah simpangan baku. Untuk regresi, galatnya ditunjukkan pada bagian berikutnya.
Menghitung interval kepercayaan untuk regresi
Ketika Anda memprediksi nilai rata-rata variabel dependen, Anda memperkirakan rentangnya menggunakan interval kepercayaan. Misalnya, Anda ingin memprediksi rentang berat rata-rata anjing berusia 2 tahun berdasarkan usianya. Ini disebut interval kepercayaan dari respons mean. Ini juga dianggap sebagai parameter populasi karena merupakan sifat dari seluruh populasi. Intervalnya dinyatakan sebagai:
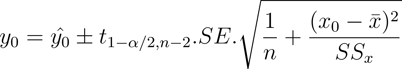
Pada ekspresi di atas:
- y0 adalah nilai sebenarnya dari parameter yang diprediksi.
- y0 adalah nilai yang diprediksi menggunakan hubungan regresi.
- Nilai kritis t dijelaskan pada bagian sebelumnya
- n adalah ukuran sampel
- (x0 - x) adalah selisih antara nilai rata-rata x dan x0, untuk mana Anda mencoba memprediksi y0. Perhatikan bahwa semakin besar perbedaan ini, semakin besar intervalnya. Jadi, Anda memperoleh interval yang sempit (dan prediksi yang lebih akurat) untuk nilai x yang dekat dengan rata-rata sampel.
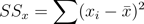
- SSx adalah penyimpangan kuadrat dari sampel nilai x. Ini dinyatakan sebagai:
- SE adalah galat baku estimasi. Ini adalah akar kuadrat dari mean square error (MSE). MSE adalah varians dari galat. Jadi, SE analog dengan simpangan baku dari galat. MSE didasarkan pada galat residual. Ini dinyatakan sebagai:
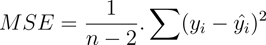
Pada ekspresi di atas, suku penjumlahan juga disebut jumlah kuadrat residual. Residual adalah selisih antara nilai sebenarnya y dan nilai y yang diprediksi.
Dengan menggunakan MSE alih-alih SE, interval kepercayaan dari respons mean juga dapat dituliskan sebagai:
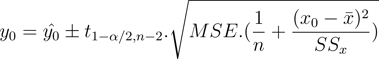
Bandingkan ekspresi di atas dengan relasi konseptual yang ditunjukkan sebelumnya.
Perhatikan bahwa galat memperhitungkan:
- Perbedaan antara nilai aktual dan prediksi dari y.
- Perbedaan antara nilai rata-rata x dan nilai xo, untuk mana Anda ingin menghasilkan prediksi
- Sebaran keseluruhan nilai x (relatif terhadap mean-nya)
Menghitung interval prediksi untuk regresi
Untuk memprediksi nilai tepat dari satu titik data individual (bukan rata-rata), Anda memperkirakan rentangnya menggunakan interval prediksi. Misalnya, Anda ingin memprediksi rentang berat sebenarnya dari satu anjing berusia 2 tahun berdasarkan usia. Ini disebut interval prediksi, dan dinyatakan sebagai:
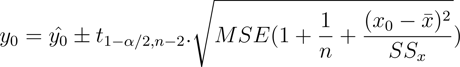
Bandingkan ini dengan interval kepercayaan yang ditunjukkan sebelumnya:
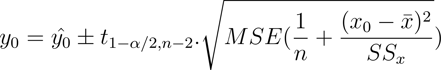
Perhatikan bahwa kedua ekspresi sangat mirip. Satu-satunya perbedaan adalah tambahan suku galat pada interval prediksi. Interval prediksi memiliki satu suku MSE tambahan di dalam akar kuadrat dibandingkan interval kepercayaan. Ini untuk memperhitungkan variabilitas pada nilai y yang ingin Anda prediksi. Hal ini membuat interval prediksi lebih lebar daripada interval kepercayaan.
Sketsa berikut menunjukkan interval kepercayaan dan prediksi terhadap estimasi titik (nilai prediksi).
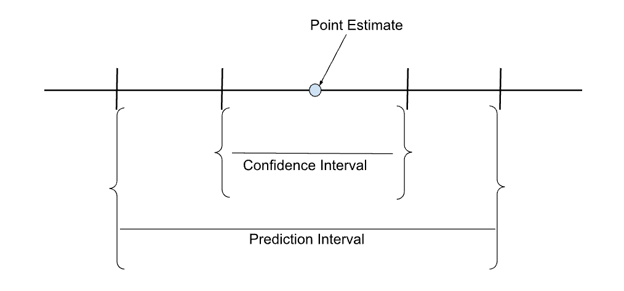
Membandingkan interval kepercayaan dan prediksi dari estimasi titik. Gambar oleh penulis.
Sketsa skematis di bawah menunjukkan interval kepercayaan dan prediksi terhadap regresi—perhatikan juga bahwa interval paling sempit berada di sekitar wilayah mean.
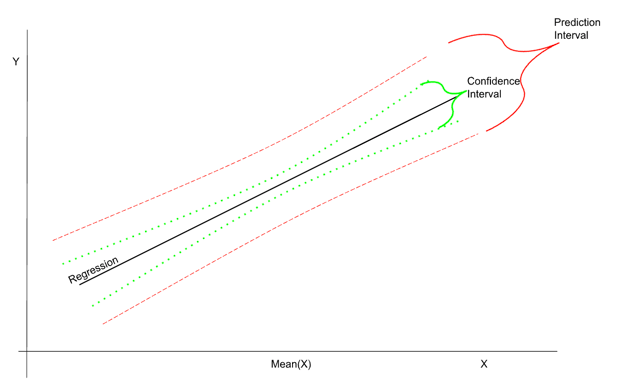
Ilustrasi interval kepercayaan dan prediksi dalam regresi. Gambar oleh penulis.
Kapan Menggunakan Interval Kepercayaan
Bagian sebelumnya membahas dasar-dasar interval kepercayaan dan prediksi, kegunaannya, dan rumus untuk menghitungnya. Bagian ini memberikan contoh praktis kapan menggunakan interval kepercayaan dan interval prediksi.
Interval kepercayaan digunakan saat memperkirakan parameter populasi. Untuk memperkirakan parameter populasi, Anda dapat:
- Menggunakan pengukuran langsung berdasarkan sampel acak
- Menggunakan model regresi berdasarkan sampel acak
Beberapa contoh kasus penggunaan interval kepercayaan adalah:
- Mengestimasi parameter populasi berdasarkan pengukuran sampel acak. Misalnya, untuk memperkirakan tinggi dan berat rata-rata bayi baru lahir, Anda melakukan pengukuran pada sampel acak bayi baru lahir.
- Mengestimasi perilaku populasi dengan mempelajari sampel acak. Kasus penggunaan ini umum dalam uji klinis, di mana Anda mencoba memperkirakan efek obat pada populasi dengan mempelajari efeknya pada sampel acak.
- Memprediksi respons mean dari variabel dependen berdasarkan analisis regresi pada sampel acak. Misalnya, Anda ingin memprediksi berat rata-rata anak anjing berusia 55 hari berdasarkan sampel berat anak anjing yang diukur setiap 15 hari.
- Menetapkan batas toleransi dalam proses manufaktur. Misalnya, jika sebuah mesin memproduksi komponen dengan spesifikasi berat tertentu, tidak setiap komponen memiliki berat persis seperti spesifikasi. Berat tiap komponen berada dalam interval kepercayaan dari berat spesifikasi. Interval ini adalah batas toleransi. Komponen dengan berat di luar batas toleransi ditolak. Mesin diharapkan memproduksi komponen yang sebagian besar berada dalam batas toleransi.
- Pengendalian mutu. Misalkan Anda ingin memastikan apakah komponen yang diproduksi mesin berada dalam batas toleransi. Tidak mungkin mengukur setiap komponen. Anda harus mengandalkan pengambilan sampel acak, mengukurnya, lalu menggunakan estimasi sampel untuk menilai parameter populasi.
- Pengujian hipotesis. Tingkat kepercayaan dan tingkat signifikansi adalah dua sisi dari koin yang sama. Tingkat signifikansi = 1 - Tingkat kepercayaan. Interval kepercayaan, dengan tingkat kepercayaan tertentu, memuat titik-titik data untuk mana hipotesis nol benar pada tingkat signifikansi (1 - tingkat kepercayaan yang ditentukan).
Kapan Menggunakan Interval Prediksi
Interval prediksi digunakan setiap kali Anda memprediksi nilai harapan dari satu titik data individual berdasarkan pengamatan (dan analisis regresi) pada sampel acak.
Beberapa contoh praktis meliputi:
- Memprediksi rentang satu titik data individual berdasarkan analisis regresi. Karena titik data individual bisa memiliki variabilitas lebih tinggi (dibanding mean sampel), Anda memerlukan rentang interval prediksi yang lebih lebar. Misalnya, Anda ingin memprediksi berat satu anak anjing berusia 55 hari berdasarkan sampel acak berat anak anjing yang diukur setiap 15 hari.
- Anda dapat menggunakan simulasi Monte Carlo untuk memprediksi nilai variabel yang tidak diketahui. Karena metode Monte Carlo bersifat probabilistik, Anda mendapatkan keluaran yang sedikit berbeda setiap kali menjalankan model. Perbedaan antar keluaran ini dikodekan dalam Monte Carlo Uncertainty Interval, yang secara konseptual serupa dengan interval prediksi.
- Dalam regresi standar, Anda membangun hubungan untuk memprediksi nilai mean dari suatu parameter. Dalam regresi kuantil, Anda membangun model berbeda untuk memprediksi setiap kuantil dari parameter target. Ini juga memungkinkan Anda menyusun interval prediksi yang lebih granular.
- Model machine learning berurusan dengan memprediksi nilai parameter yang tidak diketahui. Model-model ini biasanya didasarkan pada metode statistik dan, karenanya, memprediksi nilai rata-rata dari besaran yang tidak diketahui. Dengan demikian, keluaran model mencakup nilai harapan (rata-rata) dan interval prediksi.
- Model deep learning menggunakan serangkaian jaringan saraf untuk membuat prediksi. Untuk menilai ketidakpastian pada keluaran, umum dilakukan penghapusan acak berbagai neuron guna mempelajari variabilitas keluaran. Varians pada prediksi ini digunakan untuk membentuk interval prediksi.
- Dalam peramalan deret waktu, tujuannya adalah memprediksi nilai suatu besaran teramati pada langkah waktu di masa depan. Prediksi didasarkan pada model statistik seperti ARIMA, yang melakukan autoregresi pada rata-rata bergerak. Dengan demikian, model memprediksi nilai harapan. Nilai aktual yang diamati berada dalam interval prediksi dari nilai harapan. Interval prediksi ini dihitung sebagai fungsi dari simpangan baku. Misalnya, untuk tingkat kepercayaan 95%, interval prediksi berada dalam 1,96 simpangan baku dari nilai harapan. Selain itu, prediksi multi-langkah, yang melibatkan cakrawala peramalan lebih panjang, juga melibatkan interval prediksi yang lebih besar. Untuk mempelajari lebih lanjut tentang deret waktu, rujuk ke kursus analisis deret waktu dari DataCamp.
Interval Kepercayaan vs Interval Prediksi: Ringkasan
Interval kepercayaan dan interval prediksi sering digunakan dalam konteks yang sama, sehingga penting untuk memahami bagaimana keduanya berbeda.
Tabel berikut merangkum perbedaan berdasarkan pembahasan pada bagian sebelumnya:
|
Interval Kepercayaan |
Interval Prediksi |
|
Digunakan untuk menentukan parameter populasi berdasarkan statistik sampel |
Tidak digunakan untuk menentukan parameter populasi berdasarkan sampel |
|
Digunakan untuk memprediksi respons mean (nilai rata-rata variabel dependen untuk variabel independen tertentu) berdasarkan regresi. |
Digunakan untuk memprediksi nilai di masa depan (dari satu titik data individual untuk variabel independen tertentu) berdasarkan regresi. |
|
Biasanya lebih sempit untuk suatu analisis tertentu |
Biasanya lebih lebar untuk suatu analisis tertentu |
Menerapkan Interval Kepercayaan dan Interval Prediksi di R
Bagian ini menampilkan contoh langsung penggunaan bahasa pemrograman R untuk mengestimasi interval kepercayaan dan interval prediksi. R adalah bahasa yang dirancang untuk aplikasi statistik dan dilengkapi dataset serta fungsi statistik bawaan.
Untuk mempelajari lebih lanjut tentang regresi menggunakan R, ikuti tutorial regresi linear di R dari DataCamp.
Contoh di bawah menggunakan dataset Orange bawaan. Dataset ini melacak keliling (dalam milimeter) dan usia (dalam hari) pohon jeruk. Secara alami, kita berharap bahwa semakin tua pohonnya, semakin besar kelilingnya.
Menerapkan interval kepercayaan di R
Contoh di bawah menunjukkan cara mengestimasi interval kepercayaan untuk statistik ringkasan dan analisis regresi.
Interval kepercayaan pada statistik ringkasan
Untuk memperoleh interval kepercayaan bagi mean, jalankan uji-T standar menggunakan fungsi t.test() pada dataset:
t.test(Orange$circumference)Keluaran terlihat seperti contoh di bawah:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
96.10926 135.60502
sample estimates:
mean of x
115.8571 Hasilnya memberikan estimasi mean dan interval kepercayaan 95%. Secara default, fungsi Uji-T menggunakan tingkat kepercayaan 95%. Gunakan parameter conf.level untuk menentukan interval kepercayaan lain, seperti 99%.
> t.test(Orange$circumference, conf.level = 0.99)Perintah ini menghasilkan keluaran berikut:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
89.34458 142.36970
sample estimates:
mean of x
115.8571 Perhatikan bahwa mean yang diestimasi sama pada kedua kasus. Namun, interval perlu lebih lebar untuk tingkat kepercayaan yang lebih tinggi. Berdasarkan data, saya 99% yakin bahwa mean berada antara 89,3 dan 142,4, tetapi hanya 95% yakin bahwa mean berada antara 96,1 dan 135,6. Untuk parameter yang diestimasi dari sampel tertentu, semakin sempit interval kepercayaan, semakin rendah tingkat kepercayaannya.
Interval kepercayaan dalam regresi
Dalam analisis regresi, Anda memerlukan interval kepercayaan untuk koefisien regresi dan nilai prediksi.
Untuk pemahaman mendalam tentang cara melakukan regresi di R, ikuti kursus Inference for Linear Regression in R dari DataCamp.
Interval kepercayaan koefisien regresi
Koefisien regresi diestimasi dengan menganalisis sampel acak. Karenanya, koefisien tersebut bukan koefisien sebenarnya untuk seluruh populasi. Estimasi parameter regresi memiliki galat terkait. Selain nilai estimasinya, akan membantu jika disertakan interval kepercayaan untuk parameter-parameter tersebut.
Gunakan fungsi lm() untuk membangun model linear berdasarkan dataset Orange guna memprediksi keliling (dalam mm) pohon jeruk berdasarkan usia (dalam hari):
model_orange <- lm(circumference ~ age, data = Orange)Periksa koefisien dari model linear ini:
model_orangePerintah ini menampilkan parameter model (intersep dan kemiringan) seperti di bawah:
Coefficients: (Intercept) age
17.3997 0.1068 Gunakan fungsi confint() untuk menghitung interval kepercayaan 95%:
confint(model_orange, level = 0.95)Sekarang Anda dapat melihat interval kepercayaan 95% dari kemiringan dan intersep yang diestimasi model:
2.5 % 97.5 %
(Intercept) -0.14328303 34.9425835
age 0.08993141 0.1236092Interval kepercayaan prediksi respons mean
Gunakan model regresi yang dibuat di atas untuk memprediksi keliling rata-rata yang diharapkan dari pohon berusia 900 hari. Gunakan parameter interval untuk menentukan interval kepercayaan.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) Keluaran mencakup prediksi (fit) dan interval kepercayaan (lwr dan upr untuk batas bawah dan atas), seperti ditunjukkan di bawah:
fit lwr upr
1 113.4929 105.3211 121.6647Menerapkan interval prediksi di R
Gunakan model yang sama seperti di atas untuk memprediksi keliling spesifik dari satu pohon jeruk berusia 900 hari. Gunakan parameter interval untuk menentukan bahwa Anda menginginkan interval prediksi.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) Keluaran menyerupai contoh di bawah:
fit lwr upr
1 113.4929 64.5118 162.4741Perhatikan bahwa pada kedua kasus, nilai prediksi kelilingnya sama—113,49. Namun, interval prediksi jauh lebih lebar daripada interval kepercayaan. Interval kepercayaan dari prediksi adalah rentang yang diharapkan memuat keliling rata-rata pohon berusia 900 hari. Interval prediksi adalah rentang yang diharapkan untuk keliling satu pohon berusia 900 hari. Ini karena variasi pada tiap pohon dapat jauh lebih besar, yang menjadi lebih halus ketika mempertimbangkan nilai rata-rata.
Kesalahpahaman dan Jebakan Umum
Interval statistik lazim digunakan dalam bidang terapan seperti analisis data, farmasi, ekonometrika, dll. Bagi mereka yang tidak memiliki latar belakang akademis statistik, mudah untuk tertukar antara interval kepercayaan dan interval prediksi.
Beberapa kesalahpahaman umum dibahas di bawah ini:
- Membuat prediksi tanpa mempertimbangkan interval prediksi.
- Saat Anda menggunakan model regresi untuk memprediksi nilai variabel dependen bagi nilai variabel independen tertentu, persamaan regresi memberikan nilai harapan dari variabel dependen. Nilai aktual jarang sekali cocok dengan nilai harapan, tetapi berada dalam rentang tertentu dari nilai harapan, sebagaimana ditentukan oleh interval prediksi.
- Menganggap bahwa analisis regresi hanya melibatkan interval prediksi.
- Anda membuat dua jenis prediksi menggunakan model regresi—1) memprediksi nilai di masa depan dan 2) memprediksi respons mean. Pada contoh pohon jeruk, Anda dapat mencoba memprediksi 1) keliling satu pohon jeruk tertentu berusia 900 hari atau 2) keliling rata-rata semua pohon berusia 900 hari. Pada kedua kasus, nilai harapannya sama. Namun, yang pertama melibatkan interval prediksi, sedangkan yang kedua melibatkan interval kepercayaan.
- Mengira bahwa interval yang lebih sempit adalah yang lebih baik.
- Kadang Anda mungkin tergoda untuk hanya menggunakan interval yang lebih sempit saat memanfaatkan hasil studi regresi. Interval kepercayaan bukanlah “lebih baik” karena lebih sempit. Ia lebih sempit karena memberikan rentang untuk hal yang berbeda dibandingkan interval prediksi. Pertimbangkan apakah Anda mencoba memprediksi nilai rata-rata variabel dependen ataukah ingin memprediksi titik data individual.
- Salah mengira interval kepercayaan sebagai interval prediksi.
- Jika prediksi Anda melibatkan penentuan nilai parameter populasi dari sampel atau memprediksi respons mean (nilai rata-rata) dari regresi, gunakan interval kepercayaan. Jika Anda mencoba memprediksi suatu sifat dari titik data individual berdasarkan regresi, gunakan interval prediksi.
Kesimpulan
Artikel ini memberikan gambaran umum tentang interval kepercayaan dan interval prediksi. Artikel ini juga menjelaskan perbedaan antara konsep yang terdengar mirip ini dan menawarkan contoh praktis kapan menggunakan masing-masing jenis interval. Artikel ini juga menunjukkan cara menghitung interval prediksi dan kepercayaan menggunakan bahasa pemrograman R.
Untuk mempelajari cara menerapkan rumus statistik menggunakan Python, rujuk ke kursus statistik di Python dari DataCamp. Terakhir, jika Anda mempersiapkan wawancara kerja yang melibatkan statistik, lihat kursus pertanyaan wawancara statistik di Python dari DataCamp.
FAQs
Mengapa kita membutuhkan interval? Mengapa nilai sebenarnya tidak sama dengan nilai harapan?
Kita memerlukan interval karena kita terbatas untuk mempelajari sampel kecil alih-alih seluruh populasi dalam analisis statistik. Sifat sampel, yang dapat kita pelajari dan prediksi, mengindikasikan tetapi tidak persis sama dengan sifat populasi yang ingin kita ketahui. Namun, nilai sebenarnya berada dalam interval tertentu dari nilai prediksi.
Apakah interval kepercayaan dan interval prediksi dapat dipertukarkan?
Tidak, keduanya sangat berbeda. Interval kepercayaan digunakan untuk menyatakan rentang parameter populasi, seperti mean. Interval prediksi berkaitan dengan rentang nilai sebenarnya dari titik data individual.
Apakah interval kepercayaan dan interval prediksi pernah digunakan dalam konteks yang sama?
Ya, keduanya digunakan saat melakukan studi regresi. Anda mungkin ingin memprediksi nilai rata-rata dari suatu titik data (seperti berat rata-rata anjing berusia 2 tahun) atau Anda mungkin ingin memprediksi berat satu anjing berusia 2 tahun tertentu. Untuk yang pertama, gunakan interval kepercayaan. Untuk yang kedua, interval prediksi.
Apakah interval kepercayaan dan prediksi bergantung pada ukuran sampel?
Ya, semakin besar ukuran sampel, semakin baik estimasinya untuk parameter populasi. Jadi, estimasi berdasarkan sampel yang lebih besar akan memiliki interval yang lebih sempit.
Bisakah saya menggunakan estimasi sampel tanpa interval?
Secara prinsip, ya. Dalam praktik, ini tidak terlalu berguna. Estimasi sampel adalah nilai “harapan”. Nilai sebenarnya jarang sama dengan nilai harapan. Namun, nilai sebenarnya kemungkinan berada dalam suatu rentang di sekitar nilai harapan. Karena itu, menyediakan interval bersama estimasi adalah praktik standar. Anda bisa saja tanpa nilai harapan jika memiliki interval yang tepat.
Ketika Anda mencoba memprediksi y diberikan x, apakah interval prediksi sama untuk semua nilai x dan y? Bagaimana dengan interval kepercayaan?
Ini pertanyaan yang bagus. Jawabannya tidak. Semakin jauh nilai x dari nilai rata-rata x, semakin lebar interval prediksi dan kepercayaan. Interval berada pada titik tersempit ketika nilai x mendekati nilai mean x.

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.
Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.




Studi statistik, baik yang melibatkan penentuan parameter populasi maupun memprediksi variabel dependen, selalu mengandung ketidakpastian. Akar penyebab ketidakpastian ini adalah proses pengambilan sampel. Tidak realistis untuk mempertimbangkan seluruh populasi saat melakukan analisis statistik. Karena itu, perlu memilih sampel yang representatif—baik untuk memperkirakan parameter populasi, seperti mean, maupun untuk membangun model regresi.
Untuk mempelajari atau menyegarkan dasar-dasar ini, rujuk ke kursus pengantar statistik dari DataCamp.
Nilai sebenarnya dari parameter populasi biasanya tidak persis sama dengan nilai yang diestimasi dari sampel—perbedaan ini adalah galat baku (standard error). Untuk memperhitungkan galat ini, secara konvensional kita memperkirakan sebuah nilai harapan lalu menentukan rentang yang diharapkan memuat nilai sebenarnya.
Demikian pula, studi regresi juga didasarkan pada sampel acak alih-alih seluruh populasi. Hubungan antara variabel dependen dan independen, sebagaimana diestimasi oleh studi regresi pada sampel, tidak persis sama dengan hubungan sebenarnya di seluruh populasi. Karenanya, nilai prediksi untuk satu titik data individual tidak persis sama dengan nilai sebenarnya. Nilai sebenarnya diharapkan berada dalam suatu interval dari nilai prediksi.
Artikel ini menjelaskan makna kedua jenis interval tersebut dan metode matematis yang mendasari perhitungannya. Dibahas juga contoh praktis kapan menggunakan masing-masing interval. Terakhir, artikel ini mengilustrasikan dengan contoh langsung cara menghitung interval kepercayaan dan interval prediksi dalam bahasa pemrograman R.
Apa Itu Interval Kepercayaan?
Interval kepercayaan adalah rentang yang diharapkan—dengan tingkat kepercayaan tertentu—memuat nilai sebenarnya dari parameter populasi, seperti mean populasi.
Interval kepercayaan dalam inferensi statistik
Parameter populasi adalah sifat numerik dari seluruh populasi. Mean (dari seluruh populasi) adalah contoh parameter populasi. Nilai sebenarnya dari koefisien regresi antara dua variabel juga merupakan contoh parameter populasi. Statistik inferensial berkaitan dengan mempelajari titik-titik data dalam suatu sampel acak untuk memperkirakan parameter populasi.
Misalkan, secara hipotetis, Anda seorang ahli hortikultura atau petani jeruk dan ingin mengetahui seberapa tebal batang pohon jeruk saat berusia 100 hari. Tidak mungkin mempelajari setiap pohon jeruk yang berusia 100 hari. Jadi, Anda memilih secara acak beberapa pohon berusia 100 hari dan mengukur keliling (ketebalan) batangnya. Rata-rata dari pengukuran ini memberikan mean sampel. Anda ingin menggunakan mean sampel ini untuk memperoleh mean populasi.
Populasi pohon jeruk. Dibuat menggunakan DALL-E.
Mean sampel adalah estimasi titik untuk parameter populasi (dalam kasus ini, parameter yang diminati adalah mean). Kursus tentang statistik inferensial dari DataCamp membahas konsep-konsep ini secara lebih mendalam.
Mean sampel bersifat representatif terhadap mean populasi tetapi tidak persis sama. Mean populasi diharapkan berada dalam interval tertentu dari mean sampel, yang disebut interval kepercayaan.
Interval kepercayaan dalam regresi
Bagian sebelumnya menjelaskan interval kepercayaan dalam statistik inferensial. Regresi juga melibatkan penggunaan interval kepercayaan.
Sebagai contoh, pertimbangkan variasi dari contoh pohon jeruk yang sama:
Anda melakukannya menggunakan analisis regresi. Dataset tempat Anda menjalankan regresi didasarkan pada sampel pohon jeruk. Dengan demikian, mean sampel yang diestimasi (rata-rata keliling pohon jeruk berusia 100 hari) tidak akan persis sama dengan mean populasi. Nilai sebenarnya dari mean populasi berada dalam interval kepercayaan dari mean sampel yang diestimasi.
Bagian selanjutnya menampilkan dan menjelaskan ekspresi matematis untuk interval kepercayaan.
Apa Itu Interval Prediksi?
Interval prediksi adalah rentang yang diharapkan—dengan tingkat kepercayaan tertentu—memuat nilai sebenarnya dari satu titik data individual, berdasarkan prediksi yang dibuat menggunakan analisis regresi.
Pertimbangkan variasi lain dari contoh regresi yang disebutkan sebelumnya:
Anda menggunakan rumus regresi yang sama seperti sebelumnya. Nilai estimasi (yakni nilai harapan) dari keliling individual sama dengan keliling rata-rata yang diestimasi. Namun, Anda harus memperhitungkan variabilitas yang lebih tinggi dari titik data individual karena Anda memprediksi nilai individual (bukan rata-rata). Karena itu, interval prediksi lebih besar daripada interval kepercayaan.
Nanti dalam artikel, Anda akan melihat rumus untuk interval-interval ini dan mempelajari cara menggunakan R untuk menghitungnya.