Cours
Introduction aux statistiques en Python
4 h
197.5K
Qu'il s'agisse d'estimer des paramètres de population ou de prédire des variables dépendantes, toute étude statistique comporte une part d'incertitude. Cette incertitude provient du processus d'échantillonnage. Il est irréaliste de considérer l’ensemble de la population lors d’une analyse statistique. Il faut donc choisir un échantillon représentatif — que ce soit pour estimer un paramètre de population, comme la moyenne, ou pour construire un modèle de régression.
Pour apprendre ou réviser ces bases, consultez le cours d'introduction aux statistiques de DataCamp.
La vraie valeur du paramètre de population n’est généralement pas exactement égale à la valeur estimée à partir de l’échantillon — cet écart correspond à l’erreur standard. Pour en tenir compte, on estime une valeur attendue puis on précise un intervalle dans lequel la valeur réelle a des chances de se trouver.
De même, les études de régression reposent sur des échantillons aléatoires plutôt que sur l’ensemble de la population. La relation entre variables dépendante et indépendantes, estimée par la régression sur l’échantillon, n’est pas exactement égale à la relation vraie au niveau de la population. Par conséquent, la valeur prédite pour une observation n’est pas strictement égale à sa vraie valeur. On s’attend à ce que la vraie valeur se situe dans un certain intervalle autour de la prédiction.
Cet article explique la signification de ces deux types d’intervalles et les méthodes mathématiques sous-jacentes pour les calculer. Il présente des exemples concrets d’utilisation de chaque intervalle. Enfin, il illustre, pas à pas, le calcul des intervalles de confiance et de prédiction dans le langage R.
Un intervalle de confiance est une plage de valeurs qui devrait — avec un certain niveau de confiance — contenir la vraie valeur d’un paramètre de population, tel que la moyenne de population.
Un paramètre de population est une propriété numérique de l’ensemble de la population. La moyenne (de l’ensemble de la population) en est un exemple. La vraie valeur des coefficients de régression entre deux variables en est un autre. Les statistiques inférentielles consistent à étudier un échantillon aléatoire afin d’estimer un paramètre de population.
Supposons, par hypothèse, que vous soyez horticulteur ou producteur d’oranges et que vous vouliez savoir quelle épaisseur atteignent les orangers à 100 jours. Il est impossible d’étudier chaque oranger de 100 jours. Vous sélectionnez donc aléatoirement quelques arbres de 100 jours et mesurez leur circonférence (épaisseur). La moyenne de ces mesures vous donne la moyenne d’échantillon. Vous souhaitez utiliser cette moyenne d’échantillon pour estimer la moyenne de population.
Une population d’orangers. Créée avec DALL-E.
La moyenne d’échantillon est une estimation ponctuelle du paramètre de population (ici, la moyenne). Ce cours sur l’inférence statistique de DataCamp développe ces notions en détail.
La moyenne d’échantillon est représentative de la moyenne de population, sans lui être exactement égale. On s’attend à ce que la moyenne de population se situe dans un certain intervalle autour de la moyenne d’échantillon, appelé intervalle de confiance.
La section précédente a expliqué les intervalles de confiance en inférence statistique. La régression fait également appel à des intervalles de confiance.
Par exemple, reprenons une variante des orangers :
Vous procédez par analyse de régression. Le jeu de données utilisé pour la régression provient d’un échantillon d’orangers. Ainsi, la moyenne estimée sur l’échantillon (circonférence moyenne des orangers de 100 jours) ne coïncidera pas exactement avec la moyenne de population. La vraie valeur de la moyenne de population se situe dans un intervalle de confiance autour de la moyenne estimée.
Les sections suivantes présentent et expliquent les expressions mathématiques de l’intervalle de confiance.
Un intervalle de prédiction est une plage de valeurs qui devrait — avec un certain niveau de confiance — contenir la vraie valeur d’une observation individuelle, à partir d’une prédiction issue d’une analyse de régression.
Considérons une autre variante de l’exemple de régression :
Vous utilisez la même formule de régression que précédemment. La valeur estimée (c’est-à-dire la valeur attendue) de la circonférence individuelle est la même que la moyenne estimée. Toutefois, vous devez tenir compte de la variabilité accrue des observations individuelles, puisque vous prédisez une valeur individuelle (et non une moyenne). L’intervalle de prédiction est donc plus large que l’intervalle de confiance.
Plus loin dans l’article, vous verrez les formules correspondantes et apprendrez à les calculer avec R.
Les deux notions — intervalle de prédiction et intervalle de confiance — sont étroitement liées. Une même analyse peut mobiliser les deux. Il est donc utile de les comparer directement.
Lorsque vous avez besoin d’un paramètre de population, comme une moyenne, vous utilisez un échantillon pour l’estimer. Comme la taille de l’échantillon est en général bien inférieure à celle de la population, l’estimation d’échantillon est imparfaite. L’intervalle de confiance est la plage (autour de l’estimation d’échantillon) censée contenir le paramètre de population.
Les coefficients de régression sont aussi des paramètres de population. Parce qu’ils sont estimés à partir d’un échantillon (et non de la population entière), une erreur leur est associée. Ils peuvent donc être fournis avec un intervalle de confiance.
Par ailleurs, la régression permet de prédire soit :
Dans le premier cas, on utilise un intervalle de confiance ; dans le second, un intervalle de prédiction. La section suivante détaille davantage cette différence.
Comme expliqué plus haut, la largeur de l’intervalle de confiance est proportionnelle à l’écart-type et inversement proportionnelle à la taille d’échantillon. L’intervalle de confiance de la moyenne de population, 𝛍, s’écrit :
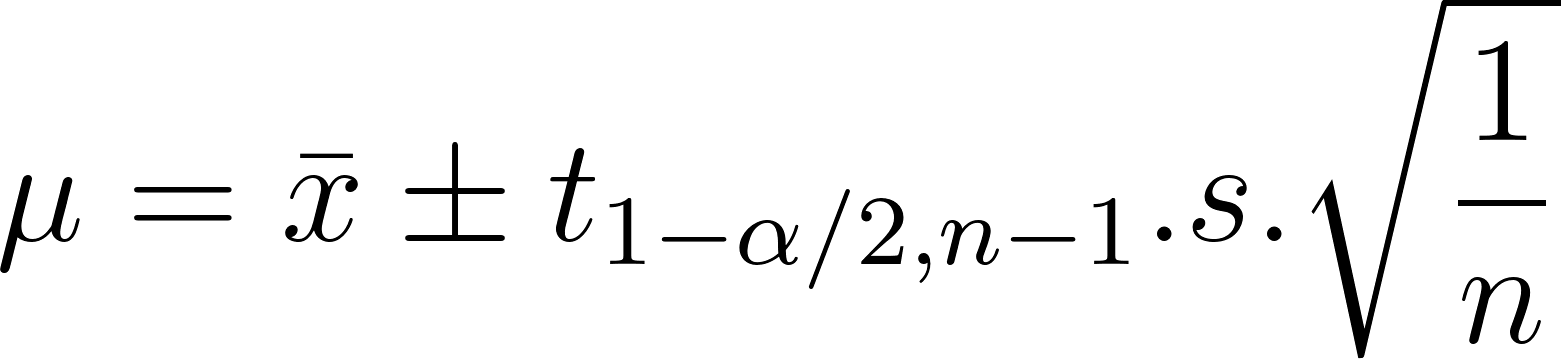
Dans cette expression :
Ainsi, la plage de 𝛍 est :
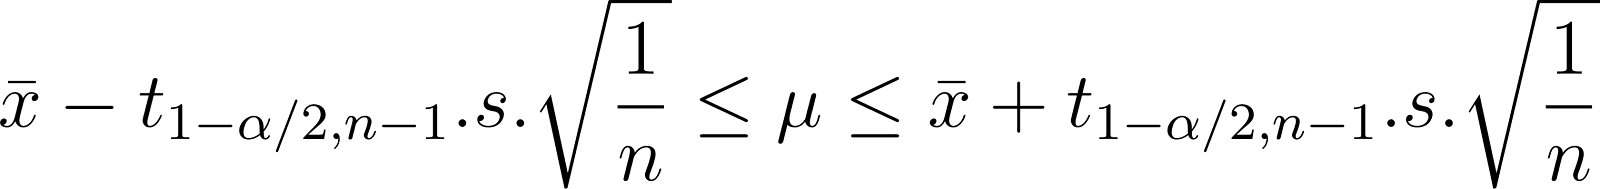
Notez aussi que la largeur de l’intervalle est proportionnelle à la valeur t. Si vous voulez un degré de confiance (certitude) très élevé que la valeur réelle se situe dans la plage donnée, cette plage doit être très large. Plus le degré de confiance est faible, plus l’intervalle est étroit. Mais un degré de confiance trop faible est peu utile. En pratique, on choisit généralement des niveaux de confiance de 90 %, 95 %, 99 %, etc.
Un niveau de confiance de 95 % correspond à un niveau de signification de 5 %. En supposant un intervalle bilatéral, vous devez trouver la valeur critique de t à 2,5 % (0,025).
Conceptuellement, tous les intervalles s’expriment ainsi :

Dans tous les cas, plus l’erreur est grande, plus l’intervalle est large. Cette erreur se calcule différemment selon le cas d’usage. En inférence, l’erreur est l’écart-type. En régression, l’erreur est présentée dans les sections suivantes.
Quand vous prédisez la valeur moyenne de la variable dépendante, vous estimez sa plage via l’intervalle de confiance. Par exemple, vous voulez prédire une plage pour le poids moyen de chiens de 2 ans en fonction de leur âge. C’est l’intervalle de confiance de la réponse moyenne. Il s’agit aussi d’un paramètre de population car il concerne toute la population. L’intervalle s’écrit :
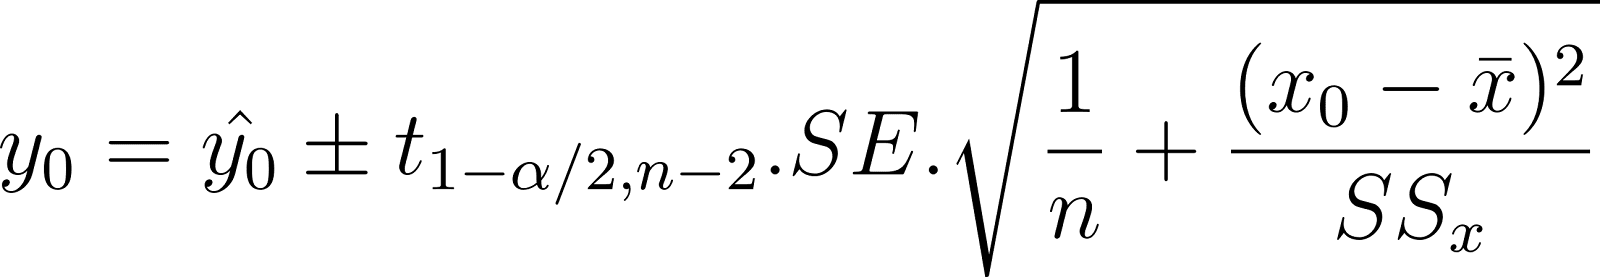
Dans cette expression :


Dans cette expression, le terme de somme est aussi appelé somme des carrés des résidus. Le résidu est la différence entre la vraie valeur de y et la valeur prédite de y.
En utilisant la MSE à la place de SE, l’intervalle de confiance de la réponse moyenne peut aussi s’écrire :
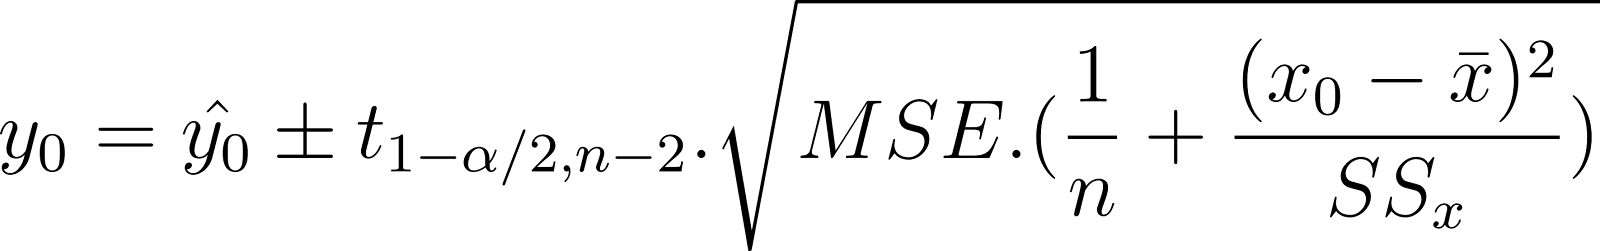
Comparez cette expression à la relation conceptuelle présentée plus haut.
Observez que l’erreur prend en compte :
Pour prédire la valeur d’une observation individuelle (et non la moyenne), vous estimez sa plage via l’intervalle de prédiction. Par exemple, vous voulez prédire la plage du poids réel d’un chien de 2 ans en particulier en fonction de l’âge. C’est l’intervalle de prédiction, exprimé comme suit :
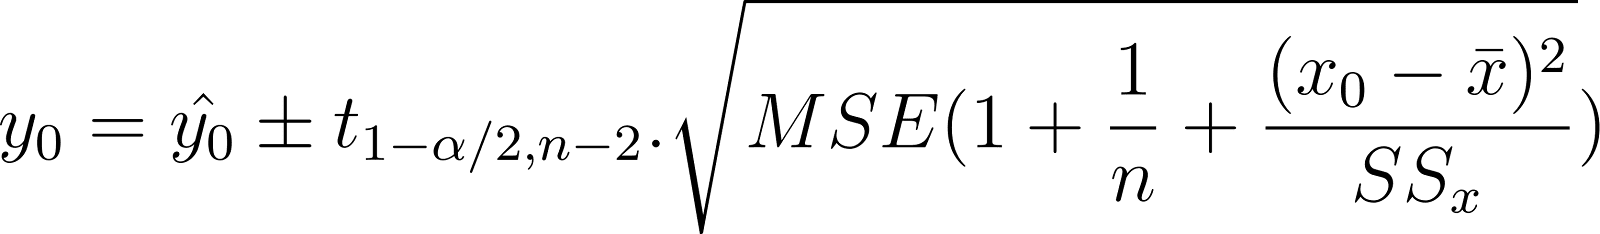
Comparez-le à l’intervalle de confiance présenté plus haut :
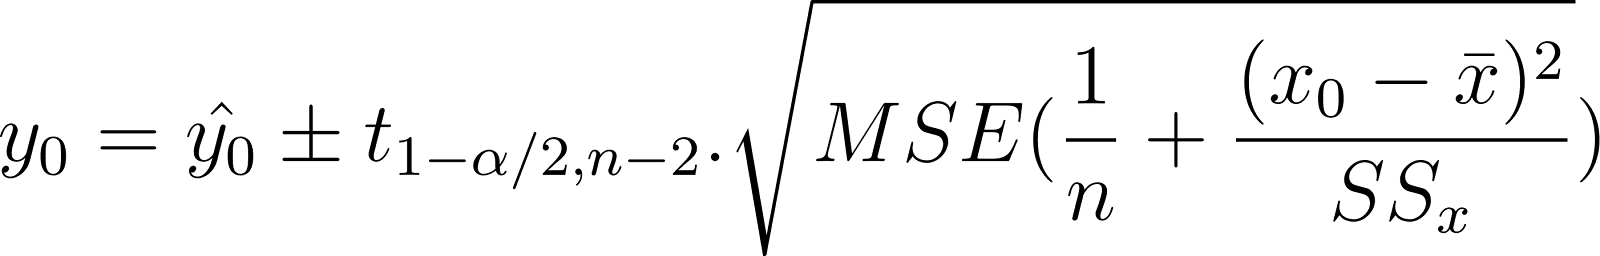
Remarquez que les deux expressions sont très proches. La seule différence réside dans le terme d’erreur supplémentaire de l’intervalle de prédiction. L’intervalle de prédiction ajoute un terme de MSE sous la racine carrée par rapport à l’intervalle de confiance. Il tient compte de la variabilité des valeurs de y que vous souhaitez prédire. Cela rend l’intervalle de prédiction plus large que l’intervalle de confiance.
Le schéma ci-dessous illustre les intervalles de confiance et de prédiction par rapport à l’estimation ponctuelle (valeur prédite).
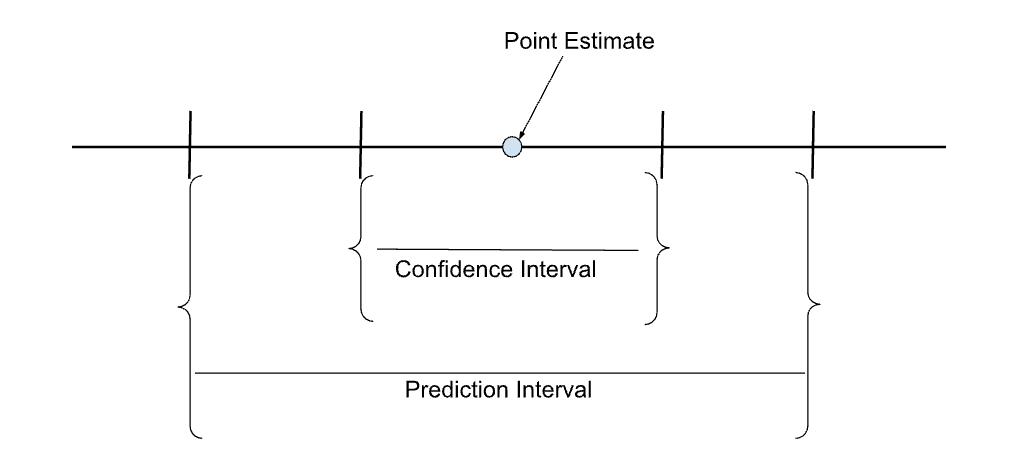
Comparaison des intervalles de confiance et de prédiction autour d’une estimation ponctuelle. Image de l’auteur.
Le croquis schématique ci-dessous montre les intervalles de confiance et de prédiction autour de la régression — remarquez également que les intervalles sont les plus étroits à proximité de la moyenne.
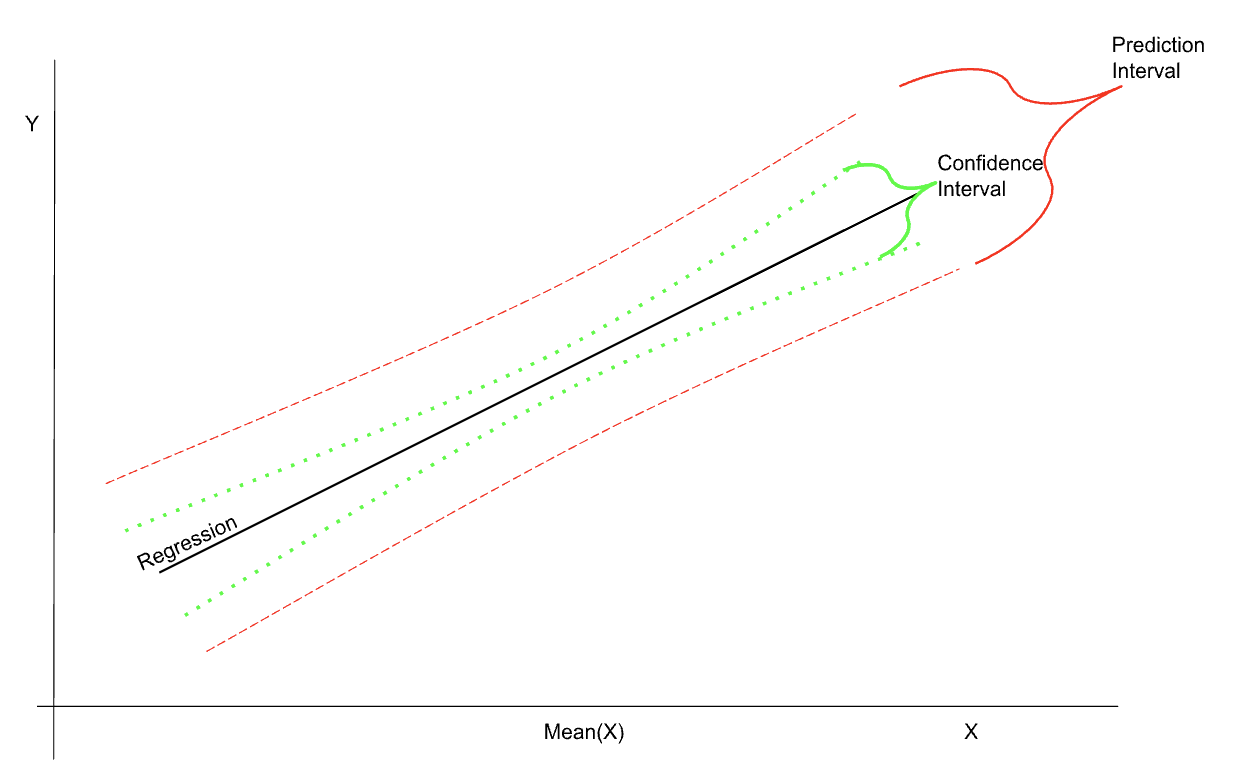
Illustration des intervalles de confiance et de prédiction en régression. Image de l’auteur.
Les sections précédentes ont rappelé les bases des intervalles de confiance et de prédiction, leurs usages et les formules de calcul. Voici des exemples concrets d’application.
On utilise un intervalle de confiance pour estimer un paramètre de population. Pour estimer ce paramètre, vous pouvez :
Quelques cas d’usage typiques des intervalles de confiance :
Les intervalles de prédiction s’emploient lorsque vous prédisez la valeur attendue d’une observation individuelle à partir d’observations (et d’une régression) sur un échantillon aléatoire.
Exemples pratiques :
Les intervalles de confiance et de prédiction sont souvent utilisés dans des contextes similaires, d’où l’importance de comprendre leurs différences.
Ce tableau récapitule les distinctions abordées ci-dessus :
|
Intervalle de confiance |
Intervalle de prédiction |
|
Utilisé pour déterminer des paramètres de population à partir de statistiques d’échantillon |
Non utilisé pour déterminer des paramètres de population à partir d’échantillons |
|
Permet de prédire la réponse moyenne (valeur moyenne de la variable dépendante pour une variable indépendante donnée) via des régressions |
Permet de prédire la valeur future (d’une observation individuelle pour une variable indépendante donnée) via des régressions |
|
Généralement plus étroit pour une analyse donnée |
Généralement plus large pour une analyse donnée |
Cette section propose des exemples pratiques en R pour estimer des intervalles de confiance et de prédiction. R est un langage conçu pour les applications statistiques, livré avec des jeux de données et des fonctions dédiées.
Pour approfondir la régression en R, suivez le tutoriel de DataCamp sur la régression linéaire en R.
Les exemples ci-dessous utilisent le jeu de données intégré Orange. Il suit la circonférence (en millimètres) et l’âge (en jours) d’orangers. Naturellement, plus l’arbre est âgé, plus sa circonférence est grande.
Les exemples suivants montrent comment estimer des intervalles de confiance pour des statistiques descriptives et des analyses de régression.
Pour obtenir l’intervalle de confiance de la moyenne, exécutez le test t standard avec la fonction t.test() sur le jeu de données :
t.test(Orange$circumference)La sortie ressemble à l’exemple suivant :
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
   96.10926 135.60502
sample estimates:
mean of x
   115.8571
Vous obtenez l’estimation de la moyenne et l’intervalle de confiance à 95 %. Par défaut, la fonction t.test utilise un niveau de confiance de 95 %. Utilisez le paramètre conf.level pour spécifier un autre niveau, par exemple 99 %.
> t.test(Orange$circumference, conf.level = 0.99)Cette commande produit la sortie suivante :
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
   89.34458 142.36970
sample estimates:
mean of x
   115.8571
Notez que la moyenne estimée est identique dans les deux cas. En revanche, l’intervalle doit s’élargir pour atteindre un niveau de confiance plus élevé. D’après les données, nous sommes confiants à 99 % que la moyenne se situe entre 89,3 et 142,4, mais seulement à 95 % qu’elle se situe entre 96,1 et 135,6. Pour un paramètre estimé sur un échantillon donné, plus l’intervalle est étroit, plus le niveau de confiance est faible.
En régression, vous avez besoin d’intervalles de confiance pour les coefficients et pour les valeurs prédites.
Pour une compréhension approfondie des régressions en R, suivez le cours DataCamp sur l’inférence pour la régression linéaire en R.
Les coefficients de régression sont estimés à partir d’un échantillon aléatoire. Ils ne sont donc pas les « vrais » coefficients de la population. Les estimations comportent une incertitude. En plus de leurs valeurs estimées, il est utile de fournir un intervalle de confiance pour ces paramètres.
Utilisez la fonction lm() pour construire un modèle linéaire sur le jeu de données Orange afin de prédire la circonférence (en mm) des orangers à partir de l’âge (en jours) :
model_orange <- lm(circumference ~ age, data = Orange)Affichez les coefficients de ce modèle linéaire :
model_orangeCette commande affiche les paramètres du modèle (interception et pente) comme ci-dessous :
Coefficients: (Intercept)          age
                              17.3997       0.1068
Utilisez la fonction confint() pour calculer les intervalles de confiance à 95 % :
confint(model_orange, level = 0.95)Vous voyez maintenant les intervalles de confiance à 95 % de la pente et de l’interception estimées par le modèle :
                          2.5 %                   97.5 %
(Intercept)     -0.14328303       34.9425835
age 0.08993141 0.1236092Utilisez le modèle de régression ci-dessus pour prédire la circonférence moyenne attendue d’arbres de 900 jours. Utilisez le paramètre interval pour demander un intervalle de confiance.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) La sortie inclut la prédiction (fit) et l’intervalle de confiance (lwr et upr pour bornes inférieure et supérieure), comme ci-dessous :
       fit                    lwr              upr
1 113.4929 105.3211 121.6647Reprenez le même modèle pour prédire la circonférence d’un oranger individuel âgé de 900 jours. Utilisez le paramètre interval pour demander l’intervalle de prédiction.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) La sortie ressemble à l’exemple suivant :
       fit                    lwr              upr
1      113.4929        64.5118        162.4741
Notez que, dans les deux cas, la valeur prédite de la circonférence est la même — 113,49. Toutefois, l’intervalle de prédiction est bien plus large que l’intervalle de confiance. L’intervalle de confiance de la prédiction est la plage censée contenir la circonférence moyenne des arbres de 900 jours. L’intervalle de prédiction est la plage attendue pour la circonférence d’un arbre individuel de 900 jours. Les variations entre individus sont en effet plus importantes et se lissent lorsqu’on considère une moyenne.
Les intervalles statistiques sont courants dans les domaines appliqués comme l’analyse de données, la pharmaceutique, l’économétrie, etc. Sans formation académique en statistiques, il est facile de confondre intervalles de confiance et de prédiction.
Voici quelques idées reçues fréquentes :
Cet article a présenté un aperçu des intervalles de confiance et de prédiction. Il explique la différence entre ces notions proches et propose des exemples concrets pour savoir quand utiliser chaque type d’intervalle. Il montre aussi comment calculer ces intervalles en R.
Pour apprendre à appliquer des formules statistiques en Python, consultez le cours DataCamp sur les statistiques en Python. Enfin, si vous préparez des entretiens incluant des questions de statistiques, découvrez le cours DataCamp sur les questions d’entretien en statistiques en Python.
Approfondissez les statistiques et la data science avec ces cours !
Cours
Cours
Cours