
Corso
Introduzione alla statistica in Python
4 ore
199.1K
Gli studi statistici, che si tratti di determinare parametri di popolazione o di prevedere variabili dipendenti, comportano sempre un certo grado di incertezza. La causa principale di questa incertezza è il processo di campionamento. È irrealistico considerare l’intera popolazione quando si conduce un’analisi statistica. È quindi necessario scegliere un campione rappresentativo, sia per stimare un parametro di popolazione come la media, sia per costruire un modello di regressione.
Per imparare o ripassare queste basi, consulta il corso introduttivo di statistica di DataCamp.
Il valore reale del parametro di popolazione di solito non è esattamente uguale al valore stimato dal campione: questa differenza è l’errore standard. Per tenerne conto, è prassi stimare un valore atteso e poi specificare un intervallo che si prevede contenga il valore effettivo.
Allo stesso modo, anche gli studi di regressione si basano su campioni casuali anziché sull’intera popolazione. La relazione tra variabili dipendenti e indipendenti, stimata dalla regressione sul campione, non è esattamente uguale alla vera relazione tra tali variabili nell’intera popolazione. Di conseguenza, il valore previsto di un singolo dato non è esattamente uguale al suo valore reale. Ci si aspetta che il valore reale cada entro un certo intervallo attorno al valore previsto.
Questo articolo spiega il significato di entrambi i tipi di intervalli e i metodi matematici alla base del loro calcolo. Discute esempi pratici su quando usare ciascun intervallo. Infine, illustra con esempi pratici come calcolare intervalli di confidenza e di predizione nel linguaggio R.
Un intervallo di confidenza è l’intervallo che ci si aspetta, con un certo livello di confidenza, contenga il valore reale di un parametro di popolazione, come la media della popolazione.
Un parametro di popolazione è una proprietà numerica dell’intera popolazione. La media (dell’intera popolazione) è un esempio di parametro di popolazione. Il valore reale dei coefficienti di regressione tra due variabili è un altro esempio di parametro di popolazione. La statistica inferenziale studia i dati di un campione casuale per stimare un parametro di popolazione.
Supponiamo, ipoteticamente, che tu sia un orticoltore o un coltivatore di arance e voglia sapere quanto diventano spessi i tronchi degli aranci quando hanno 100 giorni. È impossibile studiare ogni singolo albero di arancio di 100 giorni. Quindi selezioni casualmente alcuni alberi di 100 giorni e ne misuri la circonferenza (spessore). La media di queste misurazioni ti dà la media campionaria. Vuoi usare questa media del campione per ottenere la media della popolazione.
Una popolazione di aranci. Creata con DALL-E.
La media campionaria è una stima puntuale del parametro di popolazione (in questo caso, la media). Questo corso sulla statistica inferenziale di DataCamp approfondisce questi concetti.
La media campionaria è rappresentativa della media della popolazione ma non le è esattamente uguale. Ci si aspetta che la media della popolazione cada entro un certo intervallo della media campionaria, chiamato intervallo di confidenza.
La sezione precedente ha spiegato gli intervalli di confidenza nell’inferenza statistica. Anche la regressione prevede l’uso di intervalli di confidenza.
Come esempio, considera una variante dello stesso caso degli aranci:
Lo fai tramite un’analisi di regressione. Il dataset su cui esegui la regressione si basa su un campione di aranci. Pertanto, la media campionaria stimata (circonferenza media degli aranci di 100 giorni) non sarà esattamente uguale alla media della popolazione. Il valore reale della media di popolazione cade entro un intervallo di confidenza della media campionaria stimata.
Più avanti verranno mostrate e spiegate le espressioni matematiche dell’intervallo di confidenza.
Un intervallo di predizione è l’intervallo che ci si aspetta, con un certo livello di confidenza, contenga il valore reale di un singolo dato, sulla base di una previsione ottenuta tramite un’analisi di regressione.
Considera un’altra variante dell’esempio di regressione citato prima:
Usi la stessa formula di regressione di prima. Il valore stimato (cioè il valore atteso) della circonferenza individuale è lo stesso della circonferenza media stimata. Tuttavia, devi tener conto della maggiore variabilità dei singoli punti dati perché stai prevedendo un valore individuale (e non una media). Pertanto, l’intervallo di predizione è più ampio dell’intervallo di confidenza.
Più avanti nell’articolo vedrai le formule di questi intervalli e imparerai a usare R per calcolarli.
I due concetti, intervalli di predizione e intervalli di confidenza, sono strettamente correlati. La stessa analisi può spesso prevedere l’uso di entrambi i tipi di intervalli. Quindi è utile metterli a confronto diretto.
Quando hai bisogno di conoscere un parametro di popolazione, come una media, usi un campione per stimarlo. Poiché la dimensione del campione è tipicamente molto più piccola della popolazione, la stima del parametro basata sul campione è imperfetta. L’intervallo di confidenza è l’intervallo (attorno alla stima campionaria) che ci si aspetta contenga il parametro di popolazione.
Anche i coefficienti di regressione sono considerati parametri di popolazione. Poiché sono stimati su un campione (e non sull’intera popolazione), incorporano un certo errore. Pertanto, anche i coefficienti di regressione possono essere espressi con un intervallo di confidenza.
Inoltre, puoi usare la regressione per prevedere:
Nel primo caso si usa un intervallo di confidenza, nel secondo un intervallo di predizione. La sezione seguente spiega più nel dettaglio questa differenza.
Come spiegato in precedenza, l’ampiezza dell’intervallo di confidenza è proporzionale alla deviazione standard e inversamente proporzionale alla dimensione del campione. L’intervallo di confidenza della media di popolazione, 𝛍, è espresso come:
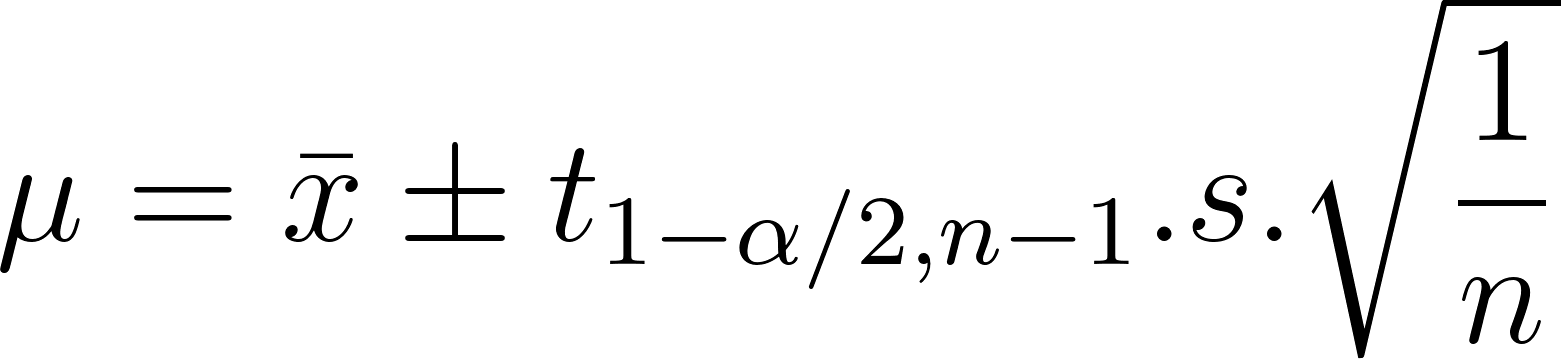
Nella formula sopra:
Quindi, l’intervallo di 𝛍 è:
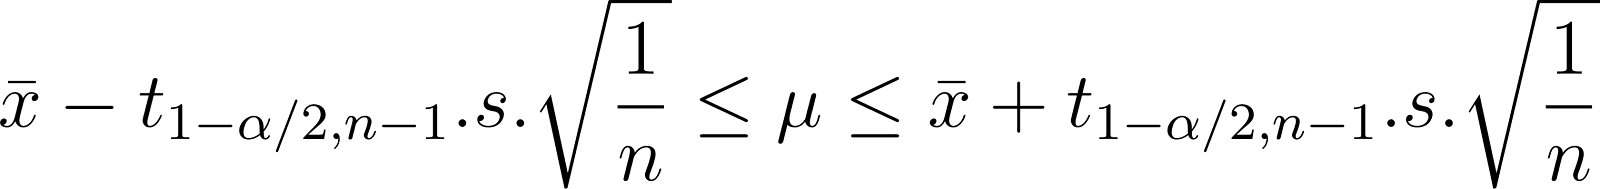
Nota anche che l’ampiezza dell’intervallo è proporzionale al valore t. Se desideri un grado di confidenza (certezza) molto elevato che il valore reale sia all’interno dell’intervallo dato, quell’intervallo deve essere molto ampio. Minore è il grado di confidenza, più stretto è l’intervallo. Ma un grado di confidenza troppo basso è poco utile. In pratica si scelgono comunemente livelli di confidenza del 90%, 95%, 99% ecc.
Se hai un livello di confidenza del 95%, ne deriva un livello di significatività del 5%. Assumendo un intervallo a due code, devi trovare il valore critico t al 2,5% (0,025).
Concettualmente, tutti gli intervalli si esprimono come segue:

Osserva che in tutti i casi, maggiore è l’errore, più ampio è l’intervallo. Questo errore si calcola in modo diverso a seconda del caso d’uso. Nell’inferenza l’errore è la deviazione standard. Nella regressione, l’errore è mostrato nelle prossime sezioni.
Quando prevedi il valore medio della variabile dipendente, ne stimi l’intervallo tramite l’intervallo di confidenza. Ad esempio, vuoi prevedere un intervallo per il peso medio dei cani di 2 anni in funzione dell’età. Questo è chiamato intervallo di confidenza della risposta media. È considerato anche un parametro di popolazione perché è una proprietà dell’intera popolazione. L’intervallo è espresso come:
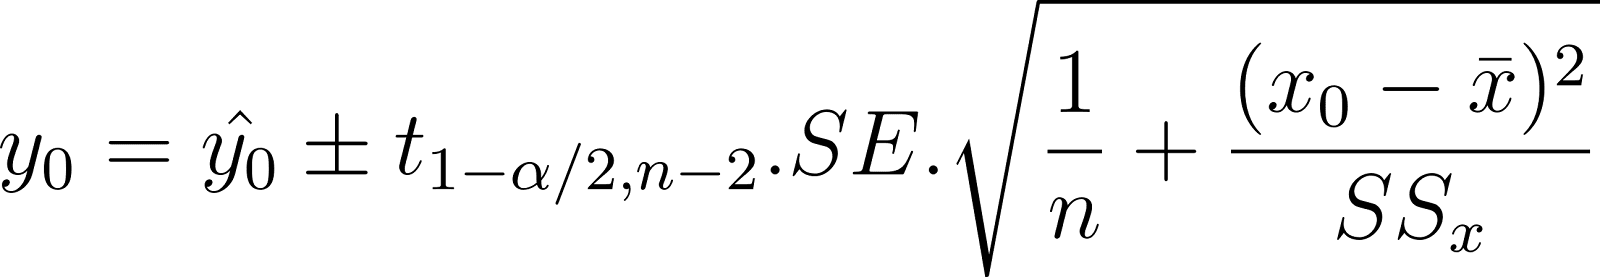
Nella formula sopra:


Nella formula sopra, il termine di sommatoria è detto anche somma dei quadrati dei residui. Il residuo è la differenza tra il valore reale di y e il valore previsto di y.
Usando l’MSE invece dell’SE, l’intervallo di confidenza della risposta media può anche essere scritto come:
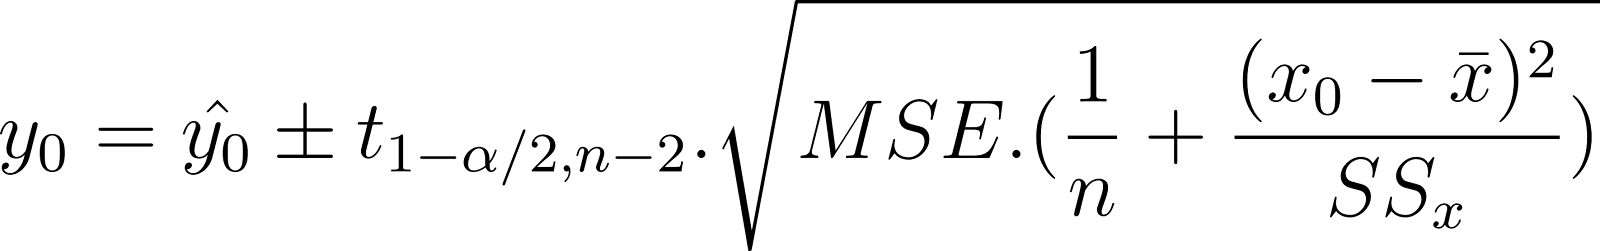
Confronta l’espressione sopra con la relazione concettuale mostrata prima.
Osserva che l’errore tiene conto di:
Per prevedere il valore esatto di un singolo punto dato (non la media), ne stimi l’intervallo usando l’intervallo di predizione. Ad esempio, vuoi prevedere l’intervallo per il peso reale di uno specifico cane di 2 anni in funzione dell’età. Questo è chiamato intervallo di predizione ed è espresso come:
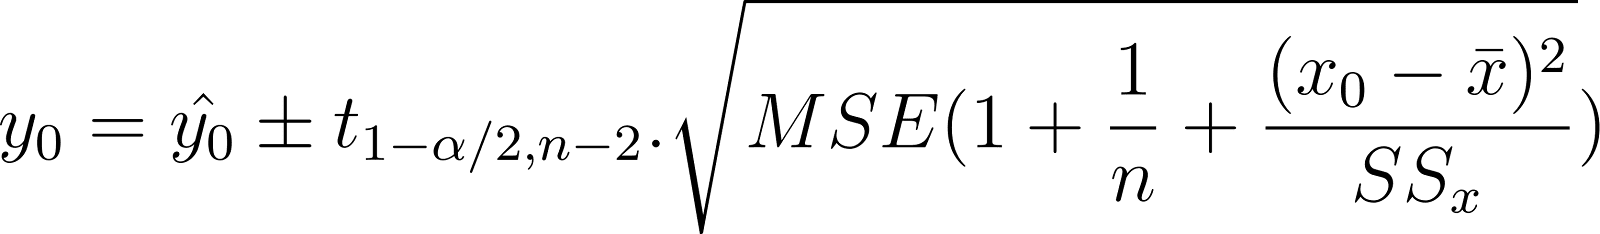
Confrontalo con l’intervallo di confidenza mostrato prima:
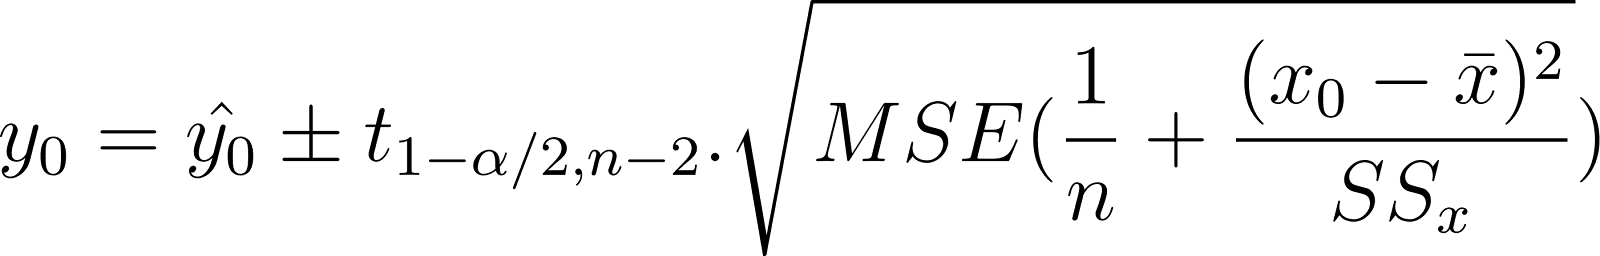
Nota che entrambe le espressioni sono molto simili. L’unica differenza è il termine di errore aggiuntivo nell’intervallo di predizione. L’intervallo di predizione ha un termine MSE aggiuntivo all’interno della radice quadrata rispetto all’intervallo di confidenza. Questo per tenere conto della variabilità nei valori di y che vuoi prevedere. Questo rende l’intervallo di predizione più ampio dell’intervallo di confidenza.
Lo schema seguente mostra gli intervalli di confidenza e di predizione in relazione alla stima puntuale (valore previsto).
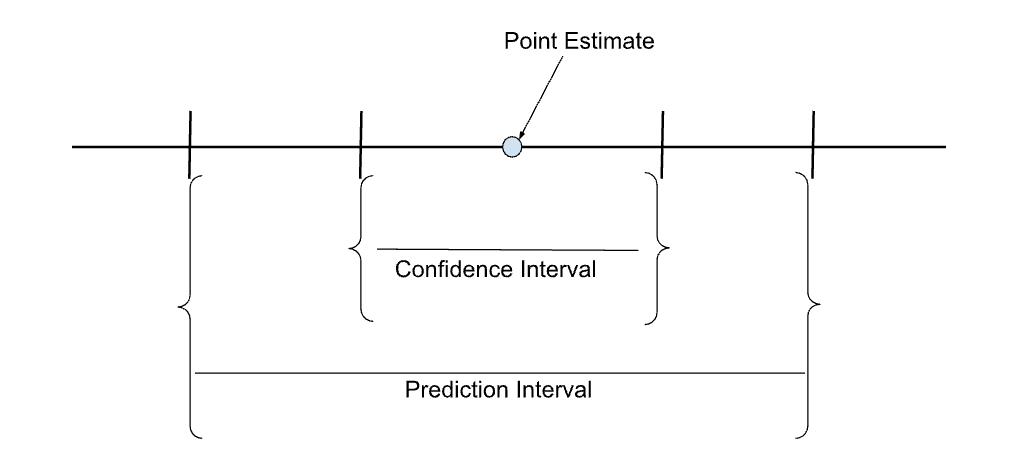
Confronto tra intervalli di confidenza e di predizione di una stima puntuale. Immagine dell’autore.
Lo schizzo schematico sotto mostra gli intervalli di confidenza e di predizione in relazione alla regressione: nota anche che gli intervalli sono più stretti nella regione della media.
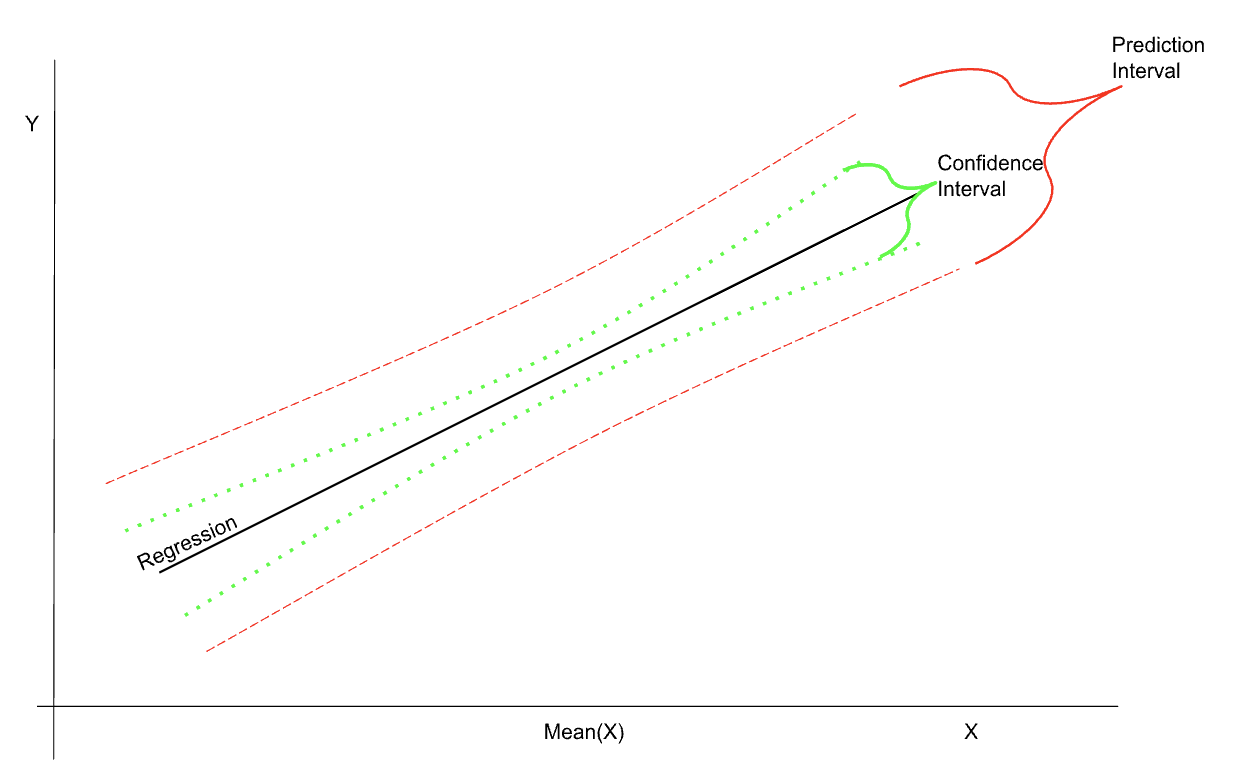
Illustrazione degli intervalli di confidenza e di predizione nella regressione. Immagine dell’autore.
Le sezioni precedenti hanno discusso le basi degli intervalli di confidenza e di predizione, i loro usi e le formule per calcolarli. Questa sezione offre esempi pratici di quando usare intervalli di confidenza e di predizione.
Un intervallo di confidenza si usa quando si stima un parametro di popolazione. Per stimarlo puoi:
Alcuni esempi d’uso dell’intervallo di confidenza sono:
Gli intervalli di predizione si usano ogni volta che prevedi il valore atteso di un singolo dato sulla base di osservazioni (e analisi di regressione) su un campione casuale.
Alcuni esempi pratici includono:
Intervalli di confidenza e di predizione sono spesso usati nello stesso contesto: è quindi importante capire come differiscono.
Questa tabella riassume le differenze sulla base della discussione nelle sezioni precedenti:
|
Intervallo di confidenza |
Intervallo di predizione |
|
Usato per determinare parametri di popolazione a partire da statistiche campionarie |
Non usato per determinare parametri di popolazione a partire da campioni |
|
Usato per prevedere la risposta media (valore medio della variabile dipendente per una data variabile indipendente) sulla base di regressioni. |
Usato per prevedere il valore futuro (di un singolo punto dato per una data variabile indipendente) sulla base di regressioni. |
|
Di solito più stretto per una data analisi |
Di solito più ampio per una data analisi |
Questa sezione mostra esempi pratici di utilizzo del linguaggio R per stimare intervalli di confidenza e di predizione. R è un linguaggio progettato per applicazioni statistiche e include dataset e funzioni statistiche integrate.
Per saperne di più sulle regressioni in R, segui il tutorial sulle regressioni lineari in R di DataCamp.
Gli esempi qui sotto usano il dataset integrato Orange. Questo dataset traccia la circonferenza (in millimetri) e l’età (in giorni) degli aranci. Naturalmente, ci si aspetta che più l’albero è vecchio, maggiore è la sua circonferenza.
Gli esempi seguenti mostrano come stimare intervalli di confidenza per statistiche di sintesi e analisi di regressione.
Per ottenere l’intervallo di confidenza per la media, esegui il T‑test standard usando la funzione t.test() sul dataset:
t.test(Orange$circumference)L’output è simile all’esempio seguente:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
   96.10926 135.60502
sample estimates:
mean of x
   115.8571
Ti fornisce la media stimata e l’intervallo di confidenza al 95%. Per impostazione predefinita, la funzione T‑Test usa un livello di confidenza del 95%. Usa il parametro conf.level per specificare un intervallo diverso, ad esempio 99%.
> t.test(Orange$circumference, conf.level = 0.99)Questo comando produce il seguente output:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
   89.34458 142.36970
sample estimates:
mean of x
   115.8571
Nota che la media stimata è la stessa in entrambi i casi. Tuttavia, per avere un livello di confidenza più alto, l’intervallo deve essere più ampio. In base ai dati, sono confidente al 99% che la media sia tra 89,3 e 142,4, ma solo al 95% che sia tra 96,1 e 135,6. Per un parametro stimato da un dato campione, più stretto è l’intervallo di confidenza, più basso è il livello di confidenza.
Nelle analisi di regressione, ti servono gli intervalli di confidenza per i coefficienti di regressione e per i valori previsti.
Per capire in profondità come fare regressioni in R, segui il corso sull’inferenza per la regressione lineare in R di DataCamp.
I coefficienti di regressione sono stimati analizzando un campione casuale. Quindi non sono i veri coefficienti dell’intera popolazione. Le stime dei parametri di regressione hanno associati degli errori. Oltre ai valori stimati, è utile fornire un intervallo di confidenza per i parametri.
Usa la funzione lm() per costruire un modello lineare basato sul dataset Orange per prevedere la circonferenza (in mm) degli aranci data la loro età (in giorni):
model_orange <- lm(circumference ~ age, data = Orange)Controlla i coefficienti di questo modello lineare:
model_orangeQuesto comando mostra i parametri del modello (intercetta e pendenza) come sotto:
Coefficients: (Intercept)          age
                              17.3997       0.1068
Usa la funzione confint() per calcolare gli intervalli di confidenza al 95%:
confint(model_orange, level = 0.95)Ora puoi vedere gli intervalli di confidenza al 95% della pendenza e dell’intercetta stimati dal modello:
                          2.5 %                   97.5 %
(Intercept)     -0.14328303       34.9425835
age 0.08993141 0.1236092Usa il modello di regressione creato sopra per prevedere la circonferenza media attesa di alberi di 900 giorni. Usa il parametro interval per specificare un intervallo di confidenza.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) L’output include la previsione (fit) e l’intervallo di confidenza (lwr e upr per i limiti inferiore e superiore), come mostrato sotto:
       fit                    lwr              upr
1 113.4929 105.3211 121.6647Usa lo stesso modello di sopra per prevedere la circonferenza specifica di un singolo arancio di 900 giorni. Usa il parametro interval per specificare che vuoi l’intervallo di predizione.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) L’output è simile all’esempio sotto:
       fit                    lwr              upr
1      113.4929        64.5118        162.4741
Nota che in entrambi i casi il valore previsto della circonferenza è lo stesso, 113,49. Tuttavia, l’intervallo di predizione è molto più ampio dell’intervallo di confidenza. L’intervallo di confidenza della previsione è l’intervallo che ci si aspetta contenga la circonferenza media degli alberi di 900 giorni. L’intervallo di predizione è l’intervallo atteso della circonferenza di un singolo albero di 900 giorni. Questo perché può esserci una variabilità considerevolmente maggiore tra i singoli alberi, che si attenua quando si considera il valore medio.
Gli intervalli statistici sono comunemente usati in campi applicati come l’analisi dei dati, la farmaceutica, l’econometria, ecc. Per chi non ha un background accademico in statistica, è facile confondere intervalli di confidenza e intervalli di predizione.
Di seguito sono discussi alcuni fraintendimenti comuni:
Questo articolo ha fornito una panoramica degli intervalli di confidenza e degli intervalli di predizione. Ha anche spiegato la differenza tra questi concetti dal suono simile e offerto esempi pratici di quando usare ciascun tipo di intervallo. L’articolo ha inoltre mostrato come calcolare intervalli di predizione e di confidenza utilizzando il linguaggio R.
Per imparare ad applicare formule statistiche con Python, consulta il corso di DataCamp sulla statistica in Python. Infine, se ti stai preparando per colloqui di lavoro che includono la statistica, dai un’occhiata al corso di DataCamp sulle domande di colloquio di statistica in Python.
Approfondisci statistica e data science con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



