
प्रेडिक्शन इंटरवल और कॉन्फिडेंस इंटरवल में अंतर
ये दोनों अवधारणाएँ—प्रेडिक्शन इंटरवल और कॉन्फिडेंस इंटरवल—काफी संबंधित हैं। एक ही विश्लेषण में अक्सर दोनों प्रकार के इंटरवल का उपयोग हो सकता है। इसलिए, इन्हें आमने-सामने तुलना करना उपयोगी है।
उद्देश्य और व्याख्या
जब आपको किसी जनसंख्या पैरामीटर, जैसे औसत, का मान चाहिए, तो आप इस पैरामीटर का अनुमान लगाने के लिए नमूना लेते हैं। क्योंकि नमूना आकार सामान्यतः जनसंख्या से बहुत छोटा होता है, नमूने का पैरामीटर अनुमान अपूर्ण होता है। कॉन्फिडेंस इंटरवल वह दायरा है (नमूना अनुमान के आसपास) जिसमें जनसंख्या पैरामीटर आने की अपेक्षा होती है।
रिग्रेशन गुणांक भी जनसंख्या पैरामीटर माने जाते हैं। क्योंकि वे पूरे जनसंख्या के बजाय नमूने पर आधारित होकर अनुमानित होते हैं, इन पैरामीटर में कुछ त्रुटि निहित होती है। अतः रिग्रेशन गुणांकों को भी कॉन्फिडेंस इंटरवल के साथ प्रकट किया जा सकता है।
इसके अलावा, आप रिग्रेशन का उपयोग दो में से किसी एक के लिए कर सकते हैं:
- आश्रित चर का औसत मान (जैसे 2-वर्षीय कुत्तों का औसत वजन) या
- किसी व्यक्तिगत डेटा बिंदु का मान (जैसे कोई विशिष्ट 2-वर्षीय कुत्ता)।
पहले मामले में कॉन्फिडेंस इंटरवल और दूसरे में प्रेडिक्शन इंटरवल का उपयोग होता है। अगले खंड में इस अंतर को और विस्तार से समझाया गया है।
गणना और इंटरवल की चौड़ाई
सांख्यिकीय अनुमान के लिए कॉन्फिडेंस इंटरवल की गणना
जैसा पहले बताया गया, कॉन्फिडेंस इंटरवल मानक विचलन के अनुक्रमानुपाती और नमूना आकार के व्युत्क्रमानुपाती होता है। जनसंख्या औसत 𝛍 का कॉन्फिडेंस इंटरवल इस प्रकार व्यक्त किया जाता है:
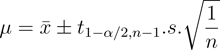
उपरोक्त निरूपण में:
- x नमूना औसत है, यानी वह अनुमान जिसे आप माप सकते हैं
- 𝛍 जनसंख्या औसत है, यानी वह जनसंख्या पैरामीटर जिसे आप अनुमानित करना चाहते हैं।
- n नमूना आकार है
- s नमूना मानक विचलन है
- t Student की T-वितरण का क्रिटिकल मान है,
- महत्त्व स्तर 1 - α पर
- n-1 डिग्री स्वतंत्रता के साथ
- मानक सारिणियों में T-मूल्य मिल जाते हैं—बस “Student’s T table” खोजें।
अतः 𝛍 का दायरा इस प्रकार है:
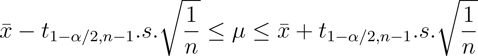
कॉन्फिडेंस स्तर और महत्त्व स्तर समझना
ध्यान दें कि इंटरवल का आकार t-मूल्य के अनुक्रमानुपाती है। यदि आप बहुत उच्च स्तर का विश्वास (निश्चितता) चाहते हैं कि वास्तविक मान दिए गए दायरे में है, तो वह दायरा बहुत बड़ा होना चाहिए। विश्वास का स्तर जितना कम होगा, इंटरवल उतना ही संकरा होगा। लेकिन बहुत कम विश्वास स्तर व्यावहारिक नहीं होता। इसलिए सामान्यतः 90%, 95%, 99% आदि कॉन्फिडेंस स्तर चुने जाते हैं।
यदि आपका कॉन्फिडेंस स्तर 95% है, तो महत्त्व स्तर 5% होता है। दो-तरफा इंटरवल मानते हुए, आपको 2.5% (0.025) पर t-क्रिटिकल मान खोजना होगा।
सैद्धांतिक रूप से, सभी इंटरवल इस प्रकार व्यक्त होते हैं:

देखें कि हर मामले में त्रुटि जितनी बड़ी होगी, इंटरवल उतना ही चौड़ा होगा। यह त्रुटि उपयोग-प्रकरण के अनुसार अलग तरह से निकाली जाती है। अनुमान में, त्रुटि मानक विचलन है। रिग्रेशन के लिए, त्रुटि अगले खंडों में दिखाई गई है।
रिग्रेशन के लिए कॉन्फिडेंस इंटरवल की गणना
जब आप आश्रित चर के औसत मान की भविष्यवाणी करते हैं, तो उसके दायरे का अनुमान कॉन्फिडेंस इंटरवल से लगाते हैं। उदाहरण के लिए, आप आयु के आधार पर 2-वर्षीय कुत्तों के औसत वजन का दायरा अनुमानित करना चाहते हैं। इसे mean response का कॉन्फिडेंस इंटरवल कहा जाता है। इसे जनसंख्या पैरामीटर भी माना जाता है क्योंकि यह पूरी जनसंख्या का गुण है। इंटरवल इस प्रकार व्यक्त होता है:
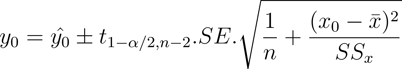
उपरोक्त निरूपण में:
- y0 भविष्यवाणी किए गए पैरामीटर का वास्तविक मान है।
- y0 रिग्रेशन संबंध का उपयोग करके भविष्यवाणी किया गया मान है।
- क्रिटिकल t-मूल्य पिछली धारा में समझाया गया है
- n नमूना आकार है
- (x0 - x) x के औसत मान और x0 (जिसके लिए आप y0 की भविष्यवाणी करना चाहते हैं) के बीच का अंतर है। ध्यान दें कि यह अंतर जितना बड़ा होगा, इंटरवल उतना ही बड़ा होगा। अतः नमूना औसत के करीब x के मानों के लिए आपको संकरे इंटरवल (और अधिक सटीक भविष्यवाणी) मिलती है।
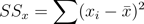
- SSx x मानों के नमूने का वर्ग विचलन है। इसे इस प्रकार व्यक्त किया जाता है:
- SE अनुमान की मानक त्रुटि है। यह mean square error (MSE) का वर्गमूल है। MSE त्रुटि का विचरण है। अतः SE, त्रुटि के मानक विचलन के समरूप है। MSE अवशिष्ट त्रुटि पर आधारित होता है। इसे इस प्रकार व्यक्त किया जाता है:
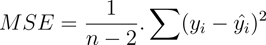
उपरोक्त निरूपण में, सिग्मा का योगफल पद अवशिष्टों के वर्गों के योग के रूप में भी जाना जाता है। अवशिष्ट y के वास्तविक मान और y के अनुमानित मान के बीच का अंतर है।
SE के बजाय MSE का उपयोग करके, mean response का कॉन्फिडेंस इंटरवल इस तरह भी लिखा जा सकता है:
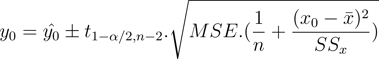
ऊपर के निरूपण की तुलना पहले दिखाए गए सैद्धांतिक संबंध से करें।
ध्यान दें कि त्रुटि में शामिल हैं:
- y के वास्तविक और अनुमानित मानों के बीच का अंतर।
- x के औसत मान और उस x के मान के बीच का अंतर xo, जिसके लिए आप भविष्यवाणी करना चाहते हैं
- x मानों का समग्र प्रसरण (उनके औसत के सापेक्ष)
रिग्रेशन के लिए प्रेडिक्शन इंटरवल की गणना
किसी व्यक्तिगत डेटा बिंदु (औसत नहीं) का सटीक मान भविष्यवाणी करने के लिए, उसके दायरे का अनुमान प्रेडिक्शन इंटरवल से लगाते हैं। उदाहरण के लिए, आप आयु के आधार पर किसी एक विशिष्ट 2-वर्षीय कुत्ते के वास्तविक वजन का दायरा अनुमानित करना चाहते हैं। इसे प्रेडिक्शन इंटरवल कहते हैं, और यह इस प्रकार व्यक्त होता है:
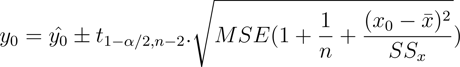
इसे पहले दिखाए गए कॉन्फिडेंस इंटरवल से तुलना करें:
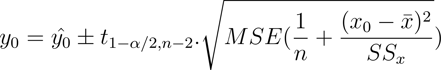
ध्यान दें कि दोनों निरूपण काफी समान हैं। अंतर केवल यह है कि प्रेडिक्शन इंटरवल में एक अतिरिक्त त्रुटि पद होता है। प्रेडिक्शन इंटरवल में वर्गमूल के भीतर कॉन्फिडेंस इंटरवल की तुलना में अतिरिक्त MSE पद होता है। यह y मानों की परिवर्तनशीलता का हिसाब रखने के लिए है, जिनकी आप भविष्यवाणी करना चाहते हैं। इससे प्रेडिक्शन इंटरवल, कॉन्फिडेंस इंटरवल से चौड़ा हो जाता है।
नीचे का स्केच बिंदु अनुमान (अनुमानित मान) के संबंध में कॉन्फिडेंस और प्रेडिक्शन इंटरवल दिखाता है।
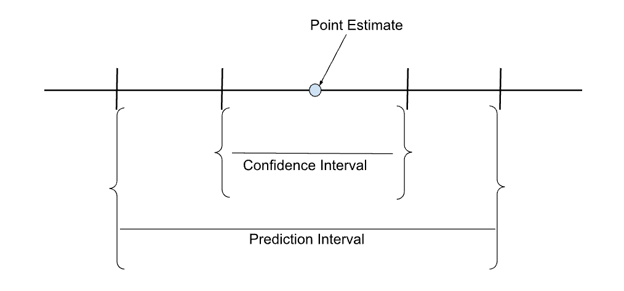
बिंदु अनुमान के कॉन्फिडेंस और प्रेडिक्शन इंटरवल की तुलना। लेखक द्वारा छवि।
नीचे की योजनाबद्ध आकृति रिग्रेशन के संदर्भ में कॉन्फिडेंस और प्रेडिक्शन इंटरवल दिखाती है—ध्यान दें कि औसत के आसपास इंटरवल सबसे संकरे होते हैं।
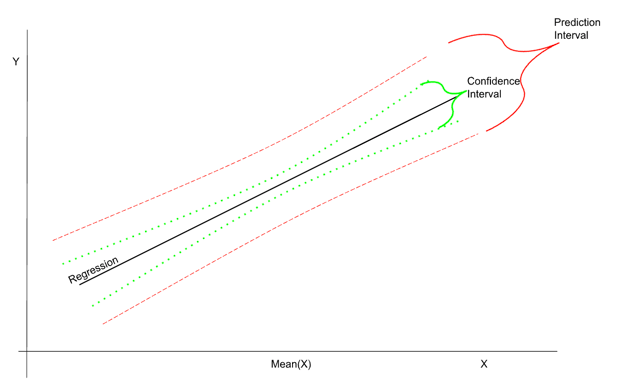
रिग्रेशन में कॉन्फिडेंस और प्रेडिक्शन इंटरवल का चित्रण। लेखक द्वारा छवि।
कॉन्फिडेंस इंटरवल का उपयोग कब करें
पिछले खंडों में कॉन्फिडेंस और प्रेडिक्शन इंटरवल, उनके उपयोग और उन्हें निकालने के सूत्रों की बुनियाद पर चर्चा हुई। इस खंड में बताया गया है कि व्यवहार में इन्हें कब उपयोग करना चाहिए।
कॉन्फिडेंस इंटरवल का उपयोग तब होता है जब आप किसी जनसंख्या पैरामीटर का अनुमान लगा रहे हों। जनसंख्या पैरामीटर का अनुमान लगाने के लिए, आप या तो:
- यादृच्छिक नमूने पर आधारित प्रत्यक्ष माप का उपयोग करें
- यादृच्छिक नमूने पर आधारित रिग्रेशन मॉडल का उपयोग करें
कॉन्फिडेंस इंटरवल के कुछ उपयोग मामलों के उदाहरण:
- यादृच्छिक नमूना मापकर जनसंख्या पैरामीटर का अनुमान लगाना। जैसे, नवजात शिशुओं की औसत लंबाई और वजन का अनुमान लगाने के लिए आप नवजातों के यादृच्छिक नमूने के माप लेते हैं।
- यादृच्छिक नमूना का अध्ययन करके किसी जनसंख्या के व्यवहार का अनुमान लगाना। यह उपयोग मामला नैदानिक परीक्षणों में आम है, जहाँ आप यादृच्छिक नमूने पर दवा के प्रभाव का अध्ययन करके पूरी जनसंख्या पर उसके प्रभाव का अनुमान लगाते हैं।
- यादृच्छिक नमूने पर किए गए रिग्रेशन के आधार पर आश्रित चर की mean response की भविष्यवाणी करना। उदाहरण के लिए, आप हर 15 दिन पर मापे गए पिल्लों के नमूने के आधार पर 55-दिन पुराने पिल्लों के औसत वजन की भविष्यवाणी करना चाहते हैं।
- निर्माण प्रक्रियाओं में टॉलरेंस लिमिट निर्धारित करना। उदाहरण के लिए, यदि कोई मशीन एक निर्दिष्ट वजन के पुर्जे बनाती है, तो हर पुर्जे का वजन स्पेसिफिकेशन के बिल्कुल बराबर नहीं होता। प्रत्येक पुर्जे का वजन निर्दिष्ट वजन के कॉन्फिडेंस इंटरवल के भीतर होता है। यही इंटरवल टॉलरेंस लिमिट है। जिन पुर्जों का वजन टॉलरेंस लिमिट से बाहर होता है, उन्हें खारिज कर दिया जाता है। मशीन से अपेक्षा होती है कि वह अधिकांश पुर्जे टॉलरेंस लिमिट के भीतर बनाए।
- गुणवत्ता नियंत्रण। मान लीजिए आप स्थापित करना चाहते हैं कि किसी मशीन द्वारा बनाए गए पुर्जे टॉलरेंस लिमिट के भीतर हैं। हर पुर्जे को मापना संभव नहीं। आपको यादृच्छिक नमूने लेने, उन्हें मापने, और फिर नमूना अनुमानों का उपयोग करके जनसंख्या पैरामीटर का आकलन करने पर निर्भर रहना होगा।
- परिकल्पनाओं का परीक्षण। कॉन्फिडेंस स्तर और महत्त्व स्तर एक ही सिक्के के दो पहलू हैं। महत्त्व स्तर = 1 - कॉन्फिडेंस स्तर। किसी निर्दिष्ट कॉन्फिडेंस स्तर वाला कॉन्फिडेंस इंटरवल उन डेटा बिंदुओं को समाहित करता है जिनके लिए शून्य परिकल्पना (1 - निर्दिष्ट कॉन्फिडेंस स्तर) के महत्त्व स्तर पर सत्य होती है।
प्रेडिक्शन इंटरवल का उपयोग कब करें
जब भी आप यादृच्छिक नमूने के अवलोकनों (और उन पर किए गए रिग्रेशन विश्लेषण) के आधार पर किसी व्यक्तिगत डेटा बिंदु के अपेक्षित मान की भविष्यवाणी करते हैं, तब प्रेडिक्शन इंटरवल उपयोग में आता है।
कुछ व्यावहारिक उदाहरण:
- रिग्रेशन विश्लेषण के आधार पर किसी व्यक्तिगत डेटा बिंदु के दायरे की भविष्यवाणी करना। क्योंकि व्यक्तिगत डेटा बिंदुओं में (नमूना औसत की तुलना में) अधिक परिवर्तनशीलता हो सकती है, प्रेडिक्शन इंटरवल का दायरा व्यापक चाहिए। उदाहरण के लिए, आप हर 15 दिन पर मापे गए पिल्लों के यादृच्छिक नमूने के आधार पर किसी व्यक्तिगत 55-दिन पुराने पिल्ले का वजन भविष्यवाणी करना चाहते हैं।
- अज्ञात चर के मान की भविष्यवाणी के लिए Monte Carlo सिमुलेशन का उपयोग। क्योंकि Monte Carlo विधियाँ प्रायिकत्मक होती हैं, प्रत्येक रन पर आपको थोड़ा भिन्न आउटपुट मिलता है। विभिन्न आउटपुट के बीच ये फर्क Monte Carlo Uncertainty Interval में एन्कोड होता है, जो वैचारिक रूप से प्रेडिक्शन इंटरवल जैसा ही है।
- मानक रिग्रेशन में, आप किसी पैरामीटर के औसत मान की भविष्यवाणी के लिए संबंध बनाते हैं। क्वांटाइल रिग्रेशन में, आप लक्ष्य पैरामीटर के प्रत्येक क्वांटाइल की भविष्यवाणी हेतु अलग-अलग मॉडल बनाते हैं। इससे अधिक सूक्ष्म प्रेडिक्शन इंटरवल बनाना संभव होता है।
- मशीन लर्निंग मॉडल अज्ञात पैरामीटर के मान की भविष्यवाणी से संबंधित होते हैं। ये मॉडल आमतौर पर सांख्यिकीय तरीकों पर आधारित होते हैं और इसलिए अज्ञात मात्रा का औसत मान अनुमानित करते हैं। अतः मॉडल के आउटपुट में अपेक्षित (औसत) मान और प्रेडिक्शन इंटरवल दोनों शामिल होते हैं।
- डीप लर्निंग मॉडल भविष्यवाणियाँ करने के लिए न्यूरल नेटवर्क की शृंखला का उपयोग करते हैं। आउटपुट में अनिश्चितता का आकलन करने के लिए, अलग-अलग न्यूरॉनों को यादृच्छिक रूप से ड्रॉप करना आम है ताकि आउटपुट की परिवर्तनशीलता का अध्ययन हो सके। इन भविष्यवाणियों के विचरण का उपयोग प्रेडिक्शन इंटरवल बनाने में होता है।
- टाइम सीरीज़ फोरकास्टिंग में लक्ष्य भविष्य के समय चरण में किसी प्रेक्षणीय का मान भविष्यवाणी करना होता है। भविष्यवाणियाँ आधारित होती हैं ARIMA जैसे सांख्यिकीय मॉडलों पर, जो मूविंग एवरेज पर ऑटो-रिग्रेशन करते हैं। इसलिए ये अपेक्षित मान का अनुमान लगाते हैं। वास्तविक प्रेक्षित मान अपेक्षित मान के प्रेडिक्शन इंटरवल के भीतर होते हैं। यह प्रेडिक्शन इंटरवल मानक विचलन का फलन होता है। उदाहरण के लिए, 95% कॉन्फिडेंस स्तर के लिए, प्रेडिक्शन इंटरवल अपेक्षित मान से 1.96 मानक विचलन के भीतर होता है। साथ ही, बहु-चरणीय भविष्यवाणियाँ, जिनमें लंबा फोरकास्ट क्षितिज शामिल होता है, बड़े प्रेडिक्शन इंटरवल को शामिल करती हैं। टाइम सीरीज़ के बारे में और जानने के लिए DataCamp के टाइम सीरीज़ विश्लेषण कोर्स को देखें।
कॉन्फिडेंस इंटरवल बनाम प्रेडिक्शन इंटरवल: एक सार
कॉन्फिडेंस इंटरवल और प्रेडिक्शन इंटरवल अक्सर एक ही सन्दर्भ में उपयोग होते हैं, इसलिए उनका अंतर समझना महत्वपूर्ण है।
पिछले खंडों की चर्चा के आधार पर यह तालिका अंतरों का सार देती है:
|
कॉन्फिडेंस इंटरवल |
प्रेडिक्शन इंटरवल |
|
नमूना सांख्यिकी के आधार पर जनसंख्या पैरामीटर निर्धारित करने में प्रयुक्त |
नमूनों के आधार पर जनसंख्या पैरामीटर निर्धारित करने में प्रयुक्त नहीं |
|
रिग्रेशन के आधार पर mean response (दिए गए स्वतंत्र चर के लिए आश्रित चर का औसत मान) की भविष्यवाणी करने में प्रयुक्त। |
रिग्रेशन के आधार पर भविष्य का मान (दिए गए स्वतंत्र चर के लिए किसी व्यक्तिगत डेटा बिंदु का) भविष्यवाणी करने में प्रयुक्त। |
|
किसी दिए गए विश्लेषण के लिए प्रायः संकरा |
किसी दिए गए विश्लेषण के लिए प्रायः अधिक चौड़ा |
R में कॉन्फिडेंस और प्रेडिक्शन इंटरवल लागू करना
यह खंड R प्रोग्रामिंग भाषा का उपयोग करके कॉन्फिडेंस और प्रेडिक्शन इंटरवल का अनुमान लगाने के हाथ-से-हाथ उदाहरण दिखाता है। R सांख्यिकीय अनुप्रयोगों के लिए डिज़ाइन की गई भाषा है, और यह अंतर्निर्मित डेटासेट और सांख्यिकीय फ़ंक्शनों के साथ आती है।
R का उपयोग करके रिग्रेशन के बारे में अधिक जानने के लिए DataCamp का R में रैखिक रिग्रेशन पर ट्यूटोरियल देखें।
नीचे दिए गए उदाहरण अंतर्निर्मित Orange डेटासेट का उपयोग करते हैं। यह डेटासेट संतरों के पेड़ों की परिधि (मिलीमीटर में) और आयु (दिनों में) को ट्रैक करता है। स्वाभाविक रूप से, जितना पेड़ पुराना होगा, उसकी परिधि उतनी बड़ी होने की अपेक्षा है।
R में कॉन्फिडेंस इंटरवल लागू करना
नीचे दिए उदाहरण सार-सांख्यिकी और रिग्रेशन विश्लेषण के लिए कॉन्फिडेंस इंटरवल का अनुमान कैसे लगाएँ, यह दिखाते हैं।
सार-सांख्यिकी में कॉन्फिडेंस इंटरवल
औसत के लिए कॉन्फिडेंस इंटरवल पाने हेतु, डेटासेट पर t.test() फ़ंक्शन का उपयोग करके मानक T-परीक्षण चलाएँ:
t.test(Orange$circumference)आउटपुट नीचे दिए उदाहरण जैसा दिखता है:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
96.10926 135.60502
sample estimates:
mean of x
115.8571 यह आपको औसत का अनुमान और 95% कॉन्फिडेंस इंटरवल देता है। डिफ़ॉल्ट रूप से, T-टेस्ट फ़ंक्शन 95% कॉन्फिडेंस स्तर उपयोग करता है। conf.level पैरामीटर का उपयोग करके 99% जैसा अलग कॉन्फिडेंस इंटरवल निर्दिष्ट करें।
> t.test(Orange$circumference, conf.level = 0.99)यह आदेश निम्नलिखित आउटपुट देता है:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
89.34458 142.36970
sample estimates:
mean of x
115.8571 ध्यान दें कि अनुमानित औसत दोनों ही मामलों में समान है। हालांकि, उच्चतर कॉन्फिडेंस स्तर के लिए इंटरवल अधिक चौड़ा होना चाहिए। डेटा के आधार पर, मैं 99% आश्वस्त हूँ कि औसत 89.3 और 142.4 के बीच है, लेकिन केवल 95% आश्वस्त हूँ कि वह 96.1 और 135.6 के बीच है। किसी दिए गए नमूने से अनुमानित पैरामीटर के लिए, इंटरवल जितना संकरा होगा, कॉन्फिडेंस स्तर उतना ही कम होगा।
रिग्रेशन में कॉन्फिडेंस इंटरवल
रिग्रेशन विश्लेषणों में, आपको रिग्रेशन गुणांकों और अनुमानित मानों के लिए कॉन्फिडेंस इंटरवल चाहिए।
R में रिग्रेशन कैसे करें, इसकी गहन समझ के लिए DataCamp का R में रैखिक रिग्रेशन के लिए अनुमान कोर्स देखें।
रिग्रेशन गुणांकों का कॉन्फिडेंस इंटरवल
रिग्रेशन गुणांक यादृच्छिक नमूने का विश्लेषण करके अनुमानित किए जाते हैं। इसलिए, वे पूरी जनसंख्या के वास्तविक गुणांक नहीं होते। रिग्रेशन पैरामीटरों के अनुमानों से कुछ त्रुटि जुड़ी होती है। उनके अनुमानित मानों के अतिरिक्त, पैरामीटरों के लिए कॉन्फिडेंस इंटरवल देना उपयोगी होता है।
Orange डेटासेट के आधार पर आयु (दिनों में) दिए जाने पर परिधि (मिमी में) की भविष्यवाणी करने के लिए lm() फ़ंक्शन का उपयोग कर एक रैखिक मॉडल बनाएँ:
model_orange <- lm(circumference ~ age, data = Orange)इस रैखिक मॉडल के गुणांक जाँचें:
model_orangeयह आदेश मॉडल के पैरामीटर (इंटरसेप्ट और ढाल) नीचे की तरह दिखाता है:
Coefficients: (Intercept) age
17.3997 0.1068 95% कॉन्फिडेंस इंटरवल की गणना के लिए confint() फ़ंक्शन का उपयोग करें:
confint(model_orange, level = 0.95)अब आप मॉडल द्वारा अनुमानित ढाल और इंटरसेप्ट के 95% कॉन्फिडेंस इंटरवल देख सकते हैं:
2.5 % 97.5 %
(Intercept) -0.14328303 34.9425835
age 0.08993141 0.1236092mean response भविष्यवाणी का कॉन्फिडेंस इंटरवल
ऊपर बनाए गए रिग्रेशन मॉडल का उपयोग 900-दिन पुराने पेड़ों की अपेक्षित औसत परिधि की भविष्यवाणी के लिए करें। interval पैरामीटर का उपयोग करके कॉन्फिडेंस इंटरवल निर्दिष्ट करें।
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) आउटपुट में भविष्यवाणी (fit) और कॉन्फिडेंस इंटरवल (lwr और upr क्रमशः निम्न और उच्च सीमाएँ) शामिल होते हैं, जैसा नीचे दिखाया गया है:
fit lwr upr
1 113.4929 105.3211 121.6647R में प्रेडिक्शन इंटरवल लागू करना
उसी मॉडल का उपयोग 900 दिन पुराने किसी एक व्यक्तिगत संतरे के पेड़ की परिधि की भविष्यवाणी के लिए करें। interval पैरामीटर का उपयोग करके बताइए कि आपको प्रेडिक्शन इंटरवल चाहिए।
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) आउटपुट नीचे दिए उदाहरण जैसा दिखता है:
fit lwr upr
1 113.4929 64.5118 162.4741ध्यान दें कि दोनों ही मामलों में, परिधि का अनुमानित मान समान है—113.49। हालांकि, प्रेडिक्शन इंटरवल, कॉन्फिडेंस इंटरवल की तुलना में काफी चौड़ा है। भविष्यवाणी का कॉन्फिडेंस इंटरवल वह दायरा है जिसमें 900-दिन पुराने पेड़ों की औसत परिधि आने की अपेक्षा है। प्रेडिक्शन इंटरवल किसी एक 900-दिन पुराने पेड़ की परिधि का अपेक्षित दायरा है। ऐसा इसलिए क्योंकि व्यक्तिगत पेड़ों में भिन्नता औसत मान पर विचार करने से अधिक होती है, जो औसत लेने पर स्मूद हो जाती है।
सामान्य भ्रांतियाँ और सावधानियाँ
सांख्यिकीय इंटरवलों का उपयोग डेटा विश्लेषण, फार्मास्यूटिकल्स, इकोनोमेट्रिक्स आदि जैसे अनुप्रयुक्त क्षेत्रों में आम है। जिनके पास सांख्यिकी का शैक्षणिक पृष्ठभूमि नहीं है, उनके लिए कॉन्फिडेंस इंटरवल और प्रेडिक्शन इंटरवल में भ्रम होना आसान है।
कुछ सामान्य भ्रांतियाँ नीचे चर्चा की गई हैं:
- प्रेडिक्शन इंटरवल पर विचार किए बिना भविष्यवाणी करना।
- जब आप दिए गए स्वतंत्र चर के लिए आश्रित चर का मान रिग्रेशन मॉडल से भविष्यवाणी करते हैं, तो रिग्रेशन समीकरण आपको आश्रित चर का अपेक्षित मान देता है। वास्तविक मान शायद ही कभी अपेक्षित मान से मेल खाता है, बल्कि प्रेडिक्शन इंटरवल द्वारा निर्दिष्ट किसी दायरे में आता है।
- मान लेना कि रिग्रेशन विश्लेषण में केवल प्रेडिक्शन इंटरवल शामिल होता है।
- आप रिग्रेशन मॉडलों का उपयोग दो प्रकार की भविष्यवाणियों के लिए करते हैं—1) भविष्य का मान, और 2) mean response की भविष्यवाणी। संतरे के पेड़ के उदाहरण में, आप 1) किसी विशिष्ट 900-दिन पुराने पेड़ की परिधि या 2) सभी 900-दिन पुराने पेड़ों की औसत परिधि की भविष्यवाणी करने की कोशिश कर सकते हैं। दोनों ही मामलों में अपेक्षित मान समान है। लेकिन, पहला प्रेडिक्शन इंटरवल और दूसरा कॉन्फिडेंस इंटरवल से संबंधित है।
- मान लेना कि संकरा इंटरवल ही बेहतर होता है।
- कभी-कभी आप रिग्रेशन अध्ययन के परिणाम का उपयोग करते समय केवल संकरा इंटरवल चुनने के लिए प्रेरित हो सकते हैं। कॉन्फिडेंस इंटरवल “बेहतर” नहीं है क्योंकि वह संकरा है। वह इसलिए संकरा है क्योंकि वह प्रेडिक्शन इंटरवल से अलग चीज़ के लिए दायरा देता है। विचार करें कि क्या आप आश्रित चर के औसत मान की भविष्यवाणी करना चाहते हैं या किसी व्यक्तिगत डेटा बिंदु की।
- कॉन्फिडेंस इंटरवल को प्रेडिक्शन इंटरवल समझ लेना।
- यदि आपकी भविष्यवाणी नमूने से जनसंख्या पैरामीटर निर्धारित करने या रिग्रेशन से mean response (औसत मान) की भविष्यवाणी से जुड़ी है, तो आप कॉन्फिडेंस इंटरवल का उपयोग करेंगे। यदि आप रिग्रेशन के आधार पर किसी व्यक्तिगत डेटा बिंदु का कोई गुण भविष्यवाणी करना चाहते हैं, तो प्रेडिक्शन इंटरवल का उपयोग करें।
निष्कर्ष
इस लेख में कॉन्फिडेंस इंटरवल और प्रेडिक्शन इंटरवल का अवलोकन दिया गया। इसमें इन समान-ध्वनि अवधारणाओं का अंतर भी समझाया गया और यह भी बताया गया कि किस प्रकार के इंटरवल का उपयोग कब करें। लेख में R प्रोग्रामिंग भाषा का उपयोग करके प्रेडिक्शन और कॉन्फिडेंस इंटरवल कैसे निकाले जाएँ, यह भी दिखाया गया।
Python का उपयोग करके सांख्यिकीय सूत्र कैसे लागू करें, यह जानने के लिए Python में सांख्यिकी पर DataCamp कोर्स देखें। अंत में, यदि आप सांख्यिकी से जुड़े नौकरी साक्षात्कारों की तैयारी कर रहे हैं, तो Python में सांख्यिकीय साक्षात्कार प्रश्नों पर DataCamp कोर्स देखें।
FAQs
हमें इंटरवल की जरूरत ही क्यों है? वास्तविक मान अपेक्षित मान के बराबर क्यों नहीं होता?
हमें इंटरवल इसलिए चाहिए क्योंकि सांख्यिकीय विश्लेषणों के लिए हम पूरी जनसंख्या के बजाय छोटे नमूनों का अध्ययन करने तक सीमित होते हैं। जिन नमूना गुणों का हम अध्ययन और अनुमान कर सकते हैं, वे उस जनसंख्या गुण के संकेतक होते हैं जिसे हम जानना चाहते हैं, पर वे उससे बिल्कुल बराबर नहीं होते। हालांकि, वास्तविक मान अनुमानित मान के किसी दायरे के भीतर आता है।
क्या कॉन्फिडेंस इंटरवल और प्रेडिक्शन इंटरवल एक-दूसरे के बदले उपयोग किए जा सकते हैं?
नहीं, ये बहुत अलग हैं। कॉन्फिडेंस इंटरवल जनसंख्या पैरामीटर, जैसे औसत, के दायरे को व्यक्त करता है। प्रेडिक्शन इंटरवल किसी व्यक्तिगत डेटा बिंदु के वास्तविक मान के दायरे के बारे में होता है।
क्या कॉन्फिडेंस इंटरवल और प्रेडिक्शन इंटरवल कभी एक ही सन्दर्भ में उपयोग होते हैं?
हाँ, दोनों का उपयोग रिग्रेशन अध्ययनों में होता है। आप या तो किसी डेटा बिंदु का औसत मान (जैसे 2-वर्षीय कुत्तों का औसत वजन) भविष्यवाणी करना चाहेंगे या किसी एक विशिष्ट 2-वर्षीय कुत्ते का वजन। पहले के लिए कॉन्फिडेंस इंटरवल, और दूसरे के लिए प्रेडिक्शन इंटरवल उपयोग करें।
क्या कॉन्फिडेंस और प्रेडिक्शन इंटरवल नमूना आकार पर निर्भर करते हैं?
हाँ, नमूना आकार जितना बड़ा होगा, वह जनसंख्या पैरामीटरों के लिए उतने बेहतर अनुमान देगा। इसलिए बड़े नमूने पर आधारित अनुमान का इंटरवल संकरा होगा।
क्या मैं इंटरवल के बिना नमूना अनुमान का उपयोग कर सकता/सकती हूँ?
सैद्धांतिक रूप से, हाँ। व्यवहार में, यह बहुत उपयोगी नहीं। नमूना अनुमान “अपेक्षित” मान होता है। वास्तविक मान शायद ही कभी अपेक्षित मान के बराबर होता है। लेकिन वास्तविक मान संभवतः अपेक्षित मान के आसपास किसी दायरे में आता है। इसलिए, अनुमान के साथ इंटरवल देना मानक प्रथा है। यदि आपके पास सही इंटरवल है, तो आप अपेक्षित मान के बिना भी काम चला सकते हैं।
जब आप x दिए जाने पर y की भविष्यवाणी करते हैं, तो क्या प्रेडिक्शन इंटरवल सभी x और y मानों के लिए समान होता है? कॉन्फिडेंस इंटरवल का क्या?
यह अच्छा प्रश्न है। उत्तर है नहीं। x के औसत मान से x का मान जितना दूर होगा, प्रेडिक्शन और कॉन्फिडेंस दोनों इंटरवल उतने ही चौड़े होंगे। जब x का मान x के औसत के पास होता है, तब इंटरवल सबसे संकरे होते हैं।

अरुण एक पूर्व स्टार्टअप संस्थापक हैं जो नई चीज़ें बनाना पसंद करते हैं। वे वर्तमान में कृत्रिम बुद्धिमत्ता की तकनीकी और गणितीय नींव का अन्वेषण कर रहे हैं। उन्हें जो सीखा है उसे साझा करना अच्छा लगता है, इसलिए वे इस पर लिखते हैं।
DataCamp के अलावा, आप उनके प्रकाशन Medium, Airbyte, और Vultr पर पढ़ सकते हैं।
सांख्यिकीय अध्ययन, चाहे वे जनसंख्या के पैरामीटर निर्धारित करने से जुड़े हों या आश्रित चर की भविष्यवाणी करने से, हमेशा कुछ अनिश्चितता शामिल करते हैं। इस अनिश्चितता की जड़ नमूना लेने की प्रक्रिया है। किसी सांख्यिकीय विश्लेषण के दौरान पूरी जनसंख्या पर विचार करना यथार्थवादी नहीं है। इसलिए, एक प्रतिनिधि नमूना चुनना आवश्यक है—चाहे किसी जनसंख्या पैरामीटर, जैसे औसत, का आकलन करना हो या कोई रिग्रेशन मॉडल बनाना हो।
इन बुनियादी अवधारणाओं को सीखने या दोहराने के लिए DataCamp के आंकड़ों के प्रारंभिक कोर्स को देखें।
जनसंख्या पैरामीटर का वास्तविक मान आमतौर पर नमूने से प्राप्त अनुमानित मान के बिल्कुल बराबर नहीं होता—यह अंतर मानक त्रुटि कहलाता है। इस त्रुटि का हिसाब रखने के लिए प्रचलन यह है कि अपेक्षित मान का अनुमान लगाएँ और फिर एक ऐसा दायरा निर्दिष्ट करें जिसमें वास्तविक मान के आने की अपेक्षा हो।
इसी तरह, रिग्रेशन अध्ययन भी पूरी जनसंख्या के बजाय यादृच्छिक नमूनों पर आधारित होते हैं। नमूने पर किए गए रिग्रेशन अध्ययन द्वारा आश्रित और स्वतंत्र चर के बीच अनुमानित संबंध पूरी जनसंख्या में उन चर के वास्तविक संबंध के बिल्कुल बराबर नहीं होता। इसलिए, किसी व्यक्तिगत डेटा बिंदु का अनुमानित मान उसके वास्तविक मान के बराबर नहीं होता। वास्तविक मान, अनुमानित मान के आसपास किसी दायरे में होने की अपेक्षा की जाती है।
यह लेख दोनों प्रकार के इंटरवल का अर्थ और उन्हें गणना करने के लिए प्रयुक्त गणितीय तरीकों की व्याख्या करता है। यह यह भी बताता है कि किन परिस्थितियों में किस इंटरवल का उपयोग करना चाहिए। अंत में, यह R प्रोग्रामिंग भाषा में कॉन्फिडेंस और प्रेडिक्शन इंटरवल की गणना करने के हाथ-से-हाथ उदाहरण देता है।
कॉन्फिडेंस इंटरवल क्या है?
कॉन्फिडेंस इंटरवल वह दायरा है जिसके भीतर किसी स्तर के विश्वास के साथ किसी जनसंख्या पैरामीटर, जैसे जनसंख्या औसत, का वास्तविक मान आने की अपेक्षा की जाती है।
सांख्यिकीय अनुमान में कॉन्फिडेंस इंटरवल
जनसंख्या पैरामीटर पूरी जनसंख्या का एक संख्यात्मक गुण है। पूरे जनसंख्या का औसत एक जनसंख्या पैरामीटर का उदाहरण है। दो चरों के बीच रिग्रेशन गुणांकों का वास्तविक मान भी जनसंख्या पैरामीटर का एक उदाहरण है। अनुमानी सांख्यिकी का उद्देश्य यादृच्छिक नमूने के डेटा बिंदुओं का अध्ययन करके जनसंख्या पैरामीटर का अनुमान लगाना है।
मान लीजिए आप एक उद्यान विशेषज्ञ या संतरे के किसान हैं और जानना चाहते हैं कि 100 दिन पुराने संतरों के पेड़ों की मोटाई कितनी होती है। हर एक 100-दिन पुराने पेड़ का अध्ययन करना असंभव है। इसलिए, आप यादृच्छिक रूप से कुछ 100-दिन पुराने पेड़ चुनते हैं और उनकी परिधि (मोटाई) मापते हैं। इन मापों का औसत आपको नमूना औसत देता है। आप इस नमूना औसत का उपयोग जनसंख्या औसत पाने के लिए करना चाहते हैं।
संतरे के पेड़ों की जनसंख्या। DALL-E द्वारा निर्मित।
नमूना औसत जनसंख्या पैरामीटर का एक बिंदु अनुमान है (इस मामले में, रुचि का पैरामीटर औसत है)। DataCamp का यह इन्फेरेंशियल स्टैटिस्टिक्स पर कोर्स इन अवधारणाओं पर विस्तार से चर्चा करता है।
नमूना औसत, जनसंख्या औसत का प्रतिनिधि होता है लेकिन उससे बिल्कुल बराबर नहीं होता। जनसंख्या औसत की अपेक्षा होती है कि वह नमूना औसत के आसपास एक निश्चित दायरे में हो, जिसे कॉन्फिडेंस इंटरवल कहा जाता है।
रिग्रेशन में कॉन्फिडेंस इंटरवल
पिछले खंड में इन्फेरेंशियल स्टैटिस्टिक्स में कॉन्फिडेंस इंटरवल की व्याख्या की गई थी। रिग्रेशन में भी कॉन्फिडेंस इंटरवल का उपयोग होता है।
उसी संतरे के पेड़ों के उदाहरण का एक रूपांतर मानें:
आप यह रिग्रेशन विश्लेषण का उपयोग करके करते हैं। जिस डेटासेट पर आप रिग्रेशन चलाते हैं, वह संतरे के पेड़ों के एक नमूने पर आधारित है। इसलिए, अनुमानित नमूना औसत (100-दिन पुराने पेड़ों की औसत परिधि) जनसंख्या औसत के बिल्कुल बराबर नहीं होगा। जनसंख्या औसत का वास्तविक मान, अनुमानित नमूना औसत के कॉन्फिडेंस इंटरवल के भीतर होगा।
आगे के खंडों में कॉन्फिडेंस इंटरवल के गणितीय निरूपण दिखाए और समझाए गए हैं।
प्रेडिक्शन इंटरवल क्या है?
प्रेडिक्शन इंटरवल वह दायरा है जिसके भीतर किसी स्तर के विश्वास के साथ, रिग्रेशन विश्लेषण से की गई भविष्यवाणी के आधार पर, किसी व्यक्तिगत डेटा बिंदु का वास्तविक मान आने की अपेक्षा की जाती है।
पहले बताए गए रिग्रेशन उदाहरण का एक और रूपांतर मानें:
आप पहले जैसा ही रिग्रेशन सूत्र उपयोग करते हैं। व्यक्तिगत परिधि का अनुमानित मान (अर्थात अपेक्षित मान) अनुमानित औसत परिधि के समान होता है। हालांकि, चूंकि आप औसत नहीं बल्कि व्यक्तिगत मान का अनुमान लगा रहे हैं, इसलिए व्यक्तिगत डेटा बिंदुओं की अधिक परिवर्तनशीलता का हिसाब रखना होगा। अतः, प्रेडिक्शन इंटरवल, कॉन्फिडेंस इंटरवल से बड़ा होता है।
लेख के आगे आप इन इंटरवल के सूत्र देखेंगे और R में उन्हें कैसे निकाला जाता है, यह सीखेंगे।