
Sự khác nhau giữa Khoảng dự đoán và Khoảng tin cậy
Hai khái niệm — khoảng dự đoán và khoảng tin cậy — có liên quan chặt chẽ. Cùng một phân tích thường có thể dùng cả hai loại khoảng. Vì vậy, so sánh trực tiếp sẽ hữu ích.
Mục đích và cách diễn giải
Khi bạn cần biết một tham số tổng thể, như trung bình, bạn dùng một mẫu để ước lượng tham số này. Vì kích thước mẫu thường nhỏ hơn nhiều so với tổng thể, ước lượng tham số từ mẫu là không hoàn hảo. Khoảng tin cậy là khoảng (quanh ước lượng từ mẫu) được kỳ vọng sẽ chứa tham số tổng thể.
Các hệ số hồi quy cũng được xem là tham số tổng thể. Vì chúng được ước lượng dựa trên mẫu (không phải toàn bộ tổng thể), một phần sai số vốn có nằm trong các tham số này. Do đó, hệ số hồi quy cũng có thể được biểu diễn kèm khoảng tin cậy.
Hơn nữa, bạn có thể dùng hồi quy để dự đoán:
- Giá trị trung bình của biến phụ thuộc (như cân nặng trung bình của chó 2 tuổi) hoặc
- Giá trị của một điểm dữ liệu riêng lẻ (như một chú chó 2 tuổi cụ thể).
Trường hợp thứ nhất dùng khoảng tin cậy, còn trường hợp thứ hai dùng khoảng dự đoán. Phần tiếp theo giải thích chi tiết hơn sự khác biệt này.
Cách tính và độ rộng của khoảng
Tính khoảng tin cậy trong suy luận thống kê
Như đã giải thích, khoảng tin cậy tỷ lệ thuận với độ lệch chuẩn và tỷ lệ nghịch với kích thước mẫu. Khoảng tin cậy của trung bình tổng thể, 𝛍, được biểu diễn như sau:
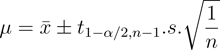
Trong biểu thức trên:
- x là trung bình mẫu, ước lượng bạn có thể đo được
- 𝛍 là trung bình tổng thể, tham số tổng thể bạn muốn ước lượng.
- n là kích thước mẫu
- s là độ lệch chuẩn mẫu
- t là giá trị tới hạn của phân phối Student’s T tại
- Mức ý nghĩa 1 - α
- n-1 bậc tự do
- Bạn có thể tra các giá trị T từ bảng chuẩn hóa — chỉ cần tìm “Student’s T table”.
Vì vậy, khoảng của 𝛍 là:
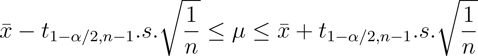
Hiểu mức độ tin cậy và mức ý nghĩa
Cũng lưu ý rằng độ rộng của khoảng tỷ lệ thuận với giá trị t. Nếu bạn muốn mức độ tin cậy (chắc chắn) cực cao rằng giá trị thực nằm trong khoảng cho trước, thì khoảng đó phải rất lớn. Độ tin cậy càng thấp, khoảng càng hẹp. Nhưng độ tin cậy quá thấp thì không hữu ích. Vì vậy, trong thực tế, thường chọn mức tin cậy 90%, 95%, 99%, v.v.
Nếu bạn có mức tin cậy 95%, nó dẫn đến mức ý nghĩa 5%. Giả sử khoảng hai phía, bạn cần tìm giá trị t-tới hạn tại 2,5% (0,025).
Về mặt khái niệm, mọi khoảng đều được biểu diễn như sau:

Lưu ý rằng trong mọi trường hợp, sai số càng lớn, khoảng càng rộng. Sai số này được tính khác nhau tùy trường hợp sử dụng. Với suy luận, sai số là độ lệch chuẩn. Với hồi quy, sai số được trình bày ở các phần sau.
Tính khoảng tin cậy cho hồi quy
Khi bạn dự đoán giá trị trung bình của biến phụ thuộc, bạn ước lượng khoảng của nó bằng khoảng tin cậy. Ví dụ, bạn muốn dự đoán khoảng cân nặng trung bình của chó 2 tuổi dựa trên tuổi. Đây được gọi là khoảng tin cậy của phản hồi trung bình. Nó cũng được xem là tham số tổng thể vì là thuộc tính của toàn bộ tổng thể. Khoảng được biểu diễn như sau:
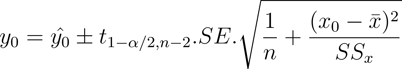
Trong biểu thức trên:
- y0 là giá trị thực của tham số được dự đoán.
- y0 là giá trị được dự đoán bằng quan hệ hồi quy.
- Giá trị t tới hạn đã được giải thích ở phần trước
- n là kích thước mẫu
- (x0 - x) là độ chênh giữa giá trị trung bình của x và x0, tại đó bạn đang cố dự đoán y0. Lưu ý độ chênh này càng lớn, khoảng càng rộng. Vì vậy, bạn nhận được khoảng hẹp (và dự đoán chính xác hơn) cho các giá trị x gần trung bình mẫu.
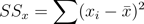
- SSx là tổng bình phương độ lệch của mẫu các giá trị x. Biểu diễn như sau:
- SE là sai số chuẩn của ước lượng. Nó là căn bậc hai của sai số bình phương trung bình (MSE). MSE là phương sai của sai số. Vì vậy, SE tương tự như độ lệch chuẩn của sai số. MSE dựa trên sai số dư. Nó được biểu diễn như sau:
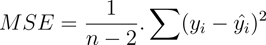
Trong biểu thức trên, hạng tổng cũng được gọi là tổng bình phương sai số dư. Sai số dư là độ chênh giữa giá trị thực của y và giá trị dự đoán của y.
Dùng MSE thay vì SE, khoảng tin cậy của phản hồi trung bình cũng có thể viết như sau:
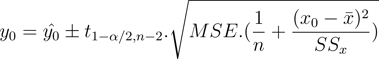
Hãy so sánh biểu thức trên với quan hệ khái niệm đã nêu trước đó.
Lưu ý rằng sai số tính đến:
- Độ chênh giữa giá trị thực và giá trị dự đoán của y.
- Độ chênh giữa giá trị trung bình của x và giá trị xo, tại đó bạn muốn tạo dự đoán
- Mức phân tán tổng thể của các giá trị x (so với trung bình của chúng)
Tính khoảng dự đoán cho hồi quy
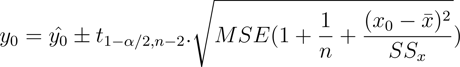
Để dự đoán giá trị chính xác của một điểm dữ liệu riêng lẻ (không phải giá trị trung bình), bạn ước lượng khoảng của nó bằng khoảng dự đoán. Ví dụ, bạn muốn dự đoán khoảng cân nặng thực của một chú chó 2 tuổi cụ thể dựa trên tuổi. Đây được gọi là khoảng dự đoán và được biểu diễn như sau:
So sánh điều này với khoảng tin cậy đã trình bày trước đó:
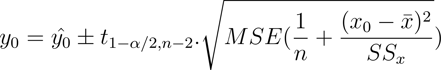
Lưu ý rằng cả hai biểu thức khá giống nhau. Điểm khác biệt duy nhất là hạng sai số bổ sung trong khoảng dự đoán. Khoảng dự đoán có thêm một hạng MSE bên trong căn bậc hai so với khoảng tin cậy. Điều này nhằm tính đến độ biến thiên ở các giá trị y mà bạn muốn dự đoán. Vì vậy khoảng dự đoán rộng hơn khoảng tin cậy.
Hình minh họa dưới đây cho thấy khoảng tin cậy và khoảng dự đoán so với ước lượng điểm (giá trị dự đoán).
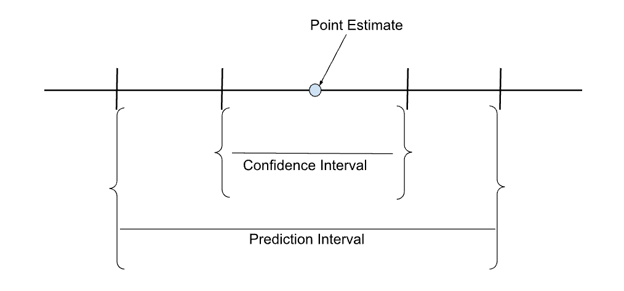
So sánh khoảng tin cậy và khoảng dự đoán của một ước lượng điểm. Hình của tác giả.
Sơ đồ dưới đây cho thấy khoảng tin cậy và khoảng dự đoán trong mối liên hệ với hồi quy — cũng lưu ý rằng các khoảng hẹp nhất ở vùng quanh trung bình.
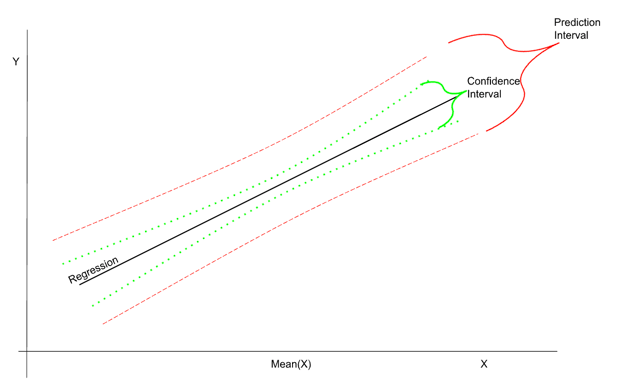
Minh họa khoảng tin cậy và khoảng dự đoán trong hồi quy. Hình của tác giả.
Khi nào dùng Khoảng tin cậy
Các phần trước đã thảo luận các kiến thức cơ bản về khoảng tin cậy và khoảng dự đoán, cách sử dụng và công thức tính. Phần này đưa ra ví dụ thực tế về thời điểm dùng khoảng tin cậy và khoảng dự đoán.
Khoảng tin cậy được dùng khi ước lượng tham số tổng thể. Để ước lượng tham số tổng thể, bạn có thể:
- Dùng đo đạc trực tiếp dựa trên một mẫu ngẫu nhiên
- Dùng mô hình hồi quy dựa trên một mẫu ngẫu nhiên
Một số ví dụ sử dụng khoảng tin cậy:
- Ước lượng tham số tổng thể dựa trên đo đạc một mẫu ngẫu nhiên. Ví dụ, để ước lượng chiều dài và cân nặng trung bình của trẻ sơ sinh, bạn đo một mẫu ngẫu nhiên các bé sơ sinh.
- Ước lượng hành vi của một tổng thể bằng cách nghiên cứu một mẫu ngẫu nhiên. Trường hợp sử dụng này phổ biến trong các thử nghiệm lâm sàng, nơi bạn cố ước lượng tác dụng của một loại thuốc lên tổng thể bằng cách nghiên cứu tác dụng của nó trên một mẫu ngẫu nhiên.
- Dự đoán phản hồi trung bình của biến phụ thuộc dựa trên phân tích hồi quy thực hiện trên một mẫu ngẫu nhiên. Chẳng hạn, bạn muốn dự đoán cân nặng trung bình của chó con 55 ngày tuổi dựa trên mẫu cân nặng chó con được đo mỗi 15 ngày.
- Thiết lập giới hạn dung sai trong quy trình sản xuất. Ví dụ, nếu một máy sản xuất các chi tiết có trọng lượng chỉ định, không phải chi tiết nào cũng có trọng lượng đúng tuyệt đối theo chỉ định. Trọng lượng của mỗi chi tiết nằm trong khoảng tin cậy quanh trọng lượng chỉ định. Khoảng này là giới hạn dung sai. Bất kỳ chi tiết nào có trọng lượng vượt ngoài giới hạn dung sai sẽ bị loại. Máy được kỳ vọng sản xuất phần lớn chi tiết nằm trong giới hạn dung sai.
- Kiểm soát chất lượng. Giả sử bạn muốn xác định liệu các chi tiết do máy sản xuất có nằm trong giới hạn dung sai hay không. Không thể đo từng chi tiết. Bạn phải dựa vào việc lấy mẫu ngẫu nhiên, đo chúng, rồi dùng ước lượng mẫu để đánh giá các tham số tổng thể.
- Kiểm định giả thuyết. Mức tin cậy và mức ý nghĩa là hai mặt của cùng một vấn đề. Mức ý nghĩa = 1 - Mức tin cậy. Một khoảng tin cậy, với mức tin cậy xác định, bao gồm những điểm dữ liệu mà giả thuyết không bị bác bỏ ở mức ý nghĩa bằng (1 - mức tin cậy xác định).
Khi nào dùng Khoảng dự đoán
Khoảng dự đoán được dùng bất cứ khi nào bạn dự đoán giá trị kỳ vọng của một điểm dữ liệu riêng lẻ dựa trên quan sát (và phân tích hồi quy) từ một mẫu ngẫu nhiên.
Một số ví dụ thực tiễn gồm:
- Dự đoán khoảng của một điểm dữ liệu riêng lẻ dựa trên phân tích hồi quy. Vì các điểm dữ liệu cá nhân có thể có độ biến thiên cao hơn (so với trung bình mẫu), bạn cần khoảng dự đoán rộng hơn. Ví dụ, bạn muốn dự đoán cân nặng của một chú chó con 55 ngày tuổi cụ thể dựa trên mẫu cân nặng chó con được đo mỗi 15 ngày.
- Bạn có thể dùng mô phỏng Monte Carlo để dự đoán giá trị của một biến chưa biết. Vì các phương pháp Monte Carlo có tính xác suất, bạn sẽ thu được đầu ra hơi khác nhau mỗi lần chạy mô hình. Những khác biệt giữa các đầu ra này được mã hóa trong Khoảng bất định Monte Carlo, về mặt khái niệm tương tự khoảng dự đoán.
- Trong hồi quy tiêu chuẩn, bạn xây dựng mối quan hệ để dự đoán giá trị trung bình của một tham số. Trong hồi quy phân vị, bạn xây dựng các mô hình khác nhau để dự đoán từng phân vị của tham số mục tiêu. Điều này cũng cho phép bạn xây dựng các khoảng dự đoán chi tiết hơn.
- Các mô hình học máy hướng tới dự đoán giá trị của một tham số chưa biết. Những mô hình này thường dựa trên phương pháp thống kê và do đó dự đoán giá trị trung bình của đại lượng chưa biết. Vì vậy, đầu ra của mô hình bao gồm cả giá trị kỳ vọng (trung bình) và khoảng dự đoán.
- Các mô hình học sâu dùng một chuỗi mạng nơ-ron để dự đoán. Để đánh giá mức bất định của đầu ra, thông thường sẽ loại ngẫu nhiên các nơ-ron khác nhau để nghiên cứu độ biến thiên của đầu ra. Phương sai của các dự đoán này được dùng để xây dựng khoảng dự đoán.
- Trong dự báo chuỗi thời gian, mục tiêu là dự đoán giá trị của một đại lượng quan sát được ở bước thời gian tương lai. Các dự đoán dựdựa trên các mô hình thống kê như ARIMA, vốn thực hiện tự hồi quy trên trung bình trượt. Do đó, nó dự đoán giá trị kỳ vọng. Các giá trị quan sát thực tế nằm trong khoảng dự đoán quanh giá trị kỳ vọng. Khoảng dự đoán này được tính như một hàm của độ lệch chuẩn. Ví dụ, với mức tin cậy 95%, khoảng dự đoán nằm trong phạm vi 1,96 độ lệch chuẩn quanh giá trị kỳ vọng. Hơn nữa, dự đoán nhiều bước, tức chân trời dự báo dài hơn, cũng đi kèm khoảng dự đoán lớn hơn. Để tìm hiểu thêm về chuỗi thời gian, hãy tham khảo khóa học phân tích chuỗi thời gian của DataCamp.
Khoảng tin cậy vs Khoảng dự đoán: Tóm tắt
Khoảng tin cậy và khoảng dự đoán thường được dùng trong cùng bối cảnh, nên việc hiểu rõ cách chúng khác nhau là quan trọng.
Bảng dưới đây tóm tắt sự khác biệt dựa trên thảo luận ở các phần trước:
|
Khoảng tin cậy |
Khoảng dự đoán |
|
Dùng để xác định tham số tổng thể dựa trên thống kê mẫu |
Không dùng để xác định tham số tổng thể dựa trên mẫu |
|
Dùng để dự đoán phản hồi trung bình (giá trị trung bình của biến phụ thuộc cho một biến độc lập cho trước) dựa trên hồi quy. |
Dùng để dự đoán giá trị tương lai (của một điểm dữ liệu riêng lẻ cho một biến độc lập cho trước) dựa trên hồi quy. |
|
Thường hẹp hơn trong cùng một phân tích |
Thường rộng hơn trong cùng một phân tích |
Triển khai Khoảng tin cậy và Khoảng dự đoán trong R
Phần này trình bày các ví dụ thực hành dùng ngôn ngữ R để ước lượng khoảng tin cậy và khoảng dự đoán. R là ngôn ngữ được thiết kế cho các ứng dụng thống kê, kèm sẵn bộ dữ liệu và hàm thống kê.
Để tìm hiểu thêm về hồi quy bằng R, hãy theo dõi hướng dẫn hồi quy tuyến tính trong R của DataCamp.
Các ví dụ dưới đây dùng bộ dữ liệu tích hợp Orange. Bộ dữ liệu này theo dõi chu vi (tính bằng milimét) và tuổi (tính bằng ngày) của cây cam. Tự nhiên, ta kỳ vọng cây càng già thì chu vi càng lớn.
Triển khai khoảng tin cậy trong R
Các ví dụ dưới đây cho thấy cách ước lượng khoảng tin cậy cho thống kê tóm tắt và phân tích hồi quy.
Khoảng tin cậy trong thống kê tóm tắt
Để lấy khoảng tin cậy cho trung bình, chạy kiểm định T tiêu chuẩn bằng hàm t.test() trên bộ dữ liệu:
t.test(Orange$circumference)Đầu ra trông như ví dụ dưới đây:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
96.10926 135.60502
sample estimates:
mean of x
115.8571 Hàm này cho bạn ước lượng trung bình và khoảng tin cậy 95%. Mặc định, hàm T-Test dùng mức tin cậy 95%. Dùng tham số conf.level để chỉ định mức tin cậy khác, như 99%.
> t.test(Orange$circumference, conf.level = 0.99)Lệnh này cho ra đầu ra như sau:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
89.34458 142.36970
sample estimates:
mean of x
115.8571 Lưu ý rằng ước lượng trung bình là như nhau trong cả hai trường hợp. Tuy nhiên, khoảng cần rộng hơn để đạt mức tin cậy cao hơn. Dựa trên dữ liệu, tôi tin cậy 99% rằng trung bình nằm trong khoảng 89,3 đến 142,4, nhưng chỉ 95% tin cậy rằng nó nằm trong khoảng 96,1 đến 135,6. Với một tham số ước lượng từ một mẫu cho trước, khoảng tin cậy càng hẹp thì mức tin cậy càng thấp.
Khoảng tin cậy trong hồi quy
Trong các phân tích hồi quy, bạn cần khoảng tin cậy cho các hệ số hồi quy và các giá trị dự đoán.
Để hiểu sâu hơn cách thực hiện hồi quy trong R, hãy theo dõi khóa học Suy luận cho Hồi quy tuyến tính trong R của DataCamp.
Khoảng tin cậy của hệ số hồi quy
Các hệ số hồi quy được ước lượng bằng cách phân tích một mẫu ngẫu nhiên. Do đó, chúng không phải là hệ số thực cho toàn bộ tổng thể. Các ước lượng tham số hồi quy có gắn với một số sai số. Bên cạnh giá trị ước tính, việc cung cấp khoảng tin cậy cho các tham số là hữu ích.
Dùng hàm lm() để xây dựng mô hình tuyến tính dựa trên bộ dữ liệu Orange nhằm dự đoán chu vi (mm) của cây cam theo tuổi (ngày):
model_orange <- lm(circumference ~ age, data = Orange)Kiểm tra các hệ số của mô hình tuyến tính này:
model_orangeLệnh này hiển thị tham số của mô hình (hệ số chặn và độ dốc) như dưới đây:
Coefficients: (Intercept) age
17.3997 0.1068 Dùng hàm confint() để tính khoảng tin cậy 95%:
confint(model_orange, level = 0.95)Giờ bạn có thể thấy khoảng tin cậy 95% của độ dốc và hệ số chặn do mô hình ước lượng:
2.5 % 97.5 %
(Intercept) -0.14328303 34.9425835
age 0.08993141 0.1236092Khoảng tin cậy của dự đoán phản hồi trung bình
Dùng mô hình hồi quy tạo ở trên để dự đoán chu vi trung bình kỳ vọng của các cây 900 ngày tuổi. Dùng tham số interval để chỉ định khoảng tin cậy.
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) Đầu ra bao gồm dự đoán (fit) và khoảng tin cậy (lwr và upr cho cận dưới và cận trên), như dưới đây:
fit lwr upr
1 113.4929 105.3211 121.6647Triển khai khoảng dự đoán trong R
Dùng cùng mô hình như trên để dự đoán chu vi cụ thể của một cây cam 900 ngày tuổi. Dùng tham số interval để chỉ định rằng bạn muốn khoảng dự đoán.
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) Đầu ra tương tự ví dụ dưới đây:
fit lwr upr
1 113.4929 64.5118 162.4741Lưu ý rằng trong cả hai trường hợp, giá trị dự đoán của chu vi là như nhau — 113,49. Tuy nhiên, khoảng dự đoán rộng hơn nhiều so với khoảng tin cậy. Khoảng tin cậy của dự đoán là khoảng được kỳ vọng bao chứa chu vi trung bình của các cây 900 ngày tuổi. Khoảng dự đoán là khoảng kỳ vọng của chu vi của một cây 900 ngày tuổi riêng lẻ. Điều này là vì có thể có biến thiên lớn hơn đáng kể ở từng cây riêng lẻ, vốn được làm trơn khi xét giá trị trung bình.
Ngộ nhận và cạm bẫy thường gặp
Các khoảng thống kê thường được dùng trong các lĩnh vực thống kê ứng dụng như phân tích dữ liệu, dược phẩm, kinh tế lượng, v.v. Với những người không có nền tảng học thuật về thống kê, rất dễ nhầm lẫn giữa khoảng tin cậy và khoảng dự đoán.
Một số ngộ nhận phổ biến được thảo luận dưới đây:
- Dự đoán mà không xem xét khoảng dự đoán.
- Khi bạn dùng mô hình hồi quy để dự đoán giá trị của biến phụ thuộc tại một giá trị biến độc lập cho trước, phương trình hồi quy cho bạn giá trị kỳ vọng của biến phụ thuộc. Giá trị thực hiếm khi trùng với giá trị kỳ vọng mà nằm trong một khoảng nhất định quanh giá trị kỳ vọng, như khoảng dự đoán chỉ ra.
- Cho rằng phân tích hồi quy chỉ liên quan đến khoảng dự đoán.
- Bạn thực hiện hai loại dự đoán bằng mô hình hồi quy — 1) dự đoán giá trị tương lai và 2) dự đoán phản hồi trung bình. Trong ví dụ cây cam, bạn có thể cố dự đoán 1) chu vi của một cây cam cụ thể 900 ngày tuổi hoặc 2) chu vi trung bình của tất cả cây 900 ngày tuổi. Ở cả hai trường hợp, giá trị kỳ vọng là như nhau. Tuy nhiên, trường hợp thứ nhất dùng khoảng dự đoán, còn trường hợp thứ hai dùng khoảng tin cậy.
- Tin rằng khoảng hẹp hơn là tốt hơn.
- Đôi khi bạn có thể bị cám dỗ chỉ dùng khoảng hẹp hơn khi sử dụng kết quả nghiên cứu hồi quy. Khoảng tin cậy không “tốt hơn” chỉ vì nó hẹp hơn. Nó hẹp hơn vì nó đưa ra khoảng cho một đại lượng khác với khoảng dự đoán. Hãy cân nhắc liệu bạn đang cố dự đoán giá trị trung bình của biến phụ thuộc hay bạn muốn dự đoán một điểm dữ liệu cụ thể.
- Nhầm lẫn khoảng tin cậy với khoảng dự đoán.
- Nếu dự đoán của bạn liên quan đến việc xác định giá trị của một tham số tổng thể từ mẫu hoặc dự đoán phản hồi trung bình (giá trị trung bình) từ hồi quy, bạn dùng khoảng tin cậy. Nếu bạn cố dự đoán một thuộc tính của một điểm dữ liệu riêng lẻ dựa trên hồi quy, hãy dùng khoảng dự đoán.
Kết luận
Bài viết đã cung cấp tổng quan về khoảng tin cậy và khoảng dự đoán. Bài cũng giải thích sự khác nhau giữa hai khái niệm có tên gọi gần giống nhau và đưa ra ví dụ thực tế về thời điểm dùng mỗi loại khoảng. Ngoài ra, bài viết cũng trình bày cách tính khoảng dự đoán và khoảng tin cậy bằng ngôn ngữ R.
Để học cách áp dụng các công thức thống kê bằng Python, hãy tham khảo khóa học thống kê bằng Python của DataCamp. Cuối cùng, nếu bạn đang chuẩn bị phỏng vấn liên quan đến thống kê, hãy xem khóa học luyện tập câu hỏi phỏng vấn thống kê bằng Python của DataCamp.
FAQs
Vì sao chúng ta cần đến các khoảng? Tại sao giá trị thực không trùng với giá trị kỳ vọng?
Chúng ta cần các khoảng vì bị giới hạn ở việc nghiên cứu các mẫu nhỏ thay vì toàn bộ tổng thể trong phân tích thống kê. Các thuộc tính của mẫu — thứ chúng ta có thể nghiên cứu và dự đoán — mang tính chỉ báo nhưng không bằng chính xác các thuộc tính tổng thể mà ta muốn biết. Tuy nhiên, giá trị thực sẽ nằm trong một khoảng nào đó quanh giá trị dự đoán.
Khoảng tin cậy và khoảng dự đoán có thể thay thế cho nhau không?
Không, chúng rất khác nhau. Khoảng tin cậy dùng để diễn đạt khoảng của một tham số tổng thể, như trung bình. Khoảng dự đoán liên quan đến khoảng của giá trị thực của một điểm dữ liệu riêng lẻ.
Khoảng tin cậy và khoảng dự đoán có bao giờ được dùng trong cùng một bối cảnh không?
Có, cả hai đều được dùng khi thực hiện các nghiên cứu hồi quy. Bạn có thể muốn dự đoán giá trị trung bình của một điểm dữ liệu (như cân nặng trung bình của chó 2 tuổi) hoặc muốn dự đoán cân nặng của một chú chó 2 tuổi cụ thể. Với trường hợp thứ nhất, bạn dùng khoảng tin cậy. Với trường hợp thứ hai, dùng khoảng dự đoán.
Khoảng tin cậy và khoảng dự đoán có phụ thuộc vào kích thước mẫu không?
Có. Mẫu càng lớn thì ước lượng cho tham số tổng thể càng tốt hơn. Vì vậy, các ước lượng dựa trên mẫu lớn hơn sẽ có khoảng hẹp hơn.
Tôi có thể dùng ước lượng mẫu mà không kèm khoảng không?
Về nguyên tắc là có. Trong thực tế thì không hữu ích lắm. Ước lượng mẫu là giá trị “kỳ vọng”. Giá trị thực hiếm khi bằng giá trị kỳ vọng. Tuy nhiên, giá trị thực nhiều khả năng nằm trong một khoảng quanh giá trị kỳ vọng. Do đó, thông lệ là cung cấp kèm khoảng cùng với ước lượng. Bạn có thể không cần giá trị kỳ vọng nếu có khoảng phù hợp.
Khi bạn cố dự đoán y theo x, khoảng dự đoán có giống nhau cho mọi giá trị x và y không? Còn khoảng tin cậy thì sao?
Đây là một câu hỏi hay. Câu trả lời là không. Giá trị x càng xa giá trị trung bình của x, thì khoảng dự đoán và khoảng tin cậy càng rộng. Các khoảng hẹp nhất khi giá trị x gần giá trị trung bình của x.

Arun là cựu nhà sáng lập startup, yêu thích xây dựng những điều mới mẻ. Hiện tại, anh đang khám phá các nền tảng kỹ thuật và toán học của Trí tuệ Nhân tạo. Anh thích chia sẻ những gì mình học được, vì thế anh viết về chúng.
Bên cạnh DataCamp, bạn có thể đọc các bài viết của anh trên Medium, Airbyte và Vultr.
Các nghiên cứu thống kê, dù nhằm xác định tham số tổng thể hay dự đoán biến phụ thuộc, đều luôn có mức độ bất định nhất định. Nguyên nhân cốt lõi của sự bất định này là quá trình lấy mẫu. Việc xem xét toàn bộ tổng thể khi thực hiện phân tích thống kê là không thực tế. Do đó, cần chọn một mẫu đại diện — dù để ước lượng tham số tổng thể như giá trị trung bình hay để xây dựng mô hình hồi quy.
Để học hoặc ôn lại những kiến thức cơ bản này, hãy tham khảo khóa học nhập môn thống kê của DataCamp.
Giá trị thực của tham số tổng thể thường không bằng chính xác với giá trị ước tính từ mẫu — sự chênh lệch này là sai số chuẩn. Để tính đến sai số này, thông lệ là ước lượng một giá trị kỳ vọng rồi chỉ định một khoảng được kỳ vọng sẽ bao chứa giá trị thực.
Tương tự, các nghiên cứu hồi quy cũng dựa trên mẫu ngẫu nhiên thay vì toàn bộ tổng thể. Mối quan hệ giữa biến phụ thuộc và biến độc lập, được ước lượng bởi nghiên cứu hồi quy trên mẫu, không hoàn toàn bằng mối quan hệ thực giữa các biến đó trong toàn bộ tổng thể. Vì vậy, giá trị dự đoán của một điểm dữ liệu riêng lẻ không chính xác bằng giá trị thực của nó. Giá trị thực được kỳ vọng sẽ nằm trong một khoảng nào đó quanh giá trị dự đoán.
Bài viết này giải thích ý nghĩa của cả hai loại khoảng và các phương pháp toán học cơ sở dùng để tính chúng. Bài viết cũng thảo luận các ví dụ thực tế về thời điểm sử dụng mỗi loại khoảng. Cuối cùng, bài viết minh họa bằng các ví dụ thực hành cách tính khoảng tin cậy và khoảng dự đoán trong ngôn ngữ lập trình R.
Khoảng tin cậy là gì?
Khoảng tin cậy là khoảng được kỳ vọng — với một mức độ tin cậy nào đó — sẽ bao chứa giá trị thực của một tham số tổng thể, chẳng hạn như trung bình tổng thể.
Khoảng tin cậy trong suy luận thống kê
Tham số tổng thể là một thuộc tính số học của toàn bộ tổng thể. Trung bình (của toàn bộ tổng thể) là một ví dụ về tham số tổng thể. Giá trị thực của các hệ số hồi quy giữa hai biến cũng là một ví dụ khác về tham số tổng thể. Thống kê suy luận nghiên cứu các điểm dữ liệu trong một mẫu ngẫu nhiên để ước lượng tham số tổng thể.
Giả sử, giả định rằng bạn là nhà làm vườn hoặc nông dân trồng cam và muốn biết cây cam dày đến mức nào khi được 100 ngày tuổi. Không thể nghiên cứu từng cây cam 100 ngày tuổi. Vì thế, bạn chọn ngẫu nhiên một số cây 100 ngày tuổi và đo chu vi (độ dày) của chúng. Giá trị trung bình của các phép đo này cho bạn trung bình mẫu. Bạn muốn dùng trung bình mẫu này để suy ra trung bình tổng thể.
Một quần thể cây cam. Tạo bằng DALL-E.
Trung bình mẫu là ước lượng điểm cho tham số tổng thể (trong trường hợp này, tham số quan tâm là trung bình). Khóa học về thống kê suy luận của DataCamp trình bày chi tiết hơn các khái niệm này.
Trung bình mẫu mang tính đại diện cho trung bình tổng thể nhưng không bằng chính xác. Trung bình tổng thể được kỳ vọng nằm trong một khoảng nhất định quanh trung bình mẫu, gọi là khoảng tin cậy.
Khoảng tin cậy trong hồi quy
Phần trước đã giải thích khoảng tin cậy trong thống kê suy luận. Hồi quy cũng sử dụng khoảng tin cậy.
Ví dụ, xét một biến thể của ví dụ cây cam ở trên:
Bạn thực hiện điều này bằng phân tích hồi quy. Bộ dữ liệu bạn chạy hồi quy dựa trên một mẫu cây cam. Do đó, trung bình mẫu ước lượng (chu vi trung bình của cây cam 100 ngày tuổi) sẽ không bằng chính xác trung bình tổng thể. Giá trị thực của trung bình tổng thể nằm trong khoảng tin cậy quanh trung bình mẫu ước lượng.
Các phần sau sẽ trình bày và giải thích các biểu thức toán học cho khoảng tin cậy.
Khoảng dự đoán là gì?
Khoảng dự đoán là khoảng được kỳ vọng — với một mức độ tin cậy nào đó — sẽ bao chứa giá trị thực của một điểm dữ liệu riêng lẻ, dựa trên dự đoán bằng phân tích hồi quy.
Xét một biến thể khác của ví dụ hồi quy đã nêu:
Bạn dùng cùng công thức hồi quy như trước. Giá trị ước lượng (tức giá trị kỳ vọng) của chu vi cá thể giống với chu vi trung bình ước lượng. Tuy nhiên, bạn phải tính đến độ biến thiên tăng lên của các điểm dữ liệu cá nhân vì bạn đang dự đoán một giá trị cá thể (không phải giá trị trung bình). Do đó, khoảng dự đoán lớn hơn khoảng tin cậy.
Phần sau của bài sẽ nêu công thức cho các khoảng này và hướng dẫn dùng R để tính chúng.