Het landschap van data-architectuur is in beweging, gedreven door het toenemende gebruik van cloudtechnologieën en de adoptie van de modern data stack. Daardoor wordt ELT steeds vaker ingezet. Maar wat houdt dit proces precies in?
In dit artikel duiken we in ELT en de rol ervan binnen geavanceerde data-architectuur.
Wat is ELT?
ELT staat voor Extract, Load, Transform. Het is een dataintegratieproces waarbij data uit verschillende bronnen wordt geëxtraheerd, in een dataopslagsysteem wordt geladen en vervolgens wordt getransformeerd naar een formaat dat eenvoudig te analyseren is.
Het ELT-proces wordt veel gebruikt in modern data stack-architecturen, waar data wordt opgeslagen, getransformeerd en geanalyseerd in een data lake of -warehouse.
Hoe werkt ELT?
Zoals de naam al aangeeft, bestaat ELT uit drie hoofdstappen: Extract, Load en Transform. Laten we elke stap nader bekijken.
De eerste stap in het ELT-proces is het extraheren van data uit diverse bronnen zoals databases, bestanden, API's of webservices. Dit kan met tools zoals ELT-software of met door ontwikkelaars geschreven maatwerkscripts.
Voorbeelden van data-extractieplatforms zijn Airbyte en Fivetran. Voor het schrijven van maatwerkscripts worden Apache Spark en Python veel gebruikt.
De geëxtraheerde data kan gestructureerd, semi-gestructureerd of ongestructureerd zijn en afkomstig uit verschillende systemen, zoals relationele databases, NoSQL-databases of cloudopslag.
2. Load
Zodra de data is geëxtraheerd, wordt deze geladen in een centraal dataopslagsysteem zoals een data lake of een datawarehouse. In deze stap wordt de geëxtraheerde data in ruwe vorm georganiseerd en opgeslagen, zonder transformatie.
Data engineers zijn meestal bij deze stap betrokken; zij laden de data naar platforms zoals:
Deze dataplatforms maken het mogelijk om grote hoeveelheden data snel te laden en bieden één bron van waarheid voor alle verschillende datatypes die uit diverse bronnen zijn verzameld.
De laatste stap in het ELT-proces is het transformeren van ruwe data naar een formaat dat is geoptimaliseerd voor analyse en rapportage. Dit omvat het opschonen, filteren, aggregeren en structureren van data op een manier die geschikt is voor business intelligence- en analysetools.
Data engineers of data scientists zijn doorgaans verantwoordelijk voor deze stap en kunnen tools gebruiken zoals:
- SQL-queries
- Apache Spark
- Python-bibliotheken zoals Pandas of NumPy
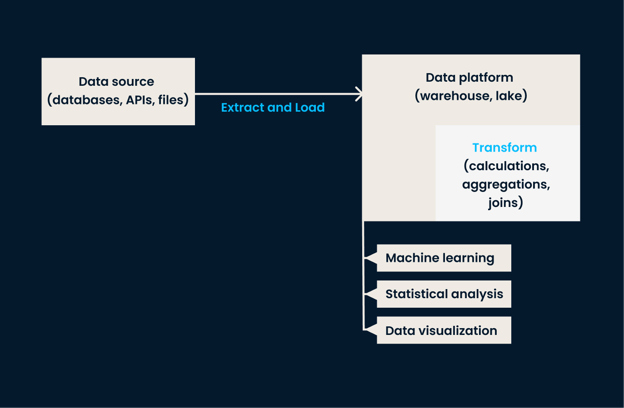
ELT-datapijplijn: de extract- en laadfasen vinden plaats voordat er enige transformatie op de data wordt toegepast. De transformatie gebeurt binnen het dataplatform.
Datatransformatie gebeurt binnen het datawarehouse of datalake, wat het verwerken van grote datavolumes vergemakkelijkt. Met moderne cloudtechnologieën kan dit bijna realtime gebeuren, zodat organisaties toegang hebben tot actuele en nauwkeurige data voor analyse.
Wil je meer leren over het gebruik van Python voor ELT? De ETL and ELT in Python-cursus is misschien precies wat je nodig hebt.
Voordelen van ELT
ELT biedt veel voordelen; dit zijn enkele opvallende punten:
- Schaalbaarheid: dankzij de kracht van cloudcomputing maakt ELT het mogelijk om grote hoeveelheden data sneller te extraheren, laden en transformeren dan traditionele ETL-processen.
- Flexibiliteit: ELT maakt integratie van data uit allerlei bronnen mogelijk, waaronder gestructureerde, semi-gestructureerde en ongestructureerde data.
- Snelheid van realtime inzichten: de ruwe data in een datalake of datawarehouse kan on-demand snel worden getransformeerd, wat realtime inzichten oplevert voor snellere besluitvorming.
ELT vs ETL
Laten we nu de verschillen tussen ELT en ETL vergelijken.
Zoals eerder genoemd is ELT een nieuwere benadering van dataverwerking waarbij data eerst in een centrale repository wordt geladen en transformaties pas daarna plaatsvinden.
ETL (Extract, Transform, Load) daarentegen is een traditionele methodologie waarbij data wordt getransformeerd vóórdat deze naar het doelsysteem wordt geladen. Deze fundamentele verschillen beïnvloeden niet alleen het proces, maar ook snelheid, kosten en veiligheid.
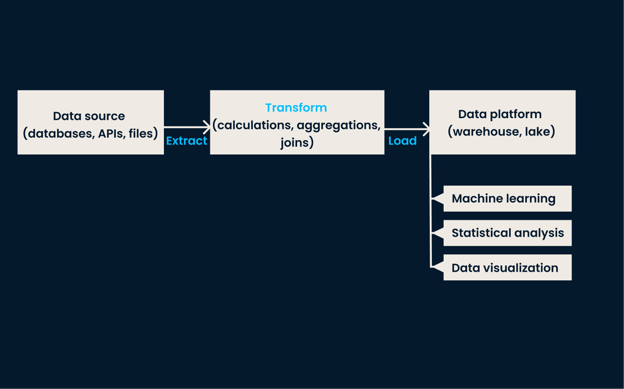
ETL-pijplijn: de transformatiefase vindt plaats voordat de data naar een doelplatform wordt geladen. Doorgaans gebeurt transformatie op een aparte server in plaats van binnen het dataplatform zelf.
Proces
ELT volgt een 'eerst laden, later transformeren'-aanpak waarbij data in ruwe vorm in een opslagsysteem wordt geladen en daarna voor analyse wordt getransformeerd.
ETL daarentegen volgt een 'extract-transform-load'-aanpak waarbij data uit verschillende bronnen wordt geëxtraheerd, vervolgens getransformeerd en tenslotte in een datawarehouse wordt geladen.
Snelheid
De ELT-aanpak staat bekend om snellere dataverwerking, omdat er geen tussentijdse staginglaag nodig is. Dit maakt realtime- of bijna-realtime data-analyse mogelijk.
ETL daarentegen duurt vaak langer door de meerdere stappen die nodig zijn om de data te transformeren en te laden.
Kosten
Bovendien maakt ELT dure ETL-software overbodig, omdat transformaties kunnen worden uitgevoerd met SQL-queries of andere opensourcetools.
Traditionele ETL-processen passen daarentegen beter bij on-premises infrastructuur, waar databronnen beperkt zijn en hardwaremiddelen minder schaalbaar dan in cloudomgevingen. On-premises infrastructuur is vaak duurder dan cloudinfrastructuur.
Beveiliging
Tot slot maakt ELT gegevensversleuteling en datamasking van persoonlijk identificeerbare informatie (PII) mogelijk tijdens het laadproces, aangezien dit plaatsvindt in een beveiligde centrale repository.
ETL-processen moeten databeveiliging waarborgen tijdens zowel extractie als transformatie. Dat is echter lastig, omdat de data naar extra staging-opslag moet verplaatsen en vaak op aparte servers wordt verwerkt.
Toepassingen van ELT
Dankzij snellere dataverwerking en cloudgebaseerde analytics kent het ELT-proces een aantal usecases waarin het uitblinkt ten opzichte van ETL.
Enkele veelvoorkomende toepassingen van ELT zijn:
- Realtime app-rapportage: met ELT krijgen organisaties realtime inzicht in het gedrag van gebruikers binnen apps.
- Datawarehousing: veel organisaties gebruiken ELT om data te laden en transformeren in een centraal datawarehouse voor rapportage en analyse.
- Cloudgebaseerde dataintegratie: met de opkomst van cloudtechnologieën is ELT een populaire keuze geworden om databronnen uit diverse on-premises en cloudapplicaties te integreren.
Er zijn verschillende tools en technologieën beschikbaar waarmee organisaties ELT-processen kunnen implementeren. Dit zijn onder andere:
Datawarehouses en datalakes
In de laadstap van het ELT-proces zijn datalakes en datawarehouses essentieel om binnen een bedrijf een centrale dataopslag te bieden.
Dit zijn de meest populaire clouddataplatforms:
- Amazon Redshift: een cloud datawarehouse-service die enorme hoeveelheden data snel en efficiënt kan verwerken.
- Google BigQuery: een serverloos, schaalbaar cloud datawarehouse dat snelle query's op grote datasets mogelijk maakt.
- Snowflake: een cloudgebaseerd datawarehouse dat ELT-processen ondersteunt en geavanceerde beveiliging en performance biedt.
- Amazon S3: een cloudopslagdienst die kan worden gebruikt als datalake voor het opslaan van ruwe data, die vervolgens kan worden getransformeerd met SQL-queries of andere tools.
Veel organisaties zetten ook open-sourcetools in voor hun ELT-processen vanwege de kosteneffectiviteit.
Deze tools kunnen helpen in verschillende fasen van het ELT-proces:
- Apache Airflow: gebruikt voor workflow-automatisering en het plannen van ETL/ELT-processen.
- dbt: open-sourcesoftware voor het transformeren van data in een datawarehouse met SQL.
- Airbyte: open-source dataintegratieplatform dat zowel ELT- als ETL-processen ondersteunt.
- Singer: open-sourcetool die via een modulaire aanpak wordt gebruikt in zowel ELT- als ETL-processen.
- Apache NiFi: open-sourcedataintegratietool die datarouting, transformatie en systeemmediatie ondersteunt.
Open-sourcetools passen uitstekend bij ELT-processen omdat ze flexibiliteit, ondersteuning door ontwikkelaars en veel integratieopties bieden.
Maatwerkscripts
Ontwikkelaars kunnen ook kiezen voor scripts die zijn gebouwd met programmeertalen voor extra maatwerk. Dit houdt vaak in dat pakketten en bibliotheken worden gebruikt om data te verwerken en te transformeren.
Veelgebruikte programmeertalen voor deze scripts zijn onder meer:
- Python: met bibliotheken zoals Pandas, NumPy en SQLAlchemy kun je helpen bij het extraheren, laden en transformeren van data.
- Apache Spark: gebruikt voor bigdataverwerking en analytics, vaak met talen zoals Python (PySpark), Java en Scala.
- R: het tidyverse-framework, samen met andere R-bibliotheken zoals dplyr en data.table, kan worden gebruikt voor data-extractie en -transformatie.
- SQL: SQL-queries kunnen worden gebruikt voor transformatietaken, en SQL Server Integration Services (SSIS) is een populaire ETL-tool die ook ELT-processen ondersteunt.
- Scala: wordt vaak gebruikt met Apache Spark voor bigdataverwerking en ELT-taken.
- Java: wordt vaak gebruikt met bigdataframeworks zoals Apache Hadoop en Apache Spark voor ELT-processen.
Tot slot
Kortom, ELT is een nieuwe en opkomende trend in dataverwerking die veel voordelen biedt ten opzichte van traditionele ETL-methoden. Het maakt snellere en efficiëntere datatransformatie mogelijk en biedt meer flexibiliteit en schaalbaarheid.
Wil je meer leren over ELT of andere data-engineeringconcepten? Kijk dan eens naar onze Data Engineer-certificering of onze Data Engineer in Python Career Track.




Het landschap van data-architectuur is in beweging, gedreven door het toenemende gebruik van cloudtechnologieën en de adoptie van de modern data stack. Daardoor wordt ELT steeds vaker ingezet. Maar wat houdt dit proces precies in?
In dit artikel duiken we in ELT en de rol ervan binnen geavanceerde data-architectuur.
Wat is ELT?
ELT staat voor Extract, Load, Transform. Het is een dataintegratieproces waarbij data uit verschillende bronnen wordt geëxtraheerd, in een dataopslagsysteem wordt geladen en vervolgens wordt getransformeerd naar een formaat dat eenvoudig te analyseren is.
Het ELT-proces wordt veel gebruikt in modern data stack-architecturen, waar data wordt opgeslagen, getransformeerd en geanalyseerd in een data lake of -warehouse.
Hoe werkt ELT?
Zoals de naam al aangeeft, bestaat ELT uit drie hoofdstappen: Extract, Load en Transform. Laten we elke stap nader bekijken.
1. Extract
De eerste stap in het ELT-proces is het extraheren van data uit diverse bronnen zoals databases, bestanden, API's of webservices. Dit kan met tools zoals ELT-software of met door ontwikkelaars geschreven maatwerkscripts.
Voorbeelden van data-extractieplatforms zijn Airbyte en Fivetran. Voor het schrijven van maatwerkscripts worden Apache Spark en Python veel gebruikt.
De geëxtraheerde data kan gestructureerd, semi-gestructureerd of ongestructureerd zijn en afkomstig uit verschillende systemen, zoals relationele databases, NoSQL-databases of cloudopslag.
2. Load
Zodra de data is geëxtraheerd, wordt deze geladen in een centraal dataopslagsysteem zoals een data lake of een datawarehouse. In deze stap wordt de geëxtraheerde data in ruwe vorm georganiseerd en opgeslagen, zonder transformatie.
Data engineers zijn meestal bij deze stap betrokken; zij laden de data naar platforms zoals:
Deze dataplatforms maken het mogelijk om grote hoeveelheden data snel te laden en bieden één bron van waarheid voor alle verschillende datatypes die uit diverse bronnen zijn verzameld.
3. Transform
De laatste stap in het ELT-proces is het transformeren van ruwe data naar een formaat dat is geoptimaliseerd voor analyse en rapportage. Dit omvat het opschonen, filteren, aggregeren en structureren van data op een manier die geschikt is voor business intelligence- en analysetools.
Data engineers of data scientists zijn doorgaans verantwoordelijk voor deze stap en kunnen tools gebruiken zoals:
ELT-datapijplijn: de extract- en laadfasen vinden plaats voordat er enige transformatie op de data wordt toegepast. De transformatie gebeurt binnen het dataplatform.
Datatransformatie gebeurt binnen het datawarehouse of datalake, wat het verwerken van grote datavolumes vergemakkelijkt. Met moderne cloudtechnologieën kan dit bijna realtime gebeuren, zodat organisaties toegang hebben tot actuele en nauwkeurige data voor analyse.
Wil je meer leren over het gebruik van Python voor ELT? De ETL and ELT in Python-cursus is misschien precies wat je nodig hebt.
Voordelen van ELT
ELT biedt veel voordelen; dit zijn enkele opvallende punten:
ELT vs ETL
Laten we nu de verschillen tussen ELT en ETL vergelijken.
Zoals eerder genoemd is ELT een nieuwere benadering van dataverwerking waarbij data eerst in een centrale repository wordt geladen en transformaties pas daarna plaatsvinden.
ETL (Extract, Transform, Load) daarentegen is een traditionele methodologie waarbij data wordt getransformeerd vóórdat deze naar het doelsysteem wordt geladen. Deze fundamentele verschillen beïnvloeden niet alleen het proces, maar ook snelheid, kosten en veiligheid.
ETL-pijplijn: de transformatiefase vindt plaats voordat de data naar een doelplatform wordt geladen. Doorgaans gebeurt transformatie op een aparte server in plaats van binnen het dataplatform zelf.
Proces
ELT volgt een 'eerst laden, later transformeren'-aanpak waarbij data in ruwe vorm in een opslagsysteem wordt geladen en daarna voor analyse wordt getransformeerd.
ETL daarentegen volgt een 'extract-transform-load'-aanpak waarbij data uit verschillende bronnen wordt geëxtraheerd, vervolgens getransformeerd en tenslotte in een datawarehouse wordt geladen.
Snelheid
De ELT-aanpak staat bekend om snellere dataverwerking, omdat er geen tussentijdse staginglaag nodig is. Dit maakt realtime- of bijna-realtime data-analyse mogelijk.
ETL daarentegen duurt vaak langer door de meerdere stappen die nodig zijn om de data te transformeren en te laden.
Kosten
Bovendien maakt ELT dure ETL-software overbodig, omdat transformaties kunnen worden uitgevoerd met SQL-queries of andere opensourcetools.
Traditionele ETL-processen passen daarentegen beter bij on-premises infrastructuur, waar databronnen beperkt zijn en hardwaremiddelen minder schaalbaar dan in cloudomgevingen. On-premises infrastructuur is vaak duurder dan cloudinfrastructuur.
Beveiliging
Tot slot maakt ELT gegevensversleuteling en datamasking van persoonlijk identificeerbare informatie (PII) mogelijk tijdens het laadproces, aangezien dit plaatsvindt in een beveiligde centrale repository.
ETL-processen moeten databeveiliging waarborgen tijdens zowel extractie als transformatie. Dat is echter lastig, omdat de data naar extra staging-opslag moet verplaatsen en vaak op aparte servers wordt verwerkt.
Toepassingen van ELT
Dankzij snellere dataverwerking en cloudgebaseerde analytics kent het ELT-proces een aantal usecases waarin het uitblinkt ten opzichte van ETL.
Enkele veelvoorkomende toepassingen van ELT zijn:
ELT-tools en -technologieën
Er zijn verschillende tools en technologieën beschikbaar waarmee organisaties ELT-processen kunnen implementeren. Dit zijn onder andere:
Datawarehouses en datalakes
In de laadstap van het ELT-proces zijn datalakes en datawarehouses essentieel om binnen een bedrijf een centrale dataopslag te bieden.
Dit zijn de meest populaire clouddataplatforms:
Open-sourcetools voor ELT
Veel organisaties zetten ook open-sourcetools in voor hun ELT-processen vanwege de kosteneffectiviteit.
Deze tools kunnen helpen in verschillende fasen van het ELT-proces:
Open-sourcetools passen uitstekend bij ELT-processen omdat ze flexibiliteit, ondersteuning door ontwikkelaars en veel integratieopties bieden.
Maatwerkscripts
Ontwikkelaars kunnen ook kiezen voor scripts die zijn gebouwd met programmeertalen voor extra maatwerk. Dit houdt vaak in dat pakketten en bibliotheken worden gebruikt om data te verwerken en te transformeren.
Veelgebruikte programmeertalen voor deze scripts zijn onder meer:
Tot slot
Kortom, ELT is een nieuwe en opkomende trend in dataverwerking die veel voordelen biedt ten opzichte van traditionele ETL-methoden. Het maakt snellere en efficiëntere datatransformatie mogelijk en biedt meer flexibiliteit en schaalbaarheid.
Wil je meer leren over ELT of andere data-engineeringconcepten? Kijk dan eens naar onze Data Engineer-certificering of onze Data Engineer in Python Career Track.