Cursus
Data opschonen in Python
4 uur
162.3K
Als je aan een nieuw dataproject begint, is de data die je verzamelt zelden meteen perfect voor je analyse. Daarom is het essentieel om aan het begin van elk project je data op te schonen.
Data opschonen is het proces van het verwijderen van fouten, uitschieters en inconsistenties en ervoor zorgen dat al je data in een formaat staat dat geschikt is voor je analyse. Data met veel fouten of die dit opschoningsproces niet heeft doorlopen, noemen we vervuilde data.
Deze stap kan voor veel beginnende dataprofessionals optioneel aanvoelen, maar geloof me: hij is cruciaal! Zonder goed opschonen kan je model verkeerde conclusies trekken, kan je grafiek een neptrend laten zien en kunnen je statistieken sterk onnauwkeurig zijn.
Denk aan een heel klein datasetje. Jij en je vrienden verdelen je snoep eerlijk en je wilt bepalen hoeveel snoepjes iedereen krijgt. Je vult je data in de onderstaande tabel in.
|
Persoon |
Aantal snoepjes |
|
Peter |
5 |
|
Sandy |
20 |
|
Sandy |
20 |
|
Joseph |
3 |
|
Amed |
12 |
Neem je nu het gemiddelde van de kolom Aantal snoepjes, dan kom je misschien tot de conclusie dat iedereen 12 snoepjes moet krijgen.
Maar als je iedereen 12 snoepjes probeert te geven, ben je te vroeg door je voorraad heen, omdat Sandy dubbel in je tabel staat. Je hebt maar 40 snoepjes in plaats van 60 (en eigenlijk ook maar 4 personen, geen 5)!
Door je dataset niet op te schonen, loop je het risico dat je analyse tot de verkeerde conclusie komt.
Bij het verdelen van snoep onder vrienden is de grootste consequentie misschien een verstoorde vriendschap. Maar in de zakenwereld kan het nalaten van opschonen leiden tot analyses die suggereren dat je het verkeerde product lanceert, het verkeerde aantal medewerkers aanneemt, in de verkeerde aandelen investeert of zelfs een klant de verkeerde prijs berekent!
Data opschonen is nog belangrijker bij complexere analyses. Daarbij heb je vaak minder duidelijke verwachtingen van de uitkomsten, waardoor je niet altijd doorhebt wanneer resultaten fout zijn.
Grondig opschonen, samen met zorgvuldig testen, helpt deze zorgen weg te nemen. In deze tutorial behandelen we wat je moet weten over het opschoningsproces in Python.
Er zijn veel soorten fouten en inconsistenties die data vervuilen. Laten we enkele van de meest voorkomende types doornemen en waarom ze problematisch zijn.
Onvolledige datasets komen heel vaak voor. Je dataset kan meerdere jaren missen, slechts deels klantinformatie bevatten of niet alle producten van je bedrijf omvatten.
Missende waarden kunnen je analyse op meerdere manieren beïnvloeden. Grote delen cruciale data die ontbreken kunnen bias veroorzaken in je resultaten. Bovendien kunnen NaN-waarden of lege cellen in een DataFrame bepaalde Python-code laten falen, wat tijdens het bouwen van je model tot veel frustratie leidt.
Uitschieters zijn waarden die ver buiten de norm vallen en niet representatief zijn voor de data. Ze kunnen het gevolg zijn van een typefout of uitzonderlijke omstandigheden. Het is belangrijk echte uitschieters te onderscheiden van informatieve extreme situaties. Uitschieters kunnen je resultaten scheeftrekken en uiteindelijk de verkeerde richting aangeven.
Zoals we hierboven zagen, kunnen dubbele records één item oververtegenwoordigen in je analyse, wat tot verkeerde conclusies leidt. Let op duplicaten die vaker voorkomen en op duplicaten met tegenstrijdige of bijgewerkte informatie.
Soms zijn waarden in onze dataset gewoonweg onjuist. Je kunt de verkeerde spelling van een klantnaam hebben, een fout productnummer, verouderde informatie of verkeerd gelabelde data.
Het kan soms lastig zijn om te bepalen of je data foutief is, daarom is verificatie van je bron zo belangrijk! Onthoud: je analyse is slechts zo goed als je data.
Inconsistenties komen in vele vormen. Er kunnen inconsistente data-invoer zijn, wat kan wijzen op een typefout of een vergissing. Als je ziet dat een klant terug in leeftijd gaat, een ingrediënt dat van ID wisselt of een product met twee gelijktijdige prijzen, kijk dan beter om zeker te zijn dat alles klopt.
Een andere problematische vorm is inconsistentie in het formaat van data. Waarden kunnen in verschillende eenheden gerapporteerd zijn (kilometers vs. miles vs. inches), in verschillende stijlen (Maand Dag, Jaar vs. Dag-Maand-Jaar), in verschillende datatypes (floats vs. integers) of zelfs in verschillende bestandstypen (.jpg vs. .png).
Deze inconsistenties maken het lastig, zo niet onmogelijk, voor je code om waarden correct te interpreteren. Dit kan resulteren in een onjuiste analyse of zelfs in code die helemaal niet draait.
Het is cruciaal dat je je dataset begrijpt voordat je hem inzet in een complexe analyse. Om dit soort begrip te ontwikkelen, doe je aan data exploratie. Zie deze stap als de voor-analyse-analyse.
Laten we kijken naar enkele typische stappen voor data exploratie op een tabelvormige dataset:
Dit lijkt misschien overbodig voor je beoogde analyse, maar er zijn een paar belangrijke redenen om deze stappen altijd te zetten. Ten eerste geeft dit je een uitstekend begrip van de grenzen van je dataset, wat essentieel is als je de resultaten van je uiteindelijke analyses wilt vertrouwen.
Ten tweede kan data exploratie je wijzen op belangrijke trends en analyses waar je eerder niet aan dacht. Deze kunnen je beoogde analyses versterken of een complicerende factor aan het licht brengen waarmee je rekening moet houden.
Ten derde kan deze voor-analyse je eerste aanwijzing zijn dat je vervuilde data hebt. Dit kan het moment zijn waarop je die uitschieter ziet, beseft dat er twee keer zoveel categorieën zijn als zou moeten, of ontdekt dat de dataverzamelingsmethode vorig jaar anders was dan het jaar ervoor. Dit zijn allemaal cruciale signalen die je nieuwsgierig zouden moeten maken naar je dataset.
Voor meer informatie over data exploratie, bekijk DataCamp’s cursus Data Exploration in Python of deze tutorial voor absolute beginners.
Laten we de details induiken met technieken voor data opschonen in Python door te bekijken hoe je veelvoorkomende problemen met vervuilde data aanpakt.
Onvermijdelijk zullen in een grote dataset enkele velden ontbreken in één of meer records. Dat betekent niet alleen dat je waardevolle data mist, maar NaN-waarden kunnen sommige Python-functies in de war brengen, waardoor je model onnauwkeurig wordt.
Als je een missende waarde vindt, kun je ervoor kiezen om die invoer uit de analyse te verwijderen of een redelijke waarde te imputeren als vervanging. Als je dataset redelijk klein is, raad ik aan de rijen met missende waarden te bekijken om de beste aanpak te bepalen.
import pandas as pd # Identify rows with NaN valuesrows_with_nan = df[df.isnull().any(axis=1)] #View the rows with NaN valuesprint(rows_with_nan)Een record verwijderen is meestal niet de eerste keuze, omdat je daarmee potentieel waardevolle informatie uit de analyse haalt.
Soms is verwijderen echter de beste optie, bijvoorbeeld als het record niet genoeg andere informatie bevat om te blijven (zoals wanneer de invoer alleen een datum is zonder waardevolle informatie).
Verwijderen is ook de makkelijkste manier om met records met missende waarden om te gaan. Dus als je weinig tijd hebt en de rest van het record niet belangrijk is voor de analyse, is verwijderen van records met NaN’s een optie.
Je kunt de .dropna()-methode uit de Pandas-bibliotheek gebruiken om rijen met NaN’s uit een DataFrame te verwijderen.
import pandas as pd # Assuming df is your DataFramedf.dropna(inplace=True)De over het algemeen geprefereerde methode om met missende waarden om te gaan is het imputeren van een redelijke waarde. Het vinden van zo’n waarde is een kunst op zich, maar er zijn verschillende gangbare methoden die een goed startpunt vormen.
De .fillna()-methode van Pandas kan missende waarden imputeren met het gemiddelde, zodat de verdeling niet verandert.
import pandas as pd # Assuming df is your DataFrame# Replace NaN values with the mean of the columndf.fillna(df.mean(), inplace=True)De scikit-learn-bibliotheek heeft ook een eenvoudige imputerfunctie die goed werkt.
from sklearn.impute import SimpleImputerimport pandas as pd # Assuming df is your DataFrameimputer = SimpleImputer(strategy='mean')df_imputed = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)Heb je een complexere imputatiemethode nodig, overweeg dan KNN- of regressie-imputatie om een geschikte waarde te vinden. Uiteindelijk hangt de keuze af van je data, je behoeften en je middelen.
Uitschieters zijn wat lastiger. Sommige schijnbare uitschieters zijn juist belangrijke data, zoals hoe de aandelenmarkt reageert op crises als COVID-19 en de mondiale recessie. Andere zijn echter typefouten of irrelevante, zeldzame omstandigheden en moeten worden verwijderd.
Het verschil kennen is vaak een kwestie van je data in context begrijpen, waar je eerdere data exploratie bij geholpen heeft, en een helder beeld hebben van het doel van je analyse.
Veel uitschieters zijn zichtbaar wanneer je de data plot, maar je kunt ook statistische methoden gebruiken om ze te identificeren.
Een gangbare methode is om voor elk datapunt een Z-score te berekenen en waarden met een extreme Z-score te elimineren.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate Z-scoresz_scores = (data - np.mean(data)) / np.std(data) # Identify outliers based on Z-score threshold (e.g., 3)threshold = 3outliers = np.where(np.abs(z_scores) > threshold)[0] print("Outliers identified using Z-score method:")print(data[outliers])Een andere methode is om de interkwartielafstand (IQR) van de verdeling te berekenen en waarden die kleiner zijn dan Q1 − (1,5 × IQR) of groter dan Q3 + (1,5 × IQR) als potentiële uitschieters te classificeren.
import numpy as npimport pandas as pd # Generate some sample datanp.random.seed(0)data = np.random.randint(low=0, high=11, size=1000)# Add some outliersdata[0] = 100data[1] = -100 # Calculate quartiles and IQRq1 = np.percentile(data, 25)q3 = np.percentile(data, 75)iqr = q3 - q1 # Identify outliers based on IQRlower_bound = q1 - (1.5 * iqr)upper_bound = q3 + (1.5 * iqr)outliers = np.where((data < lower_bound) | (data > upper_bound))[0] print("Outliers identified using IQR method:")print(data[outliers])Zodra je uitschieters hebt geïdentificeerd en vastgesteld dat ze problematisch zijn, zijn er verschillende manieren om ermee om te gaan. Als je hebt vastgesteld dat de uitschieter door een fout komt, kun je soms simpelweg de fout corrigeren om de uitschieter te verhelpen.
In andere gevallen kun je de uitschieter uit de dataset verwijderen of vervangen door een minder extreme waarde die de algehele vorm van de verdeling behoudt.
Capping is een methode waarbij je een bovengrens of ondergrens instelt op de verdeling van je data en waarden buiten die grenzen vervangt door een opgegeven waarde.
import pandas as pdimport numpy as np # Create a sample DataFrame with outliersdata = { 'A': [100, 90, 85, 88, 110, 115, 120, 130, 140], 'B': [1, 2, 3, 4, 5, 6, 7, 8, 9]}df = pd.DataFrame(data) # Define the lower and upper thresholds for capping (Here I used the 5th and 95th percentiles)lower_threshold = df.quantile(0.05)upper_threshold = df.quantile(0.95) # Cap outlierscapped_df = df.clip(lower=lower_threshold, upper=upper_threshold, axis=1) print("Original DataFrame:")print(df)print("\nCapped DataFrame:")print(capped_df)In sommige gevallen kun je je data transformeren zodat uitschieters minder impact hebben, zoals met een worteltransformatie of een logaritmische transformatie.
Wees voorzichtig bij het transformeren van data, want je kunt op de lange termijn nieuwe problemen introduceren als je niet oplet. Overweeg het volgende voordat je transformeert.
Wil je meer leren over datatransformaties, volg dan een statistiekcursus zoals DataCamp’s Introduction to Statistics in Python of Statistics Fundamentals with Python.
We hebben al gezien hoe duplicaten onze analyses kunnen verstoren. Gelukkig maakt Python het eenvoudig om duplicaten te identificeren en te behandelen.
Met de duplicated()-methode in de pandas-bibliotheek kun je makkelijk dubbele rijen in een DataFrame vinden om ze te bekijken.
import pandas as pd# Assuming 'df' is your DataFrameduplicate_rows = df[df.duplicated()]Dit geeft een DataFrame terug met de rijen die duplicaten zijn. Als het er niet te veel zijn, raad ik je aan de duplicaten te bekijken.
De meeste duplicaten zijn exacte kopieën en kun je simpelweg verwijderen met de methode drop_duplicates() in Pandas:
# Removing duplicatescleaned_df = df.drop_duplicates()Soms is het passender om dubbele records samen te voegen en informatie te aggregeren. Als duplicaten bijvoorbeeld meerdere invoeren voor dezelfde entiteit voorstellen, kunnen we ze samenvoegen met aggregatiefuncties:
# Merging duplicates by aggregating valuesmerged_df = df.groupby(list_of_columns).agg({'column_to_merge': 'sum'})Dit combineert dubbele rijen tot één, waarbij waarden worden geaggregeerd op basis van functies als som, gemiddelde, enz.
import pandas as pd#Sample DataFramedata = { 'customer_id' : [102, 102, 101, 103, 102] 'product_id' : ['A', 'B', 'A', 'C', 'B'] 'quantity_sold : [5, 3, 2, 1, 4]}df = pd.DataFrame(data)df}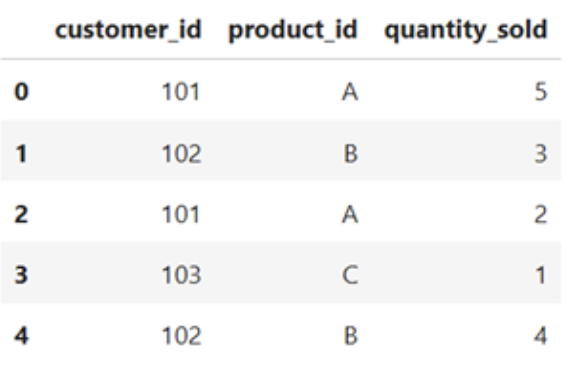
# Merging duplicates by aggregating valuesmerged_df = df.groupby(['cutomer_id', 'product_id']).agg({'quantity_sold': 'sum'}).reset_index()merged_df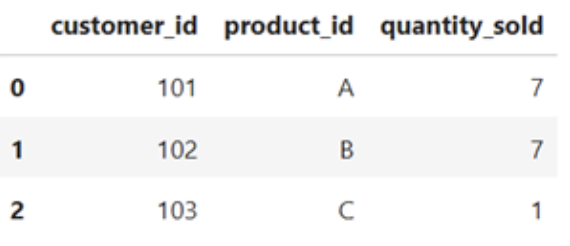
Verschillende typen inconsistenties vragen om verschillende oplossingen. Inconsistenties door onjuiste invoer of typefouten moeten mogelijk worden gecorrigeerd door iemand met domeinkennis. Of je vervangt de onjuiste data via imputatie, alsof het om een missende waarde gaat, of je verwijdert de data volledig, afhankelijk van de omstandigheden.
Inconsistenties in de opmaak van data kun je corrigeren met standaardisatietechnieken. Om spaties aan het begin en einde van een string te verwijderen, gebruik je .strip(). De methoden .upper() en .lower() standaardiseren hoofd- en kleine letters. En datums converteren naar datetimes met pd.to_datetime zorgt voor een gestandaardiseerd datumformaat.
Je kunt er ook voor zorgen dat elke waarde in een DataFrame-kolom hetzelfde datatype heeft met de methode .astype().
Andere correcties van opmaak-inconsistenties die je mogelijk moet uitvoeren, zijn onder meer:
value_mapping = {'M': 'Male', 'F': 'Female'}standardized_value = value_mapping.get('M', 'Unknown')Datatransformatie en feature engineering zijn preprocessing-technieken om ruwe data om te zetten naar een formaat dat geschikter is voor machine learning-algoritmen en statistische analyse. In deze sectie verkennen we kort enkele veelvoorkomende technieken voor datatransformatie en feature engineering in Python.
Normalisatie en standaardisatie zijn twee technieken om features naar een vergelijkbare schaal te brengen, wat belangrijk is voor veel machine learning-algoritmen.
Normalisatie schaalt data naar een vast bereik, meestal tussen 0 en 1. Zo staan alle features op dezelfde schaal en voorkom je dat bepaalde features domineren door hun grotere omvang.
from sklearn.preprocessing import MinMaxScaler

scaler = MinMaxScaler()
scaled_data = scaler.fit_transform(data)
Standaardisatie daarentegen transformeert data zodat het gemiddelde 0 is en de standaarddeviatie 1. Dit is nuttig wanneer data verschillende schalen en bereiken heeft, en zorgt ervoor dat elke feature een vergelijkbare impact op het model heeft.
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
standardized_data = scaler.fit_transform(data)
De specifieke kenmerken van je data en de vereisten van je beoogde model bepalen hoe je je data schaalt. Lees meer over het verschil tussen normalisatie en standaardisatie in onze tutorial Normalization vs. Standardization: How to Know the Difference.
Het encoden van categorische variabelen is een essentiële stap in machine learning wanneer je werkt met niet-numerieke features. Categorische variabelen vertegenwoordigen kwalitatieve data, zoals typen, klassen of labels. Om deze variabelen in algoritmen te gebruiken, moeten ze naar een numeriek formaat worden omgezet.
Een veelgebruikte techniek is one-hot encoding, waarbij elke categorie wordt omgezet in een binaire vector. Deze methode is vooral handig voor nominale categorische variabelen, waarbij geen inherente volgorde of hiërarchie bestaat.
import pandas as pd

encoded_data = pd.get_dummies(data, columns=['categorical_column'])
import pandas as pd

# Create a sample DataFrame with a categorical column
data = {
    'ID': [1, 2, 3, 4, 5],
    'Color': ['Red', 'Blue', 'Green', 'Red', 'Blue']
}
df = pd.DataFrame(data)

# Perform one-hot encoding
encoded_data = pd.get_dummies(df, columns=['Color'])

print("Original DataFrame")
print(df)

print("\nEncoded DataFrame:")
print(encoded_data)
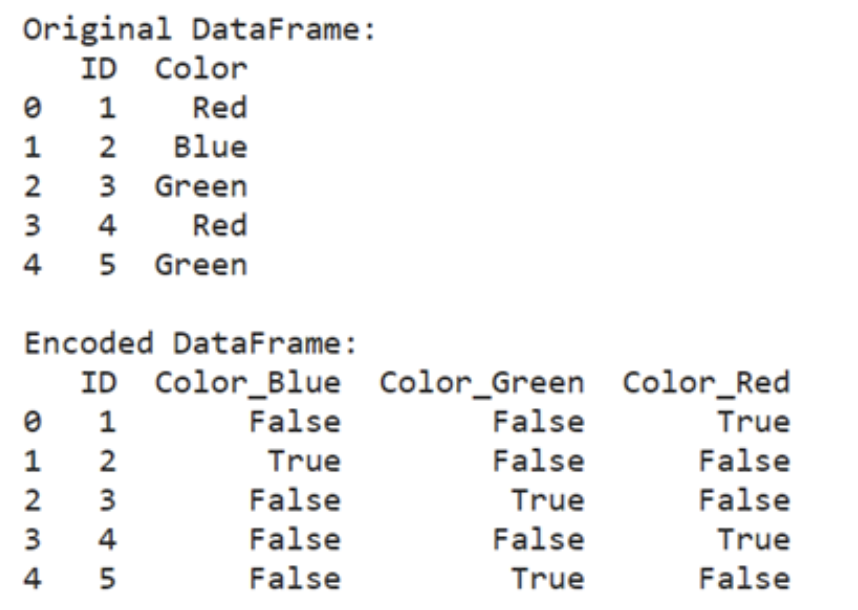
Een andere aanpak is label encoding, waarbij elke categorie een uniek geheel getal krijgt. Elke categorie wordt toegewezen aan een numerieke waarde en zo worden categorische labels effectief omgezet in ordinale nummers. Deze methode is geschikt voor ordinale categorische variabelen, waar een natuurlijke rangorde aanwezig is.
from sklearn.preprocessing import LabelEncoderencoder = LabelEncoder()encoded_data['categorical_column'] = encoder.fit_transform(data['categorical_column'])from sklearn.preprocessing import LabelEncoderimport pandas as pd#Create a sample DataFrame with categorical column data = { 'ID' : [1, 2, 3, 4, 5] 'Color' : [ 'Red', 'Blue', 'Green', 'Red', 'Green' ]}df = pd.DataFrame(data)#Perform label encodingencoder = LabelEncoder()df ['Color_LabelEncoded'] = encoder.fit_transform(df['Color'])print("Original DataFrame:")print(df[['ID', 'Color']])print("\nDataFrame with Label Encoded Column:")print(df[['ID', 'Color_LabelEncoded']])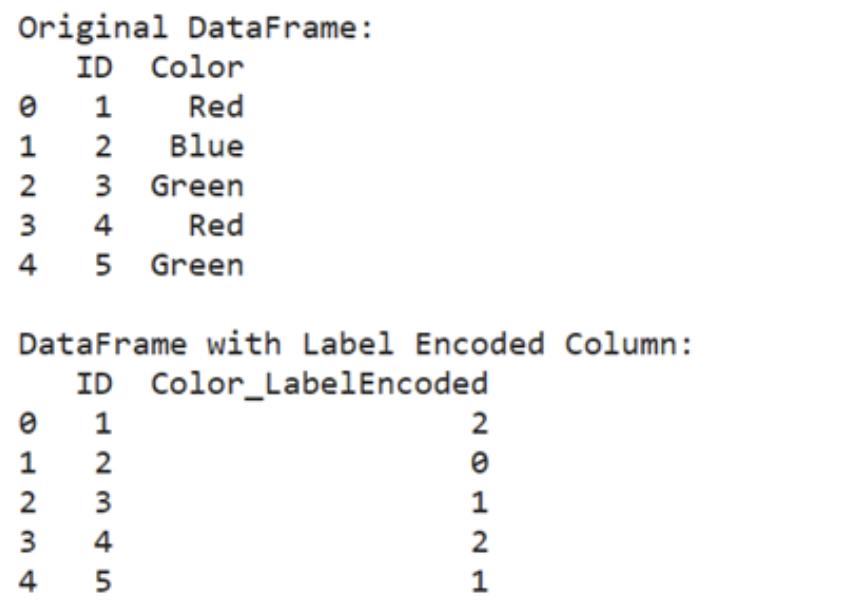
Het is belangrijk de juiste encodemethode te kiezen op basis van de aard van de categorische variabele en de eisen van het algoritme. One-hot encoding heeft meestal de voorkeur voor nominale variabelen, terwijl label encoding geschikt is voor ordinale variabelen.
Feature engineering is een stap in het ontwikkelen van machine learning-modellen waarbij je nieuwe features creëert of bestaande wijzigt. Dit is gebruikelijk wanneer ruwe data geen features bevat die direct bijdragen aan de leertaak, of wanneer bestaande features niet in een vorm staan die het algoritme effectief kan gebruiken.
Stel dat je werkt met een dataset met huizenprijzen en je de verkoopprijs wilt voorspellen op basis van features zoals het aantal kamers, de woonoppervlakte en de staat van het pand. Maar de dataset bevat geen feature die direct de algehele staat van het huis weergeeft.
In dat geval kun je een nieuwe feature creëren door bestaande features te combineren of relevante informatie te extraheren.
Je zou bijvoorbeeld een feature "Algemene staat" kunnen maken door beoordelingen van onderdelen te aggregeren, zoals de staat van de keuken, de kwaliteit van de kelder, de leeftijd van het pand, recente renovaties, enz.
Wanneer de relatie tussen features en doelvariabele niet-lineair is, kun je polynomiale features genereren door bestaande features tot verschillende machten te verheffen. Zo kun je complexe relaties vastleggen die niet lineair scheidbaar zijn.
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
polynomial_features = poly.fit_transform(data)
In andere gevallen werk je misschien met hoog-dimensionale datasets of multicollineariteit tussen features. Technieken zoals Principal Component Analysis (PCA) kunnen worden ingezet om de dimensionaliteit te reduceren met behoud van de meeste relevante informatie.
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
transformed_features = pca.fit_transform(data)
Feature engineering zorgt ervoor dat je de juiste data in het juiste formaat hebt voor je model. Er zijn veel technieken, en welke je gebruikt hangt sterk af van wat je wilt bereiken.
Bekijk deze cursus over feature engineering voor meer nuttige technieken.
Data opschonen is een cruciale stap in elk data-analyse- of machine learning-project. Hier zijn enkele best practices om je proces te stroomlijnen:
Bewaar altijd het origineel!
Dit is de allerbelangrijkste tip bij data opschonen. Bewaar een kopie van de ruwe databestanden apart van de opgeschoonde en verwerkte versies. Zo heb je altijd een referentiepunt en kun je eenvoudig terug naar de originele data als dat nodig is.
Zelf maak ik altijd een kopie van het ruwe databestand voordat ik iets wijzig en voeg ik het achtervoegsel “-RAW” toe aan de bestandsnaam zodat ik weet wat het origineel is.
Voeg comments toe aan je code om het doel van elke stap en eventuele aannames uit te leggen.
Zorg dat je opschoonwerk de verdeling niet wezenlijk verandert of onbedoelde biases introduceert. Herhaalde data exploratie na je opschoonstappen helpt te controleren of je op de goede weg bent.
Als je een lang of geautomatiseerd opschoonproces hebt, kan het nuttig zijn om in een apart document de details van elke stap vast te leggen.
Details zoals datum, specifieke actie en eventuele issues kunnen later waardevol blijken.
Bewaar dit document op een toegankelijke plek, bijvoorbeeld in dezelfde projectmap als de data of de code. In het geval van een geautomatiseerde, regelmatig bijgewerkte pipeline kun je overwegen dit logboek automatisch onderdeel van het opschoonproces te maken. Zo kun je eenvoudig checken of alles soepel verloopt.
Identificeer veelvoorkomende opschoontaken en maak er herbruikbare functies van. Zo kun je dezelfde stappen op meerdere datasets toepassen. Dit is extra handig als je bedrijfsspecifieke afkortingen wilt mappen.
Gebruik de Data Cleaning Checklist van DataCamp om niets te missen!
Data opschonen is niet zomaar een saaie klus; het is een cruciale stap die de basis vormt van elke geslaagde data-analyse en elk machine learning-project. Door te zorgen dat je data accuraat, consistent en betrouwbaar is, leg je de fundering voor onderbouwde beslissingen en betekenisvolle inzichten.
Vervuilde data kan leiden tot foutieve conclusies en gebrekkige analyses, met grote gevolgen, of je nu snoep verdeelt onder vrienden of zakelijke beslissingen neemt. Tijd en moeite investeren in opschonen betaalt zich uit, zodat je analyses betrouwbaar zijn en je resultaten bruikbaar.
Voor meer informatie en interactieve oefeningen, bekijk de data-opschoningscursus van DataCamp. Voor een hands-on uitdaging, probeer deze data cleaning code-along.
Begin vandaag nog met je data-opschoningsreis!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

