
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.4K
Stel je voor dat je een vriend een lang verhaal vertelt en je er halverwege achter komt dat hij het begin al vergeten is. Diezelfde frustratie treedt op wanneer een AI door zijn "kortetermijngeheugen" heen is en gedwongen wordt cruciale details te laten vallen om plaats te maken voor nieuwe.
In de wereld van Large Language Models (LLM’s) wordt deze aandachtsspanne bepaald door het contextvenster.
Naarmate modellen krachtiger worden en contextgroottes toenemen, wordt het begrijpen van hoe deze vensters werken cruciaal voor het bouwen van betrouwbare en schaalbare AI-systemen. In deze gids lopen we door de basis van contextvensters, de afwegingen bij het vergroten ervan en strategieën om ze effectief te gebruiken.
Wil je verder gaan dan theorie en leren hoe je contextlimieten beheert in echte Python-applicaties? Bekijk dan onze cursus Developing LLM Applications with LangChain.
Het contextvenster van een AI-model bepaalt hoeveel tekst het in zijn werkgeheugen kan vasthouden terwijl het een antwoord genereert. Het beperkt hoe lang een gesprek kan doorgaan zonder details uit eerdere interacties te vergeten.
Je kunt het zien als het kortetermijngeheugen van een mens. Het slaat informatie uit eerdere gesprekken tijdelijk op om te gebruiken voor de taak die voorligt.
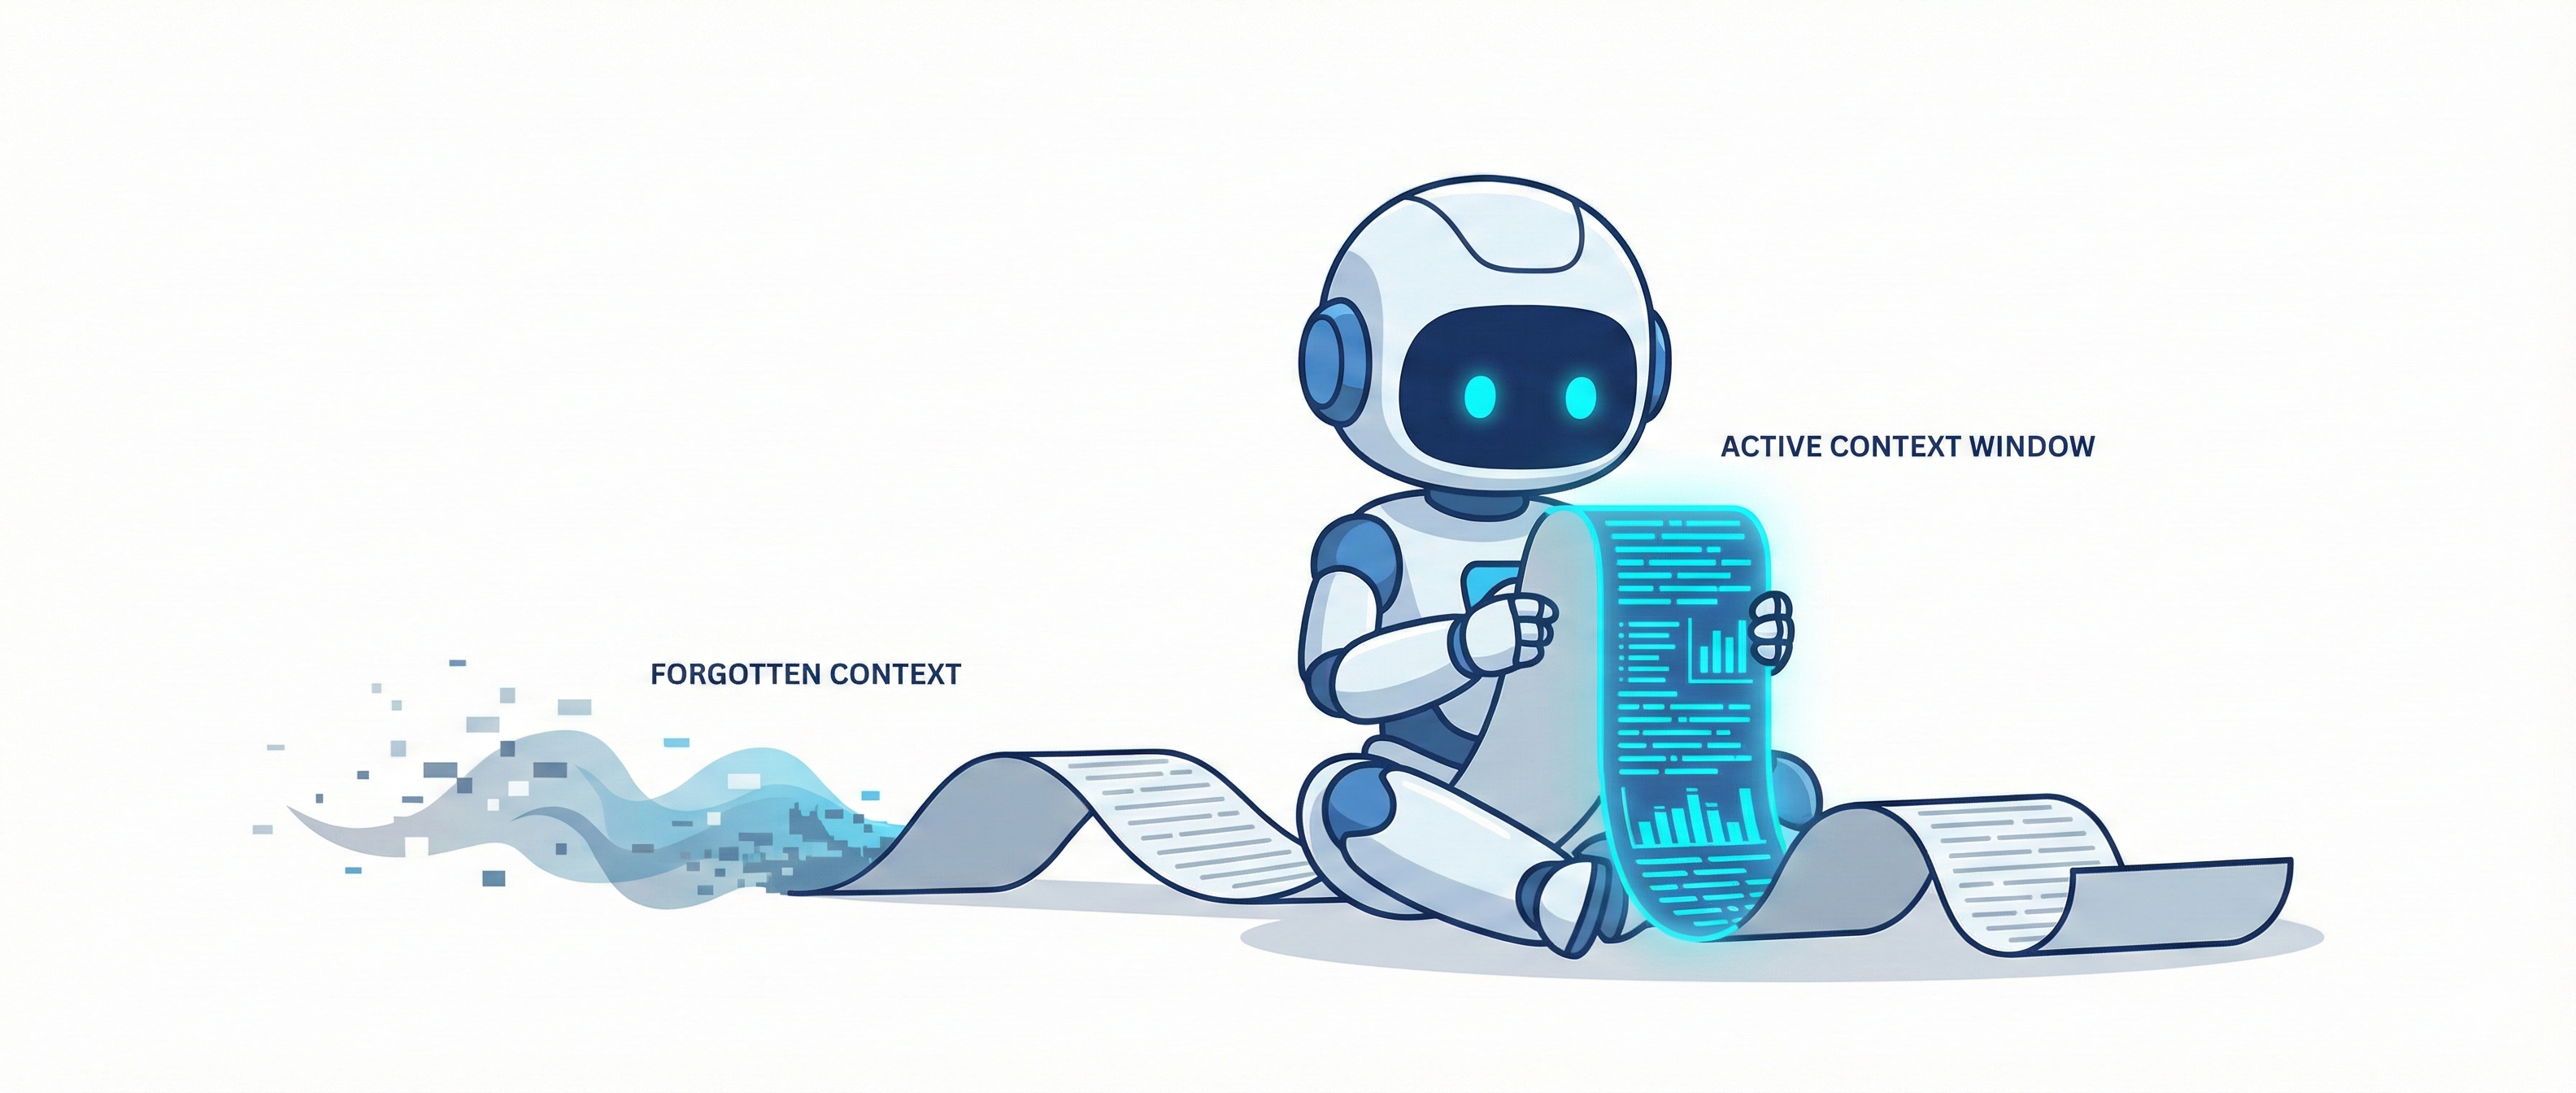
Contextvensters beïnvloeden diverse aspecten, waaronder de kwaliteit van redeneren, de diepte van het gesprek en het vermogen van het model om reacties effectief te personaliseren. Het bepaalt ook de maximale grootte van de input die het in één keer kan verwerken. Wanneer een prompt of gesprekscontext die limiet overschrijdt, kapt het model de vroegste delen van de tekst af om ruimte te maken.
Om beter te begrijpen wat dit precies betekent, kijken we naar een paar basisconcepten die ten grondslag liggen aan AI-modellen en contextvensters.
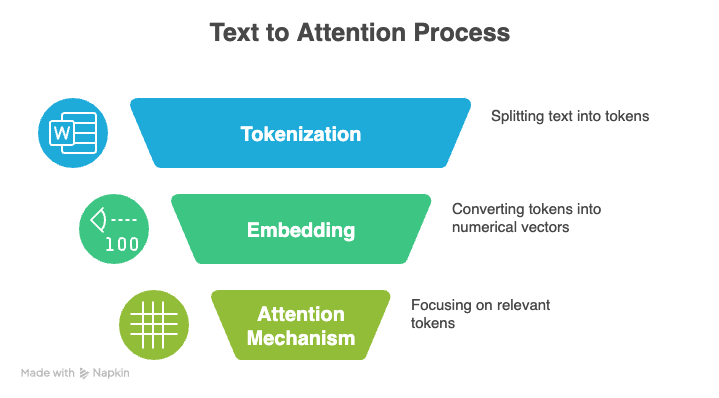
Drie kernconcepten liggen aan LLM’s ten grondslag: tokenization, het attention-mechanisme en positionele codering.
Tokenization is het proces waarbij ruwe tekst wordt omgezet in een reeks kleinere eenheden, of tokens, die een LLM kan verwerken. Deze tokens kunnen volledige woorden, afzonderlijke tekens of zelfs gedeeltelijke lettergrepen voorstellen. Gezamenlijk wordt de volledige set unieke tokens die een model herkent de woordenschat (vocabulary) van het model genoemd.
Zo kan de zin “Hello, world” worden getokenized als [“Hello”, “,”, “ world”].
Tijdens training of inferentie wordt elk token omgezet in een uniek geheel getal, en het model leest deze getallen in plaats van de originele tekst. Het analyseert de numerieke reeks, leert hoe tokens zich tot elkaar verhouden en genereert nieuwe tekst door het volgende waarschijnlijke token te voorspellen.
Efficiënte tokenization speelt een grote rol in de hoeveelheid informatie die in het contextvenster van een model past. Wanneer een tokenizer tekst met minder tokens kan weergeven, past er meer inhoud in hetzelfde venster.
Tokenizers die veelvoorkomende woorden of zinnen als één token representeren, zijn bijzonder effectief omdat ze het aantal tokens verminderen, waardoor het model langere documenten binnen zijn contextlimieten kan verwerken.
Het zogeheten attention-mechanisme is een andere pijler van moderne LLM’s. Het helpt een model zich te richten op de meest relevante delen van zijn input bij het genereren van een output.
In plaats van elk token gelijk te behandelen, vergelijkt het model de huidige representatie met alle andere tokenrepresentaties en kent het aan elke vergelijking een score toe. Deze selectieve weging stelt het model in staat lange reeksen te verwerken en context effectiever te begrijpen.
Attention is opgebouwd rond drie componenten: Queries, Keys en Values.
Queries: Het signaal dat door het huidige token wordt verzonden om te "zoeken" naar relevante informatie in de rest van de reeks.
Keys: De identifier voor elk token in de reeks die bepaalt hoe goed het overeenkomt met het zoeksignaal.
Values: De daadwerkelijke informatie-inhoud die wordt opgehaald en gebruikt wanneer een overeenkomst tussen een Query en een Key is gevonden.
Het model berekent gelijkenisscores tussen queries en keys, zet die scores om in gewichten met behulp van de softmax-activatiefunctie, en produceert vervolgens de uiteindelijke output als een gewogen som van de values.
Self-attention vergelijkt het huidige token met elk ander token in de reeks. Dit creëert een kwadratische rekenkundige kost: een verdubbeling van het contextvenster verviervoudigt de benodigde rekenkracht en het geheugen.
Naarmate contextvensters uitbreiden, wordt dit snel duur, dus modellen vertrouwen op optimalisaties zoals sparse attention, low-rank-approximatie of chunking om de berekening beheersbaar te houden.
Transformers, die moderne taalmodellen aandrijven, begrijpen van nature niet de volgorde van tokens. In plaats daarvan vertrouwen ze op positionele codering om deze informatie op te nemen.
Positionele codering voegt een klein signaal toe aan elk token dat het model helpt afstand en relatieve ordening te begrijpen.
De specifieke methode van positionele informatie bepaalt ook hoe ver het model relaties binnen een reeks betrouwbaar kan volgen, wat de grootte en effectiviteit van zijn contextvenster bepaalt. Laten we enkele populaire methoden vergelijken:
Absolute positional embeddings: Het model leert een afzonderlijke vector voor elke positie in de reeks, alsof je elk token een vast adres geeft. Dit werkt voor kortere reeksen, maar het model kan geen posities aan die het niet heeft gezien tijdens training, waardoor het contextvenster lastig uit te breiden is.
Sinusoidale encoderingen: Posities worden gecodeerd met herhalende sinus- en cosinusgolven, die elk token een uniek patroon geven op basis van zijn locatie. Ze generaliseren beter naar ongeziene lengtes dan absolute embeddings, al worden ze minder stabiel bij extreem lange reeksen.
Relatieve positionele encoderingen: In plaats van exacte posities te markeren, leert het model de afstand tussen tokens. Dit helpt te generaliseren naar langere reeksen, maar de algehele contextlimiet hangt nog steeds af van de architectuur en het geheugen van het model.
Rotary Positional Embeddings (RoPE): RoPE codeert positie door de vectorrepresentatie van elk token te roteren op basis van zijn absolute positie, en berekent zo de afstand tot andere tokens. Deze methode blijft stabiel bij groeiende reeksen en ondersteunt veel grotere contextvensters.
ALiBi (Attention Linear Biases): ALiBi brengt een eenvoudige afstandsgebonden bias aan binnen het attention-mechanisme, waardoor dichtere tokens van nature hoger worden gewogen. Het schaalt goed naar lange reeksen.
Ik raad je aan deze tutorial over hoe transformers werken te bekijken voor een gedetailleerd overzicht.
Als de context het contextvenster overschrijdt, kan het model de vroegste delen afkappen of negeren, waardoor mogelijk belangrijke context verloren gaat. Daarom experimenteren onderzoekers voortdurend met nieuwe technieken om deze limieten op te rekken en langere contextvensters mogelijk te maken.
Tot 2022 domineerden de GPT-modellen van OpenAI het landschap. Het eerste GPT-model, uitgebracht in 2018, ondersteunde een venster van 512 tokens. De twee volgende versies in 2019 en 2020 verdubbelden die limiet telkens, tot 2.048 tokens voor GPT-3. Opeenvolgende modellen bleven deze grenzen verruimen tot wel één miljoen tokens (GPT-4.1).
Recent is OpenAI ingehaald of zelfs voorbijgestreefd door de concurrentie. Google’s Gemini 2.5 en 3 Pro evenaren deze venstergrootte van tot een miljoen tokens, waardoor het mogelijk wordt om volledige boeken, grote codebases en multidocument-workloads in één keer te verwerken.
Anthropic’s Claude Sonnet 4.5-serie test momenteel dezelfde contextvenstergrootte in bèta, een uitbreiding vanaf de oorspronkelijke 200.000 tokens.
Open-source modelfamilies zoals Llama en Mistral zitten doorgaans in de range van 100k tot 200k, met degelijke prestaties op lange context terwijl ze praktisch lokaal te deployen of te fine-tunen blijven.
Uitzonderingen zijn onder meer Llama Maverick, dat een venster van 1 miljoen tokens ondersteunt, ontworpen voor generieke redenering over lange documenten. Ondertussen verlegt Llama Scout de grens nog verder met een enorme capaciteit van 10 miljoen tokens, specifiek ontwikkeld om volledige codebases of juridische archieven in één keer te verwerken.
De release van GPT-5.2 deze week markeert echter een koerswijziging. In plaats van te jagen op oneindige context, beperkte OpenAI zijn nieuwste vlaggenschip tot een venster van 400.000 tokens, waarbij ruwe grootte wordt ingeruild voor ‘perfecte recall’ en superieure redeneercapaciteiten die de afleidingsproblemen vermijden die veel voorkomen bij grotere modellen.
Verschillen in contextvenstergrootte bepalen hoe elk model presteert in echte workflows. Uitgebreide contextvensters geven modellen sterke nauwkeurigheid, samenhang en langetermijnredenering, maar vereisen ook meer rekenkracht en zorgvuldiger contextselectie.
Modellen in het middensegment blijven efficiënt en kunnen nog steeds lange documenten en uitgebreide chats aan, al hebben ze de juiste structuur nodig voor zeer grote inputs.
De volgende use-cases laten zien hoe de sterke punten van modellen met grote contextvensters tot uiting komen in toepassingen in de echte wereld.
Met genoeg ruimte om volledige rapporten, transcripties, codebases of onderzoeksartikelen in één keer vast te houden, kan een model patronen volgen, verre details verbinden en een samenhangend begrip van begin tot eind behouden. Dit biedt tal van toepassingsgebieden:
Juridisch: Grote vensters stellen modellen in staat volledige contracten te analyseren, clausules over meerdere documenten te vergelijken en verwijzingen te volgen die in lange documenten verborgen zitten.
Gezondheidszorg: Teams kunnen lange klinische richtlijnen, patiëntgeschiedenissen of datasets uit meerdere studies doorlopen, terwijl belangrijke context behouden blijft die kleinere vensters zouden missen.
Onderzoek: Een model met een groot venster kan volledige papers en literatuurreviews in één keer lezen en verbindingen naar boven halen die alleen zichtbaar worden als het hele document in beeld is.
Grotere contextvensters laten conversationele AI natuurlijker aanvoelen, omdat het model meer van het gesprek kan onthouden zonder eerdere berichten te vergeten.
In klantenservice zorgt dit voor soepelere en persoonlijkere interacties. Het model kan eerdere voorkeuren en gesprekken gebruiken om nauwkeurigere en relevantere antwoorden te geven.
Uitgebreide contextvensters ondersteunen complexe redenering over tekst, audio en beeld door het model genoeg ruimte te geven om alle modaliteiten samen te houden in plaats van ze los te verwerken.
Wanneer het volledige transcript, visuele frames en gerelateerd schriftelijk materiaal in één venster passen, kan het model details over formaten heen vergelijken, verbanden volgen en een geïntegreerd begrip van de context opbouwen.
Dit elimineert de gaten die ontstaan wanneer informatie moet worden opgeknipt of samengevat, en stelt het model in staat in één keer over de volledige set inputs te redeneren.
Grote contextvensters ontsluiten krachtige modelmogelijkheden, maar brengen ook nieuwe prestatie-uitdagingen met zich mee naarmate de inputgrootte groeit. Zelfs geavanceerde modellen hebben moeite om perfecte aandacht vast te houden over extreem lange reeksen, waardoor ze niet altijd even betrouwbaar informatie uit elk deel van de context gebruiken als je zou verwachten.
Een veelvoorkomend probleem bij lang-contextmodellen is het “lost in the middle”-effect. Modellen onthouden het begin en einde van een lange reeks vrij goed, maar missen of negeren vaak belangrijke details die in het midden verstopt zitten. Dit kan tot zwakkere antwoorden leiden, zelfs wanneer de volledige context beschikbaar is.
Een slimme structuur van de input helpt dit te voorkomen bij belangrijke taken. Dat betekent opsplitsen in duidelijke secties of kernpunten herhalen, zodat het model ze niet over het hoofd ziet.
Kosten kunnen snel oplopen naarmate het contextvenster groter wordt. Elk extra token vergroot de omvang van de attention-berekening, wat de inferentietijd, GPU-geheugenbehoefte en de totale systeembelasting verhoogt.
Om dit te beheersen, zijn effectievere manieren nodig om het model van informatie te voorzien. Technieken zoals selectieve retrieval, hiërarchische chunking of korte samenvattingen helpen de input klein te houden, zodat het model niet overbelast raakt.
Grote vensters brengen ook zorgen met zich mee rond veiligheid, beveiliging en privacy. Wanneer je het model meer input geeft, is de kans groter dat gevoelige gegevens worden blootgesteld.
Daarom hebben teams robuuste regels voor gegevensverwerking, redactiestappen en toegangscontrole nodig om te zorgen dat grote contextvensters geen nieuwe risico’s creëren.
In veel gevallen verhoogt onnodige of losjes gerelateerde informatie de cognitieve belasting voor het model, wat het risico op hallucinaties en onjuiste patronen vergroot. Lange inputs introduceren ook ruis die het begrip van de taak kan vertekenen.
In de praktijk komt hoge kwaliteit vaak voort uit zorgvuldig samengestelde context, zodat het model de juiste informatie ziet in plaats van simpelweg de meeste informatie.
Er zijn verschillende methoden om contextvensters optimaal te benutten. Daaronder vallen Retrieval Augmented Generation (RAG), context engineering, chunking en modelselectie.
Retrieval Augmented Generation (RAG) werkt door aanvullende informatie uit een externe database op te halen en aan het model te voeren wanneer er context nodig is.
In plaats van volledige documenten in het contextvenster te proppen, slaat RAG alles afzonderlijk op en haalt het alleen de stukken op die relevant zijn voor de huidige vraag. Dit houdt de context klein en geeft het model toch alle informatie die het nodig heeft.
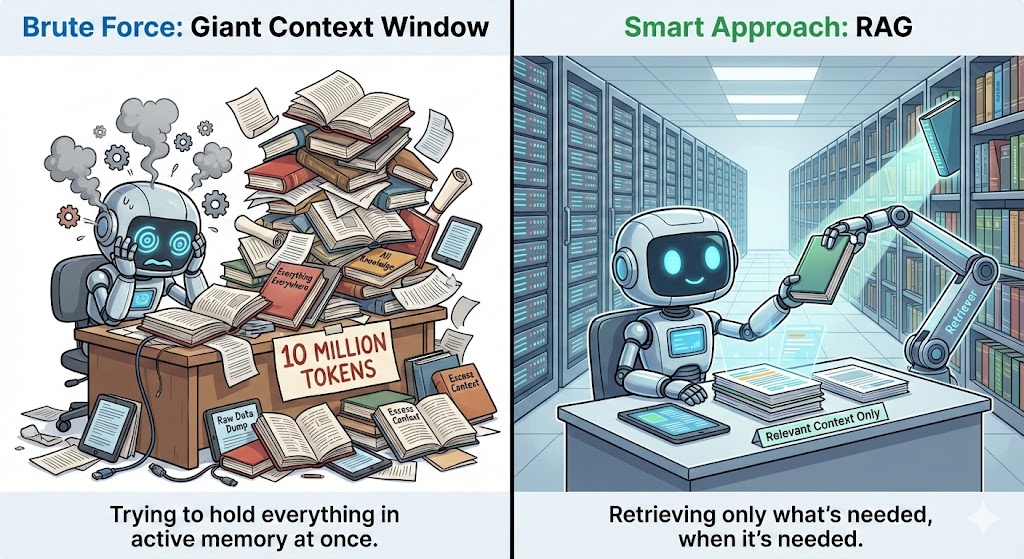
Dit doet het met embeddings of vector search om de meest relevante fragmenten te vinden en die op een schone, gestructureerde manier naar het model te sturen. Dit verhoogt de nauwkeurigheid doordat het model relevante extra informatie kan gebruiken buiten zijn trainingsdata.
Context engineering richt zich erop modellen relevante informatie te geven in plaats van ze te overladen met onnodige details. Effectieve strategieën zijn onder meer het segmenteren van lange documenten, het samenvatten van secties met lage waarde en lichte voorverwerking om hoofdpunten te benadrukken.
Semantisch zoeken helpt hierbij door de tekst te identificeren die voor de huidige query van belang is. Je kunt de resultaten ook verbeteren door de belangrijkste informatie naar het begin of einde van de context te verplaatsen, omdat modellen die plekken doorgaans beter onthouden.
Chunking hakt lange documenten op in kleinere, samenhangende secties. Het idee is om inhoud te groeperen op basis van onderwerp, structuur of de taak die het ondersteunt.
Dit houdt elke chunk samenhangend en helpt het model gefocust te blijven in plaats van te verdwalen in een enorme tekstblok. Wil je meer weten? Bekijk dan dit artikel over geavanceerde chunking-strategieën.
Semantische chunking groepeert zinnen die een vergelijkbare betekenis delen, in plaats van de tekst op willekeurige tekenlimieten te knippen. Het splitst de inhoud op natuurlijke breekpunten zoals onderwerpverschuivingen, overgang tussen alinea’s of sectiekoppen.
Taakgerichte chunking gaat nog een stap verder door elke chunk te vormen rond de specifieke vraag die je probeert te beantwoorden. Elke sectie bevat dan alleen de informatie die daadwerkelijk relevant is voor die taak.
Taken die volledige documentanalyse, redeneren over meerdere bestanden of langdurige gesprekken omvatten, profiteren van modellen met vensters in het bereik 200k–1M. Voor meer gefocuste taken zoals samenvatten, code review of kort-vragen-beantwoorden bieden modellen in de 100k–200k range vaak de beste balans tussen snelheid, kosten en nauwkeurigheid.
Kleinere vensters kunnen nog steeds goed presteren in combinatie met sterke retrievalsystemen. Een goed RAG-systeem of Model Context Protocol (MCP) kan de juiste informatie on-demand ophalen, zodat het model niet alles in zijn geheugen hoeft te houden.
Voordat we afronden, kijken we naar waar de technologie heengaat op het gebied van contextvensters.
Toekomstige modelarchitecturen bewegen richting dynamische contextvensters in plaats van vensters met vaste grootte.
Onderzoekers verkennen benaderingen die de sterke punten van transformers combineren met nieuwe geheugen-systemen voor lange afstanden, wat resulteert in modellen die informatie kunnen opslaan en terughalen zonder uitsluitend op attention-mechanismen te vertrouwen.
Deze architecturen overwinnen de beperkingen van vandaag door te verschuiven van statische contextvensters naar dynamische geheugenniveaus die meegroeien met de taak.
Geheugensystemen zijn een ander innovatiedomein. We verwachten dat toekomstige modellen meer zullen leunen op contextbewuste geheugensystemen die verder reiken dan één sessie en continuïteit in de tijd bieden.
In plaats van elk gesprek als een frisse start te behandelen, slaan deze systemen sleutelvoorkeuren, eerdere beslissingen en terugkerende thema’s op in een gestructureerde geheugenzaaglaag die kan worden opgeroepen wanneer relevant.
Hiermee verschuift personalisatie van reactief naar proactief, waardoor het model gebruikers holistischer kan begrijpen en langlopende doelen veel consistenter kan ondersteunen.
Externe retrieval ontwikkelt zich ook. Op dit moment werkt RAG als een zoekmachine die relevante tekst in de prompt trekt. Geavanceerde varianten zoals Corrective Retrieval-Augmented Generation (CRAG) zijn al opgekomen, maar dat is nog maar het begin.
In de toekomst zal retrieval meer ingebouwd aanvoelen, bijna alsof het model zijn eigen extern geheugen heeft. Modellen zullen automatisch informatie verzamelen, comprimeren en opnieuw aanbieden met minimale gebruikersinteractie.
Persistent geheugen zal ook veranderen hoe we met AI omgaan. In plaats van alles te vergeten wanneer een sessie eindigt, zal het model belangrijke details over dagen, weken of zelfs maanden onthouden. Naarmate het je stijl, gewoonten en prioriteiten leert kennen, kan het je meer op maat gemaakte en nuttige antwoorden geven, zonder dat je jezelf hoeft te herhalen.
Tools zoals Mem0 zijn al pionier op deze aanpak en fungeren als een toegewijde geheugenlaag tussen applicaties en LLM’s. Vooruitkijkend verwachten we echter dat meer van deze mogelijkheden direct in modelarchitecturen worden ingebouwd, in plaats van te vertrouwen op externe lagen.
Grotere vensters ontsluiten krachtige nieuwe workflows, maar introduceren ook attention-uitdagingen, hogere rekenkosten en kwaliteitsrisico’s wanneer de context overladen wordt. Dit maakt strategisch contextbeheer essentieel.
Technieken zoals retrieval augmentation, semantische chunking en context engineering helpen modellen gefocust, efficiënt en betrouwbaar te blijven, zelfs naarmate hun capaciteiten groeien.
Vooruitkijkend combineren de beste LLM-aangestuurde systemen slimme tools met een goed begrip van hoe context het redeneren beïnvloedt. Door deze principes toe te passen, kunnen teams de voordelen van lang-contextmodellen benutten en zich tegelijkertijd voorbereiden op de volgende generatie architecturen die de contextgrenzen nog verder oprekken.
Til je Python-basis naar een hoger niveau met de Developing Large Language Models skill track. Deze is ontworpen om je te begeleiden van fundamentele code naar het bouwen en fine-tunen van je eigen krachtige AI-applicaties.
LLM-cursussen
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

