¿Quieres iniciarte en la IA Generativa?
Aprende a trabajar con LLMs en Python directamente en tu navegador
¿Qué es Llama 3?
Llama 3 es una IA de generación de texto. Es decir, al igual que los modelos GPT de OpenAI y Claude de Anthropic, tú escribes un prompt y genera una respuesta en texto. Los últimos modelos prometen un rendimiento mejorado, especialmente en comprensión del contexto y razonamiento lógico. Los modelos Llama impulsan Meta AI, el asistente inteligente integrado en Instagram, WhatsApp, Messenger y Facebook.
Llama 3 es un modelo de "pesos abiertos". Esto significa que el propio modelo es de código abierto, lo que aporta cierta transparencia sobre cómo realiza los cálculos. Aun así, no están disponibles públicamente todos los detalles para recrearlo, como los conjuntos de datos usados para entrenarlo.
Una imagen de 3 llamas creada con Midjourney. Prompt usado: "A cartoon of 3 llamas happily frolicking in a field"
Nuevas capacidades de Llama 3
Llama 3 está disponible en dos tamaños: un modelo de 8.000 millones de parámetros y otro de 70.000 millones. En general, más parámetros implican una mejor calidad de salida, pero hacen que el modelo sea más lento y caro de ejecutar. 70.000 millones es comparable a muchos modelos competidores, aunque también hay modelos con tamaños de parámetros aún mayores. Un tercer modelo, más grande, con 400.000 millones de parámetros se ha anunciado como en desarrollo.
La ventana de contexto—la cantidad de texto que el modelo puede considerar de una vez—se ha duplicado de 4.096 a 8.192 tokens. Un token se refiere a una palabra o signo de puntuación, aunque algunas palabras se dividen en varios tokens. En inglés, cuatro tokens equivalen aproximadamente a tres palabras, así que la nueva ventana de contexto equivale a unas 15 páginas de texto (a 400 palabras por página). Aunque el incremento se agradece, aún está lejos de la vanguardia: los modelos Claude 3 ofrecen una ventana de 200.000 tokens.
No se detallaron más características del modelo en el artículo del anuncio. En su lugar, gran parte del foco se puso en el ecosistema de software que lo rodea.
Ecosistema de Llama 3
Junto al anuncio de Llama 3, Meta presentó un conjunto de herramientas para trabajar con Llama de forma más sencilla y segura. Aquí tienes un resumen.
Llama Guard 2
Llama Guard 2 es una herramienta LLM para clasificar texto como "seguro" o "no seguro". Se puede usar tanto con los prompts como con las respuestas. Por ejemplo, puede detectar si el texto contiene descripciones de violencia, discurso de odio u otros contenidos inapropiados.
Un caso de uso típico es un chatbot. Puedes revisar cada prompt y, si se marca como no seguro, mostrar un aviso u otro mecanismo para gestionar el contenido problemático. De forma similar, si el chatbot genera una respuesta marcada como no segura, puedes interceptarla e intentar de nuevo antes de que el usuario la vea.
Además de la etiqueta seguro/no seguro, las respuestas de Llama Guard 2 incluyen una etiqueta de seguridad—una de once categorías de contenido inapropiado de la taxonomía de seguridad en IA de MLCommons.
Llama Code Shield
Llama Code Shield clasifica código como seguro o inseguro. Dado que muchos desarrolladores utilizan LLM para ayudarles a escribir código, existe el riesgo de que se genere código inseguro y llegue a producción. La herramienta está pensada para incorporarse en asistentes de programación con IA y para integrarse con otras herramientas como VSCode y DataLab.
CyberSec Eval 2
CyberSec Eval 2 te permite evaluar cuán seguro es un LLM. La versión original permitía evaluar la seguridad en la generación de código y la protección frente a ciberataques. La versión más reciente amplía esto con funciones para evaluar la susceptibilidad a inyección de prompts, capacidades ofensivas automatizadas de ciberseguridad y la propensión a abusar de un intérprete de código.
torchtune
torchtune es un paquete de Python que trabaja junto al framework de deep learning PyTorch para facilitar el desarrollo de tus propios LLM. Incluye herramientas para cuatro tareas:
- Crear modelos nuevos a partir de bloques basados en LLM existentes
- Ajuste fino de LLM usando técnicas como LoRA y QLoRA
- Configurar parámetros para el entrenamiento, la cuantización y la evaluación de los modelos
- Plantillas de prompts e integración de datasets para un entrenamiento más accesible
torchtune se integra con plataformas populares de machine learning como Hugging Face, Weights & Biases, EleutherAI y Executorch.
¿Cuáles son los casos de uso de Llama 3?
Los casos de uso de Llama 3 son los mismos que los de Llama 2 y otros LLM. Entre los más comunes están los siguientes:
- Chatbots: Automatizar la atención al cliente, el soporte y la interacción mediante agentes conversacionales.
- Resumen de documentos: Condensar documentos largos en versiones más breves que destaquen los puntos clave; útil en contextos legales, académicos y de negocio.
- Creación de contenido: Generar artículos, informes, blogs e incluso escritura creativa como poesía e historias.
- Asistencia en comunicaciones y email: Automatizar la redacción de correos, respuestas y otras comunicaciones rutinarias.
- Descripciones de producto: Generar automáticamente descripciones únicas y atractivas para e-commerce.
- Herramientas educativas: Crear guías de estudio, preguntas de examen y contenido educativo adaptado al nivel del alumnado.
- Programación y generación de código: Ayudar a desarrolladores generando fragmentos de código, depurando código existente o aportando recomendaciones.
- Informes de análisis de datos: Resumir hallazgos y generar informes a partir de datos estructurados.
- Asistentes virtuales: Impulsar apps de asistente personal que gestionan agendas, responden preguntas y ejecutan tareas.
¿Cómo se compara el rendimiento de Llama 3?
El anuncio de Meta muestra resultados de benchmarks para las versiones de Llama 3 con ocho mil millones (8B) y setenta mil millones (70B) de parámetros frente a otros dos modelos.
Se utilizaron los siguientes benchmarks:
- Massive Multitask Language Understanding (MMLU). Tareas sobre matemáticas elementales, historia de EE. UU., informática, derecho y más. Para lograr alta precisión, los modelos deben poseer amplio conocimiento del mundo y capacidad de resolución de problemas.
- Graduate-Level Google-Proof Q&A (GPQA). Preguntas de opción múltiple escritas por expertos en biología, física y química. Son de gran calidad y extremadamente difíciles: expertos con doctorado (o en curso) alcanzan un 74% de acierto.
- HumanEval. Prueba de corrección funcional de código, usada para evaluar generación de código.
- GSM-8K. Problemas de matemáticas de primaria con gran diversidad lingüística.
- MATH. Problemas de matemáticas de secundaria y bachillerato.
El modelo Llama 3 8B se comparó con Gemma 7B It de Google y Mistral 7B Instruct. Son LLM de tamaño comparable (número similar de parámetros), modelos de pesos abiertos disponibles en la plataforma Hugging Face y orientados a usos similares. Los resultados se muestran en la figura 1.
Llama 3 8B supera con holgura a los otros dos modelos en los cinco benchmarks.
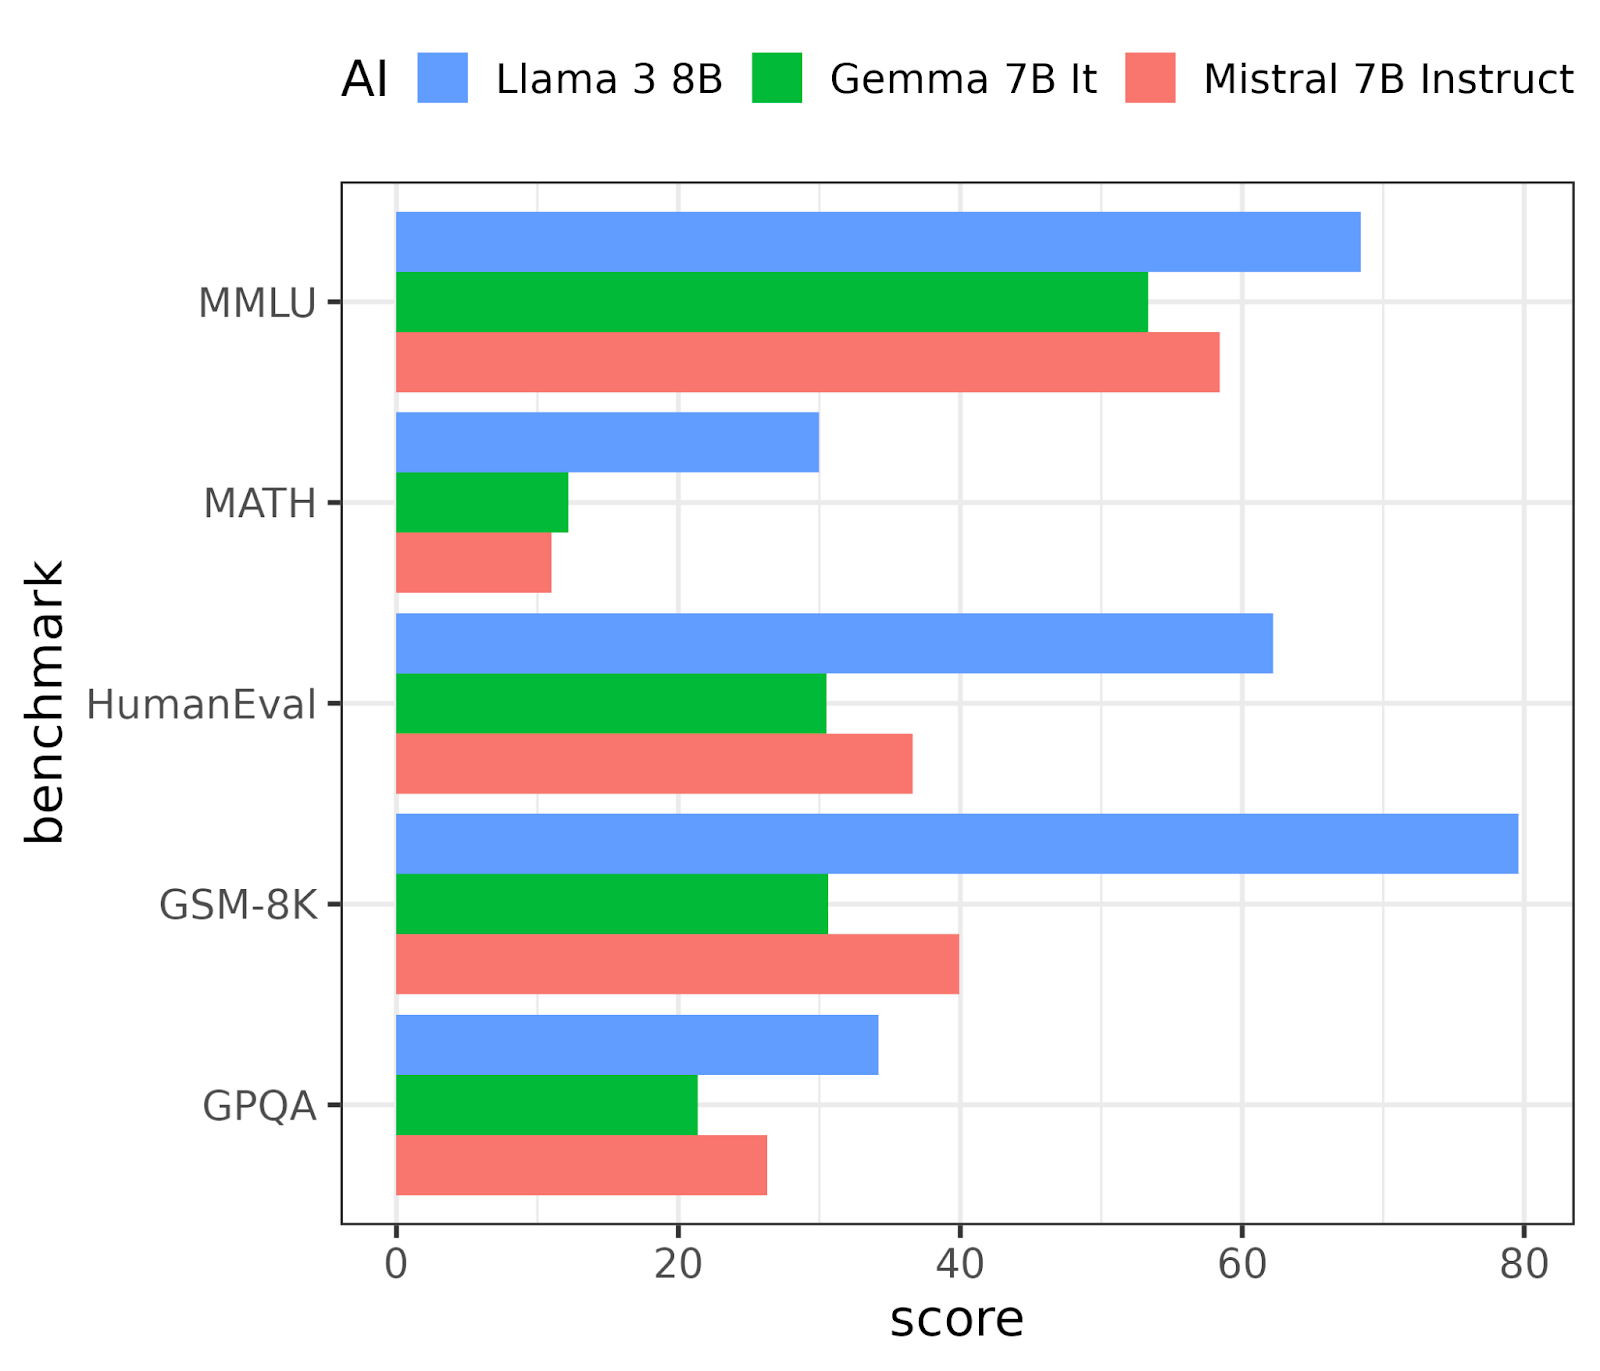
Figura 1. Rendimiento de Llama 3 8B frente a dos modelos comparables en 5 benchmarks de LLM.
Llama 3 70B se comparó con Gemini Pro 1.5 de Google DeepMind y Claude 3 Sonnet de Anthropic. Son modelos cercanos al estado del arte, aunque no los de mayor rendimiento disponible (ese honor se alterna actualmente entre GPT-4 Turbo de OpenAI y Claude 3 Opus de Anthropic). Los resultados se muestran en la figura 2.
Aquí, el rendimiento está prácticamente empatado en tres de los benchmarks. Llama 3 80B gana en HumanEval para generación de código y queda segundo tras Gemini Pro 1.5 en el benchmark MATH.
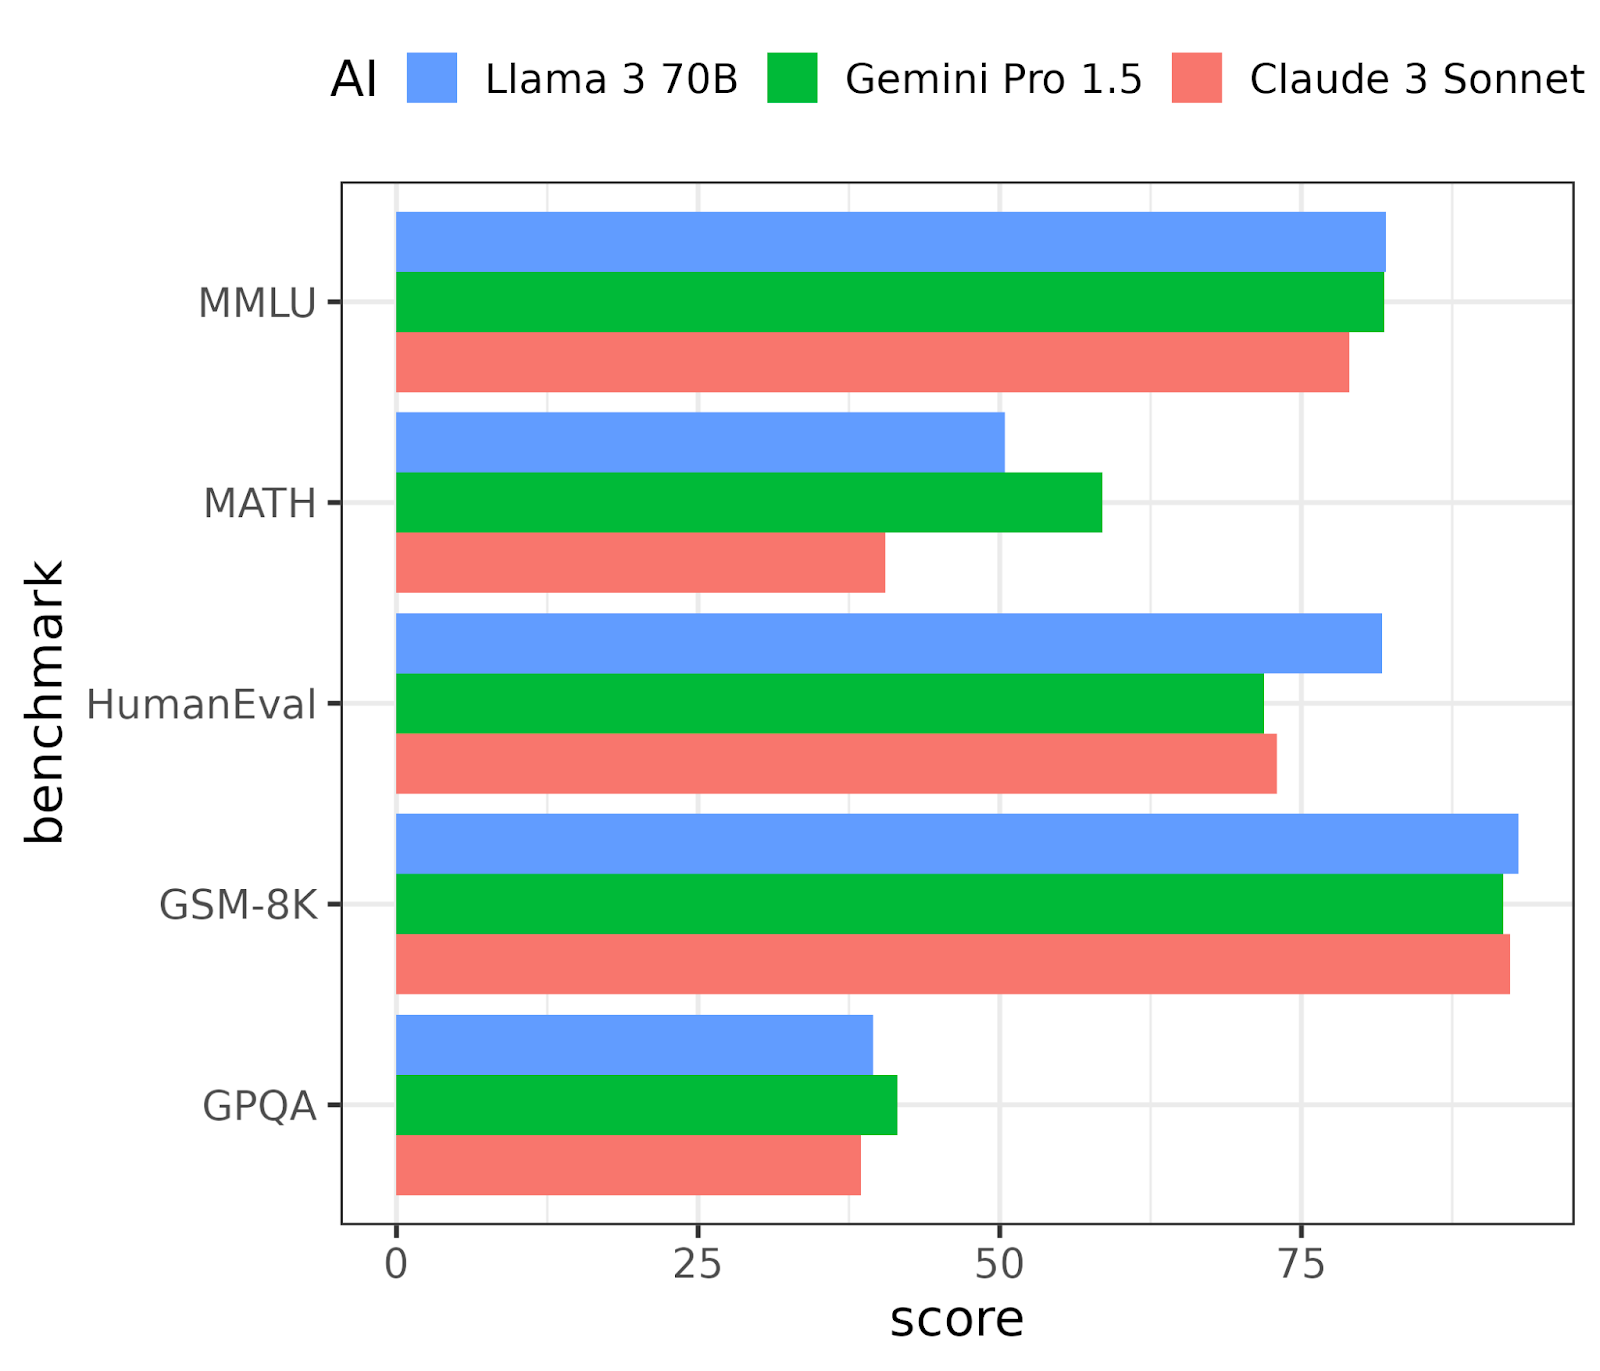
Figura 2. Rendimiento de Llama 3 70B frente a dos modelos comparables en 5 benchmarks de LLM.
Cómo interpretar los resultados
Hay más de cinco benchmarks: Llama 3 se evaluó en 15, pero en el anuncio solo se mostraron los resultados de cinco. Del mismo modo, hay muchas más opciones de LLM con los que comparar. No está claro hasta qué punto Meta pudo seleccionar los resultados más favorables.
En segundo lugar, la calidad de la salida es solo una medida del rendimiento. El tiempo y el coste de generar respuestas también importan y no se cubren en el anuncio.
En tercer lugar, el rendimiento siempre varía según el caso de uso, así que necesitas probarlo en tus propios problemas y con tu propio hardware para obtener resultados precisos para tus necesidades.
Ranking en Chatbot Arena
En los días posteriores al anuncio de Meta, el rendimiento de Llama 3 ha aparecido en el LMSYS Chatbot Arena Leaderboard, un ranking público de LLM. Llama 3 70B ocupa actualmente el 6.º puesto, la posición más alta de cualquier LLM de pesos abiertos. (Por delante están varias versiones de OpenAI GPT-4, Anthropic Claude 3 Opus y Google Gemini Pro). Mientras tanto, Llama 3 8B está en el puesto 14.
Son ascensos notables en el ranking y merece la pena explorar qué ha cambiado desde Llama 2.
¿Cómo funciona Llama 3?
Llama 3 utiliza una arquitectura transformer solo decodificador, como sus predecesores y la serie GPT. Es la arquitectura más común para modelos que generan texto. (El tipo opuesto, arquitecturas solo codificador, se usan para entender o clasificar texto proporcionado por el usuario).
El anuncio de Llama 3 no describe cambios radicales en la estructura del modelo o el proceso de entrenamiento. En su lugar, hay muchas optimizaciones en los equilibrios entre calidad de respuesta, velocidad y desarrollo.
Un nuevo tokenizador, que convierte texto en tokens, es más eficiente: los prompts y respuestas ocupan un 15% menos de tokens, lo que permite encajar más texto en la ventana de contexto.
Un nuevo mecanismo de atención—la técnica que usan los LLM para decidir qué palabras o frases son esenciales para generar la salida—llamado grouped query attention, ofrece un mejor equilibrio entre calidad de salida y velocidad de generación frente a mecanismos anteriores.
El conjunto de entrenamiento es siete veces mayor que el de Llama 2 e incluye cuatro veces más código. En general, cuanto más código hay en los datos de entrenamiento, mejor se comportan los LLM generando código.
Curiosamente, se usó el modelo Llama 2 para evaluar y clasificar datos que se incluirían en el entrenamiento de Llama 3. El uso de IA para crear una IA aún mejor es un clásico de la ciencia ficción (es un punto clave en The Hitchhiker's Guide to the Galaxy) y ahora se está llevando a la práctica.
El proceso de postentrenamiento también se ha optimizado. Tras crear un LLM, ese LLM "en bruto" puede afinarse para mejorar su rendimiento. Meta señala que el proceso de Llama 3 incluye las siguientes técnicas:
- Ajuste fino supervisado, una técnica de aprendizaje supervisado donde se usan pares de prompts y respuestas de alta calidad como ejemplos de buena salida.
- Muestreo por rechazo, en el que se generan y clasifican varias salidas y se descartan las peores.
- Técnicas de aprendizaje por refuerzo como Direct Policy Optimization y Proximal Policy Optimization, donde el modelo recibe una recompensa por buenas respuestas.
¿Qué no incluye?
Hay algunas ausencias destacables en esta versión.
Sin IA multimodal
ChatGPT de OpenAI combina la IA de texto GPT-4 con la IA de imagen DALL∙E 3; es decir, es "multimodal". El anuncio de Meta sugiere que hacer Llama 3 multimodal es un objetivo a corto plazo.
Sin IA multilingüe
Se describe que el conjunto de datos de Llama 3 contiene un 95% de texto en inglés. Esto implica que el rendimiento en otros idiomas será sensiblemente más débil. Como en el caso multimodal, una versión multilingüe de Llama 3 está en la hoja de ruta.
Sin Mixture of Experts
No se menciona en el anuncio el uso de una arquitectura de mixture of experts. Con esta técnica, un LLM se compone de varios LLM más pequeños especializados en tareas concretas (por ejemplo, generación de código, resumen de documentos y diálogo). Fue popularizada por los modelos Mixtral de Mistral AI y se rumorea que es la base de GPT-4 de OpenAI, lo que mejora el rendimiento por parámetro. Es decir, puedes lograr el mismo rendimiento con un modelo más pequeño (y por tanto más barato y rápido) usando esta técnica. Dado que Meta no la menciona (ni aparece en el repositorio de GitHub de Llama 3), podemos asumir que no se ha utilizado.
Sin world model
Yann LeCun, Chief AI Scientist de Meta, ha sido un firme defensor de los world models, donde la IA desarrolla un modelo interno de cómo funciona el mundo para aprender más rápido, realizar tareas complejas y adaptarse a situaciones desconocidas. No hubo mención de esta arquitectura en el anuncio, así que parece que Llama 3 no la incorpora.
¿Dónde puedo acceder a Llama 3?
Llama 3 se puede descargar desde su sitio web y desde su repositorio de GitHub. Ya impulsa el asistente Meta AI en Facebook, Instagram, WhatsApp y Messenger, so puedes probar Llama 3 de forma implícita usando Meta AI en esas plataformas.
Se han anunciado integraciones "próximamente" con AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM y Snowflake, que te permitirán acceder a Llama 3 desde esas plataformas.
¿Importa Llama 3?
En el extremo alto del rendimiento, la historia reciente del panorama de los grandes modelos de lenguaje es la pugna entre GPT-4 de OpenAI y Claude 3 Opus de Anthropic por la supremacía, con Google Gemini Pro y Command R+ de Cohere pisándoles los talones. Está por ver si la versión de mayor tamaño de Llama 3 que está en desarrollo será una aspirante al trono, pero mientras tanto Meta ha logrado mejoras sustanciales de rendimiento con Llama 3.
En los últimos años, los modelos cerrados (en los que los detalles del modelo no son públicos) han superado a los más abiertos. El hecho de que Llama 3 se haya colocado en 6.º lugar en el ranking es, por tanto, muy significativo.
El principal objetivo a corto plazo de Meta para Llama es simplemente impulsar el asistente inteligente Meta AI de sus plataformas sociales. Es un modelo de negocio muy distinto al de OpenAI, Anthropic o Cohere, que buscan vender sus LLM para integrarlos en productos de IA de otras empresas. En este sentido, los benchmarks de generación de código o resolución de problemas matemáticos pueden no ser tan relevantes para la compañía.
Meta cuenta con un conjunto de entrenamiento único: las publicaciones sociales de sus miles de millones de usuarios y—al margen del prestigio—el único indicador que importa es: "¿Responde Llama 3 suficientemente a las necesidades de los usuarios de redes sociales?"
Además, el enfoque de pesos abiertos implica que Llama 3 puede ser más barato de ejecutar que la competencia. Al esencialmente regalar la IA, ejerce presión a la baja sobre los precios que sus competidores pueden cobrar por sus APIs. Esto es clave, porque el optimismo desbordante de 2023 y los sueños de mejoras ilimitadas en IA generativa han dado paso a un 2024 más sobrio, en el que las direcciones han empezado a notar lo caro que resulta ofrecer funciones con LLM, y el rendimiento por euro se ha convertido en una prioridad.
Los modelos de pesos abiertos también son importantes cuando la privacidad de los datos es fundamental, por ejemplo, con datos financieros, sanitarios o información de identificación personal. Enviar datos tan sensibles a un LLM alojado por otra empresa (como ocurre con GPT y otros modelos cerrados) supone un riesgo empresarial que la mayoría de compañías no quiere asumir. Esto obliga a usar arquitecturas más complejas para un chatbot u otra función de IA con el fin de separar los datos sensibles del LLM. Un modelo de pesos abiertos como Llama 3 puede alojarse donde la organización quiera, facilitando crear productos y funciones de IA sin perder la privacidad de los datos.
Notas finales
Llama 3 parece una mejora iterativa sobre Llama 2. No se han anunciado cambios significativos en la arquitectura ni grandes funciones nuevas.
El foco en el equilibrio coste-rendimiento sugiere que Meta aspira a una IA barata de ejecutar a gran escala. Lo más interesante llega por el lado del ecosistema: ayudar a otros desarrolladores a crear LLM de alta calidad de forma más eficiente es uno de los grandes beneficios del enfoque abierto de Meta.
Si tienes ganas de adentrarte en la IA generativa, nuestro itinerario de aprendizaje AI Fundamentals te ayudará a ponerte al día con machine learning, deep learning, NLP, modelos generativos y más. También puedes leer nuestras guías sobre ajustar Llama 3, Llama 3.1 y Llama 3.2.
¿Quieres iniciarte en la IA Generativa?
Aprende a trabajar con LLMs en Python directamente en tu navegador