Willst du mit generativer KI beginnen?
Lerne, wie du mit LLMs in Python direkt in deinem Browser arbeiten kannst
Was ist Llama 3?
Llama 3 ist eine KI zur Textgenerierung. Ähnlich wie bei OpenAIs GPT- und Anthropics Claude-Modellen gibst du eine Texteingabe vor, und das Modell erzeugt eine textbasierte Antwort. Die neuesten Modelle versprechen bessere Leistung, insbesondere durch besseres Kontextverständnis und schlüssigeres logisches Denken. Die Llama-Modelle treiben Meta AI an, den smarten Assistenten in Instagram, WhatsApp, Messenger und Facebook.
Llama 3 ist ein Modell mit "offenen Gewichten". Das bedeutet, dass das Modell selbst Open Source ist und so eine gewisse Transparenz darüber bietet, wie es rechnet. Dennoch sind nicht alle Details zur Reproduktion öffentlich, etwa die Datensätze, mit denen es trainiert wurde.
Ein mit Midjourney erstelltes Bild von drei Lamas. Prompt: „A cartoon of 3 llamas happily frolicking in a field“
Neue Fähigkeiten von Llama 3
Llama 3 ist in zwei Größen verfügbar: mit 8 Milliarden Parametern und mit 70 Milliarden Parametern. Grundsätzlich führen mehr Parameter zu höherer Ausgabequalität, machen das Modell aber langsamer und teurer im Betrieb. 70 Milliarden Parameter liegen auf Augenhöhe mit vielen Konkurrenzmodellen, auch wenn es Modelle mit noch mehr Parametern gab. Ein drittes, größeres Modell mit 400 Milliarden Parametern wurde als in Entwicklung angekündigt.
Das Kontextfenster—also die Textmenge, über die das Modell gleichzeitig „nachdenken“ kann—wurde von 4.096 auf 8.192 Tokens verdoppelt. Ein Token steht für ein Wort oder Satzzeichen, manche Wörter werden in mehrere Tokens zerlegt. Im Englischen entsprechen vier Tokens etwa drei Wörtern, das neue Kontextfenster umfasst also rund 15 Seiten Text (bei 400 Wörtern pro Seite). Die Vergrößerung ist willkommen, liegt aber noch deutlich hinter der Spitze: Claude-3-Modelle bieten bis zu 200.000 Tokens.
Weitere Modelfeatures wurden in der Ankündigung nicht beschrieben. Stattdessen lag der Fokus stark auf dem umgebenden Software-Ökosystem.
Das Llama-3-Ökosystem
Parallel zur Ankündigung von Llama 3 hat Meta eine Reihe von Tools präsentiert, die die Arbeit mit Llama einfacher und sicherer machen sollen. Hier ein Überblick.
Llama Guard 2
Llama Guard 2 ist ein LLM-Tool, das Text als „sicher“ oder „unsicher“ klassifiziert—für Prompts ebenso wie für Antworten. Es kann zum Beispiel erkennen, ob Texte Gewaltbeschreibungen, Hassrede oder anderes problematisches Material enthalten.
Ein typischer Einsatzfall ist ein Chatbot. Du prüfst jeden Prompt, und wenn er als unsicher markiert wird, gibst du eine Warnung aus oder gehst anders mit dem Inhalt um. Erzeugt der Chatbot eine als unsicher markierte Antwort, kannst du sie abfangen und neu generieren, bevor sie Nutzer:innen sehen.
Zusätzlich zur Sicher/Unsicher-Markierung werden Antworten von Llama Guard 2 mit einem Safety-Label versehen—einer von elf Kategorien problematischer Inhalte aus der MLCommons AI Safety Taxonomy.
Llama Code Shield
Llama Code Shield klassifiziert Code als sicher oder unsicher. Da viele Softwareentwickler:innen LLMs zur Codeunterstützung nutzen, besteht das Risiko, dass unsicherer Code generiert und in Produktion landet. Das Tool ist dafür gedacht, in KI-Coding-Assistenten eingebaut und in Tools wie VSCode und DataLab integriert zu werden.
CyberSec Eval 2
CyberSec Eval 2 ermöglicht die Bewertung, wie sicher ein LLM ist. Die ursprüngliche Version prüfte Codegenerierung und Schutz vor Cyberangriffen. Die aktuelle Fassung erweitert dies um Tests für Anfälligkeit gegenüber Prompt Injection, automatisierte offensive Cyberfähigkeiten und die Neigung zum Missbrauch eines Code-Interpreters.
torchtune
torchtune ist ein Python-Paket, das mit dem Deep-Learning-Framework PyTorch zusammenarbeitet, um die Entwicklung eigener LLMs zu vereinfachen. Es bietet Tools für vier Aufgaben.
- Neue Modelle aus Bausteinen auf Basis bestehender LLMs erstellen
- LLMs feinabstimmen mit Techniken wie LoRA und QLoRA
- Einstellungen für Training, Quantisierung und Evaluation der Modelle konfigurieren
- Prompt-Templates und Datensatz-Integration für leichteres Training
torchtune ist in gängige Machine-Learning-Plattformen integriert, darunter Hugging Face, Weights & Biases, EleutherAI und Executorch.
Wofür lässt sich Llama 3 einsetzen?
Die Anwendungsfälle von Llama 3 entsprechen denen von Llama 2 und anderen LLMs. Häufige Einsätze sind unter anderem:
- Chatbots: Kundenservice, Support und Nutzerbindung durch Dialogassistenten automatisieren.
- Dokumentenzusammenfassungen: Lange Texte auf Kernaussagen verdichten, etwa in Recht, Wissenschaft und Wirtschaft.
- Content-Erstellung: Artikel, Berichte, Blogposts und sogar kreative Texte wie Gedichte und Geschichten generieren.
- E-Mail- und Kommunikationshilfe: Entwürfe für E-Mails, Antworten und andere Routinekommunikation automatisieren.
- Produktbeschreibungen: Einzigartige, ansprechende Beschreibungen für E-Commerce automatisch erstellen.
- Bildungstools: Lernhilfen, Prüfungsfragen und Lerninhalte passend zum Niveau der Lernenden erstellen.
- Programmierung und Codegenerierung: Entwickler:innen mit Codesnippets, Debugging oder Empfehlungen unterstützen.
- Datenanalyse-Reports: Erkenntnisse zusammenfassen und Berichte aus strukturierten Daten erzeugen.
- Virtuelle Assistenten: Persönliche Assistenten-Apps antreiben, die Termine managen, Fragen beantworten und Aufgaben erledigen.
Wie schlägt sich Llama 3 im Vergleich?
In Metas Ankündigung werden die Versionen mit acht Milliarden (8B) und siebzig Milliarden (70B) Parametern von Llama 3 gegen zwei andere Modelle gebenchmarkt.
Zum Einsatz kamen diese Benchmarks:
- Massive Multitask Language Understanding (MMLU). Aufgaben aus Grundschulmathematik, US-Geschichte, Informatik, Recht und mehr. Hohe Genauigkeit erfordert umfangreiches Weltwissen und Problemlösekompetenz.
- Graduate-Level Google-Proof Q&A (GPQA). Multiple-Choice-Fragen von Fachexpert:innen aus Biologie, Physik und Chemie. Die Fragen sind hochwertig und extrem schwierig: Expert:innen mit oder auf dem Weg zum PhD erreichen 74 % Genauigkeit.
- HumanEval. Test der funktionalen Korrektheit von Code, genutzt zur Bewertung der Codegenerierung.
- GSM-8K. Hochwertige, sprachlich vielfältige Textaufgaben aus der Grundschulmathematik.
- MATH. Mathematikaufgaben auf Mittel- und Oberstufenniveau.
Das Llama-3-8B-Modell wurde mit Googles Gemma 7B It und Mistral 7B Instruct verglichen. Diese LLMs sind ähnlich groß (ähnliche Parameteranzahl), als Open-Weights-Modelle auf Hugging Face verfügbar und für ähnliche Einsatzzwecke gedacht. Die Ergebnisse zeigt Abbildung 1.
Llama 3 8B übertrifft die beiden anderen Modelle in allen fünf Benchmarks deutlich.
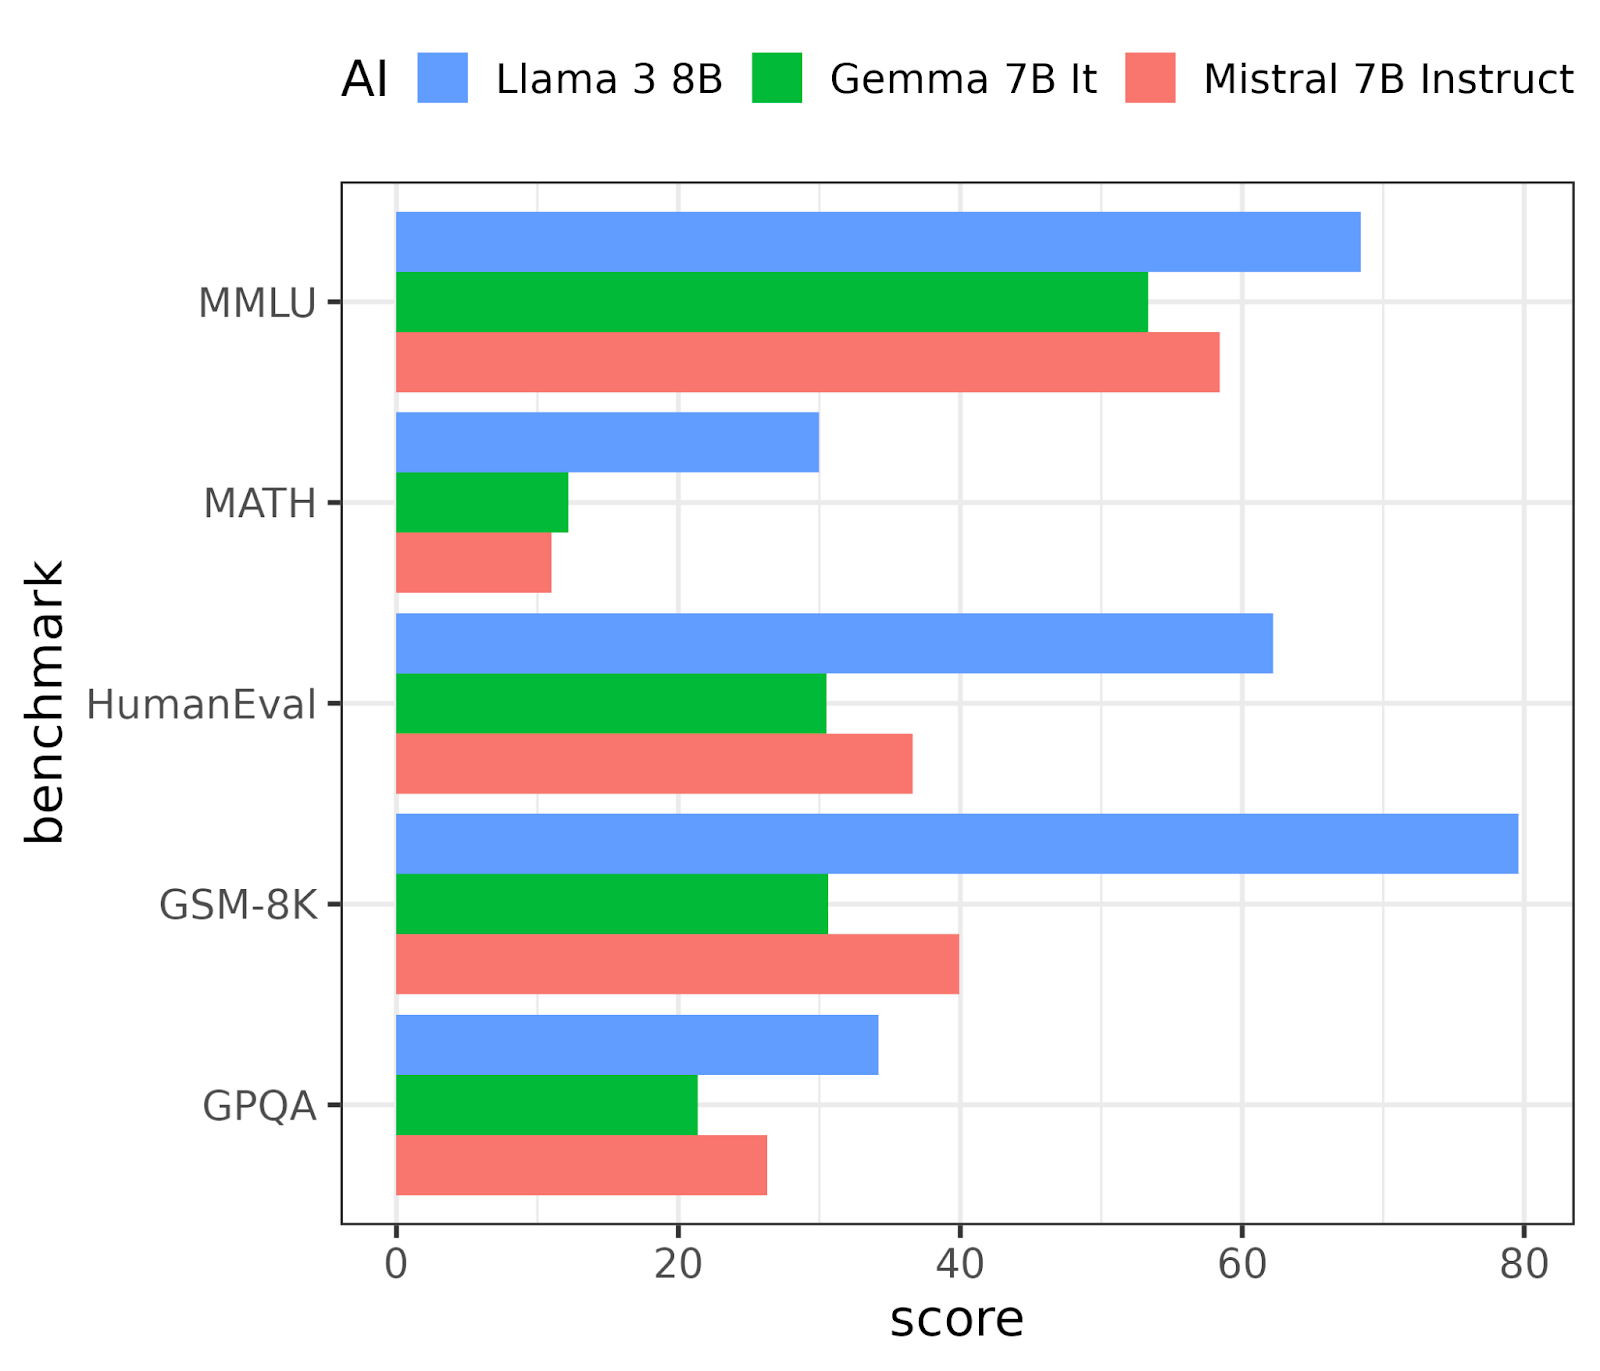
Abbildung 1. Die Leistung von Llama 3 8B im Vergleich zu zwei ähnlichen Modellen in 5 LLM-Benchmarks.
Llama 3 70B wurde mit Google DeepMinds Gemini Pro 1.5 und Anthropics Claude 3 Sonnet verglichen. Diese Modelle sind nahe am Stand der Technik, wenn auch nicht die aktuell stärksten (diesen Titel reichen sich derzeit OpenAIs GPT-4 Turbo und Anthropics Claude 3 Opus). Die Ergebnisse zeigt Abbildung 2.
Hier liegt die Leistung bei drei Benchmarks nahezu gleichauf. Llama 3 80B gewinnt im HumanEval-Benchmark zur Codegenerierung und liegt beim MATH-Benchmark hinter Gemini Pro 1.5 auf Platz zwei.
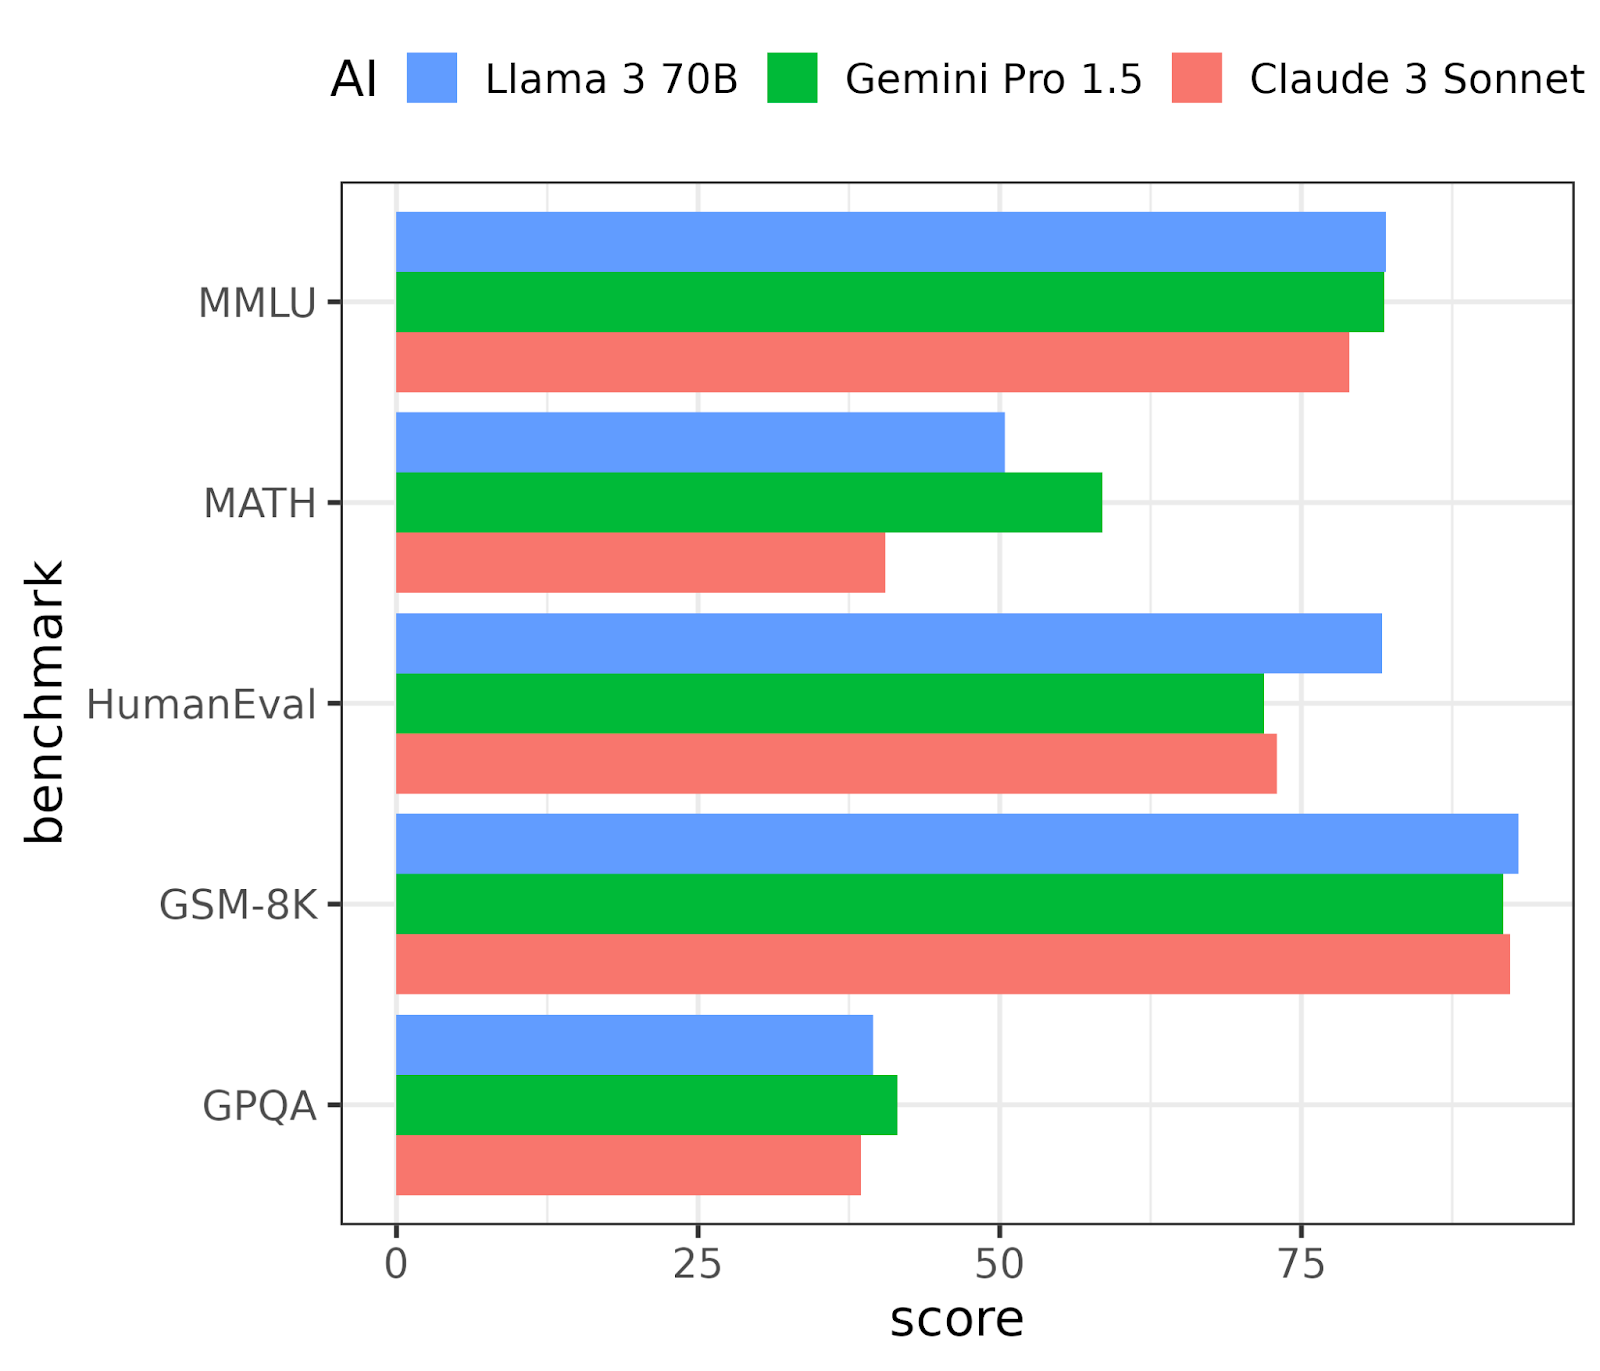
Abbildung 2. Die Leistung von Llama 3 70B im Vergleich zu zwei ähnlichen Modellen in 5 LLM-Benchmarks.
Die Benchmark-Ergebnisse einordnen
Es gibt mehr als fünf Benchmarks: Llama 3 wurde auf 15 getestet, in der Ankündigung wurden jedoch nur fünf gezeigt. Ebenso gäbe es deutlich mehr Vergleichsmodelle. Wie stark Meta bei der Ergebnispräsentation ausgewählt hat, ist unklar.
Zweitens ist die Ausgabequalität nur ein Leistungsmaß. Zeit und Kosten für die Generierung sind ebenfalls wichtig, wurden aber nicht adressiert.
Drittens variiert die Performance je nach Use Case. Für verlässliche Aussagen solltest du Llama 3 auf deiner eigenen Hardware und mit deinen eigenen Aufgaben testen.
Chatbot-Arena-Rankings
In den Tagen seit der Meta-Ankündigung ist Llama 3 auf dem LMSYS Chatbot Arena Leaderboard, einem öffentlichen LLM-Ranking, aufgetaucht. Llama 3 70B steht derzeit auf Rang 6—die beste Platzierung eines Open-Weights-LLMs. (Davor liegen verschiedene Versionen von OpenAI GPT-4, Anthropic Claude 3 Opus und Google Gemini Pro.) Llama 3 8B rangiert derweil auf Platz 14.
Das sind beachtliche Sprünge in den Rankings—Grund genug, genauer hinzuschauen, was sich seit Llama 2 verändert hat.
Wie funktioniert Llama 3?
Llama 3 nutzt—wie seine Vorgänger und die GPT-Reihe—eine Decoder-only-Transformer-Architektur. Das ist die gängigste Architektur für generative Textmodelle. (Das Gegenstück, Encoder-only-Architekturen, dient der Textanalyse oder -klassifikation.)
Die Ankündigung beschreibt keine radikalen Änderungen an Modellstruktur oder Training. Stattdessen gab es viele Optimierungen rund um den Trade-off zwischen Antwortqualität, Geschwindigkeit und Entwicklungsaufwand.
Ein neuer Tokenizer, der Text in Tokens umwandelt, ist effizienter: Prompts und Antworten benötigen rund 15 % weniger Tokens—damit passt mehr Text ins Kontextfenster.
Ein neuer Aufmerksamkeitsmechanismus—die Technik, mit der LLMs entscheiden, welche Wörter oder Phrasen für die Ausgabe wichtig sind—namens Grouped Query Attention bietet einen besseren Kompromiss zwischen Ausgabequalität und Generierungsgeschwindigkeit als frühere Verfahren.
Der Trainingsdatensatz ist siebenmal so groß wie bei Llama 2 und enthält viermal so viel Code. Mehr Code im Training führt in der Regel zu besseren Codegenerierungsfähigkeiten.
Spannend ist auch: Llama 2 wurde genutzt, um Daten für den Llama-3-Trainingssatz zu bewerten und zu klassifizieren. KI zur Entwicklung noch besserer KI zu nutzen—lange ein Science-Fiction-Motiv (ein Plotelement in Per Anhalter durch die Galaxis)—wird nun Realität.
Auch der Post-Training-Prozess wurde optimiert. Nachdem ein „rohes“ LLM erstellt ist, kann es weiter abgestimmt werden, um die Performance zu verbessern. Meta nennt dabei unter anderem folgende Techniken:
- Supervised Fine-Tuning, eine überwachte Machine-Learning-Technik, bei der Prompt-Antwort-Paare mit hoher Qualität als Positivbeispiele dienen.
- Rejection Sampling: Es werden mehrere Ausgaben erzeugt und gerankt, die schlechtesten verworfen.
- Direct Policy Optimization und Proximal Policy Optimization—Reinforcement-Learning-Verfahren, bei denen das Modell Belohnungen für gute Antworten erhält.
Was fehlt?
Einige Punkte fehlen in diesem Release auffällig.
Keine Multimodalität
OpenAIs ChatGPT kombiniert die GPT-4-Text-KI mit der Bild-KI DALL∙E 3—also „multimodal“. Laut Meta ist Multimodalität für Llama 3 ein Ziel für die nahe Zukunft.
Keine Mehrsprachigkeit
Der Llama-3-Datensatz besteht zu 95 % aus englischsprachigem Text. Die Leistung in anderen Sprachen wird daher deutlich schwächer erwartet. Eine mehrsprachige Version von Llama 3 steht—wie Multimodalität—auf dem Lernplan.
Kein Mixture-of-Experts
Nicht erwähnt wurde eine Mixture-of-Experts-Architektur. Dabei besteht ein LLM aus mehreren kleineren, spezialisierteren LLMs (z. B. für Codegenerierung, Zusammenfassungen, Dialog). Diese Technik wurde durch Mistral AIs Mixtral-Modelle popularisiert und gilt als Grundlage von OpenAIs GPT-4. Sie liefert mehr Leistung pro Parameter—gleich gute Ergebnisse mit kleineren (damit günstigeren und schnelleren) Modellen. Da Meta dies weder in der Ankündigung noch im Llama-3-GitHub-Repository erwähnt, ist davon auszugehen, dass sie nicht eingesetzt wurde.
Kein World Model
Metas Chief AI Scientist Yann LeCun ist ein starker Befürworter sogenannter World Models, bei denen die KI ein internes Modell der Welt erlernt, um schneller zu lernen, komplexe Aufgaben zu bewältigen und sich an Unbekanntes anzupassen. Diese radikale Architektur wurde nicht erwähnt und scheint in Llama 3 nicht enthalten zu sein.
Wo kann ich Llama 3 nutzen?
Llama 3 steht zum Download auf der Website und im GitHub-Repository bereit. Es treibt bereits den Meta-AI-Assistenten in Facebook, Instagram, WhatsApp und Messenger an—du kannst Llama 3 also indirekt ausprobieren, indem du Meta AI auf diesen Plattformen nutzt.
Integrationen mit AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM und Snowflake sind „in Kürze verfügbar“ angekündigt—so kannst du Llama 3 auch über diese Plattformen ansprechen.
Warum ist Llama 3 wichtig?
An der Leistungsspitze liefern sich derzeit OpenAIs GPT-4 und Anthropics Claude 3 Opus ein Kopf-an-Kopf-Rennen, dicht gefolgt von Google Gemini Pro und Cohere Command R+. Ob die größere Llama-3-Variante in Entwicklung um die Krone mitkämpft, bleibt abzuwarten. Bis dahin hat Meta mit Llama 3 spürbare Leistungsgewinne erzielt.
In den letzten Jahren lagen geschlossene Modelle (deren Details nicht öffentlich sind) meist vor den offeneren. Dass Llama 3 nun auf Rang 6 liegt, ist daher bemerkenswert.
Metas kurzfristiges Hauptziel für Llama ist, den smarten Meta-AI-Assistenten für die eigenen Social-Plattformen zu betreiben. Das unterscheidet sich stark von OpenAI, Anthropic oder Cohere, die ihre LLMs an andere Unternehmen verkaufen. Insofern könnten Benchmarks für Codegenerierung oder Matheaufgaben für Meta weniger entscheidend sein.
Meta verfügt über einen einzigartigen Trainingsdatensatz aus den Social-Posts von Milliarden Nutzer:innen—und abseits von Prestige zählt am Ende nur eine Kennzahl: „Erfüllt Llama 3 die Bedürfnisse von Social-Media-Nutzer:innen ausreichend gut?“
Darüber hinaus bedeutet der Open-Weights-Ansatz, dass Llama 3 potenziell günstiger zu betreiben ist als die Konkurrenz. Indem Meta die KI im Kern verschenkt, setzt das die Preise der Wettbewerber-APIs unter Druck. Das ist wichtig, denn die Euphorie von 2023 mit Träumen ständig wachsender Generativ-KI-Leistung ist 2024 einer nüchterneren Sicht gewichen: Führungskräfte sehen, wie teuer LLM-Features sind—und Leistung pro Euro rückt in den Fokus.
Open-Weights-Modelle sind auch dort entscheidend, wo Datenschutz oberste Priorität hat—zum Beispiel bei Finanz-, Gesundheits- oder personenbezogenen Daten. Solche hochsensiblen Informationen an ein extern gehostetes LLM zu übermitteln (wie bei GPT und anderen geschlossenen Modellen) birgt ein Geschäftsrisiko, das viele Unternehmen scheuen. Das führt oft zu aufwendigeren Architekturen, um sensible Daten vom LLM zu trennen. Ein Open-Weights-Modell wie Llama 3 kann dort gehostet werden, wo die Organisation es möchte—und erleichtert so die Entwicklung von KI-Features bei voller Datenhoheit.
Fazit
Llama 3 wirkt wie ein iteratives Upgrade gegenüber Llama 2. Weder Architektur noch große neue Features wurden angekündigt.
Der Fokus auf das Preis-Leistungs-Verhältnis deutet darauf hin, dass Meta eine KI anstrebt, die sich günstig in großem Maßstab betreiben lässt. Die spannendsten News betreffen das Ökosystem: Anderen Entwickler:innen zu helfen, effizienter hochwertige LLMs zu bauen, ist einer der größten Vorteile von Metas offenem Ansatz.
Wenn du in die Welt der Generativen KI einsteigen willst, bringt dich unser AI Fundamentals Skill Track schnell auf Kurs—mit Machine Learning, Deep Learning, NLP, generativen Modellen und mehr. Lies außerdem unsere Guides zum Feintuning von Llama 3, zu Llama 3.1 und Llama 3.2.
Willst du mit generativer KI beginnen?
Lerne, wie du mit LLMs in Python direkt in deinem Browser arbeiten kannst