Vous souhaitez vous lancer dans l'IA générative ?
Apprenez à travailler avec des LLM en Python directement dans votre navigateur
Qu'est-ce que Llama 3 ?
Llama 3 est une IA de génération de texte. À l’instar des modèles GPT d’OpenAI et Claude d’Anthropic, vous saisissez une invite et il génère une réponse textuelle. Les derniers modèles promettent de meilleures performances, notamment en compréhension du contexte et en raisonnement logique. Les modèles Llama alimentent Meta AI, l’assistant intelligent intégré à Instagram, WhatsApp, Messenger et Facebook.
Llama 3 est un modèle à « poids ouverts ». Autrement dit, le modèle est open source, offrant une certaine transparence sur sa manière de calculer. En revanche, tous les détails permettant de le reproduire, comme les jeux de données d’entraînement, ne sont pas publics.
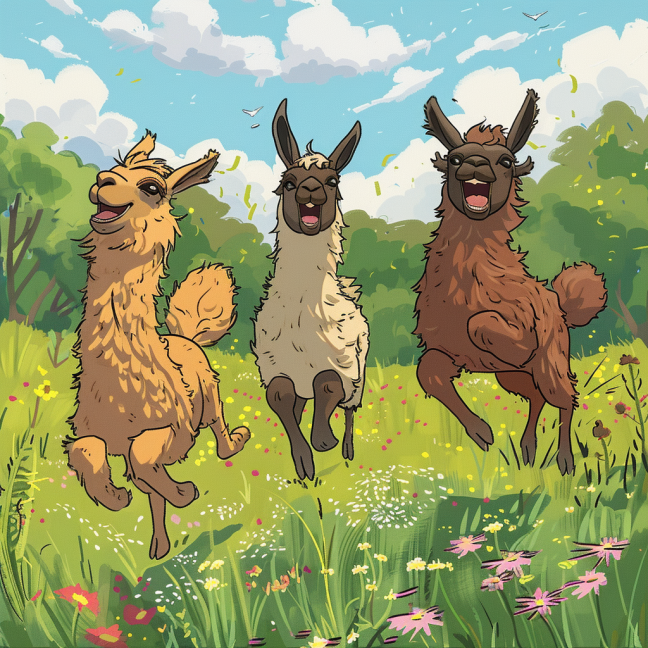
Une image de 3 lamas créée avec Midjourney. Invite utilisée : « A cartoon of 3 llamas happily frolicking in a field »
Nouvelles capacités de Llama 3
Llama 3 est disponible en deux tailles : un modèle à 8 milliards de paramètres et un à 70 milliards. En général, plus de paramètres signifie une meilleure qualité de sortie, mais aussi un modèle plus lent et plus coûteux à exécuter. 70 milliards de paramètres est comparable à de nombreux modèles concurrents, même si certains dépassent encore cette taille. Un troisième modèle, plus grand, à 400 milliards de paramètres, a été annoncé comme étant en cours de développement.
La fenêtre de contexte — la quantité de texte prise en compte en une fois — a été doublée, passant de 4 096 à 8 192 jetons. Un jeton correspond à un mot ou à un signe de ponctuation, certains mots étant découpés en plusieurs jetons. En anglais, quatre jetons représentent environ trois mots ; la nouvelle fenêtre équivaut donc à environ 15 pages de texte (400 mots par page). Cette hausse est appréciable, mais reste loin de l’état de l’art : les modèles Claude 3 proposent une fenêtre de 200 000 jetons.
D’autres caractéristiques du modèle n’ont pas été détaillées dans l’article d’annonce, qui met surtout l’accent sur l’écosystème logiciel autour de Llama.
L'écosystème Llama 3
En parallèle de l’annonce de Llama 3, Meta a présenté une suite d’outils pour travailler avec Llama plus facilement et en toute sécurité. Voici l’essentiel.
Llama Guard 2
Llama Guard 2 est un outil LLM qui classe un texte comme « sûr » ou « à risque ». Il s’applique aussi bien aux invites qu’aux réponses. Par exemple, il peut détecter la présence de descriptions de violence, de discours haineux ou d’autres contenus problématiques.
Cas d’usage typique : un chatbot. Vous contrôlez chaque invite et, si le contenu est signalé comme à risque, vous affichez un avertissement ou appliquez une autre stratégie de gestion du contenu. De même, si la réponse générée est jugée à risque, vous pouvez l’intercepter et relancer une génération avant qu’elle ne soit visible par l’utilisateur.
Au-delà du simple drapeau sûr/à risque, les réponses de Llama Guard 2 reçoivent une étiquette de sécurité — l’une des onze catégories de contenus problématiques définies par la taxonomie MLCommons AI Safety.
Llama Code Shield
Llama Code Shield évalue si du code est sécurisé ou non. À l’heure où de nombreux développeurs s’appuient sur des LLM pour les assister, le risque d’introduire du code vulnérable en production augmente. L’outil est conçu pour s’intégrer aux assistants de codage IA et à d’autres outils comme VSCode et DataLab.
CyberSec Eval 2
CyberSec Eval 2 permet d’évaluer le niveau de sécurité d’un LLM. La première version mesurait la sûreté de la génération de code et la résistance aux cyberattaques. La dernière mouture va plus loin, avec des tests de sensibilité aux injections d’invite, des capacités offensives automatisées en cybersécurité et la propension à abuser d’un interpréteur de code.
torchtune
torchtune est un package Python, complément de PyTorch, qui facilite le développement de vos propres LLM. Il propose des outils pour quatre tâches.
- Créer de nouveaux modèles à partir de briques issues de LLM existants
- Ajuster finement des LLM via des techniques comme LoRA et QLoRA
- Configurer l’entraînement, la quantification et l’évaluation des modèles
- Des templates d’invite et des intégrations datasets pour simplifier l’entraînement
torchtune est intégré à des plateformes d’apprentissage automatique populaires comme Hugging Face, Weights & Biases, EleutherAI et Executorch.
Quels sont les cas d'usage de Llama 3 ?
Les cas d’usage de Llama 3 sont similaires à ceux de Llama 2 et des autres LLM. Parmi les usages courants :
- Chatbots : automatiser le service client, le support et l’engagement via des agents conversationnels.
- Résumés de documents : condenser de longs documents en synthèses mettant en avant les points clés, utile en contexte juridique, académique et business.
- Création de contenu : générer des articles, rapports, billets de blog, ainsi que des textes créatifs comme poèmes et histoires.
- Aide à la communication et aux e-mails : automatiser la rédaction d’e-mails, de réponses et d’échanges récurrents.
- Fiches produit : générer automatiquement des descriptions uniques et percutantes pour l’e-commerce.
- Outils éducatifs : créer des fiches de révision, des questions d’examen et des contenus pédagogiques adaptés au niveau des apprenants.
- Programmation et génération de code : assister les développeurs en générant des snippets, en déboguant du code existant ou en suggérant des approches.
- Rapports d’analyse de données : synthétiser des résultats et produire des rapports à partir de données structurées.
- Assistants virtuels : alimenter des assistants personnels qui gèrent l’agenda, répondent aux questions et exécutent des tâches.
Comment se situe la performance de Llama 3 ?
L’annonce de Meta présente des résultats de benchmarks pour les versions à huit milliards (8B) et soixante-dix milliards (70B) de paramètres de Llama 3 face à deux autres modèles.
Les benchmarks utilisés sont les suivants.
- Massive Multitask Language Understanding (MMLU). Des tâches en mathématiques élémentaires, histoire des États-Unis, informatique, droit, etc. Pour y exceller, les modèles doivent disposer d’un vaste socle de connaissances et de fortes capacités de résolution de problèmes.
- Graduate-Level Google-Proof Q&A (GPQA). Des QCM rédigés par des experts en biologie, physique et chimie. Les questions sont de très haute qualité et extrêmement difficiles : des experts titulaires ou en cours de thèse atteignent 74 % de bonnes réponses.
- HumanEval. Un test de correction fonctionnelle du code, utilisé pour évaluer la génération de code.
- GSM-8K. Des problèmes de mathématiques de niveau primaire rédigés dans une grande variété linguistique.
- MATH. Des problèmes de mathématiques de niveau collège et lycée.
Le modèle Llama 3 8B a été comparé à Gemma 7B It de Google et à Mistral 7B Instruct. Ces LLM de taille comparable (nombre de paramètres similaire) sont des modèles à poids ouverts disponibles sur la plateforme Hugging Face et visent des usages analogues. Les résultats figurent à la figure 1.
Llama 3 8B surpasse nettement les deux autres modèles sur les cinq benchmarks.
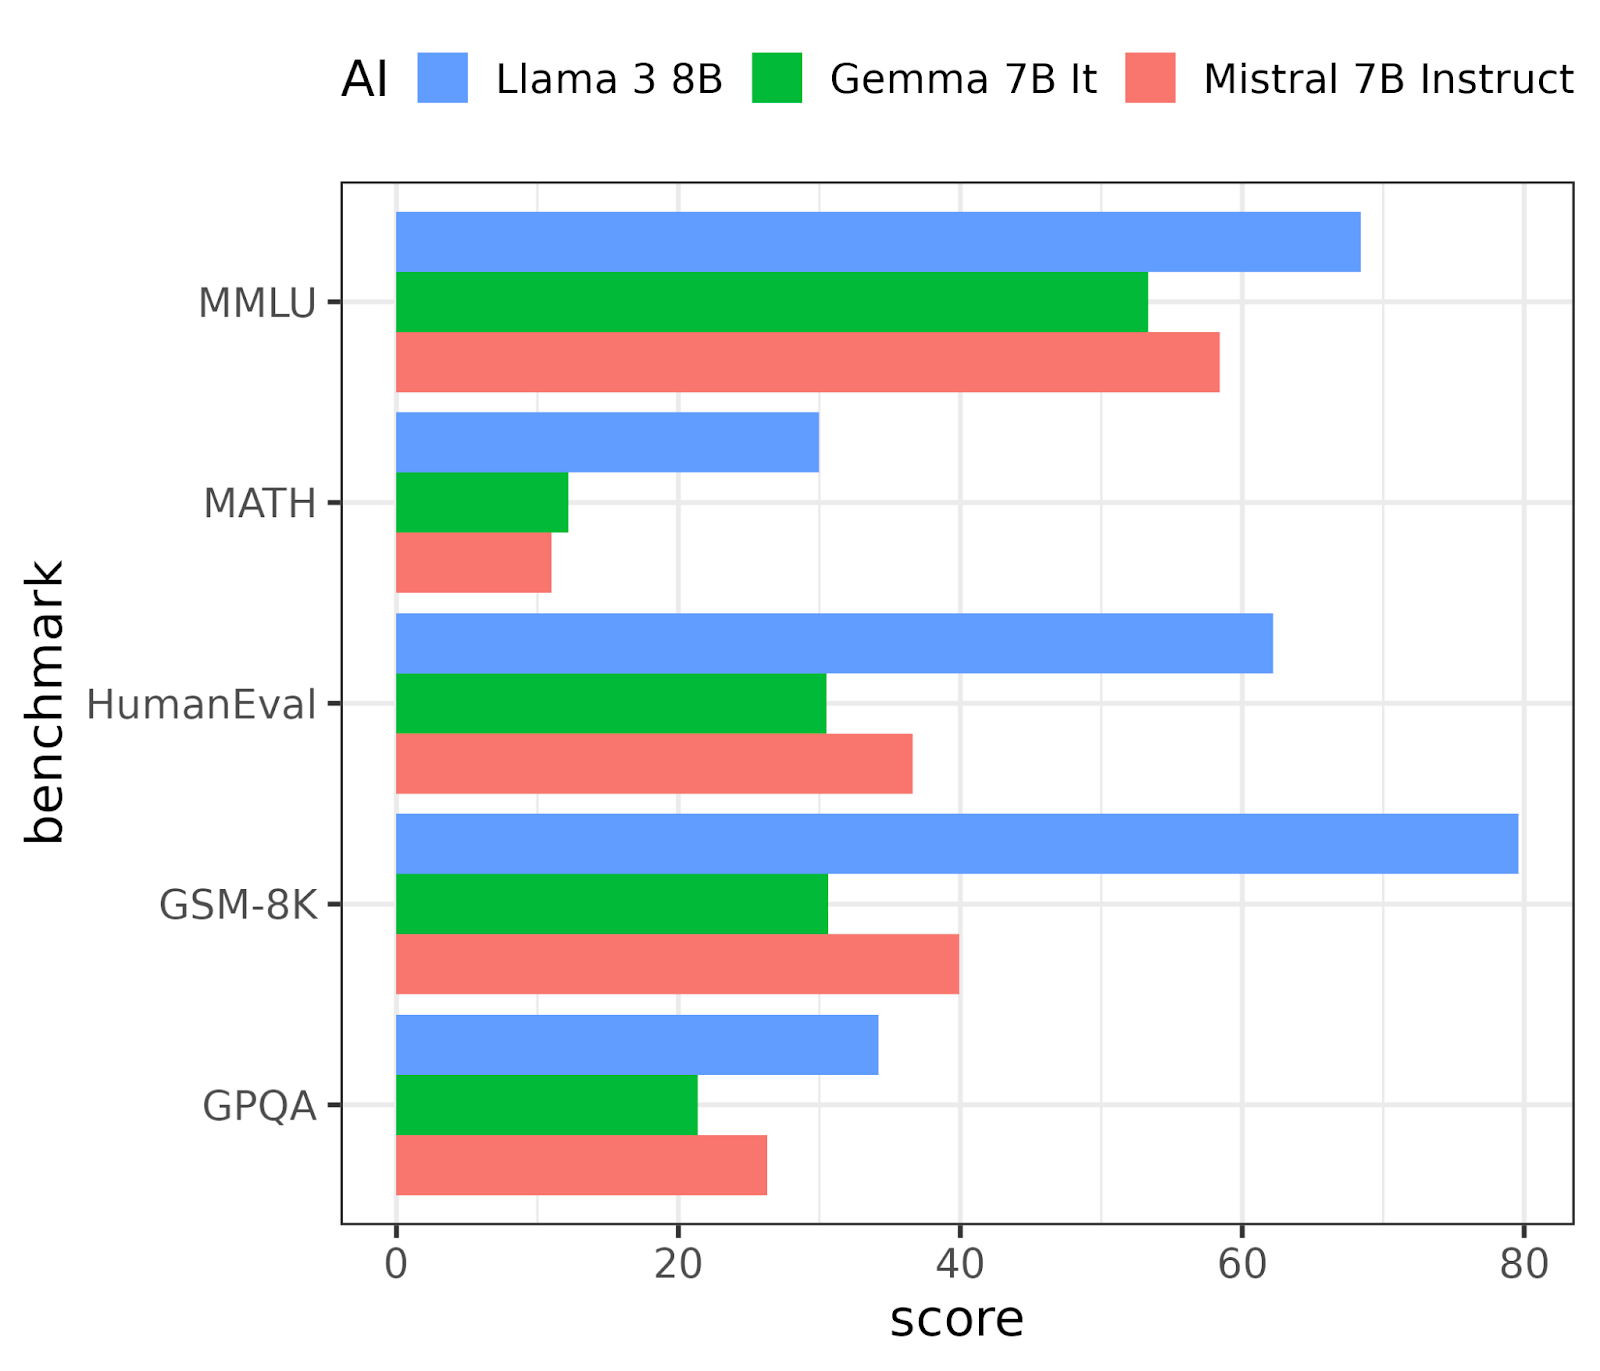
Figure 1. Performances de Llama 3 8B face à deux modèles comparables sur 5 benchmarks LLM.
Llama 3 70B a été comparé à Gemini Pro 1.5 de Google DeepMind et à Claude 3 Sonnet d’Anthropic. Ce sont des modèles proches de l’état de l’art, même s’ils ne sont pas les tout meilleurs du moment (le titre se dispute actuellement entre GPT-4 Turbo d’OpenAI et Claude 3 Opus d’Anthropic). Les résultats sont présentés à la figure 2.
Ici, les performances sont pratiquement à égalité sur trois des benchmarks. Llama 3 80B l’emporte sur HumanEval pour la génération de code et se classe deuxième derrière Gemini Pro 1.5 sur MATH.
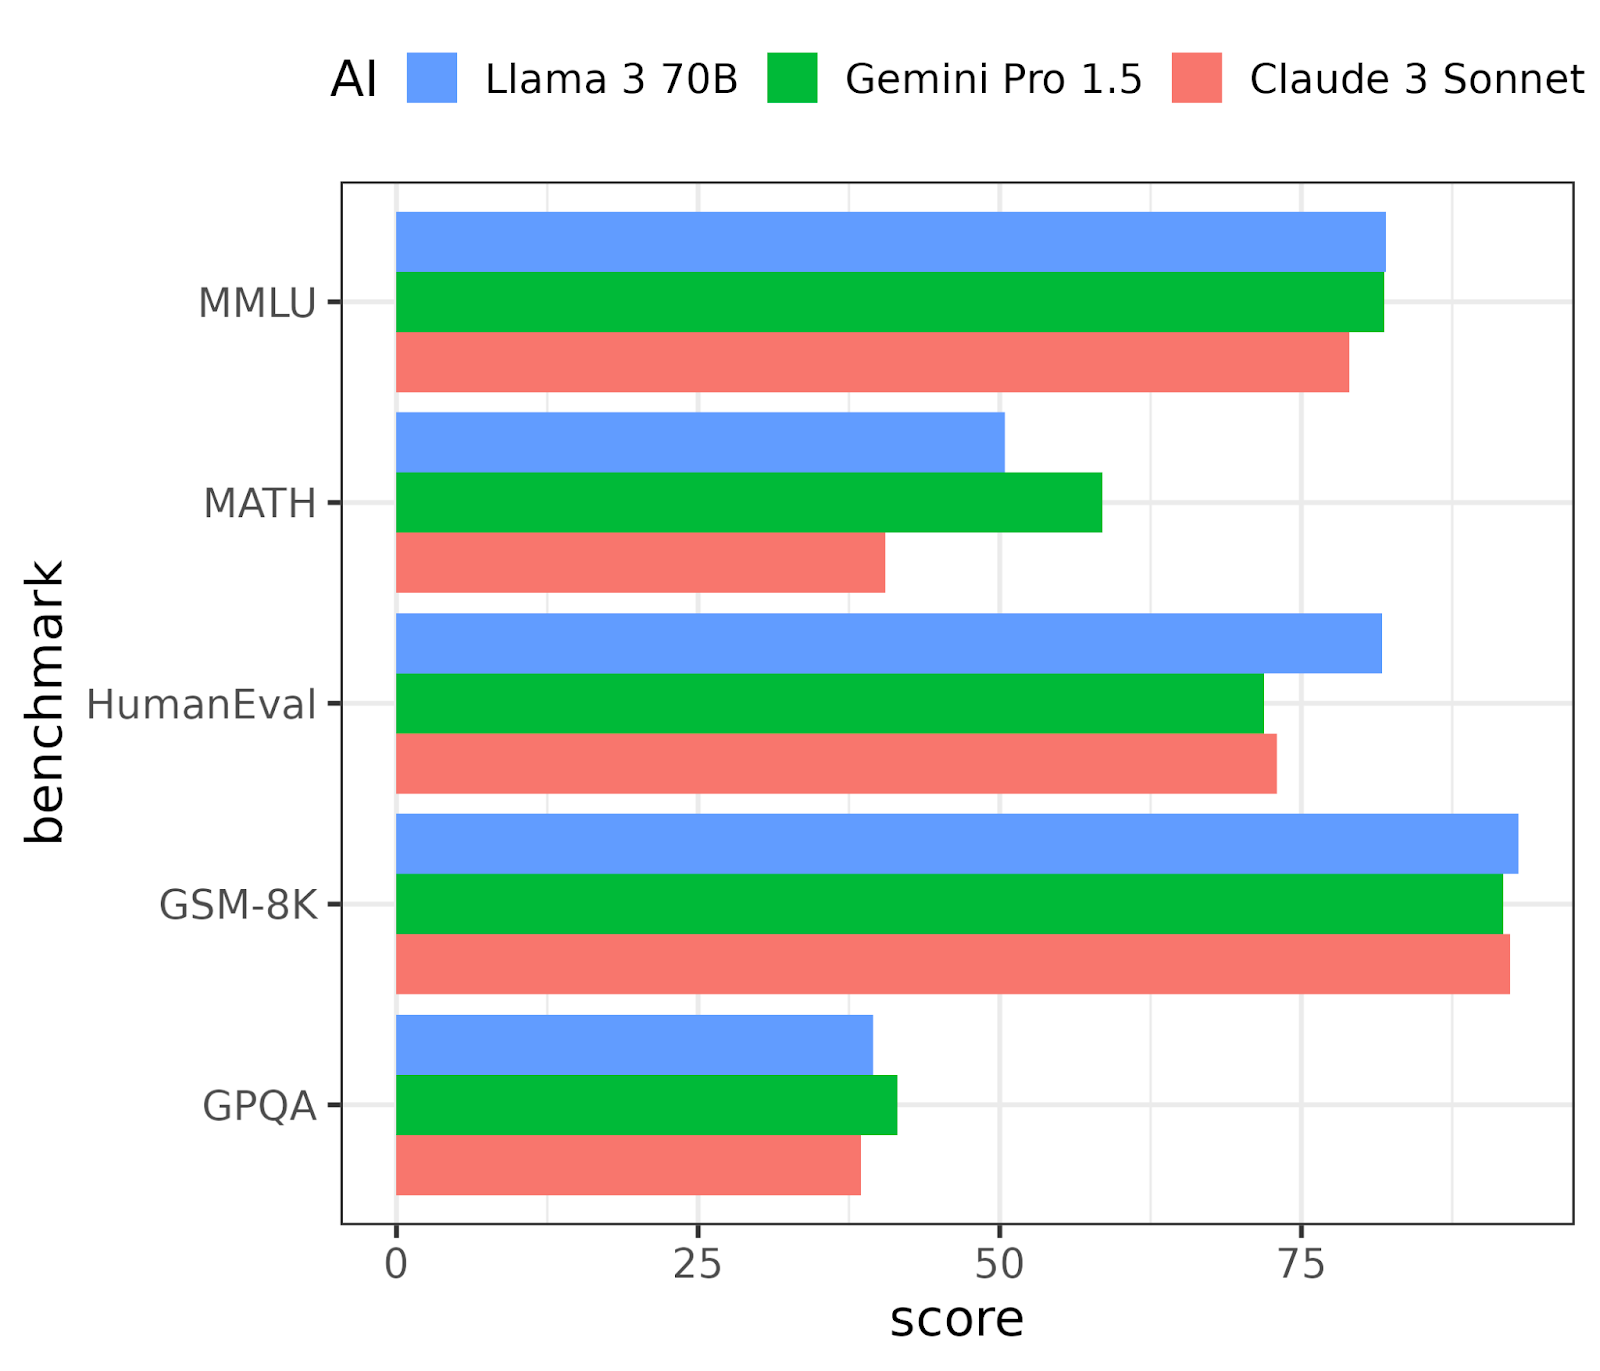
Figure 2. Performances de Llama 3 70B face à deux modèles comparables sur 5 benchmarks LLM.
Interpréter les résultats de benchmark
Il existe bien plus de cinq benchmarks : Llama 3 a été évalué sur 15 d’entre eux, mais seuls cinq résultats figurent dans l’annonce. De même, de nombreux autres LLM auraient pu servir de points de comparaison. Difficile de savoir dans quelle mesure Meta a « choisi ses combats » pour présenter ces chiffres.
Par ailleurs, la qualité de sortie n’est qu’un volet de la performance. Le temps et le coût de génération comptent aussi, or ils ne sont pas abordés dans l’annonce.
Enfin, la performance varie toujours selon le cas d’usage. Pour des résultats pertinents, testez le modèle sur vos propres problématiques et votre propre infrastructure.
Classements Chatbot Arena
Dans les jours qui ont suivi l’annonce, les performances de Llama 3 sont apparues sur le classement LMSYS Chatbot Arena, un palmarès public des LLM. Llama 3 70B est actuellement classé 6e, le meilleur rang pour un LLM à poids ouverts. (Il est devancé par diverses versions de GPT-4 d’OpenAI, Claude 3 Opus d’Anthropic et Google Gemini Pro.) De son côté, Llama 3 8B se situe à la 14e place.
Ces progressions sont notables, et il vaut la peine d’examiner ce qui a changé depuis Llama 2.
Comment fonctionne Llama 3 ?
Llama 3 utilise une architecture transformer à décodeur seul, comme ses prédécesseurs et la série GPT. C’est l’architecture la plus courante pour les modèles génératifs de texte. (À l’inverse, les architectures à encodeur seul servent à comprendre ou classer le texte fourni.)
L’annonce ne décrit aucun changement radical de structure ou de processus d’entraînement. Meta a plutôt multiplié les optimisations pour arbitrer entre qualité des réponses, vitesse et facilité de développement.
Un nouveau tokenizer, chargé de convertir le texte en jetons, est plus efficace : invites et réponses occupent 15 % de jetons en moins, ce qui permet d’insérer davantage de texte dans la fenêtre de contexte.
Un nouveau mécanisme d’attention — la technique qui aide les LLM à repérer les mots ou expressions essentiels pour générer la sortie — dit « grouped query attention », offre un meilleur compromis qualité/vitesse que les approches précédentes.
Le jeu de données d’entraînement est sept fois plus grand que celui de Llama 2, avec quatre fois plus de code. En général, davantage de code dans les données d’apprentissage améliore les capacités de génération de code des LLM.
Fait intéressant, Llama 2 a servi à évaluer et classer les données retenues pour l’entraînement de Llama 3. L’idée d’utiliser une IA pour en améliorer une autre, thème récurrent de la science-fiction (clin d’œil au Guide du voyageur galactique), devient réalité.
La phase de post-entraînement a également été optimisée. Une fois le LLM « brut » créé, on peut l’affiner pour améliorer ses performances. Meta mentionne notamment les techniques suivantes.
- Supervised fine-tuning, une technique d’apprentissage supervisé qui utilise des paires invite/réponse de haute qualité pour fournir des exemples de bonnes sorties.
- Rejection sampling, où plusieurs sorties sont générées puis classées, et les moins bonnes rejetées.
- Direct Policy Optimization et Proximal Policy Optimization, des techniques d’apprentissage par renforcement qui récompensent les bonnes réponses.
Qu'est-ce qui manque ?
Plusieurs absences notables dans cette version.
Pas d’IA multimodale
ChatGPT d’OpenAI combine l’IA texte GPT-4 et l’IA image DALL∙E 3 : c’est donc un modèle « multimodal ». Meta indique viser une version multimodale de Llama 3 à court terme.
Pas d’IA multilingue
Le jeu de données de Llama 3 contiendrait 95 % de texte en anglais. Les performances devraient donc être bien moindres dans d’autres langues. Comme pour la multimodalité, une version multilingue est inscrite à la feuille de route.
Pas de « mixture of experts »
L’annonce ne mentionne pas l’architecture « mixture of experts ». Cette approche consiste à combiner plusieurs LLM plus petits, spécialisés (par exemple, un LLM de génération de code, un autre pour le résumé, un autre pour le dialogue). Popularisée par les modèles Mixtral de Mistral AI (référence) et, selon la rumeur, utilisée dans GPT-4, elle offre un meilleur rapport performance/paramètre. Autrement dit, on obtient des performances équivalentes avec un modèle plus petit (donc moins cher et plus rapide). Comme Meta ne la mentionne pas (et qu’elle n’apparaît pas dans le référentiel GitHub de Llama 3), on peut supposer qu’elle n’a pas été utilisée.
Pas de « world model »
Yann LeCun, Chief AI Scientist de Meta, défend depuis longtemps les « modèles du monde », où l’IA développe une représentation interne du fonctionnement du monde pour apprendre plus vite, accomplir des tâches complexes et s’adapter à des situations nouvelles. Aucune mention de cette architecture radicale dans l’annonce : elle ne semble pas présente dans Llama 3.
Où accéder à Llama 3 ?
Llama 3 est disponible au téléchargement sur son site et sur GitHub. Il alimente déjà l’assistant Meta AI dans Facebook, Instagram, WhatsApp et Messenger : vous pouvez donc le tester implicitement en utilisant Meta AI sur ces plateformes.
Des intégrations avec AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake sont annoncées comme « disponibles prochainement », ce qui vous permettra d’accéder à Llama 3 via ces plateformes.
Llama 3, est-ce si important ?
Au sommet de la pyramide, la scène des grands modèles de langage est récemment dominée par GPT-4 d’OpenAI et Claude 3 Opus d’Anthropic, avec Google Gemini Pro et Command R+ de Cohere en embuscade. Reste à voir si la version de Llama 3 en cours de développement, plus volumineuse, pourra viser le titre. En attendant, Meta a nettement amélioré les performances de Llama 3.
Ces dernières années, les modèles fermés (dont les détails ne sont pas publics) ont devancé les modèles plus ouverts. Le fait que Llama 3 se hisse à la 6e place est donc notable.
L’objectif principal de Meta à court terme est d’alimenter l’assistant Meta AI pour ses plateformes sociales. Un modèle économique très différent de celui d’OpenAI, Anthropic ou Cohere, qui commercialisent leurs LLM pour des produits tiers. Dans cette optique, des benchmarks sur la génération de code ou la résolution de problèmes mathématiques ne sont peut-être pas cruciaux pour Meta.
Meta dispose d’un jeu d’entraînement unique, nourri par les publications de milliards d’utilisateurs. Mis à part la quête de prestige, le seul indicateur qui compte est : « Llama 3 répond-il suffisamment aux besoins des utilisateurs de réseaux sociaux ? »
Au-delà, l’approche à poids ouverts signifie que Llama 3 peut potentiellement coûter moins cher à l’usage que la concurrence. En « offrant » l’IA, Meta exerce une pression à la baisse sur les prix des API concurrentes. C’est clé, car l’optimisme de 2023 et les promesses d’une performance générative sans cesse croissante laissent place en 2024 à une vision plus pragmatique : les dirigeants prennent la mesure du coût des fonctionnalités LLM, et le ratio performance/prix devient prioritaire.
Les modèles à poids ouverts sont aussi essentiels lorsque la confidentialité des données est primordiale — données financières, de santé, ou informations personnelles. Confier de telles données à un LLM hébergé par un tiers (comme GPT et autres modèles fermés) implique un risque que peu d’entreprises acceptent. Cela impose souvent une architecture plus complexe pour séparer les données sensibles du LLM. Un modèle à poids ouverts comme Llama 3 peut être hébergé où l’on veut, ce qui facilite la création de fonctionnalités IA tout en préservant la confidentialité.
En conclusion
Llama 3 apparaît comme une évolution itérative de Llama 2. Aucun changement majeur d’architecture ni fonctionnalité phare n’a été annoncé.
Le focus sur le compromis coût/performance laisse entendre que Meta vise une IA exploitable à grande échelle et à moindre coût. La meilleure nouvelle concerne l’écosystème : aider les développeurs à créer des LLM de haute qualité plus efficacement est l’un des bénéfices les plus importants de l’approche ouverte de Meta.
Si vous souhaitez vous lancer dans l’IA générative, notre parcours de compétences AI Fundamentals vous mettra rapidement à niveau sur le machine learning, le deep learning, le NLP, les modèles génératifs et plus encore. Vous pouvez aussi consulter nos guides sur l’ajustement fin de Llama 3, Llama 3.1 et Llama 3.2.
Vous souhaitez vous lancer dans l'IA générative ?
Apprenez à travailler avec des LLM en Python directement dans votre navigateur