Llama 3 क्या है?
Llama 3 एक टेक्स्ट-जनरेशन AI है। यानी, OpenAI के GPT और Anthropic के Claude मॉडलों की तरह, आप एक टेक्स्ट प्रॉम्प्ट लिखते हैं, और यह एक टेक्स्ट उत्तर उत्पन्न करता है। नवीनतम मॉडल बेहतर संदर्भात्मक समझ और तार्किक तर्क पर खास तौर से बेहतर प्रदर्शन का वादा करते हैं। Llama मॉडल्स Meta AI को शक्ति देते हैं, जो Instagram, WhatsApp, Messenger और Facebook में शामिल एक स्मार्ट असिस्टेंट है।
Llama 3 एक "ओपन वेट्स" मॉडल है। इसका अर्थ है कि मॉडल स्वयं ओपन सोर्स है, जिससे यह कुछ हद तक पारदर्शिता देता है कि यह गणनाएँ कैसे करता है। फिर भी, इसे पुनःनिर्मित करने के पूरे विवरण, जैसे इसे प्रशिक्षित करने के लिए उपयोग किए गए डेटासेट, सार्वजनिक रूप से उपलब्ध नहीं हैं।
Midjourney से बनाई गई 3 लामा की एक छवि। प्रयुक्त प्रॉम्प्ट: “A cartoon of 3 llamas happily frolicking in a field”
Llama3 की नई क्षमताएँ
Llama 3 दो आकारों में उपलब्ध है: 8 बिलियन पैरामीटर मॉडल और 70 बिलियन पैरामीटर मॉडल। आम तौर पर, अधिक पैरामीटर बेहतर आउटपुट गुणवत्ता देते हैं लेकिन मॉडल को धीमा और चलाने में अधिक महंगा बनाते हैं। 70 बिलियन पैरामीटर कई प्रतिस्पर्धी मॉडलों के तुलनीय है, हालांकि कुछ उल्लेखनीय मॉडल इससे भी बड़े रहे हैं। तीसरा, 400 बिलियन पैरामीटर वाला एक बड़ा मॉडल विकासाधीन होने की घोषणा की गई है।
कॉन्टेक्स्ट विंडो—एक बार में जितने टेक्स्ट पर विचार किया जा सकता है—को 4096 से बढ़ाकर 8192 टोकन कर दिया गया है। एक टोकन एक शब्द या विराम चिह्न को संदर्भित करता है, हालांकि कुछ शब्द कई टोकनों में विभाजित हो जाते हैं। अंग्रेजी में, चार टोकन लगभग तीन शब्दों के बराबर होते हैं, इसलिए नई कॉन्टेक्स्ट विंडो लगभग 15 पृष्ठों के टेक्स्ट के बराबर है (प्रति पृष्ठ 400 शब्द मानकर)। जबकि यह वृद्धि स्वागतयोग्य है, यह अब भी अग्रणी स्तर से काफी कम है, क्योंकि Claude 3 मॉडल 200,000 टोकन की कॉन्टेक्स्ट विंडो प्रदान करते हैं।
घोषणा लेख में मॉडल की अन्य विशेषताओं का वर्णन नहीं किया गया था। इसके बजाय, ध्यान का अधिकांश भाग आस-पास के सॉफ्टवेयर इकोसिस्टम पर था।
Llama 3 इकोसिस्टम
Llama3 की घोषणा के साथ ही, Meta ने Llama के साथ काम करना आसान और सुरक्षित बनाने के लिए टूल्स का एक सूट भी घोषित किया। यहाँ एक संक्षिप्त विवरण है।
Llama Guard 2
Llama Guard 2 एक LLM टूल है जो टेक्स्ट को "सुरक्षित" या "असुरक्षित" के रूप में वर्गीकृत करता है। इसे प्रॉम्प्ट्स और उत्तर दोनों के लिए उपयोग किया जा सकता है। उदाहरण के लिए, यह पता लगा सकता है कि टेक्स्ट में हिंसा, घृणास्पद भाषण या अन्य आपत्तिजनक सामग्री के वर्णन हैं या नहीं।
एक उदाहरण उपयोग मामला चैटबॉट है। आप प्रत्येक प्रॉम्प्ट की जाँच कर सकते हैं, और यदि सामग्री असुरक्षित के रूप में चिह्नित होती है, तो आप चेतावनी दे सकते हैं या समस्या वाली सामग्री से निपटने का कोई अन्य तरीका अपना सकते हैं। इसी तरह, यदि चैटबॉट कोई ऐसा उत्तर उत्पन्न करता है जिसे असुरक्षित के रूप में चिह्नित किया गया है, तो आप उसे उपयोगकर्ता के देखने से पहले ही रोककर पुनः प्रयास कर सकते हैं।
सुरक्षित/असुरक्षित फ्लैग के अतिरिक्त, Llama Guard 2 से आने वाले उत्तरों को एक सुरक्षा लेबल के साथ टैग किया जाता है—MLCommons AI Safety Taxonomy की ग्यारह श्रेणियों में से एक।
Llama Code Shield
Llama Code Shield कोड को सुरक्षित या असुरक्षित के रूप में वर्गीकृत करता है। चूँकि कई सॉफ्टवेयर डेवलपर कोड लिखने में मदद के लिए LLMs का उपयोग कर रहे हैं, इसलिए जोखिम है कि असुरक्षित कोड जनरेट होकर प्रोडक्शन में शामिल हो जाए। यह टूल AI कोडिंग असिस्टेंट्स में शामिल होने और VSCode तथा DataLab जैसे अन्य टूल्स में एकीकृत होने के लिए बनाया गया है।
CyberSec Eval 2
CyberSec Eval 2 आपको यह आकलन करने देता है कि कोई LLM कितना सुरक्षित है। मूल CyberSec Eval कोड जनरेशन की सुरक्षा और साइबर हमलों से सुरक्षा का मूल्यांकन करने देता था। नवीनतम संस्करण इसमें और जोड़ता है, जैसे प्रॉम्प्ट इंजेक्शन के प्रति संवेदनशीलता का आकलन, स्वचालित आक्रामक साइबरसिक्योरिटी क्षमताएँ, और कोड इंटरप्रेटर के दुरुपयोग की प्रवृत्ति।
torchtune
torchtune एक Python पैकेज है जो PyTorch डीप लर्निंग फ्रेमवर्क के साथ मिलकर काम करता है, ताकि अपने खुद के LLMs विकसित करना आसान हो सके। इसमें चार कार्यों के लिए टूल्स हैं।
- मौजूदा LLMs पर आधारित बिल्डिंग ब्लॉक्स से नए मॉडल बनाना
- LLMs का फाइन-ट्यूनिंग, जैसे LoRA और QLoRA तकनीकों का उपयोग
- मॉडलों के प्रशिक्षण, क्वांटाइज़ेशन और मूल्यांकन के लिए सेटिंग्स कॉन्फ़िगर करना
- अधिक सुगम प्रशिक्षण के लिए प्रॉम्प्ट टेम्पलेट्स और डेटासेट इंटीग्रेशन
torchtune लोकप्रिय मशीन लर्निंग प्लेटफ़ॉर्म जैसे Hugging Face, Weights & Biases, EleutherAI, और Executorch के साथ एकीकृत है।
Llama 3 के उपयोग के मामले क्या हैं?
Llama 3 के उपयोग के मामले Llama 2 और अन्य LLMs के समान हैं। सामान्य उपयोग इस प्रकार हैं।
- चैटबॉट्स: संवादी एजेंटों के माध्यम से ग्राहक सेवा, सपोर्ट और एंगेजमेंट का स्वचालन।
- दस्तावेज़ सार-संक्षेप: लंबे दस्तावेज़ों को छोटे संस्करणों में संक्षिप्त करना जो मुख्य बिंदुओं को उजागर करें; कानूनी, शैक्षणिक और व्यावसायिक संदर्भों में उपयोगी।
- कंटेंट निर्माण: लेख, रिपोर्ट, ब्लॉग, और यहाँ तक कि कविता व कहानियों जैसी रचनात्मक लेखन का सृजन।
- ईमेल और संचार सहायता: ईमेल, उत्तर और अन्य नियमित संचार का मसौदा स्वचालित करना।
- उत्पाद विवरण: ई-कॉमर्स वेबसाइटों के लिए अनूठे और आकर्षक उत्पाद विवरण स्वतः उत्पन्न करना।
- शैक्षणिक टूल्स: अध्ययन गाइड, परीक्षा प्रश्न और विद्यार्थियों के सीखने के स्तर के अनुसार अनुकूलित शैक्षणिक सामग्री बनाना।
- प्रोग्रामिंग और कोड जनरेशन: डेवलपर्स की मदद करना, जैसे कोड स्निपेट बनाना, मौजूदा कोड को डीबग करना, या प्रोग्रामिंग अनुशंसाएँ देना।
- डेटा विश्लेषण रिपोर्ट्स: डेटा निष्कर्षों का सारांश और संरचित इनपुट से रिपोर्ट्स बनाना।
- वर्चुअल असिस्टेंट्स: व्यक्तिगत असिस्टेंट ऐप्स को शक्ति देना जो शेड्यूल मैनेज करें, प्रश्नों के उत्तर दें और कार्य करें।
Llama 3 का प्रदर्शन तुलना में कैसा है?
Meta की घोषणा में Llama 3 के आठ बिलियन (8B) और सत्तर बिलियन (70B) पैरामीटर संस्करणों के बेंचमार्क परिणाम दो अन्य मॉडलों के मुकाबले दिखाए गए हैं।
निम्नलिखित बेंचमार्क्स का उपयोग किया गया।
- Massive Multitask Language Understanding (MMLU)। प्रारंभिक गणित, अमेरिकी इतिहास, कंप्यूटर विज्ञान, क़ानून आदि पर कार्य। इस परीक्षण में उच्च सटीकता प्राप्त करने के लिए मॉडलों में व्यापक विश्व-ज्ञान और समस्या-समाधान क्षमता होनी चाहिए।
- Graduate-Level Google-Proof Q&A (GPQA)। जीव विज्ञान, भौतिकी और रसायन विज्ञान में डोमेन विशेषज्ञों द्वारा लिखे गए बहुविकल्पीय प्रश्न। प्रश्न उच्च-गुणवत्ता और अत्यंत कठिन हैं: संबंधित क्षेत्रों में PhD धारक या उसका अनुसरण कर रहे विशेषज्ञ 74% सटीकता प्राप्त करते हैं।
- HumanEval। कंप्यूटर कोड की कार्यात्मक शुद्धता की परीक्षा, कोड जनरेशन जाँच के लिए प्रयुक्त।
- GSM-8K। उच्च-गुणवत्ता, भाषाई रूप से विविध, ग्रेड-स्कूल गणित के शब्द-समस्याएँ।
- MATH। मिडिल और हाई स्कूल गणित समस्याएँ।
Llama 3 8B की तुलना Google के Gemma 7B It और Mistral 7B Instruct से की गई। ये समान आकार के LLMs हैं (समान पैरामीटर संख्या), Hugging Face प्लेटफ़ॉर्म पर उपलब्ध ओपन वेट्स मॉडल हैं, और समान उपयोग मामलों के लिए अभिप्रेत हैं। परिणाम चित्र 1 में दिखाए गए हैं।
Llama 3 8B पाँचों बेंचमार्क्स पर अन्य दो मॉडलों से आराम से बेहतर प्रदर्शन करता है।
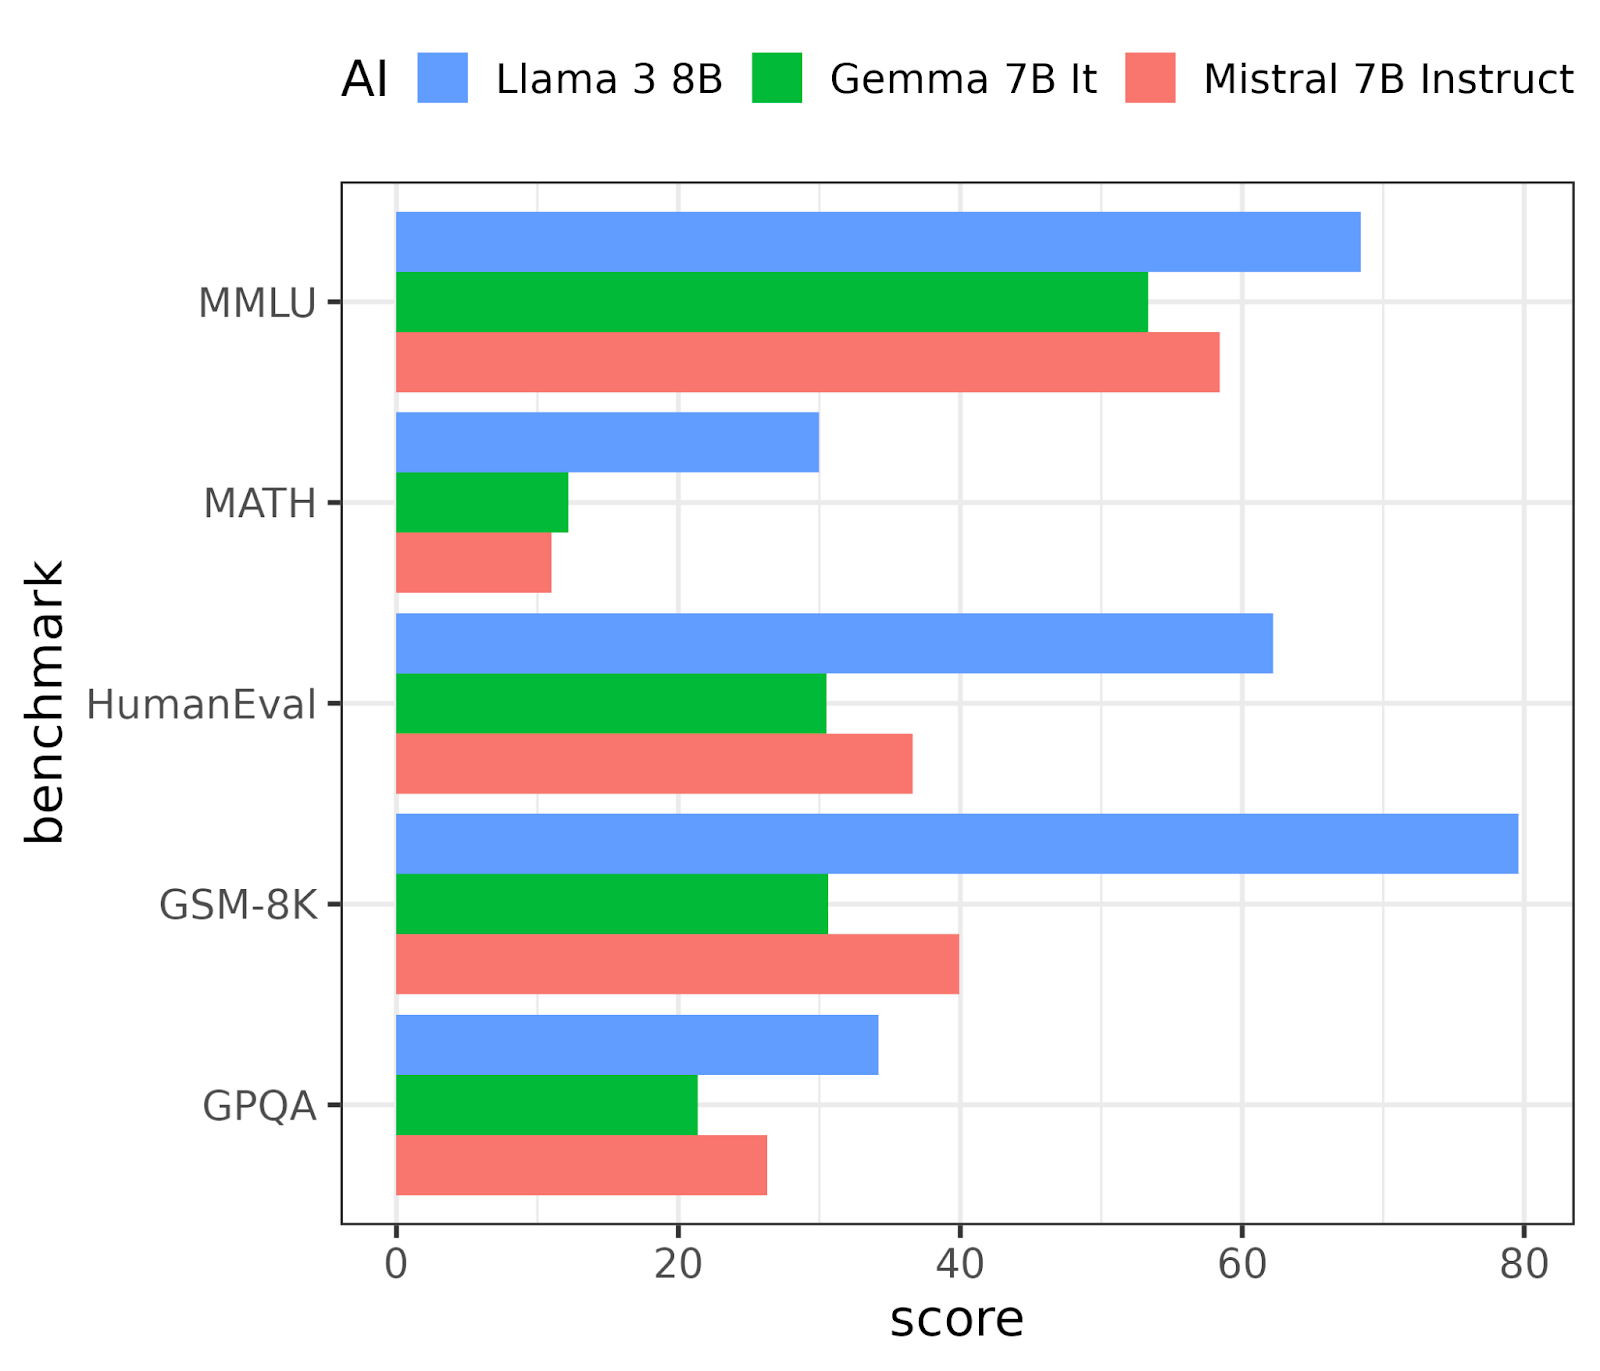
चित्र 1. 5 LLM बेंचमार्क्स पर दो तुलनीय मॉडलों के मुकाबले Llama 3 8B का प्रदर्शन।
Llama 3 70B की तुलना Google DeepMind के Gemini Pro 1.5 और Anthropic के Claude 3 Sonnet से की गई। ये अत्याधुनिक मॉडलों के क़रीब हैं, हालांकि उपलब्ध सर्वोच्च-प्रदर्शन वाले मॉडल नहीं हैं (यह सम्मान वर्तमान में OpenAI के GPT-4 Turbo और Anthropic के Claude 3 Opus के बीच अदला-बदली हो रहा है)। परिणाम चित्र 2 में दिखाए गए हैं।
यहाँ, तीन बेंचमार्क्स पर प्रदर्शन लगभग बराबरी पर है। Llama 3 80B कोड जनरेशन के HumanEval बेंचमार्क पर विजेता है और MATH बेंचमार्क पर Gemini Pro 1.5 के बाद दूसरे स्थान पर है।
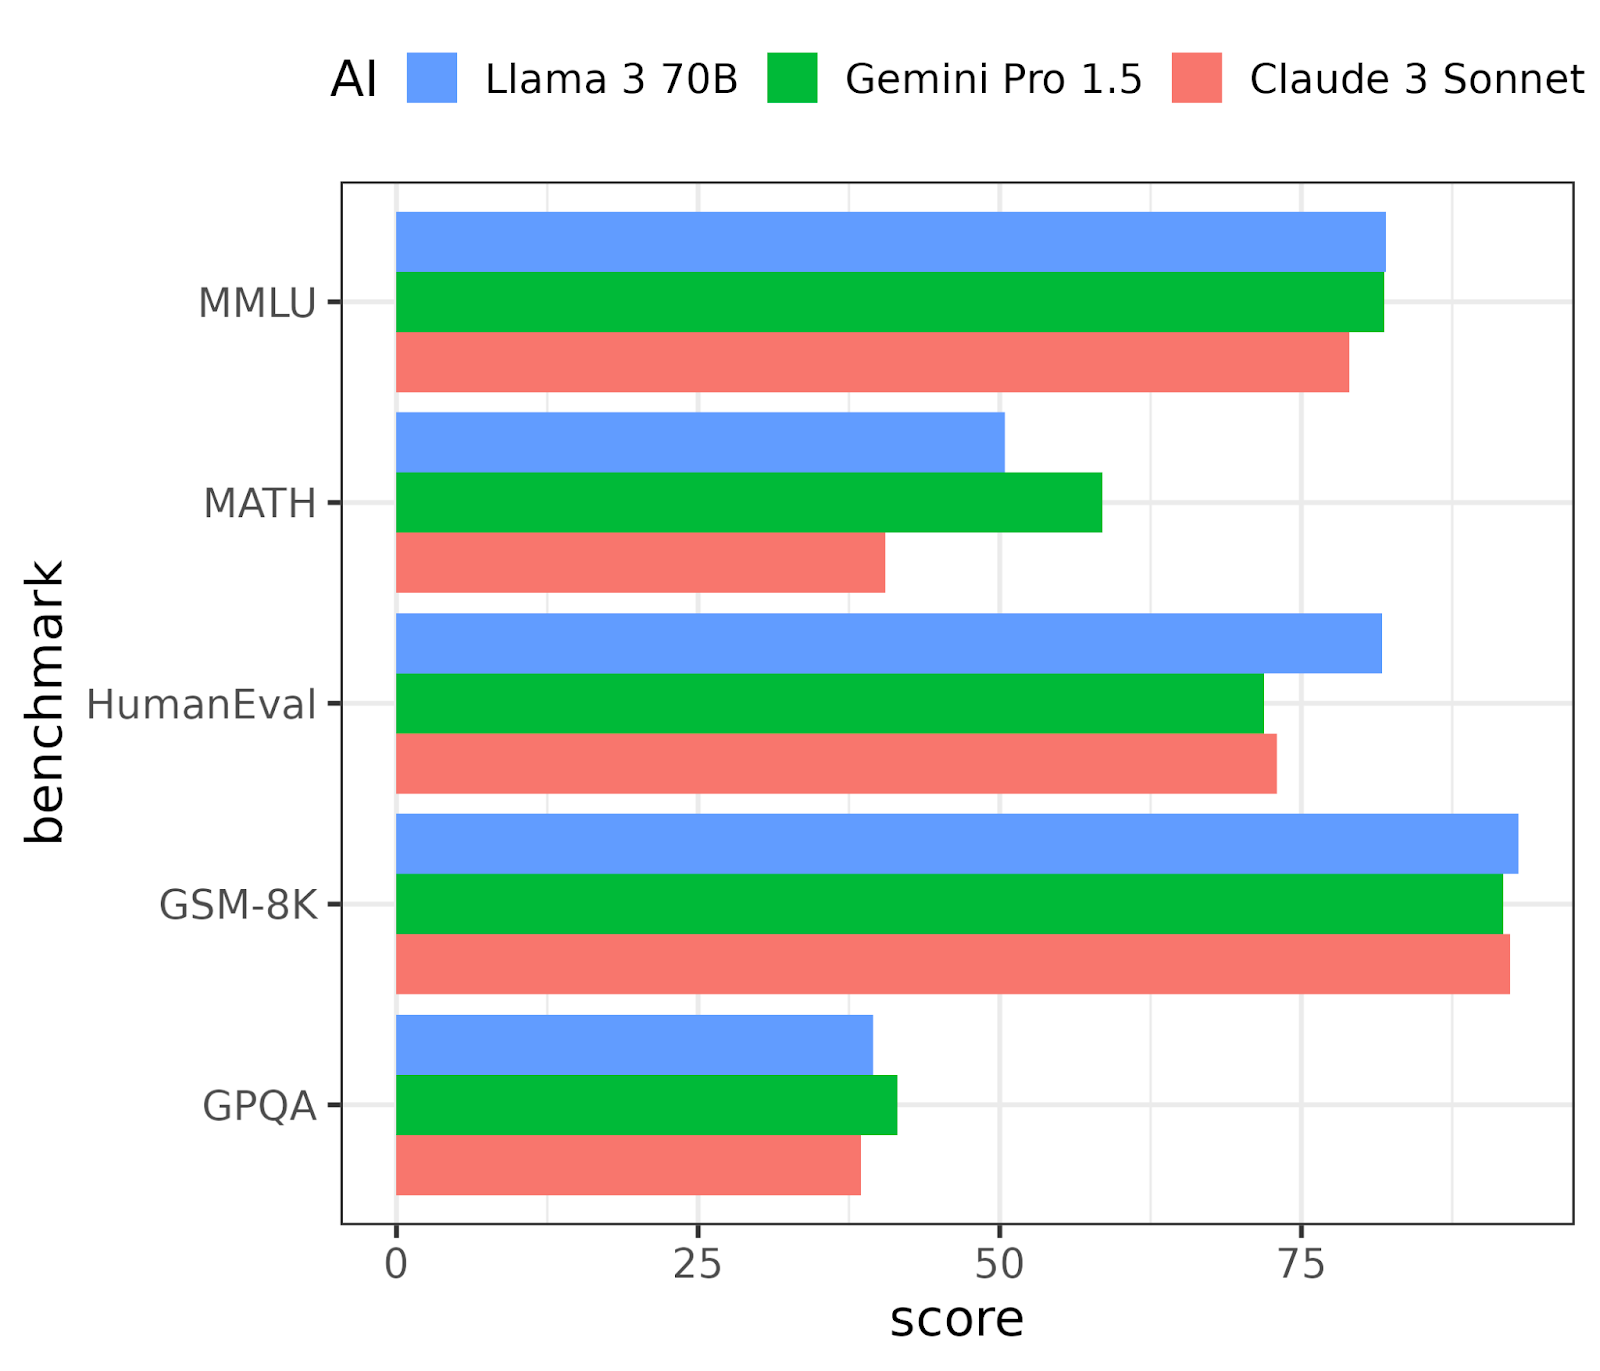
चित्र 2. 5 LLM बेंचमार्क्स पर दो तुलनीय मॉडलों के मुकाबले Llama 3 70B का प्रदर्शन।
बेंचमार्क परिणामों की व्याख्या
पाँच से अधिक बेंचमार्क्स हैं: Llama 3 का 15 पर परीक्षण किया गया, पर घोषणा में केवल पाँच के परिणाम दिखाए गए। इसी तरह, तुलना के लिए LLMs के और भी विकल्प हैं। यह स्पष्ट नहीं है कि परिणाम पेश करते समय Meta ने कितनी चुन-चुन कर प्रस्तुति दी।
दूसरे, आउटपुट की गुणवत्ता प्रदर्शन का केवल एक माप है। उत्तर उत्पन्न करने में लगने वाला समय और लागत भी महत्त्वपूर्ण हैं और घोषणा में शामिल नहीं थे।
तीसरे, प्रदर्शन हमेशा उपयोग के मामले पर निर्भर करता है, इसलिए अपने उपयोग मामलों के लिए सटीक परिणाम पाने हेतु आपको अपने हार्डवेयर पर अपने ही समस्याओं पर इसे आज़माने की ज़रूरत है।
Chatbot Arena रैंकिंग्स
Meta की घोषणा के बाद के दिनों में, Llama 3 का प्रदर्शन LMSYS Chatbot Arena Leaderboard पर दिखाई दिया, जो LLMs की एक सार्वजनिक रैंकिंग है। Llama 3 70B वर्तमान में 6वें स्थान पर है, जो किसी भी ओपन वेट्स LLM की सबसे ऊँची रैंकिंग है। (यह OpenAI GPT-4 के विभिन्न संस्करणों, Anthropic Claude 3 Opus, और Google Gemini Pro से पीछे है।) वहीं, Llama 3 8B 14वें स्थान पर है।
ये रैंकिंग्स में उल्लेखनीय छलाँगें हैं, और यह देखने लायक है कि Llama 2 के बाद से क्या बदला है।
Llama 3 कैसे काम करता है?
Llama 3 अपने पूर्ववर्तियों और GPT श्रृंखला की तरह डिकोडर-ओनली ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करता है। यह टेक्स्ट उत्पन्न करने वाले मॉडलों के लिए सबसे सामान्य आर्किटेक्चर है। (इसके विपरीत, एन्कोडर-ओनली आर्किटेक्चर उपयोगकर्ता द्वारा दिए गए टेक्स्ट को समझने या वर्गीकृत करने के लिए उपयोग होते हैं।)
Llama 3 की घोषणा में मॉडल संरचना या प्रशिक्षण प्रक्रिया में किसी क्रांतिकारी बदलाव का वर्णन नहीं है। इसके बजाय, उत्तर की गुणवत्ता, उत्तर की गति और विकास के बीच संतुलन को लेकर अनेक अनुकूलन हैं।
टेक्स्ट को टोकन्स में बदलने के लिए एक नया टोकनाइज़र अधिक कुशल है, इसलिए प्रॉम्प्ट्स और उत्तर 15% कम टोकन्स लेते हैं, जिसका मतलब है कि कॉन्टेक्स्ट विंडो में अधिक टेक्स्ट समा सकता है।
एक नया अटेंशन मैकेनिज्म—वह तकनीक जिसका उपयोग LLMs यह तय करने के लिए करते हैं कि आउटपुट जनरेट करने के लिए कौन से शब्द या वाक्यांश महत्त्वपूर्ण हैं—जिसे ग्रुप्ड क्वेरी अटेंशन कहा जाता है, पिछले मैकेनिज्म की तुलना में आउटपुट गुणवत्ता बनाम जनरेशन स्पीड के लिए बेहतर संतुलन देता है।
प्रशिक्षण डेटासेट Llama 2 में उपयोग किए गए की तुलना में सात गुना बड़ा है, जिसमें चार गुना अधिक कोड शामिल है। सामान्यतः, प्रशिक्षण डेटा में अधिक कोड होने का अर्थ है कि LLMs कोड जनरेट करने में बेहतर होंगे।
रुचिकर बात यह है कि Llama 2 मॉडल का उपयोग Llama 3 के प्रशिक्षण सेट में शामिल किए जाने वाले डेटा का मूल्यांकन और वर्गीकरण करने के लिए किया गया। बेहतर AI बनाने के लिए AI के उपयोग की धारणा लंबे समय से साइंस फिक्शन का हिस्सा रही है (यह Hitchhiker's Guide to the Galaxy में एक कथानक बिंदु है) और अब इसे व्यवहार में लाया जा रहा है।
पोस्ट-ट्रेनिंग प्रक्रिया का भी अनुकूलन किया गया है। किसी LLM के बनने के बाद, उस "कच्चे" LLM को उसके प्रदर्शन में सुधार के लिए ट्यून किया जा सकता है। Meta नोट करता है कि Llama 3 प्रक्रिया में निम्न तकनीकें शामिल हैं।
- सुपरवाइज़्ड फाइन-ट्यूनिंग, एक सुपरवाइज़्ड मशीन लर्निंग तकनीक, जहाँ प्रॉम्प्ट-उत्तर के जोड़े उच्च-गुणवत्ता वाले उत्तरों के रूप में अच्छे आउटपुट के उदाहरण देते हैं।
- रिजेक्शन सैंपलिंग, जहाँ कई आउटपुट जनरेट कर रैंक किए जाते हैं और सबसे ख़राब को खारिज कर दिया जाता है।
- डायरेक्ट पॉलिसी ऑप्टिमाइज़ेशन और प्रॉक्सिमल पॉलिसी ऑप्टिमाइज़ेशन रीइन्फोर्समेंट लर्निंग तकनीकें, जहाँ अच्छे उत्तरों के लिए मॉडल को रिवार्ड दिया जाता है।
क्या शामिल नहीं था?
इस रिलीज़ में कुछ उल्लेखनीय अनुपस्थितियाँ रहीं।
कोई मल्टीमोडल AI नहीं
OpenAI का ChatGPT, GPT-4 टेक्स्ट AI को DALL∙E 3 इमेज AI के साथ संयोजित करता है। यानी, यह "मल्टीमोडल" है। Meta की घोषणा संकेत देती है कि Llama 3 को मल्टीमोडल बनाना निकट भविष्य का लक्ष्य है।
कोई बहुभाषी AI नहीं
Llama 3 डेटासेट को 95% अंग्रेजी भाषा के टेक्स्ट वाला बताया गया है। इसका मतलब है कि अन्य भाषाओं के लिए प्रदर्शन काफ़ी कमजोर होने की उम्मीद है। मल्टीमोडल AI की तरह, Llama 3 का बहुभाषी संस्करण रोडमैप पर है।
Mixture of Experts नहीं
घोषणा में जिस एक तकनीक का उल्लेख नहीं था, वह है मिश्रित विशेषज्ञों की आर्किटेक्चर का उपयोग। इस तकनीक में, एक LLM कई छोटे LLMs से बना होता है जो संकरी भूमिकाओं में विशेषज्ञ होते हैं (उदाहरण के लिए, एक कोड जनरेशन LLM, एक दस्तावेज़ सार-संक्षेप LLM, और एक संवाद LLM)। इसे Mistral AI के Mixtral मॉडलों द्वारा लोकप्रिय किया गया और यह OpenAI के GPT-4 का आधार होने की अफ़वाह है, जो प्रति पैरामीटर बेहतर प्रदर्शन देता है। यानी, इस तकनीक का उपयोग करके आप छोटे (और इसलिए सस्ते और तेज़) मॉडल के साथ समान प्रदर्शन पा सकते हैं। चूँकि Meta इस तकनीक का उल्लेख नहीं करता (और Llama 3 GitHub रिपॉज़िटरी में भी इसका उल्लेख नहीं है), हम मान सकते हैं कि यह तरीका उपयोग नहीं हुआ।
कोई वर्ल्ड मॉडल नहीं
Meta के चीफ़ AI साइंटिस्ट, Yann LeCun, वर्ल्ड मॉडलों के मजबूत समर्थक रहे हैं, जहाँ AI दुनिया के काम करने के तरीके का आंतरिक मॉडल विकसित करता है ताकि वह तेजी से सीख सके, जटिल कार्य कर सके और अपरिचित परिस्थितियों के अनुकूल हो सके। घोषणा में इस क्रांतिकारी आर्किटेक्चर का कोई उल्लेख नहीं था, इसलिए प्रतीत होता है कि यह Llama 3 में मौजूद नहीं है।
मैं Llama 3 कहाँ एक्सेस कर सकता/सकती हूँ?
Llama 3 को उसकी वेबसाइट और उसकी GitHub रिपॉज़िटरी से डाउनलोड किया जा सकता है। यह पहले से ही Facebook, Instagram, WhatsApp और Messenger में Meta AI असिस्टेंट को शक्ति दे रहा है, इसलिए आप उन प्लेटफ़ॉर्म्स पर Meta AI का उपयोग कर अप्रत्यक्ष रूप से Llama 3 आज़मा सकते हैं।
AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM और Snowflake के साथ इंटीग्रेशन "जल्द उपलब्ध" होने का वादा किया गया है, जो आपको उन प्लेटफ़ॉर्म्स के माध्यम से Llama 3 तक पहुँचने देंगे।
क्या Llama 3 मायने रखता है?
उच्च-स्तरीय प्रदर्शन पर, बड़े भाषा मॉडल परिदृश्य की हालिया कहानी OpenAI के GPT-4 और Anthropic के Claude 3 Opus के बीच श्रेष्ठता की होड़ की रही है, जिसमें Google Gemini Pro और Cohere का Command R+ क़रीबी पीछा कर रहे हैं। यह देखना बाकी है कि विकासाधीन बड़े आकार वाला Llama 3 संस्करण ताज के लिए दावेदार होगा या नहीं, पर इस बीच Meta ने Llama 3 में उल्लेखनीय प्रदर्शन सुधार हासिल किए हैं।
पिछले कुछ वर्षों में, क्लोज़्ड मॉडल्स (जहाँ मॉडल का विवरण सार्वजनिक रूप से उपलब्ध नहीं होता) ने अधिक खुले मॉडलों से बेहतर प्रदर्शन किया है। यह तथ्य कि Llama 3 रैंकिंग में छठे स्थान पर आया है, इसलिए, काफ़ी महत्त्वपूर्ण है।
Llama के लिए Meta का मुख्य अल्पकालिक लक्ष्य बस अपनी सोशल मीडिया प्लेटफ़ॉर्म्स के लिए Meta AI स्मार्ट असिस्टेंट को शक्ति देना है। यह OpenAI, Anthropic या Cohere से बहुत अलग बिज़नेस मॉडल है, जो चाहते हैं कि अन्य कंपनियों के AI उत्पादों में उपयोग के लिए वे अपने LLM बेचें। इस संदर्भ में, कोड जनरेट करने या गणित की समस्याएँ हल करने के लिए प्रदर्शन बेंचमार्क्स कंपनी के लिए बहुत मायने न भी रखें।
Meta के पास अरबों उपयोगकर्ताओं द्वारा बनाए गए सोशल पोस्ट्स का एक अनूठा प्रशिक्षण डेटासेट है, और—शेखी बघारने के अधिकारों से परे—वह एकमात्र प्रदर्शन मीट्रिक जो मायने रखता है, वह है "क्या LLama 3 सोशल मीडिया उपयोगकर्ताओं की आवश्यकताओं को पर्याप्त रूप से पूरा करता है?"
इसके अलावा, ओपन वेट्स दृष्टिकोण का अर्थ है कि Llama 3 प्रतियोगिता की तुलना में चलाने में संभावित रूप से सस्ता है। मूलतः AI को मुफ्त में देकर, यह अपने प्रतिस्पर्धियों द्वारा अपनी APIs के लिए वसूले जा सकने वाले दामों पर नीचे की ओर दबाव डालता है। यह महत्त्वपूर्ण है, क्योंकि 2023 का उत्तेजक आशावाद और निरंतर बढ़ते जनरेटिव AI प्रदर्शन के सपने 2024 की अधिक सतर्कता में बदल गए हैं, जब अधिकारियों ने नोटिस करना शुरू किया कि LLM फीचर्स कितने महंगे हैं, और प्रति डॉलर प्रदर्शन प्राथमिकता सूची में ऊपर आ गया है।
ओपन वेट्स मॉडल्स उन परिस्थितियों में भी महत्त्वपूर्ण हैं जहाँ डेटा गोपनीयता सर्वोपरि है; उदाहरण के लिए, वित्तीय डेटा, हेल्थकेयर डेटा, या व्यक्तिगत पहचान योग्य जानकारी के साथ काम करते समय। ऐसी अत्यधिक संवेदनशील जानकारी को किसी अन्य कंपनी द्वारा होस्ट किए गए LLM (जैसे GPT और अन्य क्लोज़्ड मॉडल्स) को भेजना एक व्यावसायिक जोखिम है जिसे अधिकांश कंपनियाँ लेने को तैयार नहीं होतीं। इसका मतलब है चैटबॉट या अन्य AI फीचर के लिए अधिक जटिल आर्किटेक्चर का उपयोग करना ताकि संवेदनशील डेटा को LLM से अलग रखा जा सके। Llama 3 जैसा ओपन वेट्स मॉडल जहाँ चाहें होस्ट किया जा सकता है, जिससे डेटा गोपनीयता बनाए रखते हुए AI उत्पादों और फीचर्स को बनाना आसान हो जाता है।
समापन टिप्पणियाँ
Llama 3, Llama 2 पर क्रमिक सुधार जैसा प्रतीत होता है। आर्किटेक्चर में कोई बड़े बदलाव की घोषणा नहीं हुई, और न ही कोई प्रमुख फीचर घोषित हुआ।
लागत-प्रदर्शन संतुलन पर ध्यान यह संकेत देता है कि Meta एक ऐसा AI लक्षित कर रहा है जिसे बड़े पैमाने पर सस्ते में चलाया जा सके। सबसे रोमांचक ख़बर इकोसिस्टम उत्पादों के इर्द-गिर्द थी: अन्य डेवलपर्स को उच्च-गुणवत्ता वाले LLMs अधिक कुशलता से बनाने में मदद करना, Meta के खुले दृष्टिकोण के सबसे महत्त्वपूर्ण लाभों में से एक है।
यदि आप जनरेटिव AI की दुनिया में शुरुआत करने के इच्छुक हैं, तो हमारा AI Fundamentals स्किल ट्रैक आपको मशीन लर्निंग, डीप लर्निंग, NLP, जनरेटिव मॉडल्स, और बहुत कुछ में तेज़ी से गति पाने में मदद करेगा। आप हमारे ये गाइड भी पढ़ सकते हैं: Llama 3 का फाइन-ट्यूनिंग, Llama 3.1 और Llama 3.2।