
Last chance! 50% off DataCamp Premium
Sale ends in
Llama 3 bir metin üretim yapay zekasıdır. Yani, OpenAI’nin GPT’si ve Anthropic’in Claude modellerine benzer şekilde, bir metin istemi yazarsınız ve o da metin yanıtı üretir. En yeni modeller, özellikle daha iyi bağlamsal anlama ve mantıksal akıl yürütme etrafında iyileştirilmiş performans vaat ediyor. Llama modelleri, Instagram, WhatsApp, Messenger ve Facebook’a dahil edilen akıllı asistan Meta AI’ı çalıştırmak için kullanılıyor.
Llama 3, "açık ağırlık" bir modeldir. Bu, modelin kendisinin açık kaynak olduğu ve nasıl hesaplama yaptığına dair bir miktar şeffaflık sağladığı anlamına gelir. Yine de, onu yeniden oluşturmak için gereken veri kümeleri gibi tüm ayrıntılar kamuya açık değildir.
Midjourney ile oluşturulmuş 3 Lama resmi. Kullanılan istem: “Bir tarlada neşeyle koşturan 3 laması olan bir çizgi film”.
Llama 3 iki boyutta sunuluyor: 8 milyar parametreli bir model ve 70 milyar parametreli bir model. Genel olarak, daha fazla parametre daha iyi çıktı kalitesi sağlar ancak modeli daha yavaş ve çalıştırması daha pahalı hale getirir. 70 milyar parametre birçok rakip modelle karşılaştırılabilir, ancak daha da büyük parametre boyutlarına sahip dikkat çekici modeller de olmuştur. 400 milyar parametreli üçüncü, daha büyük bir modelin geliştirme aşamasında olduğu duyuruldu.
Bağlam penceresi—aynı anda üzerinde akıl yürütülebilen metin miktarı—4096’dan 8192 belirtece (token) çıkarılarak iki katına çıkarıldı. Bir belirteç tek bir kelimeye veya noktalama işaretine karşılık gelir, ancak bazı kelimeler birden çok belirtece bölünebilir. İngilizcede, dört belirteç yaklaşık üç kelimedir; dolayısıyla yeni bağlam penceresi yaklaşık 15 sayfa metne (sayfa başına 400 kelime) denk gelir. Artış memnuniyet verici olmakla birlikte, Claude 3 modellerinin 200.000 belirteçlik bağlam penceresi sunduğu düşünüldüğünde, hâlâ öncül seviyeden uzaktır.
Duyuru makalesinde modelin diğer özellikleri açıklanmadı. Bunun yerine, odak noktası büyük ölçüde etrafındaki yazılım ekosistemi oldu.
Llama3 duyurusuna paralel olarak Meta, Llama ile çalışmayı daha kolay ve güvenli hale getirecek bir dizi araç tanıttı. İşte bir özet.
Llama Guard 2, metni "güvenli" veya "güvensiz" olarak sınıflandıran bir LLM aracıdır. Hem istemler hem de yanıtlar için kullanılabilir. Örneğin, metnin şiddet, nefret söylemi veya diğer uygunsuz içerik tanımları içerip içermediğini tespit edebilir.
Örnek bir kullanım alanı bir sohbet robotudur. Her istemi kontrol edebilir ve içerik güvensiz olarak işaretlenirse, bir uyarı verebilir veya sorunlu içerikle başa çıkmak için başka bir yöntem uygulayabilirsiniz. Benzer şekilde, sohbet robotu güvensiz olarak işaretlenen bir yanıt üretirse, bunu kullanıcı görmeden önce yakalayıp yeniden denemek mümkündür.
Güvenli/güvensiz bayrağına ek olarak, Llama Guard 2’den gelen yanıtlar bir güvenlik etiketiyle—MLCommons AI Güvenlik Taksonomisi’ndeki on bir uygunsuz içerik kategorisinden biriyle—etiketlenir.
Llama Code Shield, kodu güvenli veya güvensiz olarak sınıflandırır. Birçok yazılım geliştiricinin kod yazarken LLM’lerden yararlanmasıyla, güvensiz kodun üretilip canlı ortama dahil edilmesi riski vardır. Bu araç, yapay zekâ kod asistanlarına dahil edilmek ve VSCode ile DataLab gibi diğer araçlara entegre edilmek üzere tasarlanmıştır.
CyberSec Eval 2, bir LLM’in ne kadar güvenli olduğunu değerlendirmenizi sağlar. İlk CyberSec Eval, kod üretiminin güvenliğini ve siber saldırılara karşı korumayı değerlendirmenize imkân tanıyordu. En son sürüm bunun üzerine inşa edilerek istem enjeksiyonuna yatkınlık, otomatik saldırgan siber güvenlik yetenekleri ve bir kod yorumlayıcısını kötüye kullanma eğilimini değerlendirmeye yönelik özellikler sunuyor.
torchtune, kendi LLM’lerinizi geliştirmeyi kolaylaştırmak için PyTorch derin öğrenme çerçevesiyle birlikte çalışan bir Python paketidir. Dört görev için araçlar sunar.
torchtune, Hugging Face, Weights & Biases, EleutherAI ve Executorch gibi popüler makine öğrenimi platformlarıyla entegredir.
Llama 3’ün kullanım alanları, Llama 2 ve diğer LLM’lerle aynıdır. Yaygın kullanımlar şunları içerir.
Meta’nın duyurusu, Llama 3’ün sekiz milyar (8B) ve yetmiş milyar (70B) parametreli sürümlerinin iki başka modele karşı kıyaslama sonuçlarını gösteriyor.
Aşağıdaki kıyaslamalar kullanıldı.
Llama 3 8B modeli, Google’ın Gemma 7B It ve Mistral 7B Instruct modellerine karşı kıyaslandı. Bunlar benzer boyutta LLM’lerdir (benzer parametre sayısı), Hugging Face platformunda mevcut açık ağırlık modelleridir ve benzer kullanım durumları için tasarlanmıştır. Sonuçlar Şekil 1’de gösterilmiştir.
Llama 3 8B, beş kıyaslamanın tamamında diğer iki modeli rahatça geride bırakıyor.
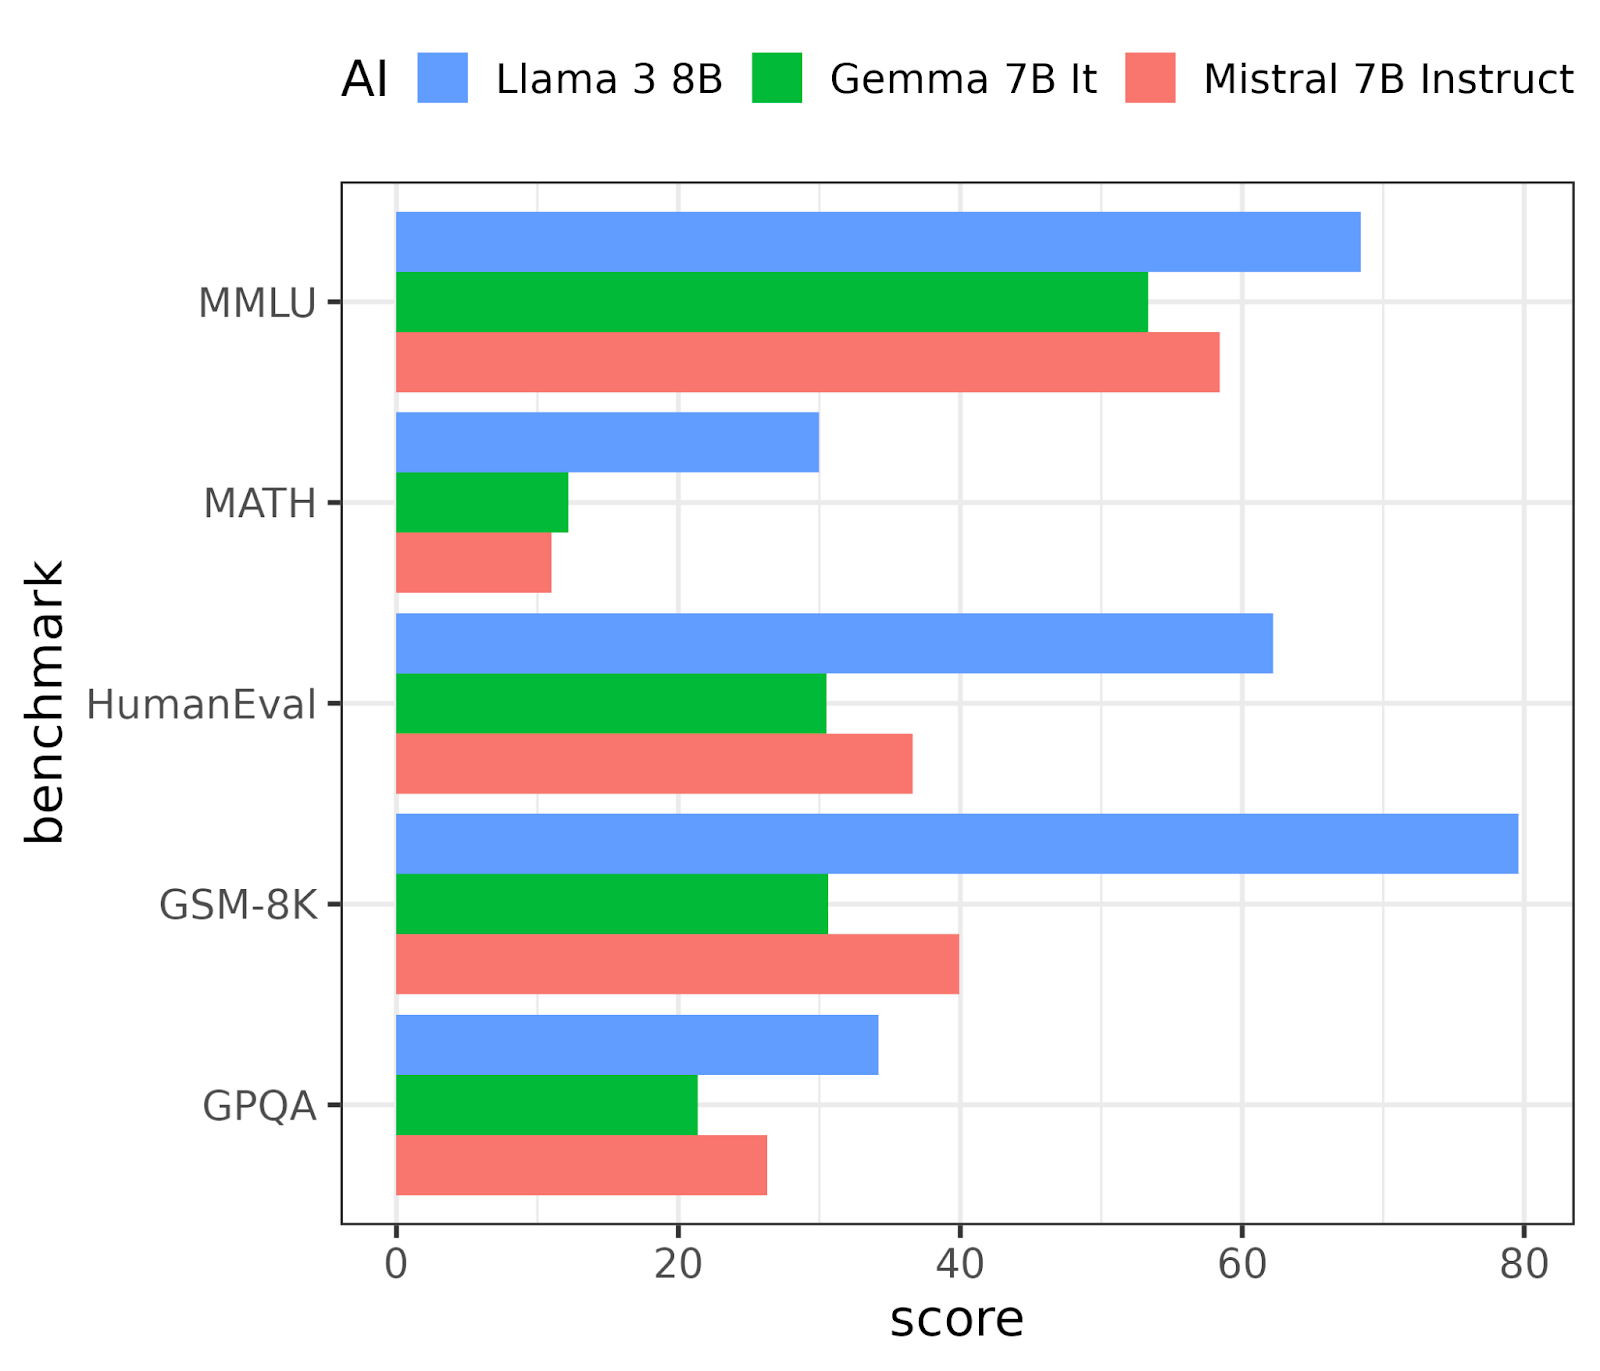
Şekil 1. Llama 3 8B’nin 5 LLM kıyaslamasında karşılaştırılabilir iki modele karşı performansı.
Llama 3 70B, Google DeepMind’in Gemini Pro 1.5 ve Anthropic’in Claude 3 Sonnet modellerine karşı kıyaslandı. Bunlar uç seviyeye yakın modellerdir, ancak mevcut en yüksek performanslı modeller değildir (bu unvan şu anda OpenAI’nin GPT-4 Turbo’su ile Anthropic’in Claude 3 Opus’u arasında gidip gelmektedir). Sonuçlar Şekil 2’de gösterilmiştir.
Burada, performans üç kıyaslamada hemen hemen başa baş. Llama 3 80B, kod üretimi için HumanEval kıyaslamasında kazanıyor ve MATH kıyaslamasında Gemini Pro 1.5’in ardından ikinci sırada yer alıyor.
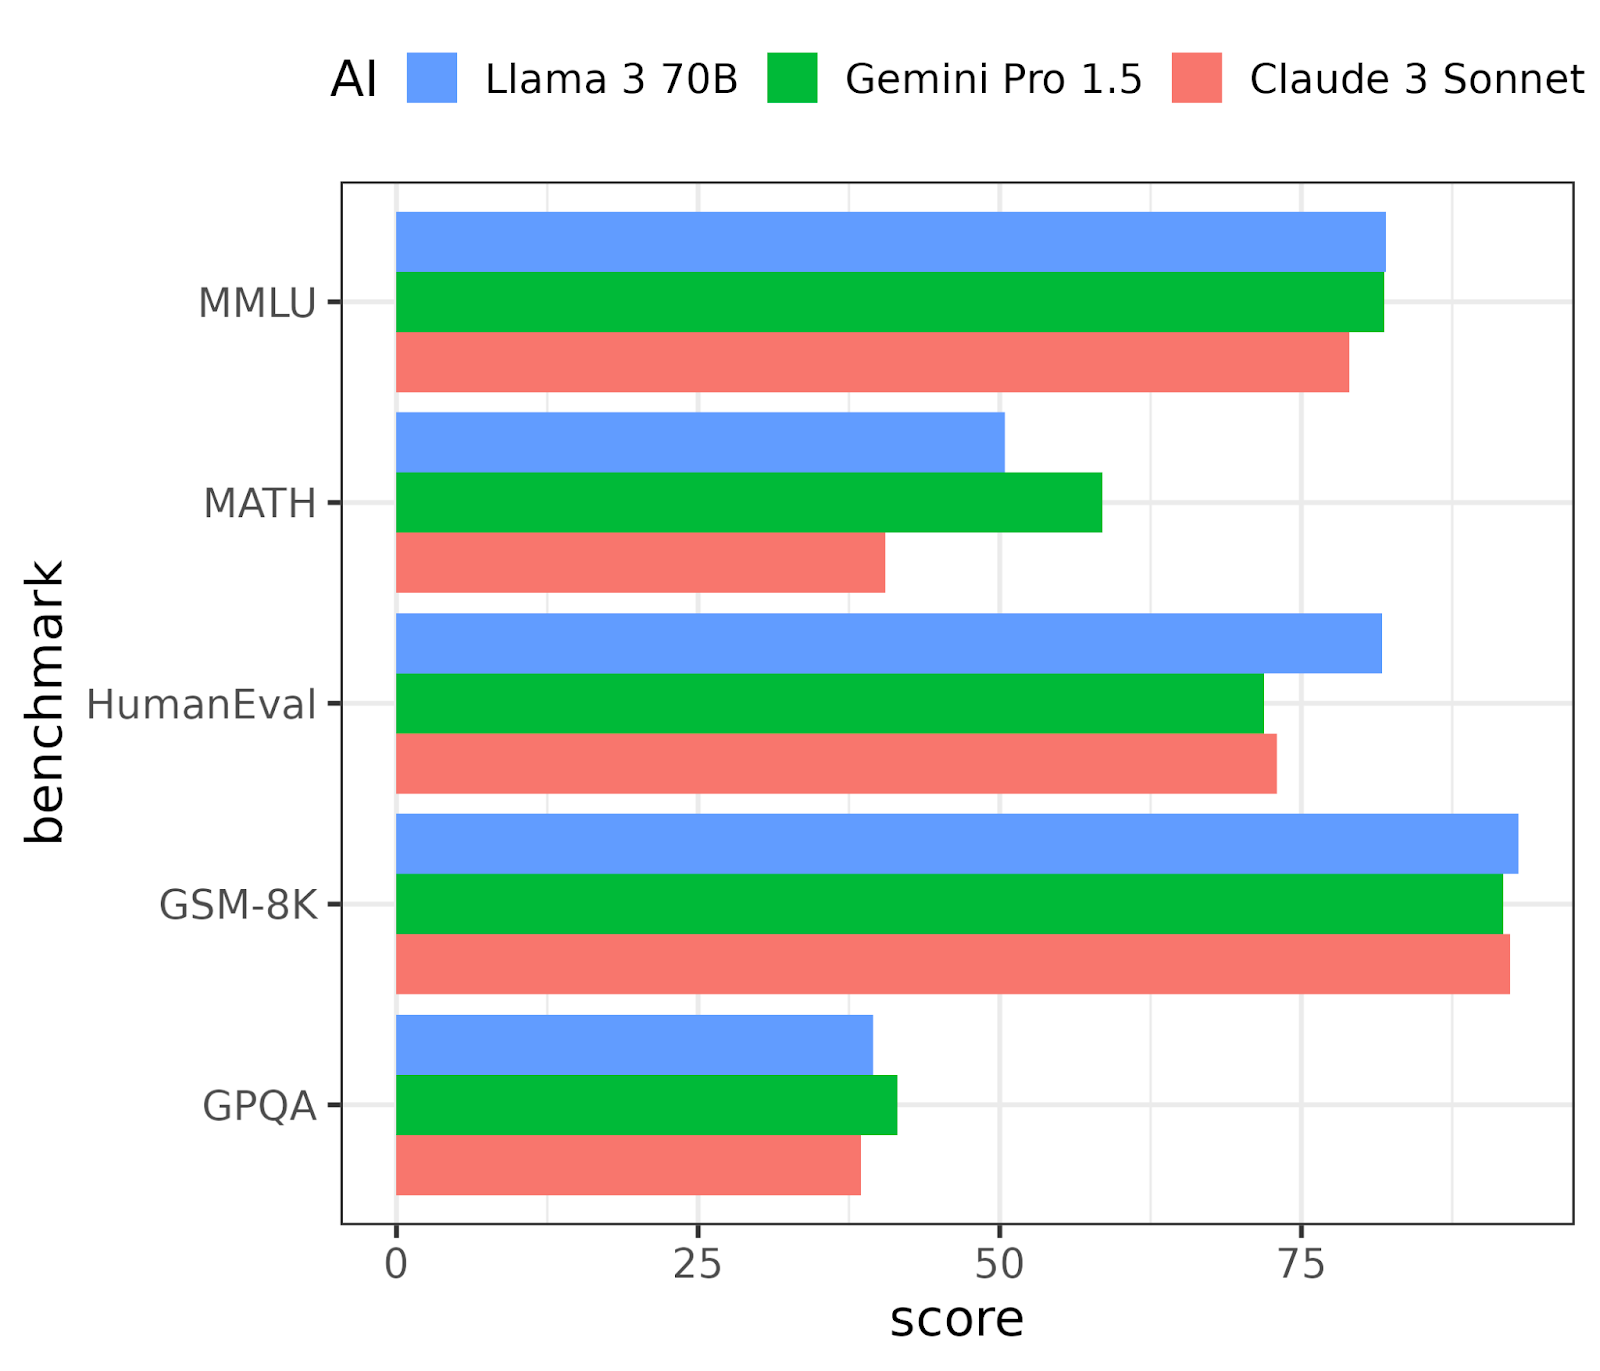
Şekil 2. Llama 3 70B’nin 5 LLM kıyaslamasında karşılaştırılabilir iki modele karşı performansı.
Beşten fazla kıyaslama vardır: Llama 3 15’inde test edilmiştir, ancak duyuruda yalnızca beşinin sonuçları gösterilmiştir. Benzer şekilde, karşılaştırılacak çok daha fazla LLM seçeneği vardır. Meta’nın sonuçları sunarken ne kadar seçmeci davrandığı belirsizdir.
İkincisi, çıktı kalitesi performansın yalnızca bir ölçüsüdür. Yanıt üretme süresi ve maliyeti de önemlidir ve duyuruda ele alınmamıştır.
Üçüncüsü, performans her zaman kullanım durumuna göre değişir; bu nedenle kendi kullanım alanlarınız için doğru sonuçlar elde etmek üzere modeli kendi donanımınızda denemeniz gerekir.
Meta duyurusundan sonraki günlerde, Llama 3’ün performansı LLM’lerin herkese açık sıralaması olan LMSYS Chatbot Arena Liderlik Tablosunda yer aldı. Llama 3 70B şu anda 6. sırada; bu, açık ağırlık bir LLM’in ulaştığı en yüksek sıralamadır. (Çeşitli OpenAI GPT-4 sürümlerinin, Anthropic Claude 3 Opus’un ve Google Gemini Pro’nun gerisindedir.) Bu arada, Llama 3 8B 14. sıradadır.
Bunlar kayda değer sıçramalar ve Llama 2’den bu yana nelerin değiştiğini keşfetmeye değerdir.
Llama 3, selefleri ve GPT serisi modeller gibi yalnızca kod çözücü (decoder-only) bir dönüştürücü (transformer) mimarisi kullanır. Bu, metin üreten modeller için en yaygın mimaridir. (Tersi tür olan yalnızca kodlayıcı (encoder-only) mimariler, kullanıcının sağladığı metni anlama veya sınıflandırma için kullanılır.)
Llama 3 duyurusu, model yapısında veya eğitim sürecinde radikal değişiklikler tanımlamıyor. Bunun yerine, yanıt kalitesi, yanıt hızı ve geliştirme arasındaki ödünleşimler etrafında birçok optimizasyon bulunuyor.
Metni belirteçlere dönüştürmek için kullanılan yeni bir belirteçleyici (tokenizer) daha verimlidir; bu nedenle istemler ve yanıtlar %15 daha az belirteç kaplar; bu da bağlam penceresine daha fazla metin sığabileceği anlamına gelir.
LLM’lerin çıktıyı üretmek için hangi kelime veya ifadelerin önemli olduğuna karar vermek için kullandığı teknik olan yeni bir dikkat (attention) mekanizması—grouped query attention—önceki mekanizmalara kıyasla çıktı kalitesi ile üretim hızı arasında daha iyi bir denge sunar.
Eğitim veri kümesi, Llama 2’de kullanılanın yedi katı büyüklüğünde ve dört kat daha fazla kod içeriyor. Genel olarak, eğitim verilerinde daha fazla kod bulunması, LLM’lerin kod üretmede daha iyi olacağı anlamına gelir.
İlginç bir şekilde, Llama 2 modeli, Llama 3’ün eğitim setine dahil edilecek verileri değerlendirmek ve sınıflandırmak için kullanıldı. Daha iyi bir yapay zekâ oluşturmak için yapay zekâdan yararlanma fikri, uzun süredir bilim kurgunun temel konularından biridir (Kâinatın Otostopçunun Galaksi Rehberi’nde bir olay örgüsü noktasıdır) ve artık uygulamaya konuyor.
Eğitim sonrası süreç de optimize edildi. Bir LLM oluşturulduktan sonra, bu "ham" LLM’nin performansı artırılmak üzere ayarlanabilir. Meta, Llama 3 sürecinin aşağıdaki teknikleri içerdiğini belirtiyor.
Bu sürümde bazı dikkat çekici eksikler vardı.
OpenAI’nin ChatGPT’si, GPT-4 metin yapay zekâsını DALL∙E 3 görsel yapay zekâsıyla birleştirir. Yani "çok modludur". Meta’nın duyurusu, Llama 3’ü çok modlu hale getirmenin yakın gelecek için bir hedef olduğunu öne sürüyor.
Llama 3 veri kümesinin %95 İngilizce metin içerdiği belirtiliyor. Bu da diğer diller için performansın çok daha zayıf olmasının beklendiği anlamına gelir. Çok modlu yapay zekâda olduğu gibi, Llama 3’ün çok dilli bir sürümü yol haritasında yer alıyor.
Duyuruda bahsedilmeyen bir teknik, uzman karışımı mimarisinin kullanılmasıydı. Bu teknikte bir LLM, daha dar görevlere uzmanlaşmış birkaç küçük LLM’den oluşur (örneğin, bir kod üretim LLM’si, bir belge özetleme LLM’si ve bir diyalog LLM’si). Bu yaklaşım, Mistral AI’ın Mixtral modelleriyle popülerleşti ve OpenAI’nin GPT-4’ünün temeli olduğu söylenir; parametre başına daha iyi performans sağlar. Yani, bu teknikle daha küçük (dolayısıyla daha ucuz ve daha hızlı) bir modelle aynı performansı elde edebilirsiniz. Meta bu teknikten bahsetmediğine (ve Llama 3 GitHub deposunda da anılmadığına) göre, bu yöntemin kullanılmadığını varsayabiliriz.
Meta’nın Baş Yapay Zekâ Bilimcisi Yann LeCun, yapay zekânın daha hızlı öğrenmek, karmaşık görevleri başarmak ve alışılmadık durumlara uyum sağlamak için dünyanın nasıl işlediğine dair içsel bir model geliştirdiği dünya modellerinin güçlü bir savunucusudur. Duyuruda bu radikal mimariden bahsedilmedi, dolayısıyla Llama 3’te bulunmadığı anlaşılıyor.
Llama 3’e kendi web sitesinden ve GitHub deposundan indirerek ulaşabilirsiniz. Facebook, Instagram, WhatsApp ve Messenger’daki Meta AI asistanını zaten çalıştırıyor; dolayısıyla bu platformlarda Meta AI’ı kullanarak dolaylı olarak Llama 3’ü deneyebilirsiniz.
AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM ve Snowflake ile entegrasyonların "yakında mevcut" olacağı vaat ediliyor; bu da Llama 3’e bu platformlar üzerinden erişmenize imkân sağlayacak.
Performansın üst segmentinde, büyük dil modelleri manzarasının son dönemdeki hikâyesi, Google Gemini Pro ve Cohere’in Command R+’ının yakın takibinde OpenAI’nin GPT-4’ü ile Anthropic’in Claude 3 Opus’unun üstünlük için mücadelesi oldu. Geliştirilmekte olan daha büyük boyutlu Llama 3 sürümünün zirve için bir aday olup olmayacağı henüz belli değil, ancak bu arada Meta, Llama 3’te kayda değer performans iyileştirmeleri elde etti.
Son birkaç yılda, (modelin ayrıntılarının kamuya açık olmadığı) kapalı modeller, daha açık modellere kıyasla daha iyi performans gösterdi. Bu nedenle, Llama 3’ün sıralamada 6. sıraya yerleşmiş olması önemli bir gelişmedir.
Meta’nın Llama için kısa vadeli ana hedefi, sosyal medya platformları için Meta AI akıllı asistanını çalıştırmaktır. Bu, LLM’lerini diğer şirketlerin yapay zekâ ürünlerinde kullanılmak üzere satmak isteyen OpenAI, Anthropic veya Cohere’den çok farklı bir iş modelidir. Bu bakımdan, kod üretme veya matematik problemlerini çözmeye yönelik performans kıyaslamaları şirket için çok da önemli olmayabilir.
Meta, milyarlarca kullanıcısının oluşturduğu sosyal gönderilerden oluşan benzersiz bir eğitim veri kümesine sahiptir ve—övünme hakkı bir yana—önemli olan tek performans metriği "LLama 3 sosyal medya kullanıcılarının ihtiyaçlarını yeterince karşılıyor mu?" sorusudur.
Bunun ötesinde, açık ağırlık yaklaşımı Llama 3’ün rakiplere göre potansiyel olarak daha ucuza çalıştırılabileceği anlamına gelir. Yapay zekâyı esasen ücretsiz sunarak, rakiplerinin API’leri için talep edebilecekleri fiyatlar üzerinde aşağı yönlü baskı oluşturur. Bu önemlidir; zira 2023’ün coşkulu iyimserliği ve sürekli artan üretken yapay zekâ performansı hayalleri, 2024’te yöneticilerin LLM özelliklerinin ne kadar pahalı olduğunu fark etmeye başlamasıyla daha temkinli bir döneme yerini bıraktı ve dolar başına performans öncelik listesinde üst sıralara çıktı.
Açık ağırlık modelleri, verilerin gizliliğinin hayati önemde olduğu durumlarda da önemlidir; örneğin finansal veriler, sağlık verileri veya kişisel olarak tanımlanabilir bilgiler kullanılırken. Bu tür son derece hassas verileri başka bir şirket tarafından barındırılan bir LLM’e iletmek (GPT ve diğer kapalı modellerde olduğu gibi) çoğu şirketin göze alamayacağı bir iş riski doğurur. Bu da hassas verileri LLM’den ayırmak için sohbet robotu veya başka bir yapay zekâ özelliği için daha karmaşık bir mimari kullanılmasını gerektirir. Llama 3 gibi açık ağırlık bir model, kuruluşun istediği yerde barındırılabildiğinden, veri gizliliğini korurken yapay zekâ ürün ve özellikleri oluşturmayı kolaylaştırır.
Llama 3, Llama 2’ye göre yinelemeli bir iyileştirme gibi görünüyor. Mimaride önemli değişiklikler veya büyük özellikler duyurulmadı.
Maliyet-performans ödünleşimlerine odaklanılması, Meta’nın büyük ölçekte ucuza çalıştırılabilecek bir yapay zekâyı hedeflediğini düşündürüyor. En heyecan verici haberler ekosistem ürünleri etrafındaydı: diğer geliştiricilerin yüksek kaliteli LLM’leri daha verimli şekilde oluşturmasına yardımcı olmak, Meta’nın açık yaklaşımının en önemli faydalarından biridir.
Eğer üretken yapay zekâ dünyasına adım atmak için sabırsızlanıyorsanız, AI Fundamentals yetkinlik yolumuz makine öğrenimi, derin öğrenme, NLP, üretken modeller ve daha fazlasında hız kazanmanıza yardımcı olacaktır. Ayrıca Llama 3’ün ince ayarı, Llama 3.1 ve Llama 3.2 hakkındaki kılavuzlarımızı da okuyabilirsiniz.
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



