Apa itu Llama 3?
Llama 3 adalah AI untuk pembuatan teks. Artinya, mirip dengan model GPT dari OpenAI dan Claude dari Anthropic, Anda menuliskan prompt teks, dan model akan menghasilkan respons teks. Model terbaru ini menjanjikan peningkatan performa, khususnya dalam pemahaman konteks yang lebih baik dan penalaran logis. Model Llama digunakan untuk mendayai Meta AI, asisten cerdas yang disertakan di Instagram, WhatsApp, Messenger, dan Facebook.
Llama 3 adalah model dengan "bobot terbuka". Artinya, model itu sendiri bersifat sumber terbuka, memberikan tingkat transparansi terkait bagaimana ia melakukan perhitungan. Meski begitu, detail lengkap untuk mereplikasinya, seperti himpunan data yang digunakan untuk melatihnya, tidak tersedia untuk publik.
Gambar 3 llama yang dibuat dengan Midjourney. Prompt yang digunakan: “A cartoon of 3 llamas happily frolicking in a field”
Kemampuan Baru Llama3
Llama 3 tersedia dalam dua ukuran: model dengan 8 miliar parameter dan 70 miliar parameter. Secara umum, semakin banyak parameter menghasilkan kualitas keluaran yang lebih baik, tetapi membuat model lebih lambat dan lebih mahal untuk dijalankan. 70 miliar parameter sebanding dengan banyak model pesaing, meskipun ada model yang berukuran parameter lebih besar. Model ketiga yang lebih besar dengan 400 miliar parameter diumumkan sedang dalam pengembangan.
Jendela konteks—jumlah teks yang dapat dipertimbangkan sekaligus—telah digandakan dari 4096 menjadi 8192 token. Token mengacu pada satu kata atau tanda baca, meski beberapa kata dipecah menjadi beberapa token. Dalam bahasa Inggris, empat token kira-kira setara dengan tiga kata, sehingga jendela konteks baru setara sekitar 15 halaman teks (dengan 400 kata per halaman). Meski peningkatan ini disambut baik, masih jauh dari batas terdepan, sebab model Claude 3 menawarkan jendela konteks 200.000 token.
Fitur-fitur lain dari model ini tidak dijelaskan dalam artikel pengumuman. Sebaliknya, banyak fokus diarahkan pada ekosistem perangkat lunak di sekitarnya.
Ekosistem Llama 3
Bersamaan dengan pengumuman Llama3, Meta memperkenalkan serangkaian alat untuk memudahkan dan mengamankan pekerjaan dengan Llama. Berikut gambaran singkatnya.
Llama Guard 2
Llama Guard 2 adalah alat LLM untuk mengklasifikasikan teks sebagai "aman" atau "tidak aman." Dapat digunakan baik untuk prompt maupun respons. Misalnya, alat ini dapat mendeteksi apakah teks mengandung deskripsi kekerasan, ujaran kebencian, atau konten tidak pantas lainnya.
Contoh kasus penggunaan adalah chatbot. Anda dapat memeriksa setiap prompt, dan jika konten ditandai tidak aman, Anda kemudian memberikan peringatan atau metode lain untuk menangani konten bermasalah tersebut. Demikian pula, jika chatbot menghasilkan respons yang ditandai tidak aman, Anda dapat mencegatnya dan mencoba lagi sebelum pengguna melihatnya.
Selain bendera aman/tidak aman, respons dari Llama Guard 2 diberi label keamanan—salah satu dari sebelas kategori konten tidak pantas berdasarkan Taksonomi Keamanan AI MLCommons.
Llama Code Shield
Llama Code Shield mengklasifikasikan kode sebagai aman atau tidak aman. Dengan banyak pengembang perangkat lunak yang memanfaatkan LLM untuk membantu menulis kode, ada risiko kode tidak aman dihasilkan dan disertakan dalam produksi. Alat ini dirancang untuk diintegrasikan ke asisten pengodean AI dan ke alat lain seperti VSCode dan DataLab.
CyberSec Eval 2
CyberSec Eval 2 memungkinkan Anda mengevaluasi seberapa aman sebuah LLM. CyberSec Eval versi awal memungkinkan Anda mengevaluasi keamanan pembuatan kode dan perlindungan dari serangan siber. Versi terbaru membangunnya lebih lanjut, dengan fitur untuk menilai kerentanan terhadap injeksi prompt, kapabilitas ofensif siber otomatis, dan kecenderungan menyalahgunakan code interpreter.
torchtune
torchtune adalah paket Python yang bekerja bersama kerangka pembelajaran mendalam PyTorch untuk memudahkan pengembangan LLM Anda sendiri. Tersedia alat untuk empat tugas.
- Membuat model baru dari blok bangunan berdasarkan LLM yang ada
- Fine-tuning LLM menggunakan teknik seperti LoRA dan QLoRA
- Mengonfigurasi pengaturan untuk pelatihan, kuantisasi, dan evaluasi model
- Templat prompt dan integrasi dataset untuk pelatihan yang lebih mudah diakses
torchtune terintegrasi dengan platform machine learning populer seperti Hugging Face, Weights & Biases, EleutherAI, dan Executorch.
Apa Saja Kasus Penggunaan Llama 3?
Kasus penggunaan Llama 3 sama dengan Llama 2 dan LLM lainnya. Penggunaan umum meliputi hal-hal berikut.
- Chatbot: Mengotomatiskan layanan pelanggan, dukungan, dan keterlibatan melalui agen percakapan.
- Ringkasan Dokumen: Merangkum dokumen panjang menjadi versi yang lebih singkat dengan menyoroti poin-poin utama, berguna dalam konteks hukum, akademik, dan bisnis.
- Pembuatan Konten: Menghasilkan artikel, laporan, blog, dan bahkan karya kreatif seperti puisi dan cerita.
- Bantuan Email dan Komunikasi: Mengotomatiskan penyusunan email, tanggapan, dan komunikasi rutin lainnya.
- Deskripsi Produk: Secara otomatis menghasilkan deskripsi produk yang unik dan menarik untuk situs e-niaga.
- Alat Pendidikan: Membuat panduan belajar, soal ujian, dan konten edukasi yang disesuaikan dengan tingkat pembelajaran siswa.
- Pemrograman dan Pembuatan Kode: Membantu pengembang dengan menghasilkan potongan kode, men-debug kode yang ada, atau memberikan rekomendasi pemrograman.
- Laporan Analisis Data: Merangkum temuan data dan menghasilkan laporan dari input data terstruktur.
- Asisten Virtual: Mendayai aplikasi asisten pribadi yang mengelola jadwal, menjawab pertanyaan, dan melakukan tugas.
Bagaimana Performa Llama 3 Dibandingkan?
Pengumuman Meta menampilkan hasil benchmark untuk versi Llama 3 dengan delapan miliar (8B) dan tujuh puluh miliar (70B) parameter dibandingkan dengan dua model lainnya.
Benchmark berikut digunakan.
- Massive Multitask Language Understanding (MMLU). Tugas pada matematika dasar, sejarah AS, ilmu komputer, hukum, dan lainnya. Untuk mencapai akurasi tinggi pada tes ini, model harus memiliki pengetahuan dunia yang luas dan kemampuan pemecahan masalah.
- Graduate-Level Google-Proof Q&A (GPQA). Pertanyaan pilihan ganda yang ditulis oleh pakar domain di biologi, fisika, dan kimia. Pertanyaannya berkualitas tinggi dan sangat sulit: pakar dengan atau yang tengah menempuh PhD di bidang terkait mencapai akurasi 74%.
- HumanEval. Uji kebenaran fungsional kode komputer, digunakan untuk memeriksa pembuatan kode.
- GSM-8K. Soal cerita matematika tingkat sekolah dasar yang berkualitas tinggi dan beragam secara linguistik.
- MATH. Soal matematika tingkat SMP dan SMA.
Model Llama 3 8B dibandingkan dengan Gemma 7B It dari Google dan Mistral 7B Instruct. Ini adalah LLM yang ukurannya sebanding (jumlah parameter serupa), merupakan model bobot terbuka yang tersedia di platform Hugging Face, dan ditujukan untuk kasus penggunaan yang serupa. Hasilnya ditunjukkan pada Gambar 1.
Llama 3 8B dengan nyaman melampaui dua model lainnya pada kelima benchmark.
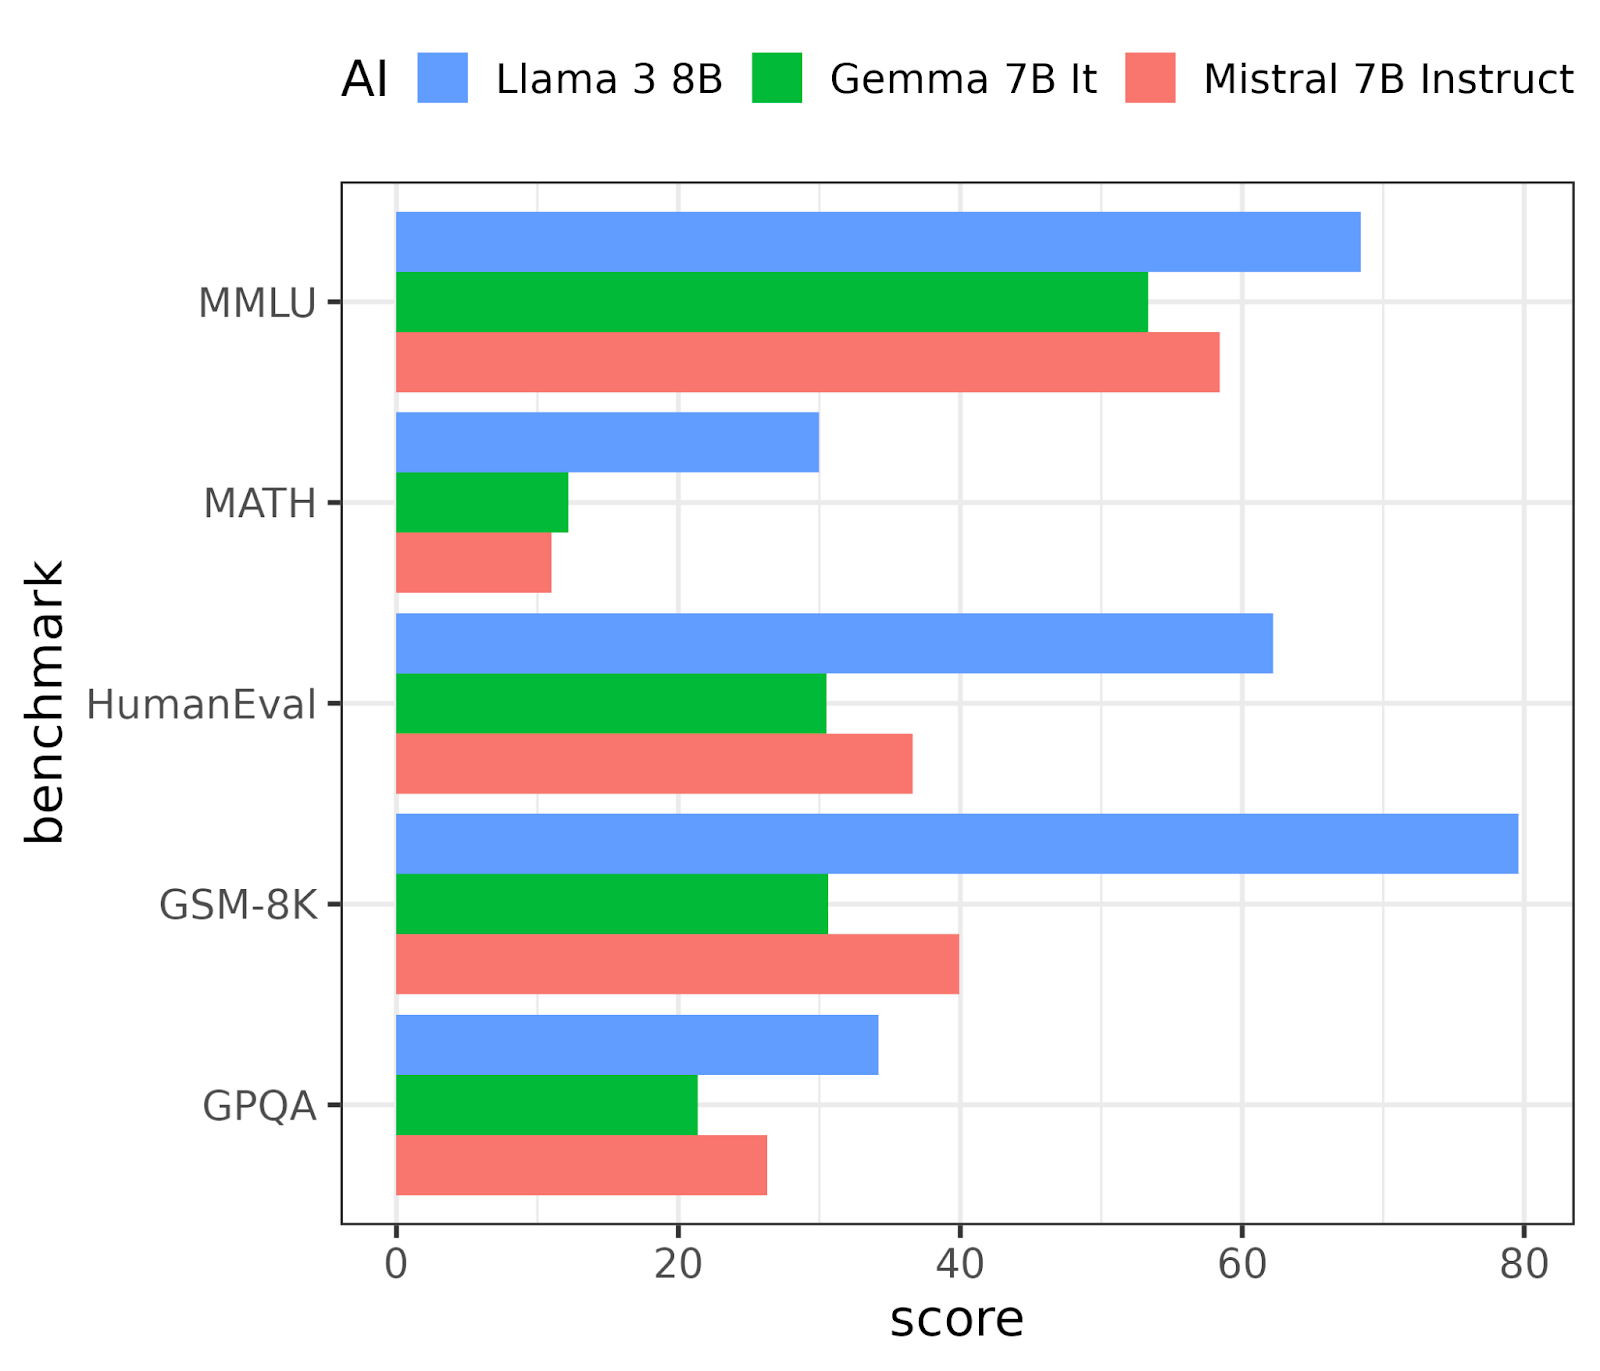
Gambar 1. Performa Llama 3 8B dibanding dua model sebanding pada 5 benchmark LLM.
Llama 3 70B dibandingkan dengan Gemini Pro 1.5 dari Google DeepMind dan Claude 3 Sonnet dari Anthropic. Ini adalah model yang mendekati batas terdepan, meski bukan yang performanya paling tinggi (gelar itu saat ini diperebutkan antara GPT-4 Turbo milik OpenAI dan Claude 3 Opus milik Anthropic). Hasilnya ditunjukkan pada Gambar 2.
Di sini, performanya hampir seri pada tiga benchmark. Llama 3 80B menang pada benchmark HumanEval untuk pembuatan kode dan berada di posisi kedua setelah Gemini Pro 1.5 pada benchmark MATH.
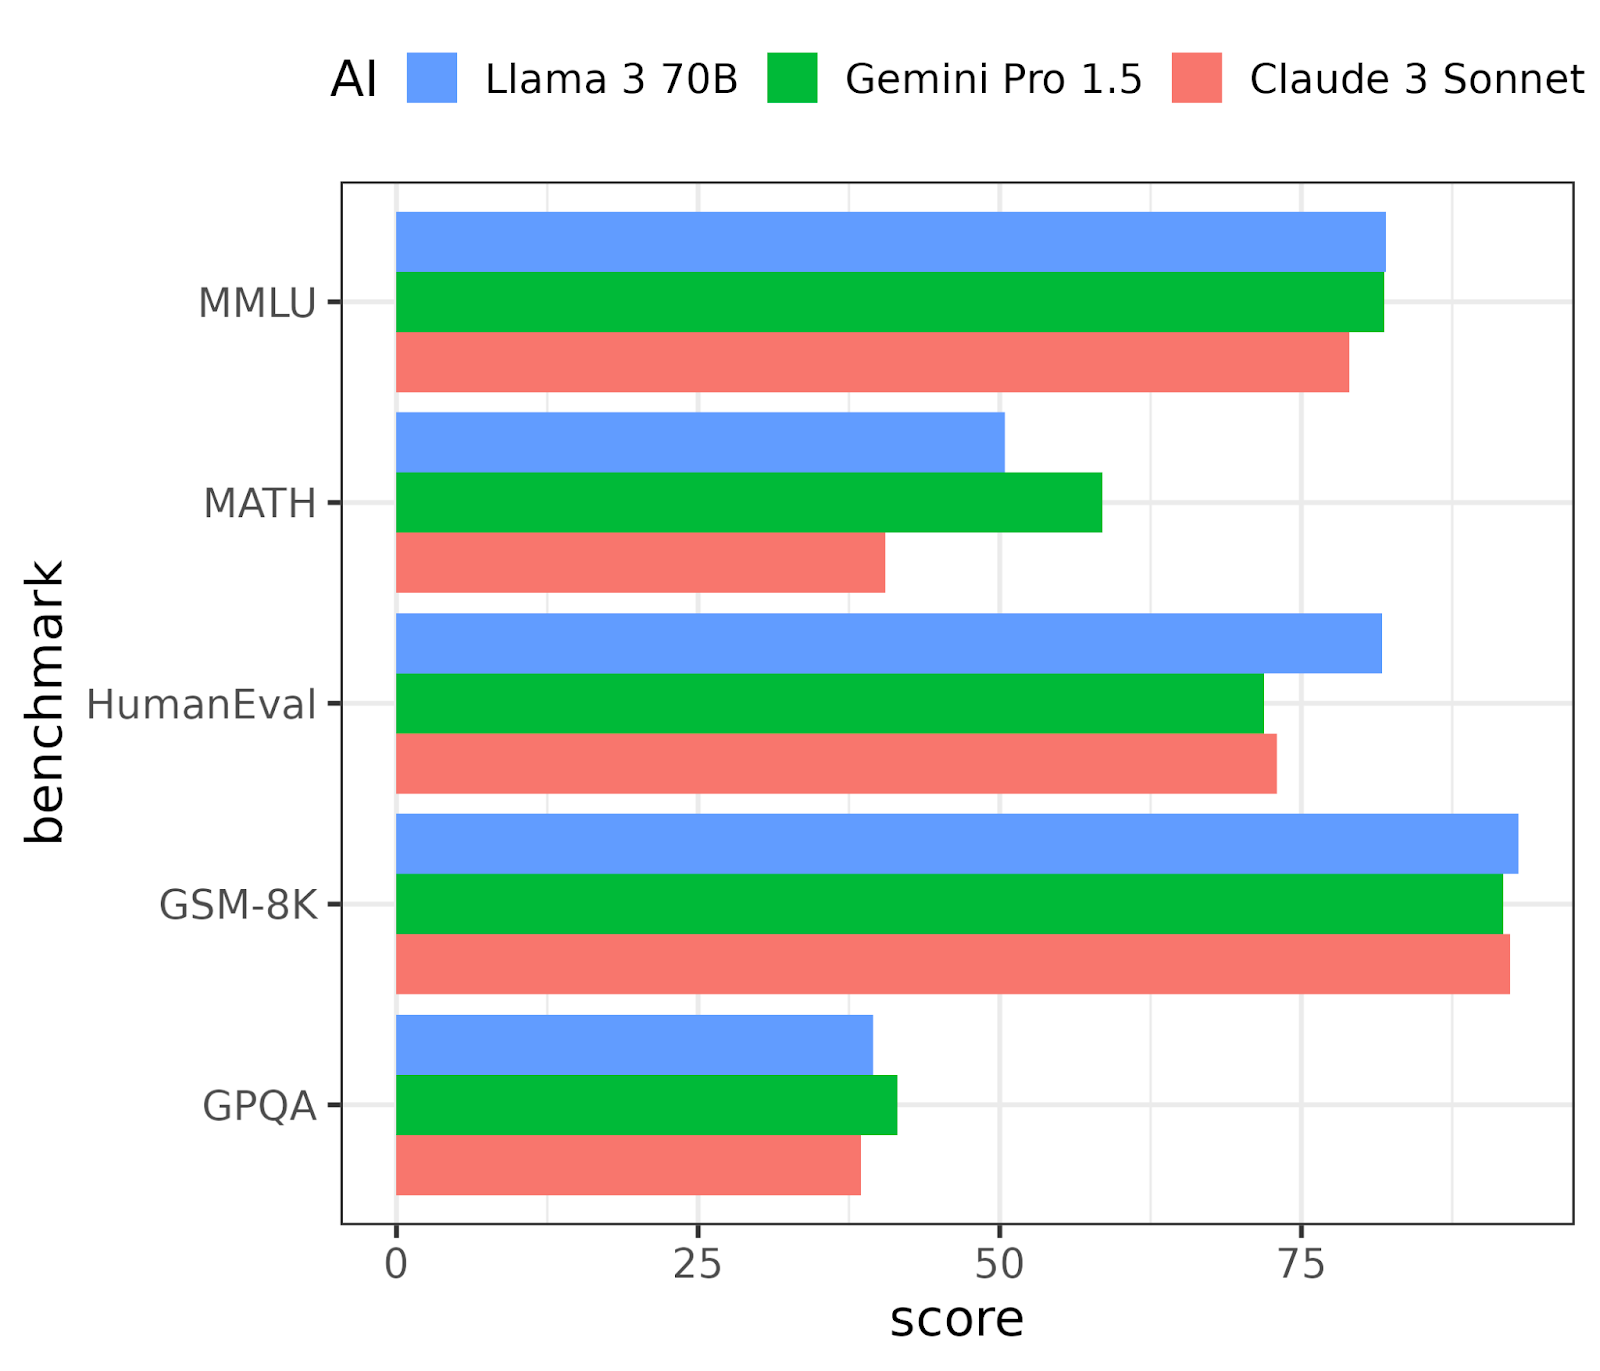
Gambar 2. Performa Llama 3 70B dibanding dua model sebanding pada 5 benchmark LLM.
Menafsirkan hasil benchmark
Ada lebih dari lima benchmark: Llama 3 dibandingkan pada 15 benchmark, tetapi hanya hasil untuk lima yang ditampilkan dalam pengumuman. Demikian pula, ada jauh lebih banyak pilihan LLM untuk dibandingkan. Tidak jelas seberapa banyak cherry-picking yang dilakukan Meta saat menyajikan hasil.
Kedua, kualitas keluaran hanyalah satu ukuran performa. Waktu dan biaya untuk menghasilkan respons juga penting dan tidak dibahas dalam pengumuman.
Ketiga, performa akan selalu bervariasi menurut kasus penggunaan, jadi Anda perlu mencobanya pada masalah Anda sendiri dengan perangkat keras Anda untuk mendapatkan hasil yang akurat bagi kasus penggunaan Anda.
Peringkat Chatbot Arena
Dalam beberapa hari sejak pengumuman Meta, performa Llama 3 muncul di LMSYS Chatbot Arena Leaderboard, peringkat publik untuk LLM. Llama 3 70B saat ini berada di peringkat ke-6, peringkat tertinggi di antara LLM bobot terbuka mana pun. (Masih di bawah berbagai versi OpenAI GPT-4, Anthropic Claude 3 Opus, dan Google Gemini Pro.) Sementara itu, Llama 3 8B berada di posisi ke-14.
Ini adalah lonjakan peringkat yang patut dicatat, dan layak ditelusuri apa yang berubah sejak Llama 2.
Bagaimana Llama 3 Bekerja?
Llama 3 menggunakan arsitektur transformer dekoder-saja, seperti pendahulunya dan seri model GPT. Ini adalah arsitektur yang paling umum untuk model yang menghasilkan teks. (Kebalikannya, arsitektur encoder-saja, digunakan untuk memahami atau mengklasifikasikan teks yang diberikan pengguna.)
Pengumuman Llama 3 tidak menjelaskan perubahan radikal pada struktur model atau proses pelatihan. Sebaliknya, ada banyak optimisasi terkait kompromi antara kualitas respons, kecepatan respons, dan pengembangan.
Tokenizer baru, yang digunakan untuk mengonversi teks menjadi token, lebih efisien, sehingga prompt dan respons membutuhkan 15% lebih sedikit token, yang berarti lebih banyak teks dapat masuk ke dalam jendela konteks.
Mekanisme attention baru—teknik yang digunakan LLM untuk memutuskan kata atau frasa mana yang penting untuk menghasilkan keluaran—yang disebut grouped query attention, memberikan kompromi yang lebih baik antara kualitas keluaran dan kecepatan generasi dibanding mekanisme sebelumnya.
Dataset pelatihan tujuh kali lebih besar daripada yang digunakan untuk Llama 2, dengan empat kali lebih banyak kode. Secara umum, semakin banyak kode dalam data pelatihan, LLM akan semakin baik dalam menghasilkan kode.
Menariknya, model Llama 2 digunakan untuk mengevaluasi dan mengklasifikasikan data yang akan dimasukkan ke dalam himpunan pelatihan Llama 3. Penggunaan AI untuk menciptakan AI yang lebih baik lagi telah lama menjadi tema fiksi ilmiah (ini peranti plot di Hitchhiker's Guide to the Galaxy) dan kini mulai dipraktikkan.
Proses pasca-pelatihan juga dioptimalkan. Setelah sebuah LLM dibuat, LLM "mentah" tersebut dapat dituning untuk meningkatkan performanya. Meta mencatat bahwa proses Llama 3 mencakup teknik-teknik berikut.
- Supervised fine-tuning, sebuah teknik pembelajaran mesin terawasi di mana pasangan prompt dan jawaban berkualitas tinggi digunakan untuk memberikan contoh keluaran yang baik.
- Rejection sampling, di mana beberapa keluaran dihasilkan dan diberi peringkat, lalu yang terburuk ditolak.
- Teknik pembelajaran penguatan Direct Policy Optimization dan Proximal Policy Optimization, di mana model diberi ganjaran untuk respons yang baik.
Apa yang tidak disertakan?
Ada beberapa hal menonjol yang absen dari rilis ini.
Tanpa AI Multimodal
ChatGPT milik OpenAI menggabungkan AI teks GPT-4 dengan AI gambar DALL∙E 3. Artinya, ia bersifat "multimodal". Pengumuman Meta menyiratkan bahwa membuat Llama 3 menjadi multimodal adalah tujuan dalam waktu dekat.
Tanpa AI Multibahasa
Dataset Llama 3 digambarkan berisi 95% teks berbahasa Inggris. Artinya, performanya diperkirakan jauh lebih lemah untuk bahasa lain. Seperti halnya AI multimodal, versi multibahasa Llama 3 ada dalam peta jalan.
Tanpa Mixture of Experts
Salah satu teknik yang tidak disebutkan dalam pengumuman adalah penggunaan arsitektur mixture of experts. Dengan teknik ini, sebuah LLM terdiri dari beberapa LLM yang lebih kecil yang mengkhususkan diri pada tugas yang lebih sempit (misalnya, LLM pembuatan kode, LLM peringkasan dokumen, dan LLM dialog). Teknik ini dipopulerkan oleh model Mixtral milik Mistral AI dan dirumorkan menjadi dasar GPT-4 milik OpenAI, yang memberikan performa lebih baik per parameter. Artinya, Anda bisa mendapatkan performa yang sama dengan model yang lebih kecil (dan karenanya lebih murah serta lebih cepat) dengan menggunakan teknik ini. Karena Meta tidak menyebutkan teknik ini (dan tidak ada penyebutan dalam repositori GitHub Llama 3), kita dapat berasumsi bahwa metode ini tidak digunakan.
Tanpa World Model
Chief AI Scientist Meta, Yann LeCun, merupakan pendukung kuat world models, di mana AI mengembangkan model internal tentang bagaimana dunia bekerja untuk belajar lebih cepat, menyelesaikan tugas kompleks, dan beradaptasi pada situasi yang tidak familiar. Tidak ada penyebutan arsitektur radikal ini dalam pengumuman, sehingga tampaknya tidak ada dalam Llama 3.
Di Mana Saya Bisa Mengakses Llama 3?
Llama 3 tersedia untuk diunduh dari situs webnya dan repositori GitHub-nya. Model ini sudah mendayai asisten Meta AI di Facebook, Instagram, WhatsApp, dan Messenger, sehingga Anda dapat mencoba Llama 3 secara implisit dengan menggunakan Meta AI di platform tersebut.
Integrasi dengan AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM, dan Snowflake dijanjikan akan "segera tersedia", memungkinkan Anda mengakses Llama 3 melalui platform-platform tersebut.
Apakah Llama 3 Penting?
Di tingkat performa tertinggi, kisah terbaru lanskap model bahasa besar adalah pertarungan antara GPT-4 milik OpenAI dan Claude 3 Opus milik Anthropic untuk memperebutkan supremasi, dengan Google Gemini Pro dan Command R+ milik Cohere membuntuti. Masih harus dilihat apakah versi Llama 3 yang berukuran lebih besar dan sedang dikembangkan akan menjadi pesaing untuk mahkota itu, tetapi sementara itu, Meta telah mencapai peningkatan performa yang substansial pada Llama 3.
Dalam beberapa tahun terakhir, model tertutup (di mana detail model tidak tersedia untuk publik) mengungguli model yang lebih terbuka. Fakta bahwa Llama 3 menempati peringkat ke-6 karenanya merupakan hal besar.
Tujuan jangka pendek utama Meta untuk Llama hanyalah untuk mendayai asisten cerdas Meta AI bagi platform media sosialnya. Ini adalah model bisnis yang sangat berbeda dengan OpenAI, Anthropic, atau Cohere, yang ingin menjual LLM mereka untuk digunakan dalam produk AI perusahaan lain. Dalam hal ini, benchmark performa untuk pembuatan kode atau pemecahan soal matematika mungkin tidak terlalu penting bagi perusahaan.
Meta memiliki himpunan data pelatihan unik berupa unggahan sosial yang dibuat oleh miliaran penggunanya, dan—di luar gengsi—satu-satunya metrik performa yang penting adalah "Apakah LLama 3 cukup memenuhi kebutuhan pengguna media sosial?"
Selain itu, pendekatan bobot terbuka berarti Llama 3 berpotensi lebih murah untuk dijalankan dibanding pesaing. Dengan pada dasarnya membagikan AI tersebut, Meta menekan harga yang dapat dikenakan pesaing untuk API mereka. Ini penting, karena optimisme tinggi di tahun 2023 dan mimpi tentang performa generatif AI yang terus meningkat telah berganti menjadi 2024 yang lebih realistis ketika para eksekutif mulai menyadari betapa mahalnya fitur LLM, dan performa per dolar menjadi prioritas tinggi.
Model bobot terbuka juga penting dalam situasi di mana privasi data sangat utama, misalnya saat menggunakan data keuangan, data layanan kesehatan, atau informasi yang dapat mengidentifikasi pribadi. Mengirimkan data yang sangat sensitif seperti itu ke LLM yang di-host oleh perusahaan lain (seperti pada GPT dan model tertutup lainnya) menimbulkan risiko bisnis yang tidak bersedia diambil sebagian besar perusahaan. Ini berarti harus menggunakan arsitektur yang lebih berbelit untuk chatbot atau fitur AI lainnya guna memisahkan data sensitif dari LLM. Model bobot terbuka seperti Llama 3 dapat di-host di mana pun organisasi menginginkan, sehingga lebih mudah membuat produk dan fitur AI sambil tetap menjaga privasi data.
Penutup
Llama 3 tampak sebagai peningkatan iteratif atas Llama 2. Tidak ada perubahan signifikan yang diumumkan pada arsitektur, dan tidak ada fitur besar yang diumumkan.
Fokus pada kompromi biaya-performa menunjukkan bahwa Meta menargetkan AI yang dapat dijalankan secara murah dalam skala besar. Kabar paling menarik ada pada produk-produk ekosistem: membantu pengembang lain menciptakan LLM berkualitas tinggi dengan lebih efisien adalah salah satu manfaat terpenting dari pendekatan terbuka Meta.
Jika Anda ingin segera mulai menekuni dunia generative AI, alur keterampilan AI Fundamentals kami akan membantu Anda memahami machine learning, deep learning, NLP, model generatif, dan banyak lagi. Anda juga dapat membaca panduan kami tentang fine-tuning Llama 3, Llama 3.1, dan Llama 3.2.




