
Cursus
Supervised Learning met scikit-learn
4 uur
308.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleNVIDIA's cuML is een door GPU's versnelde machine learning-bibliotheek die deel uitmaakt van het RAPIDS AI-ecosysteem. En nu, in open bèta, maakt cuML 25.02 het mogelijk om GPU-versnelling te gebruiken in scikit-learn, UMAP en HDBSCAN zonder je Python-code aan te passen. Dit is erg interessant nieuws voor Python machine learning engineers, data- en onderzoekswetenschappers, developers en nog veel meer professionals die uitkijken naar betere prestaties van hun modellen.
Geen paniek als je nog niet helemaal mee bent met cuML of zelfs het idee van GPU-versnelling. Ik neem je mee op tour en aan het eind van dit artikel kun je GPU-versnelling inzetten voor je regressie, classificatie, dimensiereductie of clustering.
Laten we kort alle puzzelstukjes op de juiste plek leggen.
NVIDIA ontwikkelt geavanceerde technologieën die high-performance computing, AI en data science aandrijven. Misschien herinner je je dat ze veel in het nieuws waren toen Deepseek Deepseek-R1 lanceerde en men zich afvroeg of Deepseek NVIDIA-chips gebruikte.
Nu staat NVIDIA opnieuw in het nieuws, dit keer vanwege innovaties in het RAPIDS AI-ecosysteem. RAPIDS AI, als je het nog niet kent, is een opensource-suite van GPU-versnelde bibliotheken die zijn ontworpen om data science- en machine learning-workflows te versnellen. RAPIDS is gebouwd op CUDA (Compute Unified Device Architecture), een platform voor parallelle computing en een API-model, eveneens ontwikkeld door NVIDIA. RAPIDS GPU-versnelde bibliotheken omvatten:
Dan nu cuML: cuML biedt sterk geoptimaliseerde implementaties van klassieke machine learning-algoritmen. Omdat NVIDIA de beste AI-chips heeft, krijgen deze algoritmen, die op NVIDIA GPU's draaien, een aanzienlijke snelheidswinst. GPU's, in tegenstelling tot CPU's, blinken uit in parallelle verwerking, wat praktisch betekent dat ze duizenden berekeningen tegelijk kunnen uitvoeren—ideaal voor taken zoals (je raadt het al) deep learning en machine learning.
Als je scikit-learn niet kent en je bent serieus bezig met machine learning en data science, schrijf je dan zeker in voor onze cursus Supervised Learning with scikit-learn. Ik zeg dit omdat scikit-learn de nummer één bibliotheek is voor tabeldata in de populairste programmeertaal voor machine learning. Bovendien is scikit-learn vrij eenvoudig te leren, heeft het een simpele API en werkt het goed samen met pandas en NumPy. Het is dus geen verrassing dat het RAPIDS AI-team zich strategisch en logisch richt op scikit-learn-algoritmen.
NVIDIA en cuML bieden nu de grote innovatie voor scikit-learn—en ook UMAP en HDBSCAN—van een enorme snelheidsboost. Volgens het RAPIDS AI-team betekent dit tot 50x sneller bij gebruik van scikit-learn, 60x voor UMAP en 175x voor HDBSCAN.
Mijn vuistregel-rekenwerk zegt dat een algoritme dat vijf minuten nodig heeft in scikit-learn theoretisch kan worden teruggebracht tot slechts zes seconden. Dat is een groot verschil. Ik kom hier verderop bij de benchmarks nog op terug.
Als dit allemaal ingewikkeld klinkt, geen zorgen. RAPIDS AI streeft ernaar nul codewijzigingen aan de API-code voor scikit-learn te vereisen. Echt waar, je hoeft alleen de extensie te laden, zo:
%load_ext cuml.accel
$ python -m cuml.accel script.pyDit is geen grote wijziging in de workflow die je gewend bent—precies de bedoeling. Soms moet je misschien de kernel herstarten en de extensie opnieuw laden.
Dit aspect van nul codewijzigingen is, naar mijn mening, op het eerste gezicht een heel spannende claim. Het idee is dat je je al gemaakte scikit-learn-scripts niet hoeft te veranderen—niet de eerste keer, maar ook later niet. cuML zou compatibele componenten automatisch versnellen op NVIDIA GPU's, maar als er iets in je code gebeurt dat niet compatibel is met de GPU's van NVIDIA, valt je script terug op de ‘normale’ CPU-uitvoering. Jij, als coder, ziet gewoon het resultaat en hoeft je niet druk te maken over foutafhandeling of iets anders.
Dat gezegd hebbende, ik verwacht nog steeds randgevallen die aanpassingen vereisen. Bij programmeren kan er van alles misgaan en niets is ooit zo makkelijk als het lijkt. De referentiedocumentatie noemt een aantal zaken die de ‘geen codewijzigingen’-claim wat nuanceren, of er op z'n minst wat wrijving aan toevoegen. Je moet lijsten converteren naar NumPy-arrays of pandas DataFrames, en stringlabels worden niet ondersteund, dus gebruikers moeten categorische labels vooraf encoderen. Misschien doe je dat soort dingen sowieso al, maar het punt is dat je naast het laden van de extensie ook andere gewoontes moet aanleren.
Als je basisstatistiek oefent met een simpele lineaire regressie op de mtcars-dataset, heeft het weinig zin om GPU-versnelling te gebruiken om de richtingscoëfficiënt en intercept een fractie sneller te vinden. Het besparen van milliseconden is het laden van de extensie nauwelijks waard. Maar draai je een complexer algoritme, dan telt de tijdswinst echt—om twee hoofdredenen.
Ten eerste is de bespaarde tijd significant voor veel workflows. Ik noemde dat een snelheidsboost tot 50x hypothetisch neerkomt op het terugbrengen van vijf minuten traintijd naar zes seconden. Dat is bijna vijf minuten winst. Maar bekijk de workflow van een machine learning engineer, waar het model mogelijk meerdere keren gedraaid moet worden om het goed te krijgen. Bij elkaar opgeteld gaat het besparen van tijd per run over de totale productiviteit van een data scientist.
Ten tweede—en hiermee samenhangend—kun je nu complexere modellen proberen. In het vorige voorbeeld gaan we uit van een tijdswinst voor een model met hetzelfde nauwkeurigheidsniveau. Maar wat als je denkt dat je met een complexer model juist hogere nauwkeurigheid haalt? Stel je een grid search voor met verschillende modelparameters en trainingsrondes. (Ik probeer hieronder mijn eigen mini-voorbeeld.) De permutaties groeien exponentieel, waardoor de rekenkosten op een CPU onpraktisch worden. Maar dat is minder een probleem met een 50x snelheidsboost.
Deze voordelen gaan hand in hand. Als je je project goed opzet, kun je een nauwkeuriger model krijgen dat ook sneller wordt geproduceerd of—zoals een machine learning engineer het zou zien—een geavanceerdere modelarchitectuur zonder buitensporige trainingstijden.
NVIDIA benadrukt dat de GPU's numeriek equivalente resultaten opleveren. Dat is goed om te horen, want het betekent dat de voordelen niet ten koste gaan van de modelnauwkeurigheid.
Maar ik vroeg me ook af: waarom zijn de resultaten numeriek equivalent en niet identiek? Waarschijnlijk zorgen parallelle verwerking en kleine numerieke stabiliteitsverschillen in een methode voor minuscule afwijkingen in de output. Misschien is bij UMAP de projectie net iets anders. Ik noem dit zodat je niet schrikt als je subtiele verschillen ziet tussen een CPU- en GPU-run. NVIDIA lijkt te suggereren dat je dat kunt verwachten en dat het normaal is.
Hoe dan ook, als je jezelf echt uitdaagt en een model op GPU's draait omdat het zo complex is dat CPU's praktisch niet werken, wordt het lastig om de output met een CPU-equivalent te vergelijken.
Ik noemde eerder dat er in deze cuML 25.02-release nu ondersteuning is voor scikit-learn, UMAP en HDBSCAN. Maar als je scikit-learn kent, weet je dat er heel veel verschillende algoritmen zijn. Momenteel ondersteunt RAPIDS AI een aantal van de bibliotheken, maar niet allemaal. Dit zijn de belangrijkste volgens het team:
In deze lijst ben ik zelf het meest enthousiast over een snelheidsboost bij k-Nearest Neighbors, dat bekendstaat als zwaar rekenintensief omdat je afstanden tussen alle datapunten moet berekenen.
De volgende tabel laat de estimators zien die grotendeels of volledig met cuML draaien.
| Algoritme | Bibliotheek / Functienaam | Categorie |
|---|---|---|
| UMAP | umap.UMAP |
Dimensiereductie |
| PCA (Principal Component Analysis) | sklearn.decomposition.PCA |
Dimensiereductie |
| Truncated SVD | sklearn.decomposition.TruncatedSVD |
Dimensiereductie |
| t-SNE | sklearn.manifold.TSNE |
Dimensiereductie |
| HDBSCAN | hdbscan.HDBSCAN |
Clustering |
| K-Means | sklearn.cluster.KMeans |
Clustering |
| DBSCAN | sklearn.cluster.DBSCAN |
Clustering |
| Random Forest Classifier | sklearn.ensemble.RandomForestClassifier |
Classificatie |
| Logistic Regression | sklearn.linear_model.LogisticRegression |
Classificatie |
| K-Nearest Neighbors Classifier | sklearn.neighbors.KNeighborsClassifier |
Classificatie |
| Random Forest Regressor | sklearn.ensemble.RandomForestRegressor |
Regressie |
| Lineaire regressie | sklearn.linear_model.LinearRegression |
Regressie |
| Elastic Net | sklearn.linear_model.ElasticNet |
Regressie |
| Ridge-regressie | sklearn.linear_model.Ridge |
Regressie |
| Lasso-regressie | sklearn.linear_model.Lasso |
Regressie |
| Kernel Ridge-regressie | sklearn.kernel_ridge.KernelRidge |
Regressie |
| K-Nearest Neighbors Regressor | sklearn.neighbors.KNeighborsRegressor |
Regressie |
| Nearest Neighbors Search | sklearn.neighbors.NearestNeighbors |
Zoeken naar naaste buren |
Een volledige lijst met ondersteunde methoden is te vinden in de RAPIDS AI-documentatie. We verwachten dat er snel meer algoritmen worden toegevoegd. (Je kunt ook feedback geven om het team te helpen prioriteren.) Enkele die mij opvielen als ontbrekend: support vector regressor (sklearn.svm.SVR), Theil-Sen Regressor (sklearn.linear_model.TheilSenRegressor), mean shift-clustering (sklearn.cluster.MeanShift) en multidimensionale schaling (sklearn.manifold.MDS).
Je vraagt je misschien af hoe dit allemaal werkt. Op 30.000 voet: moderne bibliotheken worden steeds vaker zo ontworpen dat ze automatisch de beste beschikbare hardware detecteren en gebruiken, of dat nu een CPU of een GPU is. We zien nu dat, wanneer een functie in scikit-learn wordt aangeroepen (als cuml.accel is ingeschakeld), de software controleert of er een compatibele GPU beschikbaar is en de uitvoering ernaartoe omleidt als dat zo is.
RAPIDS AI noemt dit mechanisme om cuml.accel zich als sklearn te laten gedragen een compatibiliteitslaag. In dit geval laat de compatibiliteitslaag van cuML scikit-learn-code zonder wijzigingen op NVIDIA GPU's draaien. Het is gebouwd als een drop-in-vervanging, fungeert als proxy, onderschept functieaanroepen naar scikit-learn en leidt ze door naar cuML.
Het RAPIDS AI-team van NVIDIA deelt een handige graphic die ik hier ook laat zien:
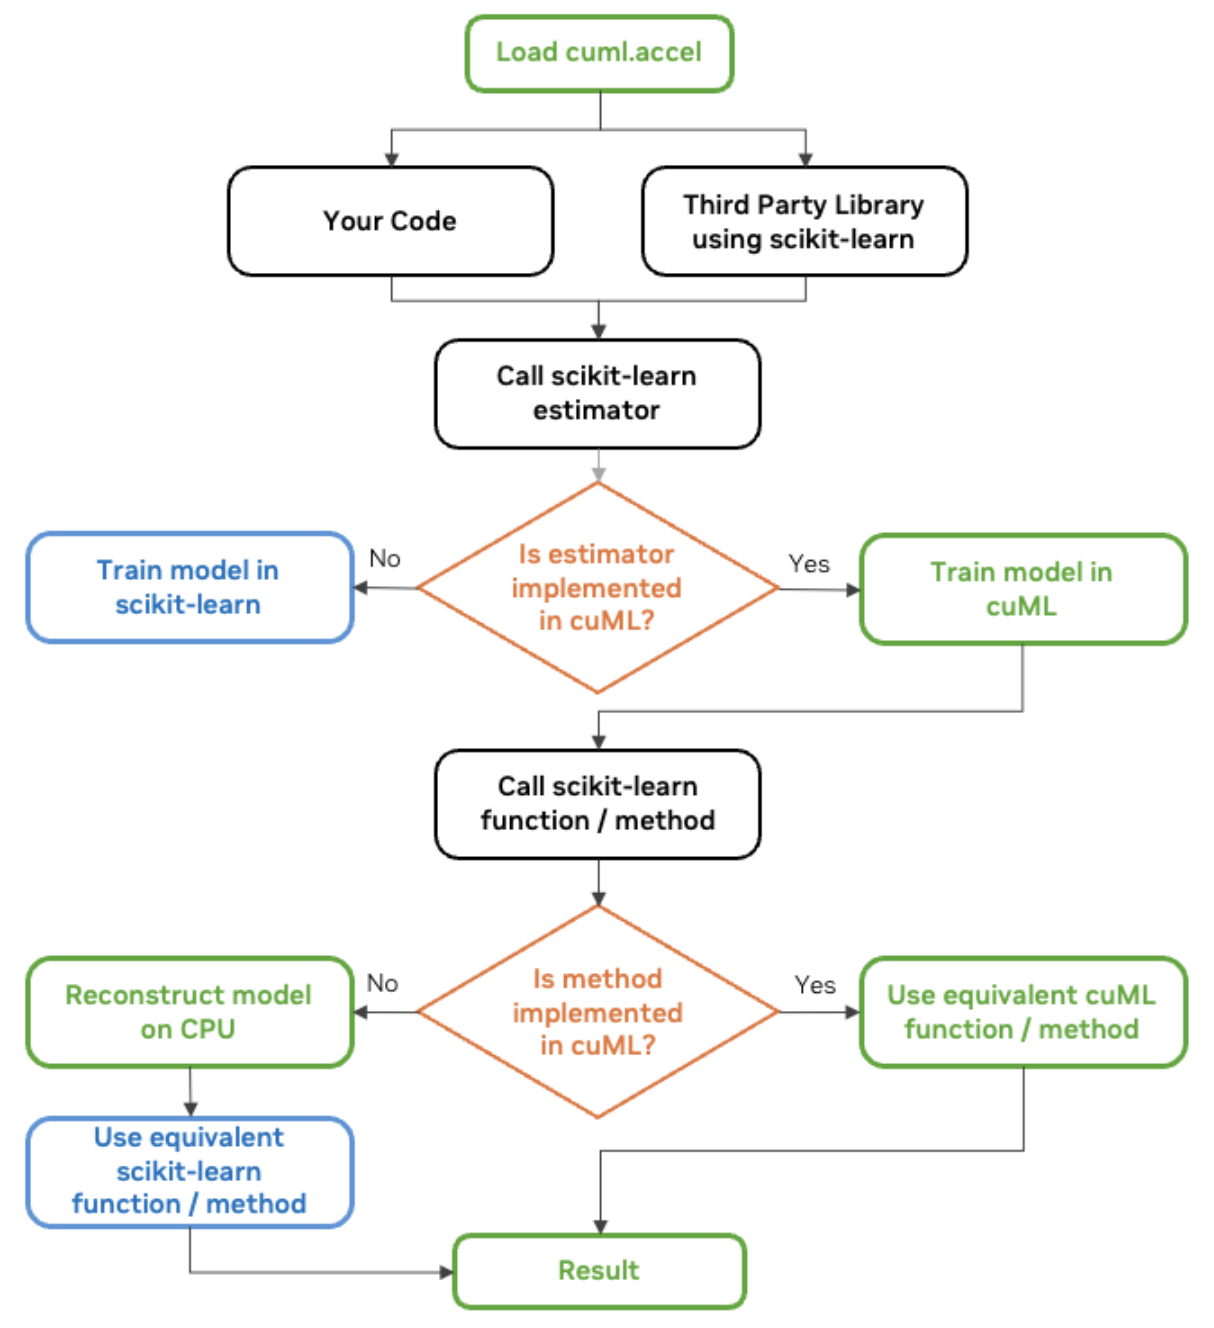
cuML scikit-learn-workflowdiagram. Bron: NVIDIA
cuML is al vooraf geïnstalleerd in Google Colab, maar gebruik je een Jupyter-notebook, activeer het dan met dit commando voordat je scikit-learn importeert:
%load_ext cuml.accel
import sklearn
Onze Python-code met sklearn gaat er nu vertrouwd uitzien—precies de bedoeling. Hier is een voorbeeld van een OLS-regressie.
# Import necessary libraries
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# Generate synthetic regression data
X, y = make_regression(n_samples=500000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Create and train an OLS regression model
ols = LinearRegression()
ols.fit(X_train, y_train)
Als ik wil zien welke onderdelen op de GPU in plaats van de CPU draaiden, kan ik logger gebruiken.
%load_ext cuml.accel

from cuml.common import logger;
logger.set_level(logger.level_enum.debug)
cuML: Installed accelerator for sklearn.
cuML: Successfully initialized accelerator.
cuML: Performing fit in GPUJe snapt het idee. Laten we nu een overtuigender voorbeeld proberen. Lineaire regressie is toch al niet bijzonder goed te paralleliseren, omdat het oplossen van de normale vergelijking of QR-decompositie sequentiële stappen omvat.
Een complexere uitbreiding van OLS-regressie is ridge-regressie. Bij het gebruik van ridge-regressie in Python past het aanroepen van Ridge() de standaardhyperparameters toe, die niet optimaal hoeven te zijn. De alpha-waarde bepaalt hoeveel regularisatie wordt toegepast. Te klein en het model overfit; te groot en het model underfit.
%load_ext cuml.accel
import sklearn

from sklearn.linear_model import Ridge
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# Generate synthetic data
X, y = make_regression(n_samples=100000, n_features=50, noise=0.1, random_state=0)

# Split into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0)

# Train a Ridge Regression model with default settings
ridge_default = Ridge()
ridge_default.fit(X_train, y_train)

# Make predictions and evaluate
y_pred_default = ridge_default.predict(X_test)
mse_default = mean_squared_error(y_test, y_pred_default)
De code hierboven traint één model met één alpha-waarde en solver. (Ik denk dat die standaard op 'auto' staat.) Dit werkt, maar optimaliseert de regularisatiesterkte of solverkeuze niet.
In plaats van te vertrouwen op defaults, kunnen we iets anders proberen. We kunnen een grid search maken die meerdere hyperparametercombinaties test en de beste selecteert.
from sklearn.model_selection import GridSearchCV

# Define Ridge Regression model
ridge = Ridge()

# Define a grid of hyperparameters to search
param_grid = {
    'alpha': [0.01, 0.1, 1.0, 10.0, 100.0],  # Different regularization strengths
    'solver': ['auto', 'svd', 'cholesky', 'lsqr', 'saga']  # Test multiple solvers
}

# Perform Grid Search with cross-validation
grid_search = GridSearchCV(ridge, param_grid, scoring='neg_mean_squared_error', cv=2, n_jobs=-1)
grid_search.fit(X_train, y_train)

# Get the best model from the search
best_ridge = grid_search.best_estimator_

# Make predictions and evaluate
y_pred_best = best_ridge.predict(X_test)
mse_best = mean_squared_error(y_test, y_pred_best)
Onze grid search test hier alle mogelijke combinaties van hyperparameters. Als we 5 waarden voor alpha definiëren ([0.01, 0.1, 1.0, 10.0, 100.0]), 5 solveropties (['auto', 'svd', 'cholesky', 'lsqr', 'saga']) en 2-voudige cross-validatie gebruiken, is het totale aantal benodigde modeltrainingen 5x5x2, oftewel 50. Dit betekent dat we in plaats van één model, 50 modellen trainen. Dit is veel, veel complexer—daarom zijn GPU's zo fijn om te gebruiken, want ze zijn veel, veel sneller. Omdat sklearn (tot) 50x sneller kan zijn, kan het trainen van deze 50 modellen evenveel tijd kosten als het trainen van maar één. (Ik koos deze aantallen bewust om dat te illustreren. Ik weet dat niet alle modellen dezelfde snelheidswinst halen.)
NVIDIA vergeleek de prestaties van scikit-learn-algoritmen op Intel CPU's met die op NVIDIA GPU's. Ze bekeken verschillende machine learning-workloads, waaronder classificatie en regressie.
De conclusie: eenvoudige modellen zoals random forests gingen van minuten trainen op CPU's naar seconden op GPU's, en complexere modellen zoals clustering gingen van uren naar minuten. De workflows waren in alle gevallen sneller, maar bij rekenzware modellen met hoog-dimensionale data waren de voordelen nog duidelijker. Daar schitteren GPU's, omdat ze parallelle verwerking gebruiken—bekend om een enorm verschil te maken bij modellen die intensieve matrixbewerkingen, afstandsberekeningen of iteratieve optimalisatie vereisen.
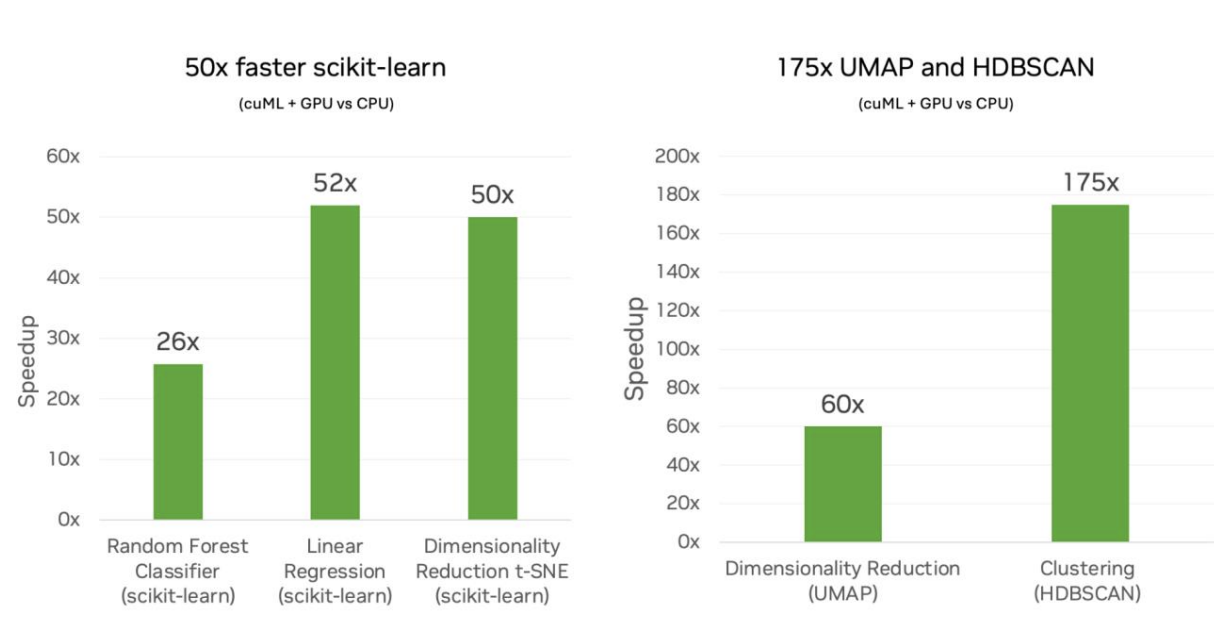
cuML scikit-learn op GPU vs scikit-learn op CPU. Bron: NVIDIA
Ik stapte eerder in het codevoorbeeld af van lineaire regressie omdat ik iets anders wilde proberen om de kracht te tonen. Maar hier zie ik een 52x-versnelling voor lineaire regressie. Ik geef toe: dat verrast me, want dat is een grote factor. Het is een goede reminder dat NVIDIA ook andere geavanceerde optimalisaties doet, zoals ervoor zorgen dat verschillende stappen kunnen worden verstrengeld zodat de GPU niet stilstaat.
Dankzij cuML versie 25.02 is een scikit-learn-algoritme op GPU's draaien nu niet al te moeilijk. Je hoeft alleen de extensie te laden, zoals ik eerder liet zien. Maar als je dieper in de workflow zit en het maximale uit GPU-versnelling wilt halen, zijn er specifieke zaken om op te letten.
NVIDIA raadt aan om datatransfers tussen CPU's en GPU's in je pipeline te minimaliseren. Met andere woorden: doe de preprocessing-, training- en inferentiestappen op de GPU voordat je de resultaten terugstuurt naar het hostgeheugen. Gooi de stappen niet door elkaar door preprocessing op de CPU te doen en vervolgens inferentie op de GPU.
Overweeg ook, om de efficiëntie te maximaliseren, CUDA-X, een verzameling GPU-versnelde bibliotheken ontwikkeld door NVIDIA. Voor random forests kun je bijvoorbeeld cuML's forest inference library gebruiken in plaats van die van scikit-learn.
Wat het RAPIDS AI-team doet is complex, dus er zullen wat issues zijn. Gelukkig is de documentatie van bekende beperkingen goed bijgehouden. Ik wil hier niet per se alle of zelfs maar enkele beperkingen opnemen, omdat veel issues vrij technisch en algoritmespecifiek zijn. Bovendien gaan updates en patches snel. In plaats daarvan geef ik je de meer algemene categorieën om rekening mee te houden.
Er zijn enkele beperkingen die gelden voor cuML als geheel, niet alleen voor specifieke algoritmen. Voorbeelden zijn beperkingen op invoerformaten (sommige problemen met Python-lijsten), versiecompatibiliteit en geheugenbeheer.
Er zijn unieke beperkingen voor afzonderlijke machine learning-algoritmen. Deze verschillen kunnen invloed hebben op hoe modellen worden getraind, hoe parameters zich gedragen of hoe resultaten worden berekend. Zo gebruikt het random forest-algoritme in cuML een andere methode voor het kiezen van splitsdrempels, wat leidt tot iets andere boomstructuren.
Er zijn verschillen in de parameters, solvers en initialisatiemethoden die worden ondersteund. Zo ondersteunt PCA de SVD-solvers "full" en "auto", maar niet "randomized". En KNN ondersteunt Minkowski-metrieken, maar geen Mahalanobis.
Er zijn momenten waarop resultaten licht kunnen verschillen door parallelisme of solververschillen. Dat noemde ik eerder al. UMAP-embeddings zijn bijvoorbeeld mogelijk niet identiek, maar de trustworthiness-score zou nog steeds hoog moeten zijn. In andere gevallen kunnen de tekens van PCA-componenten omklappen en is normalisatie nodig. Dit is weer heel specifiek: raadpleeg de meest recente documentatie bij het draaien van een bepaald algoritme.
Ik ben enthousiast over het vooruitzicht van supermakkelijke GPU-versnelling voor de bekende algoritmen in de meest gebruikte Python machine learning-bibliotheken. Dit gaat een groot verschil maken in modelnauwkeurigheid, en het is handig en niet moeilijk te implementeren.
Blijf op de hoogte van het laatste in machine learning. Volg onze carrièreroute Machine Learning Scientist in Python om alle juiste technieken onder de knie te krijgen. Doe dit zodat je maximaal profiteert van de nieuwste ontwikkelingen. Abonneer je ook op onze DataFramed-podcast. We hebben zelfs een aflevering met Jean-Francois Puget, Distinguished Engineer bij NVIDIA & Chris Deotte, Senior Data Scientist bij NVIDIA, die onder meer de impact van GPU-versnelling bespreken.
Leer Python en scikit-learn met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

