Wetenschappelijke doorbraken ontstaan zelden in een vacuüm. Vaker zijn ze de voorlaatste trede op een trap die is gebouwd op opgehoopte menselijke kennis. Om het succes van large language models (LLM’s), zoals ChatGPT en Google Bart, te begrijpen, moeten we terug in de tijd en het hebben over BERT.
BERT, ontwikkeld in 2018 door onderzoekers van Google, is een van de eerste LLM’s. Met verbluffende resultaten werd het al snel een alomtegenwoordig uitgangspunt voor NLP-taken, waaronder algemeen taalbegrip, vraag-en-antwoord en het herkennen van benoemde entiteiten.
Wil je meer leren over LLM’s? Begin vandaag nog met Hoofdstuk 1 van onze cursus Large Language Models (LLMs) Concepts.
Je kunt gerust stellen dat BERT de weg plaveide voor de generatieve AI-revolutie die we vandaag meemaken. Ondanks dat het een van de eerste LLM’s was, wordt BERT nog steeds breed gebruikt, met duizenden open-source, gratis en voorgetrainde BERT-modellen voor specifieke use-cases, zoals sentimentanalyse, analyse van klinische notities en detectie van toxische reacties.
Nieuwsgierig naar BERT? Lees verder: we verkennen de architectuur van BERT, de interne werking van de technologie, enkele praktijktoepassingen en de beperkingen.
Wat is BERT?
BERT (de afkorting van Bidirectional Encoder Representations from Transformers) is een open-sourcemodel dat in 2018 door Google is ontwikkeld. Het was een ambitieus experiment om de prestaties te testen van de zogeheten transformer – een innovatieve neurale architectuur die Google-onderzoekers in 2017 presenteerden in het beroemde paper Attention is All You Need – op taken in natuurlijke taal (NLP).
De sleutel tot het succes van BERT is de transformer-architectuur. Voordat transformers doorbraken, was het modelleren van natuurlijke taal zeer uitdagend. Ondanks de opkomst van geavanceerde neurale netwerken – te weten recurrente of convolutionele neurale netwerken – waren de resultaten slechts gedeeltelijk succesvol.
De grootste uitdaging lag in het mechanisme waarmee neurale netwerken het ontbrekende woord in een zin voorspelden. Toentertijd steunden de meest geavanceerde netwerken op de encoder-decoderarchitectuur, een krachtig maar tijd- en middelenintensief mechanisme dat ongeschikt is voor parallelle verwerking.
Met deze uitdagingen in het achterhoofd ontwikkelden Google-onderzoekers de transformer, een innovatieve neurale architectuur gebaseerd op het attention-mechanisme, zoals uitgelegd in de volgende sectie.
Hoe werkt BERT?
Laten we bekijken hoe BERT werkt: de technologie achter het model, hoe het wordt getraind en hoe het data verwerkt.
Kernarchitectuur en functionaliteit
Recurrente en convolutionele neurale netwerken gebruiken sequentiële berekening om voorspellingen te genereren. Dat wil zeggen: eenmaal getraind op enorme datasets kunnen ze voorspellen welk woord volgt op een reeks gegeven woorden. In die zin werden ze gezien als unidirectionele of contextvrije algoritmen.
Transformeraangedreven modellen zoals BERT, die ook op de encoder-decoderarchitectuur zijn gebaseerd, zijn daarentegen bidirectioneel omdat ze woorden voorspellen op basis van zowel de voorgaande als de volgende woorden. Dit wordt bereikt via het self-attention-mechanisme, een laag die is opgenomen in zowel de encoder als de decoder. Het doel van de attention-laag is het vastleggen van de contextuele relaties tussen verschillende woorden in de invoerzin.
Tegenwoordig bestaan er veel versies van voorgetrainde BERT-modellen, maar in het oorspronkelijke paper trainde Google twee versies: BERTbase en BERTlarge met verschillende neurale architecturen. Kort gezegd werd BERTbase ontwikkeld met 12 transformerlagen, 12 attention-lagen en 110 miljoen parameters, terwijl BERTlarge 24 transformerlagen, 16 attention-lagen en 340 miljoen parameters gebruikte. Zoals verwacht presteerde BERTlarge nauwkeuriger dan zijn kleinere broer.
Wil je precies weten hoe de encoder-decoderarchitectuur in transformers werkt? Lees dan zeker onze Introduction to Using Transformers and Hugging Face.
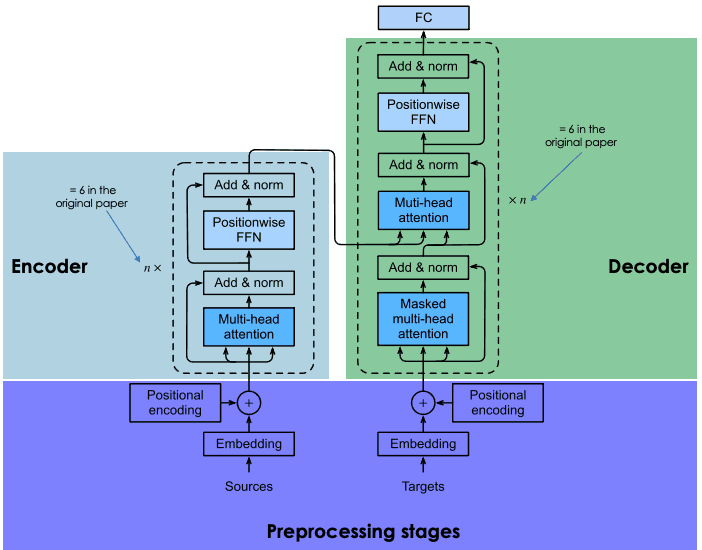
Een uitleg van de architectuur van transformers
Pretraining en fine-tuning
Transformers worden vanaf nul getraind op een enorme hoeveelheid data, via een tijdrovend en kostbaar proces (dat slechts een beperkte groep bedrijven, waaronder Google, zich kan veroorloven).
In het geval van BERT werd het vier dagen lang voorgetraind op Wikipedia (~2,5 miljard woorden) en Google’s BooksCorpus (~800 miljoen woorden). Hierdoor leert het model niet alleen Engels, maar ook veel andere talen van over de hele wereld.
Om het trainingsproces te optimaliseren ontwikkelde Google nieuwe hardware, de zogeheten TPU (Tensor Processing Unit), speciaal ontworpen voor machinelearningtaken.
Om onnodige en dure iteraties in het trainingsproces te vermijden, gebruikten Google-onderzoekers transfer learning-technieken om de (pre)trainingsfase te scheiden van de fine-tuningfase. Zo kunnen ontwikkelaars voorgetrainde modellen kiezen, de input-outputparen van de doeltaak verfijnen en het hoofd van het voorgetrainde model opnieuw trainen met domeinspecifieke data. Deze eigenschap maakt LLM’s zoals BERT de fundamentmodellen waarop eindeloos veel toepassingen kunnen worden gebouwd,
De rol van Masked Language Modeling in BERT’s verwerking
Het sleutelelement voor bidirectioneel leren in BERT (en elk LLM dat op transformers is gebaseerd) is het attention-mechanisme. Dit mechanisme is gebaseerd op masked language modeling (MLM). Door een woord in een zin te maskeren, dwingt deze techniek het model om de overige woorden in beide richtingen in de zin te analyseren om de kans te vergroten dat het gemaskeerde woord wordt voorspeld. MLM is gebaseerd op technieken die al in computervisie zijn uitgeprobeerd en is uitstekend voor taken die een goed contextueel begrip van een hele sequentie vereisen.
BERT was het eerste LLM dat deze techniek toepaste. Concreet werd tijdens het trainen een willekeurige 15% van de getokenizeerde woorden gemaskeerd. Het resultaat laat zien dat BERT de verborgen woorden met hoge nauwkeurigheid kon voorspellen.
Nieuwsgierig naar masked language modeling? Bekijk onze Large Language Models (LLMs) Concepts-cursus om alle details over deze innovatieve techniek te leren.
Waar wordt BERT voor gebruikt? BERT’s impact op NLP
Aangedreven door transformers behaalde BERT state-of-the-art resultaten op meerdere NLP-taken. Dit zijn enkele tests waarin BERT uitblinkt:
- Vraag-en-antwoord. BERT was een van de eerste chatbots op basis van transformers en leverde indrukwekkende resultaten.
- Sentimentanalyse. Zo was BERT succesvol in het voorspellen van positieve of negatieve waarderingen voor filmrecensies.
- Tekstgeneratie. Als voorloper van de volgende generatie chatbots kon BERT al lange teksten maken met eenvoudige prompts.
- Samenvatten van tekst. Evenzo kon BERT teksten uit complexe domeinen, waaronder recht en zorg, lezen en samenvatten.
- Taalkundige vertaling. BERT is getraind op data in meerdere talen. Het is dus een meertalig model, wat het zeer geschikt maakt voor vertaling.
- Autocompletetaken. BERT kan worden gebruikt voor autocompletetaken, bijvoorbeeld in e-mails of berichtendiensten.
Praktijktoepassingen van BERT
Veel LLM’s zijn in experimentele settings getest, maar niet veel zijn opgenomen in gevestigde toepassingen. Dat geldt niet voor BERT: het wordt elke dag gebruikt door miljoenen mensen (ook al zijn we ons daar niet altijd van bewust).
Een goed voorbeeld is Google Zoeken. In 2020 kondigde Google aan dat het BERT via Google Zoeken in meer dan 70 talen had ingevoerd. Dat betekent dat Google BERT gebruikt om content te rangschikken en uitgelichte fragmenten te tonen. Met het attention-mechanisme kan Google nu de context van je vraag benutten om nuttige informatie te geven, zoals in het volgende voorbeeld.
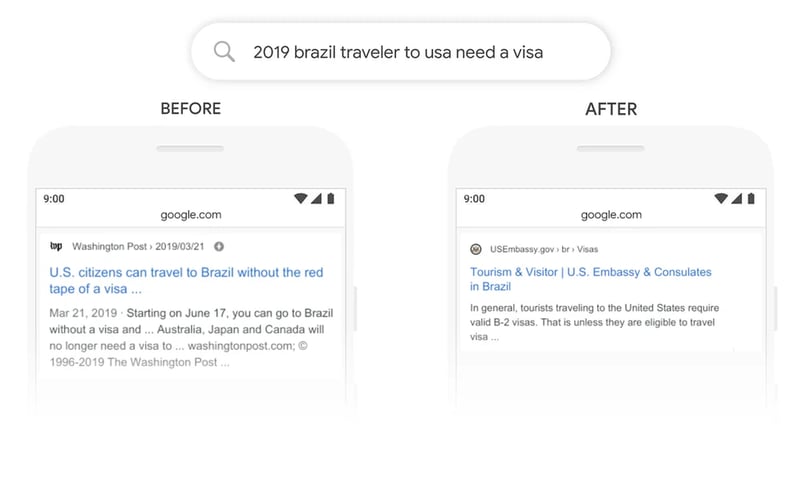
Bron: Google
BERT’s varianten en aanpassingen
Maar dat is slechts een deel van het verhaal. Het succes van BERT is voor een groot deel te danken aan het open-sourcekarakter, waardoor ontwikkelaars toegang kregen tot de broncode van de oorspronkelijke BERT en nieuwe functies en verbeteringen konden bouwen.
Dit heeft geresulteerd in flink wat varianten van BERT. Hieronder vind je enkele van de bekendste varianten:
- RoBERTa. Afkorting van “Robustly Optimized BERT Approach”, RoBERTa is een BERT-variant gemaakt door Meta in samenwerking met Washington University. Beschouwd als krachtiger dan de oorspronkelijke BERT, werd RoBERTa getraind met een dataset die 10 keer groter was dan die voor BERT. Qua architectuur is het belangrijkste verschil het gebruik van dynamische masking in plaats van statische masking. Deze techniek, waarbij trainingsdata werd gedupliceerd en 10 keer gemaskeerd, telkens met een andere maskeringsstrategie, stelde RoBERTa in staat robuustere en beter generaliseerbare representaties van woorden te leren.
- DistilBERT. Sinds de komst van de eerste LLM’s eind jaren 2010 is er een duidelijke trend om steeds grotere en zwaardere LLM’s te bouwen. Dat is logisch, want er lijkt een direct verband te bestaan tussen modelgrootte en nauwkeurigheid. Maar hoe groter het model, hoe meer middelen nodig zijn om het te draaien, en dus hoe minder mensen het kunnen gebruiken. DistilBERT wil BERT toegankelijker maken door een kleinere, snellere, goedkopere en lichtere variant te bieden. Gebaseerd op de architectuur van de oorspronkelijke BERT gebruikt DistilBERT knowledge distillation tijdens pretraining om de grootte met 40% te verminderen, terwijl 97% van het taalbegrip behouden blijft en het 60% sneller is.
- ALBERT. Staat voor A Lite BERT en is specifiek ontworpen om de efficiëntie van BERTlarge tijdens pretraining te vergroten. Omdat het trainen van grotere modellen vaak leidt tot geheugenvraagstukken, langere trainingstijden en onverwachte modeldegradatie, ontwikkelden de makers van ALBERT twee parameterreductietechnieken om het geheugengebruik te verminderen en de snelheid tijdens training te verhogen.
Wil je meer weten over de open-source LLM-beweging? Lees dan zeker onze post met de Top Open-Source LLM’s in 2023
BERT fine-tunen voor specifieke taken
Een van de mooiste dingen aan BERT, en LLM’s in het algemeen, is dat het pretrainingsproces is gescheiden van het fine-tuningproces. Dat betekent dat ontwikkelaars voorgetrainde versies van BERT kunnen nemen en die op maat kunnen maken voor hun specifieke use-cases.
Voor BERT bestaan er honderden gefinetunede versies voor een breed scala aan NLP-taken. Hieronder vind je een zeer, zeer beperkte lijst van gefinetunede BERT-versies:
- BERT-base-chinese. Een versie van BERTbase die is getraind voor NLP-taken in het Chinees
- BERT-base-NER. Een versie van BERTbase die is aangepast voor het herkennen van benoemde entiteiten
- Symps_disease_bert_v3_c41. Een symptoom-naar-ziekte-classificatiemodel voor een natuurlijke-taalchatbot.
- BERT for Patents. is een model dat door Google is getraind op meer dan 100 miljoen patenten wereldwijd. Het is gebaseerd op BERTlarge.
Beperkingen van BERT begrijpen
BERT kent de traditionele beperkingen en problemen die bij LLM’s horen. De voorspellingen van BERT zijn altijd gebaseerd op de hoeveelheid en kwaliteit van de data waarmee het is getraind. Als trainingsdata beperkt, slecht of bevooroordeeld is, kan BERT onnauwkeurige of schadelijke resultaten geven of zelfs zogeheten LLM-hallucinaties.
Voor het oorspronkelijke BERT is dit nog waarschijnlijker, omdat het model is getraind zonder Reinforcement Learning from Human Feedback (RLHF), een standaardtechniek die door geavanceerdere modellen, zoals ChatGPT, LLaMA 2 en Google Bard, wordt gebruikt om AI-veiligheid te verbeteren. RLHF houdt in dat menselijk feedback wordt gebruikt om het leerproces van het LLM tijdens training te monitoren en te sturen, wat zorgt voor effectievere, veiligere en betrouwbaardere systemen.
Verder geldt dat, hoewel BERT klein kan worden genoemd vergeleken met andere state-of-the-art LLM’s, zoals ChatGPT, er nog steeds aanzienlijke rekenkracht nodig is om het te draaien, laat staan om het vanaf nul te trainen. Ontwikkelaars met beperkte middelen kunnen het daarom mogelijk niet gebruiken.
De toekomst van BERT en NLP
BERT was een van de eerste moderne LLM’s. Maar verre van ouderwets is BERT nog steeds een van de succesvolste en meest gebruikte LLM’s. Dankzij het open-sourcekarakter zijn er vandaag meerdere varianten en honderden voorgetrainde versies van BERT voor specifieke NLP-taken.
Wil je op de hoogte blijven van BERT en recente NLP-ontwikkelingen? DataCamp helpt je graag. Bekijk onze zorgvuldig geselecteerde materialen en blijf bij in de huidige generatieve AI-revolutie!




Wetenschappelijke doorbraken ontstaan zelden in een vacuüm. Vaker zijn ze de voorlaatste trede op een trap die is gebouwd op opgehoopte menselijke kennis. Om het succes van large language models (LLM’s), zoals ChatGPT en Google Bart, te begrijpen, moeten we terug in de tijd en het hebben over BERT.
BERT, ontwikkeld in 2018 door onderzoekers van Google, is een van de eerste LLM’s. Met verbluffende resultaten werd het al snel een alomtegenwoordig uitgangspunt voor NLP-taken, waaronder algemeen taalbegrip, vraag-en-antwoord en het herkennen van benoemde entiteiten.
Wil je meer leren over LLM’s? Begin vandaag nog met Hoofdstuk 1 van onze cursus Large Language Models (LLMs) Concepts.
Je kunt gerust stellen dat BERT de weg plaveide voor de generatieve AI-revolutie die we vandaag meemaken. Ondanks dat het een van de eerste LLM’s was, wordt BERT nog steeds breed gebruikt, met duizenden open-source, gratis en voorgetrainde BERT-modellen voor specifieke use-cases, zoals sentimentanalyse, analyse van klinische notities en detectie van toxische reacties.
Nieuwsgierig naar BERT? Lees verder: we verkennen de architectuur van BERT, de interne werking van de technologie, enkele praktijktoepassingen en de beperkingen.
Wat is BERT?
BERT (de afkorting van Bidirectional Encoder Representations from Transformers) is een open-sourcemodel dat in 2018 door Google is ontwikkeld. Het was een ambitieus experiment om de prestaties te testen van de zogeheten transformer – een innovatieve neurale architectuur die Google-onderzoekers in 2017 presenteerden in het beroemde paper Attention is All You Need – op taken in natuurlijke taal (NLP).
De sleutel tot het succes van BERT is de transformer-architectuur. Voordat transformers doorbraken, was het modelleren van natuurlijke taal zeer uitdagend. Ondanks de opkomst van geavanceerde neurale netwerken – te weten recurrente of convolutionele neurale netwerken – waren de resultaten slechts gedeeltelijk succesvol.
De grootste uitdaging lag in het mechanisme waarmee neurale netwerken het ontbrekende woord in een zin voorspelden. Toentertijd steunden de meest geavanceerde netwerken op de encoder-decoderarchitectuur, een krachtig maar tijd- en middelenintensief mechanisme dat ongeschikt is voor parallelle verwerking.
Met deze uitdagingen in het achterhoofd ontwikkelden Google-onderzoekers de transformer, een innovatieve neurale architectuur gebaseerd op het attention-mechanisme, zoals uitgelegd in de volgende sectie.
Hoe werkt BERT?
Laten we bekijken hoe BERT werkt: de technologie achter het model, hoe het wordt getraind en hoe het data verwerkt.
Kernarchitectuur en functionaliteit
Recurrente en convolutionele neurale netwerken gebruiken sequentiële berekening om voorspellingen te genereren. Dat wil zeggen: eenmaal getraind op enorme datasets kunnen ze voorspellen welk woord volgt op een reeks gegeven woorden. In die zin werden ze gezien als unidirectionele of contextvrije algoritmen.
Transformeraangedreven modellen zoals BERT, die ook op de encoder-decoderarchitectuur zijn gebaseerd, zijn daarentegen bidirectioneel omdat ze woorden voorspellen op basis van zowel de voorgaande als de volgende woorden. Dit wordt bereikt via het self-attention-mechanisme, een laag die is opgenomen in zowel de encoder als de decoder. Het doel van de attention-laag is het vastleggen van de contextuele relaties tussen verschillende woorden in de invoerzin.
Tegenwoordig bestaan er veel versies van voorgetrainde BERT-modellen, maar in het oorspronkelijke paper trainde Google twee versies: BERTbase en BERTlarge met verschillende neurale architecturen. Kort gezegd werd BERTbase ontwikkeld met 12 transformerlagen, 12 attention-lagen en 110 miljoen parameters, terwijl BERTlarge 24 transformerlagen, 16 attention-lagen en 340 miljoen parameters gebruikte. Zoals verwacht presteerde BERTlarge nauwkeuriger dan zijn kleinere broer.
Wil je precies weten hoe de encoder-decoderarchitectuur in transformers werkt? Lees dan zeker onze Introduction to Using Transformers and Hugging Face.
Een uitleg van de architectuur van transformers
Pretraining en fine-tuning
Transformers worden vanaf nul getraind op een enorme hoeveelheid data, via een tijdrovend en kostbaar proces (dat slechts een beperkte groep bedrijven, waaronder Google, zich kan veroorloven).
In het geval van BERT werd het vier dagen lang voorgetraind op Wikipedia (~2,5 miljard woorden) en Google’s BooksCorpus (~800 miljoen woorden). Hierdoor leert het model niet alleen Engels, maar ook veel andere talen van over de hele wereld.
Om het trainingsproces te optimaliseren ontwikkelde Google nieuwe hardware, de zogeheten TPU (Tensor Processing Unit), speciaal ontworpen voor machinelearningtaken.
Om onnodige en dure iteraties in het trainingsproces te vermijden, gebruikten Google-onderzoekers transfer learning-technieken om de (pre)trainingsfase te scheiden van de fine-tuningfase. Zo kunnen ontwikkelaars voorgetrainde modellen kiezen, de input-outputparen van de doeltaak verfijnen en het hoofd van het voorgetrainde model opnieuw trainen met domeinspecifieke data. Deze eigenschap maakt LLM’s zoals BERT de fundamentmodellen waarop eindeloos veel toepassingen kunnen worden gebouwd,
De rol van Masked Language Modeling in BERT’s verwerking
Het sleutelelement voor bidirectioneel leren in BERT (en elk LLM dat op transformers is gebaseerd) is het attention-mechanisme. Dit mechanisme is gebaseerd op masked language modeling (MLM). Door een woord in een zin te maskeren, dwingt deze techniek het model om de overige woorden in beide richtingen in de zin te analyseren om de kans te vergroten dat het gemaskeerde woord wordt voorspeld. MLM is gebaseerd op technieken die al in computervisie zijn uitgeprobeerd en is uitstekend voor taken die een goed contextueel begrip van een hele sequentie vereisen.
BERT was het eerste LLM dat deze techniek toepaste. Concreet werd tijdens het trainen een willekeurige 15% van de getokenizeerde woorden gemaskeerd. Het resultaat laat zien dat BERT de verborgen woorden met hoge nauwkeurigheid kon voorspellen.
Nieuwsgierig naar masked language modeling? Bekijk onze Large Language Models (LLMs) Concepts-cursus om alle details over deze innovatieve techniek te leren.
Waar wordt BERT voor gebruikt? BERT’s impact op NLP
Aangedreven door transformers behaalde BERT state-of-the-art resultaten op meerdere NLP-taken. Dit zijn enkele tests waarin BERT uitblinkt:
Praktijktoepassingen van BERT
Veel LLM’s zijn in experimentele settings getest, maar niet veel zijn opgenomen in gevestigde toepassingen. Dat geldt niet voor BERT: het wordt elke dag gebruikt door miljoenen mensen (ook al zijn we ons daar niet altijd van bewust).
Een goed voorbeeld is Google Zoeken. In 2020 kondigde Google aan dat het BERT via Google Zoeken in meer dan 70 talen had ingevoerd. Dat betekent dat Google BERT gebruikt om content te rangschikken en uitgelichte fragmenten te tonen. Met het attention-mechanisme kan Google nu de context van je vraag benutten om nuttige informatie te geven, zoals in het volgende voorbeeld.
Bron: Google
BERT’s varianten en aanpassingen
Maar dat is slechts een deel van het verhaal. Het succes van BERT is voor een groot deel te danken aan het open-sourcekarakter, waardoor ontwikkelaars toegang kregen tot de broncode van de oorspronkelijke BERT en nieuwe functies en verbeteringen konden bouwen.
Dit heeft geresulteerd in flink wat varianten van BERT. Hieronder vind je enkele van de bekendste varianten:
Wil je meer weten over de open-source LLM-beweging? Lees dan zeker onze post met de Top Open-Source LLM’s in 2023
BERT fine-tunen voor specifieke taken
Een van de mooiste dingen aan BERT, en LLM’s in het algemeen, is dat het pretrainingsproces is gescheiden van het fine-tuningproces. Dat betekent dat ontwikkelaars voorgetrainde versies van BERT kunnen nemen en die op maat kunnen maken voor hun specifieke use-cases.
Voor BERT bestaan er honderden gefinetunede versies voor een breed scala aan NLP-taken. Hieronder vind je een zeer, zeer beperkte lijst van gefinetunede BERT-versies:
Beperkingen van BERT begrijpen
BERT kent de traditionele beperkingen en problemen die bij LLM’s horen. De voorspellingen van BERT zijn altijd gebaseerd op de hoeveelheid en kwaliteit van de data waarmee het is getraind. Als trainingsdata beperkt, slecht of bevooroordeeld is, kan BERT onnauwkeurige of schadelijke resultaten geven of zelfs zogeheten LLM-hallucinaties.
Voor het oorspronkelijke BERT is dit nog waarschijnlijker, omdat het model is getraind zonder Reinforcement Learning from Human Feedback (RLHF), een standaardtechniek die door geavanceerdere modellen, zoals ChatGPT, LLaMA 2 en Google Bard, wordt gebruikt om AI-veiligheid te verbeteren. RLHF houdt in dat menselijk feedback wordt gebruikt om het leerproces van het LLM tijdens training te monitoren en te sturen, wat zorgt voor effectievere, veiligere en betrouwbaardere systemen.
Verder geldt dat, hoewel BERT klein kan worden genoemd vergeleken met andere state-of-the-art LLM’s, zoals ChatGPT, er nog steeds aanzienlijke rekenkracht nodig is om het te draaien, laat staan om het vanaf nul te trainen. Ontwikkelaars met beperkte middelen kunnen het daarom mogelijk niet gebruiken.
De toekomst van BERT en NLP
BERT was een van de eerste moderne LLM’s. Maar verre van ouderwets is BERT nog steeds een van de succesvolste en meest gebruikte LLM’s. Dankzij het open-sourcekarakter zijn er vandaag meerdere varianten en honderden voorgetrainde versies van BERT voor specifieke NLP-taken.
Wil je op de hoogte blijven van BERT en recente NLP-ontwikkelingen? DataCamp helpt je graag. Bekijk onze zorgvuldig geselecteerde materialen en blijf bij in de huidige generatieve AI-revolutie!