वैज्ञानिक प्रगति शायद ही कभी निर्वात में होती है। वे अक्सर संचित मानवीय ज्ञान पर बनी सीढ़ी के अंतिम से पहले वाले पायदान की तरह होती हैं। ChatGPT और Google Bart जैसे बड़े भाषा मॉडलों (LLMs) की सफलता समझने के लिए, हमें समय में पीछे जाना होगा और BERT के बारे में बात करनी होगी।
2018 में Google शोधकर्ताओं द्वारा विकसित, BERT शुरुआती LLMs में से एक है। अपनी चौंकाने वाली उपलब्धियों के साथ, यह सामान्य भाषा समझ, प्रश्न-उत्तर, और नेम्ड एंटिटी रिकग्निशन सहित NLP कार्यों में तेजी से सर्वव्यापी बेसलाइन बन गया।
LLMs के बारे में और जानने में रुचि है? आज ही हमारे Large Language Models (LLMs) Concepts कोर्स का अध्याय 1 शुरू करें।
यह कहना उचित होगा कि BERT ने उस जनरेटिव AI क्रांति के लिए राह बनाई जिसे हम आज देख रहे हैं। शुरुआती LLMs में से एक होने के बावजूद, BERT आज भी व्यापक रूप से इस्तेमाल होता है, और विशेष उपयोग मामलों—जैसे सेंटिमेंट एनालिसिस, क्लिनिकल नोट विश्लेषण, और टॉक्सिक कमेंट डिटेक्शन—के लिए हजारों ओपन-सोर्स, निःशुल्क, और प्री-ट्रेंड BERT मॉडल उपलब्ध हैं।
BERT के बारे में जिज्ञासा है? लेख पढ़ते रहें, जिसमें हम BERT की संरचना, तकनीक के आंतरिक कामकाज, इसके कुछ वास्तविक-जीवन अनुप्रयोग, और इसकी सीमाओं का अन्वेषण करेंगे।
BERT क्या है?
BERT (Bidirectional Encoder Representations from Transformers) एक ओपन-सोर्स मॉडल है जिसे 2018 में Google ने विकसित किया। यह तथाकथित ट्रांसफॉर्मर—एक अभिनव न्यूरल आर्किटेक्चर जिसे Google शोधकर्ताओं ने 2017 में प्रसिद्ध पेपर Attention is All You Need में प्रस्तुत किया—के प्रदर्शन को प्राकृतिक भाषा (NLP) कार्यों पर परखने का एक महत्वाकांक्षी प्रयोग था।
BERT की सफलता की कुंजी उसका ट्रांसफॉर्मर आर्किटेक्चर है। ट्रांसफॉर्मर्स के आने से पहले, प्राकृतिक भाषा का मॉडलिंग करना बहुत चुनौतीपूर्ण था। उन्नत न्यूरल नेटवर्क—यथा रिकरेंट या कन्वॉल्यूशनल न्यूरल नेटवर्क—के उभार के बावजूद, परिणाम केवल आंशिक रूप से सफल थे।
मुख्य चुनौती उस तंत्र में थी जिसका उपयोग न्यूरल नेटवर्क वाक्य में गुम शब्द की भविष्यवाणी करने के लिए करते थे। उस समय, अत्याधुनिक न्यूरल नेटवर्क एन्कोडर-डिकोडर आर्किटेक्चर पर निर्भर थे—एक शक्तिशाली, पर समय और संसाधन खपत करने वाला तंत्र, जो पैरेलल कंप्यूटिंग के लिए उपयुक्त नहीं था।
इन चुनौतियों को ध्यान में रखकर, Google शोधकर्ताओं ने अटेंशन मैकेनिज्म पर आधारित, ट्रांसफॉर्मर नामक एक अभिनव न्यूरल आर्किटेक्चर विकसित किया, जैसा कि अगला खंड समझाता है।
BERT कैसे काम करता है?
आइए देखें कि BERT कैसे काम करता है—मॉडल के पीछे की तकनीक, उसका प्रशिक्षण, और डेटा प्रोसेसिंग।
मुख्य संरचना और कार्यक्षमता
रिकरेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क भविष्यवाणियां उत्पन्न करने के लिए अनुक्रमिक गणना का उपयोग करते हैं। यानी, बड़े डेटासेट पर प्रशिक्षित होने के बाद वे दिए गए शब्दों की श्रृंखला के बाद कौन सा शब्द आएगा, इसकी भविष्यवाणी कर सकते हैं। इस अर्थ में, उन्हें एक-दिशीय या संदर्भ-मुक्त एल्गोरिदम माना जाता था।
इसके विपरीत, ट्रांसफॉर्मर-समर्थित मॉडल जैसे BERT—जो एन्कोडर-डिकोडर आर्किटेक्चर पर भी आधारित हैं—द्विदिश होते हैं क्योंकि वे पिछले और अगले दोनों शब्दों के आधार पर शब्दों की भविष्यवाणी करते हैं। यह सेल्फ-अटेंशन मैकेनिज्म के माध्यम से प्राप्त होता है—एक परत जो एन्कोडर और डिकोडर दोनों में शामिल होती है। अटेंशन परत का लक्ष्य इनपुट वाक्य के विभिन्न शब्दों के बीच मौजूद संदर्भात्मक संबंधों को पकड़ना है।
आज कई प्री-ट्रेंड BERT संस्करण उपलब्ध हैं, पर मूल पेपर में Google ने दो संस्करण प्रशिक्षित किए: BERTbase और BERTlarge, विभिन्न न्यूरल आर्किटेक्चर के साथ। मूलतः, BERTbase में 12 ट्रांसफॉर्मर लेयर, 12 अटेंशन लेयर, और 110 मिलियन पैरामीटर थे, जबकि BERTlarge में 24 ट्रांसफॉर्मर लेयर, 16 अटेंशन लेयर, और 340 मिलियन पैरामीटर थे। अपेक्षा के अनुरूप, शुद्धता परीक्षणों में BERTlarge ने छोटे संस्करण को पीछे छोड़ा।
ट्रांसफॉर्मर्स में एन्कोडर-डिकोडर आर्किटेक्चर कैसे काम करता है, यह विस्तार से जानने के लिए, हम आपको हमारा Introduction to Using Transformers and Hugging Face पढ़ने की अत्यंत अनुशंसा करते हैं।
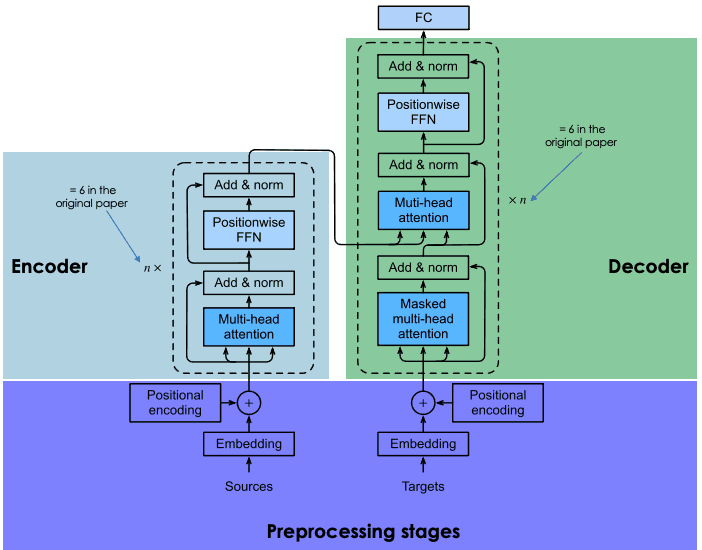
ट्रांसफॉर्मर्स की आर्किटेक्चर का एक स्पष्टीकरण
प्री-ट्रेनिंग और फाइन-ट्यूनिंग
ट्रांसफॉर्मर्स को शुरुआत से ही विशाल डेटा कॉर्पस पर प्रशिक्षित किया जाता है—यह एक समयसाध्य और महंगा प्रक्रिया है (जिसे केवल सीमित कंपनियां, जिनमें Google शामिल है, वहन कर सकती हैं)।
BERT के मामले में, इसे चार दिनों तक Wikipedia (~2.5B शब्द) और Google के BooksCorpus (~800M शब्द) पर प्री-ट्रेन किया गया। इससे मॉडल को केवल अंग्रेजी में ही नहीं, बल्कि दुनिया की कई अन्य भाषाओं में भी ज्ञान अर्जित करने में मदद मिली।
प्रशिक्षण प्रक्रिया को अनुकूलित करने के लिए, Google ने नया हार्डवेयर विकसित किया—TPU (Tensor Processing Unit)—जो विशेष रूप से मशीन लर्निंग कार्यों के लिए डिज़ाइन किया गया है।
प्रशिक्षण प्रक्रिया में अनावश्यक और महंगी अंतःक्रियाओं से बचने के लिए, Google शोधकर्ताओं ने ट्रांसफर लर्निंग तकनीकों का उपयोग कर (प्री)ट्रेनिंग चरण को फाइन-ट्यूनिंग चरण से अलग किया। इससे डेवलपर्स प्री-ट्रेंड मॉडल चुन सकते हैं, लक्षित कार्य के इनपुट-आउटपुट पेयर डेटा को परिष्कृत कर सकते हैं, और डोमेन-विशिष्ट डेटा का उपयोग करके प्री-ट्रेंड मॉडल के हेड को पुन:प्रशिक्षित कर सकते हैं। यही विशेषता BERT जैसे LLMs को उन पर निर्मित अनंत अनुप्रयोगों का फाउंडेशन मॉडल बनाती है।
BERT की प्रोसेसिंग में Masked Language Modeling की भूमिका
BERT (और ट्रांसफॉर्मर्स-आधारित हर LLM) में द्विदिश सीख हासिल करने का प्रमुख तत्व अटेंशन मैकेनिज्म है। यह तंत्र मास्क्ड लैंग्वेज मॉडलिंग (MLM) पर आधारित है। किसी वाक्य में एक शब्द को मास्क करके, यह तकनीक मॉडल को वाक्य के शेष शब्दों का दोनों दिशाओं में विश्लेषण करने के लिए बाध्य करती है, ताकि मास्क किए गए शब्द की भविष्यवाणी की संभावना बढ़े। MLM, कंप्यूटर विज़न क्षेत्र में पहले से आजमाई गई तकनीकों पर आधारित है, और यह उन कार्यों के लिए शानदार है जिनमें पूरी श्रृंखला की अच्छी संदर्भात्मक समझ आवश्यक होती है।
यह तकनीक लागू करने वाला पहला LLM BERT था। विशेष रूप से, प्रशिक्षण के दौरान टोकनाइज़ किए गए शब्दों में से यादृच्छिक 15% को मास्क किया गया। परिणामों से पता चला कि BERT छिपे हुए शब्दों की उच्च सटीकता से भविष्यवाणी कर सका।
मास्क्ड लैंग्वेज मॉडलिंग के बारे में जिज्ञासा है? इस अभिनव तकनीक के सभी विवरण जानने के लिए हमारा Large Language Models (LLMs) Concepts Course देखें।
BERT का उपयोग किस लिए होता है? NLP पर BERT का प्रभाव
ट्रांसफॉर्मर्स द्वारा समर्थित, BERT कई NLP कार्यों में अत्याधुनिक परिणाम देने में सक्षम रहा। यहां कुछ परीक्षण हैं जिनमें BERT उत्कृष्ट रहा है:
- प्रश्न-उत्तर। BERT शुरुआती ट्रांसफॉर्मर-समर्थित चैटबॉट्स में से एक रहा है, जिसने प्रभावशाली परिणाम दिए।
- सेंटिमेंट एनालिसिस। उदाहरण के लिए, BERT फिल्म समीक्षाओं के लिए सकारात्मक या नकारात्मक भाव की भविष्यवाणी करने में सफल रहा है।
- टेक्स्ट जेनरेशन। अगली पीढ़ी के चैटबॉट्स का अग्रदूत, BERT साधारण प्रॉम्प्ट्स से लंबे टेक्स्ट बना पाने में सक्षम था।
- सार-संक्षेपण। इसी तरह, BERT कानून और स्वास्थ्य सेवा सहित जटिल क्षेत्रों के टेक्स्ट को पढ़कर उनका सार प्रस्तुत कर सकता था।
- भाषा अनुवाद। BERT को कई भाषाओं के डेटा पर प्रशिक्षित किया गया है। यह इसे बहुभाषी मॉडल बनाता है, जो भाषा अनुवाद के लिए अत्यंत उपयुक्त है।
- ऑटोकंपलीट कार्य। BERT का उपयोग ऑटोकंपलीट कार्यों के लिए किया जा सकता है, उदाहरण के लिए, ईमेल या मैसेजिंग सेवाओं में।
BERT के वास्तविक-जीवन अनुप्रयोग
कई LLMs का प्रयोगात्मक सेटअप में परीक्षण हुआ है, पर बहुत कम ही सुव्यवस्थित अनुप्रयोगों में जोड़े गए हैं। BERT इसका अपवाद है—इसे हर दिन लाखों लोग इस्तेमाल करते हैं (भले हम इससे अनभिज्ञ हों)।
इसका एक शानदार उदाहरण Google Search है। 2020 में, Google ने घोषणा की कि उसने 70 से अधिक भाषाओं में Google Search के माध्यम से BERT अपनाया है। इसका अर्थ है कि Google सामग्री की रैंकिंग और फ़ीचर्ड स्निपेट प्रदर्शित करने के लिए BERT का उपयोग करता है। अटेंशन मैकेनिज्म के साथ, Google अब आपके प्रश्न के संदर्भ का उपयोग कर उपयोगी जानकारी प्रदान कर सकता है, जैसा कि निम्न उदाहरण में दिखाया गया है।
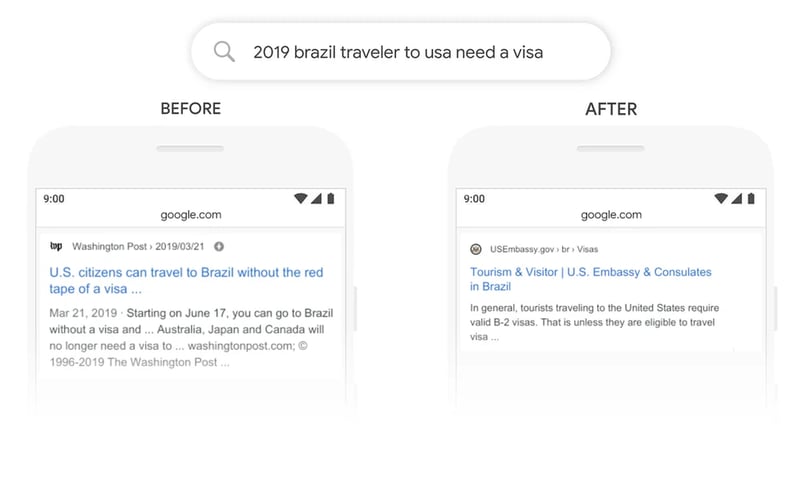
स्रोत: Google
BERT के वैरिएंट और अनुकूलन
लेकिन कहानी यहीं खत्म नहीं होती। BERT की सफलता काफी हद तक इसके ओपन-सोर्स स्वभाव के कारण है, जिसने डेवलपर्स को मूल BERT के सोर्स कोड तक पहुंच दी और नई विशेषताएं व सुधार विकसित करने में सक्षम बनाया।
इससे BERT के कई वैरिएंट सामने आए हैं। नीचे कुछ सबसे चर्चित वैरिएंट दिए गए हैं:
- RoBERTa. “Robustly Optimized BERT Approach” का संक्षिप्त रूप, RoBERTa Meta द्वारा Washington University के सहयोग से बनाया गया BERT वैरिएंट है। मूल BERT से अधिक शक्तिशाली संस्करण माना जाने वाला RoBERTa उस डेटासेट पर प्रशिक्षित है जो BERT को प्रशिक्षित करने में प्रयुक्त डेटासेट से 10 गुना बड़ा था। आर्किटेक्चर की दृष्टि से सबसे बड़ा अंतर स्टैटिक मास्किंग लर्निंग के स्थान पर डायनेमिक मास्किंग लर्निंग का उपयोग है। इस तकनीक में प्रशिक्षण डेटा को डुप्लिकेट कर उसे 10 बार अलग-अलग मास्क रणनीतियों से मास्क किया गया, जिससे RoBERTa शब्दों के अधिक सुदृढ़ और सामान्यीकृत निरूपण सीख सका।
- DistilBERT. 2010 के दशक के उत्तरार्ध से पहले LLMs के लॉन्च के बाद से बड़े और भारी LLMs बनाने की प्रवृत्ति मजबूत रही है। यह समझ में आता है, क्योंकि मॉडल के आकार और सटीकता के बीच प्रत्यक्ष संबंध दिखाई देता है। फिर भी, यह भी सच है कि मॉडल जितना बड़ा, उसे चलाने के लिए उतने ही अधिक संसाधन चाहिए—और इस प्रकार, कम लोग उसे वहन कर पाते हैं। DistilBERT का उद्देश्य BERT को अधिक सुलभ बनाना है—एक छोटा, तेज, सस्ता और हल्का वैरिएंट देकर। मूल BERT की आर्किटेक्चर पर आधारित, DistilBERT प्री-ट्रेनिंग के दौरान नॉलेज डिस्टिलेशन तकनीकों का उपयोग करता है, जिससे आकार 40% तक घट जाता है, जबकि भाषा समझने की 97% क्षमता बनी रहती है और गति 60% तक तेज होती है।
- ALBERT. “A Lite BERT” का संक्षिप्त रूप, ALBERT को विशेष रूप से प्री-ट्रेनिंग के दौरान BERTlarge की दक्षता बढ़ाने के लिए डिज़ाइन किया गया। बड़े मॉडल का प्रशिक्षण अक्सर मेमोरी सीमाओं, लंबे प्रशिक्षण समय और अप्रत्याशित मॉडल ह्रास का कारण बनता है, इसलिए ALBERT निर्माताओं ने मेमोरी खपत घटाने और प्रशिक्षण के दौरान गति बढ़ाने हेतु दो पैरामीटर-रिडक्शन तकनीकें विकसित कीं।
यदि आप ओपन-सोर्स LLM आंदोलन के बारे में और जानना चाहते हैं, तो हम अत्यधिक सलाह देते हैं कि आप हमारा 2023 के शीर्ष ओपन-सोर्स LLMs पर पोस्ट पढ़ें।
विशिष्ट कार्यों के लिए BERT का फाइन-ट्यून करना
BERT—और सामान्यतः LLMs—की सबसे बड़ी खूबियों में से एक यह है कि प्री-ट्रेनिंग प्रक्रिया फाइन-ट्यूनिंग प्रक्रिया से अलग होती है। यानी डेवलपर्स BERT के प्री-ट्रेंड संस्करण ले सकते हैं और उन्हें अपने विशेष उपयोग मामलों के लिए अनुकूलित कर सकते हैं।
BERT के मामले में, विविध NLP कार्यों के लिए विकसित BERT के सैकड़ों फाइन-ट्यून किए गए संस्करण मौजूद हैं। नीचे BERT के फाइन-ट्यून किए गए संस्करणों की एक अत्यंत सीमित सूची दी गई है:
- BERT-base-chinese. चीनी भाषा में NLP कार्यों के लिए प्रशिक्षित BERTbase का एक संस्करण
- BERT-base-NER. नेम्ड एंटिटी रिकग्निशन के लिए अनुकूलित BERTbase का एक संस्करण
- Symps_disease_bert_v3_c41. एक नैचुरल लैंग्वेज चैटबोट के लिए सिम्पटम-टू-डिजीज वर्गीकरण मॉडल।
- BERT for Patents. यह Google द्वारा दुनिया भर के 100M+ पेटेंट्स पर प्रशिक्षित मॉडल है। यह BERTlarge पर आधारित है।
BERT की सीमाओं को समझना
BERT के साथ LLMs से जुड़ी पारंपरिक सीमाएं और समस्याएं आती हैं। BERT की भविष्यवाणियां हमेशा उसके प्रशिक्षण में प्रयुक्त डेटा की मात्रा और गुणवत्ता पर आधारित होती हैं। यदि प्रशिक्षण डेटा सीमित, निम्न-गुणवत्ता वाला या पक्षपाती है, तो BERT गलत, हानिकारक परिणाम या तथाकथित LLM भ्रम उत्पन्न कर सकता है।
मूल BERT के मामले में, इसकी संभावना और भी अधिक है, क्योंकि मॉडल को Reinforcement Learning from Human Feedback (RLHF) के बिना प्रशिक्षित किया गया था—एक मानक तकनीक जिसे अधिक उन्नत मॉडल, जैसे ChatGPT, LLaMA 2, और Google Bard, AI सुरक्षा बढ़ाने हेतु उपयोग करते हैं। RLHF में प्रशिक्षण के दौरान LLM की सीखने की प्रक्रिया की निगरानी और दिशानिर्देशन के लिए मानवीय फीडबैक का उपयोग शामिल है, जिससे प्रभावी, सुरक्षित और विश्वसनीय प्रणालियां सुनिश्चित होती हैं।
इसके अलावा, यद्यपि इसे ChatGPT जैसे अन्य अत्याधुनिक LLMs की तुलना में एक छोटा मॉडल माना जा सकता है, फिर भी इसे चलाने के लिए पर्याप्त कंप्यूटिंग शक्ति चाहिए—शुरुआत से प्रशिक्षण देने की तो बात ही अलग है। अतः सीमित संसाधनों वाले डेवलपर्स शायद इसका उपयोग न कर सकें।
BERT और NLP का भविष्य
BERT आधुनिक LLMs में से एक शुरुआती मॉडल था। परंतु पुराने होने से बहुत दूर, BERT आज भी सबसे सफल और व्यापक रूप से उपयोग किए जाने वाले LLMs में से एक है। इसके ओपन-सोर्स स्वभाव के कारण, आज BERT के कई वैरिएंट्स और सैकड़ों प्री-ट्रेंड संस्करण उपलब्ध हैं, जो विशिष्ट NLP कार्यों के लिए डिजाइन किए गए हैं।
यदि आप BERT और हालिया NLP विकास के साथ अपडेट रहना चाहते हैं, तो DataCamp आपकी मदद के लिए तैयार है। हमारी क्यूरेटेड सामग्री देखें और वर्तमान जनरेटिव AI क्रांति पर नज़र बनाए रखें!


वैज्ञानिक प्रगति शायद ही कभी निर्वात में होती है। वे अक्सर संचित मानवीय ज्ञान पर बनी सीढ़ी के अंतिम से पहले वाले पायदान की तरह होती हैं। ChatGPT और Google Bart जैसे बड़े भाषा मॉडलों (LLMs) की सफलता समझने के लिए, हमें समय में पीछे जाना होगा और BERT के बारे में बात करनी होगी।
2018 में Google शोधकर्ताओं द्वारा विकसित, BERT शुरुआती LLMs में से एक है। अपनी चौंकाने वाली उपलब्धियों के साथ, यह सामान्य भाषा समझ, प्रश्न-उत्तर, और नेम्ड एंटिटी रिकग्निशन सहित NLP कार्यों में तेजी से सर्वव्यापी बेसलाइन बन गया।
LLMs के बारे में और जानने में रुचि है? आज ही हमारे Large Language Models (LLMs) Concepts कोर्स का अध्याय 1 शुरू करें।
यह कहना उचित होगा कि BERT ने उस जनरेटिव AI क्रांति के लिए राह बनाई जिसे हम आज देख रहे हैं। शुरुआती LLMs में से एक होने के बावजूद, BERT आज भी व्यापक रूप से इस्तेमाल होता है, और विशेष उपयोग मामलों—जैसे सेंटिमेंट एनालिसिस, क्लिनिकल नोट विश्लेषण, और टॉक्सिक कमेंट डिटेक्शन—के लिए हजारों ओपन-सोर्स, निःशुल्क, और प्री-ट्रेंड BERT मॉडल उपलब्ध हैं।
BERT के बारे में जिज्ञासा है? लेख पढ़ते रहें, जिसमें हम BERT की संरचना, तकनीक के आंतरिक कामकाज, इसके कुछ वास्तविक-जीवन अनुप्रयोग, और इसकी सीमाओं का अन्वेषण करेंगे।
BERT क्या है?
BERT (Bidirectional Encoder Representations from Transformers) एक ओपन-सोर्स मॉडल है जिसे 2018 में Google ने विकसित किया। यह तथाकथित ट्रांसफॉर्मर—एक अभिनव न्यूरल आर्किटेक्चर जिसे Google शोधकर्ताओं ने 2017 में प्रसिद्ध पेपर Attention is All You Need में प्रस्तुत किया—के प्रदर्शन को प्राकृतिक भाषा (NLP) कार्यों पर परखने का एक महत्वाकांक्षी प्रयोग था।
BERT की सफलता की कुंजी उसका ट्रांसफॉर्मर आर्किटेक्चर है। ट्रांसफॉर्मर्स के आने से पहले, प्राकृतिक भाषा का मॉडलिंग करना बहुत चुनौतीपूर्ण था। उन्नत न्यूरल नेटवर्क—यथा रिकरेंट या कन्वॉल्यूशनल न्यूरल नेटवर्क—के उभार के बावजूद, परिणाम केवल आंशिक रूप से सफल थे।
मुख्य चुनौती उस तंत्र में थी जिसका उपयोग न्यूरल नेटवर्क वाक्य में गुम शब्द की भविष्यवाणी करने के लिए करते थे। उस समय, अत्याधुनिक न्यूरल नेटवर्क एन्कोडर-डिकोडर आर्किटेक्चर पर निर्भर थे—एक शक्तिशाली, पर समय और संसाधन खपत करने वाला तंत्र, जो पैरेलल कंप्यूटिंग के लिए उपयुक्त नहीं था।
इन चुनौतियों को ध्यान में रखकर, Google शोधकर्ताओं ने अटेंशन मैकेनिज्म पर आधारित, ट्रांसफॉर्मर नामक एक अभिनव न्यूरल आर्किटेक्चर विकसित किया, जैसा कि अगला खंड समझाता है।
BERT कैसे काम करता है?
आइए देखें कि BERT कैसे काम करता है—मॉडल के पीछे की तकनीक, उसका प्रशिक्षण, और डेटा प्रोसेसिंग।
मुख्य संरचना और कार्यक्षमता
रिकरेंट और कन्वॉल्यूशनल न्यूरल नेटवर्क भविष्यवाणियां उत्पन्न करने के लिए अनुक्रमिक गणना का उपयोग करते हैं। यानी, बड़े डेटासेट पर प्रशिक्षित होने के बाद वे दिए गए शब्दों की श्रृंखला के बाद कौन सा शब्द आएगा, इसकी भविष्यवाणी कर सकते हैं। इस अर्थ में, उन्हें एक-दिशीय या संदर्भ-मुक्त एल्गोरिदम माना जाता था।
इसके विपरीत, ट्रांसफॉर्मर-समर्थित मॉडल जैसे BERT—जो एन्कोडर-डिकोडर आर्किटेक्चर पर भी आधारित हैं—द्विदिश होते हैं क्योंकि वे पिछले और अगले दोनों शब्दों के आधार पर शब्दों की भविष्यवाणी करते हैं। यह सेल्फ-अटेंशन मैकेनिज्म के माध्यम से प्राप्त होता है—एक परत जो एन्कोडर और डिकोडर दोनों में शामिल होती है। अटेंशन परत का लक्ष्य इनपुट वाक्य के विभिन्न शब्दों के बीच मौजूद संदर्भात्मक संबंधों को पकड़ना है।
आज कई प्री-ट्रेंड BERT संस्करण उपलब्ध हैं, पर मूल पेपर में Google ने दो संस्करण प्रशिक्षित किए: BERTbase और BERTlarge, विभिन्न न्यूरल आर्किटेक्चर के साथ। मूलतः, BERTbase में 12 ट्रांसफॉर्मर लेयर, 12 अटेंशन लेयर, और 110 मिलियन पैरामीटर थे, जबकि BERTlarge में 24 ट्रांसफॉर्मर लेयर, 16 अटेंशन लेयर, और 340 मिलियन पैरामीटर थे। अपेक्षा के अनुरूप, शुद्धता परीक्षणों में BERTlarge ने छोटे संस्करण को पीछे छोड़ा।
ट्रांसफॉर्मर्स में एन्कोडर-डिकोडर आर्किटेक्चर कैसे काम करता है, यह विस्तार से जानने के लिए, हम आपको हमारा Introduction to Using Transformers and Hugging Face पढ़ने की अत्यंत अनुशंसा करते हैं।
ट्रांसफॉर्मर्स की आर्किटेक्चर का एक स्पष्टीकरण
प्री-ट्रेनिंग और फाइन-ट्यूनिंग
ट्रांसफॉर्मर्स को शुरुआत से ही विशाल डेटा कॉर्पस पर प्रशिक्षित किया जाता है—यह एक समयसाध्य और महंगा प्रक्रिया है (जिसे केवल सीमित कंपनियां, जिनमें Google शामिल है, वहन कर सकती हैं)।
BERT के मामले में, इसे चार दिनों तक Wikipedia (~2.5B शब्द) और Google के BooksCorpus (~800M शब्द) पर प्री-ट्रेन किया गया। इससे मॉडल को केवल अंग्रेजी में ही नहीं, बल्कि दुनिया की कई अन्य भाषाओं में भी ज्ञान अर्जित करने में मदद मिली।
प्रशिक्षण प्रक्रिया को अनुकूलित करने के लिए, Google ने नया हार्डवेयर विकसित किया—TPU (Tensor Processing Unit)—जो विशेष रूप से मशीन लर्निंग कार्यों के लिए डिज़ाइन किया गया है।
प्रशिक्षण प्रक्रिया में अनावश्यक और महंगी अंतःक्रियाओं से बचने के लिए, Google शोधकर्ताओं ने ट्रांसफर लर्निंग तकनीकों का उपयोग कर (प्री)ट्रेनिंग चरण को फाइन-ट्यूनिंग चरण से अलग किया। इससे डेवलपर्स प्री-ट्रेंड मॉडल चुन सकते हैं, लक्षित कार्य के इनपुट-आउटपुट पेयर डेटा को परिष्कृत कर सकते हैं, और डोमेन-विशिष्ट डेटा का उपयोग करके प्री-ट्रेंड मॉडल के हेड को पुन:प्रशिक्षित कर सकते हैं। यही विशेषता BERT जैसे LLMs को उन पर निर्मित अनंत अनुप्रयोगों का फाउंडेशन मॉडल बनाती है।
BERT की प्रोसेसिंग में Masked Language Modeling की भूमिका
BERT (और ट्रांसफॉर्मर्स-आधारित हर LLM) में द्विदिश सीख हासिल करने का प्रमुख तत्व अटेंशन मैकेनिज्म है। यह तंत्र मास्क्ड लैंग्वेज मॉडलिंग (MLM) पर आधारित है। किसी वाक्य में एक शब्द को मास्क करके, यह तकनीक मॉडल को वाक्य के शेष शब्दों का दोनों दिशाओं में विश्लेषण करने के लिए बाध्य करती है, ताकि मास्क किए गए शब्द की भविष्यवाणी की संभावना बढ़े। MLM, कंप्यूटर विज़न क्षेत्र में पहले से आजमाई गई तकनीकों पर आधारित है, और यह उन कार्यों के लिए शानदार है जिनमें पूरी श्रृंखला की अच्छी संदर्भात्मक समझ आवश्यक होती है।
यह तकनीक लागू करने वाला पहला LLM BERT था। विशेष रूप से, प्रशिक्षण के दौरान टोकनाइज़ किए गए शब्दों में से यादृच्छिक 15% को मास्क किया गया। परिणामों से पता चला कि BERT छिपे हुए शब्दों की उच्च सटीकता से भविष्यवाणी कर सका।
मास्क्ड लैंग्वेज मॉडलिंग के बारे में जिज्ञासा है? इस अभिनव तकनीक के सभी विवरण जानने के लिए हमारा Large Language Models (LLMs) Concepts Course देखें।
BERT का उपयोग किस लिए होता है? NLP पर BERT का प्रभाव
ट्रांसफॉर्मर्स द्वारा समर्थित, BERT कई NLP कार्यों में अत्याधुनिक परिणाम देने में सक्षम रहा। यहां कुछ परीक्षण हैं जिनमें BERT उत्कृष्ट रहा है:
BERT के वास्तविक-जीवन अनुप्रयोग
कई LLMs का प्रयोगात्मक सेटअप में परीक्षण हुआ है, पर बहुत कम ही सुव्यवस्थित अनुप्रयोगों में जोड़े गए हैं। BERT इसका अपवाद है—इसे हर दिन लाखों लोग इस्तेमाल करते हैं (भले हम इससे अनभिज्ञ हों)।
इसका एक शानदार उदाहरण Google Search है। 2020 में, Google ने घोषणा की कि उसने 70 से अधिक भाषाओं में Google Search के माध्यम से BERT अपनाया है। इसका अर्थ है कि Google सामग्री की रैंकिंग और फ़ीचर्ड स्निपेट प्रदर्शित करने के लिए BERT का उपयोग करता है। अटेंशन मैकेनिज्म के साथ, Google अब आपके प्रश्न के संदर्भ का उपयोग कर उपयोगी जानकारी प्रदान कर सकता है, जैसा कि निम्न उदाहरण में दिखाया गया है।
स्रोत: Google
BERT के वैरिएंट और अनुकूलन
लेकिन कहानी यहीं खत्म नहीं होती। BERT की सफलता काफी हद तक इसके ओपन-सोर्स स्वभाव के कारण है, जिसने डेवलपर्स को मूल BERT के सोर्स कोड तक पहुंच दी और नई विशेषताएं व सुधार विकसित करने में सक्षम बनाया।
इससे BERT के कई वैरिएंट सामने आए हैं। नीचे कुछ सबसे चर्चित वैरिएंट दिए गए हैं:
यदि आप ओपन-सोर्स LLM आंदोलन के बारे में और जानना चाहते हैं, तो हम अत्यधिक सलाह देते हैं कि आप हमारा 2023 के शीर्ष ओपन-सोर्स LLMs पर पोस्ट पढ़ें।
विशिष्ट कार्यों के लिए BERT का फाइन-ट्यून करना
BERT—और सामान्यतः LLMs—की सबसे बड़ी खूबियों में से एक यह है कि प्री-ट्रेनिंग प्रक्रिया फाइन-ट्यूनिंग प्रक्रिया से अलग होती है। यानी डेवलपर्स BERT के प्री-ट्रेंड संस्करण ले सकते हैं और उन्हें अपने विशेष उपयोग मामलों के लिए अनुकूलित कर सकते हैं।
BERT के मामले में, विविध NLP कार्यों के लिए विकसित BERT के सैकड़ों फाइन-ट्यून किए गए संस्करण मौजूद हैं। नीचे BERT के फाइन-ट्यून किए गए संस्करणों की एक अत्यंत सीमित सूची दी गई है:
BERT की सीमाओं को समझना
BERT के साथ LLMs से जुड़ी पारंपरिक सीमाएं और समस्याएं आती हैं। BERT की भविष्यवाणियां हमेशा उसके प्रशिक्षण में प्रयुक्त डेटा की मात्रा और गुणवत्ता पर आधारित होती हैं। यदि प्रशिक्षण डेटा सीमित, निम्न-गुणवत्ता वाला या पक्षपाती है, तो BERT गलत, हानिकारक परिणाम या तथाकथित LLM भ्रम उत्पन्न कर सकता है।
मूल BERT के मामले में, इसकी संभावना और भी अधिक है, क्योंकि मॉडल को Reinforcement Learning from Human Feedback (RLHF) के बिना प्रशिक्षित किया गया था—एक मानक तकनीक जिसे अधिक उन्नत मॉडल, जैसे ChatGPT, LLaMA 2, और Google Bard, AI सुरक्षा बढ़ाने हेतु उपयोग करते हैं। RLHF में प्रशिक्षण के दौरान LLM की सीखने की प्रक्रिया की निगरानी और दिशानिर्देशन के लिए मानवीय फीडबैक का उपयोग शामिल है, जिससे प्रभावी, सुरक्षित और विश्वसनीय प्रणालियां सुनिश्चित होती हैं।
इसके अलावा, यद्यपि इसे ChatGPT जैसे अन्य अत्याधुनिक LLMs की तुलना में एक छोटा मॉडल माना जा सकता है, फिर भी इसे चलाने के लिए पर्याप्त कंप्यूटिंग शक्ति चाहिए—शुरुआत से प्रशिक्षण देने की तो बात ही अलग है। अतः सीमित संसाधनों वाले डेवलपर्स शायद इसका उपयोग न कर सकें।
BERT और NLP का भविष्य
BERT आधुनिक LLMs में से एक शुरुआती मॉडल था। परंतु पुराने होने से बहुत दूर, BERT आज भी सबसे सफल और व्यापक रूप से उपयोग किए जाने वाले LLMs में से एक है। इसके ओपन-सोर्स स्वभाव के कारण, आज BERT के कई वैरिएंट्स और सैकड़ों प्री-ट्रेंड संस्करण उपलब्ध हैं, जो विशिष्ट NLP कार्यों के लिए डिजाइन किए गए हैं।
यदि आप BERT और हालिया NLP विकास के साथ अपडेट रहना चाहते हैं, तो DataCamp आपकी मदद के लिए तैयार है। हमारी क्यूरेटेड सामग्री देखें और वर्तमान जनरेटिव AI क्रांति पर नज़र बनाए रखें!