
Khóa học
Khai thác đặc trưng cho NLP bằng Python
4 giờ
29.7K
Đột phá khoa học hiếm khi xảy ra trong khoảng không. Thay vào đó, chúng thường là bước áp chót trên một nấc thang được xây dựng từ tri thức tích lũy của nhân loại. Để hiểu thành công của các mô hình ngôn ngữ lớn (LLM) như ChatGPT và Google Bard, chúng ta cần quay ngược thời gian và nói về BERT.
Được phát triển vào năm 2018 bởi các nhà nghiên cứu Google, BERT là một trong những LLM đầu tiên. Với những kết quả đáng kinh ngạc, nó nhanh chóng trở thành chuẩn tham chiếu phổ biến trong các tác vụ NLP, bao gồm hiểu ngôn ngữ tổng quát, hỏi & đáp và nhận dạng thực thể có tên.
Quan tâm tìm hiểu thêm về LLM? Hãy bắt đầu Chương 1 trong khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) của chúng tôi ngay hôm nay.
Có thể nói BERT đã mở đường cho cuộc cách mạng AI sinh tạo mà chúng ta đang chứng kiến hiện nay. Dù là một trong những LLM đầu tiên, BERT vẫn được sử dụng rộng rãi, với hàng nghìn mô hình BERT mã nguồn mở, miễn phí và được huấn luyện sẵn cho các trường hợp sử dụng cụ thể như phân tích cảm xúc, phân tích ghi chú lâm sàng và phát hiện bình luận độc hại.
Tò mò về BERT? Tiếp tục đọc bài viết, chúng ta sẽ khám phá kiến trúc của BERT, cơ chế vận hành bên trong công nghệ, một số ứng dụng thực tế và các hạn chế của nó.
BERT (viết tắt của Bidirectional Encoder Representations from Transformers) là một mô hình mã nguồn mở do Google phát triển năm 2018. Đây là một thử nghiệm đầy tham vọng nhằm kiểm tra hiệu năng của cái gọi là transformer – một kiến trúc nơ-ron đổi mới do các nhà nghiên cứu Google trình bày trong bài báo nổi tiếng Attention is All You Need năm 2017 – trên các tác vụ xử lý ngôn ngữ tự nhiên (NLP).
Chìa khóa thành công của BERT nằm ở kiến trúc transformer. Trước khi transformer ra đời, việc mô hình hóa ngôn ngữ tự nhiên là một nhiệm vụ rất thách thức. Dù đã xuất hiện các mạng nơ-ron tinh vi – như tái hồi hay tích chập – kết quả chỉ thành công một phần.
Thách thức chính nằm ở cơ chế các mạng nơ-ron dùng để dự đoán từ thiếu trong câu. Khi đó, các mạng nơ-ron tối tân dựa vào kiến trúc mã hóa - giải mã, một cơ chế mạnh mẽ nhưng tốn thời gian và tài nguyên, không phù hợp cho tính toán song song.
Với những thách thức này, các nhà nghiên cứu Google đã phát triển transformer, một kiến trúc nơ-ron đổi mới dựa trên cơ chế attention, như giải thích ở phần tiếp theo.
Hãy cùng xem BERT hoạt động ra sao, bao gồm công nghệ đằng sau mô hình, cách nó được huấn luyện và cách nó xử lý dữ liệu.
Các mạng nơ-ron tái hồi và tích chập sử dụng tính toán tuần tự để tạo dự đoán. Tức là, sau khi được huấn luyện trên các bộ dữ liệu khổng lồ, chúng có thể dự đoán từ sẽ theo sau một chuỗi từ đã cho. Theo nghĩa đó, chúng được xem là các thuật toán một chiều hoặc không xét ngữ cảnh.
Ngược lại, các mô hình dùng transformer như BERT, vốn cũng dựa trên kiến trúc mã hóa - giải mã, là hai chiều vì chúng dự đoán từ dựa trên cả các từ đứng trước và đứng sau. Điều này đạt được thông qua cơ chế tự chú ý (self-attention), một lớp được tích hợp ở cả bộ mã hóa và bộ giải mã. Mục tiêu của lớp attention là nắm bắt các quan hệ ngữ cảnh giữa các từ khác nhau trong câu đầu vào.
Ngày nay có nhiều phiên bản BERT được huấn luyện sẵn, nhưng trong bài báo gốc, Google đã huấn luyện hai phiên bản: BERTbase và BERTlarge với kiến trúc nơ-ron khác nhau. Về bản chất, BERTbase có 12 lớp transformer, 12 lớp attention và 110 triệu tham số, trong khi BERTlarge dùng 24 lớp transformer, 16 lớp attention và 340 triệu tham số. Đúng như dự đoán, BERTlarge vượt trội hơn phiên bản nhỏ hơn trong các bài kiểm tra độ chính xác.
Để hiểu chi tiết kiến trúc mã hóa - giải mã hoạt động trong transformer như thế nào, chúng tôi rất khuyến nghị bạn đọc Giới thiệu về Cách sử dụng Transformers và Hugging Face của chúng tôi.
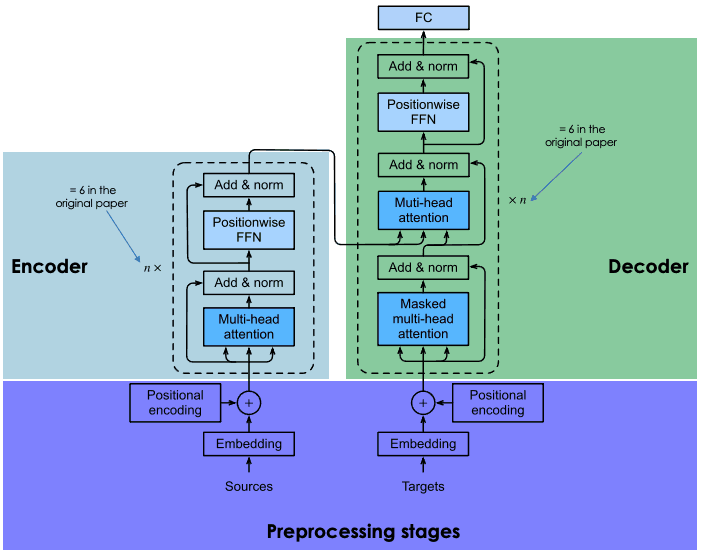
Giải thích về kiến trúc của transformer
Transformer được huấn luyện từ đầu trên một kho dữ liệu khổng lồ, theo một quy trình tốn thời gian và chi phí (chỉ một số ít công ty, bao gồm Google, có thể kham nổi).
Với BERT, mô hình được tiền huấn luyện trong bốn ngày trên Wikipedia (~2,5 tỷ từ) và BooksCorpus của Google (~800 triệu từ). Điều này cho phép mô hình tích lũy kiến thức không chỉ bằng tiếng Anh mà còn ở nhiều ngôn ngữ khác trên thế giới.
Để tối ưu quá trình huấn luyện, Google đã phát triển phần cứng mới gọi là TPU (Tensor Processing Unit), được thiết kế chuyên biệt cho các tác vụ học máy.
Để tránh những tương tác không cần thiết và tốn kém trong quá trình huấn luyện, các nhà nghiên cứu Google đã sử dụng kỹ thuật học chuyển giao để tách giai đoạn (tiền) huấn luyện khỏi giai đoạn tinh chỉnh. Điều này cho phép nhà phát triển chọn các mô hình đã tiền huấn luyện, tinh chỉnh dữ liệu cặp vào - ra của tác vụ mục tiêu và huấn luyện lại phần đầu của mô hình tiền huấn luyện bằng dữ liệu chuyên biệt theo lĩnh vực. Chính đặc tính này khiến các LLM như BERT trở thành mô hình nền tảng cho vô vàn ứng dụng xây dựng phía trên.
Yếu tố then chốt để đạt học hai chiều trong BERT (và mọi LLM dựa trên transformer) là cơ chế attention. Cơ chế này dựa trên mô hình hóa ngôn ngữ che mặt (MLM). Bằng cách che một từ trong câu, kỹ thuật này buộc mô hình phân tích các từ còn lại theo cả hai chiều trong câu để tăng khả năng dự đoán từ bị che. MLM dựa trên các kỹ thuật đã thử nghiệm trong lĩnh vực thị giác máy tính, và rất phù hợp cho các tác vụ yêu cầu hiểu ngữ cảnh tốt của cả một chuỗi.
BERT là LLM đầu tiên áp dụng kỹ thuật này. Cụ thể, 15% ngẫu nhiên các từ đã được mã hóa (tokenized) bị che trong quá trình huấn luyện. Kết quả cho thấy BERT có thể dự đoán các từ ẩn với độ chính xác cao.
Tò mò về mô hình hóa ngôn ngữ che mặt? Hãy xem Khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) để tìm hiểu mọi chi tiết về kỹ thuật đổi mới này.
Nhờ transformer, BERT đạt kết quả dẫn đầu ở nhiều tác vụ NLP. Dưới đây là một số bài kiểm tra nơi BERT vượt trội:
Nhiều LLM được thử nghiệm trong môi trường thí nghiệm, nhưng không nhiều mô hình được đưa vào các ứng dụng ổn định. Điều này không đúng với BERT, mô hình được hàng triệu người sử dụng hằng ngày (dù chúng ta có thể không nhận ra).
Một ví dụ điển hình là Tìm kiếm Google. Năm 2020, Google công bố đã áp dụng BERT trong Google Search trên hơn 70 ngôn ngữ. Điều đó có nghĩa Google sử dụng BERT để xếp hạng nội dung và hiển thị đoạn trích nổi bật. Nhờ cơ chế attention, Google nay có thể sử dụng ngữ cảnh câu hỏi của bạn để cung cấp thông tin hữu ích, như minh họa trong ví dụ sau.
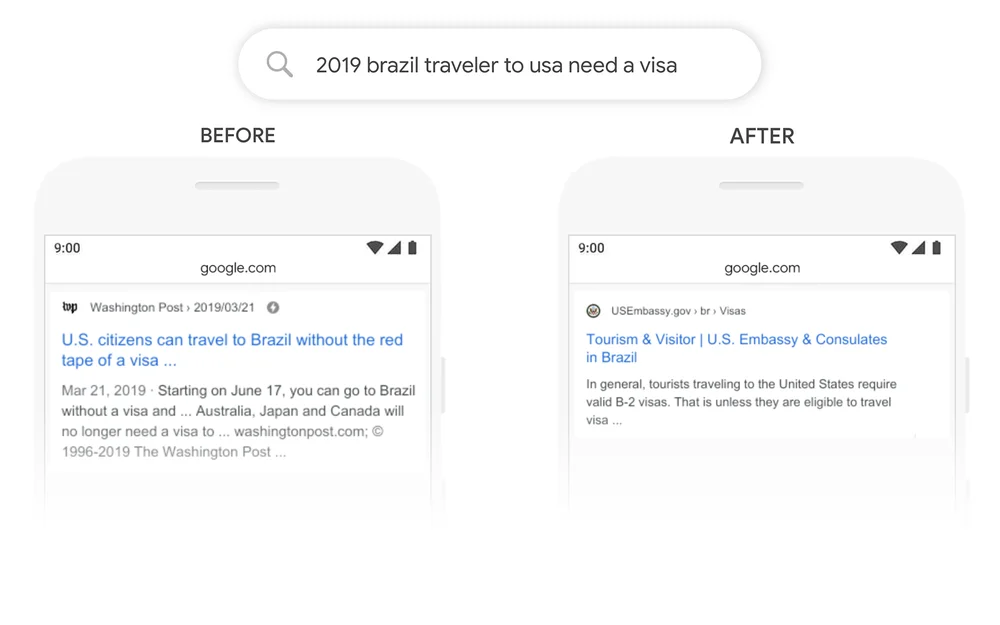
Nguồn: Google
Nhưng đó chỉ là một phần câu chuyện. Thành công của BERT phần lớn nhờ tính mã nguồn mở, cho phép nhà phát triển truy cập mã nguồn BERT gốc và tạo ra các tính năng, cải tiến mới.
Điều này đã tạo ra khá nhiều biến thể của BERT. Dưới đây là một số biến thể nổi tiếng:
Nếu bạn muốn biết thêm về phong trào LLM mã nguồn mở, chúng tôi rất khuyến nghị đọc bài viết Tổng hợp các LLM Mã nguồn Mở Hàng đầu năm 2023 của chúng tôi
Một trong những điều tuyệt vời nhất về BERT, và LLM nói chung, là quá trình tiền huấn luyện được tách biệt khỏi quá trình tinh chỉnh. Điều đó có nghĩa nhà phát triển có thể lấy các phiên bản BERT đã tiền huấn luyện và tùy biến cho trường hợp sử dụng cụ thể của mình.
Với BERT, có hàng trăm phiên bản đã được tinh chỉnh cho nhiều tác vụ NLP đa dạng. Dưới đây là một danh sách rất, rất hạn chế các phiên bản tinh chỉnh của BERT:
BERT đi kèm các hạn chế và vấn đề truyền thống gắn với LLM. Dự đoán của BERT luôn dựa trên số lượng và chất lượng dữ liệu dùng để huấn luyện nó. Nếu dữ liệu huấn luyện hạn chế, kém chất lượng và thiên lệch, BERT có thể đưa ra kết quả không chính xác, gây hại hoặc thậm chí xuất hiện ảo giác LLM.
Với BERT gốc, điều này càng dễ xảy ra hơn, vì mô hình được huấn luyện mà không có Học Tăng cường từ Phản hồi Con người (RLHF), một kỹ thuật tiêu chuẩn được các mô hình tiên tiến hơn như ChatGPT, LLaMA 2 và Google Bard sử dụng để tăng cường an toàn AI. RLHF liên quan đến việc dùng phản hồi của con người để giám sát và điều hướng quá trình học của LLM trong khi huấn luyện, qua đó đảm bảo hệ thống hiệu quả, an toàn và đáng tin cậy hơn.
Hơn nữa, dù có thể coi là mô hình nhỏ so với các LLM tối tân khác như ChatGPT, BERT vẫn đòi hỏi lượng sức mạnh tính toán đáng kể để vận hành, chưa nói đến huấn luyện từ đầu. Do đó, các nhà phát triển có nguồn lực hạn chế có thể không thể sử dụng nó.
BERT là một trong những LLM hiện đại đầu tiên. Nhưng không hề lỗi thời, BERT vẫn là một trong những LLM thành công và được sử dụng rộng rãi nhất. Nhờ tính mã nguồn mở, ngày nay có nhiều biến thể và hàng trăm phiên bản BERT đã tiền huấn luyện cho các tác vụ NLP cụ thể.
Nếu bạn muốn cập nhật về BERT và các phát triển NLP gần đây, DataCamp luôn sẵn sàng hỗ trợ. Hãy khám phá tài liệu tuyển chọn của chúng tôi và theo dõi sát cuộc cách mạng AI sinh tạo hiện tại!
Bắt đầu hành trình NLP của bạn ngay hôm nay!
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
