Bilimsel atılımlar nadiren bir boşlukta gerçekleşir. Genellikle, biriken insan bilgisinin üzerine inşa edilen bir merdivenin sondan bir önceki basamağıdır. ChatGPT ve Google Bart gibi büyük dil modellerinin (LLM’ler) başarısını anlamak için geçmişe dönüp BERT’ten bahsetmemiz gerekir.
2018’de Google araştırmacıları tarafından geliştirilen BERT, ilk LLM’lerden biridir. Çarpıcı sonuçlarıyla genel dil anlama, soru-cevap ve adlandırılmış varlık tanıma dahil olmak üzere NLP görevlerinde hızla yaygın bir kıyaslama standardı haline geldi.
LLM’ler hakkında daha fazla bilgi edinmek ister misiniz? Bugün Büyük Dil Modelleri (LLM’ler) Kavramları kursumuzun 1. Bölümüne başlayın.
Bugün tanık olduğumuz üretken yapay zekâ devrimine giden yolu BERT’in açtığını söylemek yanlış olmaz. İlk LLM’lerden biri olmasına rağmen BERT hâlâ yaygın biçimde kullanılıyor; duygu analizi, klinik not analizi ve toksik yorum tespiti gibi belirli kullanım senaryoları için binlerce açık kaynaklı, ücretsiz ve önceden eğitilmiş BERT modeli mevcut.
BERT hakkında meraklı mısınız? Bu makaleyi okumaya devam edin; BERT’in mimarisini, teknolojinin iç işleyişini, bazı gerçek dünya uygulamalarını ve sınırlamalarını inceleyeceğiz.
BERT Nedir?
BERT (Bidirectional Encoder Representations from Transformers), 2018’de Google tarafından geliştirilen açık kaynaklı bir modeldir. 2017’de Google araştırmacılarının ünlü Attention is All You Need makalesinde sunduğu yenilikçi sinir mimarisi olan transformer’ın doğal dil işleme (NLP) görevlerindeki performansını test etmek için iddialı bir deneydi.
BERT’in başarısının anahtarı transformer mimarisidir. Transformer’lardan önce doğal dili modellemek oldukça zorlu bir görevdi. Gelişmiş sinir ağlarının yükselişine –özellikle tekrarlayan veya evrişimsel sinir ağlarına– rağmen sonuçlar yalnızca kısmen başarılıydı.
Başlıca zorluk, sinir ağlarının bir cümledeki eksik kelimeyi tahmin etmek için kullandığı mekanizmada yatıyordu. O dönemde en iyi sinir ağları, paralel hesaplama için uygun olmayan, güçlü ama zaman ve kaynak tüketen bir mekanizma olan encoder-decoder mimarisine dayanıyordu.
Bu zorlukları göz önünde bulunduran Google araştırmacıları, bir sonraki bölümde açıklandığı gibi dikkat (attention) mekanizmasına dayalı yenilikçi bir sinir mimarisi olan transformer’ı geliştirdi.
BERT Nasıl Çalışır?
BERT’in nasıl çalıştığına bakalım; modelin arkasındaki teknoloji, nasıl eğitildiği ve veriyi nasıl işlediğini ele alacağız.
Temel mimari ve işlevsellik
Tekrarlayan ve evrişimsel sinir ağları, tahmin üretmek için sıralı hesaplama kullanır. Yani, büyük veri kümeleri üzerinde eğitildikten sonra, verilen bir kelime dizisini hangi kelimenin takip edeceğini öngörebilirler. Bu bakımdan tek yönlü veya bağlamdan bağımsız algoritmalar olarak kabul edilirlerdi.
Buna karşılık, encoder-decoder mimarisine dayanan ve BERT gibi transformer destekli modeller iki yönlüdür; çünkü kelimeleri hem önceki hem de sonraki kelimelere dayanarak tahmin ederler. Bu, hem encoder’a hem decoder’a dahil edilen öz-dikkat (self-attention) katmanı sayesinde başarılır. Dikkat katmanının amacı, giriş cümlesindeki farklı kelimeler arasındaki bağlamsal ilişkileri yakalamaktır.
Günümüzde birçok önceden eğitilmiş BERT sürümü vardır, ancak orijinal makalede Google iki BERT sürümü eğitti: farklı sinir mimarilerine sahip BERTbase ve BERTlarge. Özetle, BERTbase 12 transformer katmanı, 12 dikkat katmanı ve 110 milyon parametreyle geliştirilirken, BERTlarge 24 transformer katmanı, 16 dikkat katmanı ve 340 milyon parametre kullandı. Bekleneceği üzere, BERTlarge doğruluk testlerinde daha küçük kardeşini geride bıraktı.
Transformer’larda encoder-decoder mimarisinin ayrıntılı olarak nasıl çalıştığını öğrenmek için Transformers ve Hugging Face Kullanımına Giriş yazımızı okumanızı önemle tavsiye ederiz.
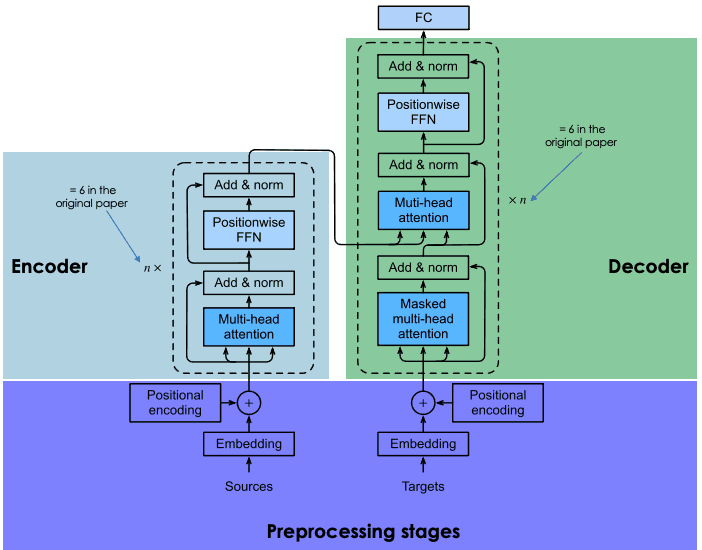
Transformer mimarisinin açıklaması
Ön eğitim ve ince ayar
Transformer’lar, yalnızca sınırlı sayıda şirketin (Google dahil) karşılayabildiği, zaman alıcı ve pahalı bir süreçle devasa bir veri külliyatı üzerinde sıfırdan eğitilir.
BERT’in özelinde, model dört gün boyunca Wikipedia (~2,5 milyar kelime) ve Google’ın BooksCorpus’u (~800 milyon kelime) üzerinde önceden eğitildi. Bu, modele yalnızca İngilizce değil, dünyadaki birçok diğer dil hakkında da bilgi kazandırır.
Eğitim sürecini optimize etmek için Google, makine öğrenimi görevleri için özel olarak tasarlanmış TPU (Tensor Processing Unit) adlı yeni bir donanım geliştirdi.
Eğitim sürecindeki gereksiz ve maliyetli etkileşimlerden kaçınmak için Google araştırmacıları, (ön) eğitim aşamasını ince ayar aşamasından ayırmak üzere transfer öğrenimi tekniklerini kullandı. Bu sayede geliştiriciler, önceden eğitilmiş modelleri seçip hedef görevin giriş-çıkış çift verilerini rafine edebilir ve önceden eğitilmiş modelin tepe katmanını alanına özgü verilerle yeniden eğitebilir. Bu özellik, BERT gibi LLM’leri üzerlerine inşa edilen sayısız uygulamanın temel modeli yapan şeydir.
BERT’in işlemesinde Maskeli Dil Modellemenin rolü
BERT’te (ve transformer tabanlı her LLM’de) iki yönlü öğrenmeyi mümkün kılan kilit unsur dikkat mekanizmasıdır. Bu mekanizma, maskeli dil modelleme (MLM) üzerine kuruludur. Bir cümledeki bir kelimeyi maskeleyerek, bu teknik modelin cümledeki kalan kelimeleri her iki yönde de analiz etmesini ve maskelenen kelimeyi tahmin etme olasılığını artırmasını sağlar. MLM, bilgisayarlı görü alanında daha önce denenmiş tekniklere dayanır ve tüm bir dizinin iyi bir bağlamsal anlaşılmasını gerektiren görevler için uygundur.
Bu tekniği uygulayan ilk LLM BERT’ti. Özellikle, eğitim sırasında belirteçlenmiş kelimelerin rastgele %15’i maskelendi. Sonuç, BERT’in gizli kelimeleri yüksek doğrulukla tahmin edebildiğini gösterdi.
Maskeli dil modelleme hakkında meraklı mısınız? Bu yenilikçi tekniğin tüm ayrıntılarını öğrenmek için Büyük Dil Modelleri (LLM’ler) Kavramları Kursumuza göz atın.
BERT Ne İçin Kullanılır? BERT’in NLP Üzerindeki Etkisi
Transformer’larla güçlendirilen BERT, birden fazla NLP görevinde son teknoloji sonuçlara ulaştı. BERT’in öne çıktığı bazı testler şunlardır:
- Soru-cevap. BERT, etkileyici sonuçlar veren ilk transformer destekli sohbet botlarından biri olmuştur.
- Duygu analizi. Örneğin, BERT film eleştirileri için olumlu ya da olumsuz ton tahmininde başarılı olmuştur.
- Metin üretimi. Yeni nesil sohbet botlarının öncüsü olan BERT, basit istemlerle uzun metinler oluşturabiliyordu.
- Metin özetleme. Benzer şekilde, BERT hukuk ve sağlık gibi karmaşık alanlardaki metinleri okuyup özetleyebiliyordu.
- Dil çevirisi. BERT, birden çok dilde yazılmış veriler üzerinde eğitildi. Bu da onu çok dilli bir model yapar ve dil çevirisi için oldukça uygun hale getirir.
- Otomatik tamamlama görevleri. BERT, e-posta veya mesajlaşma servislerinde olduğu gibi otomatik tamamlama görevleri için kullanılabilir.
BERT’in Gerçek Dünya Uygulamaları
Birçok LLM deneysel ortamlarda denendi, ancak pek azı yerleşik uygulamalara entegre edildi. BERT için durum böyle değil; her gün milyonlarca insan tarafından kullanılıyor (çoğu zaman bunun farkında olmasak da).
Harika bir örnek Google Arama’dır. 2020’de Google, 70’ten fazla dilde Google Arama üzerinden BERT’i benimsediğini duyurdu. Bu, Google’ın içerikleri sıralamak ve öne çıkan pasajları göstermek için BERT’i kullandığı anlamına gelir. Dikkat mekanizmasıyla Google artık sorunuzun bağlamını kullanarak faydalı bilgiler sunabiliyor; aşağıdaki örnekte gösterildiği gibi.
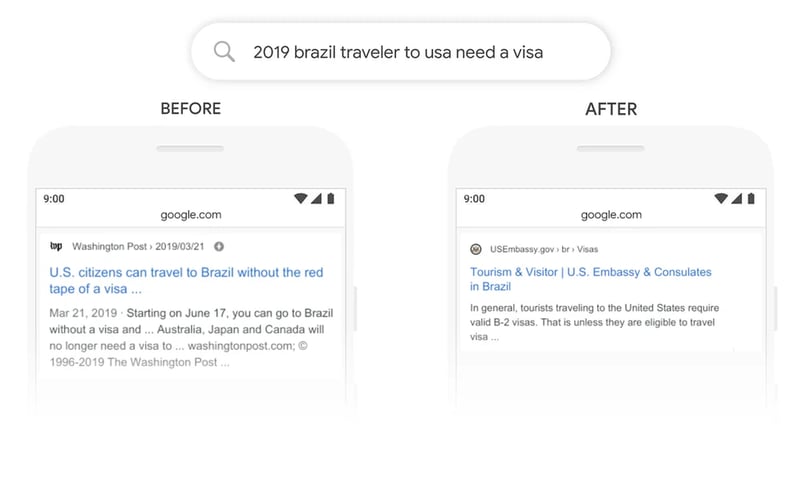
Kaynak: Google
BERT’in varyantları ve uyarlamaları
Ancak bu, hikâyenin yalnızca bir kısmı. BERT’in başarısı büyük ölçüde açık kaynak doğasından kaynaklanır; bu sayede geliştiriciler orijinal BERT’in kaynak koduna erişip yeni özellikler ve iyileştirmeler oluşturabildiler.
Bunun sonucunda BERT’in çok sayıda varyantı ortaya çıktı. Aşağıda en bilinen varyantlardan bazılarını bulabilirsiniz:
- RoBERTa. “Robustly Optimized BERT Approach”ın kısaltması olan RoBERTa, Meta’nın Washington University işbirliğiyle oluşturduğu bir BERT varyantıdır. Orijinal BERT’ten daha güçlü bir sürüm olarak kabul edilen RoBERTa, BERT’i eğitmekte kullanılanın 10 katı daha büyük bir veri kümesiyle eğitildi. Mimari açısından en belirgin fark, statik maskeleme öğrenimi yerine dinamik maskeleme öğreniminin kullanılmasıdır. Eğitim verisini çoğaltıp her seferinde farklı bir maskeleme stratejisiyle 10 kez maskeleyen bu teknik, RoBERTa’nın kelimelerin daha sağlam ve genellenebilir temsillerini öğrenmesini sağladı.
- DistilBERT. 2010’ların sonlarında ilk LLM’lerin çıkışından bu yana, daha büyük ve daha ağır LLM’ler inşa etme yönünde yerleşik bir eğilim var. Bu mantıklı; zira model boyutu ile doğruluğu arasında doğrudan bir ilişki var gibi görünüyor. Ancak model büyüdükçe çalıştırmak için daha fazla kaynağa ihtiyaç duyulduğu ve dolayısıyla daha az kişinin bunu karşılayabildiği de bir gerçek. DistilBERT, daha küçük, daha hızlı, daha ucuz ve daha hafif bir varyant sunarak BERT’i daha erişilebilir kılmayı amaçlar. Orijinal BERT mimarisine dayanan DistilBERT, ön eğitim sırasında bilgi damıtma teknikleri kullanarak boyutu %40 azaltırken dil anlama kabiliyetlerinin %97’sini korur ve %60 daha hızlı çalışır.
- ALBERT. “A Lite BERT”in kısaltması olan ALBERT, ön eğitim sırasında BERTlarge’ın verimliliğini artırmak üzere özel olarak tasarlandı. Daha büyük modellerin eğitimi sıklıkla bellek sınırlamalarına, daha uzun eğitim sürelerine ve beklenmedik model bozulmalarına yol açtığından, ALBERT’in yaratıcıları eğitim sırasında bellek tüketimini azaltmak ve hızı artırmak için iki parametre azaltma tekniği geliştirdi.
Açık kaynak LLM hareketi hakkında daha fazla bilgi edinmek isterseniz, 2023’ün En İyi Açık Kaynak LLM’lerini içeren yazımızı okumanızı şiddetle tavsiye ederiz.
BERT’in belirli görevler için ince ayarı
BERT’in ve genel olarak LLM’lerin en güzel yanlarından biri, ön eğitim sürecinin ince ayar sürecinden ayrılmış olmasıdır. Bu da geliştiricilerin, BERT’in önceden eğitilmiş sürümlerini alarak kendi özel kullanım durumlarına göre özelleştirebilecekleri anlamına gelir.
BERT özelinde, çok çeşitli NLP görevleri için geliştirilmiş yüzlerce ince ayarlı sürüm vardır. Aşağıda, BERT’in ince ayarlı sürümlerine dair çok, ama çok sınırlı bir liste bulabilirsiniz:
- BERT-base-chinese. Çince NLP görevleri için eğitilmiş bir BERTbase sürümü
- BERT-base-NER. Adlandırılmış varlık tanıma için özelleştirilmiş bir BERTbase sürümü
- Symps_disease_bert_v3_c41. Doğal dil sohbet botu için semptomdan hastalığa sınıflandırma modeli.
- BERT for Patents. Google tarafından dünya genelinde 100 milyondan fazla patent üzerinde eğitilen bir modeldir. BERTlarge’a dayanır.
BERT’in Sınırlamalarını Anlamak
BERT, LLM’lerle ilişkili geleneksel sınırlamalar ve sorunlarla birlikte gelir. BERT’in tahminleri, her zaman eğitiminde kullanılan verinin niceliğine ve niteliğine dayanır. Eğitim verisi sınırlı, zayıf ve önyargılıysa, BERT yanlış, zararlı sonuçlar üretebilir veya hatta LLM halüsinasyonları olarak adlandırılan çıktılar verebilir.
Orijinal BERT özelinde bu olasılık daha da yüksektir; çünkü model, ChatGPT, LLaMA 2 ve Google Bard gibi daha gelişmiş modeller tarafından yapay zekâ güvenliğini artırmak için kullanılan standart bir teknik olan İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) olmadan eğitilmiştir. RLHF, eğitim sırasında LLM’in öğrenme sürecini izlemek ve yönlendirmek için insan geri bildiriminin kullanılmasını içerir ve böylece sistemlerin etkin, daha güvenli ve güvenilir olmasını sağlar.
Ayrıca, ChatGPT gibi diğer son teknoloji LLM’lerle karşılaştırıldığında küçük bir model olarak kabul edilse bile, yine de çalıştırmak için hatırı sayılır bir hesaplama gücü gerektirir; sıfırdan eğitmek ise çok daha fazlasını. Bu nedenle, sınırlı kaynaklara sahip geliştiriciler onu kullanamayabilir.
BERT ve NLP’nin Geleceği
BERT, modern LLM’lerin ilk örneklerindendi. Ancak modası geçmiş olmaktan uzak; BERT hâlâ en başarılı ve en yaygın kullanılan LLM’lerden biridir. Açık kaynak doğası sayesinde bugün, belirli NLP görevleri için tasarlanmış birden çok varyant ve yüzlerce önceden eğitilmiş BERT sürümü mevcuttur.
BERT ve son NLP gelişmelerini takip etmekle ilgileniyorsanız, DataCamp yanınızda. Özenle seçilmiş materyallerimize göz atın ve güncel üretken yapay zekâ devrimini yakından izleyin!





Bilimsel atılımlar nadiren bir boşlukta gerçekleşir. Genellikle, biriken insan bilgisinin üzerine inşa edilen bir merdivenin sondan bir önceki basamağıdır. ChatGPT ve Google Bart gibi büyük dil modellerinin (LLM’ler) başarısını anlamak için geçmişe dönüp BERT’ten bahsetmemiz gerekir.
2018’de Google araştırmacıları tarafından geliştirilen BERT, ilk LLM’lerden biridir. Çarpıcı sonuçlarıyla genel dil anlama, soru-cevap ve adlandırılmış varlık tanıma dahil olmak üzere NLP görevlerinde hızla yaygın bir kıyaslama standardı haline geldi.
LLM’ler hakkında daha fazla bilgi edinmek ister misiniz? Bugün Büyük Dil Modelleri (LLM’ler) Kavramları kursumuzun 1. Bölümüne başlayın.
Bugün tanık olduğumuz üretken yapay zekâ devrimine giden yolu BERT’in açtığını söylemek yanlış olmaz. İlk LLM’lerden biri olmasına rağmen BERT hâlâ yaygın biçimde kullanılıyor; duygu analizi, klinik not analizi ve toksik yorum tespiti gibi belirli kullanım senaryoları için binlerce açık kaynaklı, ücretsiz ve önceden eğitilmiş BERT modeli mevcut.
BERT hakkında meraklı mısınız? Bu makaleyi okumaya devam edin; BERT’in mimarisini, teknolojinin iç işleyişini, bazı gerçek dünya uygulamalarını ve sınırlamalarını inceleyeceğiz.
BERT Nedir?
BERT (Bidirectional Encoder Representations from Transformers), 2018’de Google tarafından geliştirilen açık kaynaklı bir modeldir. 2017’de Google araştırmacılarının ünlü Attention is All You Need makalesinde sunduğu yenilikçi sinir mimarisi olan transformer’ın doğal dil işleme (NLP) görevlerindeki performansını test etmek için iddialı bir deneydi.
BERT’in başarısının anahtarı transformer mimarisidir. Transformer’lardan önce doğal dili modellemek oldukça zorlu bir görevdi. Gelişmiş sinir ağlarının yükselişine –özellikle tekrarlayan veya evrişimsel sinir ağlarına– rağmen sonuçlar yalnızca kısmen başarılıydı.
Başlıca zorluk, sinir ağlarının bir cümledeki eksik kelimeyi tahmin etmek için kullandığı mekanizmada yatıyordu. O dönemde en iyi sinir ağları, paralel hesaplama için uygun olmayan, güçlü ama zaman ve kaynak tüketen bir mekanizma olan encoder-decoder mimarisine dayanıyordu.
Bu zorlukları göz önünde bulunduran Google araştırmacıları, bir sonraki bölümde açıklandığı gibi dikkat (attention) mekanizmasına dayalı yenilikçi bir sinir mimarisi olan transformer’ı geliştirdi.
BERT Nasıl Çalışır?
BERT’in nasıl çalıştığına bakalım; modelin arkasındaki teknoloji, nasıl eğitildiği ve veriyi nasıl işlediğini ele alacağız.
Temel mimari ve işlevsellik
Tekrarlayan ve evrişimsel sinir ağları, tahmin üretmek için sıralı hesaplama kullanır. Yani, büyük veri kümeleri üzerinde eğitildikten sonra, verilen bir kelime dizisini hangi kelimenin takip edeceğini öngörebilirler. Bu bakımdan tek yönlü veya bağlamdan bağımsız algoritmalar olarak kabul edilirlerdi.
Buna karşılık, encoder-decoder mimarisine dayanan ve BERT gibi transformer destekli modeller iki yönlüdür; çünkü kelimeleri hem önceki hem de sonraki kelimelere dayanarak tahmin ederler. Bu, hem encoder’a hem decoder’a dahil edilen öz-dikkat (self-attention) katmanı sayesinde başarılır. Dikkat katmanının amacı, giriş cümlesindeki farklı kelimeler arasındaki bağlamsal ilişkileri yakalamaktır.
Günümüzde birçok önceden eğitilmiş BERT sürümü vardır, ancak orijinal makalede Google iki BERT sürümü eğitti: farklı sinir mimarilerine sahip BERTbase ve BERTlarge. Özetle, BERTbase 12 transformer katmanı, 12 dikkat katmanı ve 110 milyon parametreyle geliştirilirken, BERTlarge 24 transformer katmanı, 16 dikkat katmanı ve 340 milyon parametre kullandı. Bekleneceği üzere, BERTlarge doğruluk testlerinde daha küçük kardeşini geride bıraktı.
Transformer’larda encoder-decoder mimarisinin ayrıntılı olarak nasıl çalıştığını öğrenmek için Transformers ve Hugging Face Kullanımına Giriş yazımızı okumanızı önemle tavsiye ederiz.
Transformer mimarisinin açıklaması
Ön eğitim ve ince ayar
Transformer’lar, yalnızca sınırlı sayıda şirketin (Google dahil) karşılayabildiği, zaman alıcı ve pahalı bir süreçle devasa bir veri külliyatı üzerinde sıfırdan eğitilir.
BERT’in özelinde, model dört gün boyunca Wikipedia (~2,5 milyar kelime) ve Google’ın BooksCorpus’u (~800 milyon kelime) üzerinde önceden eğitildi. Bu, modele yalnızca İngilizce değil, dünyadaki birçok diğer dil hakkında da bilgi kazandırır.
Eğitim sürecini optimize etmek için Google, makine öğrenimi görevleri için özel olarak tasarlanmış TPU (Tensor Processing Unit) adlı yeni bir donanım geliştirdi.
Eğitim sürecindeki gereksiz ve maliyetli etkileşimlerden kaçınmak için Google araştırmacıları, (ön) eğitim aşamasını ince ayar aşamasından ayırmak üzere transfer öğrenimi tekniklerini kullandı. Bu sayede geliştiriciler, önceden eğitilmiş modelleri seçip hedef görevin giriş-çıkış çift verilerini rafine edebilir ve önceden eğitilmiş modelin tepe katmanını alanına özgü verilerle yeniden eğitebilir. Bu özellik, BERT gibi LLM’leri üzerlerine inşa edilen sayısız uygulamanın temel modeli yapan şeydir.
BERT’in işlemesinde Maskeli Dil Modellemenin rolü
BERT’te (ve transformer tabanlı her LLM’de) iki yönlü öğrenmeyi mümkün kılan kilit unsur dikkat mekanizmasıdır. Bu mekanizma, maskeli dil modelleme (MLM) üzerine kuruludur. Bir cümledeki bir kelimeyi maskeleyerek, bu teknik modelin cümledeki kalan kelimeleri her iki yönde de analiz etmesini ve maskelenen kelimeyi tahmin etme olasılığını artırmasını sağlar. MLM, bilgisayarlı görü alanında daha önce denenmiş tekniklere dayanır ve tüm bir dizinin iyi bir bağlamsal anlaşılmasını gerektiren görevler için uygundur.
Bu tekniği uygulayan ilk LLM BERT’ti. Özellikle, eğitim sırasında belirteçlenmiş kelimelerin rastgele %15’i maskelendi. Sonuç, BERT’in gizli kelimeleri yüksek doğrulukla tahmin edebildiğini gösterdi.
Maskeli dil modelleme hakkında meraklı mısınız? Bu yenilikçi tekniğin tüm ayrıntılarını öğrenmek için Büyük Dil Modelleri (LLM’ler) Kavramları Kursumuza göz atın.
BERT Ne İçin Kullanılır? BERT’in NLP Üzerindeki Etkisi
Transformer’larla güçlendirilen BERT, birden fazla NLP görevinde son teknoloji sonuçlara ulaştı. BERT’in öne çıktığı bazı testler şunlardır:
BERT’in Gerçek Dünya Uygulamaları
Birçok LLM deneysel ortamlarda denendi, ancak pek azı yerleşik uygulamalara entegre edildi. BERT için durum böyle değil; her gün milyonlarca insan tarafından kullanılıyor (çoğu zaman bunun farkında olmasak da).
Harika bir örnek Google Arama’dır. 2020’de Google, 70’ten fazla dilde Google Arama üzerinden BERT’i benimsediğini duyurdu. Bu, Google’ın içerikleri sıralamak ve öne çıkan pasajları göstermek için BERT’i kullandığı anlamına gelir. Dikkat mekanizmasıyla Google artık sorunuzun bağlamını kullanarak faydalı bilgiler sunabiliyor; aşağıdaki örnekte gösterildiği gibi.
Kaynak: Google
BERT’in varyantları ve uyarlamaları
Ancak bu, hikâyenin yalnızca bir kısmı. BERT’in başarısı büyük ölçüde açık kaynak doğasından kaynaklanır; bu sayede geliştiriciler orijinal BERT’in kaynak koduna erişip yeni özellikler ve iyileştirmeler oluşturabildiler.
Bunun sonucunda BERT’in çok sayıda varyantı ortaya çıktı. Aşağıda en bilinen varyantlardan bazılarını bulabilirsiniz:
Açık kaynak LLM hareketi hakkında daha fazla bilgi edinmek isterseniz, 2023’ün En İyi Açık Kaynak LLM’lerini içeren yazımızı okumanızı şiddetle tavsiye ederiz.
BERT’in belirli görevler için ince ayarı
BERT’in ve genel olarak LLM’lerin en güzel yanlarından biri, ön eğitim sürecinin ince ayar sürecinden ayrılmış olmasıdır. Bu da geliştiricilerin, BERT’in önceden eğitilmiş sürümlerini alarak kendi özel kullanım durumlarına göre özelleştirebilecekleri anlamına gelir.
BERT özelinde, çok çeşitli NLP görevleri için geliştirilmiş yüzlerce ince ayarlı sürüm vardır. Aşağıda, BERT’in ince ayarlı sürümlerine dair çok, ama çok sınırlı bir liste bulabilirsiniz:
BERT’in Sınırlamalarını Anlamak
BERT, LLM’lerle ilişkili geleneksel sınırlamalar ve sorunlarla birlikte gelir. BERT’in tahminleri, her zaman eğitiminde kullanılan verinin niceliğine ve niteliğine dayanır. Eğitim verisi sınırlı, zayıf ve önyargılıysa, BERT yanlış, zararlı sonuçlar üretebilir veya hatta LLM halüsinasyonları olarak adlandırılan çıktılar verebilir.
Orijinal BERT özelinde bu olasılık daha da yüksektir; çünkü model, ChatGPT, LLaMA 2 ve Google Bard gibi daha gelişmiş modeller tarafından yapay zekâ güvenliğini artırmak için kullanılan standart bir teknik olan İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) olmadan eğitilmiştir. RLHF, eğitim sırasında LLM’in öğrenme sürecini izlemek ve yönlendirmek için insan geri bildiriminin kullanılmasını içerir ve böylece sistemlerin etkin, daha güvenli ve güvenilir olmasını sağlar.
Ayrıca, ChatGPT gibi diğer son teknoloji LLM’lerle karşılaştırıldığında küçük bir model olarak kabul edilse bile, yine de çalıştırmak için hatırı sayılır bir hesaplama gücü gerektirir; sıfırdan eğitmek ise çok daha fazlasını. Bu nedenle, sınırlı kaynaklara sahip geliştiriciler onu kullanamayabilir.
BERT ve NLP’nin Geleceği
BERT, modern LLM’lerin ilk örneklerindendi. Ancak modası geçmiş olmaktan uzak; BERT hâlâ en başarılı ve en yaygın kullanılan LLM’lerden biridir. Açık kaynak doğası sayesinde bugün, belirli NLP görevleri için tasarlanmış birden çok varyant ve yüzlerce önceden eğitilmiş BERT sürümü mevcuttur.
BERT ve son NLP gelişmelerini takip etmekle ilgileniyorsanız, DataCamp yanınızda. Özenle seçilmiş materyallerimize göz atın ve güncel üretken yapay zekâ devrimini yakından izleyin!