{count, plural, one {कोर्स} other {कोर्स}}
R परिचय
{hours} घंटा
3.1M
फ़ीचर्स की संख्या के लिहाज से उच्च-आयामी डेटा आजकल मशीन लर्निंग समस्याओं में तेजी से आम हो गया है। इस बड़े डेटा से उपयोगी जानकारी निकालने के लिए आपको सांख्यिकीय तकनीकों का इस्तेमाल कर शोर या अनावश्यक डेटा को घटाना होता है। ऐसा इसलिए क्योंकि अक्सर आपको मॉडल को प्रशिक्षित करने के लिए हर फ़ीचर का उपयोग करने की ज़रूरत नहीं होती। आप केवल उन्हीं फ़ीचर्स को देकर अपने मॉडल को बेहतर बना सकते हैं जो असह-संबद्ध और गैर-अनावश्यक हों। यहीं पर फ़ीचर चयन महत्वपूर्ण भूमिका निभाता है। यह न केवल आपके मॉडल को तेज़ी से प्रशिक्षित करने में मदद करता है, बल्कि मॉडल की जटिलता भी घटाता है, उसे समझना आसान बनाता है और सटीकता, प्रिसिशन या रिकॉल—जो भी प्रदर्शन मीट्रिक हो—में सुधार करता है।
इस ट्यूटोरियल में, आप निम्नलिखित अवधारणाओं पर काम करेंगे:
सबसे पहले, आप फ़ीचर चयन के बारे में और जानेंगे: आप देखेंगे कि इसे कब इस्तेमाल कर सकते हैं, और अपने मॉडल के लिए सबसे महत्वपूर्ण फ़ीचर्स चुनने के लिए आपके पास कौन से तरीक़े उपलब्ध हैं!
फिर, आपको Boruta एल्गोरिद्म से परिचय कराया जाएगा। आप देखेंगे कि मूल विशेषताओं के महत्व की तुलना उनके क्रम-विकृत प्रतियों से यादृच्छिक रूप से संभव महत्व से करके प्रासंगिक फ़ीचर्स के लिए टॉप-डाउन खोज कैसे की जाती है, और क्रमशः अप्रासंगिक फ़ीचर्स को कैसे हटाया जाता है।
आप उस डेटासेट पर भी संक्षिप्त नज़र डालेंगे, जिस पर आप फ़ीचर चयन करेंगे। आप देखेंगे कि Amelia पैकेज की मदद से मिसिंग वैल्यूज़ को कैसे इम्प्यूट किया जा सकता है।
अंत में, आप Boruta पैकेज के बारे में और जानेंगे, जिसका उपयोग आप एल्गोरिद्म चलाने के लिए कर सकते हैं।
आम तौर पर, जब भी आप डेटा की विमीयता (dimensionality) घटाना चाहते हैं तो आपको Principal Component Analysis, Singular Value Decomposition आदि जैसी विधियाँ मिलती हैं। तो यह पूछना स्वाभाविक है कि आपको अन्य फ़ीचर चयन विधियों की ज़रूरत क्यों है। बात यह है कि ये तकनीकें अनदेखी (unsupervised) फ़ीचर चयन के तरीके हैं: उदाहरण के लिए PCA, जो डेटा में वैरिएंस का उपयोग करके कंपोनेंट्स ढूँढता है। ये तकनीकें फ़ीचर मानों और लक्ष्य वर्ग या मानों के बीच की जानकारी को ध्यान में नहीं रखतीं। साथ ही, ऐसी विधियों से जुड़े कुछ अनुमानों, जैसे सामान्यता (normality), के कारण उन्हें लागू करने से पहले कुछ रूपांतरणों की आवश्यकता होती है। ये बाध्यताएँ हर तरह के डेटा पर लागू नहीं होतीं।
सामान्यतः फ़ीचर चयन विधियाँ तीन प्रकार की होती हैं:
फ़िल्टर विधियाँ: फ़िल्टर विधियाँ आम तौर पर प्रीप्रोसेसिंग चरण के रूप में उपयोग होती हैं। फ़ीचर्स का चयन किसी भी मशीन लर्निंग एल्गोरिद्म से स्वतंत्र होता है। इसके बजाय, फ़ीचर्स को परिणाम चर के साथ उनके सहसंबंध के लिए विभिन्न सांख्यिकीय परीक्षणों में उनके स्कोर के आधार पर चुना जाता है। कुछ सामान्य फ़िल्टर विधियाँ हैं Correlation मेट्रिक्स (Pearson, Spearman, Distance), Chi-Squared test, ANOVA, Fisher's Score आदि।
रैपर विधियाँ: रैपर विधियों में, आप फ़ीचर्स के एक सबसेट का उपयोग करने की कोशिश करते हैं और उन पर मॉडल प्रशिक्षित करते हैं। पिछले मॉडल से निकले निष्कर्षों के आधार पर, आप सबसेट में फ़ीचर्स जोड़ने या हटाने का निर्णय लेते हैं। Forward Selection, Backward Elimination रैपर विधियों के कुछ उदाहरण हैं।
एम्बेडेड विधियाँ: ये ऐसे एल्गोरिद्म हैं जिनमें अपने अंतर्निहित फ़ीचर चयन तरीके होते हैं। LASSO रिग्रेशन इसका एक उदाहरण है।
इस ट्यूटोरियल में आप रैपर विधियों में से एक का उपयोग करेंगे जो R में Boruta नामक पैकेज के माध्यम से आसानी से उपलब्ध है।
Boruta एल्गोरिद्म, random forest वर्गीकरण एल्गोरिद्म के इर्द-गिर्द बना एक रैपर है। यह आपके डेटासेट में आउटपुट वेरिएबल के संदर्भ में मौजूद सभी महत्वपूर्ण और दिलचस्प फ़ीचर्स को पकड़ने की कोशिश करता है।
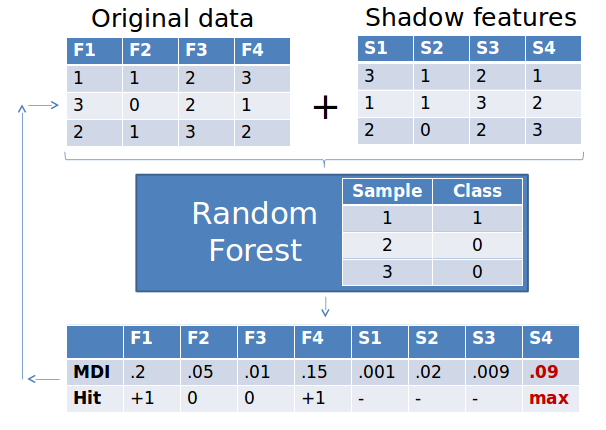
आइए Boruta एल्गोरिद्म को सबसे आम उपलब्ध डेटासेट्स में से एक पर लागू करें: Bank Marketing डेटा। यह डेटा पुर्तगाली बैंकिंग संस्थान के डायरेक्ट मार्केटिंग अभियानों (फोन कॉल्स) का प्रतिनिधित्व करता है। वर्गीकरण का लक्ष्य यह भविष्यवाणी करना है कि क्लाइंट टर्म डिपॉज़िट सब्सक्राइब करेगा या नहीं।
सुझाव: विभिन्न फ़ीचर्स का विस्तृत विवरण यहाँ ज़रूर देखें।
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
आइए summary() फ़ंक्शन का उपयोग करके आपके डेटासेट में विभिन्न फ़ीचर्स के सामान्य वर्णनात्मक आँकड़ों का सार लें।
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
summary() फ़ंक्शन निरंतर फ़ीचर्स के लिए केन्द्रीय प्रवृत्ति के माप, जैसे mean, median, quantiles आदि देता है। यदि आपके डेटा सेट में कोई श्रेणीय (categorical) फ़ीचर्स हैं, तो आपको उनके Class और Mode भी दिखेंगे।
अब श्रेणीय फ़ीचर्स को factor डेटा प्रकार में बदलते हैं:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
क्योंकि shadow फ़ीचर्स बनाने के लिए डेटा बिंदुओं को शफ़ल किया जाता है और उनके लिए Z-score निकाला जाता है, इसलिए boruta पैकेज उपयोग करने से पहले मिसिंग या खाली मानों का उपचार करना महत्वपूर्ण है, वरना यह त्रुटि देता है।
(अ)भाग्यवश, इस डेटासेट में दोनों में से कोई नहीं है। फिर भी, शैक्षिक उद्देश्य से, आप डेटा में कुछ NA जोड़ेंगे।
आइए prodNA() फ़ंक्शन का उपयोग करके अपने डेटा सेट में मिसिंग वैल्यूज़ डालें। आप यह फ़ंक्शन missForest पैकेज इंस्टॉल कर एक्सेस कर सकते हैं।
याद रखें कि आवश्यकता होने पर आप install.packages() से मिसिंग पैकेज इंस्टॉल कर सकते हैं!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
आप अपने नए डेटा फ़्रेम पर फिर से summary() फ़ंक्शन कॉल करके इम्प्यूट किए गए NA की संख्या पा सकते हैं, लेकिन चलिए थोड़े और रचनात्मक बनते हैं!
निम्नलिखित ggplot2 कोड का उपयोग करके डेटा में मिसिंगनेस को विज़ुअलाइज़ करें:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
प्लॉट में सफेद रेखाएँ आपको दृश्य रूप से दिखाती हैं कि आपने हर फ़ीचर में मिसिंग वैल्यूज़ डाली हैं, लेकिन आपने देखा कि वह ggplot_missing फ़ंक्शन लिखने में कितनी मेहनत लगी? खैर, R में Amelia पैकेज, जिसका आप अगले खंड में उपयोग करेंगे, इसी तरह का चित्र बनाने के लिए एक पंक्ति का विकल्प देता है:
library(Amelia)
missmap(bank.mis)
इसे ख़ुद आज़माएँ!
Amelia के साथ मिसिंग वैल्यूज़ इम्प्यूट करनाअब आप कई तरीकों से मिसिंग वैल्यूज़ इम्प्यूट कर सकते हैं, जैसे mean, median या mode (श्रेणीय फ़ीचर्स के लिए) से इम्प्यूट करना, पर चलिए मिसिंग वैल्यूज़ इम्प्यूट करने के लिए एक और शक्तिशाली पैकेज Amelia का उपयोग करते हैं।
Amelia m बूटस्ट्रैप सैंपल लेता है और प्रत्येक सैंपल पर EMB (expectation-maximization with bootstrapping) एल्गोरिद्म लागू करता है। mean और variance के m आकलन अलग-अलग होंगे। अंततः, पहले अनुमान सेट का उपयोग रिग्रेशन से पहली मिसिंग वैल्यूज़ सेट को इम्प्यूट करने के लिए किया जाता है, फिर दूसरे अनुमान सेट का उपयोग दूसरी सेट के लिए, और इसी तरह। बहु-इम्प्यूटेशन पक्षपात घटाने और दक्षता बढ़ाने में सहायक होता है। साथ ही, यह मल्टीकोर CPU का उपयोग करके पैरेलल इम्प्यूटेशन को सक्षम करता है।
इसके 3 महत्वपूर्ण पैरामीटर हैं:
m: बनाए जाने वाले इम्प्यूटेड डेटासेट्स की संख्या।idvars: सभी ID वेरिएबल्स और वे अन्य वेरिएबल्स रखें जिन्हें आप इम्प्यूट नहीं करना चाहते।noms: नाममात्र (nominal) वेरिएबल्स यहाँ दें।library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5इम्प्यूटेड डेटा फ़्रेम्स तक पहुँचने के लिए, आप निम्नलिखित सबसेटिंग का उपयोग कर सकते हैं:
amelia_bank$imputations[[1]]इम्प्यूटेड डेटासेट को csv फ़ाइलों में निर्यात करने के लिए उपयोग करें:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")Boruta R पैकेजअब किसी एक इम्प्यूटेड डेटासेट पर Boruta एल्गोरिद्म का उपयोग करें। आप इसके लिए Boruta पैकेज का उपयोग कर सकते हैं:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta किसी डेटा सेट में फ़ीचर्स की महत्व-परकता पर निर्णय देता है। कई पहले से ही महत्वपूर्ण और गैर-महत्वपूर्ण के रूप में वर्गीकृत हो चुके हैं, लेकिन आप देखते हैं कि कुछ को tentative श्रेणी में रखा गया है।
लेकिन इसका मतलब क्या है?
Tentative फ़ीचर्स का महत्व उनके सर्वश्रेष्ठ shadow फ़ीचर्स के इतना क़रीब होता है कि डिफ़ॉल्ट संख्या की Random Forest रन में Boruta वांछित विश्वसनीयता के साथ निर्णय नहीं ले पाता।
फिर आप इसके बारे में क्या करते हैं?
यदि tentative फ़ीचर्स रह जाते हैं तो आप maxRuns पैरामीटर बढ़ाने पर विचार कर सकते हैं। हालाँकि, ध्यान दें कि आप mtry और ntree पैरामीटरों के मान भी दे सकते हैं, जो randomForest() फ़ंक्शन को पास होंगी। पहला आपको यह निर्दिष्ट करने देता है कि प्रत्येक split पर उम्मीदवारों के रूप में यादृच्छिक रूप से कितने वेरिएबल्स सैंपल किए जाएँ, जबकि दूसरा यह बताने के लिए है कि आप कितने पेड़ उगाना चाहते हैं। इन आर्ग्युमेंट्स के साथ, Random Forest क्लासिफायर out-of-bag त्रुटि के न्यूनतम मान पर अभिसरण प्राप्त करेगा।
याद रखें कि out-of-bag त्रुटि उन क्लासिफायर्स की भविष्यवाणी त्रुटि को मापने का एक अनुमान है जो प्रशिक्षण में डेटा सैंपल्स को सब-सैंपल करने के लिए बूटस्ट्रैप एग्रीगेशन का उपयोग करते हैं। यह प्रत्येक प्रशिक्षण सैंपल X पर केवल उन पेड़ों का उपयोग करके औसत भविष्यवाणी त्रुटि है जिनके बूटस्ट्रैप सैंपल में X शामिल नहीं था।
वैकल्पिक रूप से, आप प्रक्रिया की प्रगति की रिपोर्ट पाने के लिए doTrace आर्ग्युमेंट को 1 या 2 पर सेट कर सकते हैं।
boruta पैकेज में TentativeRoughFix() फ़ंक्शन भी होता है, जिसका उपयोग median फ़ीचर Z-score की तुलना सबसे महत्वपूर्ण shadow फ़ीचर के median Z-score से करके मिसिंग निर्णयों को भरने के लिए किया जा सकता है:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
अब Boruta ने अपना काम कर दिया है: इसने प्रत्येक फ़ीचर को महत्वपूर्ण या गैर-महत्वपूर्ण के रूप में सफलतापूर्वक वर्गीकृत कर दिया है।
आप plot(boruta.bank) कॉल करके boruta वेरिएबल इम्पॉर्टेंस चार्ट प्लॉट कर सकते हैं। हालाँकि, x अक्ष के लेबल क्षैतिज होंगे। यह बहुत सुथरा नहीं लगेगा।
इसीलिए आप निम्नलिखित कोड खंड की तरह x अक्ष पर फ़ीचर लेबल्स को लंबवत जोड़ेंगे:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
y अक्ष का लेबल Importance शफ़ल किए गए डेटासेट में हर फ़ीचर के Z स्कोर का प्रतिनिधित्व करता है।
नीले बॉक्सप्लॉट्स किसी shadow फ़ीचर के न्यूनतम, औसत और अधिकतम Z स्कोर को दर्शाते हैं, जबकि लाल और हरे बॉक्सप्लॉट क्रमशः अस्वीकृत और पुष्टि किए गए फ़ीचर्स के Z स्कोर दर्शाते हैं। जैसा कि आप देख सकते हैं, लाल बॉक्सप्लॉट्स का Z स्कोर shadow फ़ीचर के अधिकतम Z स्कोर से कम है, जो ठीक वही कारण है कि उन्हें गैर-महत्वपूर्ण श्रेणी में रखा गया।
आप निम्न लिखकर फ़ीचर्स के महत्व की पुष्टि कर सकते हैं:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
आप परिणाम को आसानी से मान्य कर सकते हैं क्योंकि duration फ़ीचर को सबसे अधिक महत्व दिया गया है, जो डेटा विवरण में पहले से उल्लिखित है (ध्यान से पढ़ें तो यहाँ देखें)!
वाह! आपने कुछ पंक्तियों का कोड लिखकर ही अपने डेटासेट से सबसे महत्वपूर्ण फ़ीचर्स फ़िल्टर कर लिए हैं। इसके साथ आपने अपने डेटा से शोर घटा दिया है, जो किसी भी क्लासिफायर के लिए किसी ऑब्ज़र्वेशन को लेबल असाइन करने में वास्तव में लाभकारी होगा। इन महत्वपूर्ण फ़ीचर्स पर मॉडल प्रशिक्षित करने से आपके मॉडल का प्रदर्शन निश्चित रूप से बेहतर होगा—जो कि शुरुआत में फ़ीचर चयन करने का उद्देश्य था!
यदि आप उन संसाधनों को देखना चाहते हैं जिनका उपयोग इस ट्यूटोरियल को बनाने में किया गया है, तो निम्न देखें:
R पाठ्यक्रम
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}