Curso
Introdução ao R
4 h
3.1M
Dados de alta dimensionalidade, em termos de número de variáveis, estão cada vez mais comuns em problemas de machine learning. Para extrair informações úteis desses grandes volumes de dados, você precisa aplicar técnicas estatísticas para reduzir ruído e redundâncias. Isso porque, muitas vezes, não é necessário usar todas as variáveis disponíveis para treinar um modelo. O desempenho pode melhorar quando você utiliza apenas as variáveis não correlacionadas e não redundantes. É aí que a seleção de variáveis ganha protagonismo: além de acelerar o treinamento, ela reduz a complexidade do modelo, facilita a interpretação e melhora métricas como acurácia, precisão ou recall, dependendo do que você estiver otimizando.
Neste tutorial, você vai ver os seguintes conceitos:
Primeiro, você vai entender melhor a seleção de variáveis: quando usar, e quais métodos existem para escolher as variáveis mais importantes para o seu modelo.
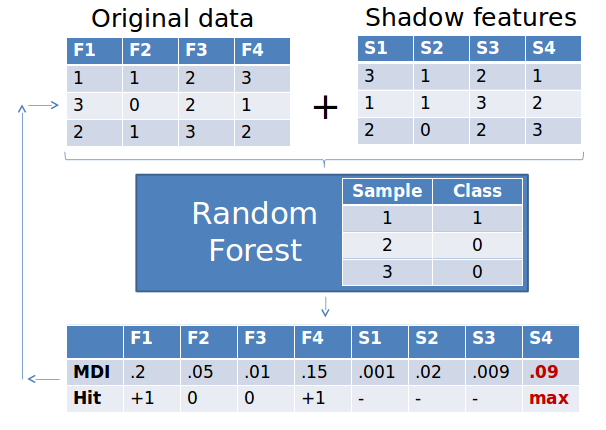
Depois, vamos apresentar o algoritmo Boruta. Você verá como ele conduz uma busca top-down por variáveis relevantes, comparando a importância dos atributos originais com a importância obtida ao acaso (estimada a partir de cópias permutadas), e eliminando progressivamente as variáveis irrelevantes.
Você também vai dar uma olhada rápida no conjunto de dados usado para a seleção. Verá como imputar valores ausentes com a ajuda do pacote Amelia.
Por fim, você aprenderá mais sobre o pacote Boruta, que permite executar o algoritmo.
De forma geral, quando você quer reduzir a dimensionalidade dos dados, surgem métodos como a análise de componentes principais (PCA), decomposição em valores singulares (SVD), entre outros. Então é natural perguntar por que precisamos de outros métodos de seleção de variáveis. O ponto é que essas técnicas fazem seleção de forma não supervisionada: por exemplo, a PCA usa a variância dos dados para encontrar componentes. Esses métodos não consideram a relação entre as variáveis preditoras e a variável-alvo. Além disso, costumam envolver suposições (como normalidade) que exigem transformações antes de aplicá-los. Essas restrições não se encaixam em todo tipo de dado.
Em linhas gerais, há três tipos de métodos de seleção de variáveis:
Métodos filtro (Filter): geralmente usados como etapa de pré-processamento. A seleção é independente de qualquer algoritmo de machine learning. As variáveis são selecionadas com base em escores de testes estatísticos que medem correlação com a variável de saída. Exemplos: métricas de correlação (Pearson, Spearman, distância), teste qui‑quadrado, ANOVA, pontuação de Fisher, etc.
Métodos wrapper: você testa subconjuntos de variáveis treinando um modelo com eles. A partir do desempenho do modelo anterior, decide adicionar ou remover variáveis do subconjunto. Exemplos: seleção forward, eliminação backward.
Métodos embutidos (Embedded): algoritmos que já incluem seleção de variáveis internamente. Regressão LASSO é um exemplo clássico.
Neste tutorial, você vai usar um método wrapper disponível em R via o pacote Boruta.
O Boruta é um wrapper construído sobre o algoritmo de classificação Random Forest. Ele busca capturar todas as variáveis importantes e interessantes do seu conjunto de dados em relação à variável de saída.
Vamos usar o Boruta em um dos conjuntos de dados mais conhecidos: Bank Marketing. Esses dados representam campanhas de marketing direto (ligações telefônicas) de uma instituição bancária portuguesa. O objetivo é prever se o cliente vai assinar um depósito a prazo.
Dica: confira a descrição detalhada das variáveis aqui.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Vamos usar a função summary() para resumir estatísticas descritivas das variáveis do conjunto de dados.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
A função summary() traz medidas de tendência central para variáveis contínuas, como média, mediana e quantis. Para variáveis categóricas, você também vê a classe e o modo.
Agora vamos converter as variáveis categóricas para o tipo fator:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Como os dados são embaralhados para criar as shadow features e o Z-score é calculado para cada uma, é importante tratar valores ausentes ou em branco antes de usar o pacote boruta, caso contrário ocorrerá erro.
(In)felizmente, este conjunto não tem nenhum dos dois. Porém, para fins didáticos, vamos inserir alguns NAs nos dados.
Vamos semear valores ausentes no conjunto usando a função prodNA(). Ela está no pacote missForest.
Lembre que você pode usar install.packages() para instalar pacotes faltantes, se precisar!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Você pode chamar summary() novamente para ver quantos NAs foram inseridos, mas vamos ser um pouco mais criativos!
Vamos visualizar a falta de dados com o seguinte código em ggplot2:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
As linhas brancas no gráfico mostram visualmente que inserimos valores ausentes em praticamente todas as variáveis — mas percebeu o trabalho para escrever a função ggplot_missing? O pacote Amelia no R, que usaremos a seguir, oferece uma alternativa de uma linha para gerar um gráfico semelhante:
library(Amelia)
missmap(bank.mis)
Experimente aí!
AmeliaVocê pode imputar valores ausentes de várias formas, como média, mediana ou moda (para categóricas), mas vamos usar um pacote poderoso para isso: Amelia.
O Amelia tira m amostras bootstrap e aplica o algoritmo EMB (expectation-maximization com bootstrap) a cada amostra. As m estimativas de médias e variâncias serão diferentes. Por fim, usa o primeiro conjunto de estimativas para imputar o primeiro conjunto de valores ausentes via regressão, o segundo conjunto para o segundo, e assim por diante. A imputação múltipla ajuda a reduzir viés e aumentar a eficiência. Além disso, suporta imputação em paralelo usando CPUs multicore.
Ele tem 3 parâmetros importantes:
m: número de conjuntos imputados a gerar.idvars: variáveis de ID e outras que você não quer imputar.noms: variáveis nominais.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Para acessar os data frames imputados, faça o seguinte subsetting:
amelia_bank$imputations[[1]]Para exportar os conjuntos imputados para arquivos csv, use:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")BorutaAgora vamos aplicar o Boruta em um dos conjuntos imputados. Use o pacote Boruta para isso:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
O Boruta classifica a relevância das variáveis do conjunto. Muitas já saem como importantes ou não importantes, mas outras ficam como tentativas (tentative).
O que isso significa?
Variáveis tentativas têm importância muito próxima das melhores shadow features, e o Boruta não consegue decidir com a confiança desejada no número padrão de execuções do Random Forest.
O que fazer?
Você pode aumentar o parâmetro maxRuns quando houver variáveis tentativas. Porém, note que também dá para fornecer valores para mtry e ntree, que são passados à função randomForest(). O primeiro define quantas variáveis são amostradas aleatoriamente a cada divisão; o segundo define o número de árvores a crescer. Com esses argumentos, o Random Forest tende a convergir para um erro out‑of‑bag mínimo.
Lembre que o erro out‑of‑bag é uma estimativa do erro de previsão de classificadores que usam bootstrap aggregation, calculada como o erro médio de previsão de cada amostra de treino X usando apenas as árvores que não viram X no bootstrap.
Como alternativa, você pode definir doTrace como 1 ou 2 para acompanhar o progresso.
O pacote boruta também traz a função TentativeRoughFix(), que resolve decisões pendentes comparando a mediana do Z-score da variável com a mediana do Z-score da shadow feature mais importante:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
O Boruta cumpriu seu papel: classificou cada variável como importante ou não importante.
Você pode plotar o gráfico de importância chamando plot(boruta.bank). Porém, os rótulos do eixo x ficam horizontais, o que não é tão legível.
Por isso, vamos rotacionar os rótulos no eixo x para ficarem verticais, como no código abaixo:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
O rótulo do eixo y, Importance, representa o Z-score de cada variável no conjunto embaralhado.
Os boxplots azuis correspondem ao Z-score mínimo, médio e máximo das shadow features; os vermelhos e verdes representam, respectivamente, os Z-scores das variáveis rejeitadas e confirmadas. Repare que os boxplots vermelhos têm Z-score menor que o Z-score máximo das sombras, por isso caíram na categoria de não importantes.
Você pode confirmar as variáveis importantes digitando:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
É fácil validar o resultado: a variável duration recebeu a maior importância, como já descrito na documentação do dataset (clique aqui)!
Pronto! Você filtrou as variáveis mais importantes do seu conjunto de dados com poucas linhas de código. Com isso, reduziu o ruído — o que ajuda qualquer classificador a rotular observações com mais assertividade. Treinar um modelo nessas variáveis essenciais tende a melhorar o desempenho, que é justamente o objetivo da seleção de variáveis.
Se quiser conferir as fontes usadas neste tutorial, veja a seguir:
Cursos de R
Curso
Curso
Curso
Tutorial
Arunn Thevapalan
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
11 min


