Corso
Introduzione a R
4 ore
3.1M
I dati ad alta dimensionalità, in termini di numero di variabili, sono sempre più comuni nei problemi di machine learning. Per estrarre informazioni utili da questi grandi volumi di dati, devi utilizzare tecniche statistiche per ridurre il rumore o i dati ridondanti. Spesso, infatti, non è necessario usare ogni variabile a disposizione per addestrare un modello. Puoi migliorarlo fornendo solo quelle variabili non correlate e non ridondanti. È qui che la selezione delle variabili gioca un ruolo importante: non solo aiuta ad addestrare il modello più velocemente, ma ne riduce anche la complessità, lo rende più facile da interpretare e migliora accuratezza, precisione o recall, qualunque sia la metrica di performance.
In questo tutorial affronterai i seguenti concetti:
Per prima cosa, approfondirai la feature selection: vedrai quando usarla e quali metodi hai a disposizione per selezionare le variabili più importanti per il tuo modello!
Poi, ti verrà presentato l'algoritmo Boruta. Vedrai come usarlo per eseguire una ricerca top-down delle variabili rilevanti confrontando l'importanza degli attributi originali con l'importanza ottenibile casualmente, stimata tramite le loro copie permutate, ed eliminando progressivamente le variabili irrilevanti.
Darai anche un'occhiata veloce al dataset su cui eseguirai la feature selection. Vedrai quanto è semplice imputare i valori mancanti con l'aiuto del pacchetto Amelia.
Infine, imparerai di più sul pacchetto Boruta, che puoi usare per eseguire l'algoritmo.
In generale, quando vuoi ridurre la dimensionalità dei dati incontri metodi come l'Analisi delle Componenti Principali, la scomposizione ai valori singolari, ecc. È naturale quindi chiedersi perché servano altri metodi di selezione delle variabili. Il punto è che queste tecniche sono modi non supervisionati di selezione: prendi ad esempio la PCA, che usa la varianza nei dati per trovare le componenti. Queste tecniche non tengono conto della relazione tra i valori delle variabili e la classe o il valore target. Inoltre, sono associate a certe assunzioni, come la normalità, che richiedono trasformazioni prima di poterle applicare. Questi vincoli non si adattano a tutti i tipi di dati.
In generale esistono tre tipi di metodi di selezione delle variabili:
Metodi filtro: in genere sono usati come passaggio di pre-processing. La selezione delle variabili è indipendente da qualsiasi algoritmo di machine learning. Le variabili vengono selezionate in base ai loro punteggi in vari test statistici per la correlazione con la variabile di output. Alcuni metodi filtro comuni sono le metriche di correlazione (Pearson, Spearman, distanza), il test Chi-quadro, ANOVA, lo score di Fisher, ecc.
Metodi wrapper: in questi metodi provi a usare un sottoinsieme di variabili e ad addestrare un modello con esse. In base alle inferenze tratte dal modello precedente, decidi di aggiungere o rimuovere variabili dal sottoinsieme. Forward selection e backward elimination sono alcuni esempi di metodi wrapper.
Metodi embedded: sono algoritmi che hanno metodi di selezione delle variabili integrati. La regressione LASSO è un esempio.
In questo tutorial userai uno dei metodi wrapper, disponibile in R tramite un pacchetto chiamato Boruta.
L'algoritmo Boruta è un wrapper costruito attorno all'algoritmo di classificazione Random Forest. Cerca di catturare tutte le variabili importanti e interessanti che potresti avere nel dataset rispetto a una variabile di outcome.
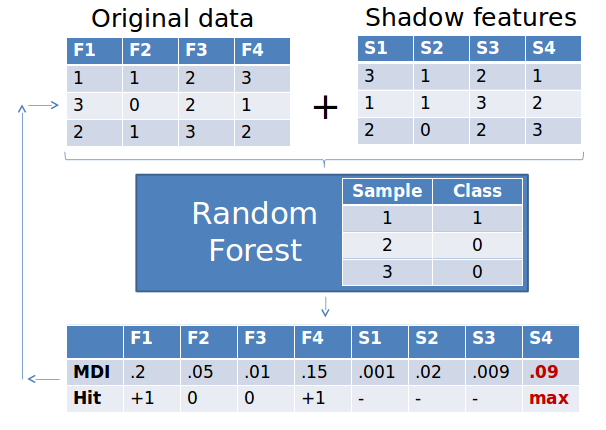
Usiamo l'algoritmo Boruta su uno dei dataset più comuni: i dati di Bank Marketing. Questi dati rappresentano campagne di marketing diretto (telefonate) di un istituto bancario portoghese. L'obiettivo di classificazione è prevedere se il cliente sottoscriverà o meno un deposito a termine.
Suggerimento: non dimenticare di consultare la descrizione dettagliata delle diverse variabili qui.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Usiamo la funzione summary() per riassumere le statistiche descrittive comuni delle diverse variabili del dataset.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
La funzione summary() fornisce le misure di tendenza centrale per variabili continue come media, mediana, quantili, ecc. Se hai variabili categoriche nel dataset, vedrai anche la classe e la modalità di quelle variabili.
Ora convertiamo le variabili categoriche nel tipo factor:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Poiché i punti dati vengono mescolati per creare le shadow features e per ciascuna viene calcolato lo Z-score, è importante trattare i valori mancanti o vuoti prima di usare il pacchetto boruta, altrimenti genera un errore.
(S)fortunatamente, questo dataset non ha né l'uno né l'altro. Tuttavia, a scopo didattico, introdurrai alcuni NA nei dati.
Seme i valori mancanti nel dataset usando la funzione prodNA(). Puoi accedere a questa funzione installando il pacchetto missForest.
Ricorda che puoi usare install.packages() per installare i pacchetti mancanti, se necessario!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Puoi richiamare di nuovo la funzione summary() sul nuovo data frame per ottenere il numero di NA imputati, ma proviamo a essere un po' più creativi!
Visualizziamo la mancanza di dati usando il seguente codice ggplot2:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
Le linee bianche nel grafico mostrano visivamente che hai inserito valori mancanti in ogni variabile, ma vedi quanta fatica è servita per scrivere quella funzione ggplot_missing? Ebbene, il pacchetto Amelia in R, che userai nella prossima sezione, fornisce un'alternativa in una sola riga per tracciare una figura simile:
library(Amelia)
missmap(bank.mis)
Provalo tu!
AmeliaOra puoi imputare i valori mancanti in vari modi, ad esempio imputando con media, mediana o moda (per le variabili categoriche), ma usiamo un altro pacchetto potente per l'imputazione dei valori mancanti: Amelia.
Amelia prende m campioni bootstrap e applica l'algoritmo EMB (expectation-maximization con bootstrapping) a ciascun campione. Le m stime di medie e varianze saranno diverse. Infine, il primo set di stime viene usato per imputare il primo set di valori mancanti tramite regressione, poi il secondo set di stime per il secondo set e così via. L'imputazione multipla aiuta a ridurre il bias e ad aumentare l'efficienza. Inoltre, è abilitata l'imputazione parallela usando CPU multicore.
Ha 3 parametri importanti:
m: il numero di dataset imputati da creare.idvars: mantieni qui tutte le variabili ID e le altre variabili che non vuoi imputare.noms: inserisci qui le variabili nominali.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Per accedere ai data frame imputati, puoi usare il seguente subsetting:
amelia_bank$imputations[[1]]Per esportare il dataset imputato in file csv usa:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")BorutaOra usiamo l'algoritmo Boruta su uno dei dataset imputati. Puoi utilizzare il pacchetto Boruta per farlo:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta fornisce un giudizio sulla significatività delle variabili in un dataset. Molte sono già classificate come importanti o non importanti, ma noti che alcune sono state assegnate alla categoria tentativo.
Ma cosa significa?
Le variabili tentativo hanno un'importanza così vicina alle loro migliori shadow features che Boruta non riesce a prendere una decisione con la confidenza desiderata nel numero predefinito di esecuzioni della Random Forest.
Che cosa puoi fare quindi?
Puoi considerare di aumentare il parametro maxRuns se restano variabili tentativo. Tuttavia, nota che puoi anche fornire valori per i parametri mtry e ntree, che verranno passati alla funzione randomForest(). Il primo ti permette di specificare il numero di variabili campionate casualmente come candidate a ogni split, mentre il secondo specifica il numero di alberi da far crescere. Con questi argomenti specificati, il classificatore Random Forest raggiungerà la convergenza al valore minimo dell'errore out-of-bag.
Ricorda che l'errore out-of-bag è una stima per misurare l'errore di previsione dei classificatori che usano il bootstrap aggregation per sotto-campionare i dati di addestramento. È l'errore medio di previsione su ciascun campione X del training set usando solo gli alberi che non avevano X nel proprio campione bootstrap.
In alternativa, puoi anche impostare l'argomento doTrace a 1 o 2, per ottenere un report dell'avanzamento del processo.
Il pacchetto boruta contiene anche la funzione TentativeRoughFix(), che può essere usata per colmare le decisioni mancanti confrontando semplicemente la mediana dello Z-score della variabile con la mediana dello Z-score della shadow feature più importante:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta ha ora fatto il suo lavoro: ha classificato con successo ogni variabile come importante o non importante.
Ora puoi tracciare il grafico di importanza delle variabili di Boruta chiamando plot(boruta.bank). Tuttavia, le etichette dell'asse x saranno orizzontali. Non sarà molto ordinato.
Per questo aggiungerai le etichette delle variabili all'asse x in verticale, proprio come nel seguente blocco di codice:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
L'etichetta dell'asse y Importance rappresenta lo Z-score di ogni variabile nel dataset mescolato.
I boxplot blu corrispondono allo Z-score minimo, medio e massimo di una shadow feature, mentre i boxplot rossi e verdi rappresentano gli Z-score delle variabili respinte e confermate, rispettivamente. Come puoi vedere, i boxplot rossi hanno uno Z-score inferiore rispetto allo Z-score massimo della shadow feature, che è precisamente il motivo per cui sono stati inseriti nella categoria non importante.
Puoi confermare l'importanza delle variabili digitando:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Puoi facilmente validare il risultato, dato che alla variabile duration è stata attribuita l'importanza più alta, come già menzionato nella descrizione dei dati (clicca qui) se leggi con attenzione!
Voilà! Hai filtrato con successo le variabili più importanti dal tuo dataset digitando solo poche righe di codice. In questo modo hai ridotto il rumore nei dati, il che sarà davvero utile per qualsiasi classificatore nel dare un'etichetta a un'osservazione. Addestrare un modello su queste variabili importanti migliorerà sicuramente le performance del tuo modello, che era proprio lo scopo della feature selection!
Se vuoi consultare le risorse utilizzate per realizzare questo tutorial, dai un'occhiata a quanto segue:
Corsi R
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



