Cours
Introduction à R
4 h
3.1M
Les données à forte dimension, en nombre de variables, sont aujourd’hui monnaie courante en apprentissage automatique. Pour en extraire des informations utiles, il faut recourir à des techniques statistiques afin de réduire le bruit ou la redondance. En effet, vous n’avez pas toujours besoin de toutes les variables pour entraîner un modèle. Vous pouvez l’améliorer en ne conservant que des variables non corrélées et non redondantes. C’est précisément là que la sélection de variables joue un rôle clé. Elle permet non seulement d’accélérer l’entraînement, mais aussi de réduire la complexité du modèle, de faciliter son interprétation et d’améliorer les métriques de performance (exactitude, précision, rappel, etc.).
Dans ce tutoriel, vous allez aborder les concepts suivants :
Vous commencerez par mieux comprendre la sélection de variables : quand l’utiliser et quelles méthodes permettent d’identifier les variables les plus importantes pour votre modèle.
Puis, vous découvrirez l’algorithme Boruta. Vous verrez comment l’utiliser pour effectuer une recherche top-down des variables pertinentes en comparant l’importance des attributs originaux avec une importance attendue au hasard, estimée via leurs copies permutées, et en éliminant progressivement les variables non pertinentes.
Vous jetterez aussi un coup d’œil rapide au jeu de données sur lequel vous appliquerez la sélection de variables. Vous verrez à quel point il est simple d’imputer les valeurs manquantes grâce au package Amelia.
Enfin, vous en apprendrez davantage sur le package Boruta pour exécuter l’algorithme.
Lorsque vous cherchez à réduire la dimensionnalité, vous pensez souvent à des méthodes comme l’analyse en composantes principales (ACP), la décomposition en valeurs singulières, etc. Pourquoi alors utiliser d’autres méthodes de sélection de variables ? Ces techniques sont des approches non supervisées : par exemple, l’ACP s’appuie sur la variance pour trouver les composantes. Elles ne tiennent pas compte de la relation entre les variables explicatives et la variable cible. De plus, elles reposent sur certains postulats (comme la normalité) qui exigent des transformations préalables, ce qui ne convient pas à toutes les données.
On distingue généralement trois familles de méthodes de sélection de variables :
Méthodes filtre : utilisées en prétraitement, elles sélectionnent les variables indépendamment de tout algorithme d’apprentissage. Les variables sont retenues selon leur score à différents tests statistiques mesurant leur corrélation avec la cible. Exemples courants : corrélations (Pearson, Spearman, distance), test du khi carré, ANOVA, score de Fisher, etc.
Méthodes wrapper : on sélectionne un sous-ensemble de variables, on entraîne un modèle, puis on ajoute ou retire des variables selon les enseignements du modèle précédent. La sélection avant (forward selection) et l’élimination arrière (backward elimination) en sont des exemples.
Méthodes intégrées : certains algorithmes embarquent leur propre mécanisme de sélection. La régression LASSO en est un exemple.
Dans ce tutoriel, vous utiliserez une méthode wrapper disponible en R via le package Boruta.
Boruta est un wrapper construit autour de l’algorithme de classification par forêts aléatoires. Il vise à capturer toutes les variables importantes et intéressantes de votre jeu de données par rapport à une variable cible.
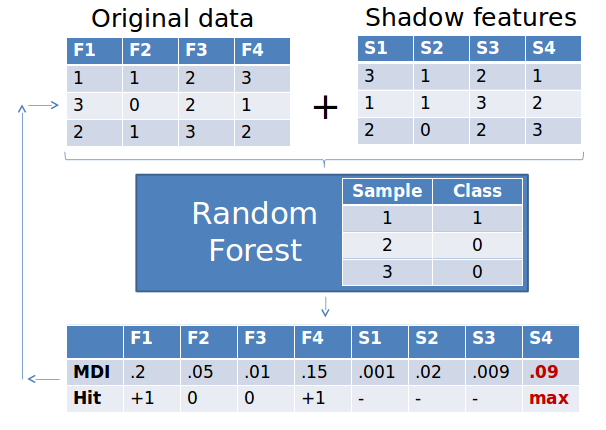
Utilisons Boruta sur l’un des jeux de données les plus répandus : Bank Marketing. Il s’agit de campagnes de marketing direct (appels téléphoniques) d’une banque portugaise. L’objectif est de prédire si un client souscrira un dépôt à terme.
Astuce : consultez la description détaillée des variables ici.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Utilisez la fonction summary() pour obtenir les statistiques descriptives de base des différentes variables.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
summary() fournit les mesures de tendance centrale pour les variables continues (moyenne, médiane, quantiles, etc.). Pour les variables catégorielles, vous verrez aussi la classe et le mode.
Convertissons maintenant les variables catégorielles en facteurs :
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Comme les points sont mélangés pour créer les variables shadow et que le Z-score est calculé pour chacune, il est important de traiter au préalable les valeurs manquantes ou vides avant d’utiliser le package boruta, sous peine d’erreur.
Ce jeu de données n’en contient (mal)heureusement pas. À des fins pédagogiques, vous allez toutefois y injecter quelques NA.
Introduisons des valeurs manquantes dans le jeu via la fonction prodNA(), disponible dans le package missForest.
Rappel : utilisez install.packages() pour installer les packages manquants si besoin.
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Vous pouvez de nouveau appeler summary() sur ce nouveau data frame pour voir le nombre de NA, mais tentons quelque chose de plus visuel.
Visualisons les valeurs manquantes avec le code ggplot2 suivant :
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
Les lignes blanches indiquent visuellement que vous avez injecté des valeurs manquantes dans chaque variable. Mais voyez l’effort nécessaire pour écrire ggplot_missing ? Le package Amelia en R, que vous utiliserez ensuite, propose une alternative en une ligne pour un graphique similaire :
library(Amelia)
missmap(bank.mis)
À vous de jouer !
AmeliaVous pouvez imputer les valeurs manquantes de plusieurs façons (moyenne, médiane, mode pour les variables catégorielles), mais utilisons un package puissant dédié à l’imputation : Amelia.
Amelia tire m échantillons bootstrap et applique l’algorithme EMB (expectation-maximization avec bootstrap) à chacun. Les m estimations de moyennes et variances diffèrent. On utilise ensuite le premier jeu d’estimations pour imputer la première série de valeurs manquantes par régression, puis le deuxième pour la seconde, etc. L’imputation multiple réduit le biais et améliore l’efficacité. Elle est aussi parallélisable sur plusieurs cœurs.
Trois paramètres sont essentiels :
m : nombre de jeux de données imputés à créer.idvars : variables d’identification (ou autres) à conserver sans imputation.noms : variables nominales à indiquer ici.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Pour accéder aux data frames imputés, utilisez le sous-ensemble suivant :
amelia_bank$imputations[[1]]Pour exporter les jeux de données imputés en csv :
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")BorutaAppliquons maintenant Boruta à l’un des jeux de données imputés, grâce au package Boruta :
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta statue sur la significativité des variables d’un jeu de données. Beaucoup sont déjà classées comme importantes ou non, mais certaines restent en catégorie « tentatives ».
Qu’est-ce que cela signifie ?
Les variables tentatives ont une importance trop proche de celle de leurs meilleures variables shadow pour que Boruta puisse trancher avec la confiance souhaitée dans le nombre d’exécutions Random Forest par défaut.
Que faire alors ?
Vous pouvez augmenter le paramètre maxRuns s’il reste des variables tentatives. Notez toutefois que vous pouvez aussi fournir des valeurs pour mtry et ntree, transmises à randomForest(). Le premier fixe le nombre de variables candidates à chaque split, le second le nombre d’arbres à faire croître. Avec ces arguments, la forêt aléatoire converge vers un minimum de l’erreur hors sac.
Rappel : l’erreur hors sac (out-of-bag) estime l’erreur de prédiction d’un classifieur qui utilise l’agrégation bootstrap pour sous-échantillonner les données d’entraînement. C’est l’erreur moyenne de prédiction sur chaque observation X en n’utilisant que les arbres qui n’ont pas vu X dans leur échantillon bootstrap.
Vous pouvez également régler doTrace à 1 ou 2 pour suivre la progression.
Le package boruta fournit aussi TentativeRoughFix() pour résoudre les décisions manquantes en comparant la médiane du Z-score d’une variable avec la médiane du Z-score de la meilleure variable shadow :
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta a désormais terminé son travail : chaque variable est classée comme importante ou non.
Vous pouvez tracer le graphique d’importance des variables avec plot(boruta.bank). Par défaut, les étiquettes de l’axe x sont horizontales, ce qui n’est pas idéal.
Ajoutons donc des étiquettes verticales sur l’axe x avec le code suivant :
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
Le label de l’axe y, Importance, représente le Z-score de chaque variable dans le jeu mélangé.
Les boîtes bleues correspondent aux Z-scores minimal, moyen et maximal d’une variable shadow, tandis que les boîtes rouges et vertes représentent respectivement les Z-scores des variables rejetées et confirmées. Vous constatez que les boîtes rouges ont un Z-score inférieur au Z-score maximal des variables shadow, ce qui explique leur rejet.
Vous pouvez confirmer l’importance des variables avec :
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Vous pouvez aisément valider ce résultat : la variable duration ressort comme la plus importante, ce qui est déjà précisé dans la description des données (voir ici).
Et voilà ! Vous avez identifié les variables clés de votre jeu de données avec seulement quelques lignes de code. Vous avez réduit le bruit, ce qui aidera tout classifieur à mieux labelliser les observations. Entraîner un modèle sur ces variables importantes améliorera très probablement ses performances — l’objectif même de la sélection de variables.
Pour consulter les ressources ayant servi à ce tutoriel, voyez ci-dessous :
Cours R
Cours
Cours
Cours