Kurs
R’ye Giriş
4 sa
3.1M
Özellik sayısı açısından yüksek boyutlu veriler, günümüzde makine öğrenimi problemlerinde giderek daha yaygın. Bu yüksek hacimli verilerden yararlı bilgi çıkarmak için gürültüyü veya yinelenen verileri azaltacak istatistiksel teknikler kullanmanız gerekir. Bunun nedeni, bir modeli eğitmek için elinizdeki her özelliği kullanmanızın çoğu zaman gerekmediğidir. Yalnızca birbiriyle ilişkili olmayan ve tekrarlı olmayan özellikleri besleyerek modelinizi iyileştirebilirsiniz. İşte burada özellik seçimi önemli bir rol oynar. Yalnızca modelinizi daha hızlı eğitmeye yardımcı olmakla kalmaz, aynı zamanda modelin karmaşıklığını azaltır, yorumlamayı kolaylaştırır ve performans ölçütünüz ister doğruluk, ister kesinlik, ister duyarlılık olsun, doğruluğu artırır.
Bu öğreticide aşağıdaki kavramları ele alacaksınız:
Önce özellik seçimi hakkında daha fazla bilgi edineceksiniz: Ne zaman kullanabileceğinizi ve modeliniz için en önemli özellikleri seçmek üzere hangi yöntemlerin mevcut olduğunu göreceksiniz!
Ardından Boruta algoritması ile tanışacaksınız. Orijinal özniteliklerin önemini, permütasyon kopyaları kullanılarak rastgele elde edilebilecek önemle karşılaştırıp, alakasız özellikleri kademeli olarak eleyerek ilgili özellikler için yukarıdan aşağıya bir arama yapmayı nasıl kullanabileceğinizi göreceksiniz.
Ayrıca, özellik seçimini gerçekleştireceğiniz veri kümesine kısaca bakacaksınız. Amelia paketinin yardımıyla eksik değerleri nasıl imputasyonla tamamlayabileceğinizi göreceksiniz.
Son olarak, algoritmayı çalıştırmak için kullanabileceğiniz Boruta paketi hakkında daha fazla bilgi edineceksiniz.
Genel olarak, verinin boyutluluğunu azaltmak istediğinizde Temel Bileşenler Analizi, Tekil Değer Ayrışımı vb. yöntemlerle karşılaşırsınız. O hâlde neden başka özellik seçimi yöntemlerine ihtiyaç duyduğunuzu sormanız doğal. Bu tekniklerin sorunu, denetimsiz özellik seçimi yöntemleri olmalarıdır: Örneğin, verideki varyansı kullanarak bileşenleri bulan PCA’yı ele alın. Bu teknikler, özellik değerleri ile hedef sınıf veya değerler arasındaki bilgiyi hesaba katmaz. Ayrıca, bu tür yöntemlerle ilişkili normallik gibi bazı varsayımlar vardır ve bunları uygulamaya başlamadan önce belli dönüşümler gerektirir. Bu kısıtlar her tür veri için geçerli değildir.
Genel olarak üç tür özellik seçimi yöntemi vardır:
Filtre Yöntemleri: Filtre yöntemleri genellikle bir ön işleme adımı olarak kullanılır. Özelliklerin seçimi herhangi bir makine öğrenimi algoritmasından bağımsızdır. Bunun yerine, özellikler, sonuç değişkeniyle olan korelasyonları için çeşitli istatistiksel testlerde aldıkları puanlara göre seçilir. Yaygın filtre yöntemleri arasında Korelasyon ölçütleri (Pearson, Spearman, Mesafe), Ki-kare testi, Anova, Fisher Skoru vb. bulunur.
Sarmalayıcı Yöntemler: Sarmalayıcı yöntemlerde, bir özellik alt kümesini kullanıp bunlarla bir model eğitirsiniz. Önceki modelden çıkardığınız sonuçlara dayanarak, alt kümeden özellik eklemeye veya çıkarmaya karar verirsiniz. İleriye Doğru Seçim, Geriye Doğru Eleme sarmalayıcı yöntemlere örnektir.
Gömülü Yöntemler: Kendi yerleşik özellik seçimi yöntemlerine sahip algoritmalardır. LASSO regresyonu buna bir örnektir.
Bu öğreticide R’de Boruta adlı bir paket aracılığıyla hazır bulunan sarmalayıcı yöntemlerden birini kullanacaksınız.
Boruta algoritması, rastgele orman sınıflandırma algoritması etrafında oluşturulmuş bir sarmalayıcıdır. Bir sonuç değişkeniyle ilişkili olarak, veri kümenizde bulunabilecek tüm önemli ve ilgi çekici özellikleri yakalamaya çalışır.
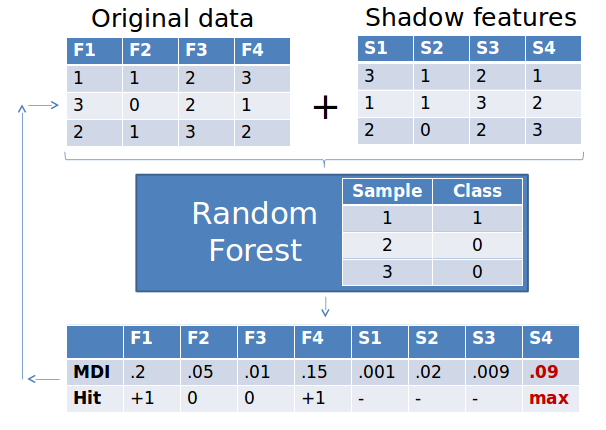
Boruta algoritmasını en yaygın bulunan veri kümelerinden birinde kullanalım: Banka Pazarlama verisi. Bu veri, bir Portekiz bankacılık kuruluşunun doğrudan pazarlama kampanyalarını (telefon aramaları) temsil eder. Sınıflandırma hedefi, müşterinin vadeli mevduata abone olup olmayacağını tahmin etmektir.
İpucu: Farklı özelliklerin ayrıntılı açıklamasını buradan incelemeyi unutmayın.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Veri kümenizdeki farklı özelliklerin ortak betimleyici istatistiklerini özetlemek için summary() işlevini kullanalım.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
summary() işlevi, ortalama, medyan, çeyrekler vb. gibi sürekli özellikler için merkezi eğilim ölçülerini verir. Veri kümenizde kategorik özellikler varsa, bu özelliklerin Sınıfını ve Modunu da görürsünüz.
Şimdi kategorik özellikleri factor veri tipine dönüştürelim:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Gölge özellikler oluşturmak için veri noktaları karıştırıldığından ve her biri için Z-skoru hesaplandığından, boruta paketini kullanmadan önce eksik veya boş değerleri ele almak önemlidir; aksi takdirde hata verir.
(Ne) yazık ki bu veri kümesinde ikisi de yok. Ancak eğitim amaçlı olarak veriye bazı NA’ler ekleyeceksiniz.
Veri kümenize eksik değerleri prodNA() işlevini kullanarak tohumlayalım. Bu işlevi missForest paketini kurarak kullanabilirsiniz.
Unutmayın ki, gerekirse eksik paketleri kurmak için install.packages() kullanabilirsiniz!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Yeni veri çerçevenizde imputasyonla oluşturulan NA sayısını almak için yine summary() işlevini çağırabilirsiniz, ancak gelin biraz daha yaratıcı olalım!
Verideki eksiklik durumunu aşağıdaki ggplot2 kodunu kullanarak görselleştirelim:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
Grafikteki beyaz çizgiler, her özellikte eksik değerleri tohumladığınızı görsel olarak gösterir; ancak ggplot_missing işlevini yazmanın ne kadar zahmetli olduğuna dikkat ettiniz mi? Neyse ki bir sonraki bölümde kullanacağınız R’deki Amelia paketi, benzer bir grafiği çizmek için tek satırlık bir alternatif sunuyor:
library(Amelia)
missmap(bank.mis)
Kendiniz deneyin!
Amelia ile İmputasyonuEksik değerleri ortalama, medyan veya mod (kategorik özellikler için) ile tamamlamak gibi çeşitli yollarla imputasyon yapabilirsiniz; ancak gelin eksik değerlerin imputasyonu için güçlü bir başka paketi, Amelia’yı kullanalım.
Amelia, m bootstrap örneklemi alır ve her örneklemde EMB (bootstrap’lı beklenti-maksimizasyon) algoritmasını uygular. m adet ortalama ve varyans tahmini farklı olacaktır. Son olarak, ilk tahmin kümesi birinci eksik değer kümesini regresyonla imputasyon için, ikinci tahmin kümesi ikinci küme için vb. kullanılır. Çoklu imputasyon yanlılığı azaltmaya ve verimliliği artırmaya yardımcı olur. Ayrıca çok çekirdekli CPU’lar kullanılarak paralel imputasyon özelliğiyle de etkinleştirilmiştir.
3 önemli parametresi vardır:
m: oluşturulacak imputasyonlu veri kümesi sayısı.idvars: imputasyon yapmak istemediğiniz tüm kimlik değişkenlerini ve diğer değişkenleri burada tutun.noms: nominal değişkenleri burada belirtin.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5İmputasyonlu veri çerçevelerine erişmek için aşağıdaki alt kümelendirmeyi kullanabilirsiniz:
amelia_bank$imputations[[1]]İmputasyonlu veri kümesini csv dosyalarına aktarmak için şunu kullanın:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")Boruta R PaketiŞimdi Boruta algoritmasını imputasyonlu veri kümelerinden birinde kullanalım. Bunu yapmak için Boruta paketinden yararlanabilirsiniz:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta, bir veri kümesindeki özelliklerin önemine ilişkin bir karar verir. Birçoğu zaten önemli veya önemsiz olarak sınıflandırılmıştır; ancak bazılarının geçici (tentative) kategorisine atandığını görürsünüz.
Peki bu ne anlama geliyor?
Geçici özelliklerin önemi, en iyi gölge özelliklerinin önemine o kadar yakındır ki, varsayılan Rastgele Orman çalıştırma sayısında Boruta istenen güvenle karar veremez.
Peki bu durumda ne yapmalısınız?
Geçici özellikler kaldıysa maxRuns parametresini artırmayı düşünebilirsiniz. Ancak, not edin ki mtry ve ntree parametreleri için de değerler sağlayabilirsiniz; bunlar randomForest() işlevine iletilecektir. İlki, her bölünmede aday olarak rastgele örneklenen değişken sayısını belirtmenize olanak tanırken, ikincisi büyütmek istediğiniz ağaç sayısını belirtmek için kullanılır. Bu argümanlar belirtildiğinde, Rastgele Orman sınıflandırıcısı, torba dışı hata değerinin en düşük olduğu noktada yakınsamayı sağlayacaktır.
Unutmayın ki torba dışı hata, eğitim için kullanılan veri örneklerini bootstrap ile alt örnekleyen sınıflandırıcıların tahmin hatasını ölçmek için bir tahmindir. Her bir eğitim örneği X için, bootstrap örneğinde X’i içermeyen ağaçlar kullanılarak elde edilen ortalama tahmin hatasıdır.
Alternatif olarak, sürecin ilerleyişine dair rapor almak için doTrace argümanını 1 veya 2 olarak ayarlayabilirsiniz.
boruta paketi ayrıca, orta özellik Z-skorunu en önemli gölge özelliğin orta Z-skoru ile basitçe karşılaştırarak eksik kararları doldurmak için kullanılabilecek bir TentativeRoughFix() işlevi içerir:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta artık işini yaptı: Her özelliği önemli veya önemsiz olarak başarıyla sınıflandırdı.
Değişken önem grafiğini plot(boruta.bank) çağrısıyla çizebilirsiniz. Ancak, x ekseni etiketleri yatay olacaktır. Bu pek derli toplu görünmez.
Bu yüzden, aşağıdaki kod parçasında olduğu gibi x eksenine özellik etiketlerini dikey olarak ekleyeceksiniz:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
y ekseni etiketi Importance, karıştırılmış veri kümesindeki her bir özelliğin Z skorunu temsil eder.
Mavi kutu grafikleri bir gölge özelliğin minimum, ortalama ve maksimum Z skorlarına karşılık gelirken, kırmızı ve yeşil kutu grafikleri sırasıyla reddedilen ve onaylanan özelliklerin Z skorlarını temsil eder. Gördüğünüz gibi kırmızı kutu grafikleri, gölge özelliğin maksimum Z skorundan daha düşük Z skoruna sahiptir; bu da onların önemsiz kategorisine konulmalarının tam nedenidir.
Özelliklerin önemini şu komutla doğrulayabilirsiniz:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Sonucu kolayca doğrulayabilirsiniz; çünkü duration özelliğine en yüksek önem verilmiştir ki veri açıklamasında da bu dikkatle okursanız belirtilmiştir (bkz. burası)!
İşte bu kadar! Sadece birkaç satır kod yazarak veri kümenizdeki en önemli özellikleri başarıyla filtrelediniz. Böylece verinizdeki gürültüyü azalttınız; bu da herhangi bir sınıflandırıcının bir gözleme etiket ataması için gerçekten faydalı olacaktır. Bu önemli özellikler üzerinde bir model eğitmek, modelinizin performansını kesinlikle iyileştirecektir; zaten özellik seçimini yapmanızın amacı da buydu!
Bu öğreticiyi hazırlarken kullanılan kaynaklara göz atmak isterseniz, aşağıdakilere bakın:
R Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




