Curso
Introducción a R
4 h
3.1M
Los datos de alta dimensión, en términos de número de variables, son cada vez más habituales en problemas de machine learning. Para extraer información útil de estos grandes volúmenes de datos, conviene aplicar técnicas estadísticas que reduzcan el ruido o la redundancia. No siempre necesitas usar todas las variables disponibles para entrenar un modelo: puedes mejorarlo si solo le das variables no correlacionadas y no redundantes. Aquí es donde la selección de características cobra protagonismo. No solo acelera el entrenamiento, también reduce la complejidad del modelo, facilita su interpretación y mejora métricas como la exactitud, la precisión o el recall.
En este tutorial vas a trabajar los siguientes conceptos:
Primero, aprenderás más sobre la selección de características: cuándo usarla y qué tipos de métodos tienes disponibles para elegir las variables más importantes para tu modelo.
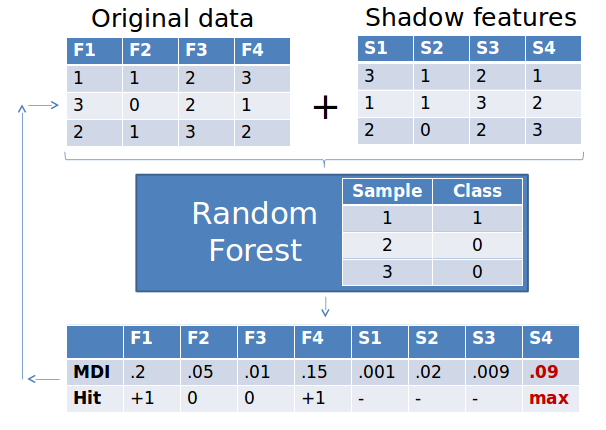
Después, conocerás el algoritmo Boruta. Verás cómo realizar una búsqueda descendente de variables relevantes comparando la importancia de los atributos originales con la importancia alcanzable al azar, estimada usando copias permutadas, y eliminando progresivamente las variables irrelevantes.
También echarás un vistazo rápido al conjunto de datos sobre el que harás la selección de características. Verás lo sencillo que es imputar valores perdidos con la ayuda del paquete Amelia.
Por último, conocerás mejor el paquete Boruta, que usarás para ejecutar el algoritmo.
Cuando quieres reducir la dimensionalidad de los datos, suelen aparecer métodos como el análisis de componentes principales o la descomposición en valores singulares. Es lógico preguntarse por qué hacen falta otros métodos de selección de características. El caso es que estas técnicas son enfoques no supervisados: por ejemplo, PCA usa la varianza para encontrar componentes. No tienen en cuenta la relación entre las variables y la clase o variable objetivo. Además, suelen implicar supuestos como la normalidad, que requieren transformaciones antes de aplicarlas. Estas restricciones no se ajustan a todo tipo de datos.
En general, hay tres tipos de métodos de selección de características:
Métodos filtro: se usan como paso de preprocesado. La selección de variables es independiente de cualquier algoritmo de machine learning. En su lugar, se eligen según su puntuación en pruebas estadísticas de correlación con la variable de salida. Algunos ejemplos: métricas de correlación (Pearson, Spearman, distancia), Chi-cuadrado, ANOVA, puntuación de Fisher, etc.
Métodos envoltorio: se prueba con un subconjunto de variables y se entrena un modelo con ellas. A partir de lo que aprendes del modelo anterior, decides añadir o quitar variables del subconjunto. La selección hacia delante y la eliminación hacia atrás son ejemplos típicos.
Métodos embebidos: algoritmos que incorporan su propia selección de variables. La regresión LASSO es un buen ejemplo.
En este tutorial usarás uno de los métodos envoltorio disponible en R mediante el paquete Boruta.
Boruta es un método envoltorio construido sobre el algoritmo de clasificación Random Forest. Intenta capturar todas las variables importantes e interesantes de tu conjunto de datos con respecto a una variable objetivo.
Usemos Boruta en uno de los conjuntos de datos más conocidos: Bank Marketing. Representa campañas de marketing directo (llamadas telefónicas) de una entidad bancaria portuguesa. El objetivo es predecir si el cliente contratará un depósito a plazo o no.
Consejo: no olvides consultar la descripción detallada de las variables aquí.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Usa la función summary() para resumir las estadísticas descriptivas de las distintas variables del conjunto de datos.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
summary() ofrece medidas de tendencia central para variables continuas como media, mediana, cuantiles, etc. Si hay variables categóricas, también verás su clase y modo.
Ahora convierte las variables categóricas al tipo factor:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Puesto que se barajan los datos para crear variables sombra y se calcula el Z-score para cada una, es importante tratar los valores ausentes o en blanco antes de usar el paquete boruta; de lo contrario, aparecerán errores.
Por (des)gracia, este conjunto no tiene ninguno. Aun así, con fines didácticos, vamos a introducir algunos NA en los datos.
Sembramos valores perdidos con la función prodNA(), disponible en el paquete missForest.
Recuerda que puedes usar install.packages() para instalar paquetes que te falten.
library(missForest)

# Genera un 5% de valores perdidos al azar
bank.mis <- prodNA(read_file, noNA = 0.05)
De nuevo puedes llamar a summary() sobre el nuevo data frame para ver cuántos NA hay imputados, pero vamos a ponernos un poco más creativos.
Visualiza la falta de datos con el siguiente código de ggplot2:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
Las líneas blancas del gráfico muestran visualmente que has sembrado valores perdidos en todas las variables, pero ¿ves el trabajo que ha supuesto escribir la función ggplot_missing? El paquete Amelia en R, que usarás en la siguiente sección, ofrece una alternativa en una sola línea para dibujar una figura similar:
library(Amelia)
missmap(bank.mis)
¡Pruébalo tú mismo!
AmeliaPuedes imputar los valores perdidos de varias formas, como imputar con la media, la mediana o la moda (para variables categóricas), pero vamos a usar otro paquete potente para imputación: Amelia.
Amelia toma m muestras bootstrap y aplica el algoritmo EMB (expectación-maximización con bootstrap) a cada muestra. Las m estimaciones de medias y varianzas serán distintas. Finalmente, el primer conjunto de estimaciones se usa para imputar el primer conjunto de valores perdidos mediante regresión; el segundo para el segundo, y así sucesivamente. La imputación múltiple ayuda a reducir sesgos y aumentar la eficiencia. Además, permite imputación en paralelo usando CPUs multinúcleo.
Tiene 3 parámetros importantes:
m: número de conjuntos imputados a crear.idvars: variables identificadoras u otras que no quieres imputar.noms: variables nominales.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Para acceder a los data frames imputados, usa el siguiente subconjunto:
amelia_bank$imputations[[1]]Para exportar el conjunto imputado a archivos csv usa:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")BorutaAhora apliquemos Boruta sobre uno de los conjuntos imputados. Puedes usar el paquete Boruta para hacerlo:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta determina la significación de las variables de un conjunto de datos. Muchas ya quedan clasificadas como importantes o no importantes, pero verás que algunas aparecen como tentativas.
¿Qué significa esto?
Las variables tentativas tienen una importancia tan cercana a la de sus mejores variables sombra que Boruta no puede decidir con la confianza deseada en el número por defecto de ejecuciones de Random Forest.
¿Qué puedes hacer entonces?
Podrías aumentar el parámetro maxRuns si quedan variables tentativas. No obstante, ten en cuenta que también puedes proporcionar valores para mtry y ntree, que se pasan a la función randomForest(). El primero especifica cuántas variables se muestrean aleatoriamente como candidatas en cada partición, y el segundo cuántos árboles quieres crecer. Con estos argumentos, el clasificador Random Forest tenderá a converger en un valor mínimo del error out-of-bag.
Recuerda que el error out-of-bag es una estimación del error de predicción para clasificadores que usan bootstrap agregando submuestras del conjunto de entrenamiento. Es el error medio de predicción en cada muestra de entrenamiento X usando solo los árboles que no incluyeron X en su muestra bootstrap.
Alternativamente, puedes establecer doTrace a 1 o 2 para obtener un informe del progreso.
El paquete boruta también incluye la función TentativeRoughFix(), que sirve para resolver decisiones pendientes mediante una comparación simple de la mediana del Z-score de la característica con la mediana del Z-score de la variable sombra más importante:
# resolver las variables tentativas
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta ya ha hecho su trabajo: ha clasificado cada variable como importante o no importante.
Ahora puedes dibujar el gráfico de importancia de variables con plot(boruta.bank). Sin embargo, las etiquetas del eje x saldrán en horizontal y no quedará muy limpio.
Por eso vas a añadir las etiquetas del eje x en vertical, como en este fragmento:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
La etiqueta del eje y, Importance, representa el Z-score de cada variable en el conjunto de datos barajado.
Los diagramas de caja azules corresponden al Z-score mínimo, medio y máximo de una variable sombra; los rojos y verdes representan los Z-scores de variables rechazadas y confirmadas, respectivamente. Como ves, los rojos tienen un Z-score menor que el máximo Z-score de las sombras, razón por la que se clasifican como no importantes.
Puedes confirmar la importancia de las variables escribiendo:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Puedes validar fácilmente el resultado: la variable duration recibe la mayor importancia, tal como se menciona en la descripción del conjunto de datos (haz clic aquí si lo lees con atención).
¡Voilà! Has filtrado con éxito las variables más importantes de tu conjunto de datos con solo unas pocas líneas de código. Con ello has reducido el ruido, lo que ayudará a cualquier clasificador a asignar etiquetas a las observaciones. Entrenar un modelo con estas variables clave mejorará su rendimiento, que es precisamente el objetivo de hacer selección de características.
Si quieres consultar los recursos usados para este tutorial, aquí los tienes:
Cursos de R
Curso
Curso
Curso
Tutorial
Arunn Thevapalan
15 min
Tutorial
Adam Shafi
14 min
Tutorial
DataCamp Team
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Zoumana Keita
15 min
Tutorial
DataCamp Team
4 min