Kurs
Einführung in R
4 Std.
3.1M
Hochdimensionale Daten mit vielen Merkmalen sind heute in Machine-Learning-Anwendungen an der Tagesordnung. Um aus diesen großen Datenmengen nützliche Informationen zu ziehen, brauchst du statistische Techniken, die Rauschen und Redundanzen reduzieren. Du musst nämlich nicht jedes verfügbare Merkmal zum Trainieren eines Modells nutzen. Oft performt dein Modell besser, wenn du nur unkorrelierte, nicht redundante Merkmale einspeist. Genau hier kommt die Featureauswahl ins Spiel. Sie beschleunigt nicht nur das Training, sondern senkt auch die Modellkomplexität, erleichtert die Interpretation und verbessert Metriken wie Genauigkeit, Präzision oder Recall – je nachdem, worauf du optimierst.
In diesem Tutorial behandelst du die folgenden Konzepte:
Als Erstes lernst du mehr über die Featureauswahl: Wann setze ich sie ein und welche Methoden stehen zur Verfügung, um die wichtigsten Merkmale für mein Modell zu wählen?
Dann lernst du den Boruta-Algorithmus kennen. Du siehst, wie du damit eine Top-down-Suche nach relevanten Merkmalen durchführst, indem du die Wichtigkeit der Originalmerkmale mit der zufällig erreichbaren Wichtigkeit ihrer permutierten Kopien vergleichst und nach und nach irrelevante Merkmale entfernst.
Außerdem wirfst du einen kurzen Blick auf den Datensatz, auf dem du die Featureauswahl anwendest, und siehst, wie du fehlende Werte mit dem Paket Amelia imputierst.
Zum Schluss erfährst du mehr über das Boruta-Paket, mit dem du den Algorithmus in R laufen lässt.
Wenn du die Dimensionalität von Daten verringern willst, denkst du vermutlich zuerst an Methoden wie die Hauptkomponentenanalyse (PCA) oder die Singulärwertzerlegung. Warum also weitere Featureauswahl-Methoden? Der Punkt ist: Diese Techniken sind unüberwachte Verfahren. PCA etwa nutzt die Varianz in den Daten, um Komponenten zu finden, berücksichtigt aber nicht den Zusammenhang zwischen Merkmalswerten und Zielvariable. Zusätzlich setzen einige dieser Methoden Annahmen wie Normalverteilung voraus und erfordern vorab Transformationen. Diese Voraussetzungen treffen nicht auf alle Datensätze zu.
Grundsätzlich unterscheidet man drei Arten der Featureauswahl:
Filter-Methoden: Sie werden meist als Preprocessing-Schritt genutzt. Die Merkmalsauswahl ist unabhängig vom eigentlichen Machine-Learning-Algorithmus. Stattdessen wählst du Merkmale basierend auf ihren Scores in statistischen Tests zur Korrelation mit der Zielgröße aus. Häufige Filter sind Korrelationsmaße (Pearson, Spearman, Distanz), Chi-Quadrat-Test, ANOVA, Fisher-Score usw.
Wrapper-Methoden: Hier wählst du einen Merkmals-Teilraum, trainierst damit ein Modell und passt die Auswahl iterativ an – hinzugefügte oder entfernte Features ergeben sich aus den Rückschlüssen der vorherigen Modelle. Beispiele sind Forward Selection und Backward Elimination.
Embedded-Methoden: Algorithmen mit integrierter Featureauswahl. LASSO-Regression ist ein prominentes Beispiel.
In diesem Tutorial nutzt du eine Wrapper-Methode, die in R mit dem Paket Boruta sofort einsatzbereit ist.
Der Boruta-Algorithmus ist ein Wrapper um den Random-Forest-Klassifikationsalgorithmus. Er versucht, mit Blick auf die Zielvariable alle wichtigen und interessanten Merkmale in deinem Datensatz zu erfassen.
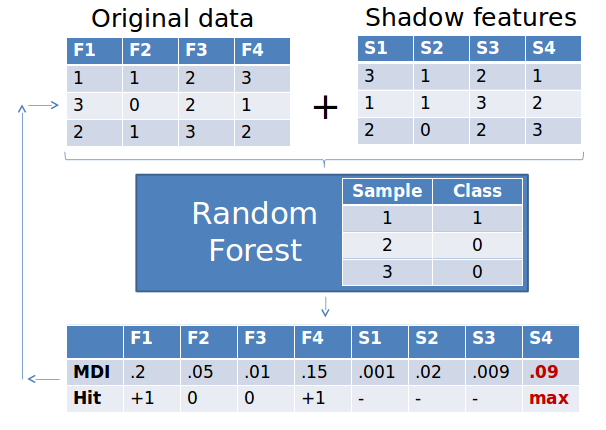
Setzen wir Boruta auf einem der gängigsten Datensätze ein: den Bank-Marketing-Daten. Sie stammen aus Direktmarketing-Kampagnen (Telefonanrufe) einer portugiesischen Bank. Ziel ist, vorherzusagen, ob ein Kunde ein Termingeldkonto abschließt oder nicht.
Tipp: Eine ausführliche Beschreibung der Merkmale findest du hier.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Nutze die Funktion summary(), um gängige beschreibende Statistiken der Merkmale im Datensatz zusammenzufassen.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
summary() liefert für kontinuierliche Merkmale Lage- und Streuungsmaße wie Mittelwert, Median, Quartile usw. Für kategoriale Merkmale siehst du zusätzlich Class und Mode.
Konvertiere nun kategoriale Merkmale in den Datentyp Factor:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Da die Datenpunkte für die Shadow-Features permutiert werden und Z-Scores für alle berechnet werden, solltest du fehlende oder leere Werte vor der Nutzung des boruta-Pakets behandeln – sonst kommt es zu Fehlern.
(Un)glücklicherweise enthält dieser Datensatz keine fehlenden Werte. Für Demonstrationszwecke fügen wir dennoch einige NAs ein.
Streue fehlende Werte mit der Funktion prodNA(). Sie gehört zum Paket missForest.
Merke: Fehlende Pakete installierst du bei Bedarf mit install.packages()!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Du kannst erneut summary() auf den neuen Data Frame anwenden, um fehlende NAs zu zählen – oder wir werden etwas kreativer.
Visualisiere die Missingness im Datensatz mit folgendem ggplot2-Code:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
Die weißen Linien in der Grafik zeigen dir, dass in allen Merkmalen fehlende Werte eingesät wurden. Der Aufwand für die Funktion ggplot_missing war jedoch nicht gerade klein. Das Paket Amelia in R, das du im nächsten Abschnitt nutzt, bietet eine Ein-Zeilen-Alternative für eine ähnliche Darstellung:
library(Amelia)
missmap(bank.mis)
Probier es selbst aus!
Amelia imputierenFehlende Werte kannst du auf verschiedene Arten ersetzen, z. B. mit Mittelwert, Median oder Modus (für kategoriale Merkmale). Wir nutzen hier das leistungsstarke Paket Amelia zur Imputation.
Amelia zieht m Bootstrap-Stichproben und wendet auf jede das EMB-Verfahren (Expectation-Maximization mit Bootstrapping) an. Die m Schätzungen für Mittelwerte und Varianzen unterscheiden sich. Anschließend werden die fehlenden Werte mehrfach imputiert: zuerst mit den ersten Schätzungen via Regression, dann mit den zweiten usw. Multiple Imputation reduziert Verzerrungen und erhöht die Effizienz. Außerdem unterstützt Amelia parallele Imputation über Multicore-CPUs.
Drei Parameter sind besonders wichtig:
m: Anzahl der zu erstellenden imputierten Datensätze.idvars: Behalte ID-Variablen und alle Variablen, die nicht imputiert werden sollen.noms: Lege hier nominale Variablen ab.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Auf die imputierten Data Frames greifst du per Subsetting zu:
amelia_bank$imputations[[1]]Zum Export der imputierten Datensätze als csv nutzt du:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")BorutaJetzt wenden wir den Boruta-Algorithmus auf einen der imputierten Datensätze an. Verwende dafür das Paket Boruta:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta trifft eine Aussage über die Signifikanz der Merkmale im Datensatz. Viele sind bereits als wichtig oder unwichtig klassifiziert, einige verbleiben jedoch zunächst als „tentative“.
Was heißt das?
Tentative Merkmale haben eine Wichtigkeit, die so nahe an der ihrer besten Shadow-Features liegt, dass Boruta mit der standardmäßigen Anzahl an Random-Forest-Durchläufen keine Entscheidung mit der gewünschten Sicherheit treffen kann.
Was kannst du tun?
Du kannst den Parameter maxRuns erhöhen, wenn nach Abschluss noch tentative Merkmale übrig sind. Beachte außerdem, dass du mtry und ntree angeben kannst; sie werden an die Funktion randomForest() übergeben. Mit mtry definierst du die Anzahl der Variablen, die an jedem Split zufällig als Kandidaten gezogen werden, und mit ntree die Anzahl der zu wachsenden Bäume. Mit passenden Werten erreicht der Random Forest bei minimalem Out-of-Bag-Fehler die Konvergenz.
Merke: Der Out-of-Bag-Fehler ist eine Schätzung des Vorhersagefehlers von Klassifikatoren, die Bootstrapping verwenden. Er ist der mittlere Fehler der Vorhersagen für Trainingsbeobachtung X, berechnet nur mit Bäumen, deren Bootstrap-Stichprobe X nicht enthält.
Alternativ kannst du doTrace auf 1 oder 2 setzen, um Fortschrittsmeldungen zu erhalten.
Das Paket boruta bietet außerdem die Funktion TentativeRoughFix(), die fehlende Entscheidungen schließt, indem der mediane Z-Score eines Merkmals mit dem medianen Z-Score des wichtigsten Shadow-Features verglichen wird:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta hat seine Arbeit erledigt: Jedes Merkmal ist nun als wichtig oder unwichtig eingestuft.
Du kannst die Variable-Importance-Grafik mit plot(boruta.bank) erstellen. Die x-Achsen-Beschriftungen sind jedoch standardmäßig horizontal – nicht besonders übersichtlich.
Daher drehen wir die Beschriftungen vertikal, so wie im folgenden Code:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
Die y-Achse Importance zeigt den Z-Score jedes Merkmals im permutierten Datensatz.
Die blauen Boxplots entsprechen minimalem, mittlerem und maximalem Z-Score eines Shadow-Features, die roten und grünen Boxplots zeigen die Z-Scores abgelehnter bzw. bestätigter Merkmale. Wie du siehst, liegen die roten Boxplots unter dem maximalen Z-Score der Shadow-Features – genau deshalb wurden sie als unwichtig eingestuft.
Die Wichtigkeit der Merkmale kannst du so ausgeben:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Das Ergebnis ist plausibel: Das Merkmal duration erhält die höchste Wichtigkeit – genau wie in der Datensatzbeschreibung (siehe hier) erwähnt.
Voilà! Du hast mit wenigen Zeilen Code die wichtigsten Merkmale aus deinem Datensatz gefiltert. Damit hast du Rauschen reduziert – ein klarer Vorteil für jeden Klassifikator bei der Labelzuweisung. Ein Modell, das nur auf diesen wichtigen Merkmalen trainiert wird, wird die Performance deutlich steigern – genau das ist der Zweck der Featureauswahl!
Wenn du die Quellen für dieses Tutorial nachlesen möchtest, schau dir Folgendes an:
R-Kurse
Kurs
Kurs
Kurs