
Cursus
Transformermodels met PyTorch
2 uur
9.2K
LLM-inferentie (Large Language Models) is een vak op zich aan het worden.
Steeds meer bedrijven zoeken LLM-inferentie- en MLOps-engineers die modellen sneller kunnen serven, minder hardware gebruiken en de inferentiekosten verlagen.
Of je nu lokaal modellen draait, een inferentieserver uitrolt of experimenteert met open-source LLM’s, begrijpen hoe inferentie werkt kan enorm veel verschil maken.
Achter efficiënte LLM-inferentie zit een hele stack aan technieken, waaronder quantization, KV-cache-optimalisatie, continuous batching, geoptimaliseerde attention-kernels, speculative decoding en hardwarebewuste tuning.
Veel moderne inferentiekaders schakelen sommige hiervan automatisch in, wat betekent dat je er mogelijk al van profiteert zonder precies te weten wat er onder de motorkap gebeurt.
In deze gids verken ik de basis van LLM-inferentie, de belangrijkste prestatietrends en -metrics, populaire serving-frameworks en praktische technieken om modellen sneller, geheugenefficiënter en goedkoper te draaien.
We beginnen met de basis: wat inferentie is, hoe inferentie werkt, hoe performance wordt gemeten en waarom modelarchitectuur ertoe doet.
LLM-inferentie gebeurt elke keer dat je een prompt naar een taalmodel stuurt en op een antwoord wacht. Het model verwerkt de input door zijn lagen en genereert vervolgens de output token voor token.
Dit is anders dan trainen. Tijdens training leert het model van data en past het zijn gewichten aan. Tijdens inferentie staan die gewichten vast en wordt het getrainde model simpelweg gebruikt om voorspellingen te genereren.
Inferentie is waar in productie het overgrote deel van de LLM-rekenkosten plaatsvindt.
Een model wordt misschien één keer getraind, maar verwerkt miljoenen requests. Daardoor is inferentie-efficiëntie nu een van de meest bepalende engineeringvraagstukken in toegepaste AI.
Begrijpen hoe inferentie technisch werkt is belangrijk, omdat de knelpunten niet altijd voor de hand liggen.
Snellere hardware betekent niet altijd snellere reacties. Grotere modellen zijn niet altijd trager. De architectuur van het model, de lengte van de input, de batchgrootte en de serving-infrastructuur grijpen op elkaar in op manieren die je wil begrijpen voordat je gaat optimaliseren.
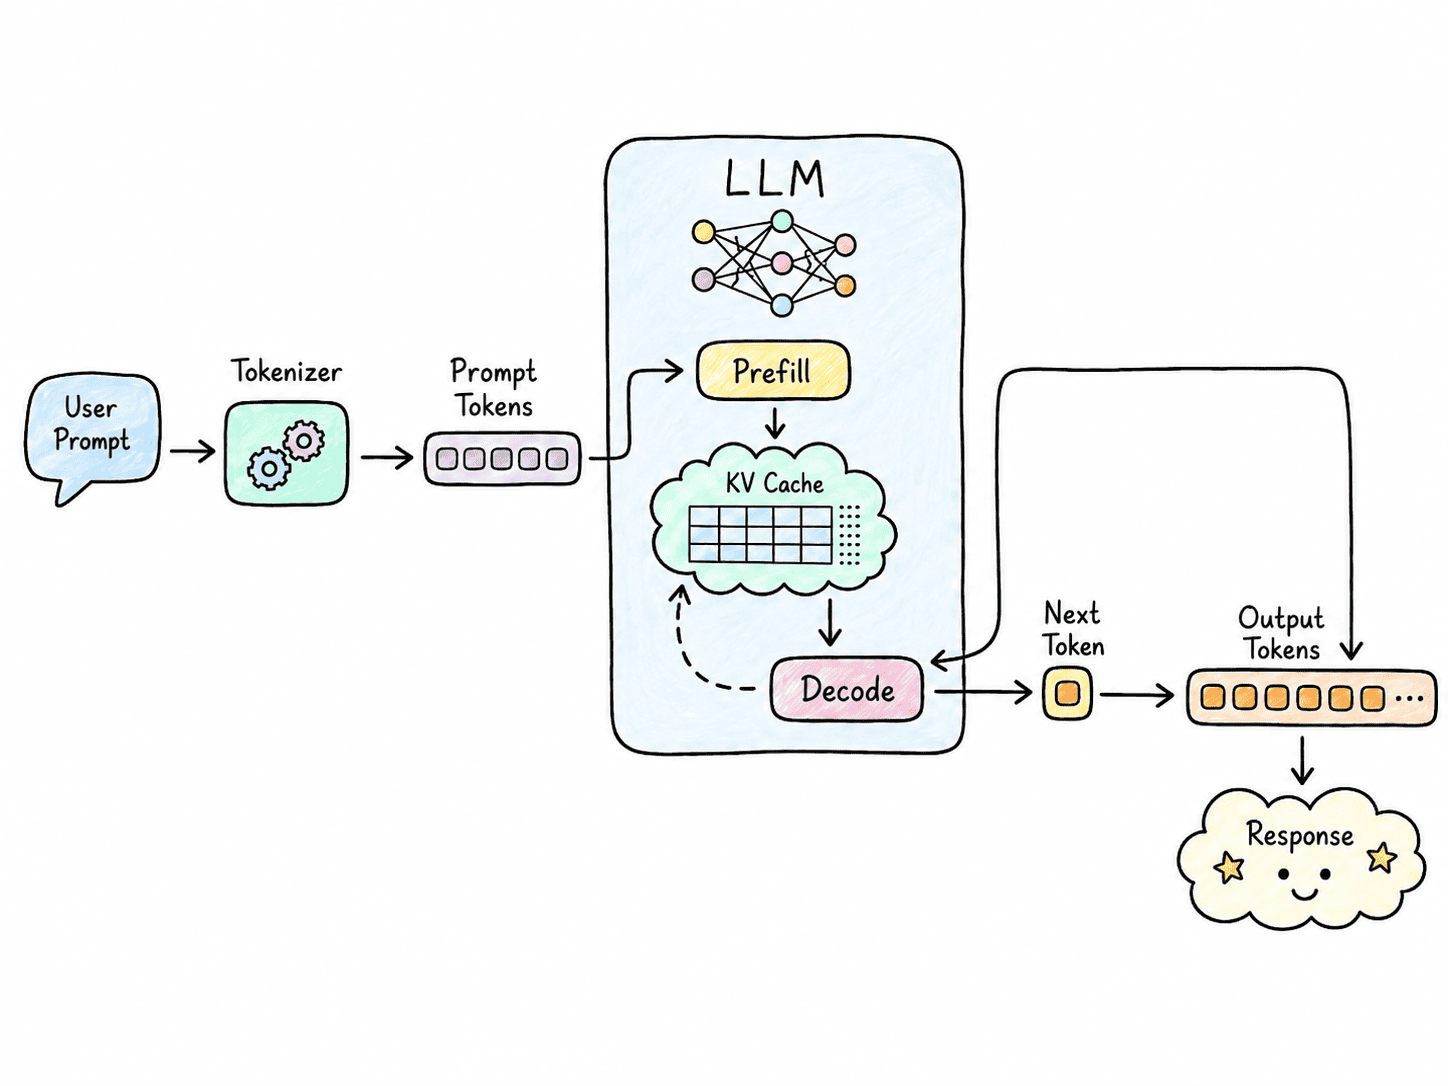
Voor de meeste decodergebaseerde LLM’s bestaat inferentie uit twee hoofdfases: prefill en decode.
Bij kleinere batchgroottes wordt decoderen vaak meer beperkt door geheugenbandbreedte dan door ruwe GPU-compute, omdat modelgewichten en gecachte attention-toestanden continu uit het geheugen moeten worden gelezen.
Dit onderscheid is belangrijk, omdat een optimalisatie die prefill-prestaties verbetert, niet per se ook decoding verbetert.
Er is geen enkele metric die vertelt of een inferentieserver snel, efficiënt of kosteneffectief is. Deze metrics helpen knelpunten opsporen, serving-opzetten vergelijken en bepalen of een optimalisatie de performance daadwerkelijk verbetert.
Enkele van de belangrijkste metrics zijn:
Cache hit rate kan in productie extra belangrijk zijn. Agentische systemen hergebruiken vaak grote systeemprompts, tooldefinities, conversatieprefixen of documenten.
Als 95% of meer van die input uit cache kan worden geserveerd, kan herhaalde prefill-berekening sterk worden verminderd, wat latency verbetert en de effectieve kosten van die requests verlaagt.
Deze metrics hangen nauw samen.
Grotere batches en hogere concurrency kunnen throughput en GPU-utilisatie verbeteren, maar de latency voor individuele gebruikers verhogen.
Zo kan het verlagen van de precisie het geheugengebruik en de hardware-eisen beperken, maar de generatie niet versnellen als de hardware geen geoptimaliseerde kernels voor dat formaat heeft.
Het doel is daarom niet één metric te maximaliseren, maar de juiste balans te vinden tussen latency, throughput, benutting en kosten voor jouw workload.
Inferentieprestaties worden sterk beïnvloed door de architectuur van het model zelf.
Een dense transformer gebruikt in wezen al zijn parameters voor elke token. Een Mixture-of-Experts (MoE)-model daarentegen bevat veel experts, maar activeert voor elke token slechts een kleine subset.
Dit kan de hoeveelheid berekening per token verminderen, maar introduceert ook uitdagingen zoals expert routing, load balancing, GPU-communicatie en plaatsing van experts.
De attention-architectuur heeft ook een groot effect op geheugenverbruik en inferentiesnelheid.
Traditionele Multi-Head Attention (MHA) slaat voor elke attention-head afzonderlijke key- en value-representaties op, waardoor de KV-cache groot kan worden.
Multi-Query Attention (MQA) vermindert deze geheugenvraag door meerdere query-heads dezelfde keys en values te laten delen.
Grouped-Query Attention (GQA) zit ertussenin: groepen query-heads delen key-value-representaties. Nieuwere architecturen gebruiken technieken zoals Multi-head Latent Attention (MLA), die deze representaties nog verder comprimeren.
Daarom kunnen twee modellen met een vergelijkbaar aantal parameters zich tijdens inferentie heel verschillend gedragen.
Hun architectuur kan aanzienlijk van invloed zijn op rekenvereisten, KV-cachesize, geheugenverbruik en generatiesnelheid.
Vervolgens kijken we naar de meest gebruikte frameworks voor het draaien van LLM’s, van lokale setups tot grootschalige productiesystemen.
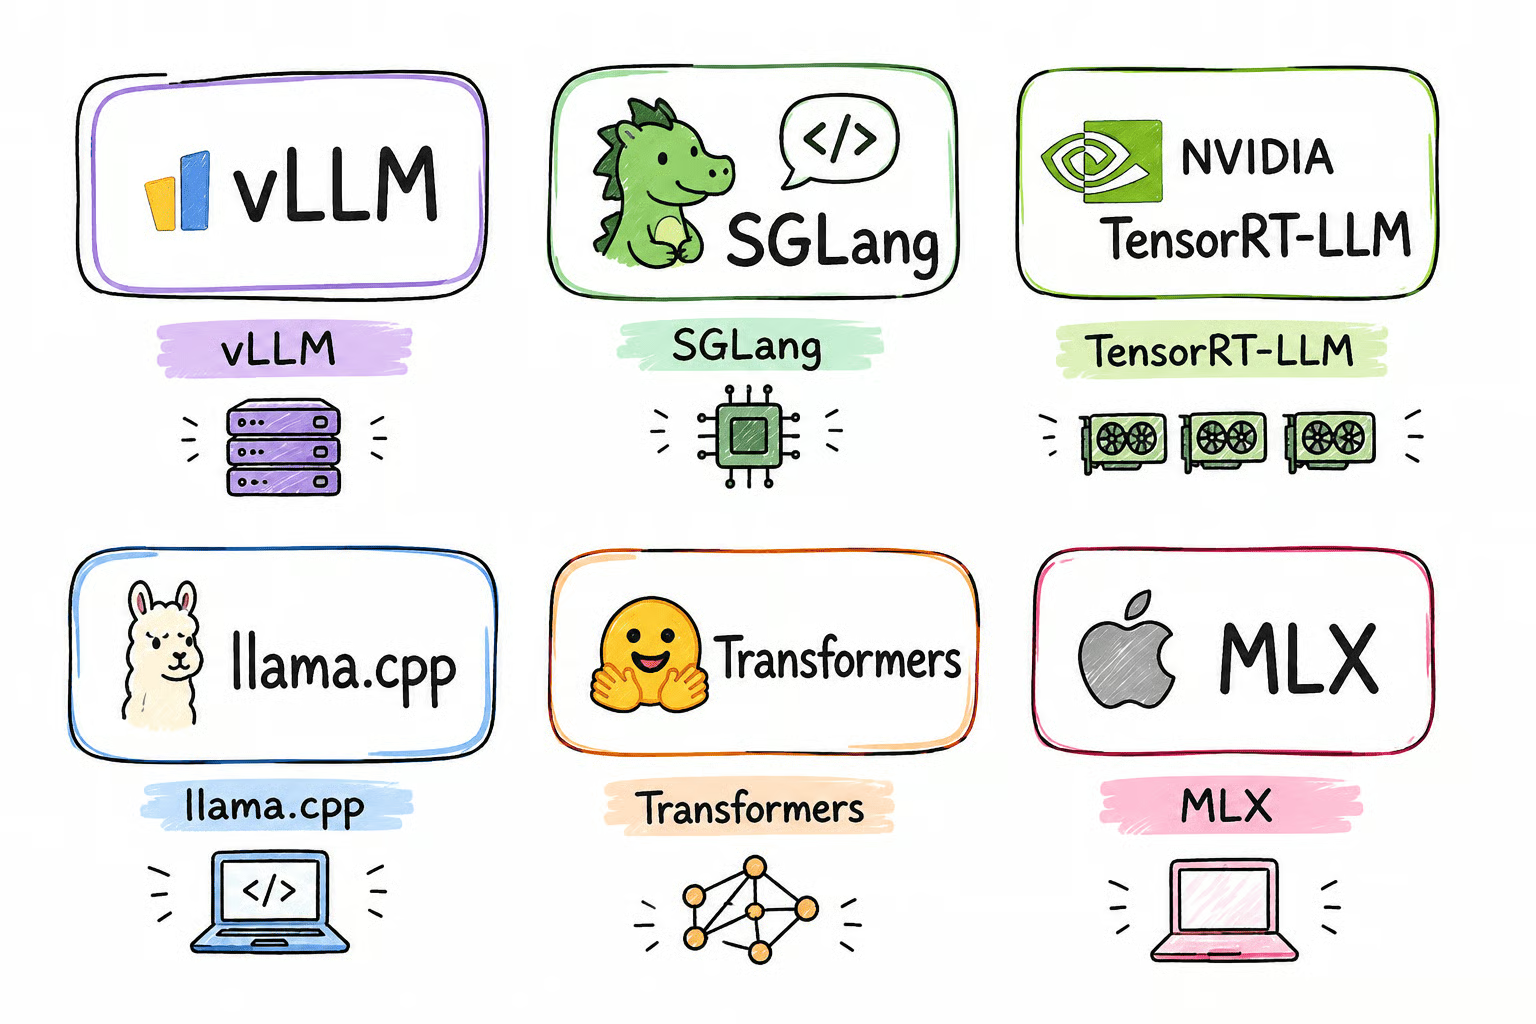
vLLM is een van de meest gebruikte algemene inferentie-engines. Het ondersteunt continuous batching, PagedAttention, chunked prefill, prefix caching, quantization, speculative decoding, geoptimaliseerde attention-kernels en gedistribueerde inferentie.
SGLang focust op hoge genratieprestaties en efficiënte requestplanning. Het is vooral handig voor agents, redeneermodellen, herhaalde context, gestructureerde output en andere complexe generatie-workloads.
TensorRT-LLM is NVIDIA’s geoptimaliseerde inferentiestack. Het benut NVIDIA-GPU-features, gespecialiseerde CUDA-kernels, lage-precisieformaten, gedistribueerde uitvoering, KV-caching en geavanceerde batching.
llama.cpp is bijzonder nuttig voor lokale en resourcebeperkte inferentie. Het ondersteunt GGUF-quantization, CPU-GPU-hybride inferentie en geheugen-gemapte modelbestanden, zodat gewichten over GPU-geheugen, systeems RAM en, indien nodig, schijfgebaseerd geheugen kunnen worden verdeeld.
Hierdoor kun je modellen draaien die veel groter zijn dan de beschikbare VRAM, al kan zwaar leunen op disk de performance aanzienlijk verlagen.
MLX is een inferentie- en machinelearningframework ontworpen voor Apple Silicon. Het maakt gebruik van de uniforme geheugenarchitectuur van Macs en is daarmee een handige optie om lokaal op M-serie apparaten LLM’s te draaien en ermee te experimenteren.
Van quantization tot speculative decoding: in dit deel behandelen we de technieken die inferentie sneller, goedkoper en geheugenefficiënter maken.
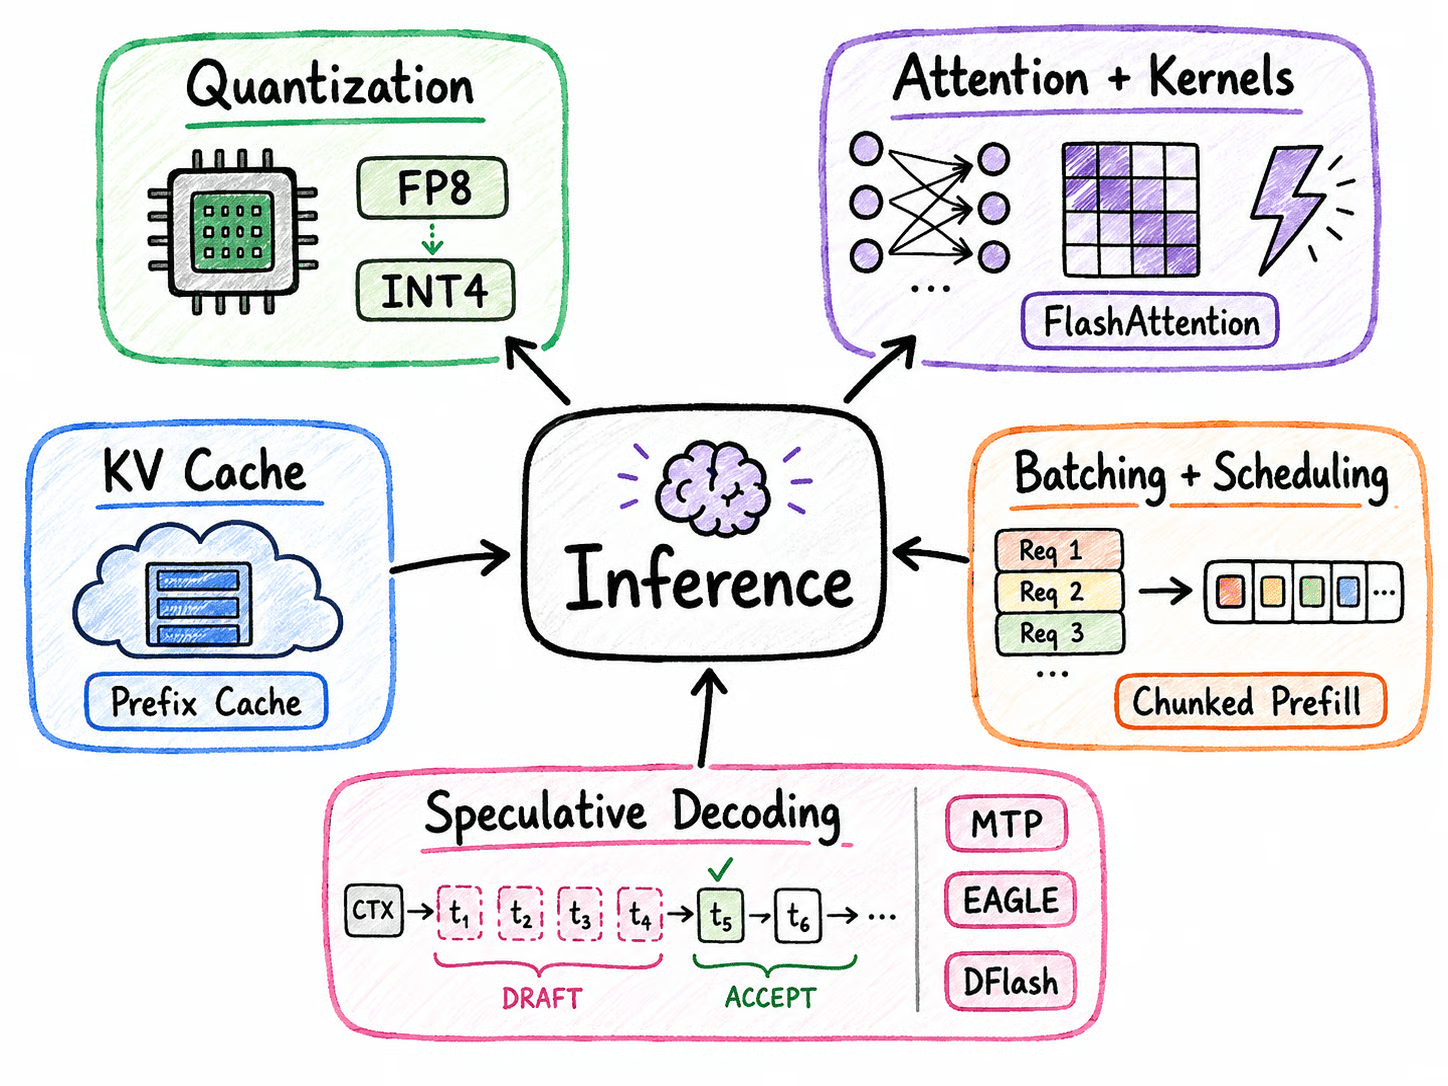
Een van de meest voorkomende inferentie-optimalisaties is quantization.
Modellen worden vaak met BF16- of FP16-precisie getraind.
Quantization representeert gewichten, activaties of caches met kleinere numerieke formaten.
Veelgebruikte formaten en benaderingen zijn onder meer:
Het verlagen van de precisie reduceert het geheugengebruik en kan de benodigde geheugenbandbreedte verminderen.
Maar kleiner is niet automatisch sneller. De performance hangt sterk af van de vraag of de doellardware efficiënte kernels voor die precisie biedt.
De KV-cache kan ook worden gequantized, wat steeds waardevoller wordt bij long-context en hoge concurrency.
Attention is een van de belangrijkste operaties binnen een transformer. Het stelt het model in staat te bepalen welke tokens in de context het meest relevant zijn bij het genereren van de volgende token.
Maar attention kan rekentechnisch duur worden, vooral naarmate het contextvenster groeit.
Daar komen geoptimaliseerde kernels in beeld. Een kernel is een sterk geoptimaliseerd stukje code dat een specifieke wiskundige operatie uitvoert op hardware zoals een GPU. In plaats van te veranderen hoe het model werkt, zorgen geoptimaliseerde kernels ervoor dat dezelfde berekeningen sneller verlopen en het geheugen efficiënter wordt gebruikt.
Een goed voorbeeld is FlashAttention. Traditionele attention kan veel tijd besteden aan het verplaatsen van grote tussentijdse resultaten tussen GPU-geheugen en compute-units.
FlashAttention vermindert deze overhead door attention in kleinere blokken te verwerken en meer van de berekening dicht bij de GPU te houden.
Moderne inferentie-engines gebruiken meerdere soortgelijke optimalisaties, waaronder:
Belangrijk is dat deze technieken het model of de outputkwaliteit doorgaans niet veranderen. Ze optimaliseren hoe de berekeningen worden uitgevoerd, zodat inferentie-engines sneller tokens kunnen genereren en de beschikbare hardware efficiënter benutten.
Tijdens generatie slaan transformers keys en values van eerdere tokens op in de KV-cache.
Zonder deze cache zou het model eerdere tokens elke keer opnieuw moeten uitrekenen bij het genereren van de volgende.
Het nadeel is geheugengebruik. Lange contexten en veel gelijktijdige gebruikers kunnen ervoor zorgen dat de KV-cache een groot deel van het GPU-geheugen inneemt.
Er zijn verschillende technieken om dit aan te pakken.
PagedAttention verdeelt KV-cachegeheugen in beheersbare blokken in plaats van grote aaneengesloten allocaties te vereisen.
Prefix caching laat requests met identieke prefixen eerder berekende KV-toestanden hergebruiken. Dit is vooral nuttig voor gedeelde systeemprompts, agents en herhaalde documentcontexten.
Andere aanpakken zijn onder meer:
Voor grootschalige inferentiesystemen kan KV-cachebeheer minstens zo belangrijk zijn als optimalisatie van modelgewichten.
Wanneer een inferentieserver veel requests tegelijk ontvangt, probeert hij deze samen te verwerken zodat de GPU bezig blijft. Dit heet batching.
Het probleem is dat LLM-requests zelden tegelijk eindigen.
De ene gebruiker genereert 50 tokens, de andere 2.000.
Bij traditionele batching kunnen kortere requests moeten wachten op de langste request in de batch.
Continuous batching lost dit op door voltooide requests te verwijderen en direct te vervangen door nieuwe. Zo blijft de GPU werken in plaats van capaciteit onbenut te laten.
Een andere nuttige techniek is chunked prefill. In plaats van één heel grote prompt in één keer te verwerken, splitst de server deze in kleinere stukken zodat andere requests die al tokens genereren niet worden geblokkeerd.
Naarmate het verkeer toeneemt, wordt inferentie een planningsprobleem. De server moet beslissen welke requests hij verwerkt, hoe hij ze groepeert en hoe hij GPU-geheugen, sequentielengte, throughput en latency balanceert.
Traditioneel autoregressief decoderen genereert tokens één voor één, waardoor generatie inherent sequentieel is.
Speculative decoding probeert deze bottleneck te doorbreken door meerdere kandidaat-tokens goedkoop te genereren en vervolgens door het volledige doelmodel parallel te laten verifiëren.
Als meerdere kandidaten worden geaccepteerd, kan de generatie meerdere tokens tegelijk opschuiven zonder de outputdistributie van het doelmodel te veranderen.
Er zijn meerdere benaderingen van dit idee:
Het basisidee is eenvoudig:
Genereer meerdere waarschijnlijke toekomstige tokens goedkoop en verifieer ze vervolgens efficiënt met het grotere model.
Speculative decoding werkt het best wanneer de volgende tokens relatief voorspelbaar zijn en het acceptatiepercentage hoog is.
Dit is vooral nuttig voor coderen en andere sequentiële taken, waar zelfs een kleiner model vaak kan voorspellen wat volgt.
Bij complex redeneren of zeer onvoorspelbare generatie worden mogelijk minder drafttokens geaccepteerd, waardoor het performancevoordeel afneemt.
Naarmate modellen en workloads groeien, wordt geheugen een grote beperking. Hier verkennen we offloading, multi-GPU-inferentie, gedisaggregeerd serven en optimalisatie voor lange context.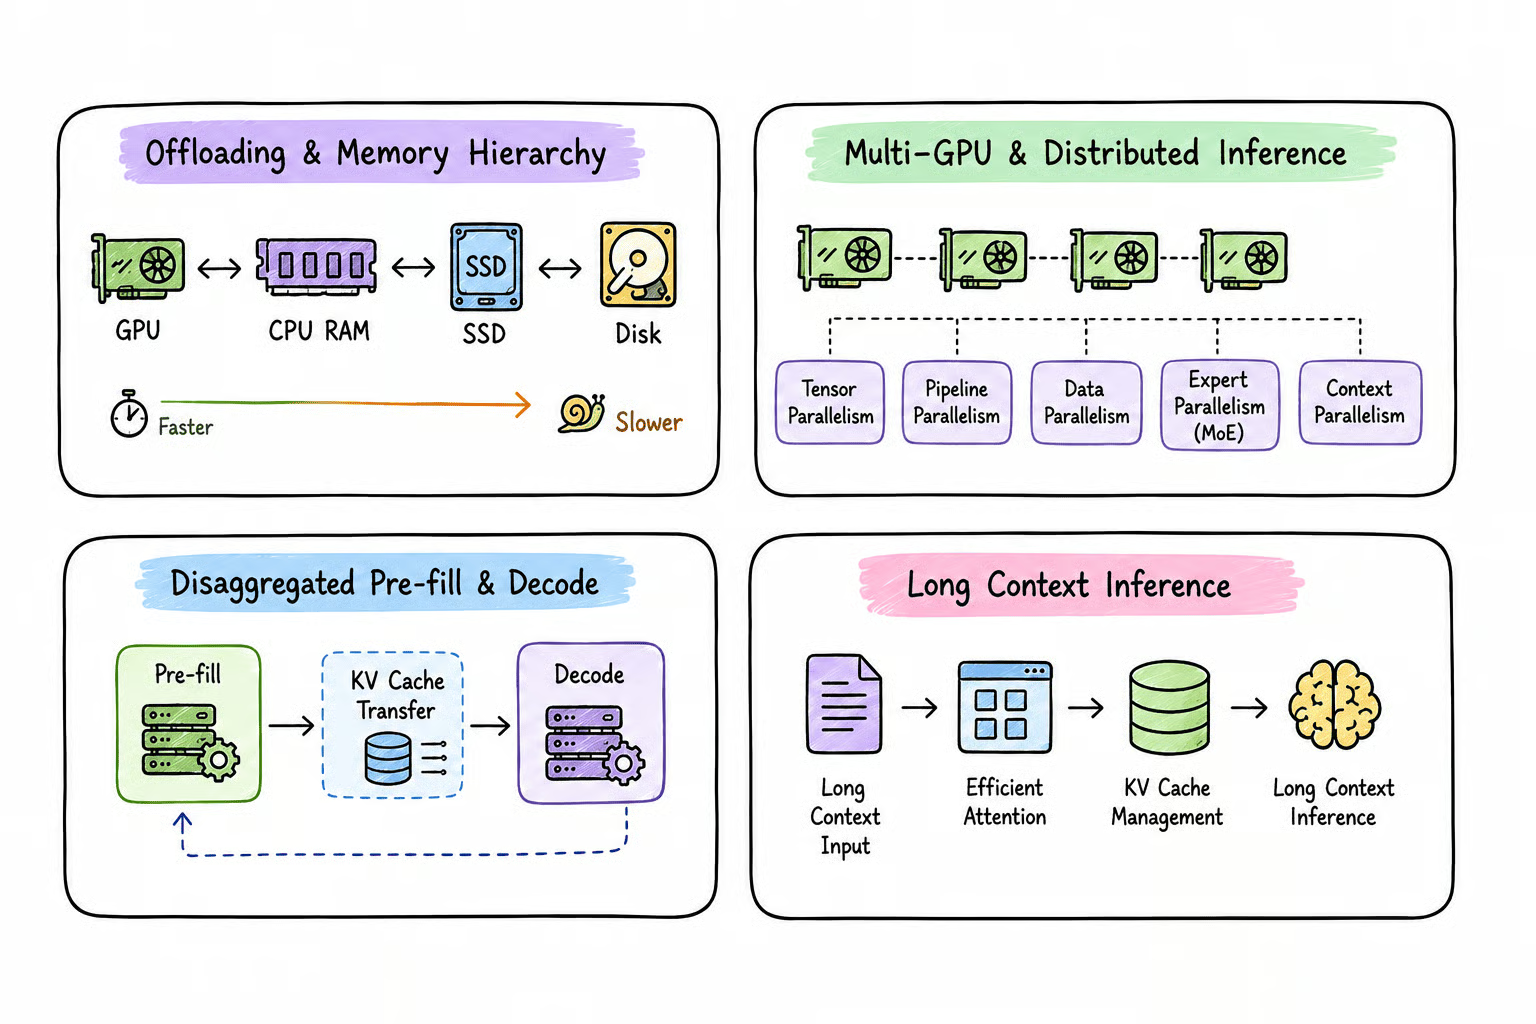
Soms is het doel niet maximale snelheid, maar simpelweg een model laten draaien op de hardware die je hebt.
Inferentiesystemen kunnen verschillende geheugenniveaus gebruiken:
GPU HBM → CPU RAM → NVMe-opslag
GPU-geheugen is het snelst, maar ook het meest beperkt.
CPU-geheugen biedt meer capaciteit tegen lagere snelheid, terwijl NVMe-opslag nog meer ruimte geeft maar veel trager is.
Als een model of zijn KV-cache niet volledig in VRAM past, kunnen inferentie-engines een deel van de workload elders onderbrengen met technieken zoals:
Dit vergroot de beschikbare geheugencapaciteit, maar gaat meestal ten koste van performance, omdat data tussen tragere geheugenniveaus moet worden verplaatst, vaak via PCIe.
De basisafweging is eenvoudig: hoe verder data van het GPU-geheugen af moet, hoe meer capaciteit je wint, maar hoe trager inferentie doorgaans wordt.
Zeer grote modellen vereisen vaak meerdere accelerators.
Veelgebruikte strategieën zijn:
Zodra inferentie meerdere GPU’s beslaat, wordt communicatie een belangrijke bottleneck.
Technologieën zoals NVLink, NVSwitch en snel netwerk kunnen daarom grote invloed hebben op de prestaties.
Prefill en decode gedragen zich heel verschillend tijdens inferentie. Prefill is meestal compute-intensief, omdat veel prompttokens parallel worden verwerkt, terwijl decode vaak geheugenbandbreedte-intensief is, waarbij tokens één voor één worden gegenereerd.
In plaats van beide fases om dezelfde GPU’s te laten concurreren, kunnen grotere serving-systemen ze scheiden:
Prompt → Prefill-worker → KV-cacheoverdracht → Decode-worker → Response
Prefill-workers verwerken de prompt en bouwen de KV-cache, die vervolgens wordt overgedragen aan dedicated decode-workers die de reactie genereren. Hierdoor kan elke fase andere hardware, batching- en parallelismestrategieën gebruiken.
Het grootste voordeel is dat prefill en decode onafhankelijk kunnen worden geoptimaliseerd en opgeschaald, wat helpt om time to first token (TTFT) en inter-token latency (ITL) te beheersen, vooral bij lange prompts en hoge verkeersvolumes.
Lange contextvensters creëren een ander type inferentie-uitdagingen. Naarmate de input groeit, kost prefill meer rekenwerk, terwijl de KV-cache groter wordt, wat GPU-geheugen verbruikt en decoderen duurder maakt.
Verschillende technieken helpen hierbij:
Belangrijk is dat ondersteuning voor een contextvenster van één miljoen tokens context window niet betekent dat het serven van één miljoen tokens snel, goedkoop of praktisch is.
Langere contexten verhogen geheugengebruik, time to first token en de totale inferentiekosten.
Niet elk model gedraagt zich hetzelfde tijdens inferentie, dus bekijken we de unieke uitdagingen van MoE-modellen, gestructureerde generatie en redeneerworkloads.
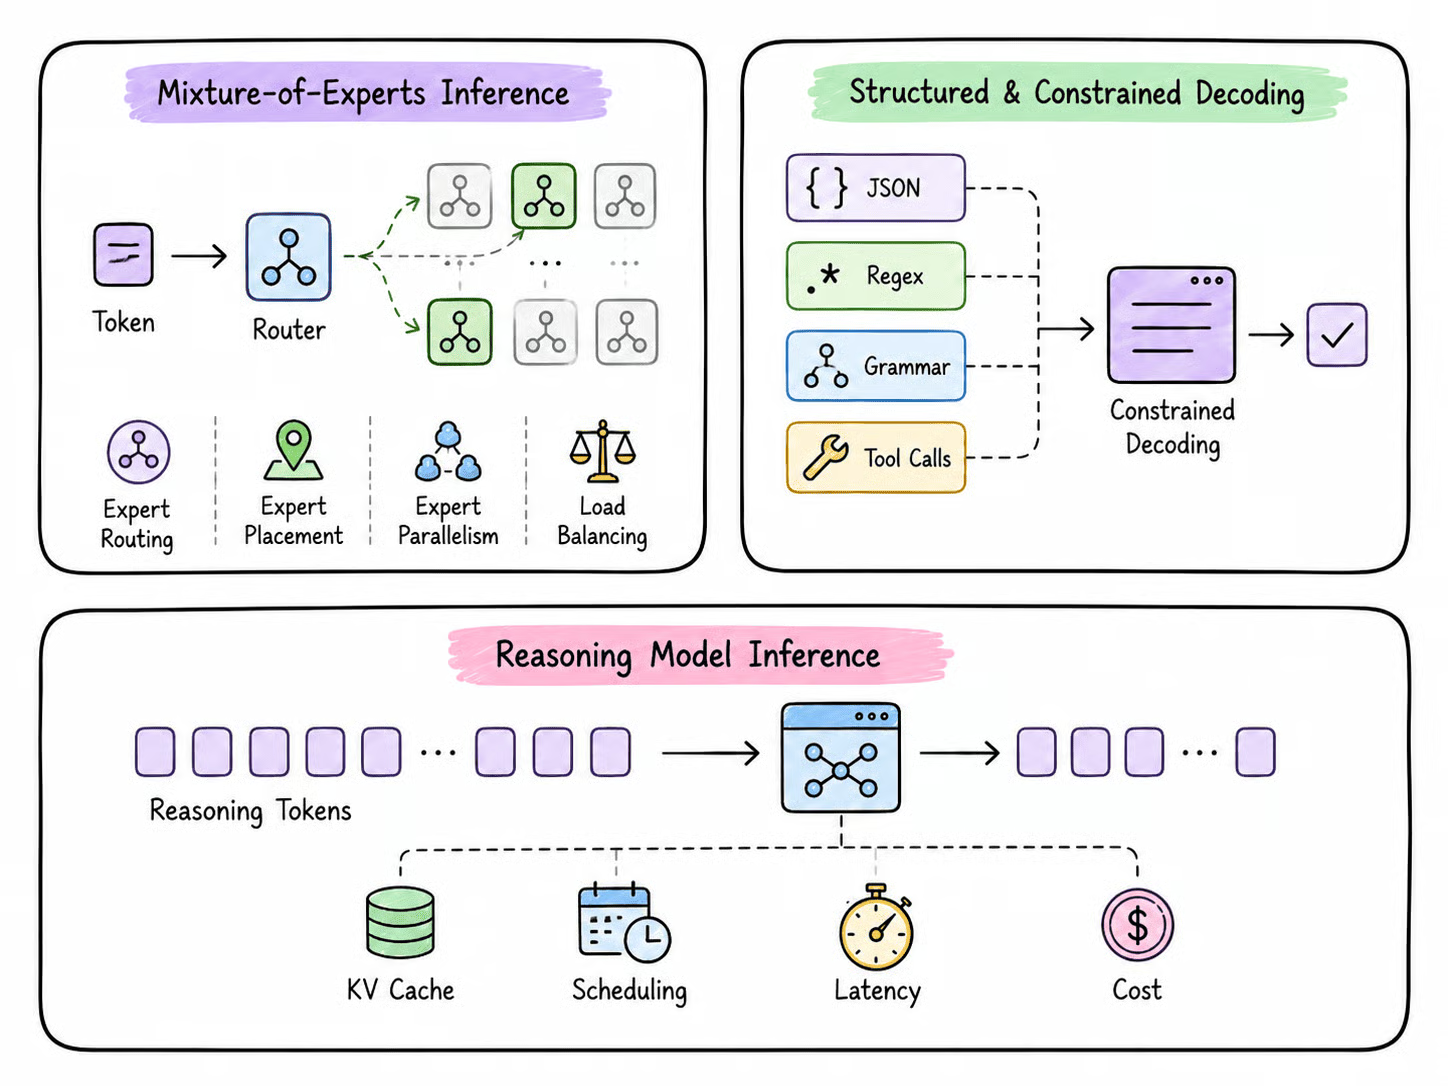
Mixture-of-Experts (MoE)-modellen gedragen zich anders dan dense modellen. In plaats van elke parameter voor elke token te gebruiken, selecteert een router slechts een klein aantal experts om elke token te verwerken.
Dit vermindert de berekening, maar de volledige set experts moet nog steeds ergens over de serving-hardware worden opgeslagen.
Efficiënte MoE-inferentie hangt daarom af van:
Op schaal kan communicatie een grote bottleneck worden, daarom bieden technologieën zoals DeepEP gespecialiseerde kernels met hoge throughput en lage latency voor het verplaatsen van tokens tussen experts.
Het onderscheid is dat totale parameters bepalen hoeveel modelcapaciteit moet worden opgeslagen, terwijl actieve parameters beter aangeven hoeveel berekening per token wordt uitgevoerd.
Moderne LLM-toepassingen hebben vaak iets voorspelbaarders nodig dan onbegrensde tekst. Agents moeten bijvoorbeeld geldige JSON, toolargumenten, SQL of reacties volgens een vooraf gedefinieerd schema genereren.
Beperkt decoderen stuurt welke tokens het model bij elke stap mag genereren, zodat de uiteindelijke output een vereiste structuur volgt. Moderne inferentie-engines zoals vLLM ondersteunen constraints, waaronder:
Dit is meestal betrouwbaarder dan onbegrensde tekst genereren en die achteraf proberen te repareren. Beperkt decoderen garandeert echter de structuur, niet per se de juistheid van de informatie erin.
Redeneermodellen creëren een heel andere inferentieworkload omdat ze mogelijk duizenden tussentijdse redeneertokens genereren voordat ze het uiteindelijke antwoord produceren.
In tegenstelling tot long-context-workloads, waar de meeste kosten uit het verwerken van een grote input kunnen komen, kunnen redeneerworkloads tijdens de hele generatie duur blijven omdat de decode-fase zelf heel lang wordt.
Lange redeneertraces beïnvloeden:
Een extra uitdaging is dat de redeneerlengte vaak moeilijk te voorspellen is.
De ene request is snel klaar, terwijl een andere duizenden tokens blijft genereren. Dit bemoeilijkt batching, planning en KV-cache-allocatie wanneer veel gebruikers tegelijk worden geserveerd.
Daardoor kan het serven van een chatbot die een paar honderd tokens genereert en een redeneermodel dat mogelijk 10.000 tokens genereert heel verschillende inferentie-, geheugen- en planningsstrategieën vereisen.
Software-optimalisatie is slechts een deel van LLM-inferentie. De onderliggende hardware kan net zo veel invloed hebben op snelheid, geheugencapaciteit, schaalbaarheid en kosten.
Belangrijke hardwarekenmerken zijn onder meer:
Een nuttig concept om hardwareprestaties te begrijpen is arithmetic intensity, dat beschrijft hoeveel berekening wordt uitgevoerd ten opzichte van hoeveel data moet worden verplaatst. Workloads met hoge arithmetic intensity zijn vaak compute-bound, terwijl workloads met lage arithmetic intensity vaak beperkt worden door geheugenbandbreedte.
Tijdens prefill kunnen veel prompttokens parallel worden verwerkt, waardoor de hardware zijn rekenbronnen beter benut. Tijdens decode worden tokens echter sequentieel gegenereerd en worden modelgewichten en KV-cachedata herhaaldelijk geraadpleegd. Daardoor is geheugenbandbreedte extra belangrijk voor de generatiesnelheid.
Daarom zijn geheugencapaciteit en geheugenbandbreedte twee verschillende zaken. Zo kunnen zowel de NVIDIA DGX Spark als een Apple M4 Max-systeem tot 128 GB uniform geheugen bieden. Maar DGX Spark levert 273 GB/s geheugenbandbreedte, terwijl M4 Max tot 546 GB/s haalt. Dus hoewel beide systemen mogelijk hetzelfde grote model in het geheugen kunnen passen, kan hun inferentieperformance heel verschillend zijn.
Hetzelfde principe geldt bij het vergelijken van GPU’s en lokale AI-machines: het model passend krijgen lost het capaciteitsprobleem op, niet per se het snelheidsprobleem.
Voor LLM-inferentie moeten rekenprestaties, geheugencapaciteit, geheugenbandbreedte en interconnectsnelheid samen worden bekeken.
Met zoveel inferentietechnieken is het cruciaal om eerst te identificeren wat jouw systeem daadwerkelijk beperkt.
Een model dat niet in VRAM past, vraagt om een heel andere optimalisatie dan een server met hoge latency of lage throughput.
|
Probleem / Scenario |
Te overwegen technieken |
|
Model past niet in VRAM |
Quantization, CPU-offloading, tensor-/pipelineparallelisme |
|
Hoge TTFT / trage prefill |
Prefix caching, tuning van chunked prefill, geoptimaliseerde attention |
|
Trage tokengeneratie |
Speculative decoding, geoptimaliseerde kernels, lagere precisie |
|
Lage throughput / hoge concurrency |
Continuous batching, requestplanning, dataparallelisme |
|
KV-cache-geheugendruk |
KV-cache-quantization, paging, offloading, verminderde context/concurrency |
|
Workloads met lange context |
Chunked prefill, contextparallelisme, KV-cache-optimalisatie |
|
Grote MoE-modellen |
Expertparallelisme, expertplaatsing, load balancing, geoptimaliseerde MoE-kernels |
|
Herhaalde of gedeelde prompts |
Prefix caching, prefix-bewuste routing |
|
Lokaal / beperkte hardware |
Quantization, llama.cpp/GGUF, MLX op Apple Silicon |
|
Grootschalig productieserven |
vLLM, SGLang, TensorRT-LLM, gedistribueerde inferentie, disaggregatie van prefill/decode |
Belangrijk is dat er geen enkele beste optimalisatie bestaat.
Begin met het meten van metrics zoals TTFT, tokengeneratiesnelheid, throughput, GPU-utilisatie en geheugengebruik. Pas vervolgens de techniek toe die de daadwerkelijke bottleneck aanpakt en benchmark opnieuw.
Zo kan quantization helpen bij beperkt geheugen, continuous batching de throughput verbeteren, prefix caching herhaalde prefill-arbeid verminderen en speculative decoding de generatiesnelheid verhogen wanneer toekomstige tokens voorspelbaar zijn.
Het doel is niet simpelweg tokens per seconde te maximaliseren, maar de beste balans te vinden tussen latency, throughput, geheugengebruik, modelkwaliteit, hardware en kosten.
Een LLM lokaal draaien en een reactie krijgen via llama.cpp is een goed begin, maar betekent niet automatisch dat je een efficiënt inferentiesysteem hebt gebouwd.
Voor persoonlijke projecten, experimenten en kleinere workloads kan een eenvoudige lokale setup meer dan voldoende zijn.
Maar zodra je veel gebruikers gaat serven, lange contexten afhandelt of complexe codeer- en agentische systemen bouwt, veranderen de eisen snel.
Je hebt een inferentiestack nodig die veel requests tegelijk kan verwerken, een goede generatiesnelheid behoudt, het geheugen efficiënt beheert en responsief blijft naarmate de workloads zwaarder worden.
Dan gaan concepten als continuous batching, prefix caching, KV-cachebeheer, quantization, speculative decoding, geoptimaliseerde kernels, parallelisme en requestplanning een grote rol spelen.
Je moet ook metrics begrijpen zoals TTFT, throughput, latency, concurrency, GPU-utilisatie en kosten per token in plaats van performance alleen op tokens per seconde te beoordelen.
Er bestaat ook geen universele configuratie die voor elk model of elke workload werkt. Een techniek die goed werkt voor coderen, levert mogelijk niet hetzelfde voordeel op voor redeneren.
Een optimalisatie die throughput verbetert, kan de latency verhogen. Quantization kan de geheugeneisen aanzienlijk verlagen, maar agressievere quantization kan ook de modelkwaliteit verminderen.
Uiteindelijk draait goede LLM-inferentie-engineering om balans. Het doel is de hardware die je al hebt zo goed mogelijk te benutten, terwijl je snelheid, geheugen, throughput, latency, modelkwaliteit en kosten in evenwicht houdt.
Daarom is leren over inferentie belangrijk. In plaats van volledig te vertrouwen op standaardinstellingen of simpelweg meer GPU’s toe te voegen, kun je begrijpen waar de bottleneck zit, de juiste optimalisatie kiezen en een serving-systeem bouwen dat echt is afgestemd op jouw workload.
Wil je meer leren over LLM-inferentie, bekijk dan ons webinar Understanding LLM Inference.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

