
Lernpfad
KI-Agent-Grundlagen
6 Std.
Autonome KI-Agenten sind mächtige Systeme, und genau diese Stärke kann sie auch gefährlich machen.
OpenClaw und ähnliche Agent-Frameworks gehen weit über reine Textgenerierung hinaus. Sie führen Code aus, ändern Dateien, rufen APIs auf und interagieren direkt mit anderen Systemen. Das bedeutet: Der Schritt vom „Denken“ zum „Handeln“ verändert das Sicherheitsmodell grundlegend.
Jeder Fehler kann reale Folgen haben. Aktionen, die OpenClaw ausführt, ähneln eher Backend-Diensten mit echten Betriebsrechten als einer einfachen Chatoberfläche.
In diesem Leitfaden zeige ich dir die Sicherheitsaspekte beim Betrieb von OpenClaw und Best Practices, damit deine Bereitstellung potenzielle Risiken einkalkuliert.
Wenn du mit den Konzepten hinter Tools wie OpenClaw noch nicht vertraut bist, empfehle ich unseren Kurs Introduction to AI Agents.
OpenClaw (früher Clawdbot, kurzzeitig Moltbot) ist ein Open-Source-Framework für autonome Agenten, das ein Large Language Model (LLM) mit ausführbaren Tools verbindet. Zu diesen Tools können gehören:
Anders als ein einfacher Chatbot, der nur Text zurückgibt, ermöglicht OpenClaw dem Modell, echte Aktionen in deiner Umgebung auszuführen. In der Praxis ist es damit eher eine Automatisierungs- oder DevOps-Engine als ein reiner Konversationsassistent.
Das zentrale Risiko ergibt sich direkt aus dieser Fähigkeit: Text ist meist harmlos, Handlungen sind es nicht.
Aktionen eines Agenten können zum Beispiel sein:
Wird der Agent durch bösartige Eingaben oder schlecht strukturierte Prompts beeinflusst, können diese Aktionen unerwünschte Folgen haben. Einfache LLM-Schutzmechanismen wie Keyword-Filter oder Antwortmoderation reichen hier nicht aus.
Ein Prompt-Injection-Angriff könnte das Modell etwa dazu bringen, sensible Dateien auszulesen oder ein API-Token zu missbrauchen.
Wenn du Alternativen zu OpenClaw evaluierst, findest du hier unseren Vergleichsleitfaden.
Schauen wir uns an, was du konkret tun kannst, um die Sicherheit deiner Bereitstellung zu erhöhen.
Am Anfang steht Transparenz über deine OpenClaw-Instanz. Ohne klares Verständnis darüber, was vorhanden ist und worauf es zugreifen kann, ist wirksamer Schutz unmöglich.
Bevor du Firewall-Regeln oder Container-Einstellungen änderst, nimm dir Zeit, die aktuelle Umgebung zu kartieren. Viele Sicherheitsvorfälle entstehen nicht durch ausgefeilte Exploits, sondern durch vergessene Testserver oder zu weitreichende Anmeldedaten, die nie zurückgenommen wurden.
Beginne damit, jede laufende OpenClaw-Instanz zu identifizieren:
Es ist tatsächlich üblich, vergessene Cloud-Server zu finden, Container, die mit -p 0.0.0.0:3000:3000 exponiert sind, oder temporäre Tunnel wie Ngrok, die nie beendet wurden. Solche Experimentier-Setups überleben oft ihren Zweck und sollten abgeschaltet werden.
Anschließend solltest du deine „Kronjuwelen“ identifizieren. Das sind sensible Assets, auf die der Agent zugreifen kann, zum Beispiel:
Jedes Credential sollte hinsichtlich Umfang und Rechten bewertet werden. Administratorzugriff birgt beispielsweise ein deutlich höheres Risiko als reiner Lesezugriff. Ein klares Bild dieser Privilegien hilft, potenzielle Schäden zu quantifizieren.
Eine hilfreiche Frage ist: „Wenn der Agent heute vollständig kompromittiert würde, was könnte realistisch passieren?“
Unmittelbare Risiken solltest du ebenfalls dokumentieren, darunter:
Diese Erkenntnisse schriftlich festzuhalten, schafft eine Ausgangsbasis und macht Verbesserungen messbar.
Für etabliertere Setups lohnt sich ein Sicherheitsstufenmodell.
Ein gestuftes Modell schafft Struktur und Klarheit. Nicht jede Bereitstellung braucht Enterprise-Kontrollen, aber jede sollte bewusst eingeordnet sein.
Die drei Hauptstufen sind:
Geeignet für Experimente und Lernumgebungen ohne sensible Daten.
Auf dieser Stufe interagiert der Agent ggf. mit geteilten Repositories oder internen APIs und braucht stärkere Leitplanken.
Diese Stufe ist für Umgebungen gedacht, die regulierte Daten oder Finanzprozesse verarbeiten.
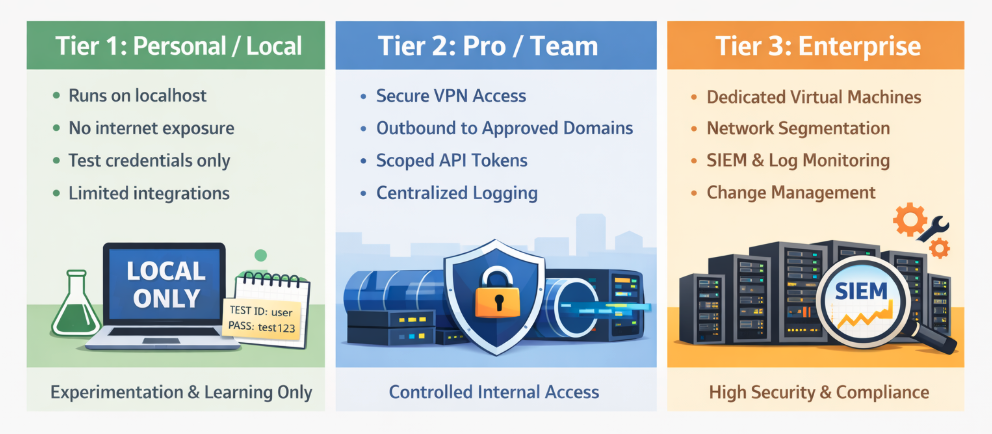
Wichtig ist nicht, pauschal die höchste Stufe zu wählen, sondern klar zu verstehen, welche Stufe gilt und warum.
Eine Staging- oder „Safe Lab“-Umgebung bietet Raum, Sicherheitsänderungen zu testen, ohne Produktionssysteme zu gefährden. Das sollte ein einfaches Testbett sein, in dem Änderungen keine realen Konsequenzen haben.
Diese Umgebung sollte die Produktionsarchitektur trotzdem widerspiegeln, jedoch mit Sandbox- oder Dummy-Credentials. Test-Cloud-Accounts, Mock-APIs und interne E-Mail-Sandboxes ermöglichen realistische Tests ohne Risiko.
Empfehlenswert ist außerdem ein dokumentiertes „Break-Glass“-Verfahren: ein Wiederherstellungsplan, der erklärt, wie der Zugriff wiederhergestellt wird, falls Firewall-Regeln oder Container-Restriktionen Administratoren versehentlich aussperren.
Wenn ein Agent von außen erreichbar ist, kann er angegriffen werden. Deshalb musst du eingehenden Zugriff steuern. Das ist deine erste sichtbare Verteidigungsschicht.
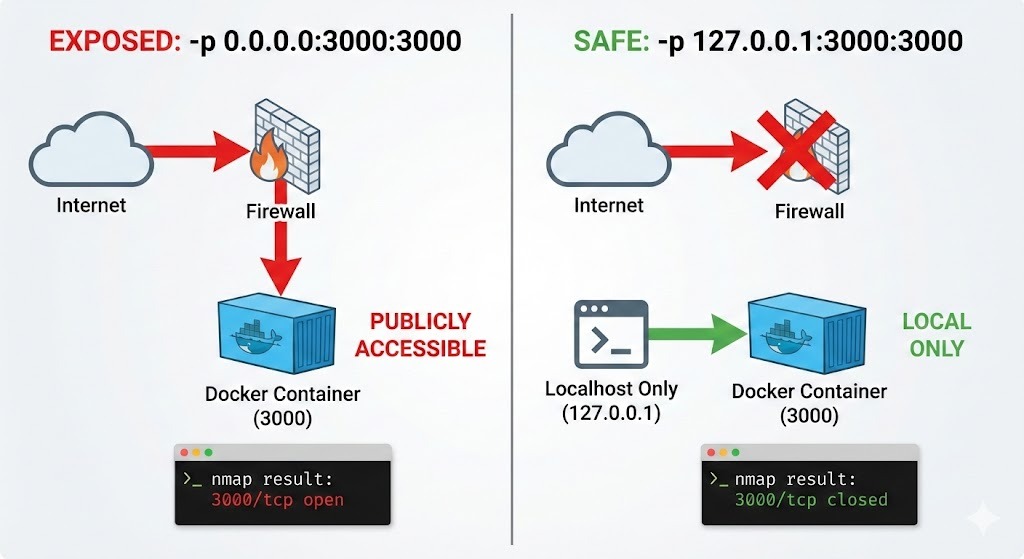
Am sichersten ist die Standardkonfiguration, die die Anwendung an die localhost-IP 127.0.0.1 bindet, sodass sie nur lokal erreichbar ist.
app.listen(3000, "127.0.0.1");Zudem ist Verifikation wichtig. Ein Portscan von einem anderen Gerät mit nmap sollte bestätigen, dass keine Ports exponiert sind.
sudo nmap -p- -sS <target_IP>Beachte, dass Docker auf Linux-Hosts UFW oder andere Host-Firewalls umgehen kann, da es Netzwerkrouten direkt manipuliert.
Wenn du einen Port mit -p 0.0.0.0:3000:3000 veröffentlichst, kann Docker diesen Port exponieren, selbst wenn die Host-Firewall ihn scheinbar blockiert. Nur auf Firewalls zu setzen reicht bei Docker nicht aus.
Schnell prüfen kannst du die tatsächlich veröffentlichten Ports mit:
docker port <container_name>
Look for 0.0.0.0:3000->3000/tcp (exposed publicly) versus 127.0.0.1:3000->3000/tcp (localhost-only).
Linux users can also inspect active Docker iptables rules:
```bash
sudo iptables -L DOCKER -n -v
Wenn du 0.0.0.0:PORT-Bindings oder ACCEPT-Regeln in der DOCKER-Chain siehst, ist der Port extern erreichbar, sofern er nicht explizit eingeschränkt wird.
Bestätige das zusätzlich von einer anderen Maschine mit nmap:
nmap -p 3000 <target_IP>Dieser Scan prüft von außen, ob Port 3000 tatsächlich geschlossen/gefiltert ist, und belegt, dass kein externer Zugriff existiert.
Best Practice ist, im Docker-Run-Befehl explizit an localhost (127.0.0.1) zu binden:
docker run -p 127.0.0.1:3000:3000 openclawPrüfe danach mit docker port und einem externen nmap-Scan von einer anderen Maschine.
Wenn Fernzugriff nötig ist, ist eine direkte Exponierung im öffentlichen Internet selten gerechtfertigt.
Ein VPN wie Tailscale oder WireGuard stellt verschlüsselte, authentifizierte Verbindungen zwischen vertrauenswürdigen Geräten her. Das reduziert die Angriffsfläche deutlich im Vergleich zu offenen Ports.
Wo Browserzugriff erforderlich ist, kann ein Reverse Proxy wie Nginx HTTPS terminiert und Authentifizierung erzwingen, bevor der Traffic die Anwendung erreicht.
Auch beim Session-Management ist Sorgfalt gefragt. Schwache Sitzungssteuerungen können starke Perimeterschutzmaßnahmen aushebeln.
Starke Passwörter, regelmäßiges Rotieren von Zugangsdaten und Rate-Limits auf Login-Endpunkten helfen gegen Brute-Force-Angriffe. Kurze Session-Lebensdauern mindern den Wert gestohlener Tokens.
Sichere Cookies, SameSite-Attribute und CSRF-Schutz sind auch relevant, wenn das Backend ein KI-gestützter Agent ist. Die umgebende Webinfrastruktur muss genauso gehärtet werden wie bei jeder anderen Anwendung.
Selbst mit starkem Perimeterschutz bleibt Missbrauch möglich. Eindämmungs- und Isolationsstrategien bestimmen, wie weit sich ein Vorfall ausbreiten kann.
Den Container als Nicht-Root-User auszuführen, reduziert die Auswirkungen potenzieller Escape-Schwachstellen.
Unnötige Linux-Capabilities sollten entfernt werden, um die Angriffsfläche zu verkleinern. Container laufen oft mit mehr Rechten als nötig; das Streichen ungenutzter Capabilities limitiert, was ein Angreifer tun kann.
All diese Maßnahmen verfolgen dasselbe Ziel: Selbst wenn der Agent aus dem Ruder läuft, darf er das Hostsystem nicht kontrollieren.
Unten findest du ein einfaches docker run-Beispiel, das die Syntax zum Setzen eines Nicht-Root-Users, das Entfernen spezifischer Linux-Capabilities und das Mounten des Dateisystems als Read-only zeigt.
docker run \
  --name openclaw-secure \
  --user 1000:1000 \
  --read-only \
  --cap-drop=CAP_SYS_ADMIN \
  --cap-drop=CAP_NET_RAW \
  -v openclaw-workspace:/app/workspace \
  -p 127.0.0.1:3000:3000 \
  openclaw:latest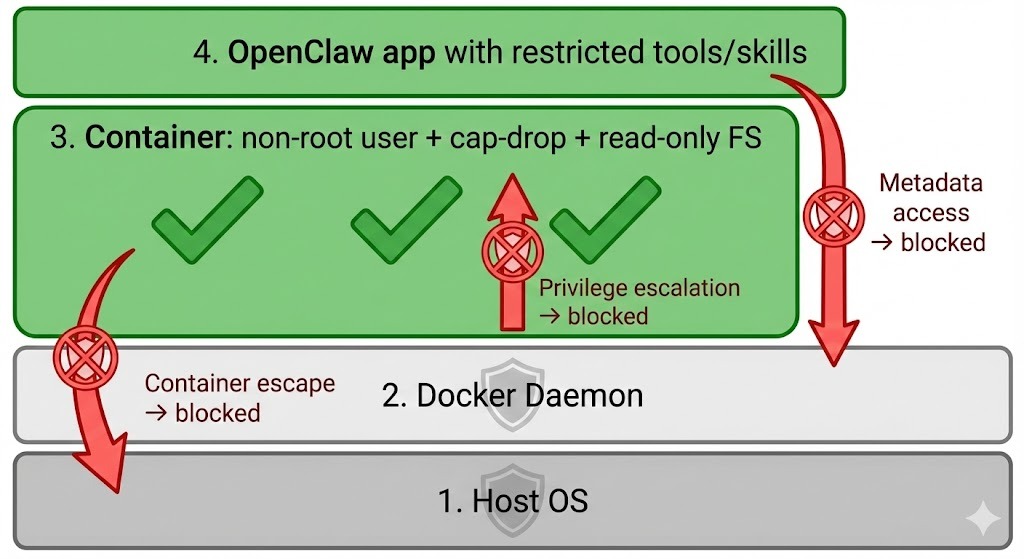
Für Teams mit Docker Compose gelten dieselben Prinzipien. Ein minimales gehärtetes docker-compose.yml-Snippet könnte so aussehen:
version: "3.9"

services:
  openclaw:
    image: openclaw:latest
    user: "1000:1000"
    read_only: true
    cap_drop:
      - CAP_SYS_ADMIN
      - CAP_NET_RAW
    ports:
      - "127.0.0.1:3000:3000"
    volumes:
      - openclaw-workspace:/app/workspace

volumes:
  openclaw-workspace:
Wichtig: Diese Linux-Capability-Beschränkungen sind auch bei Docker auf macOS oder Windows notwendig. Docker Desktop führt Container in einer versteckten Linux-VM aus.
Mit anderen Worten: macOS oder Windows entbinden nicht vom Container-Hardening.
Outbound-Filterung wird oft übersehen, ist aber entscheidend. Schwere Vorfälle wie Datenabfluss laufen über ausgehende Kanäle.
Eine standardmäßige „Deny All“-Outbound-Policy zwingt Admins dazu, freigegebene Domains explizit zu erlauben. Den Traffic auf notwendige Endpunkte wie API-Anbieter und interne Services zu begrenzen, reduziert das Risiko drastisch.
Das Blockieren des Zugriffs auf Cloud-Metadaten-Dienste verhindert außerdem die unbeabsichtigte Preisgabe von Instanz-Credentials.
Linux-Cloud-Instanzen (AWS/GCP/Azure) stellen temporäre Credentials über die Link-Local-IP 169.254.169.254 bereit. OpenClaw könnte diesen Endpunkt versehentlich abfragen und Metadaten leaken. Du kannst ausgehenden Traffic zur Metadaten-IP explizit droppen:
sudo iptables -A OUTPUT -d 169.254.169.254 -j DROPZur Verifikation führe aus:
sudo iptables -L -n -vSo stellst du sicher, dass Traffic den Host nicht verlässt, selbst wenn der Agent den Metadatenservice erreichen will.
Wenn du die Regel spezifisch auf Docker-Traffic beschränken willst, blockiere sie in der DOCKER-USER-Chain (wird vor den Docker-eigenen Regeln ausgewertet):
sudo iptables -I DOCKER-USER -d 169.254.169.254 -j DROPDieser Ansatz ist oft robuster, da Docker iptables-Regeln dynamisch anpasst. Die DOCKER-USER-Chain ist speziell für benutzerdefinierte Restriktionen gedacht.
Aktivität der Regel prüfen mit:
sudo iptables -L DOCKER-USER -n -vSensible Host-Verzeichnisse wie ~/.ssh oder /etc sollten niemals gemountet werden, außer es ist zwingend nötig.
Auch der Einsatz flüchtiger Container bietet zusätzlichen Schutz.
Sie stellen für jede Aufgabe einen frischen Container bereit und werden anschließend zerstört. So wird dauerhafte Persistenz deutlich erschwert. Solche temporären Umgebungen verringern die Möglichkeit, dass sich Angreifer festsetzen.
Jedes zusätzliche Tool erweitert die Möglichkeiten. Mit mehr Möglichkeiten steigt jedoch auch das Risiko.
Secrets sollten zur Laufzeit über Umgebungsvariablen oder ein Secret-Management-System injiziert werden. Zugangsdaten im Quellcode, in Prompts oder im Container-Image einzubetten, schafft unnötige Angriffsflächen.
Regelmäßige Audits verbundener Integrationen helfen, ungenutzte Credentials zu entfernen. Anmeldedaten ohne Zweck vergrößern nur die Angriffsfläche.
Autonome Agenten lassen sich über Skills und zusätzliche Komponenten erweitern. Damit wächst das Risiko. Die Absicherung der Skill-Lieferkette bedeutet, Drittanbieter-Erweiterungen so vorsichtig zu behandeln wie Produktivabhängigkeiten in einer Backend-Anwendung.
Unkontrollierte Auto-Updates von Plugins erhöhen das Supply-Chain-Risiko.
Neue Releases könnten unbeabsichtigt Schwachstellen einführen, oder im schlimmsten Fall enthält ein kompromittiertes Paket bösartiges Verhalten.
Zur Risikoreduzierung solltest du Skills auf spezifische Versionen und, wenn möglich, auf exakte Hashes pinnen.
Zum Beispiel:
"web-browser-skill": "1.4.2#sha256:abc123"Pinning stellt sicher, dass exakt der in Staging getestete Code auch in Produktion läuft. Es verhindert stille Upgrades und senkt das Risiko von Supply-Chain-Angriffen durch Dependency Hijacking oder bösartige Updates.
Das entspricht Best Practices in der Softwareentwicklung, wo Produktivsysteme Abhängigkeiten versionieren, um unerwartetes Verhalten zu vermeiden.
Bevor du einen neuen Skill aktivierst, solltest du dir den Quellcode ansehen. Autonome Agenten arbeiten oft mit API-Tokens, Dateizugriff oder Netzwerkrechten.
Ist der Code schlecht geschrieben oder bösartig, können diese Privilegien unbemerkt missbraucht werden.
Achte insbesondere auf:
Selbst ein scheinbar harmloses Browsing-Tool könnte Daten exfiltrieren, wenn es versteckte Netzaufrufe enthält. Ein kurzer Code-Review deckt offensichtliche Warnsignale auf und reduziert das Risiko deutlich.
Viele Agent-Frameworks liefern mehrere integrierte Tools wie Shell-Zugriff, Python-Ausführung, Dateieditoren oder Webbrowser. Flexibilität ist in Experimenten hilfreich, in Produktion gilt: so wenig wie möglich.
Jedes aktivierte Tool ist eine potenziell missbrauchbare Fähigkeit. Unnötige Tools zu entfernen, reduziert die Angriffsfläche und begrenzt den Schaden im Kompromittierungsfall.
KI-Systeme bringen neue, spezifische Verhaltensrisiken mit, die sich von klassischen Software-Schwachstellen unterscheiden. Schauen wir uns Risiken und Gegenmaßnahmen für OpenClaw an.
Da OpenClaw stark auf Prompts angewiesen ist, gilt: Externe Inhalte sind grundsätzlich untrusted Input. Webseiten, E-Mails und Dokumente können versteckte Anweisungen enthalten, die das Modell beeinflussen und bösartige Ergebnisse herbeiführen.
Prompt Injection nutzt die Befolgungsneigung des Modells aus. Versteckte HTML-Kommentare oder geschickt formulierte Texte können versuchen, Systemregeln zu überschreiben oder sensible Daten zu extrahieren.
Sinnvolle Abwehrmaßnahmen sind unter anderem:
Das Leeren des Speichers zwischen unabhängigen Aufgaben senkt zusätzlich das Risiko unbeabsichtigter Datenlecks.
Für längerfristige Bereitstellungen brauchst du mehr Observability und Monitoring, um sicherzustellen, dass die Modelle wie erwartet arbeiten.
Umfassendes Logging sollte Prompts, Modellausgaben, Tool-Aufrufe, Dateimodifikationen und API-Interaktionen erfassen. Eine zentrale Log-Ablage verhindert Manipulation und unterstützt die Incident-Analyse.
Ich empfehle Benachrichtigungen bei ungewöhnlichem Verhalten (z. B. unerwarteter ausgehender Traffic oder Zugriff auf Systemdateien), um schneller reagieren zu können.
Da Sicherheit kein Einmal-Thema ist, solltest du OpenClaw außerdem bei Bedarf auf die neueste Version aktualisieren.
OpenClaw bietet großes Potenzial für lokale LLM-Bereitstellungen. Weil die meisten lokal laufen, ist die Sicherheit deines eigenen Rechners entscheidend.
Daher sollte eine gehärtete OpenClaw-Bereitstellung nicht öffentlich erreichbar sein, in einer eingeschränkten Runtime laufen, eng gescopte Credentials nutzen und ein umfassendes Logging pflegen.
Wenn du das selbst umsetzen willst, lege deine Sicherheitsstufe fest und arbeite die passenden Maßnahmen ab.
Du willst mehr über aktuelle KI-, LLM- und Agent-Technologien erfahren? Unser Lernpfad AI Agent Fundamentals ist der ideale Start.
AI Courses
Lernpfad
Kurs
Kurs
Blog
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Derrick Mwiti
10 Min.


