
लर्निंग पाथ
एआई एजेंट मूलभूत बातें
6 घंटा
स्वायत्त AI एजेंट शक्तिशाली सिस्टम होते हैं, और यही शक्ति उन्हें संभावित रूप से ख़तरनाक भी बना सकती है।
OpenClaw और इसी तरह के एजेंट फ़्रेमवर्क केवल टेक्स्ट जनरेट करने से आगे जाते हैं। ये कोड चलाते हैं, फ़ाइलें संशोधित करते हैं, API कॉल करते हैं, और सीधे अन्य सिस्टम्स के साथ इंटरैक्ट करते हैं। इसका अर्थ है कि "सोचने" से "कार्रवाई करने" की ओर बदलाव होता है, जो सुरक्षा मॉडल को बुनियादी रूप से बदल देता है।
की गई हर गलती वास्तविक परिणाम दे सकती है। OpenClaw द्वारा चलाए गए कोई भी सिस्टम एक्शन साधारण बातचीत इंटरफेस की बजाय वास्तविक ऑपरेशनल विशेषाधिकारों वाली बैकएंड सेवाओं जैसे दिखते हैं।
इस मार्गदर्शिका में, मैं OpenClaw चलाने के सुरक्षा पहलुओं और सर्वोत्तम प्रथाओं को कवर करूँगा ताकि आपका डिप्लॉयमेंट संभावित जोखिमों को ध्यान में रखे।
यदि आप अभी तक OpenClaw जैसे टूल्स के पीछे के कॉन्सेप्ट्स से परिचित नहीं हैं, तो मैं हमारे Introduction to AI Agents कोर्स की सिफारिश करता हूँ।
OpenClaw (पहले Clawdbot और थोड़े समय के लिए Moltbot के रूप में जाना जाता था) एक ओपन-सोर्स स्वायत्त एजेंट फ़्रेमवर्क है जो लार्ज लैंग्वेज मॉडल (LLM) को निष्पाद्य टूल्स के सेट से जोड़ता है। इनमें शामिल हो सकते हैं:
एक बेसिक चैटबॉट जो केवल टेक्स्ट लौटाता है उससे अलग, OpenClaw मॉडल को आपके वातावरण के अंदर वास्तविक कार्य करने में सक्षम बनाता है। व्यावहारिक रूप से, यह एक बुनियादी संवादात्मक सहायक की तुलना में ऑटोमेशन इंजन या DevOps यूटिलिटी के अधिक क़रीब है।
मूल जोखिम इसी क्षमता से आता है: टेक्स्ट आमतौर पर हानिरहित होता है, पर क्रियाएँ नहीं।
एजेंट द्वारा किए गए एक्शन में शामिल हो सकते हैं:
यदि एजेंट दुर्भावनापूर्ण इनपुट या ख़राब संरचित प्रॉम्प्ट से प्रभावित होता है, तो ये एक्शन अनपेक्षित परिणाम दे सकते हैं। साधारण LLM सुरक्षा उपाय जैसे कीवर्ड फ़िल्टरिंग या रिस्पॉन्स मॉडरेशन इस संदर्भ में पर्याप्त नहीं हैं।
उदाहरण के लिए, एक प्रॉम्प्ट इंजेक्शन अटैक मॉडल को संवेदनशील फ़ाइलें प्राप्त करने या किसी API टोकन का दुरुपयोग करने के लिए बहका सकता है।
यदि आप OpenClaw के वैकल्पिक फ़्रेमवर्क का मूल्यांकन कर रहे हैं, तो आप यहाँ हमारी तुलना मार्गदर्शिका देख सकते हैं।
आइए देखते हैं कि आपके डिप्लॉयमेंट के लिए सुरक्षा को कैसे बढ़ाया जा सकता है।
शुरुआत में, आपको हमेशा अपनी OpenClaw इंस्टेंस में स्पष्टता सुनिश्चित करनी चाहिए। जो मौजूद है और उसे किस चीज़ तक पहुँच है, इसका स्पष्ट समझ बिना सार्थक सुरक्षा संभव नहीं है।
फ़ायरवॉल नियमों या कंटेनर सेटिंग्स को संशोधित करने से पहले, मौजूदा वातावरण का नक्शा बनाने के लिए समय निकालें। कई सुरक्षा घटनाएँ उन्नत एक्सप्लॉइट्स से नहीं, बल्कि भूले हुए टेस्ट सर्वर्स या जगह पर छोड़ दिए गए अत्यधिक अनुमतिपूर्ण क्रेडेंशियल्स से उत्पन्न होती हैं।
हर चल रही OpenClaw इंस्टेंस की पहचान करके शुरू करें:
अक्सर यह पाया जाता है कि भूले हुए क्लाउड सर्वर, -p 0.0.0.0:3000:3000 के साथ एक्सपोज़्ड कंटेनर, या Ngrok जैसे अस्थायी टनल बंद ही नहीं किए गए। ऐसे प्रयोगात्मक सेटअप अक्सर अपने निर्धारित उद्देश्य से अधिक समय तक जीवित रहते हैं और इन्हें सक्रिय नहीं रखना चाहिए।
अगला चरण है अपने "क्राउन ज्वेल्स" की पहचान करना। ये वे संवेदनशील एसेट्स हैं जिन तक एजेंट की पहुँच हो सकती है, जैसे:
प्रत्येक क्रेडेंशियल के स्कोप और विशेषाधिकार का आकलन किया जाना चाहिए। उदाहरण के लिए, एडमिनिस्ट्रेटर-स्तरीय एक्सेस केवल रीड-ओनली एक्सेस की तुलना में कहीं अधिक जोखिम वहन करता है। इन विशेषाधिकारों की स्पष्ट तस्वीर संभावित नुकसान को मापने में मदद करती है।
एक उपयोगी सवाल जो आप स्वयं से पूछ सकते हैं: “यदि एजेंट आज पूरी तरह से समझौता कर लिया जाए, तो वास्तविक रूप से क्या हो सकता है?”
तत्काल जोखिमों का भी दस्तावेजीकरण किया जाना चाहिए, जिनमें शामिल हैं:
इन निष्कर्षों को लिखना एक बेसलाइन स्थापित करता है और सुधारों को मापनीय बनाता है।
ज्यादा परिपक्व डिप्लॉयमेंट्स के लिए एक अच्छी प्रथा है सुरक्षा टियर मॉडल अपनाना।
टियर-आधारित मॉडल संरचना और स्पष्टता देता है। यद्यपि हर डिप्लॉयमेंट में एंटरप्राइज़-ग्रेड नियंत्रणों की आवश्यकता नहीं होती, हर डिप्लॉयमेंट का जानबूझकर वर्गीकरण होना चाहिए।
यहाँ 3 मुख्य टियर हैं:
यह टियर उन प्रयोगात्मक और सीखने के वातावरण के लिए उपयुक्त है जहाँ कोई संवेदनशील डेटा शामिल नहीं है।
इस स्तर पर, एजेंट साझा रिपॉज़िटरी या आंतरिक APIs के साथ इंटरैक्ट कर सकता है, जिसके लिए मज़बूत गार्डरेल्स की आवश्यकता होती है।
यह टियर उन वातावरणों के लिए बनाया गया है जो नियामित डेटा या वित्तीय ऑपरेशंस संभाल रहे हों।
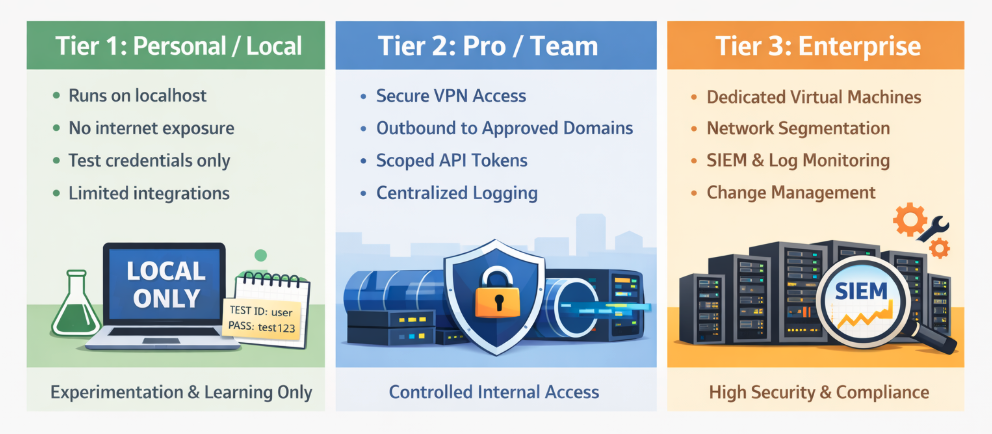
कुंजी यह है कि डिफ़ॉल्ट रूप से उच्चतम टियर न चुनें, बल्कि स्पष्ट रूप से समझें कि कौन-सा टियर लागू होता है और क्यों।
स्टेजिंग या “सुरक्षित लैब” वातावरण उत्पादन प्रणालियों को जोखिम में डाले बिना सुरक्षा परिवर्तनों का परीक्षण करने का स्थान देता है। यह एक सरल टेस्ट बेड होना चाहिए जहाँ किए गए किसी भी परिवर्तन का वास्तविक दुनिया में असर न हो।
हालाँकि, इस वातावरण को फिर भी प्रोडक्शन आर्किटेक्चर को प्रतिबिंबित करना चाहिए, साथ ही सैंडबॉक्स या डमी क्रेडेंशियल्स का उपयोग करना चाहिए। उदाहरण के लिए, टेस्ट क्लाउड अकाउंट्स, मॉक APIs, और आंतरिक ईमेल सैंडबॉक्स वास्तविक जोखिम के बिना यथार्थवादी परीक्षण की अनुमति देते हैं।
एक दस्तावेजीकृत “ब्रेक ग्लास” प्रक्रिया भी अनुशंसित है। “ब्रेक ग्लास” प्रक्रिया एक रिकवरी योजना है जो बताती है कि यदि फ़ायरवॉल नियम या कंटेनर प्रतिबंध गलती से प्रशासकों को ब्लॉक कर दें तो एक्सेस कैसे बहाल करें।
यदि किसी एजेंट तक बाहर से पहुँचा जा सकता है, तो उसे टार्गेट किया जा सकता है। यही कारण है कि आपको इनबाउंड एक्सेस मैनेज करना होगा। यह आपकी पहली दृश्यमान रक्षा परत होगी।
सबसे सुरक्षित डिफ़ॉल्ट कॉन्फ़िगरेशन एप्लिकेशन को localhost IP 127.0.0.1 से बाँधता है, जिससे वह केवल लोकल मशीन से ही एक्सेस हो सके।
app.listen(3000, "127.0.0.1");इसके अलावा, कुछ सत्यापन होना महत्त्वपूर्ण है। nmap का उपयोग करके किसी अन्य डिवाइस से पोर्ट स्कैन यह पुष्टि करनी चाहिए कि कोई पोर्ट एक्सपोज़्ड नहीं है।
sudo nmap -p- -sS <target_IP>आपको यह भी ध्यान रखना चाहिए कि Docker लिनक्स होस्ट्स पर UFW या अन्य होस्ट फ़ायरवॉल को बाइपास कर सकता है क्योंकि यह सीधे नेटवर्किंग नियमों में हेरफेर करता है।
जब आप -p 0.0.0.0:3000:3000 से कोई पोर्ट प्रकाशित करते हैं, तो Docker उस पोर्ट को एक्सपोज़ कर सकता है भले ही आपका होस्ट फ़ायरवॉल उसे ब्लॉक करता हुआ दिखे। दूसरे शब्दों में, Docker के शामिल होने पर केवल फ़ायरवॉल पर भरोसा करना काफ़ी नहीं है।
तेज़ी से जाँचने का एक तरीका कि Docker वास्तव में क्या एक्सपोज़ कर रहा है, प्रकाशित पोर्ट्स देखना है:
docker port <container_name>
Look for 0.0.0.0:3000->3000/tcp (exposed publicly) versus 127.0.0.1:3000->3000/tcp (localhost-only).
Linux users can also inspect active Docker iptables rules:
```bash
sudo iptables -L DOCKER -n -v
यदि आप 0.0.0.0:PORT बाइंडिंग्स या DOCKER चेन में ACCEPT नियम देखते हैं, तो वह पोर्ट बाहरी रूप से पहुँचा जा सकता है जब तक कि उसे स्पष्ट रूप से सीमित न किया गया हो।
आप किसी अन्य मशीन से nmap का उपयोग करके बाहरी रूप से भी पुष्टि कर सकते हैं:
nmap -p 3000 <target_IP>यह कमांड आपके टार्गेट को बाहर से स्कैन करता है ताकि पुष्टि हो सके कि पोर्ट 3000 वास्तव में बंद/फ़िल्टर्ड है, यानी बाहरी एक्सेस नहीं है।
सर्वोत्तम प्रथा है Docker run कमांड में स्पष्ट रूप से localhost (127.0.0.1) से बाँधना:
docker run -p 127.0.0.1:3000:3000 openclawफिर docker port और किसी अन्य मशीन से बाहरी nmap स्कैन—दोनों से पुष्टि करें।
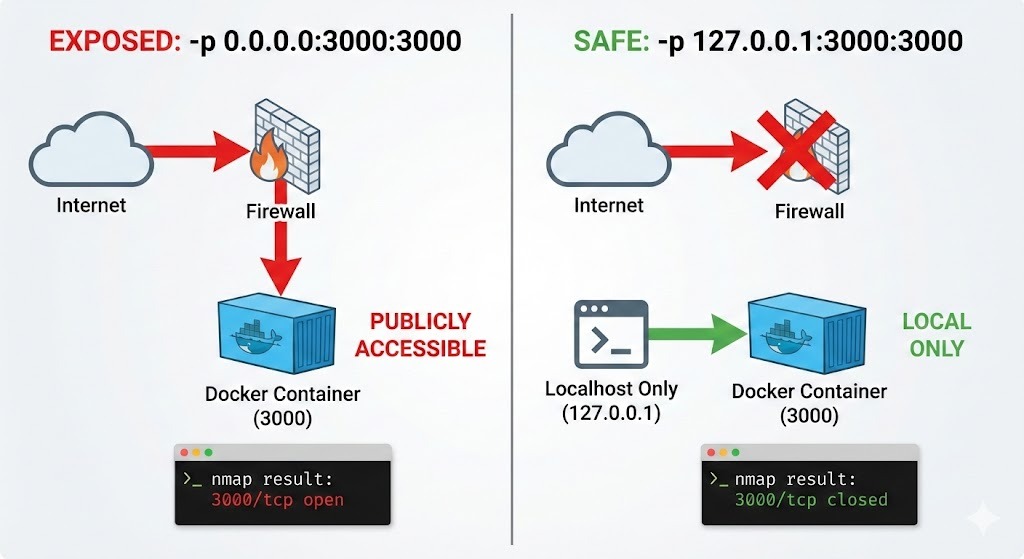
जब रिमोट एक्सेस ज़रूरी हो, तो एप्लिकेशन को सीधे पब्लिक इंटरनेट पर एक्सपोज़ करना शायद ही कभी उचित ठहराया जा सकता है।
Tailscale या WireGuard जैसे VPN का उपयोग भरोसेमंद डिवाइसों के बीच एन्क्रिप्टेड, प्रमाणित कनेक्टिविटी स्थापित करने के लिए किया जा सकता है। यह दृष्टिकोण खुले पोर्ट्स छोड़ने की तुलना में एक्सपोज़र को नाटकीय रूप से कम करता है।
जहाँ ब्राउज़र एक्सेस आवश्यक है, वहाँ Nginx जैसा रिवर्स प्रॉक्सी HTTPS कनेक्शनों को टर्मिनेट कर सकता है और ट्रैफ़िक एप्लिकेशन तक पहुँचने से पहले प्रमाणीकरण लागू कर सकता है।
सेशन मैनेजमेंट वह जगह भी है जहाँ आपको सावधानीपूर्वक ध्यान देने की ज़रूरत है। कमज़ोर सेशन नियंत्रण अक्सर अन्य मज़बूत परिमेटर सुरक्षा को कमजोर कर देते हैं।
मज़बूत पासवर्ड का उपयोग, क्रेडेंशियल्स का नियमित रोटेशन, और लॉगिन एंडपॉइंट्स पर रेट लिमिटिंग ब्रूट-फोर्स हमलों के खिलाफ बचाव में मदद करते हैं। छोटे सेशन जीवनकाल चोरी हुए टोकन की उपयोगिता भी कम करते हैं।
सिक्योर कुकीज़, SameSite एट्रिब्यूट्स, और CSRF प्रोटेक्शन प्रासंगिक रहते हैं, भले ही बैकएंड AI-संचालित एजेंट हो। आसपास का वेब इन्फ्रास्ट्रक्चर किसी भी अन्य एप्लिकेशन की तरह हार्डन किया जाना चाहिए।
मज़बूत परिमेटर नियंत्रणों के बावजूद, दुरुपयोग की संभावना बनी रहती है। कंटेनमेंट और आइसोलेशन रणनीतियाँ यह निर्धारित करने में अत्यंत सहायक होती हैं कि किसी घटना का फैलाव कितनी दूर तक हो सकता है।
कंटेनर को non-root यूज़र के रूप में चलाना संभावित एस्केप कमजोरियों के प्रभाव को कम करता है।
अनावश्यक Linux क्षमताओं को भी हटाया जाना चाहिए ताकि अटैक सरफेस सिकुड़े। कंटेनर अक्सर आवश्यक से अधिक विशेषाधिकारों के साथ चलते हैं, और अप्रयुक्त क्षमताओं को हटाने से हमलावर के काम करने की सीमा सीमित होती है।
इनमें से प्रत्येक उपाय एक ही विचार को सुदृढ़ करता है: भले ही एजेंट गलत व्यवहार करे, उसे होस्ट सिस्टम का नियंत्रण नहीं होना चाहिए।
नीचे एक सरल docker run उदाहरण है जो non-root यूज़र सेट करने, विशिष्ट Linux क्षमताओं के बिना चलाने, और फ़ाइल सिस्टम को रीड-ओनली के रूप में माउंट करने का सिंटैक्स दर्शाता है।
docker run \
  --name openclaw-secure \
  --user 1000:1000 \
  --read-only \
  --cap-drop=CAP_SYS_ADMIN \
  --cap-drop=CAP_NET_RAW \
  -v openclaw-workspace:/app/workspace \
  -p 127.0.0.1:3000:3000 \
  openclaw:latest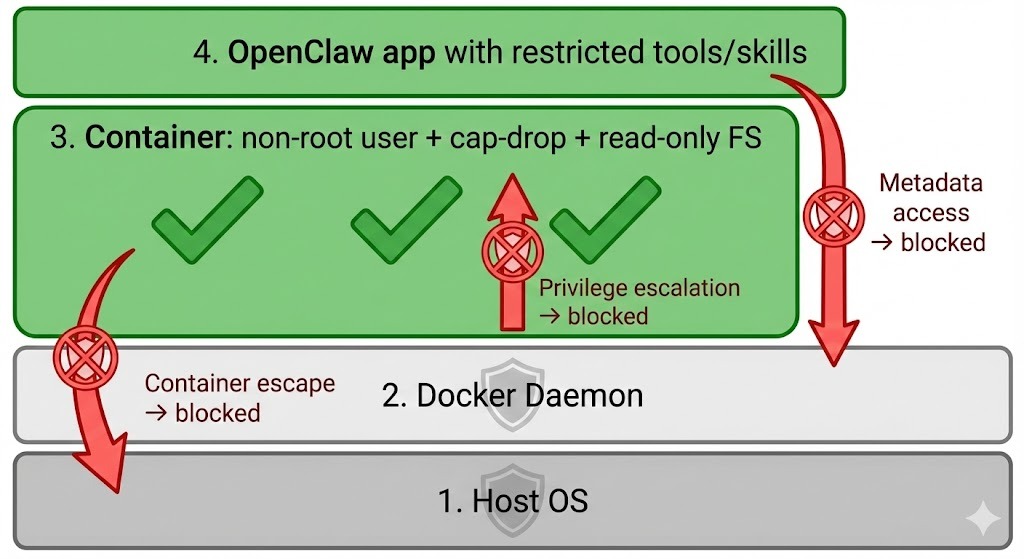
Docker Compose का उपयोग करने वाली टीमों के लिए भी वही सिद्धांत लागू होते हैं। एक न्यूनतम हार्डन किया हुआ docker-compose.yml स्निपेट कुछ इस प्रकार हो सकता है:
version: "3.9"

services:
  openclaw:
    image: openclaw:latest
    user: "1000:1000"
    read_only: true
    cap_drop:
      - CAP_SYS_ADMIN
      - CAP_NET_RAW
    ports:
      - "127.0.0.1:3000:3000"
    volumes:
      - openclaw-workspace:/app/workspace

volumes:
  openclaw-workspace:
एक महत्त्वपूर्ण स्पष्टता यह है कि ये Linux क्षमता प्रतिबंध macOS या Windows पर Docker चलाने पर भी अनिवार्य रहते हैं। यद्यपि वे सिस्टम Linux नहीं हैं, Docker Desktop कंटेनरों को एक छिपी हुई Linux वर्चुअल मशीन के अंदर चलाता है।
दूसरे शब्दों में, macOS या Windows पर होने से कंटेनर हार्डनिंग की आवश्यकता समाप्त नहीं होती।
आउटबाउंड फ़िल्टरिंग अक्सर नज़रअंदाज़ कर दी जाती है, फिर भी यह अत्यंत महत्वपूर्ण है। गंभीर घटनाएँ, जैसे डेटा एक्सफ़िल्ट्रेशन, ऐसे आउटबाउंड चैनलों के माध्यम से होती हैं।
डिफ़ॉल्ट “deny all” आउटबाउंड नीति प्रशासकों को स्पष्ट रूप से केवल अनुमोदित डोमेन्स को अनुमति देने के लिए बाध्य करती है। ट्रैफ़िक को आवश्यक एंडपॉइंट्स—जैसे API प्रदाता और आंतरिक सेवाएँ—तक सीमित करना इस जोखिम को काफ़ी हद तक कम कर देता है।
क्लाउड मेटाडेटा सेवाओं तक पहुँच को ब्लॉक करना इंस्टेंस क्रेडेंशियल्स के आकस्मिक एक्सपोज़र को भी रोकता है।
Linux क्लाउड इंस्टेंसेज़ (AWS/GCP/Azure) लिंक-लोकल IP 169.254.169.254 के माध्यम से अस्थायी क्रेडेंशियल्स एक्सपोज़ करते हैं। OpenClaw गलती से इस एंडपॉइंट को क्वेरी कर सकता है और इंस्टेंस मेटाडेटा लीक कर सकता है। आप मेटाडेटा IP तक आउटबाउंड ट्रैफ़िक को स्पष्ट रूप से ड्रॉप कर सकते हैं:
sudo iptables -A OUTPUT -d 169.254.169.254 -j DROPसत्यापित करने के लिए, निम्न चलाएँ:
sudo iptables -L -n -vयह सुनिश्चित करता है कि भले ही एजेंट मेटाडेटा सेवा तक पहुँचने की कोशिश करे, ट्रैफ़िक होस्ट से बाहर न जाए।
यदि आप नियम को विशेष रूप से Docker ट्रैफ़िक तक सीमित करना चाहते हैं, तो आप इसे DOCKER-USER चेन में ब्लॉक कर सकते हैं (जिसका मूल्यांकन Docker के अपने नियमों से पहले होता है):
sudo iptables -I DOCKER-USER -d 169.254.169.254 -j DROPयह दृष्टिकोण अक्सर अधिक सुरक्षित होता है क्योंकि Docker iptables नियमों को गतिशील रूप से संशोधित करता है। DOCKER-USER चेन विशेष रूप से यूज़र-परिभाषित प्रतिबंधों के लिए डिज़ाइन की गई है।
आप निम्न से पुष्टि कर सकते हैं कि नियम सक्रिय है:
sudo iptables -L DOCKER-USER -n -vसंवेदनशील होस्ट डायरेक्टरीज़ जैसे ~/.ssh या /etc को तब तक माउंट न करें जब तक यह बिल्कुल आवश्यक न हो।
ईफ़ेमरल कंटेनरों का उपयोग भी अतिरिक्त सुरक्षा परत प्रदान करने के लिए किया जाना चाहिए।
ये प्रत्येक टास्क के लिए एक ताज़ा कंटेनर की तरह कार्य करते हैं और बाद में नष्ट कर दिए जाते हैं। इससे दीर्घकालीन स्थायित्व काफ़ी कठिन हो जाता है। ऐसे अस्थायी वातावरण हमलावर की पाँव जमाने की क्षमता को कम करते हैं।
हर अतिरिक्त टूल क्षमता बढ़ाता है। हालाँकि, इस बढ़ी हुई क्षमता के साथ जोखिम भी बढ़ता है।
सीक्रेट्स को रनटाइम पर एन्वायरनमेंट वेरिएबल्स या किसी सीक्रेट मैनेजमेंट सिस्टम के माध्यम से इंजेक्ट किया जाना चाहिए। सोर्स कोड, प्रॉम्प्ट्स, या कंटेनर इमेजेस में क्रेडेंशियल्स एम्बेड करना अनावश्यक एक्सपोज़र पैदा करेगा।
कनेक्टेड इंटिग्रेशन का समय-समय पर ऑडिट यह सुनिश्चित करने में मदद कर सकता है कि अनुपयोगी क्रेडेंशियल्स हटा दिए जाएँ। जिन क्रेडेंशियल्स का कोई उद्देश्य नहीं, वे केवल अटैक सरफेस बढ़ाते हैं।
स्वायत्त एजेंट्स को स्किल्स और अतिरिक्त कंपोनेंट्स के माध्यम से विस्तारित किया जा सकता है। इस विस्तार के साथ अतिरिक्त जोखिम भी आता है। स्किल सप्लाई चेन को सुरक्षित करना मतलब थर्ड-पार्टी एक्सटेंशन को उसी सावधानी से ट्रीट करना जैसा आप बैकएंड एप्लिकेशन में प्रोडक्शन डिपेंडेंसीज़ के साथ करते हैं।
कंट्रोल के बिना प्लगइन्स को ऑटो-अपडेट होने देना सप्लाई-चेन जोखिम लाता है।
ऐसी स्थिति में, कोई नया रिलीज़ अनजाने में कमजोरियाँ ला सकता है, या सबसे बुरी हालत में, समझौता किया गया पैकेज दुर्भावनापूर्ण व्यवहार शामिल कर सकता है।
इस जोखिम को कम करने के लिए, आपको स्किल्स को विशिष्ट वर्ज़नों और जहाँ संभव हो, सटीक हैशेस पर पिन करना चाहिए।
उदाहरण के लिए:
"web-browser-skill": "1.4.2#sha256:abc123"पिनिंग सुनिश्चित करती है कि स्टेजिंग में आपने जिस सटीक कोड का परीक्षण किया था, वही प्रोडक्शन में चल रहा है। यह साइलेंट अपग्रेड्स को रोकता है और डिपेंडेंसी हाईजैकिंग या दुर्भावनापूर्ण अपडेट के माध्यम से सप्लाई-चेन पॉयज़निंग की संभावना कम करता है।
यह दृष्टिकोण सॉफ़्टवेयर विकास में सर्वोत्तम प्रथाओं को प्रतिबिंबित करता है, जहाँ प्रोडक्शन सिस्टम अनपेक्षित व्यवहार से बचने के लिए डिपेंडेंसी वर्ज़न लॉक करते हैं।
कोई भी नई स्किल सक्षम करने से पहले, उसके सोर्स कोड की समीक्षा करने के लिए समय निकालें। स्वायत्त एजेंट अक्सर API टोकन्स, फ़ाइल एक्सेस, या नेटवर्क परमिशन के साथ कार्य करते हैं।
यदि स्किल का सोर्स कोड ख़राब लिखा है, तो कोई दुर्भावनापूर्ण प्लगइन चुपचाप उन विशेषाधिकारों का दुरुपयोग कर सकता है।
निम्नलिखित व्यवहारों पर क़रीबी नज़र रखें:
एक दिखने में हानिरहित ब्राउज़िंग टूल भी, यदि उसमें छिपे नेटवर्क कॉल हों, तो डेटा एक्सफ़िल्ट्रेट कर सकता है। एक त्वरित कोड समीक्षा स्पष्ट लाल झंडे उजागर कर सकती है और जोखिम को काफ़ी कम कर सकती है।
कई एजेंट फ़्रेमवर्क अनेक बिल्ट-इन टूल्स के साथ आते हैं, जैसे शेल एक्सेस, Python निष्पादन, फ़ाइल एडिटर्स, या वेब ब्राउज़र्स। यद्यपि प्रयोग के दौरान लचीलापन उपयोगी है, प्रोडक्शन डिप्लॉयमेंट्स को न्यूनतम रखना चाहिए।
सक्रिय किया गया हर टूल ऐसी क्षमता दर्शाता है जिसका दुरुपयोग हो सकता है। अनावश्यक टूल्स हटाने से अटैक सरफेस कम होता है और एजेंट के समझौता होने पर उसकी क्षमताएँ सीमित रहती हैं।
AI सिस्टम ऐसे नए और विशिष्ट व्यवहारिक जोखिम लाते हैं जो पारंपरिक सॉफ़्टवेयर कमजोरियों से भिन्न होते हैं। आइए OpenClaw से जुड़े कुछ संभावित जोखिमों और समाधानों पर नज़र डालते हैं।
चूँकि OpenClaw अपने आउटपुट के लिए प्रॉम्प्ट इंजीनियरिंग पर निर्भर करता है, बाहरी सामग्री को हमेशा अविश्वसनीय इनपुट माना जाना चाहिए। उदाहरण के लिए, वेबपेज, ईमेल, और दस्तावेज़ों में छिपे निर्देश हो सकते हैं जो मॉडल को प्रभावित करने के लिए डिज़ाइन किए गए हों। इससे दुर्भावनापूर्ण परिणाम निकल सकता है।
प्रॉम्प्ट इंजेक्शन मॉडल की निर्देश-पालन प्रकृति का शोषण करता है। छिपी हुई HTML टिप्पणियाँ या सावधानीपूर्वक गढ़ा गया टेक्स्ट सिस्टम नियमों को ओवरराइड करने या संवेदनशील डेटा निकालने की कोशिश कर सकता है।
इसे रोकने के लिए हम कुछ रक्षात्मक उपाय अपना सकते हैं, जिनमें शामिल हैं:
असंबंधित कार्यों के बीच मेमोरी साफ़ करना भी अनपेक्षित डेटा लीक की संभावनाएँ और घटा सकता है।
दीर्घकालिक डिप्लॉयमेंट्स के लिए, आपको अधिक ऑब्ज़र्वेबिलिटी और मॉनिटरिंग की आवश्यकता होती है ताकि आपके मॉडल अपेक्षा के अनुसार प्रदर्शन कर रहे हों।
व्यापक लॉगिंग को प्रॉम्प्ट्स, मॉडल आउटपुट्स, टूल कॉल्स, फ़ाइल संशोधनों, और API इंटरैक्शन कैप्चर करने चाहिए। केंद्रीकृत लॉग स्टोरेज छेड़छाड़ को रोकने और घटना की जाँच में सहायक होगा।
मैं असामान्य व्यवहार (जैसे अप्रत्याशित आउटबाउंड ट्रैफ़िक या सिस्टम फ़ाइलों तक पहुँच) के लिए किसी प्रकार के अलर्ट की सिफ़ारिश करूँगा ताकि तेज़ी से प्रतिक्रिया दी जा सके।
चूँकि सुरक्षा एक बार की कॉन्फ़िगरेशन नहीं है, आपको जहाँ आवश्यक हो OpenClaw को नवीनतम संस्करण में अपडेट करने पर भी विचार करना चाहिए।
OpenClaw स्थानीय रूप से LLMs के डिप्लॉयमेंट के लिए बड़ी संभावनाएँ लाता है। क्योंकि अधिकांश लोकल मशीनों पर चलते हैं, आपकी अपनी मशीन की सुरक्षा महत्त्वपूर्ण है।
इस प्रकार, एक हार्डन किया हुआ OpenClaw डिप्लॉयमेंट सार्वजनिक इंटरनेट से अप्राप्य रहना चाहिए, सीमित रनटाइम में संचालित होना चाहिए, संकीर्ण-स्कोप क्रेडेंशियल्स का उपयोग करना चाहिए, और व्यापक लॉगिंग बनाए रखनी चाहिए।
इसे अपने लिए लागू करने हेतु, मैं आपको चुनौती देता हूँ कि आप अपनी विशिष्ट टियर स्थिति निर्धारित करें और उसी के अनुसार सुरक्षा उपायों पर काम करें।
नवीनतम AI, LLM, और एजेंट टेक्नोलॉजी पर और जानना चाहते हैं? हमारा AI Agent Fundamentals ट्रैक शुरू करने का सबसे अच्छा तरीका है।
AI कोर्स
लर्निंग पाथ
कोर्स
कोर्स