Cursus
Principes fondamentaux des agents IA
6 h
Les agents IA autonomes sont des systèmes puissants, et c’est justement cette puissance qui peut les rendre dangereux.
OpenClaw et des frameworks d’agents similaires vont bien au-delà de la simple génération de texte. Ils exécutent du code, modifient des fichiers, appellent des API et interagissent directement avec d’autres systèmes. Cela signifie un passage du « raisonner » à l’« agir » qui change fondamentalement le modèle de sécurité.
Chaque erreur peut entraîner de véritables conséquences. Les actions exécutées par OpenClaw s’apparentent à des services backend dotés de privilèges opérationnels réels, bien loin d’une simple interface conversationnelle.
Dans ce guide, je couvre les aspects de sécurité liés à l’exécution d’OpenClaw et les bonnes pratiques pour que votre déploiement tienne compte des risques potentiels.
Si vous n’êtes pas encore familiers avec les concepts derrière des outils comme OpenClaw, je vous recommande notre cours Introduction to AI Agents.
OpenClaw (anciennement Clawdbot, puis brièvement Moltbot) est un framework d’agent autonome open source qui connecte un grand modèle de langage (LLM) à un ensemble d’outils exécutables. Ces outils peuvent inclure :
Contrairement à un chatbot basique qui ne renvoie que du texte, OpenClaw permet au modèle d’agir concrètement dans votre environnement. En pratique, il se rapproche davantage d’un moteur d’automatisation ou d’un utilitaire DevOps que d’un simple assistant conversationnel.
Le risque central découle naturellement de cette capacité : le texte est généralement inoffensif, les actions ne le sont pas.
Parmi les actions possibles d’un agent :
Si l’agent est influencé par une entrée malveillante ou des prompts mal structurés, ces actions peuvent produire des effets indésirables. Les garde-fous LLM classiques, comme le filtrage par mots-clés ou la modération de réponses, ne suffisent pas dans ce contexte.
Une attaque par injection de prompt, par exemple, pourrait tromper le modèle pour récupérer des fichiers sensibles ou détourner un jeton d’API.
Si vous évaluez des frameworks alternatifs à OpenClaw, consultez notre guide comparatif.
Voyons maintenant comment renforcer la sécurité de votre déploiement.
Pour commencer, veillez toujours à la clarté de votre instance OpenClaw. Sans vision précise de ce qui existe et de ses droits d’accès, aucune protection efficace n’est possible.
Avant de modifier les règles du pare-feu ou les paramètres des conteneurs, prenez le temps de cartographier l’environnement actuel. De nombreux incidents de sécurité proviennent moins d’exploits sophistiqués que de serveurs de test oubliés ou d’identifiants trop permissifs laissés en place.
Commencez par identifier chaque instance OpenClaw en fonctionnement :
Il est fréquent de découvrir des serveurs cloud oubliés, des conteneurs exposés avec -p 0.0.0.0:3000:3000 ou des tunnels temporaires comme Ngrok jamais fermés. Ces montages expérimentaux dépassent souvent leur but initial et ne devraient pas rester actifs.
Ensuite, identifiez vos « bijoux de la couronne », c’est-à-dire les actifs sensibles accessibles à l’agent, comme :
Chaque identifiant doit être évalué pour sa portée et ses privilèges. Par exemple, un accès administrateur entraîne un risque bien supérieur à un accès en lecture seule. Disposer d’une vision claire de ces privilèges aide à quantifier les dommages potentiels.
Une question utile à se poser : « Si l’agent était totalement compromis aujourd’hui, que pourrait-il réellement se passer ? »
Documentez également les risques immédiats, notamment :
Consigner ces constats établit une ligne de base et rend les améliorations mesurables.
Pour des déploiements plus établis, l’adoption d’un modèle de sécurité par niveaux est une bonne pratique.
Ce modèle apporte structure et clarté. Tous les déploiements n’ont pas besoin de contrôles de niveau entreprise, mais chacun doit être catégorisé de manière intentionnelle.
Voici les 3 niveaux principaux :
Ce niveau convient à l’expérimentation et à l’apprentissage, sans données sensibles.
À ce niveau, l’agent peut interagir avec des dépôts partagés ou des API internes, ce qui exige des garde-fous renforcés.
Ce niveau est conçu pour les environnements manipulant des données réglementées ou des opérations financières.
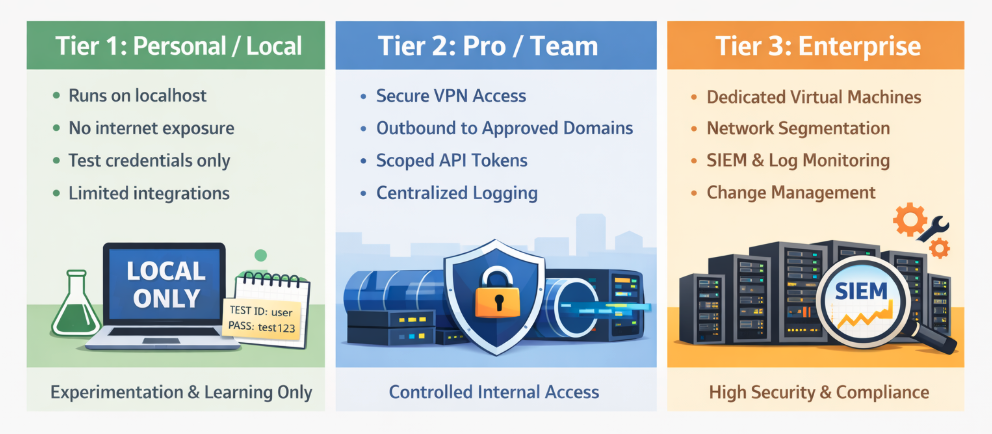
L’essentiel n’est pas de viser par défaut le niveau le plus élevé, mais d’identifier clairement le niveau adapté et pourquoi.
Un environnement de préproduction ou « safe lab » permet de tester des changements de sécurité sans risquer les systèmes de production. Il doit s’agir d’un banc d’essai simple où les modifications n’auront aucune conséquence réelle.
Cet environnement doit toutefois refléter l’architecture de production, tout en utilisant des identifiants sandbox ou factices. Par exemple, des comptes cloud de test, des API simulées et des bacs à sable e-mail internes permettent des tests réalistes sans risque opérationnel.
Nous recommandons aussi une procédure documentée de type « break glass » : un plan de secours pour restaurer l’accès si des règles de pare-feu ou des restrictions de conteneur bloquent par erreur les administrateurs.
Si un agent est joignable de l’extérieur, il peut être ciblé. D’où la nécessité de gérer les accès entrants : c’est votre première couche de défense visible.
La configuration par défaut la plus sûre lie l’application à l’IP localhost 127.0.0.1, la rendant accessible uniquement depuis la machine locale.
app.listen(3000, "127.0.0.1");Prévoyez également une vérification : un scan de port depuis un autre appareil avec nmap doit confirmer qu’aucun port n’est exposé.
sudo nmap -p- -sS <target_IP>Notez que Docker peut contourner UFW sur les hôtes Linux (ou d’autres pare-feux) en manipulant directement les règles réseau.
Lorsque vous publiez un port avec -p 0.0.0.0:3000:3000, Docker peut exposer ce port même si le pare-feu de l’hôte semble le bloquer. Autrement dit, se fier uniquement aux pare-feux ne suffit pas quand Docker est en jeu.
Un moyen rapide de vérifier ce que Docker expose réellement consiste à consulter les ports publiés :
docker port <container_name>
Look for 0.0.0.0:3000->3000/tcp (exposed publicly) versus 127.0.0.1:3000->3000/tcp (localhost-only).
Linux users can also inspect active Docker iptables rules:
```bash
sudo iptables -L DOCKER -n -v
Si vous voyez des bindings 0.0.0.0:PORT ou des règles ACCEPT dans la chaîne DOCKER, ce port est joignable depuis l’extérieur sauf restriction explicite.
Vous pouvez aussi confirmer depuis une autre machine avec nmap :
nmap -p 3000 <target_IP>Cette commande scanne votre cible de l’extérieur pour confirmer que le port 3000 est bien fermé/filtré, preuve de l’absence d’accès externe.
Bonne pratique : lier explicitement à localhost (127.0.0.1) dans la commande Docker run :
docker run -p 127.0.0.1:3000:3000 openclawPuis confirmez avec docker port et un scan nmap externe depuis une autre machine.
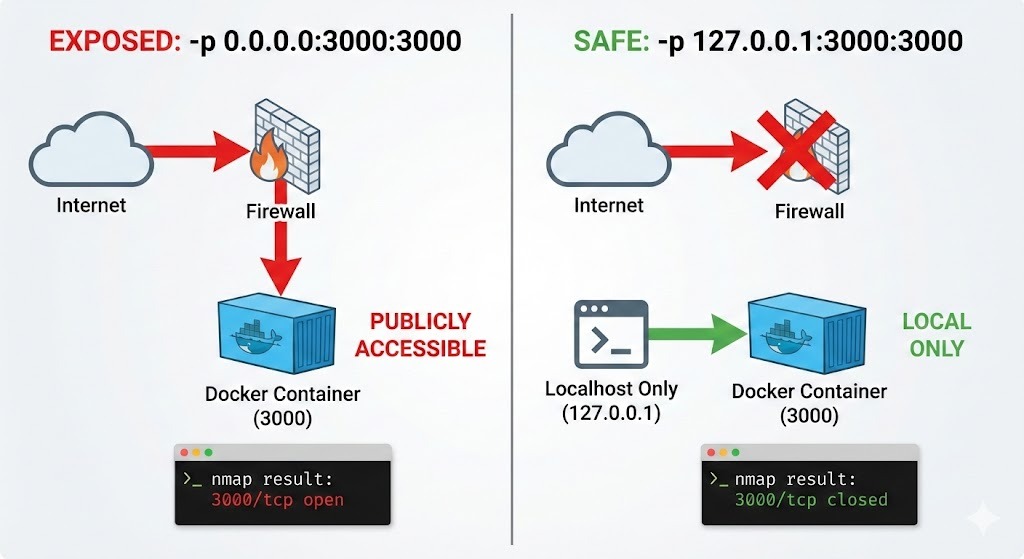
Quand l’accès à distance est nécessaire, exposer directement l’application sur Internet se justifie rarement.
Un VPN comme Tailscale ou WireGuard permet d’établir une connectivité chiffrée et authentifiée entre appareils de confiance. Cette approche réduit fortement l’exposition par rapport aux ports laissés ouverts.
Si un accès via navigateur est requis, un reverse proxy comme Nginx peut terminer les connexions HTTPS et imposer une authentification avant que le trafic n’atteigne l’application.
La gestion des sessions requiert également une attention particulière. Des contrôles faibles peuvent ruiner une périmétrie par ailleurs solide.
Des mots de passe robustes, une rotation régulière des identifiants et un rate limiting sur les endpoints de connexion aident à se défendre contre la force brute. Des durées de session courtes diminuent également l’intérêt de jetons volés.
Cookies sécurisés, attributs SameSite et protections CSRF restent pertinents même si le backend est un agent piloté par IA. L’infrastructure web autour doit être durcie comme pour toute application.
Même avec de bons contrôles périmétriques, le risque d’abus subsiste. Les stratégies de confinement et d’isolation déterminent jusqu’où un incident peut se propager.
Exécuter le conteneur avec un utilisateur non-root réduit l’impact d’éventuelles failles d’évasion.
Il faut également supprimer les capacités Linux non nécessaires pour réduire la surface d’attaque. Les conteneurs fonctionnent souvent avec plus de privilèges que requis ; retirer les capacités inutiles limite les possibilités d’un attaquant.
Toutes ces mesures visent le même objectif : même si l’agent se comporte mal, il ne doit pas contrôler l’hôte.
Voici un exemple simple de docker run illustrant la syntaxe pour définir un utilisateur non-root, retirer des capacités Linux et monter le système de fichiers en lecture seule.
docker run \
  --name openclaw-secure \
  --user 1000:1000 \
  --read-only \
  --cap-drop=CAP_SYS_ADMIN \
  --cap-drop=CAP_NET_RAW \
  -v openclaw-workspace:/app/workspace \
  -p 127.0.0.1:3000:3000 \
  openclaw:latest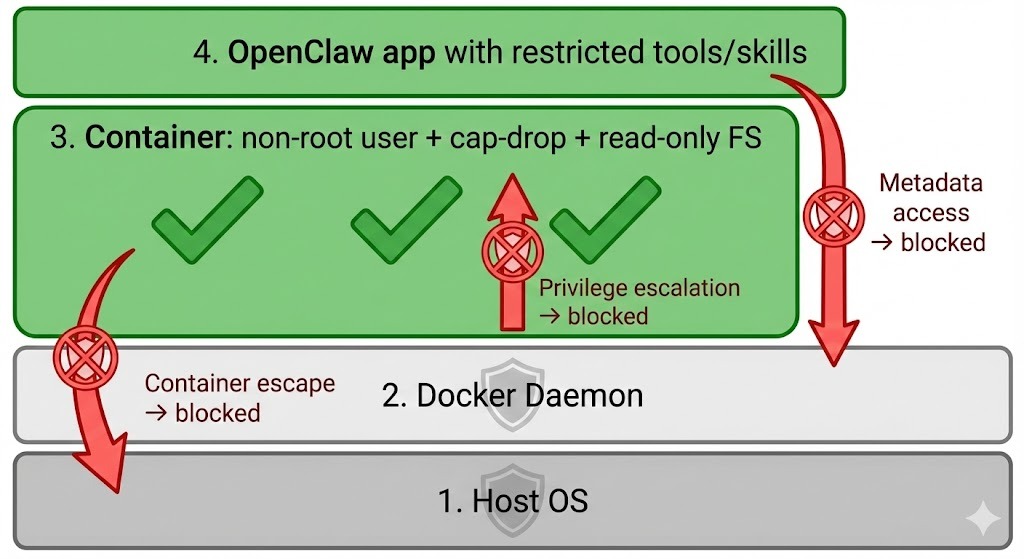
Pour les équipes utilisant Docker Compose, les mêmes principes s’appliquent. Un extrait minimaliste et durci de docker-compose.yml pourrait ressembler à ceci :
version: "3.9"

services:
  openclaw:
    image: openclaw:latest
    user: "1000:1000"
    read_only: true
    cap_drop:
      - CAP_SYS_ADMIN
      - CAP_NET_RAW
    ports:
      - "127.0.0.1:3000:3000"
    volumes:
      - openclaw-workspace:/app/workspace

volumes:
  openclaw-workspace:
Précision importante : ces restrictions de capacités Linux restent indispensables même sous macOS ou Windows. Bien que ces systèmes ne soient pas Linux, Docker Desktop exécute les conteneurs dans une machine virtuelle Linux cachée.
Autrement dit, être sur macOS ou Windows n’élimine pas le besoin de durcir les conteneurs.
Le filtrage sortant est souvent négligé, pourtant crucial. Les incidents graves, comme l’exfiltration de données, passent par ces canaux sortants.
Une politique par défaut « tout refuser » oblige les administrateurs à autoriser explicitement les domaines approuvés. Limiter le trafic aux endpoints nécessaires — fournisseurs d’API et services internes — réduit fortement ce risque.
Bloquer l’accès aux services de métadonnées cloud empêche également l’exposition accidentelle d’identifiants d’instance.
Les instances Linux (AWS/GCP/Azure) exposent des identifiants temporaires via l’IP locale 169.254.169.254. OpenClaw pourrait interroger par erreur cet endpoint et divulguer des métadonnées d’instance. Vous pouvez bloquer explicitement le trafic sortant vers cette IP :
sudo iptables -A OUTPUT -d 169.254.169.254 -j DROPPour vérifier, exécutez :
sudo iptables -L -n -vAinsi, même si l’agent tente d’atteindre le service de métadonnées, le trafic ne quittera jamais l’hôte.
Pour cibler spécifiquement le trafic Docker, vous pouvez bloquer dans la chaîne DOCKER-USER (évaluée avant les règles de Docker) :
sudo iptables -I DOCKER-USER -d 169.254.169.254 -j DROPCette approche est souvent plus sûre, car Docker modifie dynamiquement les règles iptables. La chaîne DOCKER-USER est conçue pour vos restrictions personnalisées.
Vous pouvez confirmer l’activation de la règle avec :
sudo iptables -L DOCKER-USER -n -vDes répertoires hôtes sensibles comme ~/.ssh ou /etc ne doivent jamais être montés sauf impératif absolu.
Utilisez aussi des conteneurs éphémères pour une protection supplémentaire.
Ils fournissent un environnement neuf à chaque tâche puis sont détruits. Cela complique la persistance à long terme. De tels environnements temporaires réduisent la capacité d’un attaquant à s’implanter.
Chaque outil ajouté étend les capacités. Mais cette extension s’accompagne d’un risque accru.
Injectez les secrets à l’exécution via des variables d’environnement ou un gestionnaire de secrets. Intégrer des identifiants dans le code source, les prompts ou les images de conteneur crée une exposition inutile.
Des audits périodiques des intégrations connectées aident également à retirer les identifiants non utilisés. Des identifiants sans utilité n’apportent que de la surface d’attaque.
Les agents autonomes s’étendent via des skills et composants additionnels. Cette extension apporte aussi des risques. Sécuriser la chaîne d’approvisionnement des skills revient à traiter les extensions tierces avec la même prudence que des dépendances de production dans une application backend.
Laisser des plugins se mettre à jour automatiquement sans contrôle introduit un risque supply chain.
Un nouveau correctif peut introduire par inadvertance des vulnérabilités, ou pire, un package compromis peut embarquer un comportement malveillant.
Pour réduire ce risque, figez les skills sur des versions précises et, si possible, sur des hachages exacts.
Par exemple :
"web-browser-skill": "1.4.2#sha256:abc123"Le version pinning garantit que le code testé en préproduction est exactement celui qui tourne en production. Il empêche les mises à jour silencieuses et réduit les risques d’empoisonnement supply chain via détournement de dépendances ou mises à jour malveillantes.
Cette approche reflète les bonnes pratiques du développement logiciel, où les systèmes de production verrouillent les versions pour éviter les comportements inattendus.
Avant d’activer un nouveau skill, prenez le temps d’en revoir le code source. Les agents autonomes opèrent souvent avec des jetons d’API, des accès fichiers ou réseau.
Si le code du skill est mal écrit, un plugin malveillant peut détourner discrètement ces privilèges.
Soyez attentif aux comportements suivants :
Même un outil de navigation apparemment anodin peut exfiltrer des données s’il inclut des appels réseau cachés. Un examen rapide du code peut révéler des signaux d’alerte et réduire fortement le risque.
De nombreux frameworks d’agents incluent plusieurs outils intégrés, comme l’accès shell, l’exécution Python, des éditeurs de fichiers ou des navigateurs web. Si cette flexibilité est utile en phase d’expérimentation, un déploiement en production doit rester minimal.
Chaque outil activé représente une capacité potentiellement détournable. Supprimer les outils inutiles réduit la surface d’attaque et limite ce que l’agent peut faire s’il est compromis.
Les systèmes d’IA introduisent des risques comportementaux nouveaux, différents des vulnérabilités logicielles classiques. Examinons les risques et parades possibles avec OpenClaw.
Parce qu’OpenClaw repose sur l’ingénierie de prompt pour ses sorties, le contenu externe doit toujours être traité comme non fiable. Des pages web, e-mails ou documents peuvent contenir des instructions cachées destinées à influencer le modèle, avec à la clé des effets malveillants.
L’injection de prompt exploite la propension du modèle à suivre des consignes. Des commentaires HTML cachés ou un texte soigneusement conçu peuvent tenter de contourner les règles système ou d’extraire des données sensibles.
Parmi les mesures défensives utiles :
Purger la mémoire entre des tâches sans lien peut aussi réduire les fuites involontaires de données.
Pour des déploiements de longue durée, il vous faut davantage d’observabilité et de monitoring afin de garantir que les modèles se comportent comme prévu.
Une journalisation exhaustive doit capturer prompts, sorties du modèle, appels d’outils, modifications de fichiers et interactions API. Un stockage centralisé des journaux aide à prévenir les altérations et à enquêter sur les incidents.
Je recommande de mettre en place des alertes en cas de comportement inhabituel (trafic sortant inattendu, accès à des fichiers système, etc.) pour réagir plus vite.
La sécurité n’étant pas un réglage ponctuel, pensez également à mettre à jour OpenClaw vers la dernière version lorsque nécessaire.
OpenClaw offre un vrai potentiel pour le déploiement local de LLM. Parce que la plupart des instances tournent sur des machines locales, la sécurité de votre propre poste est essentielle.
Ainsi, un déploiement OpenClaw durci doit rester injoignable depuis Internet, fonctionner dans un runtime restreint, utiliser des identifiants à portée réduite et maintenir une journalisation exhaustive.
Pour le mettre en place, je vous invite à déterminer votre niveau cible puis à déployer les mesures de sécurité en conséquence.
Vous souhaitez explorer davantage les dernières technologies IA, LLM et agents ? Notre parcours AI Agent Fundamentals est la meilleure façon de commencer.
Cours IA
Cursus
Cours
Cours
blog
blog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Zoumana Keita
15 min
Tutoriel