
Cursus
Agentic Systems ontwerpen met LangChain
3 uur
14.9K
Oefen en volg je voortgang.
Ga Verder Met GoogleVoor veel mensen worden large language models (LLM’s) vooral gebruikt als conversatie-interfaces. Je stelt een vraag, het model antwoordt, en daar eindigt de interactie.
LLM’s kunnen echter meer: ze worden ingebed in systemen die autonoom kunnen plannen, onthouden en acties ondernemen. Zo ontstaan zogeheten LLM-agents. Agentische systemen worden steeds populairder in moderne analytics- en bedrijfsworkflows.
Aan het eind van dit artikel begrijp je wat LLM-agents zijn, hoe ze worden gebouwd, welke typen agents er bestaan en waar ze waarde kunnen creëren.
Haal het meeste uit dit artikel door het te combineren met het AI Fundamentals skill track om je kennis over AI en LLM’s op te frissen.
Laten we bespreken hoe LLM-agents verschillen van standaard language models.
Je gebruikelijke LLM-interface, zoals een chatbot, kan alleen prompts ontvangen en antwoorden genereren op basis van zijn training, zonder externe acties of status. Een LLM-agent gebruikt daarentegen een LLM als kern van het redeneervermogen (als een brein) en plaatst er ondersteunende componenten omheen die het mogelijk maken om te redeneren, te plannen en uit te voeren.
LLM-agents verschuiven de focus van automatisering naar autonomie.
Automatisering stelt LLM’s in staat input te nemen en een reeks stappen te volgen om output te genereren. Met autonomie geven we de LLM een set tools en het vermogen om te beslissen hoe die het beste tot een oplossing kan komen, gebaseerd op wat het weet over de situatie. Dat geeft de LLM meer flexibiliteit en complexiteit om “zelfstandig” te handelen.
Zie een kale LLM als een expert-consultant die vragen beantwoordt op basis van zijn kennis. Een LLM-agent is diezelfde expert die een team leidt: die beslist welke vragen gesteld moeten worden, welke teamleden (tools) geraadpleegd worden en hoe hun antwoorden tot een oplossing worden gecombineerd.
Een LLM-agent bestaat uit meerdere kerncomponenten:
De volgende grafiek visualiseert de onderlinge relatie.
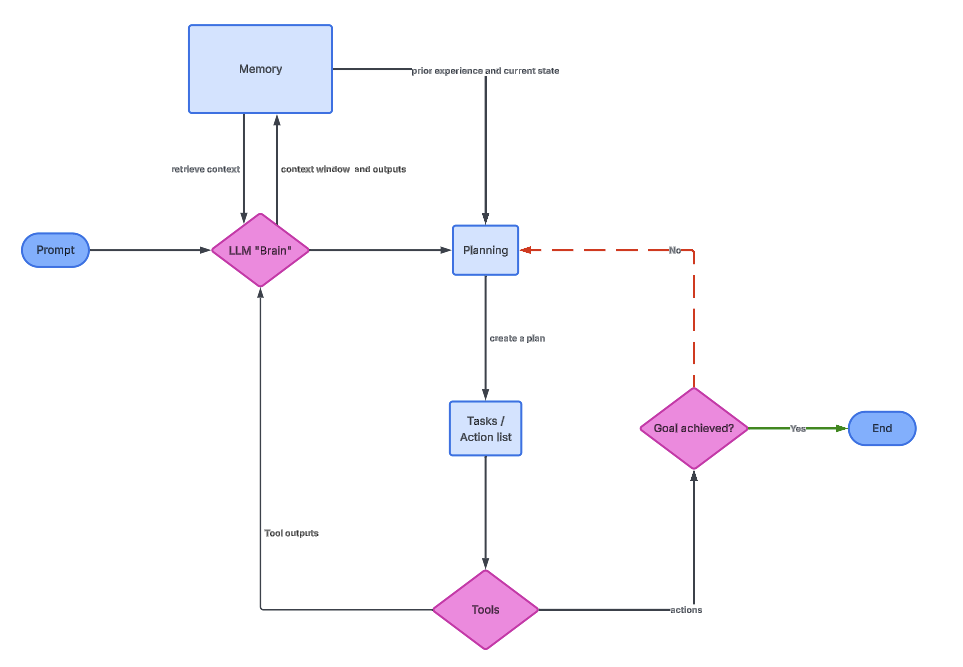
De LLM fungeert als het cognitieve hart van de agent. Het interpreteert het doel van de gebruiker, redeneert over tussenstappen en beslist welke acties genomen worden. In de praktijk wordt de LLM herhaaldelijk aangeroepen, niet slechts één keer.
Elke keer dat de LLM wordt aangeroepen, ontvangt die context die het oorspronkelijke doel, eerdere acties, tool-uitvoer en relevant geheugen kan bevatten. Op basis daarvan beslist de LLM over de volgende actie. Daarmee functioneert de LLM meer als een controller dan als een statische tekstgenerator.
Voor dataprofessionals is het belangrijk te begrijpen dat de LLM niet direct code of queries uitvoert. Die genereert gestructureerde instructies die door andere componenten worden geïnterpreteerd. De kwaliteit van een agent hangt vaak af van hoe goed deze instructies worden begrensd en gevalideerd.
Planningslogica is het mechanisme waarmee agents complexe problemen oplossen door ze op te delen in behapbare stappen. Zonder planning zou een agent alles in één antwoord proberen op te lossen, wat vaak leidt tot fouten of hallucinaties.
In een planningsfase decomposeert de agent een hoogover doel in kleinere taken. Zo kan “Klantverloop analyseren” worden opgesplitst in “klantdata laden”, “churn-rate berekenen”, “trends identificeren” en “bevindingen samenvatten”. Elke subtaken wordt vervolgens sequentieel of conditioneel uitgevoerd.
Een populaire techniek is Chain-of-Thought (CoT), waarbij het model expliciet wordt aangemoedigd te redeneren door een reeks acties als opeenvolgende prompts te koppelen.
ReAct (reasoning and acting) gaat nog een stap verder en verweeft redeneertraces met tool-acties en externe observaties. Deze externe feedback helpt agents gegrond te blijven en zichzelf te corrigeren wanneer tussenresultaten niet overeenkomen met de verwachting.
Geheugen stelt een agent in staat om continuïteit te behouden over interacties en acties door eerdere informatie te hergebruiken. Zonder geheugen zou elke stap geïsoleerd zijn en moet de agent dezelfde kennis steeds opnieuw ontdekken.
Korte-termijngeheugen bevindt zich doorgaans binnen het contextvenster van de LLM. Het omvat recente berichten, intermediair redeneren en tool-uitvoer. Net als RAM in computerarchitectuur is dit geheugen snel maar beperkt en verdwijnt het zodra de context wordt overschreden.
Lange-termijngeheugen wordt extern geïmplementeerd, vaak met behulp van vector databases. Technieken zoals RAG (Retrieval-Augmented Generation) stellen de agent in staat relevante documenten of eerdere interacties op te halen en in de huidige context te injecteren.
Tools breiden de mogelijkheden van een agent uit voorbij taal. Ze stellen de agent in staat te interageren met de echte wereld, inclusief databases, API’s en rekenengines.
Vanuit het perspectief van de agent zijn tools aanroepbare functies met gedefinieerde input en output. De LLM beslist wanneer een tool wordt gebruikt, welke argumenten worden meegegeven en hoe het resultaat wordt geïnterpreteerd. Dit beslisproces onderscheidt agents van gescripte workflows.
Tools kunnen functies omvatten zoals Google-zoekopdrachten, SQL-uitvoering, Python-interpreters en API’s. De agent heeft in feite toegang tot dezelfde technologische hulpmiddelen als wij en kan ze samenbrengen om oplossingen uit te voeren.
De bovenstaande afbeelding toont de algemene LLM-agentarchitectuur. Het brein levert geheugen- en planningsinformatie, die vervolgens een reeks taken met tools initieert.
In deze sectie vatten we de verschillende categorieën agents samen, van de meest basale reflexagents tot complexe lerende agents.
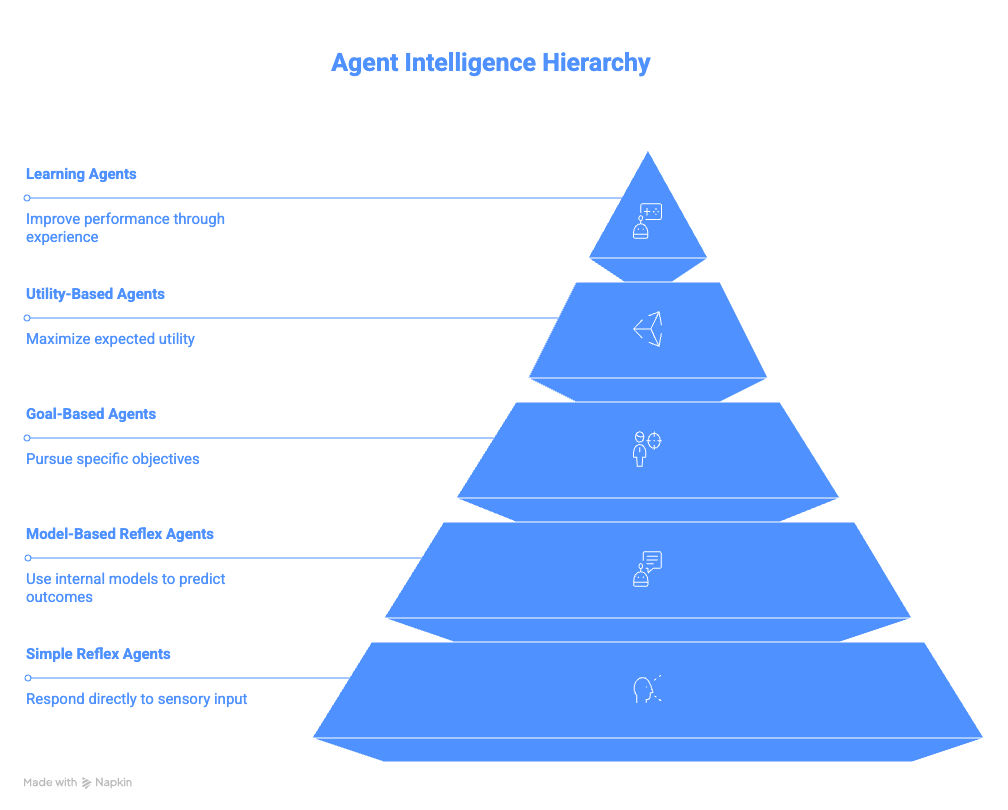
Eenvoudige reflexagents werken met directe als-dan-regels. Ze houden geen rekening met historie, toekomstige consequenties of alternatieve acties. Als aan een voorwaarde wordt voldaan, wordt de bijbehorende actie direct uitgevoerd.
Deze eenvoud maakt ze makkelijk te implementeren, maar ook erg kwetsbaar. Onverwachte input of een ontbrekend signaal kan leiden tot onjuist gedrag. Ze kunnen zich ook niet aanpassen aan veranderende omgevingen.
Het voorbeeld van een e-mail-unsubscribe-bot laat deze beperking zien. Die voert de taak snel uit maar mist bewustzijn, wat tot ongewenste resultaten kan leiden.
Modelgebaseerde reflexagents verbeteren eenvoudige reflexagents door een interne representatie van de omgeving bij te houden. Dat interne model stelt ze in staat te redeneren over zaken die niet direct zichtbaar zijn.
Door een status in de tijd te volgen, kunnen deze agents omgaan met gedeeltelijke observeerbaarheid. Ze onthouden wat er al is gebeurd en gebruiken die informatie voor toekomstige acties.
IDE-assistenten zoals Copilot of Cursor AI zijn sterke voorbeelden. Ze houden overzicht over bestanden, variabelen en functies gedurende een sessie, waardoor ze intelligenter kunnen suggereren dan simpel patroonmatchen. Ze slaan ook een brug naar de volgende categorie agents.
Doelgerichte agents zijn ontworpen rond uitkomsten in plaats van triggers. Ze plannen en evalueren acties op basis van de vraag of deze het systeem dichter bij een gewenst doel brengen, in plaats van puur reactief te zijn.
Deze agents genereren plannen die meerdere stappen en conditionele vertakkingen kunnen omvatten. Als één benadering faalt, kunnen ze een alternatief pad proberen. Dit maakt ze aanzienlijk flexibeler dan reflexgebaseerde agents.
Het maken van een reisplanning laat zien hoe een enkel hoogover doel kan worden opgesplitst in meerdere gecoördineerde acties over systemen heen.
De agent reageert niet simpelweg op de prompt “geef me een itinerary” en spuugt informatie uit. In plaats daarvan splitst die het doel op in kleine deelproblemen, zoals:
Het doel om een reisplanning te genereren wordt vervolgens bereikt door de oplossingen van elk van die problemen te combineren.
Nutgebaseerde agents breiden doelgerichte agents uit door optimalisatie te introduceren. In plaats van simpelweg een doel te halen, evalueren ze verschillende uitkomsten met behulp van een “nutfunctie”.
Een nutfunctie kent scores toe aan uitkomsten op basis van criteria zoals kosten, tijd, risico of gebruikersvoorkeur. De agent kiest vervolgens de actiesequentie die het totale nut maximaliseert.
Deze aanpak is gangbaar in aanbevelingssystemen en optimalisatieproblemen. Denk aan het vinden van de beste route naar een locatie, het aanbevelen van de juiste producten, of zelfs het samenstellen van de beste analyse voor een specifieke gebruiker.
Lerende agents zijn ontworpen om hun gedrag in de loop van de tijd te verbeteren zonder expliciete herprogrammering.
Bij elke iteratie krijgt een agent feedback en gebruikt die informatie om de prestaties te verbeteren. Ze opereren in omgevingen waar optimaal gedrag niet vooraf bekend is en vereisen geen expliciete herprogrammering voor elke nieuwe situatie.
Er zijn twee hoofdcomponenten: een “Critic” en een “Learning Element”. De “Critic” evalueert uitkomsten en geeft feedback. Het “Learning Element” gebruikt deze feedback om toekomstige beslissingen aan te passen. Na verloop van tijd raakt de agent beter afgestemd op gebruikersvoorkeuren of omgevingsbeperkingen.
Stel bijvoorbeeld een LLM-agent voor die dagelijks nieuws voor je samenvat. Die kan je gedrag observeren en zich aanpassen aan je voorkeuren. Als de agent merkt dat je “Sport”-samenvattingen zelden opent, maar wel interesse hebt in “Eten en drinken”, dan kan die stoppen met sport en zich richten op jouw interesse in bepaalde keukens of restaurants.
De volgende tabel vat de verschillen tussen de typen LLM-agents samen.
|
Agent |
Kernidee |
Geheugen |
Planning |
Leren |
Complexiteit |
Voorbeeld |
|
Eenvoudige reflexagent |
Mapt direct een conditie op een actie |
Nee |
Geen |
Nee |
Zeer laag |
Automatisch e-mails archiveren die het woord “unsubscribe” bevatten |
|
Modelgebaseerde reflexagent |
Houdt een intern model van de omgeving bij |
Ja (statustracking) |
Minimaal |
Nee |
Laag |
IDE-assistent die variabelen of bestanden onthoudt die eerder in een sessie zijn gedefinieerd |
|
Doelgerichte agent |
Onderneemt acties om een specifiek doel te bereiken |
Ja |
Ja |
Nee |
Middel |
Vluchten, hotels en vervoer boeken voor een zakenreis |
|
Nutgebaseerde agent |
Kiest de beste uitkomst op basis van voorkeuren |
Ja |
Ja |
Nee |
Middel tot hoog |
Reisagent die kosten vs. duur vs. comfort optimaliseert |
|
Lerende agent |
Verbetert gedrag op basis van feedback in de tijd |
Ja |
Ja |
Ja |
Hoog |
Nieuwsagent die content aanpast op basis van gebruikersbetrokkenheid |
In deze sectie bespreken we veelgebruikte frameworks voor het bouwen van LLM-agentsystemen.
LangChain biedt een modulair framework voor het bouwen van LLM-gestuurde systemen. Het uitgangspunt is dat je complexe workflows kunt opbouwen door eenvoudige componenten te combineren. Het vangt de uitdaging van communiceren met verschillende LLM’s en abstraheert dat proces voor de gebruiker via Python-objecten.
Het sleutelconcept in LangChain is het idee van “Chains”, die prompts, modellen en parsers koppelen tot herhaalbare workflows. Zo neem je bijvoorbeeld een PromptTemplate, die aan de LLM wordt gevoerd en verwerkt door een OutputParser.
LCEL (LangChain Expression Language) biedt een declaratieve syntaxis waarmee gebruikers pipes (|) kunnen gebruiken om visueel chains te componeren. In plaats van klassieke Python-workflows waarbij je prompts expliciet aan je model moet doorgeven, kun je simpelweg chain = prompt | model schrijven en laat je LangChain de templating afhandelen.
Voor complexere functionaliteit laat LangChain gebruikers tools toevoegen zoals Wikipedia, Python REPL’s en Google Search aan hun agents
LangGraph bouwt voort op de functionaliteit van LangChain en combineert deze concepten met geheugen om stateful agentarchitecturen op productieniveau te ondersteunen met expliciete controle over de uitvoeringsstroom.
Naast LangGraph is het LangChain-ecosysteem verder gegroeid met manieren om agents makkelijker te observeren (LangSmith) en zelfs drag-and-dropinterfaces (LangFlow).
LlamaIndex blinkt uit in documentgerichte workflows met nauwkeurige OCR en parsing voor 90+ ongestructureerde bestandstypen, desgewenst gecombineerd met agentische workflows voor intelligente retrieval en extractie.
De dataconnectoren vereenvoudigen het inladen uit veel bronnen, terwijl de indexstructuren de retrieval optimaliseren. De VectorStoreIndex is de meestgebruikte keuze voor semantisch zoeken.
Query-engines orkestreren retrieval en generatie, terwijl routers agent-achtige besluitvorming introduceren door de meest geschikte databron voor een gegeven query te selecteren.
CrewAI is ontworpen rond samenwerking. In plaats van één agent laat het meerdere agents met verschillende rollen samenwerken.
De focus ligt op “Crews”: een gedefinieerde set agents. Elke agent krijgt een persona, doel en achtergrondverhaal, wat het gedrag vormgeeft.
Taken definiëren wat er moet gebeuren en hoe succes eruitziet. Je definieert hoe een individuele taak eruitziet, geeft parameters mee, de verwachte output, en welke agents aan die taak moeten werken.
Processen bepalen hoe taken worden uitgevoerd: sequentieel, hiërarchisch of via orchestrator-workerpatronen waarbij een primaire agent complexe taken dynamisch opdeelt, vergelijkbaar met menselijke teams.
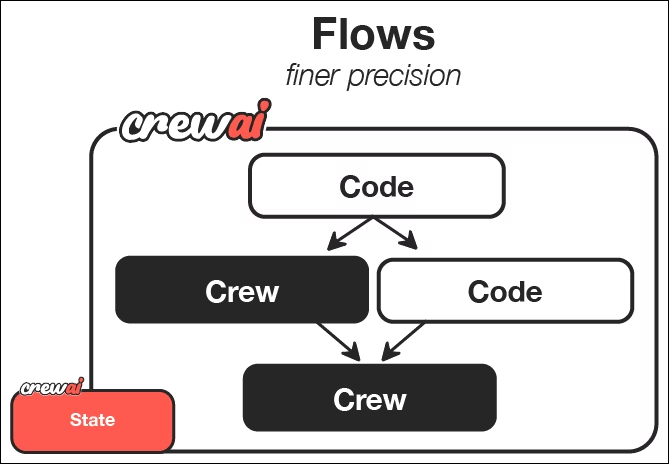
Uit de CrewAI-documentatie blijkt dat flows een manier bieden om crews te orkestreren en te triggeren. Elke crew gebruikt LLM-agents met gedefinieerde rollen en taken om specifiek werk te doen en gewenste uitkomsten te creëren.
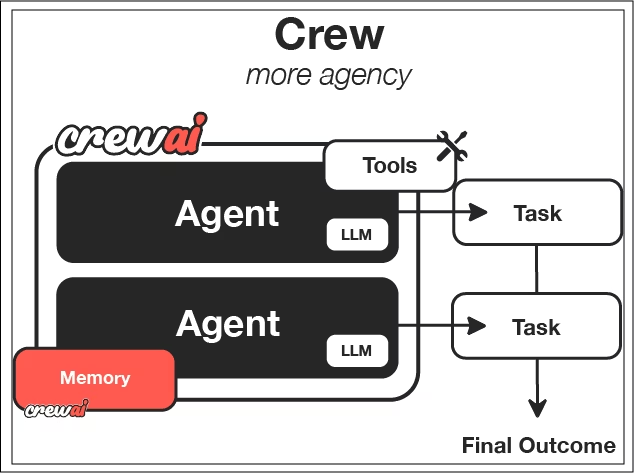
De keuze voor een framework hangt af van je probleemdomein en randvoorwaarden. Elk van de gepresenteerde frameworks heeft zijn eigen sterke punten:
Houd rekening met je datacomplexiteit, het vereiste autoniveau en operationele beperkingen. Er is geen universeel juiste keuze.
Ter ondersteuning van je besluitvorming kun je ook onze artikelen raadplegen waarin LangChain wordt vergeleken met LlamaIndex en respectievelijk CrewAI met LangGraph.
De use-cases voor LLM-agents zijn in feite eindeloos en alleen beperkt door je verbeelding.
Moderne code-assistenten gebruiken agentische workflows om wijzigingen te plannen, uit te voeren en te verifiëren. Ze kunnen een codebase verkennen, oplossingen genereren, tests draaien en iteratief fouten herstellen.
Zo integreert Cursor naadloos in je IDE en helpt je regels afmaken of wijzigingen in pipelines herstellen met gevolgen stroomafwaarts. Claude Code kan je helpen bij het schrijven van tests, complete scripts maken of inconsistenties in je code door een repo heen beoordelen. Met GitHub Copilot kun je helpen bij het schrijven van pull requests en het testen van code als onderdeel van een request-workflow.
Hierdoor verschuift de rol van de ontwikkelaar van elke regel schrijven naar het superviseren en sturen van intelligente systemen. Voor dataprofessionals kan dit experimenteren en prototyping aanzienlijk versnellen.
Ik raad je aan de cursus Software Development with GitHub Copilot te volgen als je aan de slag wilt met LLM-gestuurde code-assistenten.
Agentische BI-systemen stellen gebruikers in staat vragen in natuurlijke taal te stellen en bruikbare inzichten te krijgen. De agent kan vragen naar SQL vertalen, queries uitvoeren en resultaten toelichten.
Je kunt met je data praten zoals je met een senior teamlid zou doen en realtime nieuwe inzichten en visualisaties krijgen. Dit vermindert de afhankelijkheid van dashboards en maakt verkennende analyse mogelijk voor niet-technische teamleden.
Onderzoeksagents automatiseren informatieverzameling en -synthese. Ze doorzoeken het web, halen bronnen op en vatten bevindingen samen; sommige systemen hebben eenvoudige filters voor bronkwaliteit. Ze kunnen zelfs interne documentatie op sites als Notion of berichten binnen Slack bekijken.
Met toegang tot al deze informatiebronnen kunnen LLM-agents niet alleen snel informatie synthetiseren, maar ook volledige documenten en samenvattingen genereren die teams snel kunnen delen.
Dit is vooral waardevol in snel veranderende domeinen waar statische datasets snel verouderen. Agents leveren continu ververste inzichten.
Voor meer ideeën over hoe mensen AI-agents gebruiken, bekijk onze gids met de Top 10 AI Agent Projects.
Hoewel agentische workflows geweldig en zeer krachtig zijn, brengen ze ook uitdagingen met zich mee. Agents kunnen stappen hallucineren, tool-uitvoer verkeerd interpreteren of in lange of onbedoelde lussen terechtkomen. Guardrails, validatie en observeerbaarheid zijn cruciaal voor productiesystemen.
Elke agentactie vereist vaak een LLM-call. Complexe taken kunnen tientallen calls omvatten, wat de latency en API-kosten verhoogt. Daarnaast betaal je mogelijk voor extra infrastructuur zoals cloudopslag, cloudcomputing en andere kosten om de LLM-agent te ondersteunen.
Autonome systemen zijn lastiger te debuggen dan deterministische code. Begrijpen waarom een agent een beslissing nam, vereist het traceren van status, geheugen en redeneerstappen.
Afhankelijk van het framework dat je gebruikt kan dit bijzonder uitdagend zijn. Sommige frameworks, zoals CrewAI, abstraheren veel dieper vanwege de extra complexiteit, in tegenstelling tot een eenvoudiger framework als LangChain, dat zich richt op het vereenvoudigen van toegang tot je LLM’s.
We gaan van geïsoleerde chatbots naar volledig agentische workflows die kunnen redeneren, plannen en handelen. Hoewel het nog vroeg is, verandert dit paradigma nu al hoe datasystemen worden gebouwd en gebruikt.
Voor aankomende dataprofessionals geeft kennis van LLM-agents vandaag je morgen een sterke voorsprong. Deze systemen vertegenwoordigen de toekomst van intelligente automatisering.
Ga oefenen en bouw deze LLM-agents met onze cursus Designing Agentic Systems with LangChain!
LLM-agentcursussen
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

