
Programma
Nozioni di base sugli agenti AI
6 ore
Gli agenti AI autonomi sono sistemi potenti, e proprio questa potenza può renderli pericolosi.
OpenClaw e framework di agenti simili vanno oltre la semplice generazione di testo. Eseguono codice, modificano file, chiamano API e interagiscono direttamente con altri sistemi. Questo significa che c’è un passaggio dal "pensare" all’"agire" che cambia radicalmente il modello di sicurezza.
Ogni errore può avere conseguenze reali. Qualsiasi azione di sistema eseguita da OpenClaw assomiglia più a servizi backend con veri privilegi operativi che a una semplice interfaccia conversazionale.
In questa guida tratterò gli aspetti di sicurezza dell’esecuzione di OpenClaw e le best practice per assicurarti che il tuo deployment tenga conto dei potenziali rischi.
Se non conosci ancora i concetti alla base di strumenti come OpenClaw, ti consiglio il nostro corso Introduzione agli agenti AI.
OpenClaw (precedentemente noto come Clawdbot e brevemente Moltbot) è un framework open-source per agenti autonomi che collega un large language model (LLM) a un set di strumenti eseguibili. Questi strumenti possono includere:
A differenza di un semplice chatbot che restituisce solo testo, OpenClaw consente al modello di compiere azioni reali nel tuo ambiente. In pratica, è più vicino a un motore di automazione o a un’utilità DevOps che a un assistente conversazionale di base.
Il rischio principale deriva direttamente da questa capacità: il testo è generalmente innocuo, le azioni no.
Le azioni eseguite da un agente possono includere:
Se l’agente è influenzato da input malevoli o prompt strutturati male, tali azioni possono produrre conseguenze indesiderate. Semplici salvaguardie per LLM come il filtro per parole chiave o la moderazione delle risposte non sono sufficienti in questo contesto.
Un attacco di prompt injection, ad esempio, potrebbe indurre il modello a recuperare file sensibili o a usare in modo improprio un token API.
Se stai valutando framework alternativi a OpenClaw, consulta la nostra guida comparativa qui.
Vediamo più da vicino cosa si può fare per migliorare la sicurezza del tuo deployment.
Per iniziare, dovresti sempre assicurarti di avere chiarezza sulla tua istanza OpenClaw. Senza una chiara comprensione di cosa esiste e a cosa può accedere, una protezione efficace è impossibile.
Prima di modificare le regole del firewall o le impostazioni del container, prenditi il tempo per mappare l’ambiente attuale. Molti incidenti di sicurezza non derivano da exploit avanzati, ma da server di test dimenticati o credenziali troppo permissive lasciate in circolazione.
Inizia identificando ogni istanza in esecuzione di OpenClaw:
È in realtà comune scoprire server cloud dimenticati, container esposti con -p 0.0.0.0:3000:3000 o tunnel temporanei come Ngrok mai chiusi. Questi setup sperimentali spesso sopravvivono allo scopo per cui erano stati creati e non dovrebbero restare attivi.
Quindi dovresti identificare i tuoi "gioielli della corona". Sono gli asset sensibili a cui l’agente può accedere, come:
Ogni credenziale dovrebbe essere valutata per ambito e privilegi. Ad esempio, l’accesso a livello di amministratore comporta un rischio molto maggiore rispetto all’accesso in sola lettura. Avere un quadro chiaro di questi privilegi aiuta a quantificare i potenziali danni.
Una domanda utile da porti è: “Se l’agente fosse completamente compromesso oggi, cosa potrebbe realisticamente accadere?”
Anche i rischi immediati dovrebbero essere documentati, tra cui:
Documentare questi riscontri stabilisce una baseline e rende misurabili i miglioramenti.
Una buona pratica per deployment più strutturati è adottare un modello a livelli di sicurezza.
Un modello a livelli offre struttura e chiarezza. Anche se non ogni deployment richiede controlli di livello enterprise, ogni deployment dovrebbe essere categorizzato intenzionalmente.
Ecco i 3 livelli principali:
Questo livello è adatto a sperimentazione e ambienti di apprendimento in cui non sono coinvolti dati sensibili.
A questo livello, l’agente può interagire con repository condivisi o API interne, richiedendo barriere di protezione più solide.
Questo livello è pensato per ambienti che gestiscono dati regolamentati o operazioni finanziarie.
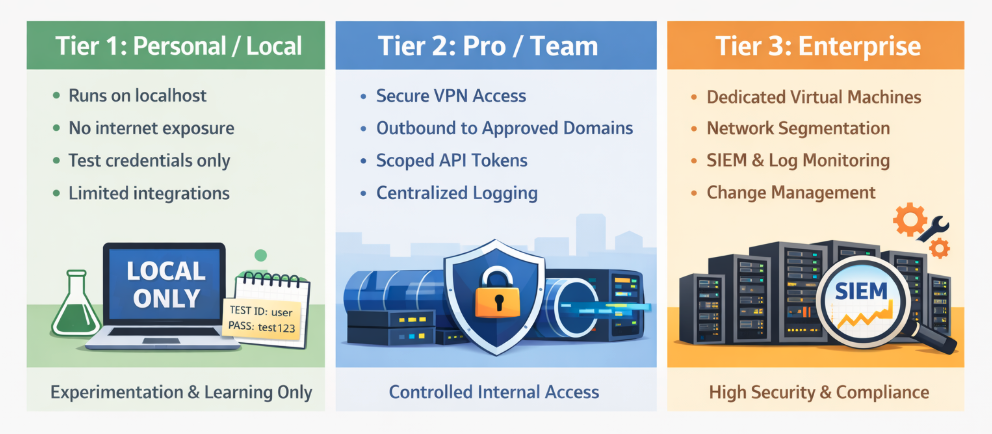
La chiave non è impostare di default il livello più alto, ma capire chiaramente quale livello si applica e perché.
Un ambiente di staging o “laboratorio sicuro” offre uno spazio in cui testare modifiche alla sicurezza senza mettere a rischio i sistemi di produzione. Dovrebbe essere un banco di prova semplice in cui qualsiasi modifica non avrebbe conseguenze nel mondo reale.
Tuttavia, questo ambiente dovrebbe rispecchiare l’architettura di produzione, pur utilizzando credenziali sandbox o fittizie. Ad esempio, account cloud di test, API mock e sandbox email interne consentono test realistici senza rischi nel mondo reale.
È consigliata anche una procedura documentata di “break glass”. Una procedura di “break glass” è un piano di ripristino che spiega come recuperare l’accesso se regole del firewall o restrizioni del container bloccano accidentalmente gli amministratori.
Se un agente è raggiungibile dall’esterno, può essere preso di mira. Per questo devi gestire l’accesso in ingresso. Sarà il tuo primo livello visibile di difesa.
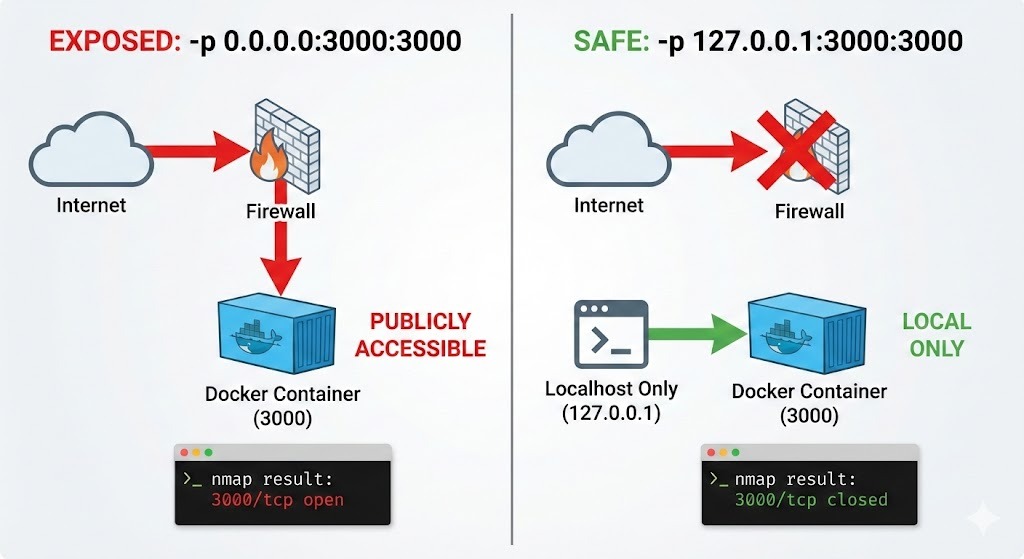
La configurazione predefinita più sicura associa l’applicazione all’IP di localhost 127.0.0.1, rendendola accessibile solo dalla macchina locale.
app.listen(3000, "127.0.0.1");Inoltre, è importante effettuare delle verifiche. Una scansione delle porte da un altro dispositivo usando nmap dovrebbe confermare che nessuna porta è esposta.
sudo nmap -p- -sS <target_IP>Tieni anche presente che Docker può bypassare UFW su host Linux o altri firewall dell’host perché manipola direttamente le regole di rete.
Quando pubblichi una porta con -p 0.0.0.0:3000:3000, Docker potrebbe esporla anche se il firewall dell’host sembra bloccarla. In altre parole, affidarsi solo ai firewall non basta quando è coinvolto Docker.
Un modo rapido per verificare cosa sta effettivamente esponendo Docker è controllare le porte pubblicate:
docker port <container_name>
Look for 0.0.0.0:3000->3000/tcp (exposed publicly) versus 127.0.0.1:3000->3000/tcp (localhost-only).
Linux users can also inspect active Docker iptables rules:
```bash
sudo iptables -L DOCKER -n -v
Se vedi binding 0.0.0.0:PORT o regole ACCEPT nella catena DOCKER, quella porta è raggiungibile esternamente a meno che non sia esplicitamente ristretta.
Puoi anche confermare dall’esterno da un’altra macchina usando nmap:
nmap -p 3000 <target_IP>Questo comando scansiona il tuo target dall’esterno per confermare che la porta 3000 sia effettivamente chiusa/filtrata, dimostrando l’assenza di accesso esterno.
La best practice è associare esplicitamente a localhost (127.0.0.1) nel comando Docker run:
docker run -p 127.0.0.1:3000:3000 openclawPoi conferma sia con docker port che con una scansione nmap esterna da un’altra macchina.
Quando l’accesso remoto è necessario, esporre l’applicazione direttamente a internet è raramente giustificato.
Una VPN come Tailscale o WireGuard può essere usata per stabilire connettività crittografata e autenticata tra dispositivi fidati. Questo approccio riduce drasticamente l’esposizione rispetto a lasciare porte aperte.
Dove è richiesto l’accesso via browser, un reverse proxy come Nginx può terminare le connessioni HTTPS e imporre l’autenticazione prima che il traffico raggiunga l’applicazione.
La gestione delle sessioni richiede particolare attenzione. Controlli deboli sulle sessioni possono vanificare difese perimetrali altrimenti solide.
Password robuste, rotazione regolare delle credenziali e rate limiting sugli endpoint di login aiutano a difendersi dagli attacchi brute-force. Durate brevi delle sessioni riducono anche l’utilità dei token rubati.
Cookie sicuri, attributi SameSite e protezioni CSRF restano rilevanti anche quando il backend è un agente AI. L’infrastruttura web circostante deve essere indurita come qualsiasi altra applicazione.
Anche con controlli perimetrali solidi, la possibilità di uso improprio rimane. Strategie di contenimento e isolamento saranno molto utili per determinare fin dove può estendersi un incidente.
Eseguire il container come utente non root riduce l’impatto di potenziali vulnerabilità di escape.
Anche le capacità Linux non necessarie andrebbero rimosse per ridurre la superficie d’attacco. I container spesso girano con più privilegi del necessario e rimuovere capacità inutilizzate limita ciò che un attaccante può fare.
Ognuna di queste misure rafforza la stessa idea: anche se l’agente si comporta male, non dovrebbe poter controllare il sistema host.
Di seguito un semplice esempio di docker run che mostra la sintassi per impostare un utente non root, rimuovere specifiche capacità Linux e montare il filesystem in sola lettura.
docker run \
  --name openclaw-secure \
  --user 1000:1000 \
  --read-only \
  --cap-drop=CAP_SYS_ADMIN \
  --cap-drop=CAP_NET_RAW \
  -v openclaw-workspace:/app/workspace \
  -p 127.0.0.1:3000:3000 \
  openclaw:latest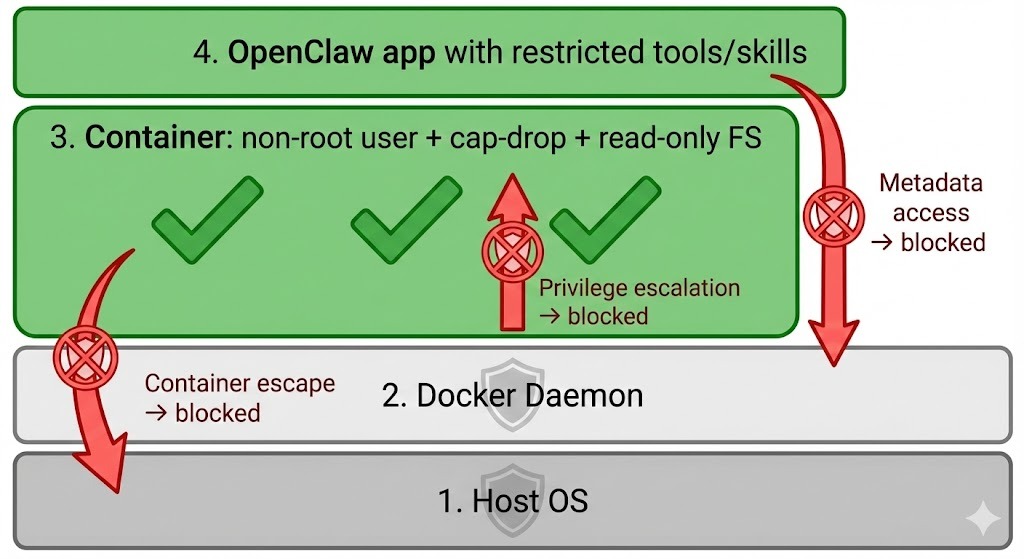
Per i team che usano Docker Compose valgono gli stessi principi. Un docker-compose.yml minimale e indurito potrebbe apparire così:
version: "3.9"

services:
  openclaw:
    image: openclaw:latest
    user: "1000:1000"
    read_only: true
    cap_drop:
      - CAP_SYS_ADMIN
      - CAP_NET_RAW
    ports:
      - "127.0.0.1:3000:3000"
    volumes:
      - openclaw-workspace:/app/workspace

volumes:
  openclaw-workspace:
Un chiarimento importante è che queste restrizioni sulle capacità Linux restano obbligatorie anche quando si esegue Docker su macOS o Windows. Sebbene questi sistemi non siano Linux, Docker Desktop esegue i container all’interno di una macchina virtuale Linux nascosta.
In altre parole, usare macOS o Windows non elimina la necessità di indurire i container.
Il filtraggio in uscita è spesso trascurato, eppure è cruciale. Incidenti gravi, come l’esfiltrazione di dati, avvengono proprio attraverso canali in uscita.
Una policy predefinita "nega tutto" in uscita obbliga gli amministratori a consentire esplicitamente i domini approvati. Limitare il traffico agli endpoint necessari, come provider di API e servizi interni, riduce drasticamente questo rischio.
Bloccare l’accesso ai servizi di metadati del cloud previene anche l’esposizione accidentale delle credenziali di istanza.
Le istanze Linux nel cloud (AWS/GCP/Azure) espongono credenziali temporanee tramite l’IP link-local 169.254.169.254. OpenClaw potrebbe interrogare accidentalmente questo endpoint e far trapelare metadati dell’istanza. Puoi eliminare esplicitamente il traffico in uscita verso l’IP dei metadati:
sudo iptables -A OUTPUT -d 169.254.169.254 -j DROPPer verificare, esegui quanto segue:
sudo iptables -L -n -vQuesto assicura che, anche se l’agente prova a raggiungere il servizio di metadati, il traffico non lasci mai l’host.
Se vuoi limitare la regola specificamente al traffico Docker, puoi bloccarla nella catena DOCKER-USER (che è valutata prima delle regole di Docker):
sudo iptables -I DOCKER-USER -d 169.254.169.254 -j DROPQuesto approccio è spesso più sicuro perché Docker modifica dinamicamente le regole di iptables. La catena DOCKER-USER è progettata specificamente per restrizioni definite dall’utente.
Puoi confermare che la regola è attiva con:
sudo iptables -L DOCKER-USER -n -vDirectory sensibili dell’host come ~/.ssh o /etc non dovrebbero mai essere montate se non strettamente necessario.
Dovrebbero anche essere usati container effimeri per fornire un ulteriore livello di protezione.
Agiscono come un container nuovo per ogni attività e vengono distrutti al termine. Questo rende molto più difficile la persistenza a lungo termine. Ambienti temporanei come questi riducono la capacità di un attaccante di stabilire un punto d’appoggio.
Ogni strumento aggiuntivo amplia le capacità. Tuttavia, con queste capacità aggiuntive aumenta anche il rischio.
I secret dovrebbero essere iniettati a runtime tramite variabili d’ambiente o un sistema di gestione dei secret. Incorporare credenziali nel codice sorgente, nei prompt o nelle immagini dei container creerebbe un’esposizione non necessaria.
Audit periodici delle integrazioni collegate possono anche aiutare a garantire che le credenziali non utilizzate vengano rimosse. Credenziali senza uno scopo aumentano solo la superficie d’attacco.
Gli agenti autonomi possono essere ampliati tramite skill e componenti aggiuntivi. Con questa espansione arriva un rischio aggiuntivo. Mettere in sicurezza la supply chain delle skill significa trattare le estensioni di terze parti con la stessa cautela che applicheresti alle dipendenze di produzione in un’applicazione backend.
Consentire l’aggiornamento automatico dei plugin senza controllo introduce rischi di supply chain.
In questo scenario, una nuova release potrebbe introdurre involontariamente vulnerabilità o, nel peggiore dei casi, un pacchetto compromesso potrebbe includere comportamenti malevoli.
Per ridurre questo rischio, dovrai fissare le skill a versioni specifiche e, dove possibile, a hash esatti.
Ad esempio:
"web-browser-skill": "1.4.2#sha256:abc123"Il pinning assicura che il codice testato in staging sia esattamente quello in esecuzione in produzione. Evita upgrade silenziosi e riduce le probabilità di avvelenamento della supply chain tramite hijacking delle dipendenze o aggiornamenti malevoli.
Questo approccio rispecchia le best practice nello sviluppo software, dove i sistemi di produzione bloccano le versioni delle dipendenze per evitare comportamenti inattesi.
Prima di abilitare una nuova skill, dovresti prenderti il tempo di rivederne il codice sorgente. Gli agenti autonomi spesso operano con token API, accesso ai file o permessi di rete.
Se il codice sorgente della skill è scritto male, un plugin malevolo può abusare silenziosamente di tali privilegi.
Presta particolare attenzione a comportamenti come:
Anche uno strumento di navigazione apparentemente innocuo potrebbe esfiltrare dati se include chiamate di rete nascoste. Una rapida revisione del codice può far emergere segnali d’allarme evidenti e ridurre significativamente il rischio.
Molti framework di agenti includono diversi strumenti integrati, come accesso alla shell, esecuzione Python, editor di file o browser web. Sebbene la flessibilità sia utile in fase di sperimentazione, i deployment in produzione dovrebbero essere ridotti al minimo indispensabile.
Ogni strumento abilitato rappresenta una capacità che potrebbe essere abusata. Rimuovere gli strumenti non necessari riduce la superficie d’attacco e limita ciò che l’agente può fare in caso di compromissione.
I sistemi di AI introducono rischi comportamentali nuovi e unici, diversi dalle vulnerabilità del software tradizionale. Vediamo alcuni dei potenziali rischi e le soluzioni associate a OpenClaw.
Poiché OpenClaw dipende dal prompt engineering per il suo output, i contenuti esterni dovrebbero essere sempre trattati come input non affidabile. Ad esempio, pagine web, email e documenti possono contenere istruzioni nascoste progettate per influenzare il modello. Questo può portare a esiti malevoli.
La prompt injection sfrutta la natura del modello di seguire istruzioni. Commenti HTML nascosti o testi accuratamente elaborati possono tentare di ignorare le regole di sistema o estrarre dati sensibili.
Possiamo adottare alcune misure difensive per prevenirla, tra cui:
Pulire la memoria tra attività non correlate può anche ridurre ulteriormente le probabilità di fuoriuscite involontarie di dati.
Per deployment di lungo periodo, hai bisogno di maggiore osservabilità e monitoraggio per assicurarti che i modelli si comportino come previsto.
Un logging completo dovrebbe catturare prompt, output del modello, chiamate agli strumenti, modifiche ai file e interazioni con le API. Uno storage centralizzato dei log aiuterebbe anche a prevenire manomissioni e supportare l’indagine sugli incidenti.
Consiglierei qualche forma di alert per comportamenti insoliti (come traffico in uscita inatteso o accesso a file di sistema) per abilitare tempi di risposta più rapidi.
Dato che la sicurezza non è una configurazione una tantum, dovresti anche considerare di aggiornare OpenClaw all’ultima versione quando necessario.
OpenClaw offre un grande potenziale per il deployment locale di LLM. Poiché la maggior parte gira su macchine locali, la sicurezza della tua macchina è importante.
Di conseguenza, un deployment di OpenClaw indurito dovrebbe rimanere inaccessibile da internet pubblica, operare in un runtime con restrizioni, usare credenziali con ambito ristretto e mantenere un logging completo.
Per applicarlo in prima persona, ti propongo di determinare il tuo livello specifico e lavorare di conseguenza sulle misure di sicurezza.
Vuoi esplorare di più sulle ultime tecnologie di AI, LLM e agenti? La nostra track AI Agent Fundamentals è il modo migliore per iniziare.
Corsi di AI
Programma
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



