
Last chance! 50% off DataCamp Premium
Sale ends in
Als je jezelf vaak betrapt op het handmatig beheren van terugkerende taken, weet je dat het niet alleen saai is — het is ook een recept voor gemiste deadlines en inconsistente datapijplijnen.
Cronjobs zijn dé oplossing om repetitieve taken op Unix-gebaseerde systemen te automatiseren. Ze laten je commando's of scripts plannen om op specifieke intervallen te draaien. Door het eenvoudige en flexibele planningssysteem van cron te gebruiken, kun je alles automatiseren van basisgegevensverzameling tot complexe ETL-workflows die anders constante handmatige interventie vereisen. Het opzetten van deze geautomatiseerde processen elimineert menselijke fouten en zorgt ervoor dat je datapijplijnen consistent en betrouwbaar draaien.
Cronjobs onder de knie krijgen is essentieel voor elke data engineer die in Unix-omgevingen werkt. Alleen al de mogelijkheid om geautomatiseerde taken te plannen en te beheren verbetert je workflow enorm en verlaagt de onderhoudslast.
In deze complete gids laat ik je alles zien wat je moet weten over cronjobs voor data engineering — van basisinstellingen tot geavanceerde use-cases en best practices.
>Helemaal nieuw in Data Engineering? Onze cursus ontrafelt de buzzwords en legt de concepten uit.
Een cronjob is een tijdgestuurde scheduler in Unix-besturingssystemen waarmee je automatisch commando's kunt uitvoeren op vaste tijden, datums of intervallen.
Zie cron als je persoonlijke assistent die taken precies uitvoert wanneer jij wilt, zonder handmatige tussenkomst. Voor data engineers betekent dit dat je databaseback-ups, gegevensoverdrachten, rapportgeneratie en meer kunt automatiseren.
Cronjobs staan in een eenvoudig tekstbestand genaamd de "crontab" (cron table). Elke regel in dit bestand vertegenwoordigt een geplande taak en volgt een specifiek formaat met zes componenten:
* * * * * command-to-execute
│ │ │ │ │
│ │ │ │ └─── Day of week (0-6, where 0 is Sunday)
│ │ │ └───── Month (1-12)
│ │ └─────── Day of month (1-31)
│ └───────── Hour (0-23)
└─────────── Minute (0-59)
De eerste vijf velden vertellen cron precies wanneer je commando moet draaien. Je kunt specifieke waarden, bereiken (zoals 1-5), lijsten (zoals 1, 3, 5) of sterretjes (*) gebruiken, wat "elke" tijdseenheid betekent. De zesde component is het daadwerkelijke commando dat je wilt uitvoeren.
Als je bijvoorbeeld elke dag om middernacht een Python-script wilt draaien om data uit een API te halen, ziet je cronjob er zo uit:
0 0 * * * /usr/bin/python3 /home/username/scripts/extract_data.pyDit vertelt cron om je script uit te voeren op 0 minuten, 0 uur (middernacht), elke dag van de maand, elke maand en elke dag van de week. Het absolute pad naar zowel de Python-interpreter als je script zorgt ervoor dat de job correct draait, ongeacht de omgeving.
Je kunt ook complexere schema's maken. Stel dat je elke maandag, woensdag en vrijdag om 15:30 uur een database-opschoning wilt draaien, dan ziet je cron-expressie er zo uit:
30 15 * * 1,3,5 /path/to/cleanup_script.shElk sterretje fungeert als een wildcard en laat je flexibele schema's maken die precies bij je behoeften passen. Je kunt zelfs speciale snelkoppelingen gebruiken zoals @daily, @weekly of @monthly om veelvoorkomende planningspatronen leesbaarder te maken.
Dat was het voor de basis. Straks laat ik je hands-on zien hoe je met cronjobs werkt voor data-engineeringtaken.
Nu je weet wat cronjobs zijn, gaan we je eerste geautomatiseerde taak instellen. Het proces is eenvoudig en vereist slechts een paar commando's om te starten.
Om cronjobs te maken of te wijzigen, moet je toegang hebben tot je crontab. Dat kan met het commando crontab -e:
crontab -e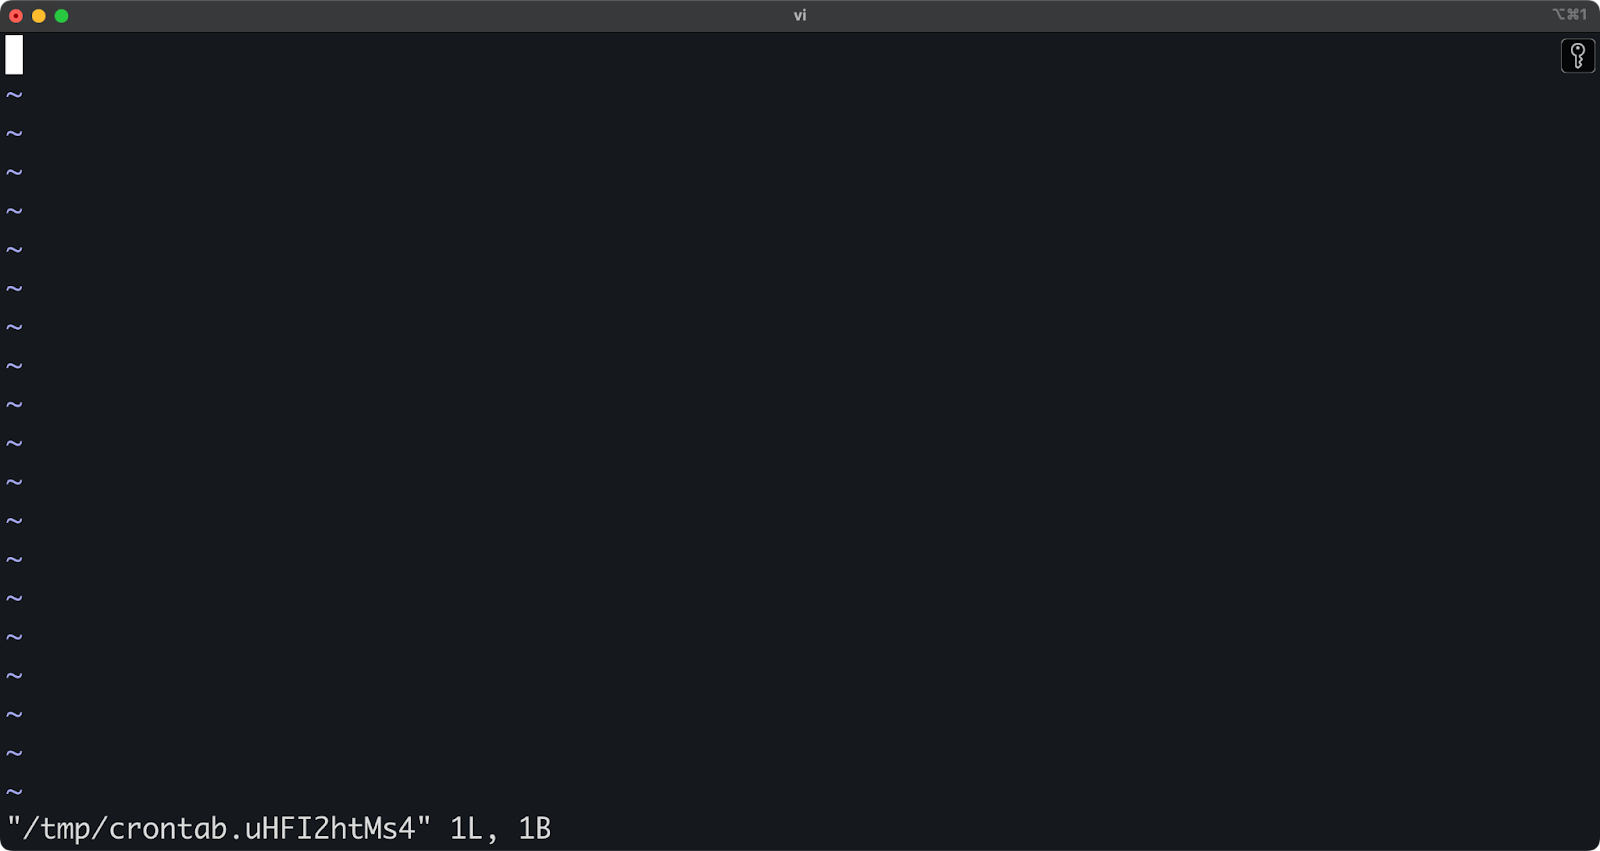
Afbeelding 1 - Een crontab-bestand bewerken
Bovenstaand commando opent een vi-teksteditor waarin je geplande taken kunt toevoegen, bewerken of verwijderen.
Je crontab kan leeg zijn als je hem nog nooit hebt gebruikt. Om een nieuwe cronjob toe te voegen, voeg je gewoon een nieuwe regel toe volgens de eerder uitgelegde cron-syntax. Elke regel moet zowel het tijdschema als het uit te voeren commando bevatten.
Om bijvoorbeeld een script elke dag om 3:00 uur 's ochtends te draaien, voeg je deze regel toe:
0 3 * * * /path/to/your/commandSla het bestand op en sluit de editor. Cron installeert automatisch je nieuwe crontab en start je jobs op de gespecificeerde tijden.
Laten we beginnen met een praktisch voorbeeld: een Python-script plannen dat gegevens uit een API haalt elke minuut. Hier is een compleet Python-script dat verbinding maakt met het REST API-endpoint, objectgegevens ophaalt en opslaat in een CSV-bestand — zorg er alleen voor dat je Python-interpreter de pakketten requests en pandas geïnstalleerd heeft:
# fetch_api_data.py

import requests
import pandas as pd
import os
from datetime import datetime

# Create a timestamp for the filename
timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")

# Set file paths - CHANGE THIS
data_dir = "/Users/dradecic/Desktop/cron/data"
output_file = f"{data_dir}/objects_{timestamp}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)

# Fetch data from the API
try:
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame([
                {
                    "id": row.get("id", ""),
                    "user_id": row.get("userId", ""),
                    "title": row.get("title", ""),
                    "body": row.get("body", "")
                } for row in data
            ])

            df.to_csv(output_file, index=False)

            print(f"Data successfully saved to {output_file}")
        else:
            print("API returned empty data")
    else:
        print(f"API request failed with status code: {response.status_code}")
except Exception as e:
    print(f"Error occurred: {str(e)}")
Plan dit script nu met cron om elke dag om 2:00 uur 's ochtends te draaien:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py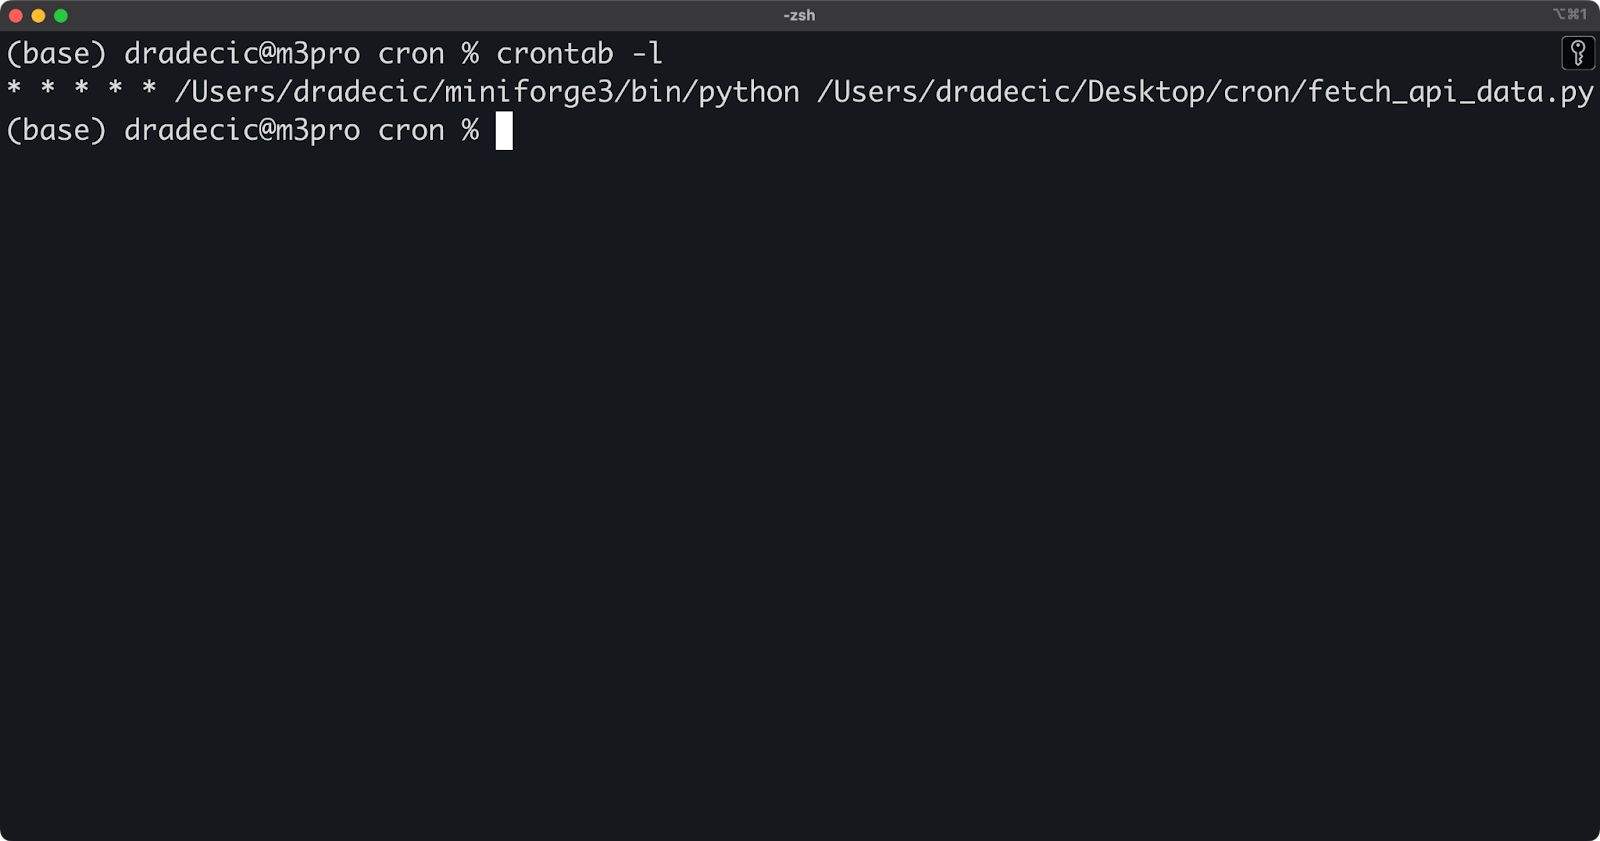
Afbeelding 2 - Actieve crontabs weergeven
Deze regel vertelt cron om je Python-script elke minuut van elke dag te draaien. Gebruik absolute paden voor zowel de Python-interpreter (/Users/dradecic/miniforge3/bin/python in mijn geval) als je script (/Users/dradecic/Desktop/cron/fetch_api_data.py in mijn geval).
Waarom absolute paden? Cron draait met een beperkte omgeving, dus het kent je shell-PATH-variabele of je huidige map niet. Je job kan mislukken zonder absolute paden omdat cron de commando's of bestanden die je wilt gebruiken niet kan vinden.
Terwijl je dit las, zijn er een paar CSV-bestanden opgeslagen in mijn map data, wat aangeeft dat deze cronjob werkt zoals bedoeld:
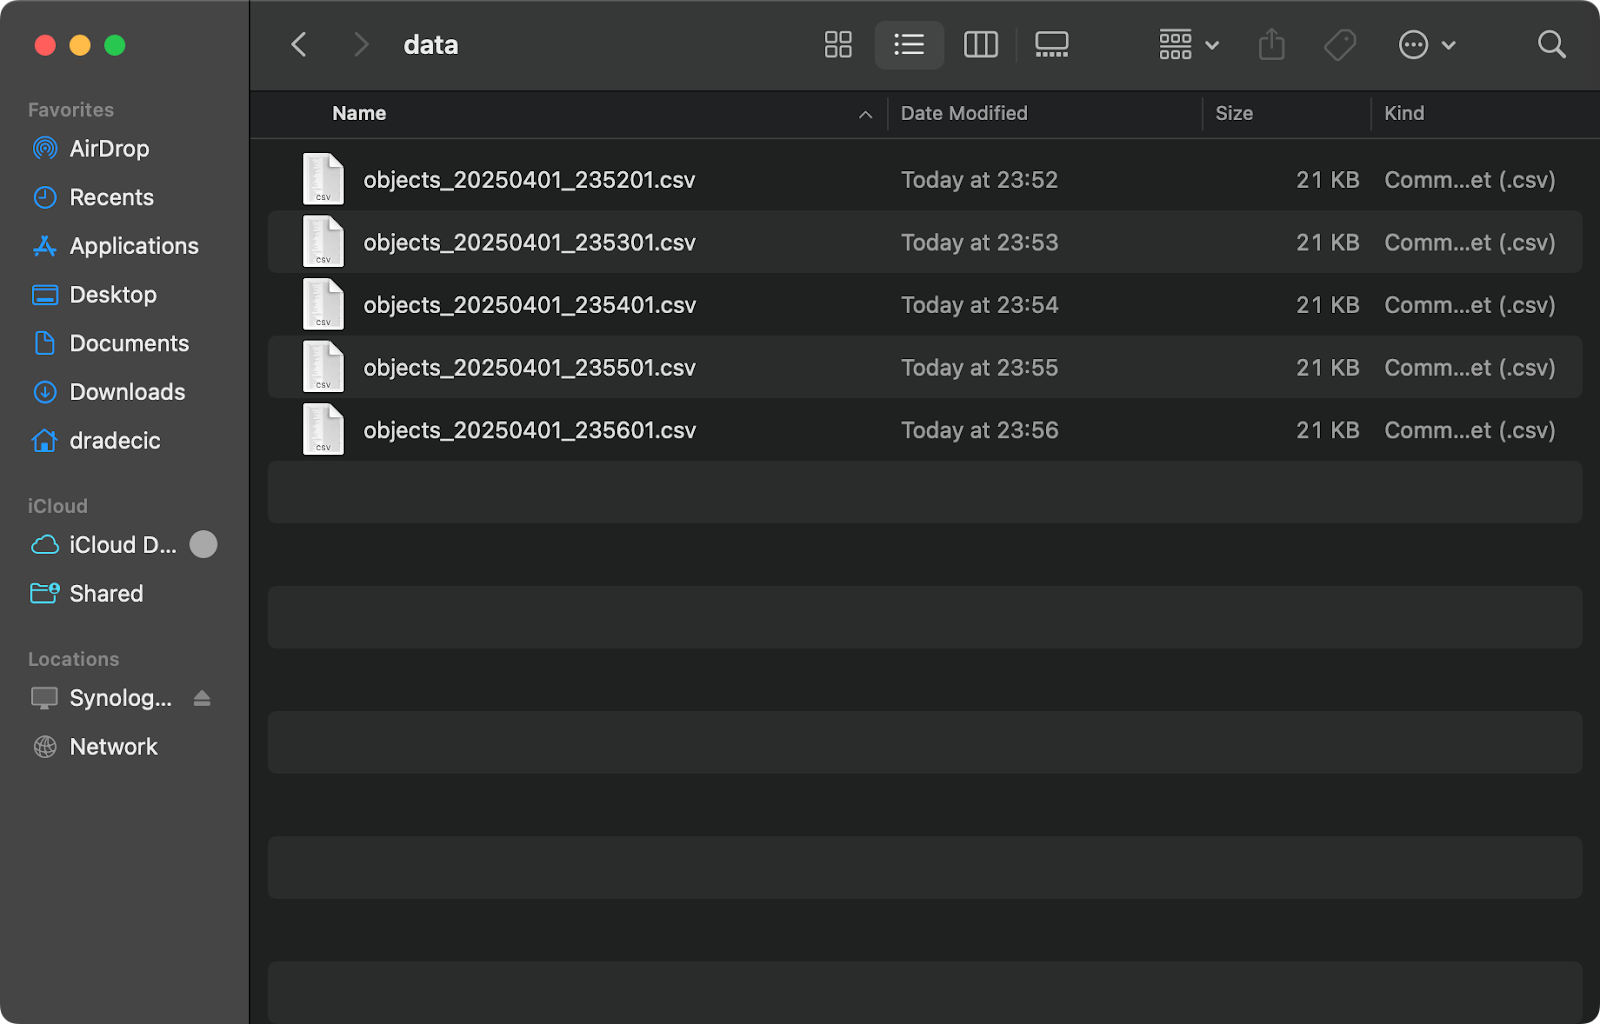
Afbeelding 3 - Opgeslagen CSV-bestanden
Voor complexere data-engineeringworkflows zoals ETL (Extract, Transform, Load)-jobs kun je cron gebruiken om meerstapsprocessen te plannen. Een gangbare aanpak is om een shellscript te maken dat al je ETL-stappen bevat en dat script vervolgens met cron te plannen.
Om het simpel te houden is de code in het onderstaande .sh-script theoretisch en maakt die geen verbinding met gegevensbronnen:
#!/bin/bash
# etl_pipeline.sh

# Extract data from source
/usr/bin/psql -U username -d source_db -c "COPY (SELECT * FROM source_table) TO '/tmp/extracted_data.csv' WITH CSV HEADER;"

# Transform data
/usr/bin/python3 /home/username/scripts/transform_data.py

# Load data into target
/usr/bin/psql -U username -d target_db -c "\COPY target_table FROM '/tmp/transformed_data.csv' WITH CSV HEADER;"

# Log completion
echo "ETL job completed at $(date)" >> /home/username/logs/etl_job.log
Als dat geregeld is, wil je je shellscript uitvoerbaar maken:
chmod +x /home/username/scripts/etl_pipeline.shPlan het tot slot met cron om bijvoorbeeld elke werkdag om 1:00 uur 's ochtends te draaien:
0 1 * * 1-5 /home/username/scripts/etl_pipeline.shAls data engineer biedt het plannen van ETL-taken met cron deze voordelen:
Voor grotere ETL-processen wil je mogelijk foutafhandeling toevoegen aan je scripts:
#!/bin/bash
# etl_pipeline.sh

# Set error handling
set -e  # Exit immediately if any command fails

# Execute ETL steps
# ...

# If we get here, all steps succeeded
echo "ETL job completed successfully at $(date)" >> /home/username/logs/etl_job.log
En dat is het! Je ETL-pijplijn draait automatisch op de geplande tijden, verwerkt je data en logt de status voor monitoring.
Zodra je cronjobs hebt ingesteld, moet je ze beheren en monitoren om te zorgen dat ze draaien zoals verwacht.
Daarmee bedoel ik: controleren welke jobs momenteel gepland staan, verouderde jobs verwijderen en hun uitvoering monitoren. In deze sectie laat ik je essentiële commando's en technieken zien om je cronjobs zonder gedoe te onderhouden.
Gebruik het commando crontab -l om al je momenteel geplande cronjobs te zien:
crontab -lBovenstaand commando toont de inhoud van je huidige crontab-bestand, met alle geplande jobs, inclusief timing en commando's. Het is een snelle manier om te verifiëren welke jobs actief zijn zonder de bewerkingsmodus in te gaan.
Zo ziet je output eruit als je de vorige sectie hebt gevolgd:
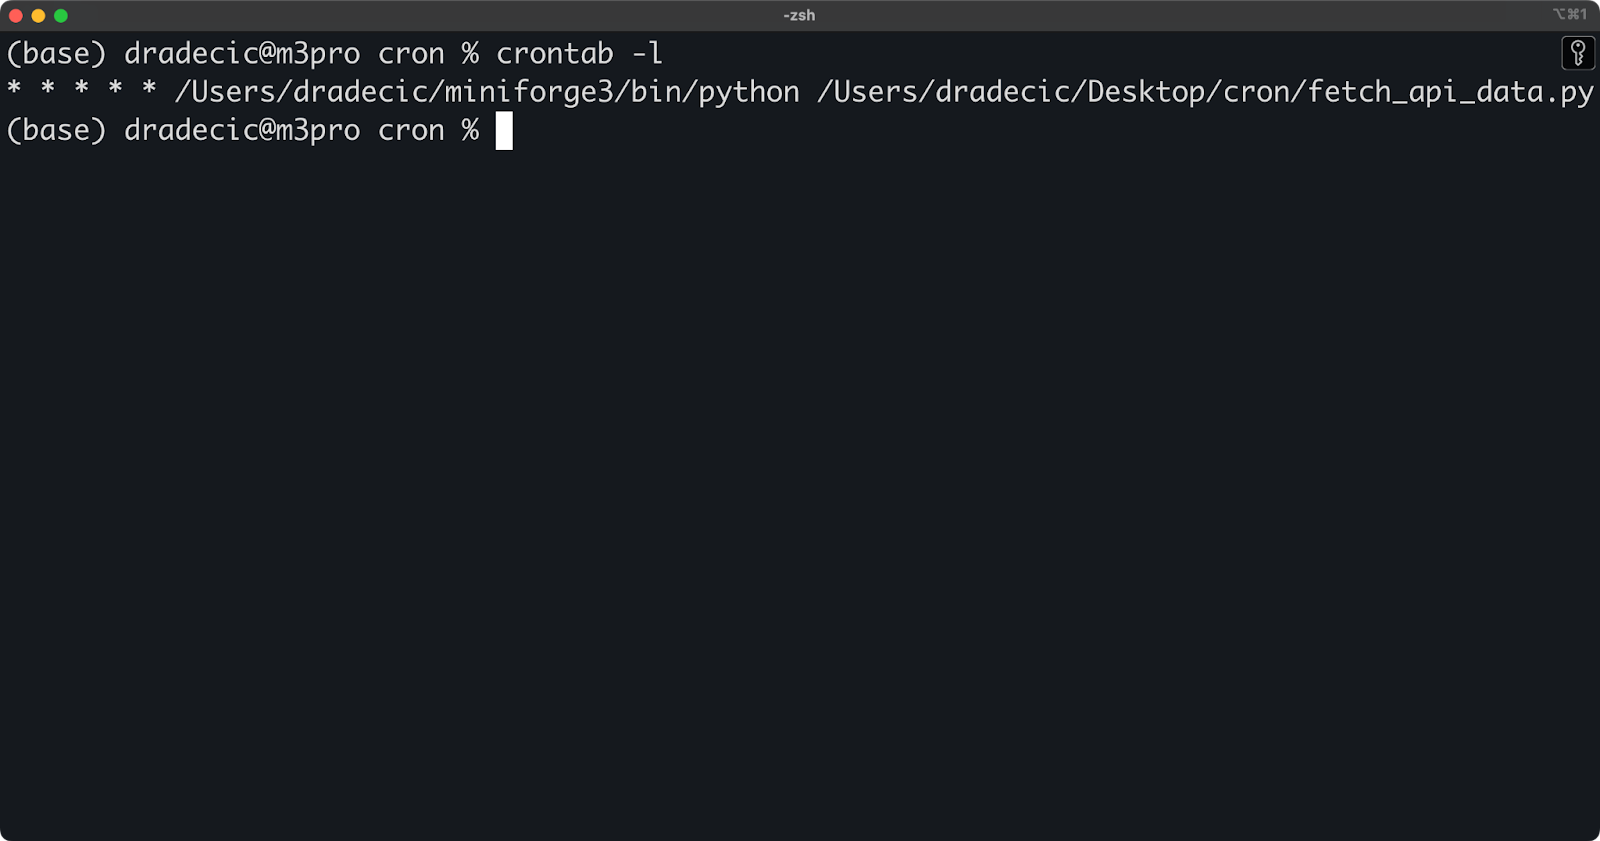
Afbeelding 4 - Actieve cronjobs
Als je cronjobs voor een andere gebruiker wilt controleren (root-toegang vereist), draai dan in plaats daarvan dit commando:
sudo crontab -u username -lEr zijn meerdere manieren om cronjobs te verwijderen of uit te schakelen wanneer ze niet langer nodig zijn. Om een specifieke job te verwijderen, open je crontab in de bewerkingsmodus en verwijder je de betreffende regel:
crontab -eOm een job tijdelijk uit te schakelen zonder te verwijderen, zet je een # aan het begin van de regel om deze te becommentariëren:
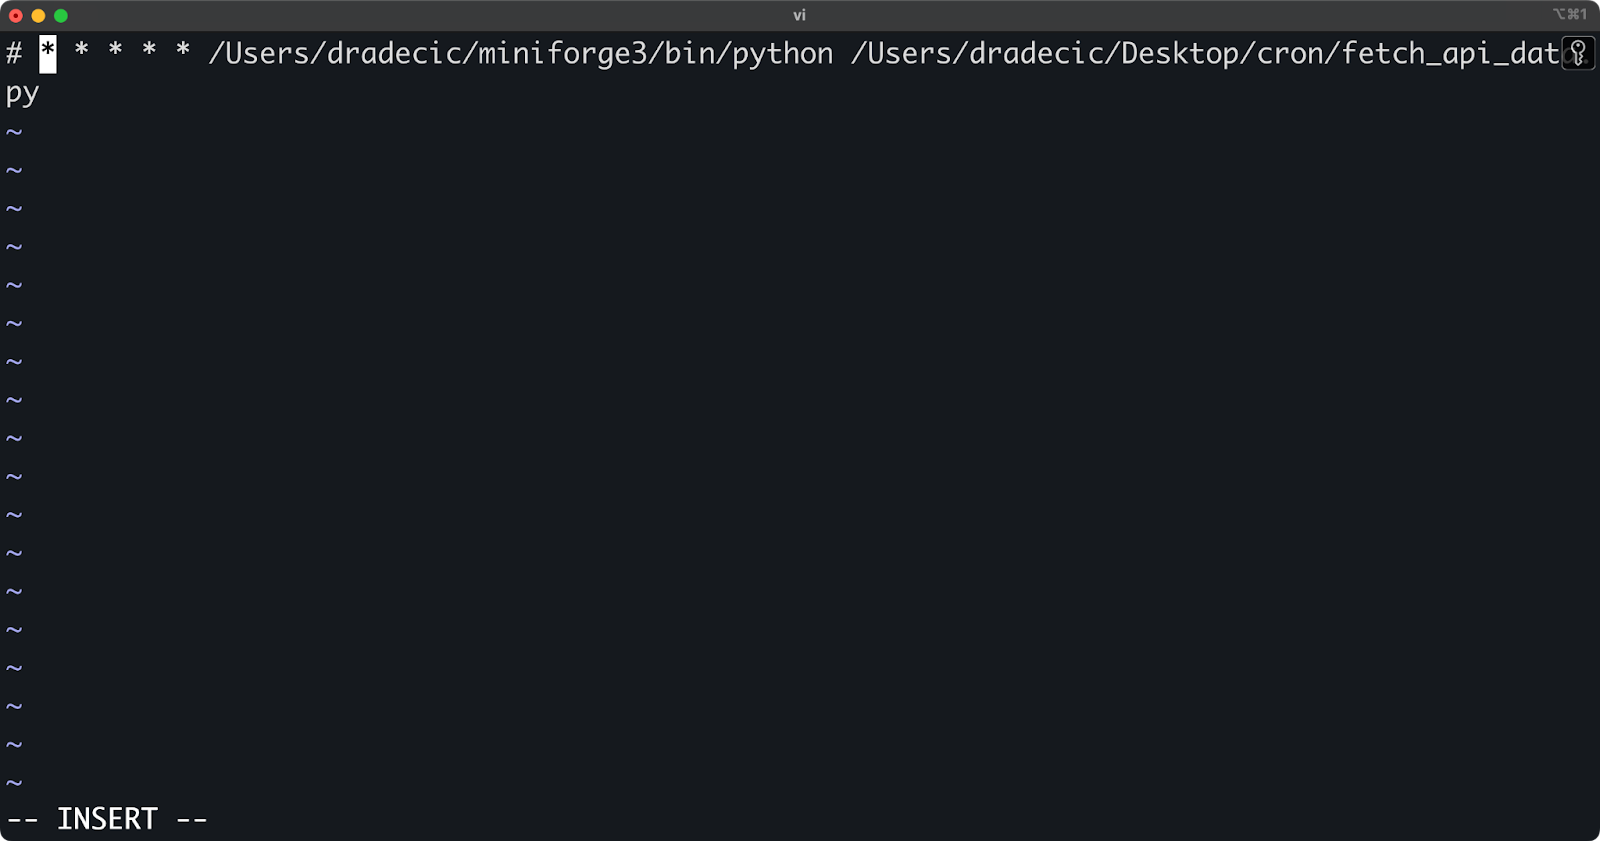
Afbeelding 5 - Een cronjob tijdelijk uitschakelen
De becommentarieerde job blijft in je crontab voor later naslag, maar wordt niet uitgevoerd volgens het gedefinieerde schema.
Als je je hele crontab wilt verwijderen (alle jobs), gebruik dan de optie -r:
crontab -r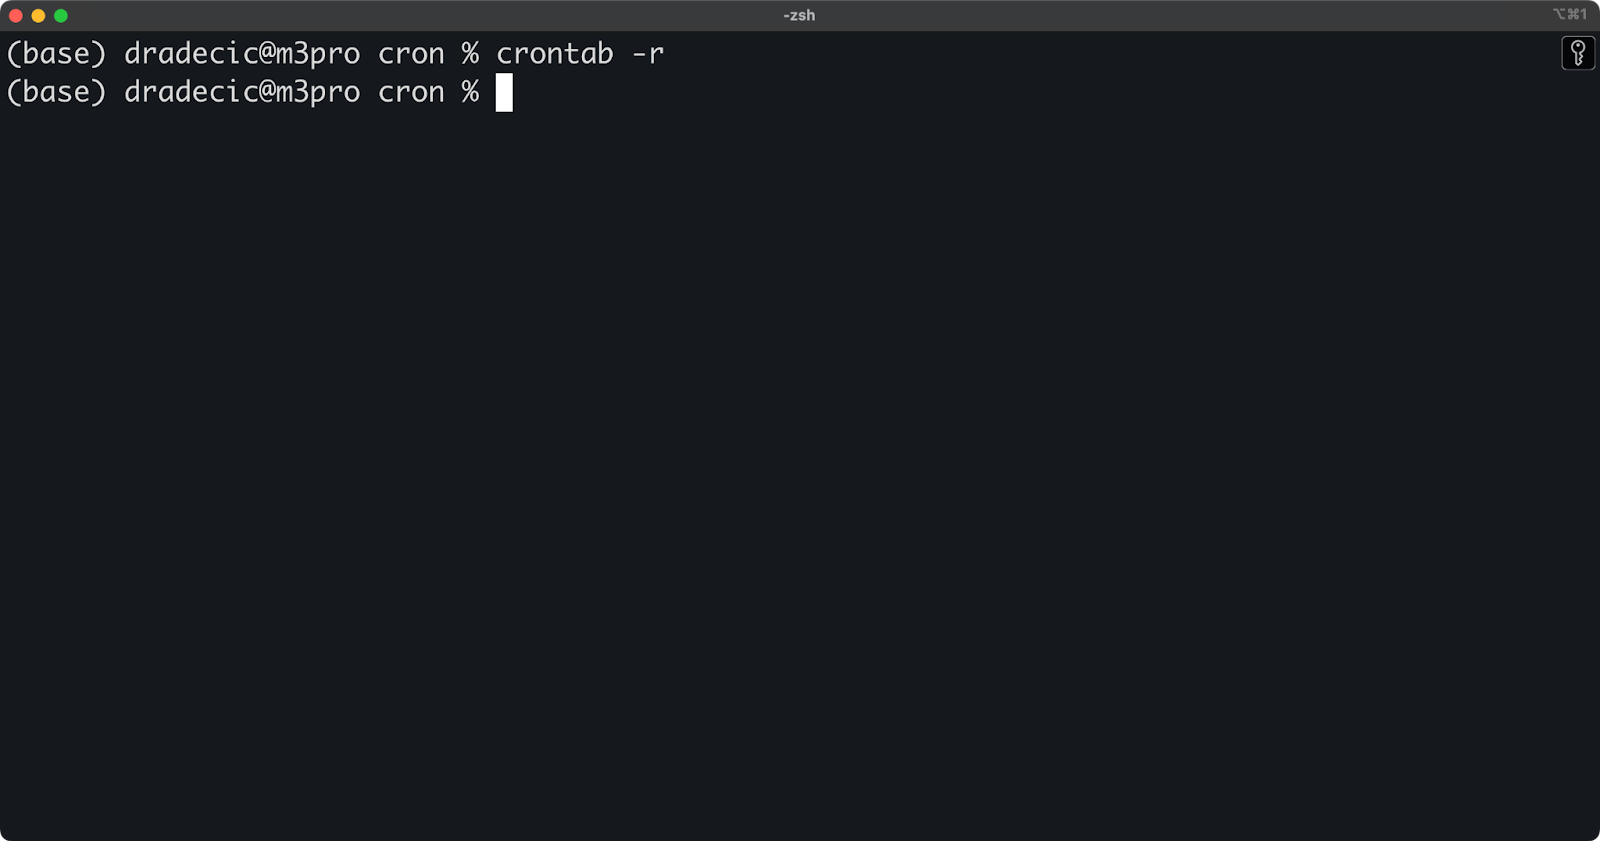
Afbeelding 6 - De hele crontab verwijderen
Wees voorzichtig met dit commando — het verwijdert al je geplande jobs zonder bevestiging. Om onbedoelde verwijdering te voorkomen, kun je eerst een back-up van je crontab maken:
crontab -l > my_crontab_backupDit slaat je huidige crontab op in een bestand dat je kunt gebruiken om je jobs te herstellen indien nodig:
crontab my_crontab_backup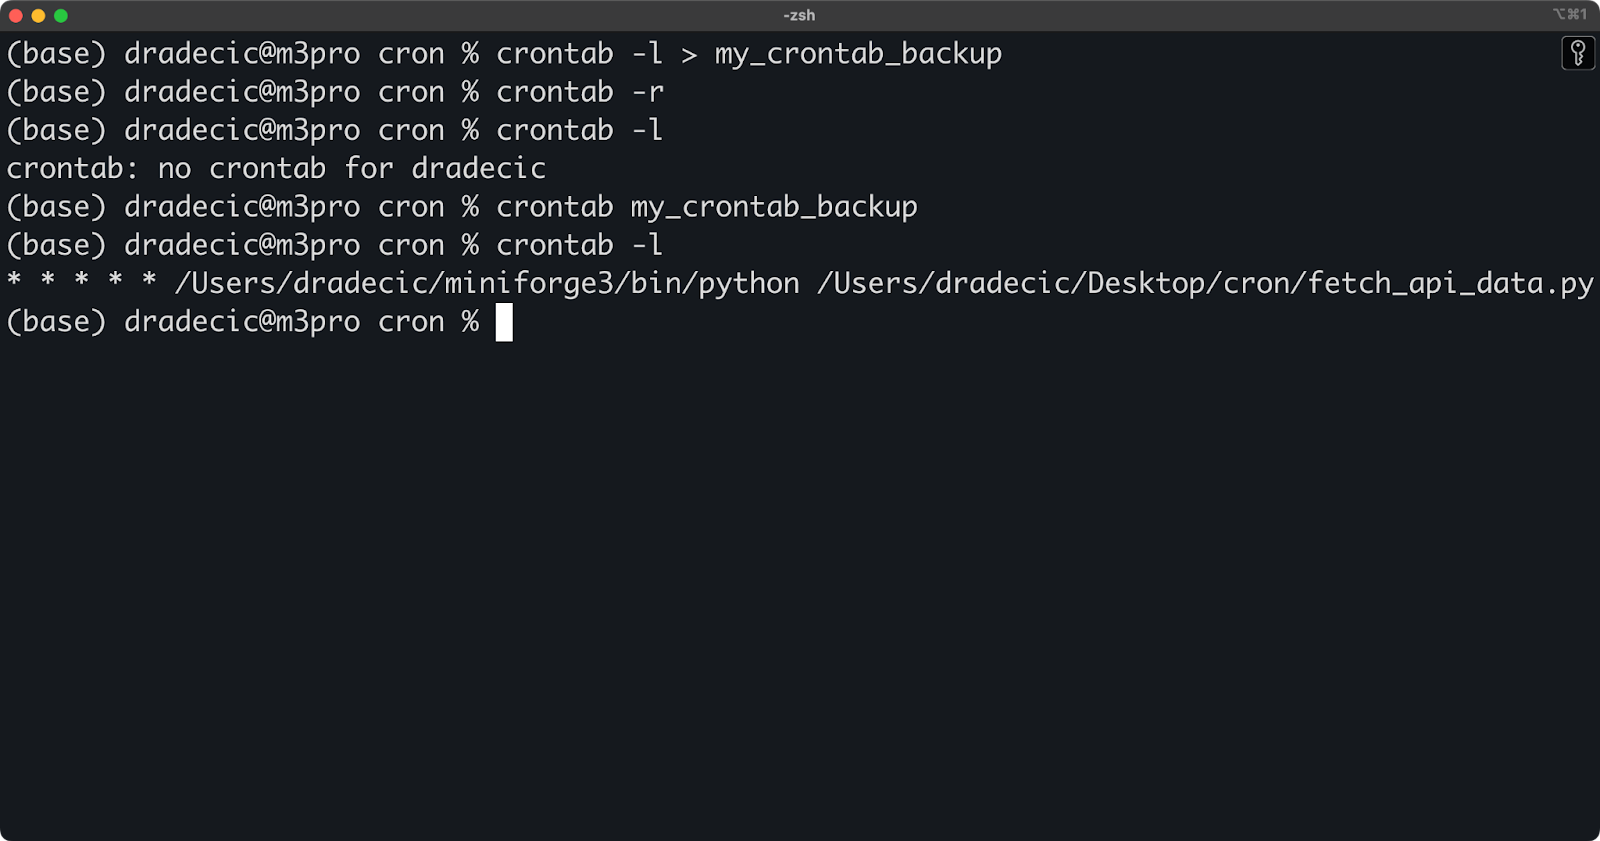
Afbeelding 7 - Een crontab herstellen vanuit een back-up
Standaard probeert cron de uitvoer van jobs te e-mailen naar de gebruiker die de crontab bezit. Dit vereist echter een correct geconfigureerd mailsysteem, wat niet altijd beschikbaar is. In plaats daarvan kun je uitvoer omleiden naar logbestanden voor eenvoudigere tracking en troubleshooting.
Om zowel standaarduitvoer als foutmeldingen vast te leggen, gebruik je deze omleidingssyntax:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1Deze omleiding lijkt in het begin misschien intimiderend, dus laat me het even uitleggen:
>> voegt uitvoer toe aan het opgegeven bestand.2>&1 leidt stderr (foutmeldingen) om naar dezelfde locatie als stdout (standaarduitvoer).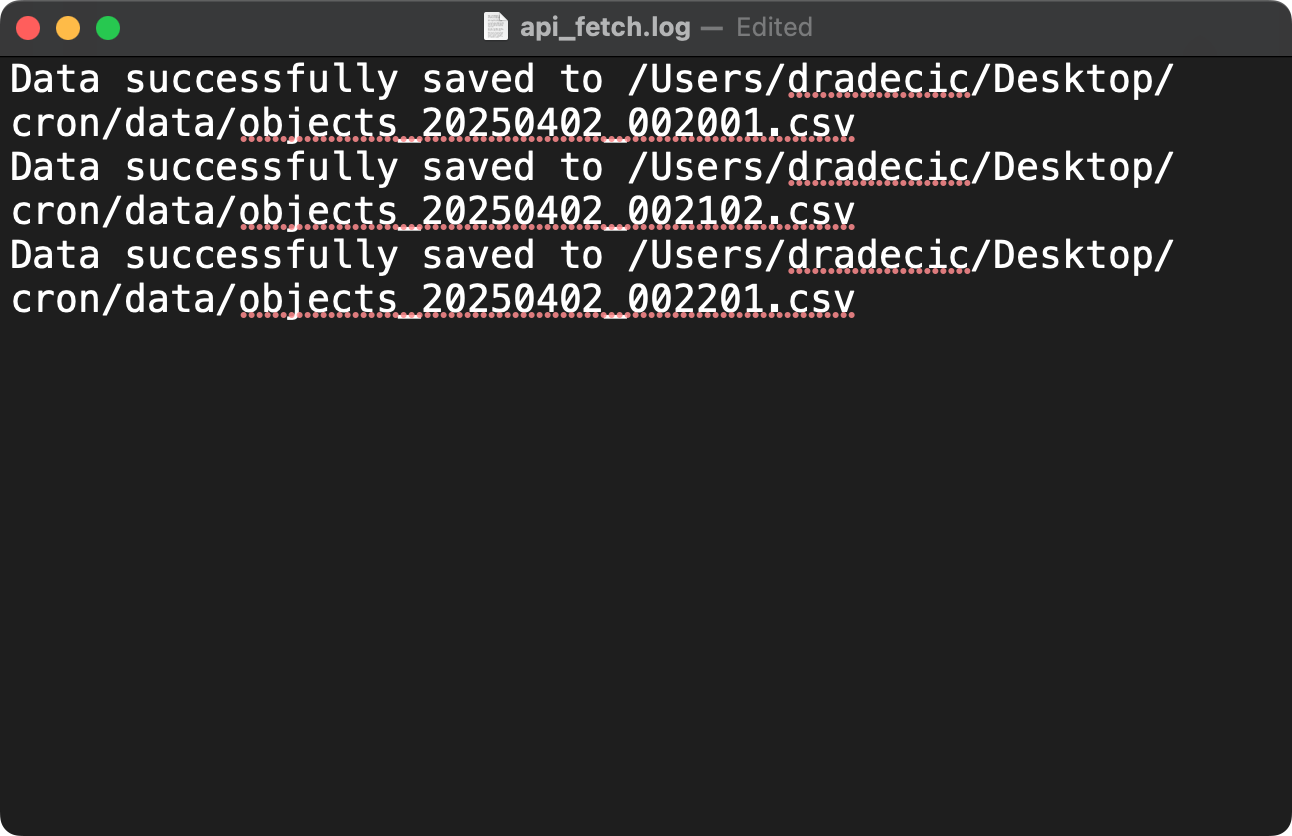
Afbeelding 8 - Logbestanden van cronjobs vastleggen
Voor betere logbeheer kun je tijdstempels toevoegen aan je logregels:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "Job completed at $(date)" >> /Users/dradecic/Desktop/cron/logs/api_fetch.log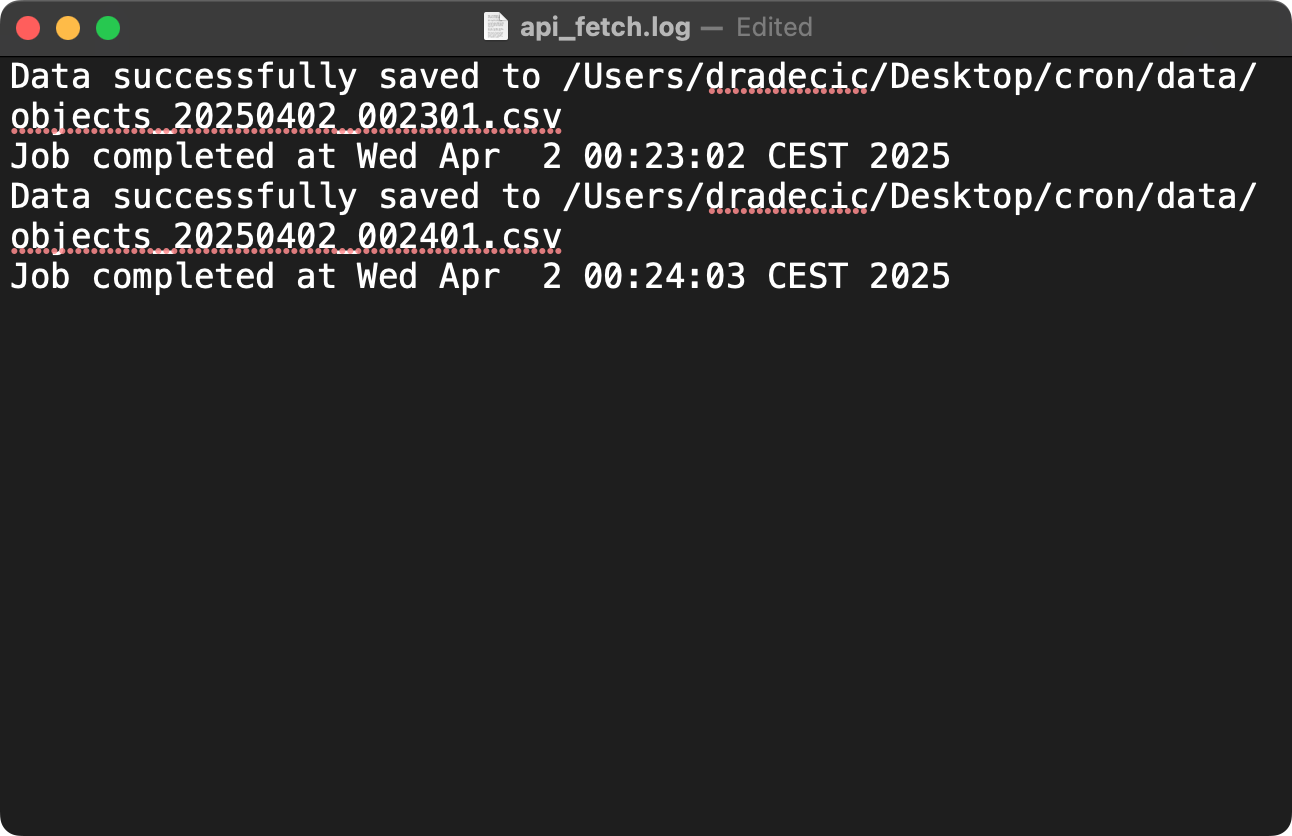
Afbeelding 9 - Cronjoblogs vastleggen met tijdstempels
Als je aparte logbestanden voor normale uitvoer en fouten wilt, gebruik dan:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>> /Users/dradecic/Desktop/cron/logs/api_fetch_errors.log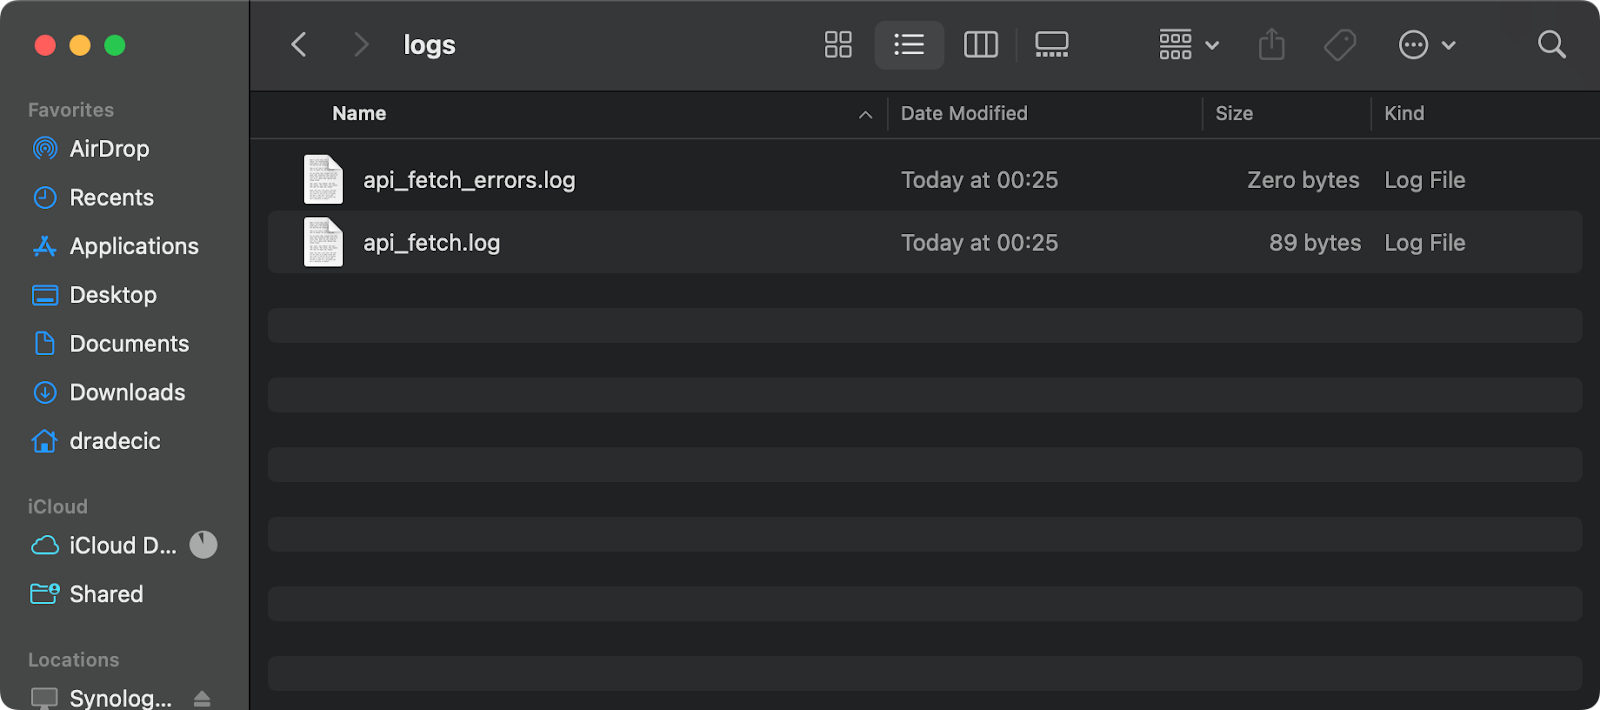
Afbeelding 10 - Cronjob-log- en foutbestanden
Voor kritieke jobs die bij falen een melding vereisen, kun je e-mailalerts instellen. Als je systeem een mailtransferagent (zoals postfix of sendmail) geïnstalleerd heeft, kun je je cronjob aanpassen om alleen een e-mail te sturen als de job faalt:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 || echo "API fetch failed on $(date)" | mail -s "Cron Job Failed" your-email@example.comDit gebruikt de operator ||, wat betekent: "voer het mail-commando alleen uit als het vorige commando faalt."
Voor e-mailnotificaties bij succes gebruik je:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/api_fetch.log 2>&1 && echo "API fetch completed successfully on $(date)" | mail -s "Cron Job Succeeded" your-email@example.comJe kunt ook geavanceerdere monitoringtools zoals Prometheus met Node Exporter of toegewijde cron-monitoringdiensten gebruiken, maar deze eenvoudige log- en e-mailtechnieken bieden voor de meeste data-engineeringbehoeften effectieve monitoring.
Tot nu toe heb je de basis cron-commando's en patronen gezien voor het vastleggen van logs en fouten. Ze zijn een goede start, maar voor productie-use-cases wil je geavanceerdere commando's en integratie met containertechnologieën verkennen.
In deze sectie zie je hoe je je cronjob-implementatie naar een hoger niveau tilt voor meer geavanceerde data-engineeringworkflows.
Je kunt meerdere commando's aan elkaar schakelen in één cronjob om complexe workflows te maken zonder aparte shellscripts nodig te hebben.
Er zijn verschillende manieren om commando's te combineren.
Je kunt puntkomma's gebruiken om commando's sequentieel te draaien ongeacht of eerdere commando's slagen:
* * * * * cd /path/to/data && python3 extract.py; python3 transform.py; python3 load.pyOf je kunt && gebruiken om commando's alleen te draaien als het vorige commando slaagt (stopt bij de eerste fout):
* * * * * cd /path/to/data && python3 extract.py && python3 transform.py && python3 load.py >> /path/to/logs/etl.log 2>&1Of kies voor || om een commando alleen te draaien als het vorige commando faalt (foutafhandeling):
* * * * * python3 /path/to/critical_job.py || python3 /path/to/send_alert.py "Critical job failed"Voor complexere ketens van commando's kun je haakjes gebruiken om commando's te groeperen:
* * * * * (cd /path/to/data && python3 extract.py && echo "Extraction complete") && (python3 transform.py && echo "Transform complete") >> /path/to/logs/etl.log 2>&1Deze aanpak werkt goed voor eenvoudigere workflows met meerdere stappen. Voor zeer complexe pipelines met veel stappen, conditionele logica of foutafhandeling is een dedicated shellscript nog steeds de betere optie.
Docker-containers zijn onmisbaar geworden in moderne data-engineeringstacks. Je kunt cron op verschillende krachtige manieren integreren met Docker om te zorgen dat je geplande taken in consistente, geïsoleerde omgevingen draaien.
Ter demonstratie pas ik het script fetch_api_data.py licht aan met aparte mappen voor het ophalen van data en logs, en wijzig ik de paden zodat het script in een containeromgeving kan werken:
# fetch_api_data.py

import requests
import pandas as pd
import os
import uuid
from datetime import datetime

# Set file paths
data_dir = "/app/data"
log_dir = "/app/logs"
output_file = f"{data_dir}/objects_{str(uuid.uuid4())}.csv"

# Make sure the data directory exists
os.makedirs(data_dir, exist_ok=True)
os.makedirs(log_dir, exist_ok=True)


def log_message(message):
    print(f"{datetime.now().isoformat()}: {message}")


# Fetch data from the API
try:
    log_message("Starting API data fetch")
    response = requests.get("https://jsonplaceholder.typicode.com/posts")
    if response.status_code == 200:
        data = response.json()

        # Check if we have data
        if data:
            df = pd.DataFrame(
                [
                    {
                        "id": row.get("id", ""),
                        "user_id": row.get("userId", ""),
                        "title": row.get("title", ""),
                        "body": row.get("body", ""),
                    }
                    for row in data
                ]
            )

            df.to_csv(output_file, index=False)

            log_message(f"Data successfully saved to {output_file}")
        else:
            log_message("API returned empty data")
    else:
        log_message(f"API request failed with status code: {response.status_code}")
except Exception as e:
    log_message(f"Error occurred: {str(e)}")
Dus zowel de opgehaalde data als de logs worden opgeslagen in de map /app/runs.
De volgende stap is een Dockerfile maken — een enkel bestand met instructies voor Docker om de container te bouwen en te draaien:
FROM python:3.12-slim

# Install cron and required packages
RUN apt-get update && apt-get -y install cron \
    && pip install requests pandas \
    && rm -rf /var/lib/apt/lists/*

# Set up directories
WORKDIR /app
RUN mkdir -p /app/runs/data /app/runs/logs

# Copy our script
COPY fetch_api_data.py /app/

# Make the script executable
RUN chmod +x /app/fetch_api_data.py

# Create the crontab file
RUN echo "* * * * * root /usr/local/bin/python /app/fetch_api_data.py >> /app/runs/logs/api_fetch.log 2>&1" | tee /etc/cron.d/api-cron
RUN chmod 0644 /etc/cron.d/api-cron

# Create a startup script
RUN echo '#!/bin/sh' > /app/start.sh && \
    echo 'mkdir -p /app/runs/logs' >> /app/start.sh && \
    echo 'touch /app/runs/logs/api_fetch.log' >> /app/start.sh && \
    echo 'tail -f /app/runs/logs/api_fetch.log &' >> /app/start.sh && \
    echo 'cron -f' >> /app/start.sh
RUN chmod +x /app/start.sh

# Set entry point
CMD ["/app/start.sh"]
Bijna klaar. Je kunt nu het volgende commando draaien om het image te bouwen en de Docker-container te starten
docker build --no-cache -t api-cron-job . && \
docker run --rm --name api-fetcher api-cron-job
Als je verbinding maakt met de container, zie je dat het Python-script elke minuut wordt uitgevoerd:
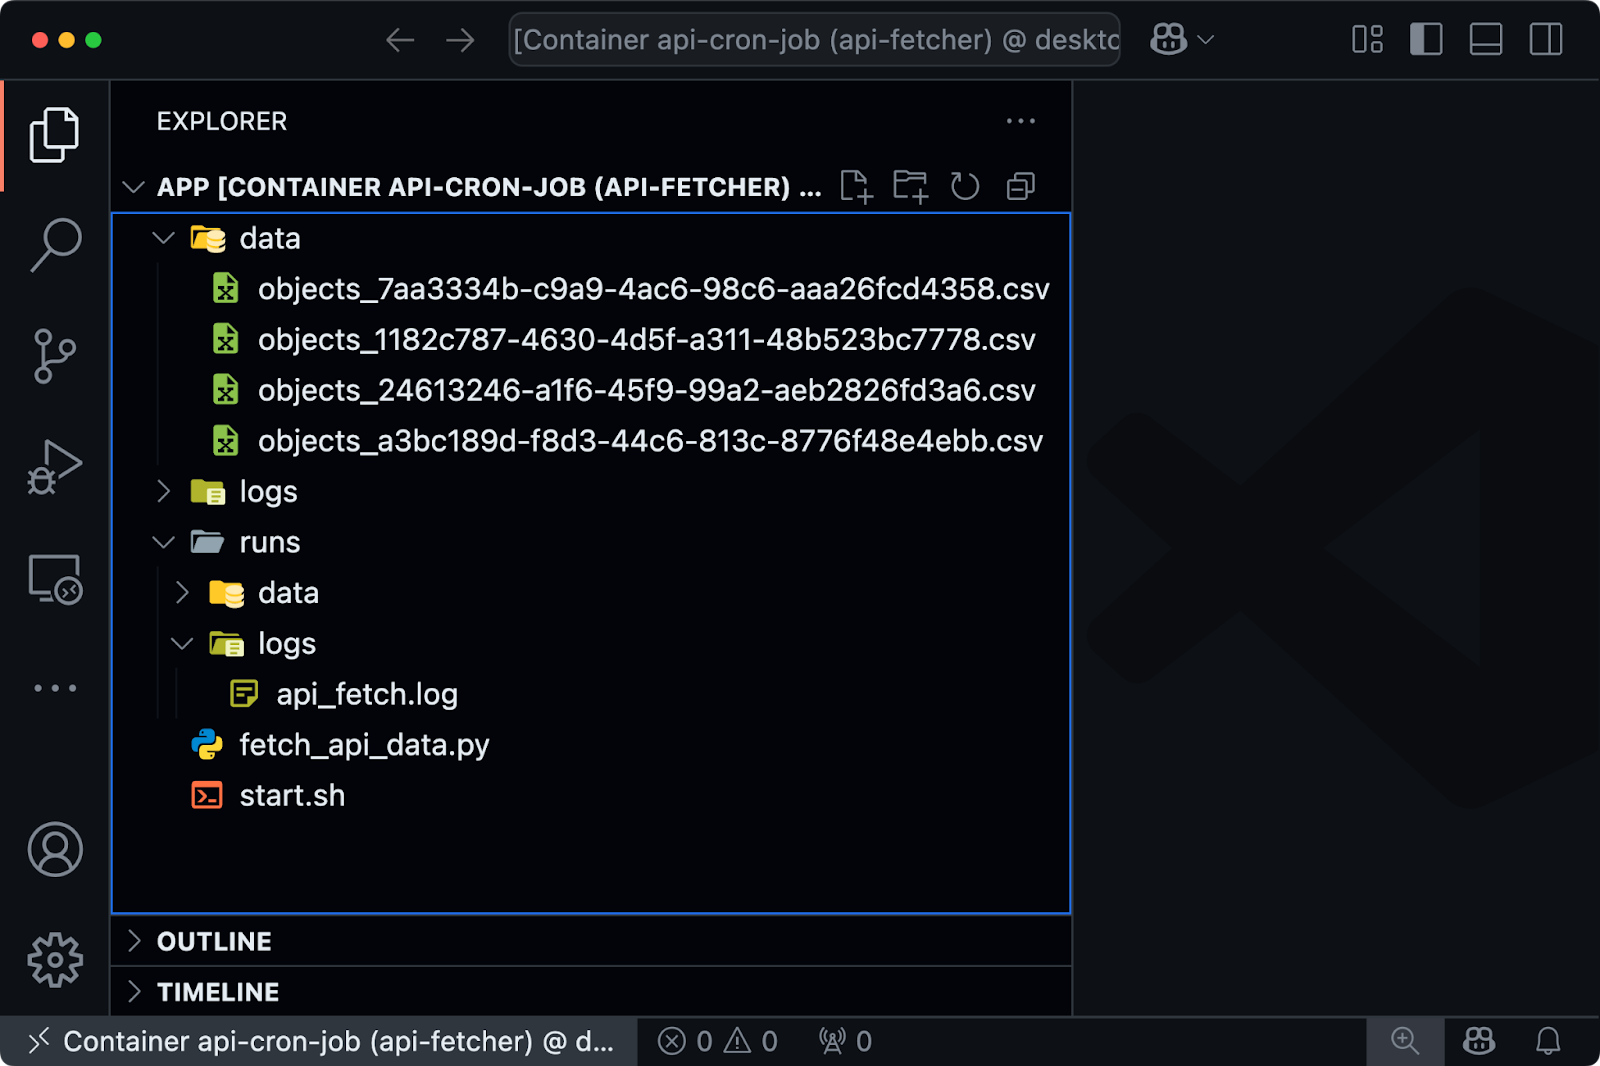
Afbeelding 11 - Cronjob die draait in een Docker-container
Ben je juist op zoek naar een manier om een data-engineeringpijplijn in een Docker-container volgens een cron-schema te draaien, laat dan het script fetch_api_data.py ongewijzigd, maar pas de Dockerfile aan:
# Use Python 3.12 slim as base image
FROM python:3.12-slim

# Install required Python packages
RUN pip install --no-cache-dir requests pandas

# Set working directory
WORKDIR /app

# Copy the script into the container
COPY fetch_api_data.py /app/

# Set execution permissions
RUN chmod +x /app/fetch_api_data.py

# Run the script
CMD ["/usr/local/bin/python", "/app/fetch_api_data.py"]
Voeg vervolgens het volgende toe aan de crontab op je systeem:
*/2 * * * * cd /path/to/root/project/folder && docker build --no-cache -t api-cron-job . && docker run --rm --name api-fetcher api-cron-jobDit triggert de build en draait de container elke 2 minuten.
Voor gedistribueerde data-engineeringworkflows moet je vaak processen uitvoeren op externe servers. Cronjobs kunnen deze externe operaties triggeren via SSH.
Je kunt bijvoorbeeld een commando als dit draaien om een cronjob op een externe server uit te voeren:
0 5 * * * ssh username@remote-server 'python3 /path/to/remote_job.py' >> /path/to/logs/remote_job.log 2>&1Zorg er voor dit soort taken voor dat SSH-sleutelgebaseerde authenticatie tussen servers is ingesteld, zodat er geen wachtwoordprompt verschijnt.
Om gegevens tussen servers op schema over te zetten, gebruik je de volgende cronjob:
0 6 * * * scp /path/to/local/data.csv username@remote-server:/path/to/destination/ >> /path/to/logs/data_transfer.log 2>&1Voor complexere externe operaties kun je SSH combineren met shellscripts:
#!/bin/bash
# remote_etl.sh

# Run extraction on the data source server
ssh username@source-server 'python3 /path/to/extract.py'

# Transfer the extracted data to the processing server
scp username@source-server:/path/to/extracted_data.csv /local/temp/

# Run transformation locally
python3 /path/to/transform.py

# Transfer the transformed data to the warehouse server
scp /local/temp/transformed_data.csv username@warehouse-server:/path/to/data/

# Trigger the load process on the warehouse server
ssh username@warehouse-server 'python3 /path/to/load.py'
En plan het vervolgens simpelweg met cron:
0 7 * * * /path/to/remote_etl.sh >> /path/to/logs/remote_etl.log 2>&1Met deze aanpak kun je multi-server datapijplijnen rechtstreeks vanuit je cronjobs orkestreren. Het werkt, maar voor zeer complexe gedistribueerde workflows kun je gespecialiseerde orkestratietools zoals Apache Airflow of Prefect overwegen.
Zelfs de best ontworpen cronjobs kunnen falen of problemen veroorzaken als ze niet met goede operationele praktijken zijn geïmplementeerd.
Als data engineer moet je ervoor zorgen dat je geplande taken betrouwbaar draaien, gracieus falen en voldoende zichtbaarheid geven voor troubleshooting. In deze sectie laat ik je zien hoe je dat aanpakt.
Logging is cruciaal voor geautomatiseerde processen die zonder direct toezicht draaien. Zonder logs wordt het bijna onmogelijk om problemen met cronjobs te diagnosticeren.
Voor basislogging kun je zowel standaarduitvoer als foutmeldingen omleiden naar logbestanden:
* * * * * /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1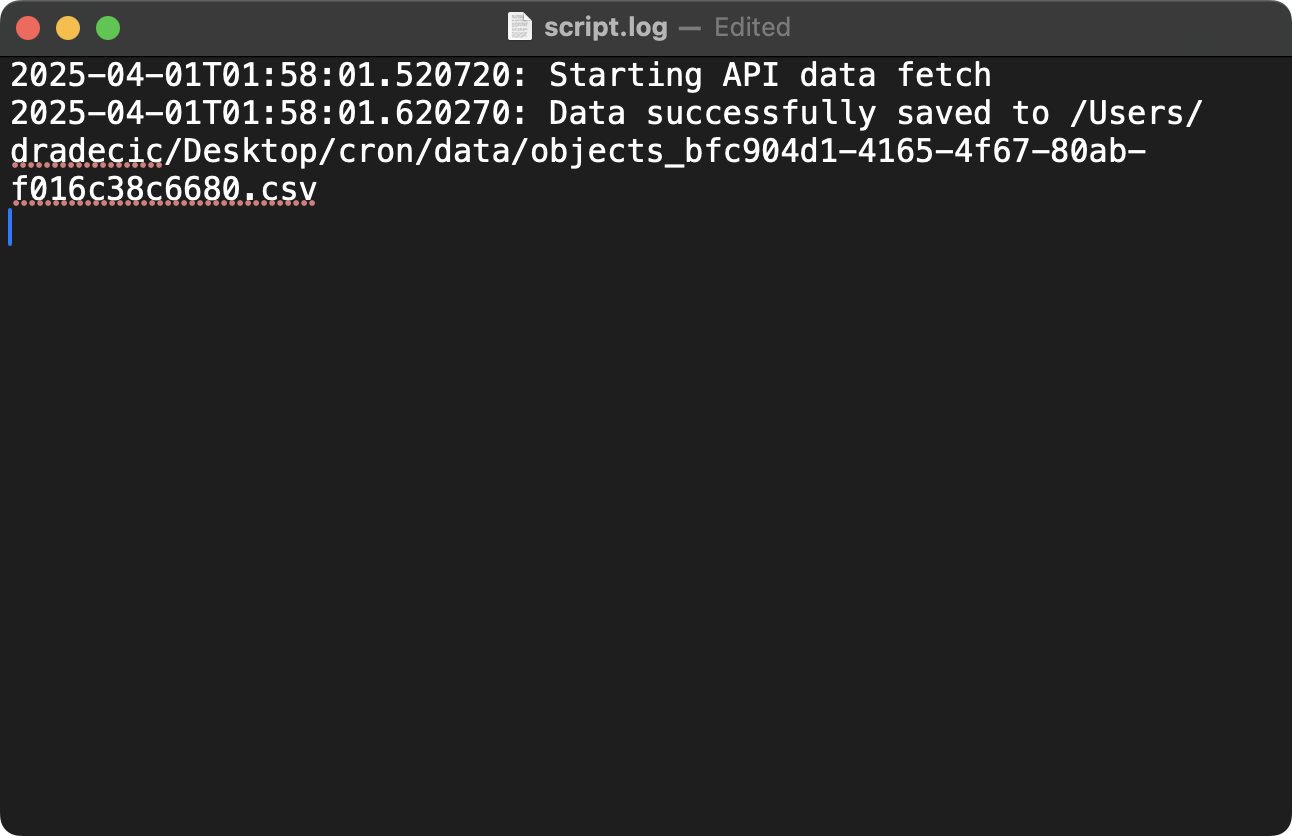
Afbeelding 12 - Configuratie voor cronjob-logging (1)
Dit commando draait je script elke minuut en voegt alle uitvoer toe aan een logbestand. De operator >> voegt toe in plaats van te overschrijven, terwijl 2>&1 zowel standaardfout (bestandsdescriptor 2) als standaarduitvoer (bestandsdescriptor 1) naar hetzelfde logbestand leidt.
Voor meer gestructureerde logging kun je tijdstempels en job-identificaties toevoegen:
* * * * * (echo "=== Job started at $(date) ==="; /Users/dradecic/miniforge3/bin/python /Users/dradecic/Desktop/cron/fetch_api_data.py; echo "=== Job finished at $(date) with exit code $? ===") >> /Users/dradecic/Desktop/cron/logs/script.log 2>&1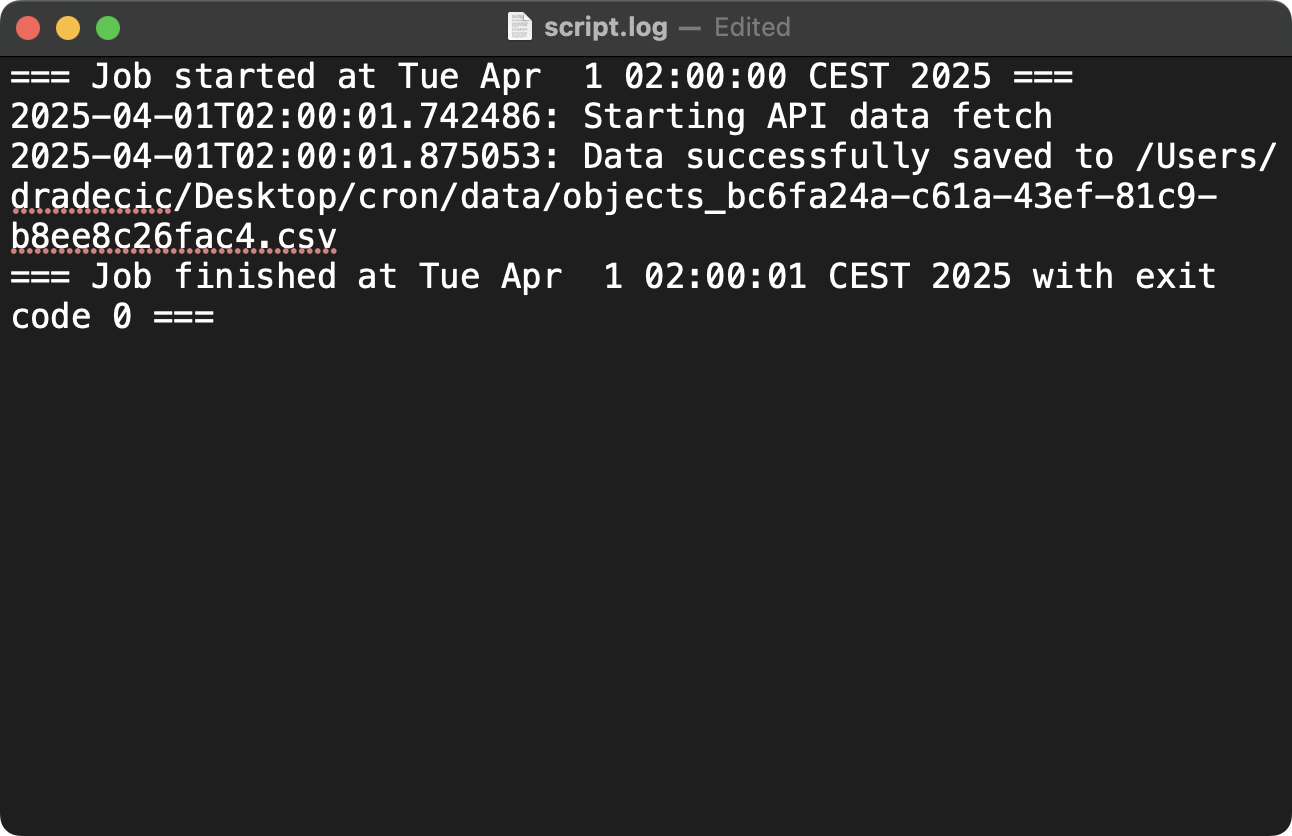
Afbeelding 13 - Configuratie voor cronjob-logging (2)
Dit uitgebreide commando voegt een duidelijke startmarkering met tijdstempel toe vóór het uitvoeren van je script en een eindmarkering met zowel tijdstempel als exitcode na voltooiing. De haakjes groeperen deze commando's zodat al hun uitvoer naar het logbestand wordt omgeleid. De variabele $? bevat de exitcode van het meest recent uitgevoerde commando, waarmee je kunt bepalen of het script is geslaagd (exitcode 0) of gefaald (niet-nul).
Om te voorkomen dat logs te veel schijfruimte innemen, kun je logrotatie implementeren. Gebruik de utility logrotate, die op de meeste Linux-distributies beschikbaar is:
Maak een configuratiebestand aan op /etc/logrotate.d/cron-jobs:
/path/to/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    create 0640 username groupname
}
Deze configuratie vertelt het systeem om:
daily)missingok)rotate 14)compress)delaycompress)notifempty)create 0640 username groupname)De logrotate-service van het systeem past deze instellingen automatisch toe, meestal eenmaal per dag. Bij uitvoering hernoemt het je huidige logbestand (met een datum-suffix), comprimeert oudere logs, verwijdert logs ouder dan 14 dagen en maakt een nieuw logbestand aan voor nieuwe regels.
Robuuste data-engineeringworkflows hebben strategieën nodig om met fouten om te gaan. Je kunt retrylogica in je scripts of cronjobs integreren, of je cronjobs koppelen aan monitoringsystemen.
Ik laat je in deze sectie zien hoe je al deze opties implementeert.
Ingebouwde retrylogica kun je direct in je Python-scripts implementeren, zoals in dit voorbeeld:
import time
import random

def fetch_data_with_retry(max_attempts=3, backoff_factor=1.5):
    attempt = 1
    while attempt <= max_attempts:
        try:
            # Try to fetch data
            return fetch_data()
        except Exception as e:
            print(f"Attempt {attempt} failed: {str(e)}")
            # Calculate backoff time with jitter
            backoff_time = backoff_factor ** (attempt - 1) * (random.uniform(0.8, 1.2))
            if attempt < max_attempts:
                print(f"Retrying in {backoff_time:.2f} seconds...")
                time.sleep(backoff_time)
            else:
                print("Max retry attempts reached. Giving up.")
                raise
        attempt += 1
Deze Python-functie implementeert een exponential backoff-strategie met jitter. Zo werkt het:
max_attempts keer geprobeerd een dataophaaloperatie uit te voeren (standaard 3).Dit patroon is ideaal voor het afhandelen van tijdelijke fouten zoals netwerkproblemen of API-ratelimieten. De exponentiële toename van de wachttijd geeft het externe systeem tijd om te herstellen, terwijl de jitter "thundering herd"-problemen voorkomt.
Cron-gebaseerde retries zijn ook een optie. Je kunt mislukte jobs opnieuw proberen door ze vaker te plannen dan strikt nodig.
Hier is een voorbeeld waarin ik twee cronjobs instel:
success_flag-bestand aangemaakt dat voorkomt dat het script binnen 10 minuten opnieuw draait.*/10 * * * * [ ! -f /path/to/success_flag ] && python /path/to/script.py && touch /path/to/success_flag
0 0 * * * rm -f /path/to/success_flag Bovenstaande setup is misschien lastig te begrijpen, dus ik loop de stappen nog eens door:
[ ! -f /path/to/success_flag ])/path/to/script.py)touch /path/to/success_flag)0 0 * * *) en verwijdert de success-flag, zodat het proces de volgende dag opnieuw kan draaien.Deze techniek is handig voor taken die eenmaal per dag voltooid moeten worden maar tijdelijk kunnen falen. De job blijft het die dag proberen totdat hij één keer slaagt.
Monitoringintegratie laat je cronjobs koppelen aan monitoringsystemen, zoals Prometheus. Dat is een onderwerp op zich, dus hier geef ik alleen een high-level overzicht.
Het script hieronder is een wrapper om je echte job heen die statistieken verzamelt en rapporteert aan Prometheus. Dit zijn de stappen die het script uitvoert:
#!/bin/bash
# monitored_job.sh

# Define pushgateway URL
PUSHGATEWAY="http://prometheus-pushgateway:9091"

# Start time in seconds
START_TIME=$(date +%s)

# Run the actual job
/path/to/actual_job.sh
EXIT_CODE=$?

# End time in seconds
END_TIME=$(date +%s)
DURATION=$((END_TIME - START_TIME))

# Push metrics to Prometheus
cat <<EOF | curl --data-binary @- ${PUSHGATEWAY}/metrics/job/cron_job/instance/$(hostname)
# HELP cron_job_duration_seconds How long the cron job took to execute
# TYPE cron_job_duration_seconds gauge
cron_job_duration_seconds{name="data_extraction"} ${DURATION}

# HELP cron_job_exit_code Exit code of the cron job
# TYPE cron_job_exit_code gauge
cron_job_exit_code{name="data_extraction"} ${EXIT_CODE}

# HELP cron_job_last_run_timestamp Timestamp of last job run
# TYPE cron_job_last_run_timestamp gauge
cron_job_last_run_timestamp{name="data_extraction"} ${END_TIME}
EOF

exit ${EXIT_CODE}
Met deze statistieken kun je:
De Pushgateway fungeert als tussenpersoon, zodat de kortlevende cronjob zijn statistieken kan doorsturen naar Prometheus, dat ze vervolgens opslaat voor alerting en visualisatie.
Tijdzone-issues zijn veelvoorkomende uitdagingen in data engineering, vooral wanneer je werkt met wereldwijde databronnen of gedistribueerde systemen.
Zoals je zou verwachten zijn cronjobs gevoelig voor tijdzone-instellingen.
Standaard gebruikt cron de lokale tijdzone van het systeem. Je kunt de tijdzone van je systeem controleren met dit Linux-commando:
timedatectlBovenstaand commando toont de huidige tijd- en tijdzoneconfiguratie van je systeem. Als je server is ingesteld op een lokale tijdzone zoals America/New_York, dan worden alle cronschema's in die tijdzone geïnterpreteerd.
Gebruik UTC voor je cronjobs om consistente planning te garanderen, ongeacht serverlocatie of zomertijdwijzigingen:
# Set the CRON_TZ environment variable at the top of your crontab
CRON_TZ=UTC

# Now all job schedules will use UTC
0 0 * * * /path/to/daily_job.sh
Door de regel CRON_TZ=UTC bovenaan je crontabbestand toe te voegen, vertel je cron om alle tijdspecificaties in UTC te interpreteren in plaats van lokale tijd.
Dit betekent dat de job elke dag om middernacht UTC draait, ongeacht de lokale tijdzone van de server of zomertijdwijzigingen. UTC (Coordinated Universal Time) verandert nooit door zomertijd en biedt een consistent referentiepunt voor alle locaties.
Als data engineer zijn cronjobs van onschatbare waarde.
Ze helpen je repetitieve taken te automatiseren en betrouwbare datapijplijnen te bouwen. Ze bieden een consistente en krachtige manier om scripts te plannen en complexe orkestratie van meerstaps-ETL-processen uit te voeren. De syntax vergt wat gewenning, maar na een paar dagen voelt het natuurlijk aan.
Onthoud bij het implementeren van cronjobs in je data-engineeringwerk om best practices rond logging, foutafhandeling en tijdzonebeheer te volgen. Goede logging geeft je zicht op jobuitvoering en maakt troubleshooting eenvoudiger. Degelijke foutafhandeling met retrymechanismen zorgt ervoor dat je pijplijnen kunnen herstellen van tijdelijke fouten. Zorgvuldig tijdzonebeheer houdt je schema's consistent, vooral als je werkt met wereldwijde databronnen of gedistribueerde teams.
>Wil je in 2025 aan de slag als Data Engineer? Dit zijn 5 essentiële skills die je moet hebben.
Zeker, gespecialiseerde workflow-orkestratietools zoals Apache Airflow of Prefect bieden geavanceerdere functies voor complexe datapijplijnen, maar cron blijft relevant voor veel data-engineeringtaken. Het is eenvoudig te gebruiken, betrouwbaar en heeft weinig overhead — perfect voor automatiseringsbehoeften.
Om meer te leren over data engineering, schrijf je in voor deze cursussen van DataCamp:
Leer meer over data engineering met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


